AIが数か月にわたる研究コンテキストを忘れないようにするには?
2026-08-21
どのメモリ設計なら、レビューサイクル全体で検索戦略を維持できるのか?
セッションに依存するチャットボットは、会話が終わった瞬間に検索式、採用基準、抽出済みの知見を失います。そのため、数か月に及ぶレビューは停滞します。プロトコルを永続的な状態として扱うツール、すなわちセッションをまたぐ永続メモリを備えたJenova's Academic Research Assistant、プロジェクト単位の系統的レビュー用ワークスペースを提供するElicit、そしてGemini Notebookのようにソースを限定したノートブックは、2026年のレビューサイクル全体を乗り切れる設計です。Consensusは、次の四半期にプロトコルを記憶することよりも、単発のエビデンス・マッピングで強みを発揮します。
永続的な研究メモリと使い捨てのチャットを分ける主な要素は、次のとおりです。
✅ 固定プロトコル層 — 組み入れ・除外ルールを、毎回入力し直すプロンプトではなく指示として保存する ✅ 蓄積される知見メモリ — 過去の抽出結果、除外理由、未解決の不一致を、再説明なしで呼び出せる ✅ 根拠に基づくコーパス — 論文、メモ、検索ログを紐付け、回答をエビデンスセットに結び付けたままにする ✅ 監査可能な判断 — 数か月後にも再構築できるスクリーニング根拠を、PRISMA 2020に沿って残す ✅ セッション間の継続性 — 日、デバイス、モデルを切り替えても、レビューの状態が消えないようにする
これらのツールを有用に比較するには、研究メモリをチャットボットの機能ではなくスタックとして捉え、プロジェクトを1週間離れた後でも各層が維持されているかを検証することが役立ちます。
AI研究アシスタントは、なぜ時間の経過とともにプロトコルの忠実性を失うのか?
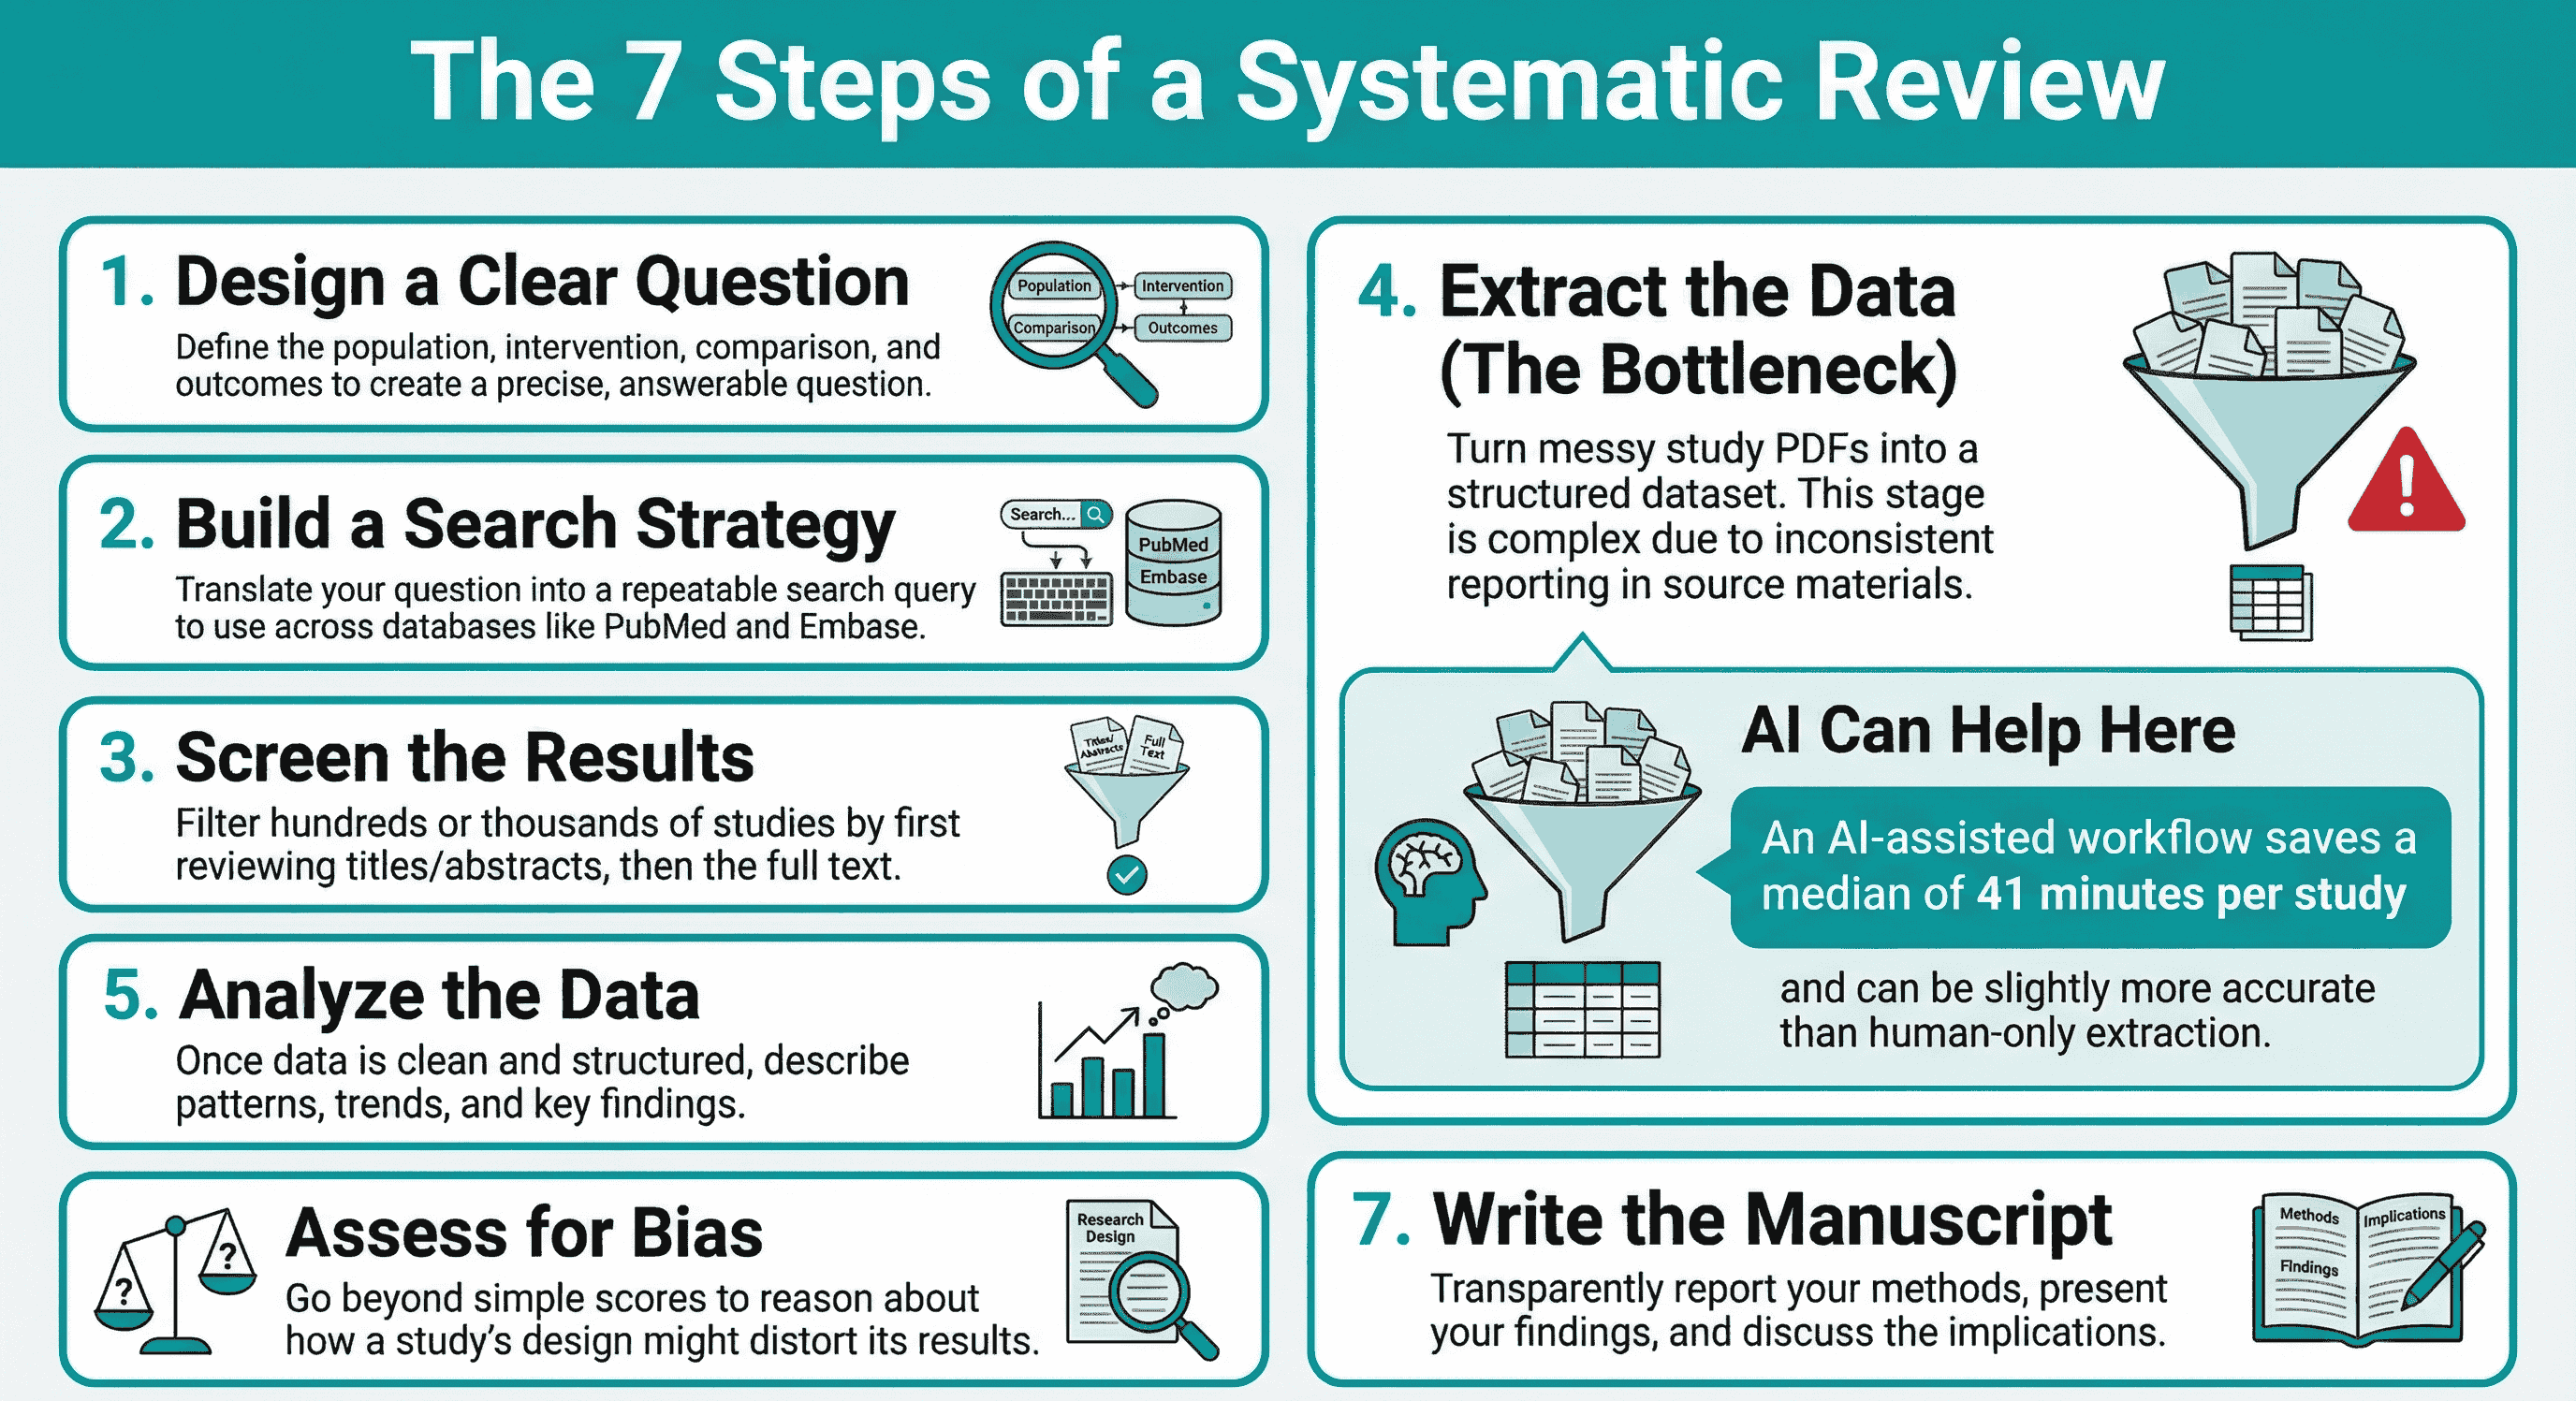
多くの消費者向けAIチャットが忘れるのは、セッションを越えて存続するプロジェクトではなく、一時的なコンテキストウィンドウに情報を保存しているためです。系統的レビューは、問いの設計、検索戦略、スクリーニング、抽出、分析、バイアス評価、原稿執筆という7段階のプロセスであり、どの段階も数週間前に下した判断に依存します。アシスタントが当初のPICOフレーミングや研究を除外した理由を思い出せないと、レビューは徐々に逸脱し始めます。
この種の作業に対する報告基準は明確です。PRISMA 2020 statementは、系統的レビューをどのように報告すべきかに関するエビデンスベースのチェックリストです。また、BMJによるPRISMA 2020の掲載論文では、ペアワイズ・メタアナリシスのような統合を含むレビューに向けた位置付けが示されています。Hofstra Universityの方法論ガイドは、この声明を、系統的レビューおよびメタアナリシスを報告するための27項目からなる最小セットと説明しています。検索式や除外理由を再構築できないアシスタントは、このチェックリストを支援できません。
忘却の問題は仮説上のものではありません。研究者はすでにレビューのパイプライン全体で機械学習を利用しています。63のMLツールを対象とした2022年のマッピングでは、文献検索からデータ抽出までのタスクが扱われました。こうしたツールが単独ではほとんど解決できないのが、長期的な忠実性です。つまり、1か月目と同じ組み入れルールを4か月目にも同じように適用することです。
チャット型アシスタントは、特に次の3つの点で問題を悪化させます。
- プロトコルの蒸発。 Boolean検索式、データベースの対象範囲(PubMed、Embase)、日付制限は、第一級のオブジェクトとして保存されないプロンプトの中に存在します。
- 基準のドリフト。 組み入れルールを非公式に言い換えるうちに、対象集団、介入、アウトカムの定義が少しずつ変わります。
- 知見の健忘。 抽出した効果量、矛盾する結果、「この論文に戻る」といったメモは、スレッドがなくなると消失します。
King's College Londonのエビデンス統合ガイドは、現在のコンセンサスを端的に示しています。AIはレビューのさまざまな段階で役立ちますが、方法論的な統制を置き換えるものではありません。メモリとは、その統制を暦の時間にわたって引き延ばすものです。
研究コンテキストを記憶するAIツールには何を求めるべきか?
長期的な研究向けAIは、単発のチャットがどれほど流暢かではなく、プロトコルの永続性、知見の継続性、ソースへの根拠付け、監査可能性、コーパスのカバレッジ、そしてその状態を維持するコストで評価すべきです。洗練された要約を書けても、先月の除外ログを取得できないツールは、節約する以上の時間を消費します。
本記事では、評価を具体化するために、4層モデルである研究継続性スタックを用います。
- 固定プロトコル。 チャットバッファの外部に保存された検索戦略と組み入れ・除外基準(カスタム指示、プロトコル文書、またはスクリーニング設定)。
- 蓄積メモリ。 セッションごとにリセットされるのではなく、セッションをまたいで増えていく過去の知見、未解決の問い、レビュー担当者間の不一致。
- 根拠に基づくコーパス。 アシスタントが利用を許可されている実際の論文、PDF、メモ、検索エクスポート。
- 判断監査。 後から組み入れ・除外の理由を再構築できること。理想的には引用箇所も含み、第二のレビュー担当者やPRISMAフロー図を後で作成できる状態です。
このスタックに照らして検証すると、購入時に問うべきことが変わります。Elicitは、スクリーニング基準、除外理由、基準ごとのスコアをPRISMA監査可能な形で扱えるように設計されており、層1と層4に強みがあります。Gemini Notebookは、回答でアップロードしたソースからの正確な引用箇所を示すように設計されており、層3に強みがあります。Consensusは、2億5,000万本超の研究論文を検索し、エビデンスがどこで一致しているかを示すように設計されており、発見には強い一方、あなた自身のプロトコルを記憶することには弱みがあります。Jenova's Academic Research Assistantは、無制限のチャット履歴、セッションをまたぐ永続メモリ、添付可能なナレッジベースを中心に構築されており、数か月にわたる研究プログラムにおいて層1〜3に強い一方、ネイティブのPRISMA図には弱みがあります。
プロジェクトの種類に応じて各層に重みを付けてください。Cochraneスタイルの系統的レビューでは監査可能性を最優先にすべきです。2学期にまたがる学位論文の文献レビューでは、蓄積メモリを重視すべきです。同じ論文群をプロジェクト間で再利用するラボでは、根拠に基づく再利用可能なコーパスを重視すべきです。
Jenova、Elicit、Consensus、Gemini Notebookは長期的な研究メモリをどう扱うのか?
Jenovaは、研究プログラムが対話的かつ反復的で、期間が数か月単位である場合に最も強みを発揮します。Elicitは、作業単位が正式な系統的レビューである場合に最も強く、Consensusは迅速なエビデンス・マッピングで、Gemini Notebookはコーパスがすでに手元にある場合に最も強力です。4つのツールは研究継続性スタックの異なる層を最適化しているため、どれか1つが普遍的に優れているわけではありません。
| 機能 / 評価軸 | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| プロトコルの永続性 | プロジェクトワークスペース、リビングレビューの更新 | 無制限の履歴、永続メモリ、カスタム指示 | プロンプトレベルのフィルター、保存済みプロトコルではない | ノートブック単位の指示とソース |
| 組み入れ基準 | 基準の自動提案、二重レビュー、除外理由 | 指示に組み込み、セッションをまたいで呼び出し | 検索ごとに適用する自然言語フィルター | 範囲を限定したノートブック内でユーザーが定義 |
| 過去の知見の想起 | 再利用可能な抽出表とレポート | メモ、不一致、判断のセッション間メモリ | クエリ単位の統合であり、長期ログではない | アップロードした内容に基づく |
| コーパス / ソース | 1億3,800万本の論文、PubMed、ClinicalTrials.gov、アップロード資料 | ユーザーアップロード、ナレッジベース、ライブ検索ツール | 2億5,000万本超の論文、ライセンス取得済み全文 | アップロードしたPDF、文書、サイト、音声、動画 |
| 監査可能性 | PRISMAフロー、引用、基準ごとのスコア | 対話履歴、ネイティブのPRISMA図はなし | 学術引用とConsensus Meter | ソースからの引用箇所単位の引用 |
| 料金(2026年時点) | 文書化されたProティアを含む有料サブスクリプション | 無料ティア、有料プランは月額$20から | 有料サブスクリプション | 個人利用は無料、組織データはトレーニングに使用されない |
| 最適な用途 | 正式な系統的レビューとリビングアップデート | 忘却が許されない複数月の研究プログラム | 迅速なエビデンスの概観と医療モード検索 | 閉じたコーパスの統合とソースに基づく教育 |
Elicit
Elicitは、1億2,500万本超の論文を検索、要約、データ抽出し、チャットできる専用の科学研究アシスタントです。系統的レビュー製品では、1億3,800万本の論文を毎週更新しながらインデックス化しています。最大40,000本の論文をスクリーニングでき、スクリーニング基準を自動提案し、除外理由と裏付け引用により、すべての判断をPRISMA監査可能な状態に保てます。
数か月にわたる、複合的な研究プログラムにおける制約は、その専門性にあります。Elicitは構造化されたレビュー作業に優れますが、レビューオブジェクトの外にある派生仮説、指導教員からのフィードバック、変化していくメモを記憶する汎用的な研究パートナーとしての設計は、比較的限定的です。
Jenova Academic Research Assistant
Academic Research Assistantは、文献探索、原稿作成、引用管理のための学術研究パートナーです。無制限のチャット履歴とセッションをまたぐ永続メモリを備えたプラットフォーム上で動作します。検索戦略と組み入れ基準はカスタムエージェント指示に固定できます。PDF、プロトコル、スクリーニングログをプライベートなナレッジベースとして添付すれば、以後のセッションを同じエビデンスセットから開始できます。
率直な制約はElicitとは逆です。ネイティブのPRISMAフロー図、二重レビューのスクリーニングUI、または1億3,800万本の論文を対象とする専用の系統的レビューコーパスは提供していません。Cochraneレベルの監査証跡を必要とするチームは、判断をレビュー管理ツールへエクスポートする必要があります。ワンパスで引用を多く含むレポートが必要な関連作業は、数百のソースをインライン引用付きで統合するDeep Researchに任せられます。その後、知見を同じ長期スレッドに保存し直せば、また別の孤立文書になることを防げます。
Consensus
Consensusは、ライセンス取得済みの全文を含む2億5,000万本超の論文を利用するAI学術検索エンジンです。1,000万人の研究者、学生、臨床医による利用実績と、170以上の大学図書館パートナーを報告しています。Deep Searchは用語を拡張し、引用グラフをたどります。Medical modeは、約50,000件の臨床ガイドラインと、上位1,000の医学雑誌からの800万本の論文に対象を絞ります。Consensus Meterは、二者択一の問いに対してどの程度エビデンスが一致しているかを可視化します。
Paperguideによる2026年の比較は、適切な捉え方を示しています。Consensusはエビデンスを発見・評価し、Gemini Notebookはすでに持っているソースを変換する。Consensusはメモリシステムとしては限定的です。組み入れ基準をリビングプロトコルとしてネイティブに保存しないため、1学期にわたるプロジェクトには「3月に何を決めたか」を記録する外部の場所が依然として必要です。
Gemini Notebook
Gemini Notebook(旧NotebookLM、2026年7月にリブランド)は、ソースに根拠を置く思考パートナーです。PDF、Webサイト、YouTube動画、音声、Google Docs、スライドをアップロードすると、正確な引用箇所を示す引用付きで回答を得られます。組織のデータは製品のトレーニングには使用されません。
境界はノートブックです。渡したソースを忘れないからこそ、定義済みの読書セットには有効です。一方で、アップロードしていない論文を発見することはありません。まだ検索を続けている数か月規模のレビューでは、これは設定上の問題ではなく構造的な制約です。
検索戦略と組み入れ基準をセッション間で永続化するには?
プロトコル文書、カスタム指示、スクリーニング設定といった永続的なオブジェクトとして書き残し、唯一のコピーを使い捨てのプロンプト内に置かないことです。戦略が昨日のチャットにしか存在しないなら、それは存在していないのと同じです。
実践的なパターンは、次のようになります。
- 問いをPICO形式で固定する。 Population、intervention、comparison、outcomesは、毎週月曜日に言い換えるのではなく、アシスタントの常設指示にそのままコピーすべきです。
- 検索を再現可能な成果物として保存する。 データベース名、Boolean検索式、日付制限、言語制限、灰色文献のソースは、アシスタントが再読できる文書に記録します。
- 組み入れと印象を分ける。 「RCT、成人、2015〜2026年、英語全文」のような基準はルールとして列挙します。「私たちの理論に関連しているように思える」といった好みは、プロトコルを密かに書き換えられないよう仮説としてタグ付けします。
- 理由付きで除外を記録する。 PRISMAは選択プロセスの透明な報告を求めています。DistillerSRの方法論概要は、PRISMAが、レビューを損なう落とし穴を著者が避けるために存在すると強調しています。
Jenovaでは、固定プロトコルのステップはカスタム指示ブロックと添付したプロトコルPDFです。数か月にわたって維持される常設プロンプトは、次のようになります。
あなたはプロジェクトHEP-24の系統的レビュー・パートナーです。対象集団:NAFLDを有する18歳以上の成人。介入:GLP-1受容体作動薬。比較:標準治療またはプラセボ。主要アウトカム:MRI-PDFFおよびNAS。RCTおよび前向きコホート、2018〜2026年、英語全文を組み入れる。動物実験、データのない学会抄録、8週間未満の試験は除外する。新しいバッチをスクリーニングする前に必ず組み入れルールを再掲し、対象集団を暗黙に拡大しないこと。
Elicitでは、これに相当するのは製品内でレビュー・プロトコルを精緻化し、承認、編集、または置換できる自動提案のスクリーニング基準を使用することです。すべての判断に除外理由と裏付け引用を付与できるため、チャットログよりもPRISMA監査ファイルに近い状態になります。
Gemini Notebookでは、同じPICOブロックをノートブックの指示に貼り付け、プロトコルと検索エクスポートをアップロードします。アシスタントはそれらのファイルに忠実であり、その外側の論文を捏造しません。
注意すべき失敗パターンは、「親切な範囲拡大」です。6週間後、モデルは関連がありそうに聞こえるという理由で隣接する対象集団を組み入れ始めることがあります。各セッションの開始時にアシスタントが再掲しなければならない固定プロトコルは、追加できる最も低コストの統制です。
永続メモリはデータ抽出とバイアス評価をどう変えるのか?
永続メモリは、抽出を一回限りの転記作業から累積データセットへと変えます。ここは最も時間が失われる場所であり、AI支援が実証的に検証可能になっている場所でもあります。7段階のレビュー図が抽出をボトルネックとして示すのは、ソースPDFがアウトカムを一貫しない形で報告するためです。抽出シートを記憶できないアシスタントは、その混乱を毎週再導入します。
2026年のエビデンスは、マーケティング上の主張よりも精密です。medRxivのレビュー内研究では、慢性疾患のRCT 50件でElicit支援抽出と人間のみの抽出を比較し、全体精度に差はないことが示されました(0〜100スケールの平均差0.57)。一方で、AI支援抽出は24.82分高速であり、50研究全体で$181.98低コストでした。エラーの種類と重症度は同程度でした。Elicit自身の検証では、VDI/VDEが1,511データポイント中1,502件を正しく抽出(99.4%)したと報告しており、CSIROの研究者は手作業による抽出と比較して偽陰性がほぼゼロであると確認しました。
別の研究ラインでは、AIを置き換えではなく第二のレビュー担当者として扱っています。Cochrane Evidence Synthesis and Methodsの論文では、特に標準化された変数において、AIツールはデータ抽出で人間のレビュー担当者と高く同等の性能を示したと報告されています。Birmingham City Universityの方法論ノートはより慎重です。生成AIツールは年、国、参加者数では良好に機能するものの、これは試験群ごとの微妙なアウトカムを抽出できることと同義ではありません。
生の抽出精度に加えてメモリがもたらすのは、シートの一貫性です。
- 12週目にも2週目と同じアウトカム名、時点、単位が再利用される。
- すでにフラグが立った不一致(「同じ論文内に2種類のサンプルサイズがある」)を、新発見であるかのように再発見しない。
- バイアス評価では、単なるスコアではなく設計について推論できる。Risk-of-biasの作業では、無作為化、盲検化、欠測データが結果をどのように歪め得るかを扱います。そのためには抄録だけでなく、研究の設計メモを記憶している必要があります。
Jenovaのここでの制約は意図ではなくインターフェースです。永続メモリは、割付隠蔽を重要なドメインとして扱うことを思い出せますが、Cochrane RoB 2表を自動入力するわけではありません。Elicitの制約は逆です。抽出は高度に構造化され、引用で裏付けられますが、指導教員との面談に存在する非公式なバイアス推論は、永続化する別の場所を必要とします。両方を行うチームは、構造化ツールで抽出を行い、設計レベルのコメントは長期運用する研究エージェントに保持すべきです。
数か月続くAI研究ワークフローをどのように構築するか?
永続的なプロジェクトホームを1つ作り、最初の検索の前にプロトコルを読み込み、後続のすべてのセッションを新しいチャットではなくそのホームの更新として実行することで構築します。メモリネイティブなエージェントを使う場合でも、系統的レビュー用ワークスペースを使う場合でも考え方は同じで、異なるのはボタンだけです。
Jenovaの設定(最初の2分未満、その後は継続運用)
- Academic Research Assistantを開き、プロジェクトが長期に及ぶ場合は、専用エージェントのカスタム指示としてプロトコルを保存します。
- プロトコル、検索式、既存のスクリーニング用スプレッドシートをナレッジベースとして添付します。
- 曖昧な「続けて」ではなく、状態の要約から始めます。
PICO、検索済みデータベース、最終検索日、組み入れ・除外数、前回セッションで未解決だった3つの不一致を再掲してください。その後、固定基準に照らして次の25件のタイトルをスクリーニングしてください。組み入れ範囲を拡大しないでください。
- 各セッションを、次のセッションで読み込める文書化された引き継ぎで終了します。検索の更新、新たな除外と理由、まだ欠けている抽出フィールド、第二レビュー担当者への質問を記録します。
Jenovaの有料プランは、無料利用枠の30倍を月額$20から提供しており、月額$50、$100、$200、$500、$1,000の上位ティアがあります。利用枠は請求日に毎月リセットされます。スクリーニングの途中で無料ティアの上限に達してレビューが止まることも、数か月に及ぶ作業にとっては別種のメモリ障害であるため、この料金体系は重要です。
Elicitの設定
Elicitの系統的レビューの流れは、プロトコルの精緻化、PubMed、ClinicalTrials.gov、論文コーパスの検索の組み合わせ(または他データベースからのインポート)、AI支援の二重レビューによるスクリーニング、引用で裏付けたフィールドによる抽出、そしてPRISMAフロー図、論文要約表、検索戦略を含められるレポートの統合です。リビングレビューは、数か月規模の作業を支える機能です。レビューとアラートを組み合わせることで、同じプロトコルに新しい論文を新規プロジェクトなしで取り込めます。
Gemini Notebookの設定
レビューごとに1つのノートブックを作成します。プロトコル、検索エクスポート、PDFをアップロードします。それらのファイルから回答できるはずの問いだけを尋ねます。新しい論文がスクリーニングを通過したら、2つ目のノートブックを始めるのではなく同じノートブックに追加します。ソースに根拠を置くツールが「忘れる」原因は、ノートブックの分割です。
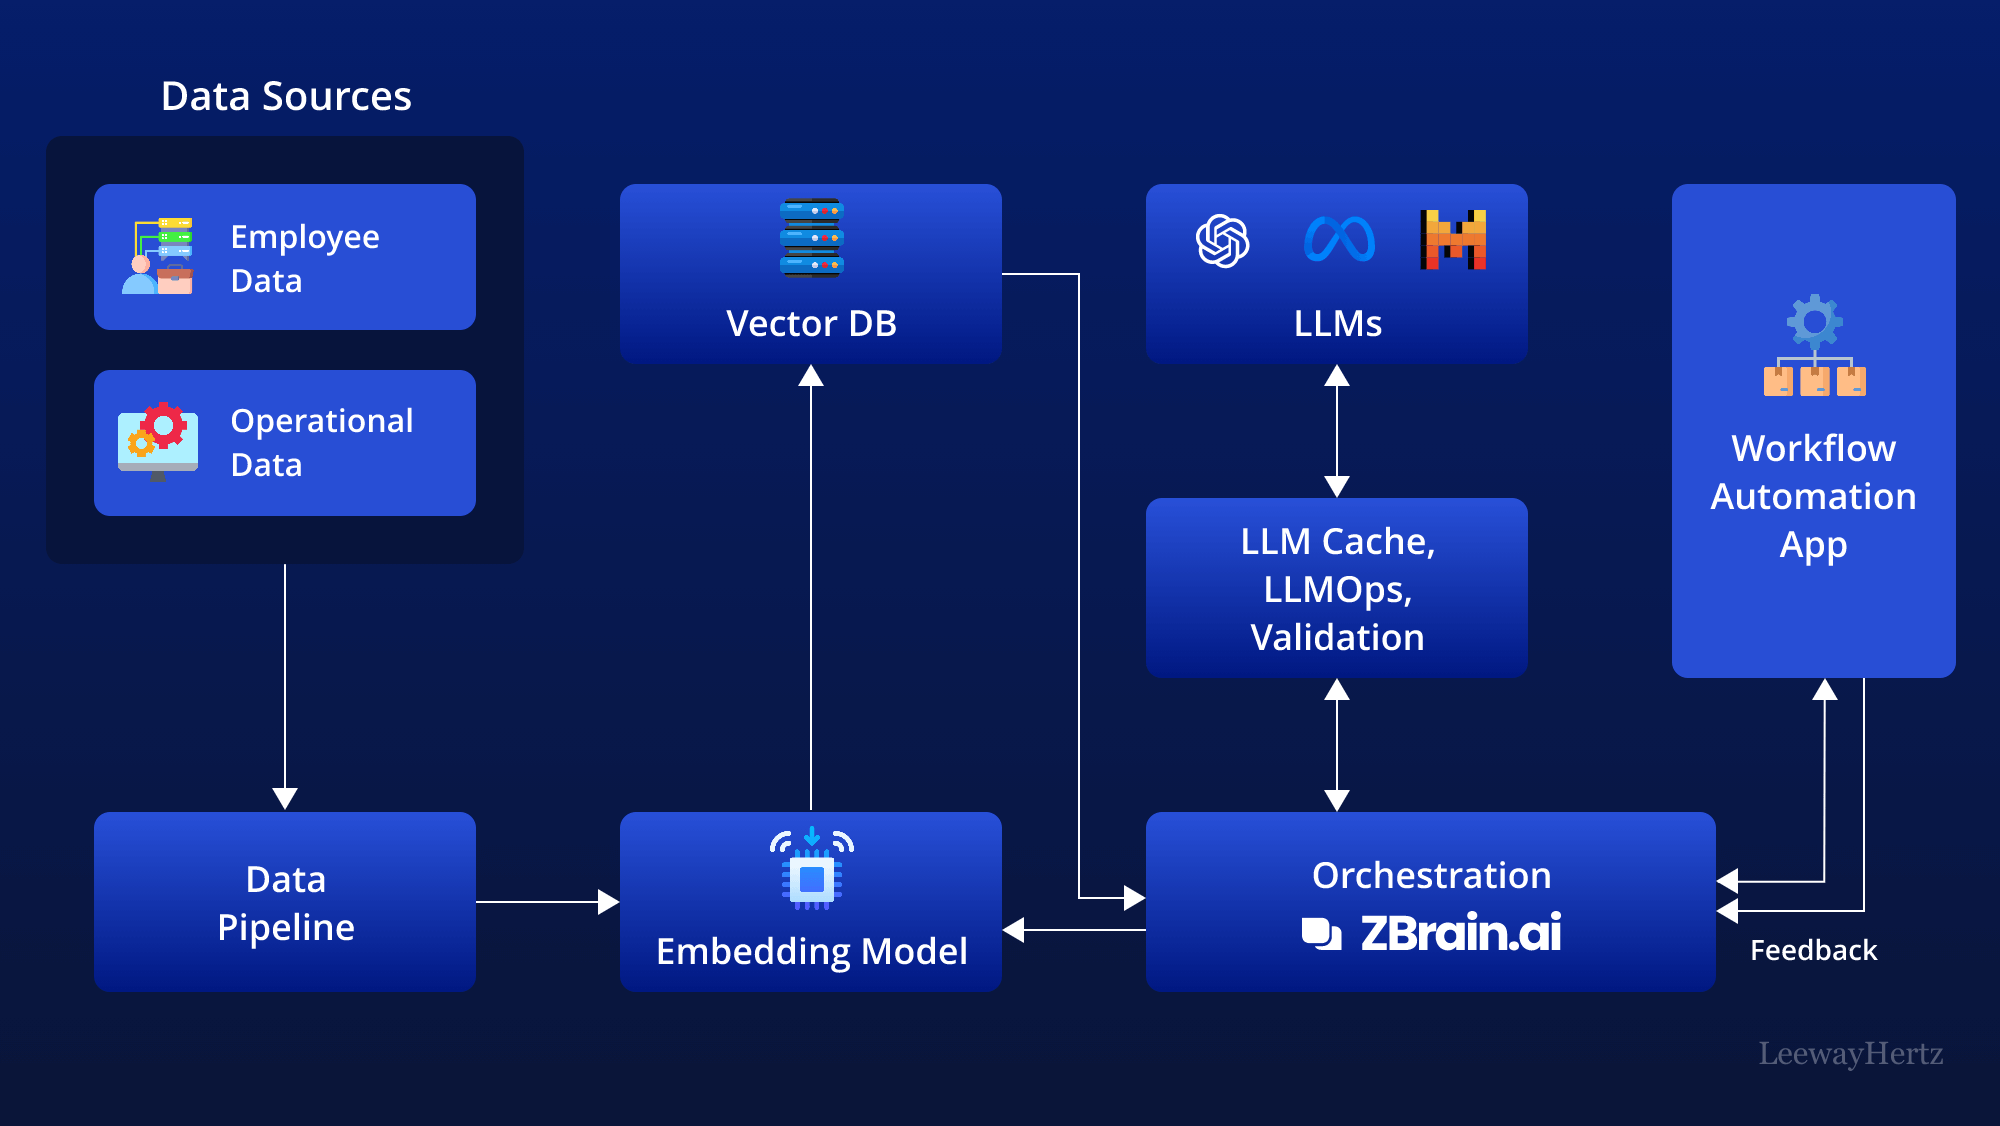
このアーキテクチャ図は、同じ考え方を産業規模で表したものです。永続的な研究メモリはパイプラインです。ソースは取り込み、埋め込み、ベクトルストア、オーケストレーション、モデル呼び出し、検証、フィードバックループを通過します。研究者がこのスタックを自ら組み立てる必要はありませんが、それを実装する製品は必要です。セッションチャットは最後の箱にすぎません。知見がメモリ、ナレッジベース、レビュー用ワークスペースに定着しなければ、パイプラインには状態がなく、4か月目に1か月目を説明し直すことになります。
エビデンス統合におけるAIメモリについて、研究方法論者は何を述べているのか?
方法論者はAIを、再構築可能なプロトコルの代替ではなく、監査上の問題を伴う省力化のためのレビュー担当者として扱っています。有用な専門家の問いは、「モデルはサンプルサイズを抽出できるか」ではありません。「第二の人間が、なぜこの論文が2月に除外されたのかを確認し、10月にも同意できるか」です。
「6か月目に破綻するレビューは、モデルが類義語を見落としたために失敗することはほとんどありません。組み入れルールがオブジェクトとして保存されなかったために失敗します。チームはセッションごとに少し異なる対象集団の定義を入力し、なぜエビデンス表が安定しないのかと悩みます。この状況で永続メモリは便利な機能ではありません。プロトコルと知見を同じタイムラインに存在させる唯一の方法です。"
「また、チームが構造化された抽出を過信し、判断ログへの投資を怠る例も見ています。引用で裏付けたデータフィールドは必要であり、精度と時間に関する2026年の抽出研究は有望です。しかし、それらは境界的な試験をなぜ残したのかを記録しません。AIがその理由を取得できないなら、リビングレビューを持っていることにはなりません。関連する一連のチャットを持っているだけです。"
「私たちが推奨する実践的な設計は、地味なものです。プロトコルを指示に固定し、知見をメモリまたはワークスペースに蓄積し、指し示せるコーパスに回答を根拠付け、PRISMAチェックリストが利用できる監査記録をエクスポートする。この4つの作業のためにツールを選んでください。最初の午後に流暢に感じたからという理由で選んではいけません。"
— Jenovaプロダクトチーム、長期運用研究ワークフロー設計
この姿勢は、レビューが最終的に入るべき報告の世界と一致します。PMC上のPRISMA 2020の説明と詳細化の論文は、このガイドラインが統合を含むレビューのためのものであることを明確に示しています。EQUATOR Networkも同じ更新済み報告ガイドラインを掲載しています。方法を記憶できないアシスタントは、方法の報告を支援できません。
AIアシスタントが先月の除外を呼び出せないと、再現可能性に何が起こるのか?
再現可能性は見せかけに崩れます。流暢な関連研究セクションは生成できても、研究セットを正当化できなくなります。数か月にわたるプロジェクトでは、数百件の組み入れ・除外判断が生じます。その判断を取得できなければ、新しいスクリーニング担当者、指導教員、査読者は、プロトコル主導の除外とセッション時点の気分による除外を見分けられません。
リビング系統的レビューでは、この失敗が明白になります。Elicitはリビングレビューを、完成したレビューとアラートを組み合わせ、新しい情報を毎年、または必要に応じて取り込むものとして説明しており、プロセス全体と中間結果へのリンク共有を可能にしています。これは、前四半期の除外が更新対象のオブジェクトの一部である場合にのみ機能します。「トピックを覚えている」だけで除外ログを記憶しないチャットボットは、すでに除外した論文を再び組み入れるか、すでに抽出した論文を再び除外することになります。
次の3つの再現可能性チェックにより、欠落を迅速に明らかにできます。
- 再現テスト。 1週間プロジェクトを離れた後、アシスタントに直近20件の除外と理由を列挙させます。理由を捏造したり、プロジェクトを混同したりするなら、監査層が欠けています。
- 範囲拡大テスト。 テーマとしては魅力的だが対象範囲外の抄録を与えます。固定基準を引用せずに組み入れを主張するなら、プロトコルの永続性は失敗しています。
- 引き継ぎテスト。 同僚が口頭での説明なしに、アシスタントの最新の状態要約から作業を継続できるべきです。できないなら、そのメモリは個人的なものであり、科学的なものではありません。
Jenovaは、指示、ナレッジベース、セッションメモリを実際に使用している場合、再現テストと引き継ぎテストに対応できます。ただし、ジャーナルがフロー図を求める場合は、PRISMA形式のログをエクスポートする必要があります。Elicitは監査テストによりネイティブに対応できますが、非公式な科学的判断を別の場所に保持する必要は残ります。ConsensusとGemini Notebookを単独で使用すると、それぞれ異なるテストに失敗します。Consensusはあなた自身の除外を再現できず、Gemini Notebookはアップロードされなかった論文を再現できません。
したがって、数か月に及ぶ研究の問題は、「2026年にどのモデルが最も賢いか」ではありません。検索戦略、組み入れ基準、過去の知見が、戻ってきたときにも存在し続けるスタックに保存されているかどうかです。その3つのオブジェクトを維持できるツールを選び、ドリフトが起きるなら必ず表面化するよう、各セッションの開始時にアシスタントへ再掲させてください。
参考文献
- PRISMA 2020 statement — 系統的レビューのためのチェックリスト、フロー図、報告ガイダンス
- PRISMA statement — 系統的レビューに関する主要な報告ガイドラインの概要
- The BMJ — PRISMA 2020 statement:系統的レビュー報告のための更新済みガイドライン
- Hofstra University LibGuides — 系統的レビューおよびメタアナリシスのためのPRISMA 27項目チェックリスト
- ScienceDirect — 63のMLツールのマッピングを含む、系統的文献レビューとメタアナリシスのためのAIツール
- King's College London — エビデンス統合におけるAIツール
- Elicit — スクリーニング、抽出、PRISMA監査、リビングレビュー、検証結果を含む系統的文献レビュー
- Elicit — コーパス規模と研究者基盤を含む製品・料金概要
- Consensus — コーパス規模、Deep Search、Medical modeを備えたAI学術検索エンジン
- Paperguide — ConsensusとNotebookLMの比較:エビデンス発見とソース変換(2026年)
- Gemini Notebook(旧NotebookLM)— ソースに根拠を置くノートブック、引用箇所単位の引用、データ利用ポリシー
- DistillerSR — PRISMAガイドラインと系統的レビューを損なう落とし穴
- medRxiv — Elicitを用いたAI支援データ抽出と人間のみの抽出における精度・効率の比較(2026年)
- Wiley / Cochrane Evidence Synthesis and Methods — データ抽出における第二レビュー担当者としてのAIツール
- Birmingham City University — 文献レビューのデータ抽出における生成AIの性能
- PubMed Central — PRISMA 2020の説明と詳細化
- EQUATOR Network — PRISMA 2020報告ガイドラインの記録