AIリサーチアシスタントによる架空引用を防ぐには?
2026-08-21
引用根拠に基づくAIリサーチツールと、幻覚を起こすチャットボットを分ける安全策とは?
AIリサーチアシスタントが論文をでっち上げるのを防ぐ最も信頼できる方法は、記憶から参考文献を生成するツールを使わず、すべての主張を機械検証可能な識別子を持つ取得済みレコードに紐付け、原稿に入れる前に各引用を原典と照合することです。2026年において、この構成、すなわち根拠に基づく検索、識別子チェック、人による検証こそが、Jenova's Academic Research Assistant、Elicit、SciSpace、Consensus、Sciteのような文献ツールと、もっともらしい見た目の参考文献を今なお捏造する汎用チャットボットを分けるものです。
実際に架空の情報源を減らす主な要因は次のとおりです。
✅ 記憶ではなく検索 — アシスタントは、訓練データから参考文献を補完するのではなく、索引化された学術レコードを検索しなければなりません。 ✅ 識別子への紐付け — 引用するすべての文献には、独立して解決可能な DOI、PMID、arXiv ID、または出版社 URL が必要です。 ✅ 存在確認だけでなく忠実性 — RAG評価研究が示すように、実在する論文であっても、そこにない知見の根拠として引用すれば失敗です。 ✅ 書誌情報の正確性 — 著者名、年、巻、ページ範囲は、モデルが作ったニアミスではなく、実際のレコードと一致していなければなりません。 ✅ 人による検証ループ — Stanford Librariesと主要なスタイルガイドは、すべての引用に対する責任をツールではなく著者に課しています。
ツールを有益に比較するには、引用の完全性をプロンプト作成の小技ではなく、アーキテクチャの問題として捉えるとよいでしょう。以降では、そのアーキテクチャ、捕捉すべき失敗モード、そしてどのアシスタントにも適用できるワークフローを示します。
2026年、なぜ捏造されたAI引用が公表論文に現れているのか?
捏造された引用は、もはや教室内の逸話ではありません。研究者が各参考文献を解決せずにチャットボットの書誌リストを原稿へ貼り付けるため、ジャーナル、助成金申請書、引用インデックスにまで入り込んでいます。2026年のNatureの分析では、2025年の出版物のうち数万件に、無効なAI生成参考文献が含まれる可能性があると推定されました。
この汚染には特徴的なパターンがあります。コンピュータ科学者のGuillaume Cabanacは、自身の論文が、捏造論文の検出という自身の研究分野とは重ならないInternational Dental Journalで引用されているとの通知を受け、自分の参考文献なのに認識できないことに気付きました。ゴースト引用はこのように広がります。書式は整い、実在しそうな雑誌名が使われ、ざっと目を通すだけなら見逃されるのです。
文書化された事例は撤回を余儀なくするほど深刻です。Resnik and Hosseiniは、Academic Ethics掲載論文で29件中19件の引用が幻覚だった事例、その後撤回されたPLOS ONE論文で76件中18件の引用が捏造だった事例、そしてDigestive Diseases and Sciencesの展望論文で14件中12件の参考文献が存在しなかった事例をまとめています。GPT-4oの引用を対象とした2025年のメンタルヘルス研究では、56%に誤りがあり、約5件に1件は完全な幻覚だったことが確認されました。
教員の懸念は今やほぼ普遍的です。College Boardの調査によると、教員はAIの利用が批判的思考、独自の文章作成、学術的誠実性を損なっていると懸念しています。UNC Charlotteのような図書館ガイドは、幻覚による引用を例外的な問題ではなく、標準的な研究リスクとして扱うようになりました。
ツール選びへの示唆は明白です。アシスタントがライブのレコードを取得せずに、整ったAPAまたはVancouver形式の参考文献を出力できるなら、存在しない論文を捏造できます。そしてその論文は印刷物に掲載されるまで残り得ます。
参考文献リストをAIリサーチアシスタントに任せる前に、何を評価すべきか?
AIリサーチアシスタントは、情報源の真実性、識別子への紐付け、主張と本文箇所の忠実性、書誌情報の正確性、強制された人による検証ループという、5要素からなる「引用完全性スタック」で評価すべきです。文章の流暢さでは高得点でも、このスタックで低評価のツールは、どれほど洗練された文章に見えても参考文献リストには安全ではありません。
1. 情報源の真実性
回答が取得済みコーパスから来ているのか、パラメトリックメモリから来ているのかを確認してください。検索拡張システムはGoogle Scholar、PubMed、Semantic Scholar、Scopus、またはarXivを検索してから生成します。一方、検索機能のないチャットボットは、引用の次のトークンを予測するだけです。忠実性指標が存在するのは、検索が行われた場合であっても、生成内容が取得コンテキストから逸脱し得るからです。
2. 識別子への紐付け
タイトル・著者・年の組み合わせだけでは不十分です。DOI、PMID、PMCID、または出版社 URL を必須とし、必ず自分で解決してください。ゴースト参考文献は、多くの場合このテストで直ちに失敗します。実在論文だが巻号やページ範囲が違うといった書誌情報のニアミスも、再確認すれば見つかります。
3. 主張と本文箇所の忠実性
RAGにおける引用に関するACM研究では、正確性は忠実性と同義ではないことが示されました。引用の最大57%が、本来裏付けるはずの主張を支持していない可能性があります。実在するものの当該の知見を含まない論文は、存在しない論文と同じくらい危険です。実在する著者を経由して虚偽の結果を正当化してしまうためです。
4. 書誌情報の正確性
著者順、年、掲載媒体、巻、号、ページはレコードと一致しなければなりません。経営学分野でのRAGツールのテストでは、完全な捏造であるゴースト項目は少ない一方、小さな書誌情報エラーは依然として多いことが示されています。こうしたエラーも引用インデックスを壊し、論文の取り違えを隠しかねません。
5. 人による検証ループ
Stanfordが要約するAPAのジャーナル方針では、AIツールが提供する情報と引用は著者が検証しなければならないとされています。Wileyの研究者向けガイドラインとHarvardの研究公正ガイダンスも同様に、開示と正確性の責任を人間の著者に置いています。このカテゴリーのアシスタントに、その義務をなくせるものはありません。
スタックの重み付けは作業に応じて変えてください。システマティックレビューでは、忠実性と識別子への紐付けを重く評価すべきです。探索的なスクリーニングでは、引用前にすべての候補を検証するなら、より広い再現率を許容できます。文章の質を過大評価してはいけません。流暢な段落こそが、偽の引用を説得力あるものにする仕組みです。
人気のAIリサーチツールは、引用の信頼性においてどう異なるのか?
参考文献を学術インデックスから取得するのか、モデルの記憶から生成するのかによって、ツール間には大きな違いがあります。この単一の設計選択が、ゴースト引用リスクの大部分を予測します。汎用チャットボットは、書誌リストに使うには依然として最も高リスクな選択肢です。専用のリサーチアシスタントはゴースト参考文献を減らしますが、それでも引用内容の誤解、メタデータの誤登録、論文が示す内容の過剰主張は起こり得ます。
2026年時点の実用的な比較は次のとおりです。
| 機能 / 評価軸 | 汎用チャットボット(例:ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| 証拠の情報源 | ブラウジングを有効にしない限り、主にパラメトリックメモリ | 取得論文、抽出テーブル | 複数データベース検索(Google Scholar、PubMed、arXiv) | 実証的な問いに対して取得論文を使用 | 支持・反証コンテキストを持つ引用インデックス | 学術データベースとリポジトリを横断するリアルタイム文献探索 |
| ゴースト参考文献のリスク | 高い。ジャーナルや研究室で事例が確認済み | RAGの参考文献リスト研究では低い | RAGの参考文献リスト研究では低い | 検索ベースだが、依然として検証が必要 | 引用グラフ内の項目では低い | 検索ベースだが、独立したDOIチェックが必要 |
| 主張と情報源の忠実性 | 取得済みの本文箇所がなければ弱い | 構造化抽出ではより強い | 取得論文を引用する回答ではより強い | 実証的なYes/Noの問いではより強い | 論文がどのように引用されているかについて強い | 取得された本文箇所とモデル選択に依存し、人による確認が必要 |
| 書誌情報の正確性 | 捏造された細部が頻繁に生じる | RAG監査で軽微な不正確さが報告されている | RAG監査で軽微な不正確さが報告されている | 分野監査レベルでは未検証 | 引用コンテキスト周辺では強い | 取得レコードのメタデータを継承するが、文章中では逸脱し得る |
| 価格(2026年時点) | ベンダーのプランにより異なる | 未検証 | 未検証 | 未検証 | 未検証 | 利用回数に制限のある無料枠、月額$20からの有料プラン |
| 最適な用途 | 文章の下書き。参考文献リストの作成には不向き | エビデンステーブルとシステマティックな抽出 | 広範で学際的な文献検索 | 実証的なYes/Noの問いへの迅速な回答 | 引用が主張を支持または反証するかの検証 | 永続メモリを備えた、エンドツーエンドの文献探索、原稿準備、引用管理 |
汎用チャットボット
チャットボットはアウトライン作成や言い換えには優れていますが、書誌情報の構築には失敗します。前述のGPT-4oメンタルヘルス監査の数字は、警告として重要です。生成された引用の半数以上に誤りが含まれていました。ライブのレコードなしで完璧に見える参考文献を出力できるツールなら、すべての引用を未検証として扱ってください。
Elicit
Elicitは、論文をスクリーニングし、手法、アウトカム、限界をテーブルに抽出する作業で強みを発揮します。独立した比較では、迅速な探索的検索よりも、厳密なエビデンスベースのワークフローに適しているとされています。制約はカバレッジ密度です。200クエリのSciSpace実施ベンチマークでは、Elicitはクエリ当たり13.0件の高関連論文を返したのに対し、SciSpace Deep Reviewは26.3件でした。この差は、ゴースト引用リスクではなく再現率に影響します。
SciSpace
SciSpaceは複数の学術データベースを検索し、独自のDeep Review評価ではP@3からP@70までの精度で首位でした。この広さは、PubMed、arXiv、Google Scholarに証拠が分散する学際的な問いで役立ちます。制約は方法論にあります。関連性ラベルは3つの外部モデルから得ていたとはいえ、主要なベンチマークはSciSpace自身が実施しました。ベンダーのベンチマークは方向性を示すものとして扱い、採用する論文は自分で検証してください。
Consensus
Consensusは、ナラティブレビューを書くよりも、論文に基づいて実証的な科学的質問へ回答するために作られています。同じ200クエリテストでは、Consensus Deepは最初の結果において最高精度を記録しました(P@1 = 0.5882)が、リストの下位に進むにつれてその優位性を失いました。出発点を見つけるツールとしては強力ですが、長いスクリーニングリストを扱う主力ツールとしては弱めです。
Scite
Sciteの特徴的な資産は引用インテリジェンスです。後続論文が特定の主張を支持しているか、言及しているか、反証しているかを確認できます。比較では、包括的な研究運用ツールよりは用途が狭いものの、エビデンス検証ではより強いと位置付けられています。失敗モードが「この実在論文は、アシスタントが主張した内容を言っていない」であるなら、Sciteのような引用コンテキストが適切な手段です。
Jenova Academic Research Assistant
Jenova's Academic Research Assistantは、文献探索に加えて、原稿作成と引用の支援を一つの永続的なワークスペースで必要とする研究者やPhD学生向けに構築されています。主要な学術データベースとリポジトリをリアルタイムで横断検索し、セッションをまたいでプロジェクトメモリを保持し、単一ベンダーに固定されずに最新モデルで下書きを作成できます。この組み合わせは、レビューに数週間を要し、アシスタントが採択基準、除外論文、未解決のDOIを覚えておく必要がある場合に有用です。
ただし、専用の引用コンテキストインデックスではないため、支持・反証のマップについてSciteを置き換えることはできません。また、Elicitの意味での専用抽出グリッドでもありません。リアルタイム検索では、流暢なモデルが過剰解釈し得る低品質または不適合なレコードを取得する場合もあります。正直な運用原則は、すべての検索ツールで同じです。候補を見つけて整理するために使い、書誌情報を正しいと保証させるために使ってはいけません。
検索拡張生成はゴースト参考文献を完全に防げるのか?
いいえ。検索拡張生成(RAG)は、参考文献リストに完全な捏造論文が入ることを大幅に減らしますが、書誌情報の誤りをなくすわけではなく、取得された論文が結び付けられた文を支持する保証にもなりません。したがって、防止策は一つではなく、三つの異なる失敗モードを対象にする必要があります。
この三つは、いずれも「もっともらしい見た目の引用」を作るため、混同しやすいものです。
- ゴースト参考文献 — 引用された文献が存在しない。
- 書誌情報の逸脱 — 文献は実在するが、著者、年、巻、またはページが誤っている。
- コンテキスト幻覚 — 文献は実在し、メタデータもほぼ正しいが、アシスタントが論文にない知見を帰属させている。
経営学分野におけるScopus AI、Elicit、SciSpace、Sciteのフィールド分析では、RAGベースのツールは一般に検証可能なゴースト参考文献を出力しませんでした。一方で軽微な書誌情報の不正確さは依然として見られ、完全に存在しない情報源は、生成されたリストではごくわずかでした。これがRAGを正しく理解する方法です。ゴーストを抑える強力な制御策ではありますが、完全な引用品質システムではありません。
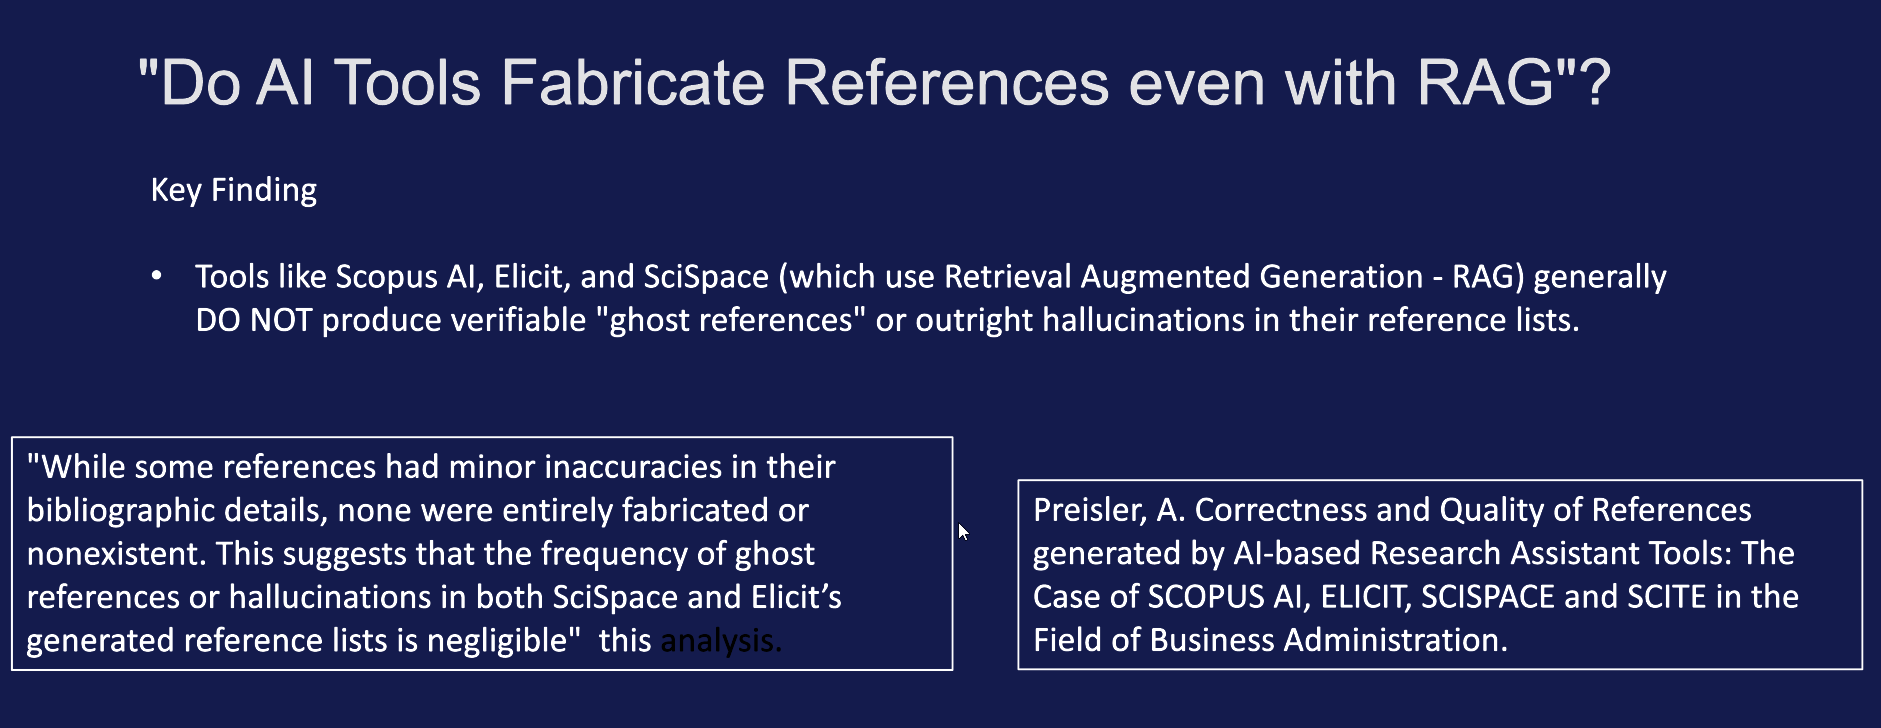
忠実性に関する研究は、残るリスクを説明します。RAG評価フレームワークでは、回答の関連性と忠実性を区別しています。応答は話題に沿っていても、取得した本文箇所に根拠付けられていない可能性があります。RAGの引用の大きな割合が忠実性を欠き得るというACMの知見は、実務上の警告です。DOIが解決するかだけを確認すれば、ゴーストは捕捉できますが、誤った帰属は見逃します。
汎用チャットボットは第一のモードで主に失敗します。RAGアシスタントは主に第二と第三のモードで失敗します。したがって、「この論文は存在するか」とだけ尋ねる防止ワークフローは、研究者が実際に使用すべきツールに対して不完全です。
AIリサーチアシスタントが返した引用は、どのように検証するのか?
二段階のプロトコルで検証します。最初に識別子を解決し、次に特定の本文箇所が主張を裏付けていることを確認します。どちらかを省略すると、捏造または誤用された情報源が出版物に入り込む原因になります。
第1段階 — レコードは存在するか?
- 返されたタイトル、筆頭著者、年、DOIを正確にコピーします。
- DOIをレジストラまたは出版社のページで解決します。DOIがない場合は、研究ガイドが推奨する直接照合アプローチに従い、Google Scholar、PubMed、またはジャーナルサイトで完全一致のタイトルを検索します。
- 解決しない項目、別の論文に解決される項目、AI整形の引用としてしか存在しない項目はすべて除外します。
- 著者順、年、巻、号、ページを、アシスタントの書誌ブロックではなく出版社のレコードと照合します。
第2段階 — この論文はこの文を支持しているか?
- PDFまたはHTMLの全文を開きます。因果関係の主張、効果量、「最初の証拠」といった表現では、抄録だけでは不十分です。
- その主張を裏付けるはずの本文箇所を探します。メモに引用してください。
- 引用を「支持」「言及」「反証」に分類します。これはSciteが製品化している区別であり、手作業でも適用できます。
- アシスタントが限界を知見として言い換えていたり、仮説を結果として扱っていたりする場合は、その文に対する引用を破棄します。
Jenova's Academic Research Assistantでは、参考文献リストを生成する前に検索条件を制約してください。
「[topic]に関する査読済み論文およびプレプリントを2019~2026年で検索してください。DOIまたはPMIDを持つ項目だけを返してください。各項目について、タイトル、著者、年、掲載媒体、識別子、1文の知見、引用した本文箇所を提示してください。検証可能なレコードを取得できない場合は、その項目を完全に省いてください。メタデータを補完または推測してはいけません。」
その後、同じ候補をElicitまたはSciSpaceでも確認し、第二のコーパスチェックを行います。ツール間の不一致は有益です。一方のシステムが順位付けした論文を、もう一方が取得できなかったことを示します。
Scienceによる幻覚を起こした科学論文の報道が示すように、タイトルをざっと読むだけでは不十分です。アシスタントは、一つの実在論文を正しく引用した直後に、同じ段落内で近接した別の論文を捏造することがあります。検証は段落単位ではなく、項目ごとに実施する必要があります。
幻覚による引用は研究不正に該当し得るか?
はい、一定の条件では該当し得ます。そして、法的な研究不正の定義を満たさない場合でも、撤回、助成金上の問題、キャリアへの損害を招く可能性があります。防止の動機は礼儀ではなく、責任リスクです。
Resnik and Hosseiniの主張によれば、米国連邦規則の下で、幻覚による引用は次の三条件を満たす場合に立証可能な研究不正となり得ます。すなわち、研究者が生成ツールを使って存在しない引用を作成したこと、それらの引用がレビューや計量書誌学研究のように知見を支えるデータとして機能していること、そして研究者が出力を確認せず捏造リスクに無関心を示したことです。ナラティブな序論におけるゴースト参考文献は、質の低い研究行為です。しかし、システマティックレビューでエビデンスとして数えられるゴースト参考文献は、捏造データにより近いものです。
資金提供機関は、すでにこの問題を実務上の課題として扱っています。2025年夏、NIHの助成金審査スタッフはAI支援による提案書に圧倒され、同機関は採択後に発見された不適切なAI利用を研究公正審査に回す可能性を示しています。Harvardの研究公正ハブも関連する制約を改めて示しています。AIツールは著者として記載できず、NIHの科学的ピアレビュー担当者は批評の作成に生成AIを使用することを禁じられており、著者はツールの使用方法を開示しなければなりません。
ジャーナルも同じ責任分担へ収束しています。APA、MLA、Chicago、IEEEの規則をまとめたStanfordの資料は、AI生成コンテンツの開示と、APAの場合は引用を人間が明示的に検証することを求めています。Cornellの教育ガイダンスはさらに、自動AI検出アルゴリズムは信頼性が低すぎて、研究公正のための戦略にはなり得ないと警告しています。事後の検出は、投稿前の検証に代わる弱い手段です。
実務上の基準は単純です。解決可能なレコードと、それを支持する本文箇所を示せないなら、その引用は原稿、スライド、助成金申請書に入れるべきではありません。
研究公正の専門家は、AI生成引用について何と言っているのか?
専門家は現在、捏造された参考文献を、ユーザーが予見できない神秘的なモデルの不具合ではなく、生成モデルを図書館のように使うというプロセス上の失敗として扱っています。研究公正オフィスと引用研究に共通する見解は、RAGはゴーストを減らすものの、人による検証は必須であり、既知の失敗率を考えれば、監督なしのチャットボット書誌リストを使うことは無謀だというものです。
「ジャーナルに届き続ける誤りは、モデルが時に推測すること自体ではありません。研究者が、言語モデルにそもそも設計されていない目録作成タスクを任せていることです。アシスタントがレコードを取得していないなら、書誌パターンを補完しているのであり、補完されたパターンこそが、実在しそうなジャーナルに実在しそうな論文を作り、解決しないDOIを付与する仕組みです。検索ツールへ切り替えれば、この失敗モードは劇的に減らせます。しかし次の失敗、すなわち結果セクションではなくモデルの要約にしか存在しない結果を、実在論文から引用したかのように扱う問題は減りません。」
「私たちは研究利用者に、3区分ワークフローを実行するよう勧めています。区分Aは取得済みで本文箇所まで確認済みのものです。これらの引用は使用できます。区分Bは取得済みだがメタデータだけを確認したものです。これらは読書リストに残します。区分Cは、モデルが解決可能な識別子なしに出力したものです。これは「後で調べる」のではなく削除します。書式を整える手間が大きそうだからと区分Cを飛ばすチームほど、後になって14件中12件の参考文献が存在しなかったと気付きます。追加の確認にかかるコストは、撤回や助成金の研究公正審査に比べればわずかです。」
— Jenova Product Team、学術ワークフロー向けAIリサーチエージェント設計
この助言は、出版社や大学の方針とも一致しています。ツール名、ツールが実施した作業を明示し、すべての参考文献について人間の著者が責任を負ってください。研究公正のガイダンスは、もはや「AIを避ける」ではありません。「情報源が存在するかどうかを外注しない」です。
AIを使って引用に安全な文献レビューを実施するには?
検索を最初、抽出を次、文章作成を最後に置き、どの文も通過を省略できない検証ゲートを備えたパイプラインとして実行してください。この順序を逆にし、先に論旨を下書きしてからアシスタントに「引用を追加して」と頼むことは、ゴースト参考文献と最も強く関連するプロンプトパターンです。
ジャーナルや助成金審査に耐えられるワークフローは次のとおりです。
- 検索前に採択基準を書く。 対象集団、介入、年、言語、研究デザインを定めます。ツールにメモリ機能がある場合、セッション間で基準が保持されるよう、その基準をアシスタントに渡します。
- 一つではなく二つの検索ツールで検索する。 例として、Jenova's Academic Research AssistantとElicitまたはSciSpaceを組み合わせます。ヒットの和集合を保持し、単一の順位付きリストを信用しません。
- 識別子を持つ候補セットを固定する。 タイトル、著者、年、掲載媒体、DOI/PMIDをエクスポートします。識別子がないものはセットの外で保留にします。
- 全文に対して要約ではなく抽出を行う。 手法、サンプル、アウトカム、限界、引用した文を記録します。Elicit形式のテーブルはここで役立ちます。コンテキスト幻覚が入り込むのはナラティブな要約です。
- 抽出テーブルから下書きを作成する。 文にテーブル上の行がないなら、その文に引用を付けてはいけません。そして、その文自体が論文に不要かもしれません。
- ツールを開示する。 Stanfordによるスタイルガイド規則のまとめに従い、ツール名、バージョン、日付、実施した機能(検索、抽出、言語編集)を記載します。
- 投稿する書誌リストに対し、最後にDOIを一括確認する。 この最終チェックで、コピー&ペーストによる逸脱や、改訂時にモデルが挿入した参考文献を捕捉できます。
Jenovaをチャットボットモードではなくパイプラインの中に留めるプロンプトは次のとおりです。
「私がアップロードした候補セットだけを使用して、背景セクションを下書きしてください。実証的な記述にはすべて、そのセット内のDOIを引用し、新しい情報源を導入してはいけません。主張が抽出メモで裏付けられない場合は、引用を付ける代わりにUNSUPPORTEDと明記してください。」
SciSpaceまたはElicitでは、それぞれのツールの検索または抽出ビューを使って同じテーブルを再構築し、行を比較してください。知見についてテーブル間で不一致がある場合は、PDFを読んでください。不一致を確認するコストは、出版後の訂正よりも低く済みます。
このパイプラインを機能させる制約は、技術的であると同時に心理的でもあります。どれほど優れたアシスタントであっても、情報源なしで書いた文章に対して「参考文献を補って」と頼んではいけません。そのプロンプトは、リサーチツールを再び引用生成器へ変えてしまいます。これは、このスタック全体が防ぐために設計された失敗モードです。
参考文献
- Nature — 幻覚による引用が科学文献を汚染している
- Accountability in Research(Resnik & Hosseini)— 生成AIが生み出す幻覚による引用
- Stanford Libraries — 学術研究におけるAI:引用ガイドライン
- ACM Digital Library — 検索拡張生成において正確性は忠実性ではない
- DeepEval — RAGシステムの忠実性指標
- Confident AI — RAG評価指標:回答の関連性、忠実性、コンテキストの関連性
- UNC Charlotte Library — AIによる幻覚引用の研究ガイド
- Wiley — 研究者向けAIガイドライン
- College Board — 学生のAI利用が学術的誠実性を損なうという教員の懸念
- Harvard Medical School Academic and Research Integrity — 研究におけるAI
- Cornell Center for Teaching Innovation — AIと学術的誠実性
- SciSpace — 200クエリによるSciSpace、Elicit、Consensusの文献検索ベンチマーク
- Paperguide — ElicitとSciSpaceの比較
- Paperguide — ElicitとSciteの比較
- Science — 見ずに引用する:AIが科学論文を幻覚するとき
- SciSpace — SciSpaceとElicitの製品比較