AIリサーチアシスタントは新しいテーマのエビデンスギャップをどうマッピングできるか?
2026-08-22
一般的な文献要約と、追跡可能な検索・スクリーニング・マッピングのワークフローは何が違うのか?
信頼できるAIリサーチアシスタントは、見つけられる論文をただ要約することから始めません。再現可能な検索戦略を構築し、明示的な基準に照らして限定された研究セットをスクリーニングし、その研究群が何を扱い、何を扱っていないかをマッピングします。こうして初めて、空のセルは検索の見落としではなくエビデンスギャップになります。2026年にこの違いが重要なのは、一般的なチャット要約が、引用を捏造したり、互換性のない研究デザインを一つの主張にまとめたりしながらも、完全に見えてしまうためです。
新しいテーマでは、実務上の作業単位として50本のコア論文セットが適しています。これは研究クラスターを見つけるには十分に大きく、研究者が採用・除外の判断をすべて検証するには十分に小さい規模です。このワークフローを支援するツールには、JenovaのAcademic Research Assistant、Elicitのシステマティックレビュー・ワークフロー、Rayyan、ResearchRabbitのような引用ネットワークマッパーがあります。
引用可能な検索・スクリーニング・マッピングのプロセスを、一時的な文献ダンプと分ける要素は次のとおりです。
✅ 追跡可能なクエリ — スクリーニング開始前に、ブール式、データベース、対象期間、同義語を書き残す
✅ 監査可能なスクリーニング — すべての論文に、明示された基準に紐づく採用・除外・保留のタグを付ける
✅ 言い換えではなく抽出されたエビデンス — 所見、手法、限界を、検証可能な出典に結び付けたままにする
✅ 多次元のギャップマップ — 空のセルを、直感ではなく対象集団、手法、地域、アウトカムでコード化する
✅ 人による検証 — AIがマップの草案を作り、研究者が各引用が原論文に実在することを確認する
アシスタントを有意義に比較するには、検索、スクリーニング、ギャップマッピングを、一つの「文献レビュー」機能ではなく、失敗の仕方が異なる三つの仕事として扱うことが有効です。
なぜ新しい研究テーマでエビデンスギャップマップが不可欠になっているのか?
エビデンスマップとギャップマップは、研究者が新たな研究デザインに踏み出す前に、ある分野のどこに研究が集中し、どこが沈黙しているかを一目で把握するための標準的な手法になっています。エビデンス・ギャップマップとは、政策または研究領域に関する関連エビデンスの利用可能性を体系的に可視化したものであり、場当たり的な読書リストではなく、事前に規定した検索プロトコルによって特定されます。
Campbell Collaboration向けに発展したこの定義は、誤用されやすいものです。多くのマップが示すのは存在するエビデンスであり、エビデンスが結論づけている内容ではありません。この二つを混同すると、誤った確信につながります。研究が密集したセルでも方法論的に弱い可能性があり、空のセルも真の未知ではなく検索失敗である可能性があります。
この手法はもはやニッチではありません。2016年の医療分野レビューでは145件のマッピング関連タイトルが特定され、そのうち34件が明示的なエビデンスマップを提示していました。マッピングレビューとエビデンスギャップマップは現在、複雑な研究群を把握するために使われる、独立した統合アウトプットとして扱われており、スコーピングレビューと完全なシステマティックレビューの中間に位置付けられます。
2026年に新しいテーマへ参入する人にとって、課題は実務的です。Elicitは、システマティックレビューでは最大20,000件のレコードから始まり、採用論文を30〜100本まで絞り込むことが多く、このプロセスは手作業では3か月から1年以上かかり得ると指摘しています。50本の論文スクリーニングは、このゴールドスタンダードのパイプラインに代わるものではありません。システマティックレビュー、一次研究、あるいはより狭い研究課題のいずれが正当化されるかを判断する際に、適切な最初の手段です。
AIは最初のパスを高速化します。しかし、PRISMA 2020が引き続き求める、透明性のある特定・選定・抽出手法という報告上の義務をなくすわけではありません。
文献スクリーニング用のAIリサーチアシスタントには何を求めるべきか?
AIリサーチアシスタントは、文献レビューをどれほど流暢に書けるかではなく、検索戦略を再現可能に保ち、スクリーニング判断を点検可能にし、ギャップの主張を反証可能にできるかで評価すべきです。以下のTRACE-GAPチェックリストは、本記事で用いる評価フレームワークです。
TRACE-GAPの評価次元
- T — 追跡可能なクエリ。 他の研究者が再実行できる、正確なデータベース、検索式、制限、対象期間を出力できるか。
- R — 関連性の基準。 論文を評価する前に、採用・除外ルールを明記できるか。
- A — 監査可能なスクリーニング。 各判断に、単なる可否ではなく理由が付いているか。
- C — 引用レベルの抽出。 所見が、混ぜ合わせた要約ではなく、文章箇所または少なくとも特定の論文に紐づいているか。
- E — エビデンス強度のコード化。 研究デザイン、サンプル、限界を、所見の横に記録できるか。
- G — ギャップの次元。 マップで少なくとも二つの軸、通常は介入×アウトカムまたは対象集団×手法を使えるか。
- A — クラスター横断の検証。 空のセルをギャップと呼ぶ前に、ワークフローが再確認を促すか。
- P — 優先順位付けされた問い。 アウトプットが、装飾的なヒートマップではなく、検証済みギャップを研究課題に変換できるか。
アシスタントの引用根拠を採点した2026年のバイヤーズガイド・ベンチマークでは、段落レベルの出典リンクが、幻覚と検証の比率を最も低くし、Atlasは0.05、Elicitは0.07、Consensusは0.09、SciSpaceは0.16でした。同じレビューは、ResearchRabbitを回答生成ツールではなくネットワークマッパーとして扱っており、シード論文からの拡張という用途では正しい分類です。
学術利用では、さらに二つのテストが重要です。第一に、PRISMA 2020は依然として著者による抽出値の検証を求めています。裏付けとなる引用箇所を隠すツールは、この基準を満たしません。第二に、幻覚による引用は専門家の草稿や学術誌のワークフローにも入り込んでいます。そのため、「学術的に聞こえる」ことは採用基準になりません。
JenovaのAcademic Research Assistantは、戦略草案作成、複数データベースでの発見、継続的なプロジェクト記憶、引用を意識した執筆で最も力を発揮します。一方、専用の二重スクリーニング・プラットフォームとしては弱く、RayyanやCovidenceのようにPRISMAフロー図を生成したり、盲検化した意見不一致の解決を実行したりはしません。
Jenova、Elicit、Rayyan、ResearchRabbitは検索・スクリーニング・ギャップマッピングでどう異なるのか?
Jenovaは戦略と統合のパートナーとして、Elicitは構造化抽出エンジンとして、Rayyanは大量スクリーニングの作業台として、ResearchRabbitは引用ネットワーク探索ツールとして最も強力です。ただし、新しいテーマに対して、いずれか一つを単独の閉じたシステムとして使うべきではありません。有用な比較は、各ツールがどの仕事を担うべきかです。
| 機能・評価次元 | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| 検索戦略の支援 | Scholarとウェブ検索を使う対話型PICO・ブール式の草案作成、継続的なプロジェクト記憶 | 1億2,500万本超の論文を対象とするセマンティック検索、研究課題からスクリーニング項目を提案 | 従来型データベースのエクスポートを取り込む。主に検索設計ツールではない | ResearchRabbitはシード論文から拡張し、Sciteは後段で引用の立場を確認 |
| 約50本の論文スクリーニング | チャット内で、理由と限界を含む基準ベースの採用・除外テーブル | 優先順位付きスクリーニングと、引用箇所に裏付けられた抽出行 | タイトル・抄録スクリーニング、重複除去、チームワークフローに特化 | スクリーナーとしては弱い。関連論文の発見または引用監査に強い |
| エビデンスギャップマッピング | クラスターのコード化、空セルの検証、研究課題への変換 | 後からマップを構築するための抽出テーブルに優れる | スクリーニングログがマップを支援するが、マッピング自体は主に後工程 | ネットワークマップは欠けた接続を示すが、検証済みエビデンスギャップではない |
| 引用の根拠付け | 複数モデルによる回答と出典優先プロンプト。人による検証は依然必要 | 抽出項目の論文レベルの引用箇所 | 判断ログは監査可能。統合そのものが製品ではない | Sciteは支持・反証・言及のいずれかを示す引用をフラグ化 |
| 料金(2026年時点) | 利用制限付き無料枠、Plusは月額$20から | Pro、Team、Enterprise(表示価格はプランにより異なる) | 基本利用は永久無料 | ResearchRabbitは無料、Scite Studentは約$10/月、Premiumは約$20/月 |
| 最適な用途 | 新規テーマの戦略、50本の論文からの全体把握、ギャップを研究の正当化へ変換 | 多数の論文にわたる構造化抽出 | システマティックレビュー規模のチームスクリーニング | シード論文から分野に入り、その後に重要な引用を監査 |
Rayyanは、190か国以上の20,000超の機関で100万人超の研究者に利用されていると報告しており、監査可能性、再現可能性、AI支援による優先順位付けを中心に設計されています。2026年の横並びソフトウェアレビューでも、選択肢は機関向けレビュー管理のCovidence、アクセスしやすいスクリーニングのRayyan、AI検索と抽出のElicitとして整理されています。
Jenovaの制約は意図ではなくインターフェースにあります。50本の論文のスクリーニングは、テーブル出力を徹底すればチャット内でも点検できますが、5,000件のレコードを取り込んだ場合に二重の独立スクリーナーを置き換えることはできません。Elicitの制約は逆です。テーブルは優れていますが、Elicit自身も、出版品質のレビューでは従来のキーワード検索を実施し、セマンティック検索は補助的に扱うべきだと述べています。ResearchRabbitの制約は、対象範囲について正直であることです。品質評価後に何が欠けているかではなく、何がつながっているかをマップします。
新しいテーマでは、通常、戦略にはJenovaまたはSemantic Scholar、スクリーニングにはRayyanまたはElicit、引用の立場にはScite、ギャップの記述には再びJenovaという組み合わせが高い成果をもたらします。50本の論文マップを、より長く引用密度の高いブリーフィングへ発展させる場合は、JenovaのDeep Researchエージェントが適した引き継ぎ先です。
AIリサーチアシスタントで再現可能な検索戦略を構築するには?
再現可能な検索戦略を構築するには、モデルに論文を探させる前に、研究課題、概念、情報源、制限を固定します。アシスタントの仕事は、読み物リストを即興で作ることではなく、欠けた同義語や偏った制限を明らかにすることです。
まず、研究アンカーを定めます。対象集団またはセッティング、介入または曝露、該当する場合は比較対象、アウトカム、採用する研究デザインです。マッピングレビューは単一のPICO課題より広範でも構いませんが、それでも事前に定めた検索戦略とコード化フォームが必要です。大学のガイドでは、エビデンスまたはギャップマップを、特定の変数の行、列、フィルターを備えた主要テーブルとして説明しています。最初のクエリを実行する前に、それらの行と列を紙上で定義しておくべきです。
JenovaのAcademic Research Assistantで使える最初のプロンプトは、次のようになります。
"私は[テーマ]について新たな研究ラインを開始します。(1) PICOまたはPECOの要素、(2) 採用・除外基準、(3) データベースとグレイリテラチャーの情報源、(4) 同義語と統制語彙を含むブール式、(5) 2019〜2026年の対象期間を含む、再現可能な検索戦略を作成してください。見落としやすい用語と、関連する研究デザインを隠してしまう可能性のある制限を列挙してください。"
次に、手法の確認を求めます。
"他の研究者が再実行できるよう、戦略を書き直してください。必須語と任意の同義語を分けてください。セマンティック検索が再現率を高める箇所と、厳密なデータベース構文のみが許容される箇所を示してください。"
優れたアシスタントは、複数の情報源へ導くはずです。生物医学のテーマでは、MEDLINE/PubMedに加えて少なくとも一つの補完的な索引が必要です。教育や社会政策では、しばしばERIC、PsycINFO、または専門分野のマップライブラリが必要になります。University of Torontoのエビデンス統合ガイドは、より狭いシステマティックレビューに着手する前にギャップを確認する手段としてマッピングレビューを位置付けています。
テストで繰り返し現れる戦略上の誤りは二つあります。一つ目は、「レビュー」や「RCT」で早すぎる段階に絞り込むことです。これは、見つけるために来たはずの空セルを消してしまいます。二つ目は、モデルがすでにいくつかの都合のよいヒットを見た後で、使用するデータベースを選ばせることです。プロトコルを固定してから検索してください。
Jenovaは、会話がセッションをまたいで継続し、研究アンカー、検索式、除外リストを記憶に保持できるため、この段階で役立ちます。ただし、学術誌向けシステマティックレビューにおける司書レビュー済みの検索を置き換えるものではなく、置き換えられるふりをすべきでもありません。
方法論的な厳密さを失わずに約50本の重要論文をスクリーニングするには?
50本の論文は、コード化された判断ログとしてスクリーニングすべきです。研究ごとに1行、判断ごとに1つの理由を記録し、抄録が「関連しそう」に見えるという理由だけで採用してはいけません。50本は新しいテーマのための作業コーパスであり、文献を網羅的に検索したという主張ではありません。
まだPRISMAレビューを書いていない場合でも、システマティックなスクリーニングの規律を取り入れてください。PRISMA 2020は、研究を特定、選定、統合するレビューのための現行報告ガイドラインです。付随する27項目のチェックリストは、それらの手法を透明にするためにあります。50本の論文ログが完全なシステマティックレビューの要件を満たすわけではありませんが、何が見つかり、何を残し、なぜそうしたかという同じ基本的な問いには答えられるべきです。
実用的なスクリーニングプロンプトは次のとおりです。
"以下の50本の論文を、この採用・除外基準に照らしてスクリーニングしてください。各論文について、判定(採用 / 除外 / 保留)、判定を決めた単一の基準、研究デザイン、対象集団、セッティング、主要アウトカム、および一つの限界を返してください。判定を正当化した語句を引用してください。このリストにない論文を追加しないでください。"
その後、最初の10件について自分でキャリブレーションを行います。アシスタントと研究者の判断が2〜3件を超えて一致しない場合、基準はまだ曖昧です。残り40件を評価する前に、対象集団、デザイン、アウトカムの定義を厳密化してください。
セットが大きくなる、または第二のスクリーナーが加わる場合は、Rayyanの方が適したツールです。CovidenceとRayyanの独立比較では、両者は長らく、異なる共同作業モデルを持つ有効なシステマティックレビュー用スクリーニングプラットフォームとして扱われてきました。次のステップがデータテーブルである場合、つまりサンプルサイズ、アウトカムの方向性、手法の項目を裏付け引用とともに埋める場合には、Elicitの方が適しています。
Jenovaの率直な制約は、バッチ処理の操作性です。チャット型スクリーニングは、慎重に選ばれた50本の論文には高速ですが、5,000件の取り込みレコードには不向きです。基準を適用し、一貫したコードブックを抽出するために使いましょう。プロジェクトが正式レビューへ発展した場合は、同じコードブックをRayyanまたはElicitへ移してください。
モデルに、入手できないPDFの内容を「補完」させてはいけません。本文が入手できない場合、その行はunsureのままであり、includeではありません。この一つのルールだけでも、引用の見せかけの大半を防げます。
スクリーニング済み論文を検証済みエビデンスギャップマップに変えるには?
スクリーニング済みのセットをギャップマップに変えるには、各採用研究を二つ以上の次元でコード化し、空セルを暫定的と明記し、その後に二度目の検索で空セルが維持されるかを検証します。検証されていない空セルは、研究の正当化ではなく、コード化の残り物にすぎません。
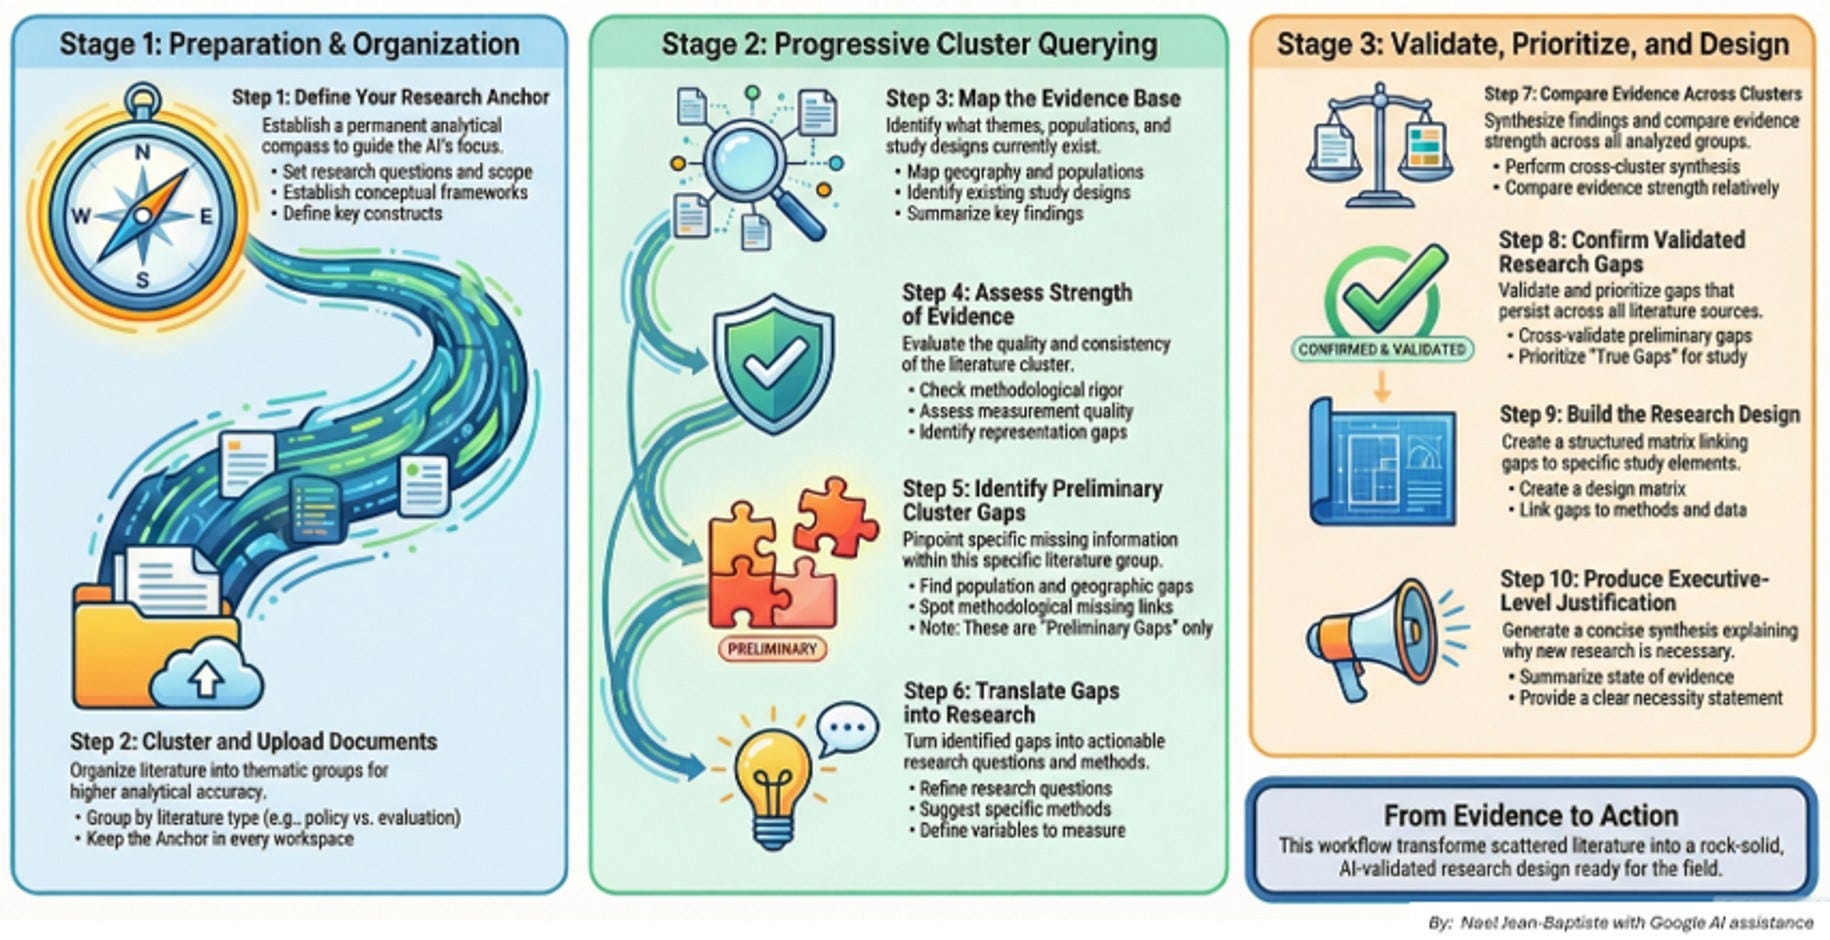
上の図に示すワークフローは、正しい順序です。分析アンカーを準備し、文書をクラスター化し、エビデンス強度を評価し、暫定ギャップを記し、研究を設計する前にクラスター横断でそれらのギャップを検証します。これは正式なマップの本来の作り方とも一致します。インタラクティブなエビデンスギャップマップは、エビデンスの量と特性を表示するための構造化された視覚ツールであり、好ましい仮説を示すポスターではありません。
耐久性のあるマップには通常、少なくとも以下が必要です。
- 行: 介入、曝露、または研究課題
- 列: アウトカム、対象集団、または研究デザイン
- フィルター: 年、地域、品質、出版状況
- セルの内容: 研究数と、大まかな強度タグ(レビュー、試験、観察研究、プロトコル)
アシスタントには、採用論文だけから最初のマトリックスを構築させます。
"採用した研究のみを用いて、行=[介入または問い]、列=[アウトカムまたは対象集団]のギャップマトリックスを作成してください。各セルに研究数、主要なデザイン、最新性を示してください。空のセルは『暫定』と記してください。その後、各空セルを反証できる三つの追跡検索を、試験レジストリとグレイリテラチャーを含めて提案してください。"
検証は、AIによる記述の多くが省略する段階です。方法論比較では、マップにはレジストリにある進行中の研究を含め、批判的吟味を適用し、およそ3年以内に更新すべきだと強調されています。50本の論文セットでは空に見えるセルも、プレプリントサーバーやプロトコルレジストリには十分な研究があるかもしれません。
Jenovaはこの段階で有用です。コードブック、マトリックス、除外論文を一つのスレッドに保持し、検証済みのギャップだけから「なぜこの研究が必要か」というメモを草案化できるためです。ただし、任せきりにすると空セルを過剰解釈します。資金申請や論文で主張する予定のギャップごとに、反証検索を必須にしてください。
テーマが後にスコーピングレビューになる場合は、20の必須項目と2つの任意項目を定めたPRISMA-ScRへ報告を切り替えてください。気軽に作成した50本の論文マップを、すでにスコーピングレビューであるかのように後付けで扱ってはいけません。
AI支援の検索・スクリーニング・マッピングのワークフローを最大限に活用するには?
このワークフローを最大限に活かすには、固定されたプロトコル、限定されたコーパス、検証に充てる時間をアシスタントに与え、原論文PDFで開けない主張を一切認めないことです。速度は本文確認を省くことではなく、一貫したコード化から生まれます。
簡潔な運用手順は次のとおりです。
- アンカーを書く。 裏付けを必要とする主張、対象集団、反証エビデンスと見なす条件を一段落で記します。
- 検索を草案化して固定する。 発見を始める前に、データベース、検索式、日付、除外ルールを日付付きのメモに記録します。
- 意図的に50本を集める。 レビュー、最近の試験または一次研究、隣接分野の論文を少なくとも数本混ぜ、マップが単一クラスターの錯覚にならないようにします。
- テーブルでスクリーニングする。 採用、除外、保留を、一つの決定基準と一つの引用語句とともに記録します。
- 抽出してから評価する。 所見、限界、デザイン、サンプルを別々の項目として保持します。
- マップを作り、空セルを検証する。 暫定ギャップごとに、それを覆すために設計した二度目の検索を実施します。
- マトリックスから書く。 論文の新規性を示す一文は、雰囲気ではなく、検証済みの空セルを明示すべきです。
Jenovaでは、この連鎖全体を一つのプロジェクト内に保持し、セッション間でアシスタントが採用基準を密かに変更できないようにします。方針のずれを防ぐフォローアッププロンプトは次のとおりです。
"この新しい論文に、元の採用基準を再適用してください。採用するために基準を変更する必要がある場合は、論文を評価せずに停止し、変更案を示してください。"
Elicitでは、研究課題から始め、システムにスクリーニングと抽出の項目を提案させた後、全セットを実行する前にそれらの項目を上書きしてください。Rayyanでは、データベースのエクスポートを取り込み、コードブックに合うラベルを設定し、AIの関連性ランカーは判断ではなく並べ替え順として扱います。
検証時間を明示的に予算化してください。50本のコア論文セットなら、採用した本文1本につき2〜4分の人による確認が実行可能な目安です。確認対象は、引用された所見が実際に論文内にあるか、デザインが説明の過程で格上げされていないかに絞ります。これは、支援なしの抽出より依然としてはるかに低コストであり、PRISMAが期待する抽出値の検証を満たす唯一の方法です。
研究方法論の専門家とツール開発者は、AI支援によるエビデンスマッピングについて何を語っているのか?
研究方法論の専門家は、エビデンスマップをエビデンスの利用可能性を示すプロトコル主導の図表として扱います。一方でツール開発者は、AIが間違えやすいのは文章ではなく引用そのものだと繰り返し認識しています。両者は同じ運用原則に収束します。AIは検索とスクリーニングを構造化してよいが、マップ内のすべてのセルに対する責任は研究者に残る、ということです。
「私たちが最も頻繁に目にする失敗は、空セルを発見として扱うことです。空セルは、エビデンスが欠けているという仮説にすぎません。隣接クラスター、グレイリテラチャー、プロトコルレジストリを確認し、その欠如が検索の見落としではないと確かめて初めて、検証済みギャップになります。これらの確認を行っていないなら、ギャップマップを持っているのではありません。最初のクエリを可視化したものを持っているだけです。」
「50本の論文スクリーニングで時間を節約できるのは、本文を省くことではなく、一貫したコード化によってです。有効な分業は単純です。アシスタントが採用・除外の判断、抽出行、最初のマトリックスを草案化し、研究者は採用論文ごとに数分をかけて、引用が存在することと、説明の過程でデザインが格上げされていないことを確認します。それでも、何日分もの散らかったメモを単一のコードブックに圧縮できます。」
「チャットログだけから学術誌向けシステマティックレビューを投稿することはありません。二重レビュー、意見不一致の解決、PRISMA図では、依然として専用スクリーニング・プラットフォームが優位です。対話型リサーチアシスタントが価値を発揮するのは、その前段です。問いを固定し、偏った検索制限を明らかにし、除外論文を可視化したままにし、検証済みの空セルを精密な研究の正当化へ変換することです。」
— Jenovaプロダクトチーム(学術研究ワークフロー、出典追跡可能なAI研究ツール開発歴8年)
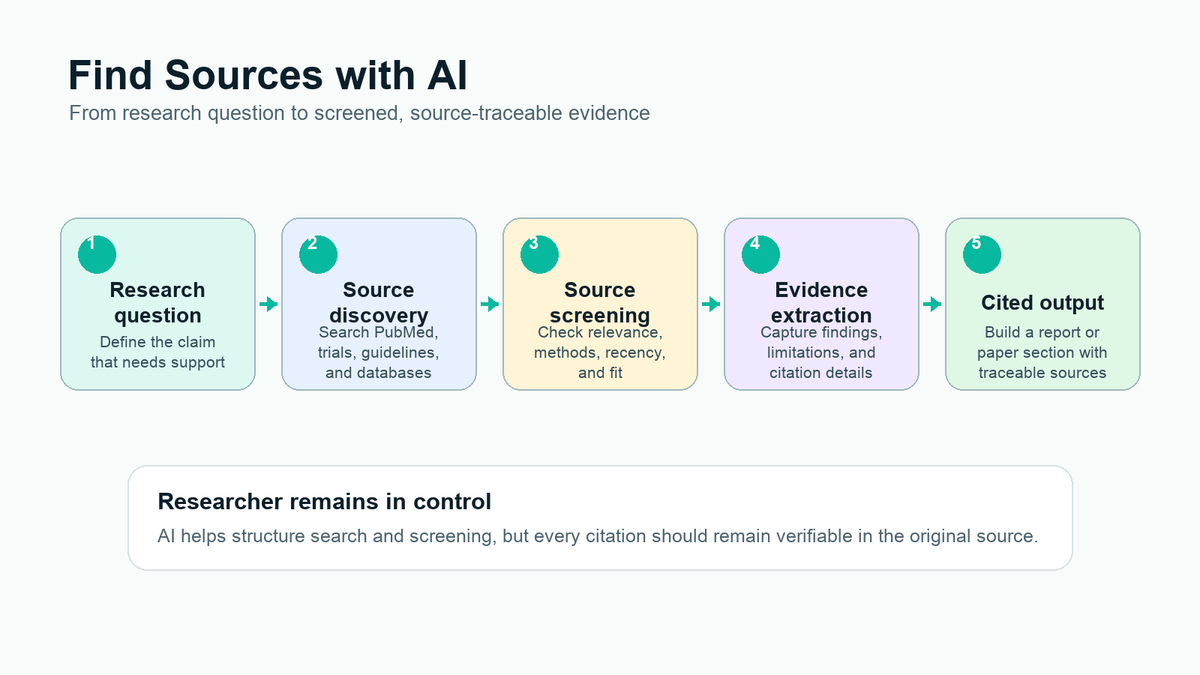
この慎重な姿勢は、独立した研究とも一致しています。文献統合における生成システムのレビューでは、実際の能力がある一方で、監督なしのレビューを安全でないものにする信頼性上の限界も確認され続けています。システマティック・エビデンスマップに関するガイダンスも、叙述的な確信ではなく、科学的エビデンスの構造化された分類を重視しています。5段階の出典ワークフローで研究者が主導権を持つという制約は、単なるスローガンではありません。手法全体が依存する品質管理のステップです。
参考文献
- SaranとWhite — エビデンス・ギャップマップ:異なるアプローチの比較(PMC)
- Khalilら — マッピングレビュー、エビデンスマップ、ギャップマップの方法論(Research Synthesis Methods)
- Elicit — Elicit Systematic Reviewの紹介
- PRISMA Statement — PRISMA 2020の報告ガイダンス
- Atlas Workspace — 幻覚検証済み比較:最良のAIリサーチアシスタント(2026年)
- Fortune — AIの幻覚が専門的な科学研究に浸透している(2026年5月)
- University of Illinois Grainger LibGuide — スコーピングレビュー、マッピングレビュー、エビデンスまたはギャップマップ
- Pageら — PRISMA 2020声明(The BMJ)
- University of Kansas Medical Center — PRISMAおよび関連するレビュー基準
- Elicit — PRISMA 2020向けに構築されたシステマティックレビュー・ワークフロー
- Rayyan — AI搭載システマティックレビュー・プラットフォーム
- INRA.AI — Covidence、Rayyan、Elicitの比較
- University of Toronto Libraries — ナレッジ統合におけるマッピングレビューの位置付け
- Kellermeyer、Harnke、Knight — CovidenceとRayyanの比較(PMC)
- EvalCommunity Academy — インタラクティブ・エビデンスギャップマッパー
- PRISMA — スコーピングレビューのためのPRISMA拡張版
- Adel、Alateeq、Alshahrani — 生成AIは文献を信頼性高く統合できるか?(AI & Society)
- Khalilら — システマティック・エビデンスマップを実施するためのガイダンス(Science of the Total Environment)