AIは学際的エビデンスを事実の混同なく統合できるか?
2026-08-21
学際的AI統合では、どの3つのエビデンス層を分野横断で分離すべきか?
AIが学際的エビデンスを信頼性高く統合するには、すべての主張を出典上の事実、著者の結論、モデル推論のいずれかとしてラベル付けし、それらの層がラベルのない一つの段落へと融合しないようにしなければなりません。2026年において、この区別こそが監査可能なリサーチブリーフと、暫定的な主張をもっともらしい権威へとロンダリングする流暢な要約を分けるものです。汎用チャットボットは依然として標準でこれらの層を混在させるため、書誌情報の捏造と引用誤りが依然として十分に記録されています。
JenovaのAcademic Research Assistantを含む目的特化型の研究エージェントは、実在する出典を取得し、帰属を保持し、モデル自身の論理的飛躍を可視化できる場合に、この作業でより強みを発揮します。ただし、これらはPRISMA登録済みのシステマティックレビューの代替ではありません。
プロベナンスを意識した統合と、ラベルのない言い換えを分ける主な要因は次のとおりです。
✅ 出典上の事実は、一次テキストで報告された測定値、手法、サンプルサイズ、観察結果です
✅ 著者の結論は、論文の著者が考察または要旨で導く解釈であり、独立した真実ではありません
✅ AI推論は、モデルが論文や分野を横断して追加する類推的・予測的・統合的な推論です
✅ 分野横断マッピングは明示的でなければなりません。ある分野で確立されたメカニズムが、別の分野では仮説にすぎないことが多いためです
✅ 抽出可能なすべての文は、簡単な監査に耐えるべきです。誰が、どの文書で、どの認識論的ステータスで、この主張を行ったのか?
この問題でツールを比較する際は、プロベナンスを書式設定の好みではなく、第一級の評価基準として扱ってください。本ガイドの以降では、この視点、すなわちFCI-TRACEフレームワークを用いて、統合システムが実際にどのように振る舞うかを評価します。
プロベナンスが崩壊すると、なぜ学際的AI統合は失敗するのか?
プロベナンスなしの学際的統合が失敗するのは、各分野でエビデンスの基準が共有されておらず、言語モデルはそれらの基準を保持するよりも、一貫した文章を生成するよう最適化されているためです。気候論文の実証結果、経済学者の因果識別に関する主張、臨床医の診療ガイドラインは、一つの文の中で文法的に結び付けられます。その文は、実際に測定されたのが一つの節だけであったとしても、確立済みの知識として読めてしまいます。
これは仮説上の失敗モードではありません。ChatGPT生成の文献レビューに関するScientific Reportsの研究では、GPT-3.5の引用の55%、GPT-4の引用の**18%が捏造であり、残る実在の引用のうち43%と24%**には実質的な書誌情報の誤りが含まれていることが判明しました。その後の報道では、生成ツールが公表論文における捏造引用の増加と関連付けられています。2026年の複数モデルを対象としたレビューでも、AI生成参考文献のほぼ40%に誤りまたは捏造があり、完全に正確なのは26.5%にすぎないとされています。
十分に索引化された科学文書以外では、ハルシネーション率はさらに急増します。MIT Sloanが要約したStanford HAIの評価では、2023年当時のモデルにおいて、汎用チャットボットは法律リサーチのクエリで**58~82%**の割合でハルシネーションを起こしました。法律、政策、臨床の領域は、学際的ブリーフが最も頻繁に求められる場面であり、ラベルのない推論が最も高いコストを生む場面でもあります。
より根深い問題は、出典ロンダリングです。考察セクションのヘッジ付きの節が、ヘッジなしで言い直され、あたかも結果であったかのように引用されます。プロベナンス基準は、その変換を阻止するために存在します。学際的研究では、主張のステータスが変わったことに読者が共有された手法から気付けないため、リスクが増幅されます。
AIエビデンス統合システムを評価するには、どの基準を使うべきか?
AIエビデンス統合システムは、どれだけ多くの論文に言及するかではなく、見解の不一致がある状況でもFCIの層を維持できるかで評価すべきです。出力を監査できないなら、流暢さ、速度、さらには再現率さえ二次的な要素です。ここで用いるFCI-TRACEフレームワークは、6つの次元を評価します。
FCI(認識論的ステータス)
- 事実: システムは、論文、節、図、表などのロケーターを添えて、結果を引用または緊密に言い換えられるか?
- 結論: 解釈を特定の著者に帰属させ、ヘッジ表現を維持しているか?
- 推論: 類推的または統合的なステップをモデル生成として明示しているか?
TRACE(統合の品質)
- 追跡可能性: 各主張が論文タイトルだけでなく、出典内の該当箇所に対応付けられている。
- 最新性: システムがプレプリント日、出版日、ガイドライン更新日を区別している。これは非AIの書誌ツールでも既知の失敗であり、Walters and Wilderの研究で文書化されたChatGPTの誤りモードでもあります。
- 一致度: 収束する結果と矛盾する結果が、偽のコンセンサスに平均化されるのではなく、表に整理されている。
- 網羅性: 問いが分野横断型である場合、少なくとも2つの学問分野の手法が表現されている。
- 認識論的ラベル付け: ステータスタグが脚注に隠されず、本文中で可視化されている。
これは、検索と要約で終わりがちな汎用的な「文献レビューのためのAI」チェックリストよりも厳格です。大学のガイドは現在、論文を要約し、構造化表にデータを抽出するツールを取り上げ、システマティックレビューのチームは半自動スクリーニングと完全自動スクリーニングを区別しています。これらの能力は重要です。しかし、それだけで著者の結論が事実として書き換えられるのを防ぐことはできません。
プロトコルの透明性も評価に含めるべきです。PRISMA 2020は、統合を含むシステマティックレビューのための27項目の報告チェックリストであり、EQUATOR Networkを通じて解説論文とともに維持されています。チャットボットのセッションはPRISMAレビューではありません。それでも、防御可能なAIワークフローは、適格性の論理、検索した情報源、モデルが追加した内容を報告すべきです。
主要なAI研究ツールは、事実、著者の主張、モデル推論をどのように扱うか?
主要ツールは明確な線で分かれます。論文に根拠を置く抽出ツールは捏造を減らす一方、汎用チャットモデルは流暢でも帰属が弱く、生成文章内でFCIラベルをネイティブに強制するものはほぼありません。以下の比較は、総合的な人気ではなく、認識論的衛生に関するものです。
| 機能 / 評価軸 | 汎用ChatGPT | Elicit | Jenova Academic Research Assistant | Scite(引用コンテキスト) |
|---|---|---|---|---|
| 根拠コーパス | 学習データに任意のブラウジングを追加。引用は未検証であることが多い | 1億2,500万本の論文、200万人以上の研究者が利用する検索、要約、抽出 | ライブの学術・Web検索、添付ファイル、永続的なセッションメモリ | 論文がどのように引用されているかを示す引用グラフと支持・反証コンテキスト |
| 出力内のFCIラベル | 通常はラベルなし。事実、考察上の主張、モデルの飛躍が同じ語り口を共有 | 文レベルの認識論的タグより、論文レベルの抽出に強い | FCI層にタグを付け、セッションをまたいでプロトコルを維持するよう指示できる | 統合内の主張タイプよりも、引用スタンスをラベル付け |
| 学際的統合 | 高い流暢さ、分野横断では弱い監査証跡 | 実証研究の問いと構造化抽出に最も強い | 数日間にわたり、手法プロトコルと分野別の追加調査が必要な場合に最も強い | 統合ツールとしては限定的。引用コンテキストの視点としてより強い |
| 引用検証 | 体系的テストで高い捏造率と誤り率 | 論文に根拠を置く行により、架空の参考文献を減らす | 検索と帰属を組み合わせるが、人間による抜き取り確認は依然必要 | 後続論文が主張を支持するか反証するかについてネイティブなコンテキストを提供 |
| スクリーニング / 抽出 | 非構造化 | システマティックレビュー向けのスクリーニングとデータ抽出を自動化 | 反復的な探索と原稿支援。専用スクリーニングUIではない | スクリーニング用ワークベンチではない |
| 料金(2026年時点) | サブスクリプション。正確な個人向けプランはここでは未検証 | 本レビューでは未検証 | 使用量が限られた無料プラン、Plusは月額$20(使用量30×) | 本レビューでは未検証 |
| 最適な用途 | 出典がすでに手元にある場合の草稿作成 | 実証論文からの列形式の抽出 | FCI層を可視化して維持する必要がある、複数セッション・複数出典のブリーフ | 後続文献で主張がどのように扱われているかの確認 |
Elicit。 製品の対象範囲を検討すると、これはチャットボットではなく研究ワークベンチです。利用者は質問を提示し、論文を取得し、項目を抽出します。2026年の独立した比較では、Elicitは文献探索、スクリーニング、データ抽出に強いとされる一方、Consensusはイエス・ノーで答える科学的な質問に強いと説明されています。この抽出能力は実在する強みです。その一方で制約もあります。利用者が発見と解釈を分ける列を定義しない限り、入力済みの表でも要旨の因果動詞を結果であるかのように提示できます。
ConsensusとSemantic Scholar。 Consensusは、完全なレビュー・パイプラインではなく、実在する論文を対象とした回答エンジンとして繰り返し位置付けられています(The Drive AI)。2026年のあるまとめでは、Consensusの入門価格は年間約$144とされていました。Semantic Scholarは、同じ比較において探索の中核であり続けています。ここで検討した公開説明によれば、どちらのツールにも事実と推論を区別する必須のオーバーレイは搭載されていません。
Scite。 Sciteは、問いが「二つの分野をどう統合するか」ではなく「ある論文がどのように引用されているか」である場合に、より適しています。比較では、Elicitのより広範なレビュー・ワークフローに対する引用コンテキストの専門ツールとして扱われています(Paperguide、2026年)。支持と反証を示す引用ラベルは価値がありますが、FCIとは依然として別物です。後続論文は、そもそも事実ではなかった著者の結論を「支持」することがあり得ます。
汎用ChatGPT。 依然として、監督なしの統合における誤った標準選択です。GPT-4で改善された18%の捏造率であっても、引用の厳密さが求められる作業には適合しません。また、実在する参考文献の中でも、巻、ページ、年といった数値の引用項目が最も頻繁に誤ります。図書館のガイダンスでは現在、ハルシネーションによる引用をそれ自体が研究公正性のテーマとして扱っています。
Jenova Academic Research Assistant。 このエージェントは、一回限りの要約ではなく、文献探索、原稿支援、引用管理を必要とする研究者や博士課程学生向けに構築されています。Jenovaプラットフォームでは、学術検索を使用し、無制限のチャット履歴を保持し、手法プロトコルを永続メモリに保存できるため、FCIルールがセッションごとにリセットされません。Deep Researchと組み合わせると、幅広く検索して引用密度の高いレポートを返すため、複数回の作業にまたがる学際的な問いに適しています。
率直な制約も重要です。これはCovidence、DistillerSR、Rayyanではありません。専用のPRISMAフローダイアグラム用ワークベンチも、Elicitが訴求する規模の1億2,500万論文に対応するネイティブな抽出グリッドもありません。高リスクな採択判断と統計的プーリングは、依然として人間のレビュアーが担うべきです。深さにおける優位性は、自動化された確実性ではなく、プロトコルの持続性と明示的なラベル付けです。
ナレッジオーケストレーションは、分野ごとのエビデンスが一つの物語に崩壊するのをどう防ぐか?
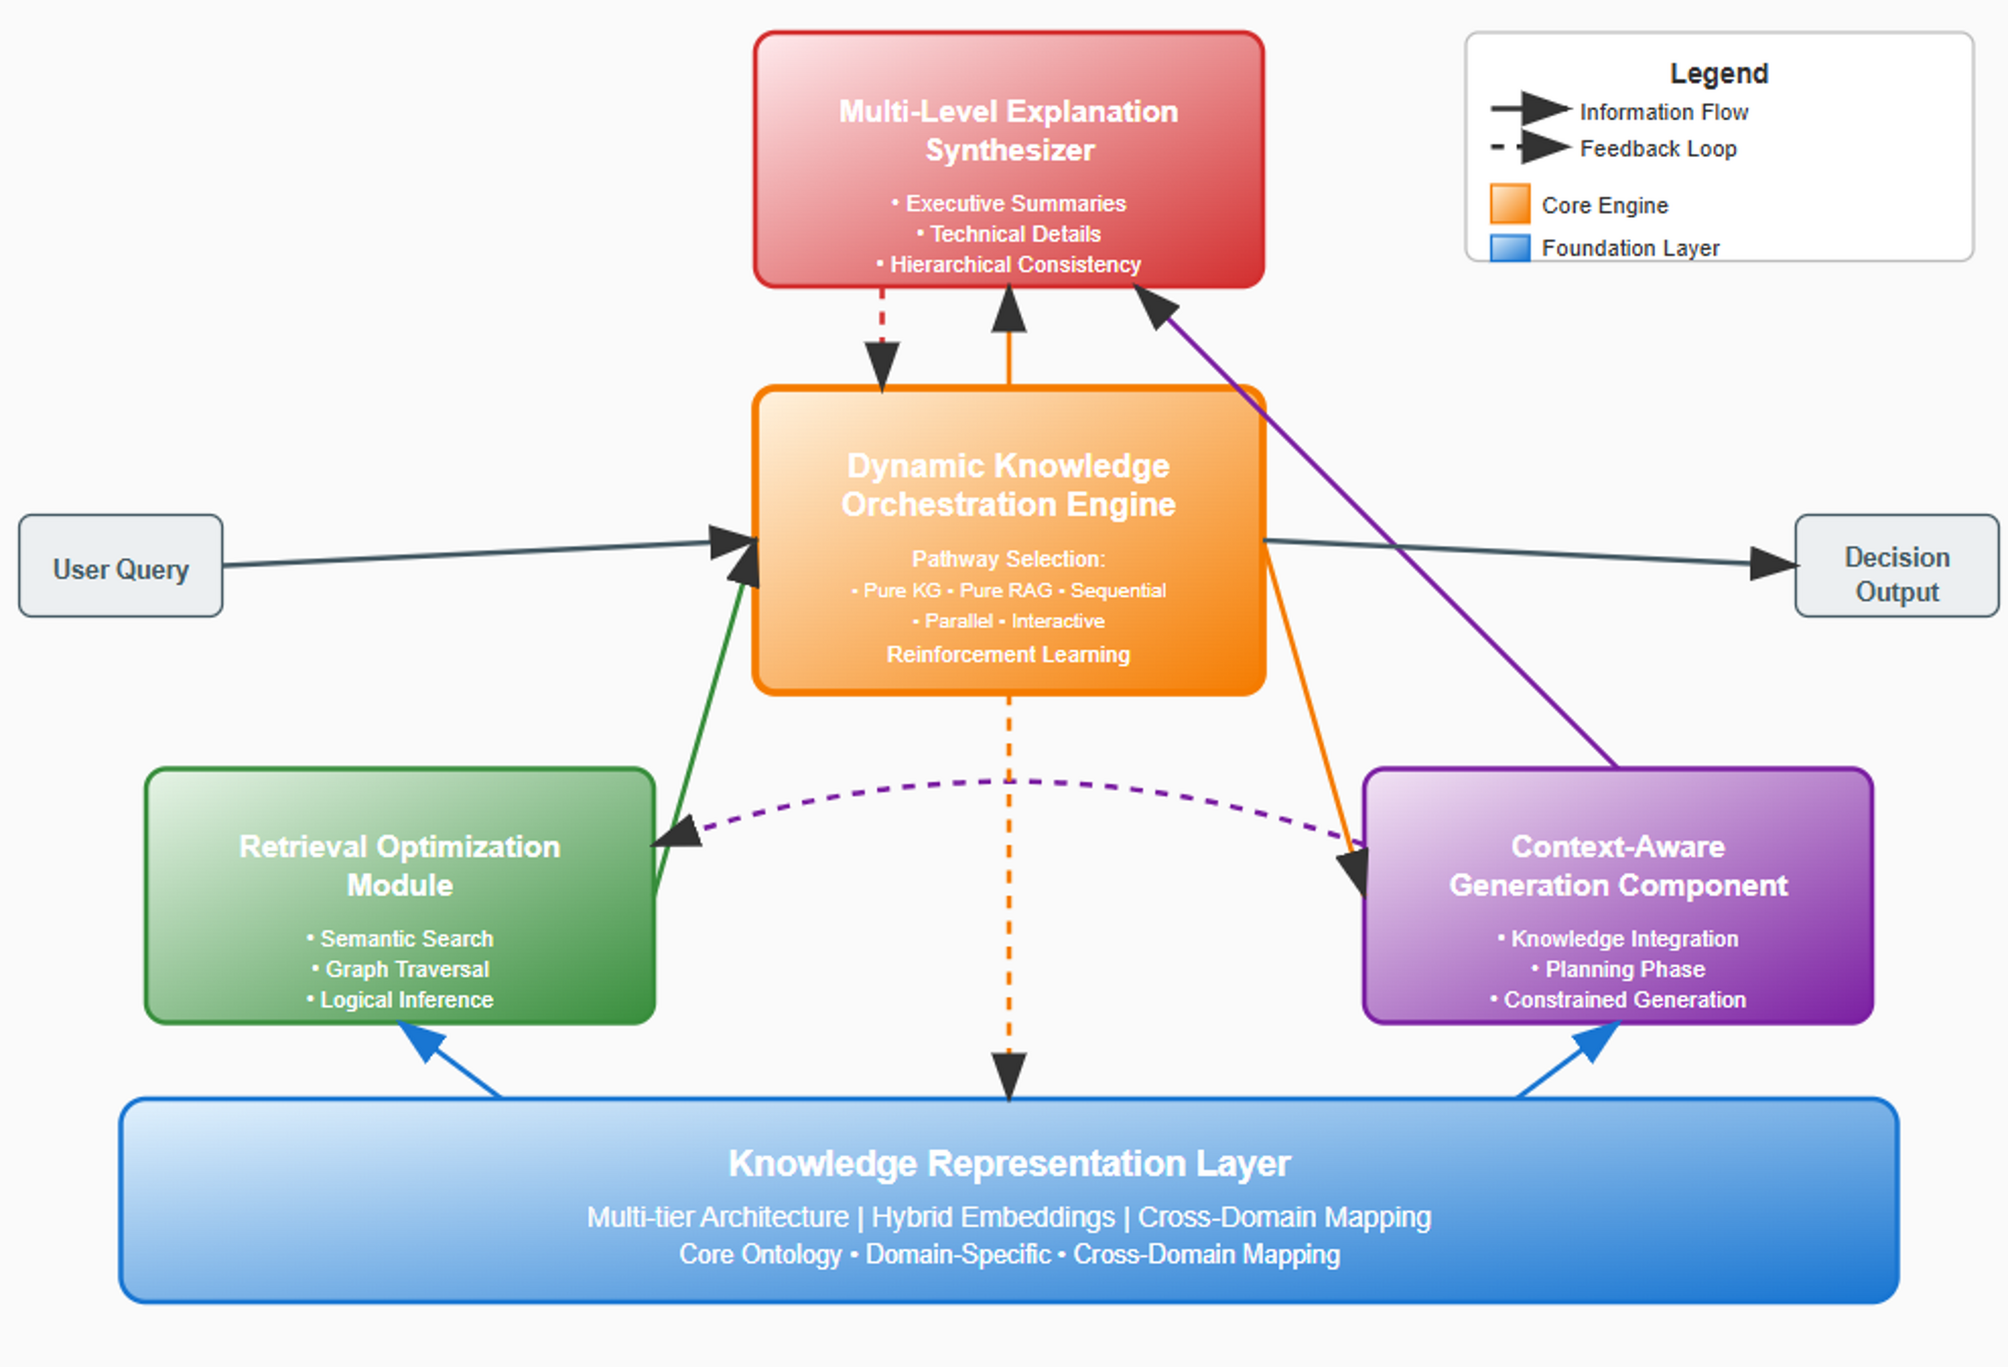
ナレッジオーケストレーションは、生成の前に検索経路を選択し、取得された内容と階層的に整合するよう説明を強制することで、分野ごとのエビデンスを保全します。典型的なオーケストレーション・スタックを検討すると、学際的な作業で「取得してから書く」だけでは不十分な理由が分かります。
基盤となるのは、知識表現層です。ここにはハイブリッド埋め込み、ドメイン・オントロジー、分野横断マッピングが含まれます。この層がなければ、モデルは気候物理学における「不確実性」、計量経済学における「不確実性」、臨床ガイドラインにおける「不確実性」を同じトークン近傍として扱います。しかし、これらは同じではありません。分野間で用語を対応付けることは推論ステップであり、そのようにラベル付けすべきです。
その上位で、検索最適化モジュールがセマンティック検索、グラフ走査、論理推論を組み合わせます。問いが関係的なものである場合、グラフ走査は重要です(生態学のメカニズムAは、公衆衛生のメカニズムBに類推できるか?)。セマンティック検索だけでは類似した言語を返すにすぎず、共有された因果構造を証明しません。抽出された主張に対する論理推論は、解釈可能な主張検証のために設計されたエビデンス推論ネットワークにより近いものです。
続いて、オーケストレーション・エンジンは、常にチャンクをプロンプトへ投入するのではなく、ナレッジグラフのみ、RAGのみ、逐次、並列、対話型といった経路を選択します。二つの分野をマッピングする前に独立して収集すべき場合、並列検索が適切です。ある分野のアウトカム尺度が次のクエリを制約すべき場合、逐次検索が適切です。これらのモードを明示せずに混合すると、気候と健康に関するブリーフが、いつの間にか政策提言へと変わってしまいます。
コンテキスト認識型生成の段階では、制約の下で計画すべきです。出典が因果動詞を使用していないなら生成しないこと、サンプルフレームを統合しないことです。最後の多層説明統合器の段階でFCIが可視化されます。つまり、エグゼクティブサマリー、技術的詳細、そしてサマリーがエビデンスを追い越さないための整合性チェックです。PaperTrailのような、現在の研究における主張とエビデンスのインターフェースも同じ方向を示しています。学術的な環境での信頼性は、より滑らかな文章ではなく、主張をエビデンスに対応付けることに依存します。
JenovaのAcademic Research Assistantは、すべての内部ルーティング設定を研究者向けのコントロールとして公開しているわけではありません。完全に検査可能なDAGを必要とするチームにとっては、これは実際の制約です。ただし、多くの学術ワークフローにとって実用的に同等なものは提供します。すなわち、永続的な指示、添付コーパス、ライブ検索、そしてエビデンスの蓄積中もラベル付けプロトコルを安定させるのに十分なメモリです。
セマンティック引用パイプラインは、統合に入る前に主張をどのように検証するか?
セマンティック引用パイプラインは、各引用を段落末尾の書式付き装飾ではなく、出典文書と照合すべき仮説として扱うことで、主張を検証します。このステップを省略すると、学際的統合は生成器が生んだすべての架空または変質した参考文献を引き継いでしまいます。
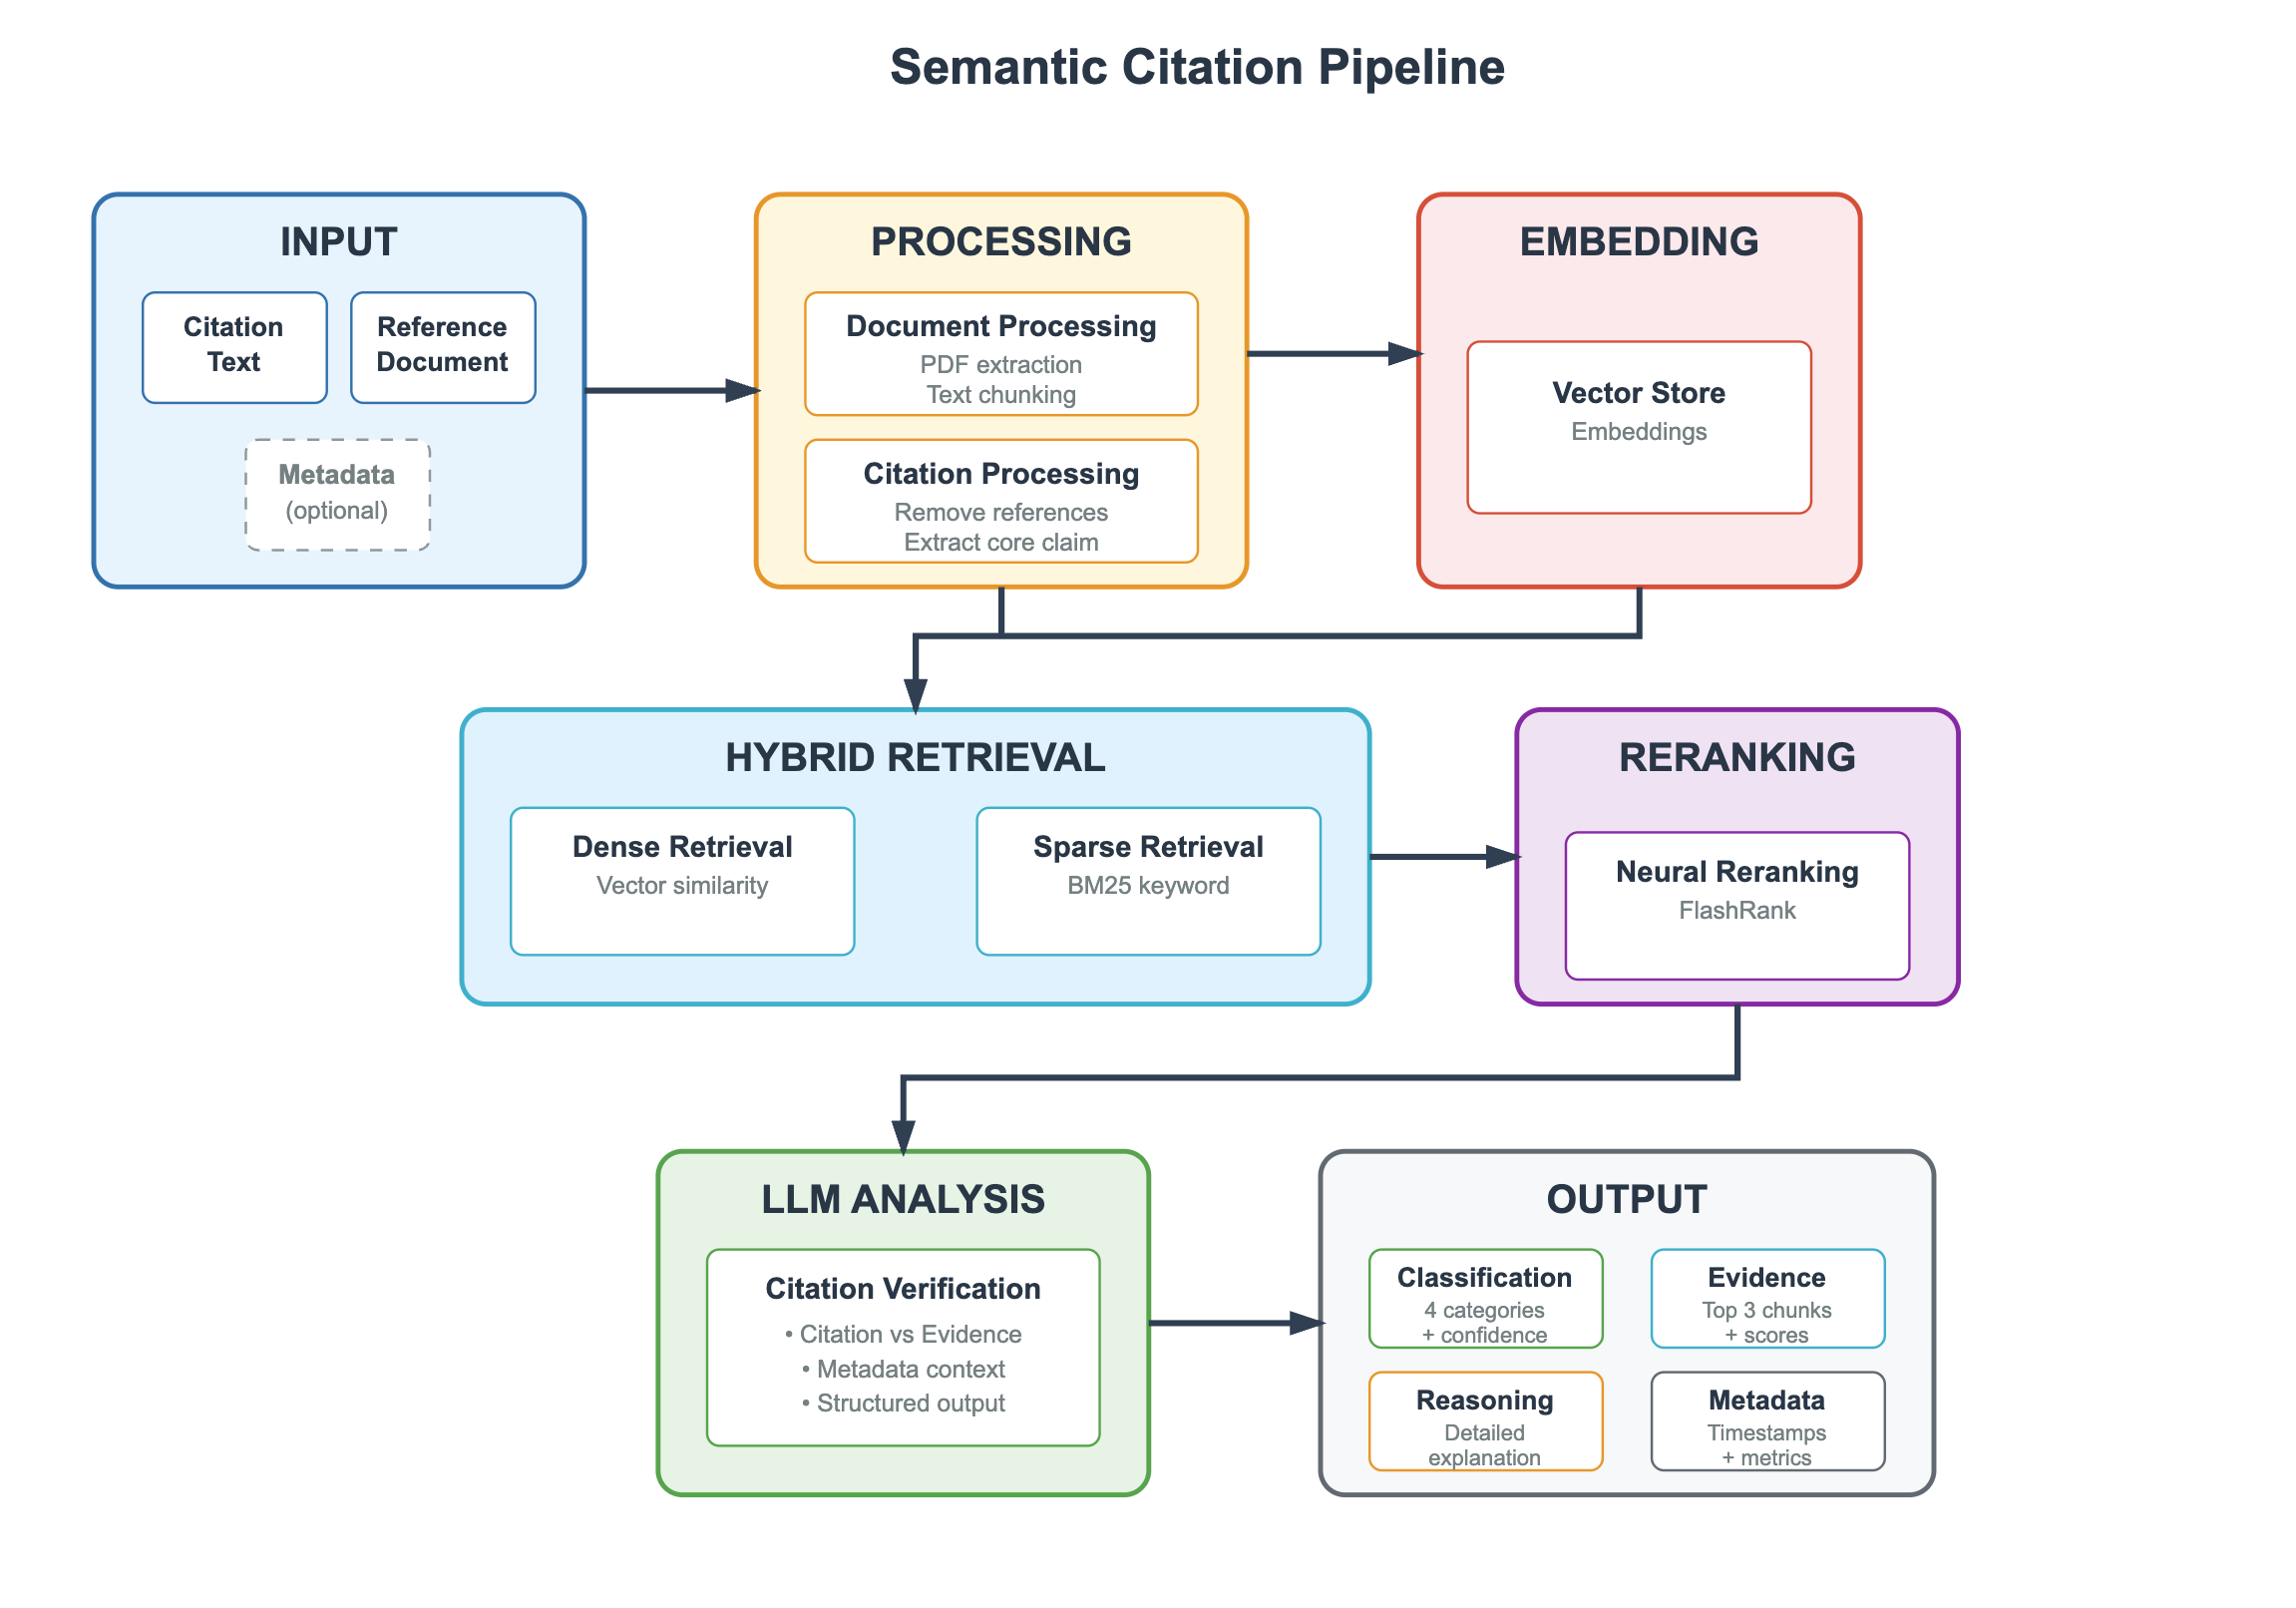
本番運用を想定したパイプラインを検討すると、固定された順序が見えてきます。入力は、引用テキスト、参照文書、任意のメタデータです。処理では、PDFテキストを抽出し、チャンク化し、モデルが参考文献一覧を読んで主張を「検証」できないよう参考文献リストを除去し、核となる主張を分離します。埋め込みでは、それらのチャンクを保存します。次にハイブリッド検索が密なベクトル検索と疎なBM25を並列で実行します。学問分野の専門用語や統計的記法は、純粋な埋め込み検索では失敗しやすいため、これは必要です。ニューラル再ランキングでは、たとえばFlashRankを用いて上位の該当箇所を保持します。その後にのみ、LLM分析が主張とエビデンスの関係を分類します。
統合エージェントが取り込むべき有用な出力は、単なる二値の合否ではありません。支持、反証、未言及、部分的対応という4分類に信頼度を加え、上位のエビデンス箇所と文章による根拠を添えたものです。このパターンは、説明可能でエビデンス水準の主張検証に向かうより広い動きと一致します。また、大学の教育部門が物語を捏造するのではなくエビデンスを抽出するAIアシスタントを説明する際に、すでに推奨している内容とも一致します。
パイプラインがあっても、二つの失敗モードは残ります。第一に、分類器が節のコンテキスト(結果か考察か)を無視すれば、正しく引用された著者の結論であっても事実として誤分類される可能性があります。第二に、ハイブリッド検索は同じ分野の別論文から非常に似た文を見つけることがあります。これは言い換えによる引用ドリフトです。したがって、上位の該当箇所を人間がレビューすることは、敗北の告白ではなく手法の一部です。
Jenovaのワークフローでは、主張を統合メモに入れる前に引用とロケーターの提示を必須にし、その後、同じ参考文献一覧に対してDeep Researchを第二パスとして実行することで、このパイプラインを近似できます。ただし、固定された評価指標を持つ専用の引用検証サービスを置き換えるものではありません。学位論文の章や学術誌への投稿では、エビデンス表をエクスポートして検査してください。
AI研究エージェントに、事実・結論・推論を分離するよう指示するには?
エージェントには、ラベルを定義し、主張ステータスの暗黙の格上げを禁止し、分野横断の物語を作る前に矛盾表を求める常設プロトコルを与えます。ツール選択も重要ですが、ラベルのないプロンプトでは、どのプラットフォームでもFCIは崩壊します。
JenovaのAcademic Research Assistantでは、持続性のあるセットアップは次のようになります。
- jenova.ai/a/academic-research-assistant でエージェントを開き、研究課題、対象分野、対象期間を示します。
- 常設のFCIプロトコルを貼り付けます(同じルールをセッション間で適用する場合は、カスタム指示に保存します)。
「作業プロトコル:すべての文に[事実]、[著者の結論]、または[AI推論]のラベルを付けること。事実には出典ロケーターが必要です。著者の結論では論文名を示し、ヘッジ表現を維持してください。AI推論には、出典が述べていない分野横断マッピング、因果的飛躍、提言をすべて含めます。エビデンスが矛盾する場合、平均化しないでください。次の表を作成してください:主張 | 層 | 出典 | ロケーター | 一致度(支持 / 反証 / 不在)。」
- コーパスを用意します。すでに信頼しているPDFを添付し、最初の検索に分野を規定させるのではなく、その後で追加の探索を依頼します。
- 層構造のある成果物を必須にします。注釈付き参考文献、FCIタグ付きの知見、そして新しい事実を導入できない短い統合です。
通常、利用可能な構造を生み出す初回プロンプトは次のとおりです。
「質問:2015年以降、高所得国の都市において、都市ヒートアイランドの強度、住宅の質、心血管疾患による救急入院はどのように関連するか? 分野:気候学、疫学、都市経済学。出力:(1)出典マップ、(2)FCIタグ付きの知見、(3)矛盾ログ、(4)最後に列挙し、未検証と明記したAI推論。取得していないものは一切引用しないこと。」
Elicitでは、同等の規律は文章ラベルではなく列の設計にあります。ツールの質問から抽出へ進むワークフローに従い、報告された結果、著者の解釈、対象集団、特定された限界について個別の抽出フィールドを作成してください。単一の「主な知見」列は使用しないでください。その列こそが、考察の動詞が結果へと格上げされる場所です。
汎用チャットボットの場合は、Natureの研究が必要性を示唆する敵対的チェックを追加してください。まず引用文を要求し、その後で図書館データベースにより各参考文献を独立して照合します。同じモデルに「この引用は実在するか」と尋ねても、信頼できません。プロジェクトがシステマティックレビューである場合、採択判断にはエビデンス統合の図書館ガイダンスで説明されているスクリーニングツールを使い、適格性判定からチャットボットを外してください。
参考文献一覧が大きく、引用密度の高い第二パスが必要な場合は、JenovaのDeep Researchがより適したフォローアップです。最初のラベルなしの一括検索としてではなく、FCIルールを整備した後に使用してください。
研究方法論者はAIエビデンスのプロベナンスについて何を述べているか?
研究方法論者は、ラベルのないAI統合を生産性向上ではなく報告上の失敗と捉えています。読者が文の属する層を確認できないなら、その文書はまだエビデンスではありません。この見方は、透明性のある統合を求めるPRISMAの要求や、捏造参考文献をエビデンス記録への脅威として扱う引用公正性研究と一致します。
「私たちが目にする失敗モードは、モデルが論文を読めないことではありません。モデルが単一の認識論的な声で書くことです。手法上の数値、考察セクションのヘッジ付きの節、分野横断の類推が、同じ確信度の英語としてモデルから出力されます。すると学際的な委員会は、本来なら層について議論すべきところを結論について議論します。ある文が『誰がこれを主張し、それは測定されたのか、推論されたのか』に答えられないなら、結果ブリーフに入れるべきではありません。」
「FCIラベル付けは、事後的な撤回よりも低コストです。統合前にロケーターを強制するチームは、第一パスにより時間をかけますが、引用ドリフトを解きほぐす時間は大幅に減らせます。NatureのChatGPT研究は今も警告すべきベースラインです。捏造率が大きく低下しても、残存する誤り率は参考文献一覧では許容できません。プロベナンスが制御システムです。流暢さではありません。」
「オーケストレーションと引用検証パイプラインは、その基準を運用に落とし込む方法です。構成概念を共有しない分野は並列で取得してください。主張が統合器に届く前に、チャンクに対して検証してください。モデルの統合ステップは、別の名前付きブロックに保持してください。このアーキテクチャはチャットボットの要約より保守的です。それが目的です。」
— Jenova Product Team、AI研究エージェント設計、学術・専門職ユーザー向けの検索・帰属ワークフロー構築における8年の経験
ツール選択における含意は限定的です。プロトコルを維持し、出典を示し、矛盾を許容できるシステムを優先してください。単に学際的に聞こえるシステムを優先してはなりません。
どのような場合に、人間によるレビューは分野横断のAI統合を上書きすべきか?
主張が意思決定を変える場合、分野ごとの手法の境界をまたぐ場合、またはロケーターまで追跡できない場合には、人間によるレビューがAI統合を上書きすべきです。これは、そもそも統合を正当化する作業の大半に当たります。AIは草稿作成と検索の増幅器であり、認識論的権威ではありません。
少なくとも次の5つの条件では、上書きは譲れません。
- 因果表現が統合文には現れるものの、引用された研究の結果セクションには現れない。
- 構成概念の不一致が起こり得る(たとえば、心理学の「ストレス」、医学の「アロスタティック負荷」、経済学の「ボラティリティ」)。
- ガイドラインまたは法律が関与する。法的クエリにおけるハルシネーション率は、統制されたテストで特に高いことが示されています。
- 統計的プーリングが示唆されている。言語モデルは、要旨を言い換えるだけで防御可能なメタ分析を実施することはできず、PRISMA 2020はまさに統合を含むレビューのために存在します。
- 引用検証がPDFに対して実行されていない。2026年になっても、架空または変質した参考文献は依然として十分に多く、学術誌と図書館はそれを公正性の問題として扱っています。
実務的な役割分担は次のようになります。Academic Research Assistantが出典マップ、FCIタグ、矛盾ログを提案します。コーパスが正式なレビューである場合、Elicitまたはスクリーニングツールが構造化抽出を担います。人間の方法論者が層の格上げとすべての分野横断推論を裁定します。AIはマッピングを提案してもよいですが、それを格上げできるのは人間だけです。
このように用いるなら、AI統合は学際的判断の代替ではありません。事実、著者の結論、モデル推論を、検査可能な別々のストリームに保ち、判断が誠実に扱えるものを提供する方法です。
参考文献
- Rules Integrity Initiative — プロベナンスと出典ロンダリング
- Walters & Wilder、Scientific Reports — ChatGPTが生成した書誌引用における捏造と誤り
- Forbes — 研究論文で増加する捏造引用の原因としてAIを指摘(2026年)
- Enago — 研究引用におけるAIハルシネーション(2026年)
- MIT Sloan — Stanford HAIの法律クエリ率を含む、AIハルシネーションとバイアスへの対処
- George Mason University Libraries — 文献レビューのためのAIツール
- King's College London — エビデンス統合におけるAIツール
- PRISMA 2020声明
- Pageら、The BMJ — PRISMA 2020声明
- EQUATOR Network — PRISMA報告ガイドライン
- Elicit — 科学研究のためのAI
- Paperguide — ElicitとSciteの比較(2026年)
- PapersFlow — ElicitとConsensus AI
- The Drive AI — Elicit、Consensus、Semantic Scholarの比較
- Omid Saffari — 2026年の優れたAI研究ツール
- UNC Charlotte Library — AIによるハルシネーション引用
- Wuら、AAAI — 解釈可能な主張検証のためのエビデンス推論ネットワーク
- PaperTrail — 学術LLM出力の根拠付けのための主張・エビデンスインターフェース(arXiv)
- Zhangら、EACL — マルチモーダルかつ説明可能な主張検証
- University of Iowa — AI支援による文献レビュー