AIはどのようにエビデンスを見つけ、査読者への回答を下書きできるのか?
2026-08-22
エビデンスに基づく回答ツールと汎用AI下書きツールは何が違うのか?
2026年に著者が査読者へ適切に回答するために役立つツールは、最も滑らかな文章を書くツールではありません。各査読コメントを引用可能な根拠に対応付け、その根拠が実際に主張を裏付けているかを確認し、記録が許容する以上に強くならない表現で返信を下書きするツールです。Jenova's Academic Research Assistantは、文献探索、引用管理、原稿に基づく下書きという、根拠を最優先するループのために構築されています。一方、Scite、Elicit、SciSpace、Consensusは、それぞれ異なる強みで同じ業務の一部を担います。
使えるAI反論ワークフローと、流暢だが危険なワークフローを分ける要素は次のとおりです。
✅ レター全体に対する一括の文献リストではなく、コメント単位での検索 ✅ 書誌情報だけでなく、情報源の該当文を開いて確認する引用チェック ✅ すべての主張に対する根拠ラベル――支持あり、部分的に支持、矛盾、不確実 ✅ 「示唆する」を「実証する」へと強めず、ラベルに見合う慎重な下書き ✅ AIが提案した文を却下、限定、削除できる人間による確認
111か国、約1,600人の研究者を対象としたFrontiersの調査に関する2026年のNature報告では、半数を超える研究者がすでに査読時にAIを利用していることが示されました。現在、同じ圧力は回答書を作成する著者にもかかっています。ツールを有用に比較するには、エビデンスの発見、引用の検証、主張の調整を、単一の執筆作業ではなく3つの別個の仕事として扱う必要があります。
引用が未検証だと、なぜ査読者への回答書は失敗するのか?
改訂が失敗したり遅延したりする主な理由は、著者が無礼だったからではありません。引用がレターの主張どおりの内容を述べていない、約束した分析が原稿に存在しない、あるいは論文が弱くしか裏付けていない発見を返信で過大に述べているからです。編集者や査読者は、こうした不一致を数分で確認できます。
汎用モデルは、この失敗を防ぐどころか、起こしやすくします。大学のガイダンスは明確です。AIシステムは、実在するように見えて実際には存在しない引用を頻繁に捏造します。捏造した参考文献の提出は、学術不正として扱われます。ステレンボッシュ大学の責任ある利用に関するガイダンスも、多くのツールはライブデータベースに対して参考文献をリアルタイムで検証できないと指摘しています。回答書は、この教訓を学ぶには高リスクな場所です。新しい引用を加えるたびに、情報源が存在し、今書いた正確な文を支持しているという暗黙の約束をすることになるからです。
もう一つ、より見えにくい失敗があります。それは、論文自体は正しいが使い方が誤っているケースです。方法論論文をアウトカムの根拠として引用する、レビュー論文を一次試験として引用する、異なる集団で得られた結果を直接的な確認として提示する――これらはすべてDOIチェックを通過しても、なお誤解を招きます。SciteのSmart Citationsは、後続研究がある主張を支持しているのか、反証しているのか、単に言及しているだけなのかを示すために存在します。これは、参考文献の書式が正しいかを確認することとは別の問題です。
ルールベースの参考文献チェッカーは、機械的な層では本当に強力です。PoolTextは、AI参考文献チェッカーがスタイルエラー、欠落項目、句読点、DOI書式について高精度であると指摘しています。これは必要ですが、それだけでは十分ではありません。完璧に整形されていても、裏付けのない主張は依然として過剰主張です。
AIによる査読者回答ワークフローでは、何を評価すべきか?
ツールは、コメント分割、エビデンス検索、情報源の該当文検証、主張と根拠の分類、適切に調整された下書き、改訂履歴の記憶という6つの観点で評価すべきです。このうち1つの観点でしか高評価を得られないツールでは、完成しているように見えて実際には未完成のレターができてしまいます。
本記事で用いるコメント・エビデンス整合フレームワークでは、6つの観点を次のように重み付けします。
- コメント分割(15%) — 1段落に2つの要求が隠れている複合コメントも含め、各査読者の要求を個別に切り出せるか?
- エビデンス検索(20%) — 原稿、著者のデータ、外部文献をそれぞれ別に検索し、根拠がどのプールから得られたかを示せるか?
- 情報源の該当文検証(20%) — 人間が、返信を裏付けるとされる正確な文を開けるか?
- 主張と根拠の分類(20%) — 提案されるすべての引用に、支持あり、部分的に支持、支持なし、不確実のラベルが付与されるか?
- 調整された下書き(15%) — 文章はラベルを反映するか、それとも自信に満ちた学術文へと自動的に置き換わるか?
- 改訂履歴の記憶(10%) — 以前のラウンド、約束した分析、却下した表現をシステムが記憶できるか?
この重み付けには意図があります。下書きは業務の中で最も低コストな部分です。検索と分類こそが、レターを引用可能なものにするか、二度目の査読問題にするかを分けます。AI生成査読と人間の査読を比較した研究では、AIが人間の査読者に対して決定的な付加価値をもたらすことは示されていません。これは著者にとっても有益な注意です。流暢さは妥当性の指標ではありません。
弱いツールをすぐに見抜く実践的なテストは、次のとおりです。
- 論文だけでは完全に回答できない査読コメントをモデルに与え、結果を捏造しないか確認する。
- 引用キーだけでなく、引用した各論文の根拠となる文を引用するよう求める。
- 返信文を下書きする前に、4分類の根拠ラベルを必ず付けさせる。
- 1週間後に同じコメントを再実行し、レターが以前の譲歩と矛盾していないか確認する。
製品がこれらのテストに対して、どのように失敗するかを可視化できないなら、その製品は役に立っていません。本来管理すべき不確実性を隠しているだけです。
主要なAI研究ツールは、エビデンス検索と引用チェックでどう異なるのか?
現在、すべての仕事――各コメントに対する根拠の発見、引用の検証、過剰主張しない返信の下書き――を一手に担う製品はありません。有用な比較とは、各ツールが実際にはどの仕事のために設計されているかです。
| 機能 / 観点 | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| エビデンス検索 | 1億2,500万本超の論文を対象としたAI検索とデータ抽出 | リアルタイムの文献探索と、原稿に紐付いたナレッジベース | 大規模な出版社支援コーパスを対象とする、ライセンス済み学術フルテキストと引用文脈 | 査読コメントを対象にした論文根拠型エージェントワークフロー |
| 引用の検証 | 構造化抽出に強く、Elicitの報告テストでは1,511データポイント中1,502件が正確(99.4%) | 候補情報源と引用詳細を検索。情報源の該当文は人間による確認がなお必要 | すべてのAI主張が、特定の論文中の特定の文にリンクする | 返信パッケージの組み立てに有用。検証の深さは基礎となる情報源に依存 |
| 回答書の下書き | 間接的――完全なレターより、表や文献に関する回答に向く | コメントと原稿を同一セッションで扱う場合のポイントごとの下書きに強い | 間接的――発見が妥当かを検証するための設計で、レター執筆向けではない | 専用の査読者回答下書きワークフロー |
| 主張と根拠のシグナル | 抽出精度であり、4分類の根拠スキームではない | 下書きループ内でユーザーが分類を課す | 支持、対照、言及の引用文脈 | 正式な根拠分類よりも査読者に沿った構造 |
| 料金(2026年時点) | 本レビューでは未確認 | 利用制限付きの無料枠、月額$20からの有料プラン | 本レビューでは未確認 | 本レビューでは未確認 |
| 最適な用途 | 体系的な抽出とエビデンステーブル | 1つの原稿に紐付けたエンドツーエンドの改訂サイクル | 文献が実際にある文を裏付けているかの確認 | 専用の反論下書きエージェントを求める著者 |
Elicitは、査読者から不足している比較、より明確な関連研究の整理、複数研究からの数値抽出を求められた場合に最も強力です。ジョージ・メイソン大学の研究ガイドは、これを論文を要約し、構造化されたエビデンスビューへデータを抽出するツールと説明しています。反論における制約は対象範囲です。優れたエビデンステーブルは、まだトーンを調整したレターではありません。また、抽出した所見を因果的主張に格上げすることを自動的には防いでくれません。
Sciteは、リスクが文献の誤読にある場合に最も強力です。3億本超の学術論文を検索し、さらに重要な点として、後続論文が特定の主張をどのように扱ったかを示します。査読者から「この引用は結論を支持していない」と指摘されたとき、あるいは代表的な論文を、現在でも研究分野全体が同意しているかのように引用したくなったときに適したツールです。一方で、完全な改訂秘書としては弱い面があります。これだけで14件のコメントへの回答書を管理したり、原稿の行番号を追跡したり、第1ラウンドで何を譲歩したかを覚えたりはできません。
SciSpaceは、「査読者への回答」をチャットプロンプトではなく、第一級のワークフローとして扱う数少ない製品の一つです。構造が必要な場合、この焦点は実際の利点になります。同時に、制約も明確です。根拠層が薄ければ、構造化された出力であっても結果を過大に述べる可能性があります。
Consensusは、科学的主張を迅速に見つけ、整理し、分析するために設計された査読済み文献の検索エンジンです。反論のうち「研究分野は現在何を述べているか」という部分に有用です。引用監査ツールでも、レター整形ツールでもありません。
Jenova's Academic Research Assistantは、これらの専門ツールの中間に位置します。原稿、査読者のPDF、過去のやり取りを一つの継続的なワークスペースで保持し、文献を検索し、コメントごとの返信を下書きできます。Sciteのような支持対対照の引用集計をネイティブには提供せず、またPeerReplyのrespond-to-reviewersワークフローが掲げるような、Wordですぐ使える改訂パッケージのエクスポーターでもありません。これらは率直に認めるべき不足です。その代わりとなる強みは継続性です。6週間にわたる改訂では、一度きりのレター生成器よりも記憶が必要です。
Paper Digestは、限定的な専門ツールとして加える価値があります。その主張検証の志向は、下書きチャットボットよりSciteに近く、初回の執筆者よりも第2段階のチェッカーとして適しています。
多面的Q&Aエンジンは、各コメントの裏付けとなるエビデンスをどのように見つけるのか?
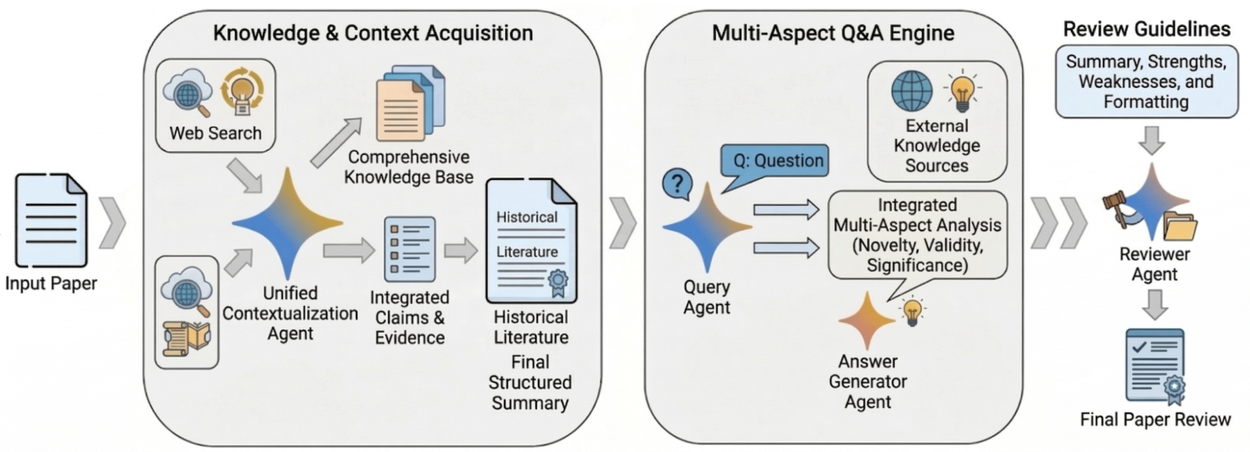
信頼できるシステムは「査読を読んでレターを書く」のではありません。各査読コメントをクエリに変換し、3つの別個の知識プールから検索した上で、初めて返信を書けるかを判断します。上のパイプライン図が示しているのは、まさにこの構造です。まず知識取得、次に多面的な質問応答、最後に統合を行います。
3つのプールは区別を維持すべきです。
- 原稿プール — 図、表、方法、限界、すでに実施した分析。
- 著者プール — 実験ノート、追加の頑健性チェック、データ辞書、過去の回答書。
- 文献プール — モデルの記憶ではなくScholar型検索によって取得した、査読者の異議に実際に答える論文。
これらのプールを混同すると、過剰主張が始まります。文献において真である文は、自分の論文の結果ではありません。ノートブック内の感度分析は、出版済みの表ではありません。効果的なクエリエージェントは、1つのコメントに対して3つの異なる質問をします。これはすでに原稿にあるか? なければ、著者は未公表の裏付けを持っているか? それもなければ、文献は限定的な主張、改訂、または譲歩を正当化するか?
実務上、Jenova's Academic Research Assistantでの検索手順は次のようになります。
- 原稿、決定通知書、補足資料を添付する。
- 暗黙の要求も含め、査読者の要求を番号付きで一覧化するよう依頼する。
- 各要求について、下書きの前に3プール検索を強制する。
「査読者2、コメント3は、2019年のサブサンプルを除外しても効果が維持されるかを尋ねています。まず添付された原稿だけを検索してください。回答となる表、節、または文を引用してください。何も見つからなければ『原稿内に記載なし』と述べ、必要な分析を列挙してください。外部論文を私たちの結果であるかのように引用しないでください。」
- 原稿内で見つからなかった場合にのみ、エージェントは文献を検索するか、新たな分析を提案すべきです。
専用の反論製品も、同様の分離を行います。Manusightsは、レター自体の下書きには汎用言語モデルが依然として最も実用的なツールだと論じています。文章に限れば、これは正しい見解です。しかし、その文章モデルの前には、エビデンスエンジンが必要です。そうでなければ、レターは記録にある内容ではなく、チャットボットが最も近接したものとして見つけた内容を自信を持って言い換えるだけになります。
多面的査読エンジンにおける新規性、妥当性、重要性という3つの分析軸は、実際に査読コメントの大半が位置する3つの軸でもあります。不足するベースラインへのコメントは妥当性の問題です。増分的な貢献へのコメントは新規性の問題です。誰がなぜ関心を持つべきかというコメントは重要性の問題です。このようにコメントをタグ付けすると、妥当性への異議に重要性の段落で答える事態を防げます。
情報源を引用する前に、AIは引用の裏付けをどう分類すべきか?
回答書に含めるすべての引用は、下書きに入れる前に、支持あり、部分的に支持、支持なし、不確実の4つのラベルのいずれかを受けるべきです。システムがラベルを割り当てられないなら、脚注を付けるべきではありません。
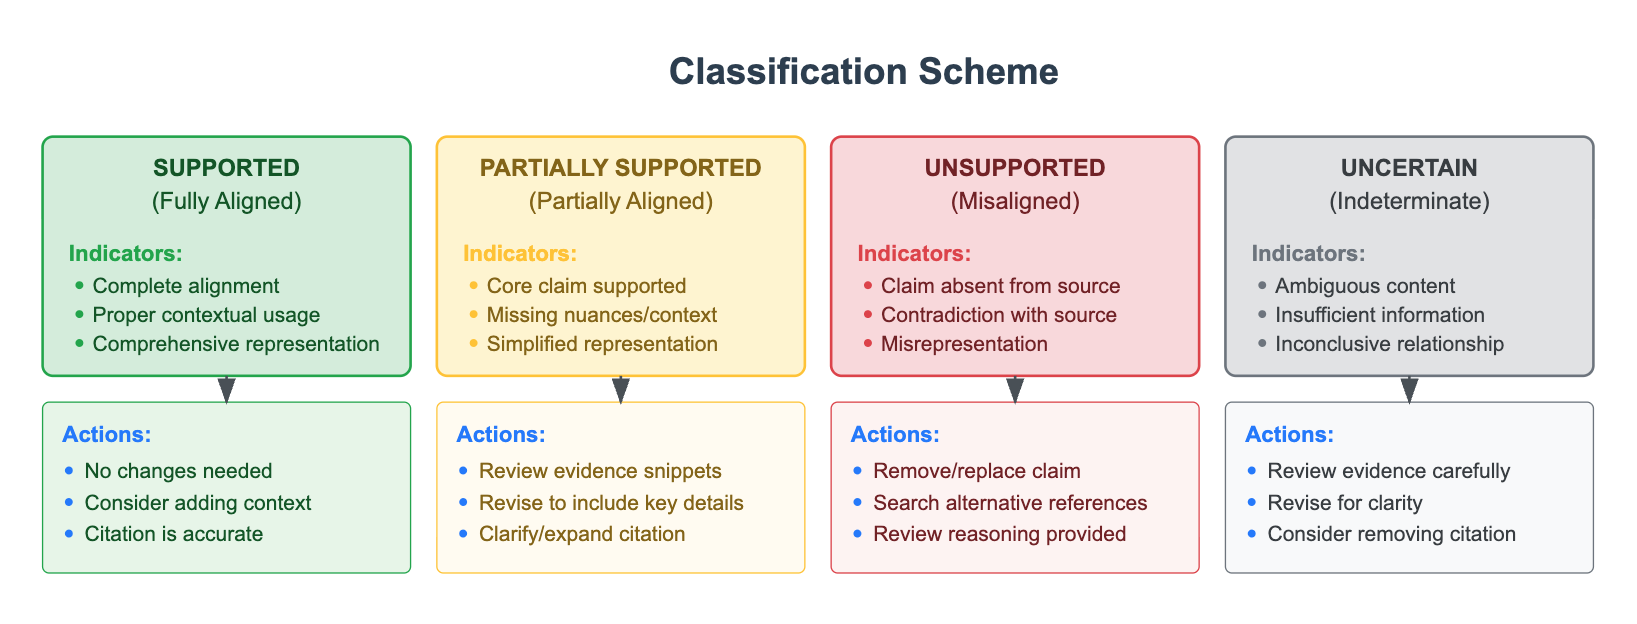
この分類こそが、引用チェッカーと主張チェッカーの違いです。
支持ありとは、これから用いる主張と同じ範囲、対象集団、因果的強度で、情報源がその主張を述べていることを意味します。対応:引用を残します。査読者に整合性が伝わるよう、5語程度の文脈句を加えることを検討してください。
部分的に支持とは、中心となる事実は情報源にあるものの、文から限定条件、サンプル制約、または相反する副次的な結果が落ちていることを意味します。対応:不足しているニュアンスを含めるよう文を書き換えるか、より適切な一次情報源に置き換えます。これは実際の反論で最も多い誠実なラベルであり、汎用チャットボットが「支持あり」に平坦化しがちなものです。
支持なしとは、主張が存在しない、矛盾している、または情報源が許容しない方法で使われていることを意味します。対応:削除または置換します。著者リストが著名である、あるいはDOIが解決するという理由で引用を残してはいけません。
不確実とは、PDFが有料で閲覧できない、該当節が曖昧である、あるいは利用可能なテキストから主張と情報源の関係を判断できないことを意味します。対応:論文を開くか、引用を削除します。不確実性は、弱い形の支持ではありません。
Sciteは、後続論文が発見を支持、反証、または議論しているかを示すことで、このスキームに近い仕組みを文献規模で実装しています。これは外部引用にとって非常に有用です。しかし、自分の新しい文を自分の図に照らして分類するわけではありません。原稿内部の主張については、この4分類スキームを下書きワークフロー自体が適用する必要があります。
このスキームを強制するプロンプトは、次のとおりです。
「査読者1への返信として提案する各文について、(1) 文、(2) 引用、(3) 情報源または原稿からの逐語引用、(4) 支持あり / 部分的に支持 / 支持なし / 不確実のいずれか1つのラベル、(5) そのラベルが求める書き換えを出力してください。支持なしとラベル付けされた文は一切含めないでください。部分的に支持とラベル付けされたすべての文は、私に見せる前に書き換えてください。」
Columbia Journalism ReviewによるAI検索エンジンの比較では、情報源として挙げられた媒体が著名ブランドであっても、体系的な引用失敗が見つかりました。学術ツールは、この点でオープンWebの回答エンジンより優れていますが、失敗の形は同じです。信頼できる媒体名が、検証済みの文の代替として使われます。この置き換えを止めるために、4分類ゲートが存在します。
結論を過大に述べずに、ポイントごとの回答を下書きするには?
下書きはラベルが確定してから行い、ラベルに動詞を選ばせます。「示す」「実証する」「証明する」は、範囲が一致する支持ありの主張にのみ用います。部分的に支持される主張には、「〜と整合的である」「部分的に対応する」「[明記した制約]のもとで成り立つ」を使います。不確実な主張には動詞を与えません。計画または削除として扱います。
明確な回答書の骨格は次のようになります。
- 査読者の指摘を中立的な表現で言い換える。
- 何を行ったかを述べる。すでに論文にある、追加分析を行った、または譲歩した、のいずれかです。
- ページ、行、表、図、補足資料など、該当箇所を示す。
- コメントが文献に関するものである場合に限り、外部研究を引用し、必ず根拠ラベルを付ける。
- 正確な原稿変更、または変更しなかった限定的な理由で締めくくる。
Jenova's Academic Research Assistantは、最初に制約を与えれば、この骨格を長いレター全体で維持できます。
「エビデンステーブル内の支持あり項目と、書き換え済みの部分的に支持項目だけを使って、査読者2への返信を下書きしてください。私が提示した動詞リストを使ってください。すべての段落には原稿内の位置情報または明示的な譲歩を含めてください。完了していない将来の実験を、完了済みであるかのように予告しないでください。引用論文の考察節を、私たちの結果であるかのように説明しないでください。」
SciSpaceや、レター執筆者として使う汎用モデルでは、下書き製品は完全性と丁寧さを最適化するため、同じ制約を貼り付ける必要があります。完全性は、存在しない分析が現れる原因になります。丁寧さは、見解の相違を「同意し、すでに示した」へと格上げする原因になります。
慎重な表現は装飾ではありません。忠実性を支える機能です。有用なヘッジは具体的です。
- 範囲に関するヘッジ:「このサンプルでは」「線形モデルのもとでは」「追跡データが完全な参加者の間では」
- 認識論的ヘッジ:「〜と整合的である」「〜を排除しない」「予備的な支持を示す」
- プロセスに関するヘッジ:「新たに報告する」「追加した」「現行の設計では検証できない」
反論下書きで禁止すべき格上げには、相関を効果にすること、頑健性チェックを再現研究にすること、非有意な結果を「差がない」にすること、単一の支持的引用を「十分に確立されている」にすることが含まれます。AI支援による学術執筆のガイダンスは、生成された文章が原稿の実際の主張と一致するかを著者が確認する責任を負うと強調しています。開示に関するジャーナル方針は異なりますが、The Conversationによる出版社ルールの要約では、日常的な機械的支援には引用が不要な場合がある一方、実質的なAI生成コンテンツにはしばしば必要だとされています。モデルが下書きした文献解釈を含む回答書は、通常後者に該当します。
ProofreaderProの回答書に関する実務ガイドは、構造とトーンについて正しい指摘をしています。しかし、構造とトーンは難しい部分ではありません。難しいのは、表が許容する以上の強さでコメントに答えることを拒むことです。査読者が、自分にはない因果的識別戦略を求めているなら、誠実な下書きは限界を説明する段落であり、可能であれば、より弱くても識別可能な分析です。元の回帰をより自信たっぷりに言い換えることではありません。
過剰主張を捉えるための第2段階プロンプトは、次のとおりです。
「各返信段落をエビデンステーブルと比較してください。動詞が根拠ラベルより強い文をすべて指摘してください。引用文がない引用をすべて指摘してください。追跡された原稿修正に対応しない約束をすべて指摘してください。」
研究公正の専門家は、AI支援による反論について何と言っているのか?
査読の公正性に取り組む研究者は、同じ点を繰り返し指摘しています。AIは検索と整形を加速できますが、編集者に返すすべての文の真偽を最終的に負うのは著者です。
「私たちが目にする失敗は、参考文献リストのカンマ欠落であることはほとんどありません。問題は、引用している論文に対して認識論的に一段階強すぎる文です。役に立つことを報酬とするモデルは、あなたが禁止しない限り、その差を埋めてしまいます。最も低コストな制御はアーキテクチャです。検索し、ラベル付けし、それから下書きする。この順序を逆にすれば、レターには後から正当化しようとする主張が含まれることになります。」
「Smart Citationsツールは、研究分野がある論文を今も支持しているかを確認するコストを変えました。しかし、自分の表3が回答書の段落6にある動詞を支持しているかを確認するコストは変えていません。この2番目の確認は、依然として人間が数値の隣にある文を読むことです。それを省略する著者は、時間を節約しているのではありません。次の査読ラウンドから時間を借りているのです。」
「また、チームには却下ログを残すよう助言しています。モデルが『私たちは示す』と言いたがってもラベルが部分的に支持にとどまるたび、却下した文を書き留めてください。2本か3本の論文を経ると、研究室に固有の典型的な過剰主張が見えてきます。通常は因果関係を示す動詞、サンプルを超えた一般化、レビューを試験であるかのように引用することです。カスタム指示とは、実質的にはそのログをコード化する方法にすぎません。」
— Jenova Product Team、学術ワークフロー設計、原稿・引用システムを8年間支援
この助言は、査読におけるAI自体に関する研究文献とも一致しています。査読におけるAIに関するPMCレビューは、いかなる判断の前にも、査読者がAI生成コンテンツを批判的に評価し続けなければならないと強調しています。AIが決定通知書に対する著者側にいる場合も、同じ義務が適用されます。査読のやり取りでChatGPT級のモデルを使う著者は、提案を原稿の中核的主張と研究公正に照らして検証するよう特に警告されています。
EditageによるAIの査読回答への実地テストは、勝者総取りのランキングというより、そこから見える傾向に有用性があります。モデルは返信が完全に見えるかを判定できても、返信が真実であるかについては弱いままであり得ます。完全に見えることが、レターを早すぎる段階で提出させる性質なのです。
AIが下書きした査読者回答は、いつ上書きすべきか?
根拠ラベルが文より弱いとき、コメントがモデルでは根拠付けられない判断を求めるとき、同意することで次のラウンドにおいて擁護できない主張に自分を縛るときは、下書きを上書きすべきです。上書きは例外ではなく、通常の工程です。
以下の場合は、直ちに上書きしてください。
- エージェントが、まだ開いて確認していない論文を引用している。
- エージェントが、方法に対する批判に対して、新しいテストなしで序論の文章を追加して答えている。
- エージェントが、査読者の誤解を、説明の書き換えではなく引用追加の要求として扱っている。
- エージェントが、リポジトリに存在しない分析を「発見」している。
- エージェントが、両立しない分析を求める2人の査読者に同意し、その矛盾を指摘していない。
- エージェントが、一次の実証的主張を裏付けるためにレビュー論文を使っている。
一部のコメントは、完全に委任すべきではありません。研究倫理、データアクセス、利益相反、結果が臨床的または政策的に重要かどうかに関する要求では、自分が何を支持する意思があるかを人間が判断する必要があります。AIは文書を集められます。しかし、それらに対する責任を引き受けることはできません。
逆方向の問題も拡大しています。著者は現在、AIによって生成されたように見える査読コメントにも遭遇しています。その場合も、正しい対応はエビデンス優先です。コメント内の実行可能な科学的要求を言い換え、一般的な水増し部分は無視し、文書で裏付けられる要求に答えます。AIらしいレビューにAIらしいレターで応じても、ファイル内の根拠のない文章が倍増するだけです。
各コメントを締めくくるための、実行可能な人間参加型プロセスは次のとおりです。
- 査読者の文を読み、自分で6語の要約を書く。
- 下書き段落を見る前に、エージェントのエビデンス行を採用または却下する。
- 行を却下した場合、段落を編集しない。エージェントを検索段階へ戻す。
- 部分的に支持された行を採用する場合、動詞は自分で編集する。
- その後にのみ、段落をレターへ入れる。
このように使えば、Jenova's Academic Research Assistant、Scite、Elicit、SciSpaceのような専用下書きエージェントは、互いに代替可能なものではなく補完的なものになります。検索ツールは、論文を見落とす可能性を減らします。分類は、論文を誤用する可能性を減らします。下書きツールは、レターが整理されない可能性を減らします。ただし、ラベルのない主張から下書きを作ることを拒まない限り、どのツールも過剰主張の可能性を減らしません。
守るべき基準は、プロンプト入力欄の上に置けるほど簡単です。動詞を正当化する文、表、または譲歩を指し示せないなら、その文は回答書に入れるべきではありません。
参考文献
- Nature — 現在では半数超の研究者が査読にAIを使用
- プレトリア大学図書館 — 引用管理とAIハルシネーションのリスク
- ステレンボッシュ大学 — 学術執筆における責任あるAI利用のガイドライン
- Scite — Smart Citationsと文単位の主張検証
- PoolText — 参考文献チェックを含む、査読においてAIができることとできないこと
- ScienceDirect — AI生成査読と人間の査読の比較
- Elicit — AI文献検索と報告された抽出精度
- ジョージ・メイソン大学図書館 — 文献レビューのためのAIツール
- SciSpace — Response to Reviewersエージェントワークフロー
- Consensus — 査読済み文献を対象とするAI検索
- PeerReply — ポイントごとの回答と改訂パッケージのワークフロー
- Paper Digest — 学術的エビデンスに対する主張検証
- Manusights — 査読者への回答に最適なAIツール
- Columbia Journalism Review — AI検索エンジンと引用の失敗
- PMC — AI支援による学術執筆
- The Conversation — ジャーナル論文におけるAIに関する出版社ガイドライン
- ProofreaderPro — AIの支援を受けた査読者回答書の書き方
- PMC — 査読におけるAI
- PMC — ChatGPT 4を用いた査読対応
- Editage — 査読回答に対するAIのテスト
- ResearchGate — AI生成の査読コメントに関する議論