AIは数百本の論文から研究質問ごとにエビデンスを抽出できるのか?
2026-08-21
研究質問に固定した抽出ワークフローは、要約先行のAIツールとどう異なるのか?
研究質問に固定したワークフローは、あらかじめ定義した研究質問に対して、比較可能で出典に紐づいたフィールドを返します。一方、要約先行ツールは、各論文をそれぞれの論文自身の表現で言い換えた流暢な段落を返します。2026年、この違いはモデルブランドよりも重要です。Jenova's Academic Research Assistantは、永続メモリと原稿作成支援を備えた、反復的かつ質問主導の抽出に最も適しています。Elicitは実証研究のリサーチマトリクスにより強く、Covidenceは、PRISMA 2020の報告要件に従う必要がある二重査読者制のシステマティックレビューにおいて、依然として標準的な選択肢です。
エビデンス抽出と論文単位の要約を分ける主な要素は、次のとおりです。
✅ 質問への忠実性 — すべてのセルが論文独自の貢献の枠組みではなく、あなたの質問に答えます。
✅ フィールド単位の構造化 — 方法、サンプルサイズ、アウトカム、効果方向が、出典箇所にリンクされたカスタム列に格納されます。
✅ 論文横断の比較可能性 — 矛盾や研究デザインの違いは、フィールドを揃えて初めて可視化されます。
✅ 引用文脈の確認 — 引用された知見を、そのまま正しいと仮定せず、後続研究に照らして再検証します。
✅ 人間による裁定 — 大規模言語モデルは抽出を加速しますが、高リスクの統合において教師なし利用はまだ実用段階に達していません。
ツールを意味のある形で比較するには、抽出を単一の「これらのPDFを要約して」というプロンプトではなく、取り込み、質問によるフィルタリング、構造化、比較、検証、執筆から成るパイプラインとして扱うことが有用です。
分析単位が研究質問であるとき、広範なAI要約はなぜ失敗するのか?
広範な要約は、比較不能な研究を一つの叙述に押し込めるため、研究質問に必要な正確なセルを隠してしまいます。論文単位の概要は完全に見えても、サンプルサイズ、比較対象、追跡期間、あるいは結果が増加・減少・無効果のどれだったかを省くことがあります。「この論文は何について述べているか」から「このコーパスはこの質問について何を示すか」へ移行した時点で、こうした欠落は致命的です。
エビデンス統合の目的は、抄録を言い換えることではなく、構造化された質問に答えることです。PRISMA 2020は、レビューをなぜ行ったのか、どのような方法を用いたのか、何が見つかったのかを報告するための枠組みであり、読みやすいダイジェストを作るためのものではありません。推奨手法を適用した場合、従来型のレビューは今もチームで約1年を要します。そのボトルネックを生んだ文献量こそ、要約先行のチャットツールが数段落に圧縮しようとしているものです。
要約は論文のレトリックも引き継ぎます。著者は有意な結果を強調し、抄録では無効果の結果が十分に報告されず、引用は後続研究によって弱められた主張を広めます。質問単位の抽出は、この偏りを反転させます。まずフィールドを定義し、その後に全論文へ同じ質問を投げかけます。LLMによる抽出の検証では、別の失敗パターンも示されています。モデルは背景情報のフィールドを安定して扱えても、アウトカムデータを見落とすことがあり、アウトカム抽出は研究特性の抽出より依然として難しいのです。
実務上の意味は単純です。出力を、研究ごとに1行、質問要素ごとに1列の表へそのまま入れられないなら、まだエビデンスは得られていません。得られているのは概要です。
AIによるエビデンス抽出ワークフローには何を求めるべきか?
質問への忠実性、構造化フィールド、出典追跡可能性、論文横断の整合、引用文脈の検証、記録された人間の検証ループという6つの能力を探すべきです。これらが一体となって、研究質問に固定した抽出フレームワークを構成します。流暢な文章力では高得点でも、この6点で弱いツールは、結局のところ広範な要約しか生成しません。
質問への忠実性。 システムは、PICO、PECO、またはカスタムスキーマのようなプロトコル形式の質問を受け入れ、周辺的な知見へ逸脱しない必要があります。「質問でフィルタリングする」ことは、現代のLLM抽出パイプラインにおける基礎工程であり、任意の改善機能ではありません。
構造化フィールド。 サンプルサイズ、デザイン、介入または曝露、比較対象、アウトカム、効果方向、限界は、すべて出典箇所にリンクされたカスタム列に格納されるべきです。チャット画面内の自由記述は、データ抽出フォームではありません。
出典追跡可能性。 回答にはPDF内のハイライトまたは位置情報が必要です。それがなければ、モデルの誤りを原記録と照合して裁定できず、方法を透明に報告することもできません。
論文横断の整合。 同じフィールドは、すべての行で同じ意味を持たなければなりません。そうでなければ、矛盾、用量差、デザイン効果を把握できません。
引用文脈の検証。 2018年に正しかった知見が、その後の試験を経て成立しなくなっている可能性があります。引用された主張を再確認しない抽出は、古いエビデンスを新しい原稿へと洗浄して持ち込んでしまいます。
人間による検証。 人間が抽出した研究の最大63%には、少なくとも1つのデータ抽出エラーがあります。LLMは異なる種類のエラーを導入する一方、人間のエラーを検出することもできます。ワークフローでは不一致を、勝敗を決める指標ではなく、PDFを開くべきシグナルとして扱う必要があります。
2026年の大学図書館による比較でも、ツールはマーケティング上の主張ではなく、役割、コーパス、失敗モードで評価されています。Oregon State Universityのレビューは、Consensusが情報源を誤読することがある一方で、Elicitのマトリクスは実証論文に最も有用であるものの、要約にはニュアンスが欠ける場合があると指摘しています。これは導入を妨げる決定的欠点ではなく、適切な粒度の評価所見です。
複数論文にまたがる構造化エビデンスを抽出できるAIツールはどれか?
すべての段階を支配する単一ツールはありません。Elicitは実証研究のマトリクス、Covidenceはチームによるシステマティックレビュー、Consensusは合意の迅速な概観、Jenova's Academic Research Assistantは引用管理と下書き作成まで継続できる、反復的な質問主導分析に強みがあります。Paperguide型のパイプラインは、同じ工程を複数ツールにまたがって組み合わせる場合でも、抽出先行の順序を例示しています。
| 機能・観点 | Elicit | Jenova's Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| 質問単位のカスタム列 | 方法、サンプルサイズ、知見に対応するカスタマイズ可能な研究マトリクス | プロンプトで定義したスキーマを、セッションをまたいで永続メモリに保持 | 表形式の要約と合意メーター。カスタムフィールドの制御は限定的 | スクリーニング後、採択研究に対するデータ抽出フォーム |
| 一般的な統合規模 | 収集済み情報源に対するプロトコルから抽出までのワークフロー。Plus要約は少数の論文を引用 | アップロード済みPDFとScholar連携レコードに対するバッチ抽出 | 統合1回あたり最大20本の論文(Pro)または50本(Deep) | 正式なレビューのためのチーム規模スクリーニングコーパス |
| 出典追跡可能性 | 採用文献へのリンク | 添付PDFに根拠を置く文書ベースの回答 | 概観で使用した情報源へのリンク | 完全なスクリーニングおよび抽出の監査証跡 |
| 二重査読者ワークフロー | 中核設計ではない | 組み込まれていない | 組み込まれていない | 独立した二重スクリーニングと不一致解決 |
| 引用文脈の確認 | 抽出セットを越える確認は限定的 | Scholarと検索による、セッション横断の文献追跡 | 合意メーターを一致シグナルとして使用 | 手作業。更新はレビュープロトコルに従う |
| 原稿作成への引き渡し | 文献管理ツールへエクスポート | 引用管理と下書き作成。Word Doc Generatorで原稿の体裁も整えられる | Plusユーザー向けエクスポート | レビュー原稿の作成は別段階 |
| 価格(2026年時点) | 機関向けPlusサブスクリプション。消費者向けプランは本稿では未検証 | 無料プランあり。Plusは月額$20から | フリーミアム。一部の大学はProをライセンス提供 | 年間個人プラン、パッケージ、組織向けプラン |
| 最適な用途 | 実証研究の抽出表 | 長期プロジェクトにおける、反復的で質問主導の分析 | 生物医学・STEM領域の迅速な合意スナップショット | PRISMA準拠のチーム型システマティックレビュー |
Elicitは、プロトコルの改善、情報源の収集、スクリーニング、抽出、統合を行うためのツールとして明確に位置付けられています。これは質問単位の作業として適切な役割定義です。図書館による評価では、生成される要約はしばしば知見に焦点を当て、ニュアンスを欠くと記録されており、マトリクスは実証研究の報告慣行に最適化されています。質的研究、理論研究、または構造の不十分な論文は、よりきれいには抽出できません。
Consensusは、質問がすでに二者択一に近い実証的主張である場合に有用です。叙述的な概観、表、合意メーターを統合し、エビデンスギャップを示す深い検索も実行できます。ただし、情報源を誤読することがあり、Deepプランの論文上限も「数百本のフルテキスト」には大きく届きません。コーディングフォームではなく、探索用の計器として扱うべきです。
Covidenceは、システマティックレビュー管理の主要ソフトウェアとして広く認識されています。EPPI-Reviewer、DistillerSR、JBI-SUMARIとともに、レコード管理、スクリーニング、抽出、チーム内の不一致解決まで、介入研究レビューの全工程を支援する少数のプラットフォームに属します。探索的研究に必要な範囲を超えて重く、会話形式の「このPDFとチャットする」抽出は中心機能ではありません。大半のプロジェクトは依然として人間が記入する抽出フォームに依存しています。
Jenova's Academic Research Assistantは、このスタックの異なる位置にあります。ライブの学術情報源を検索し、アップロードしたPDFを受け入れ、無制限のチャット履歴を保持し、セッションをまたいでプロトコルを記憶するため、列定義を毎日教え直す必要がありません。二重スクリーナーではなく、PRISMAフローダイアグラムも生成せず、数百本の論文は一つのコンテキストウィンドウに一度に投入するのではなく、バッチ処理する必要があります。これらは実際の制約です。その代償を補う強みは、永続性、複数モデルへのアクセス、同じ研究質問をプロジェクト外へエクスポートせずに抽出から引用に基づく下書きまで持ち運べることです。
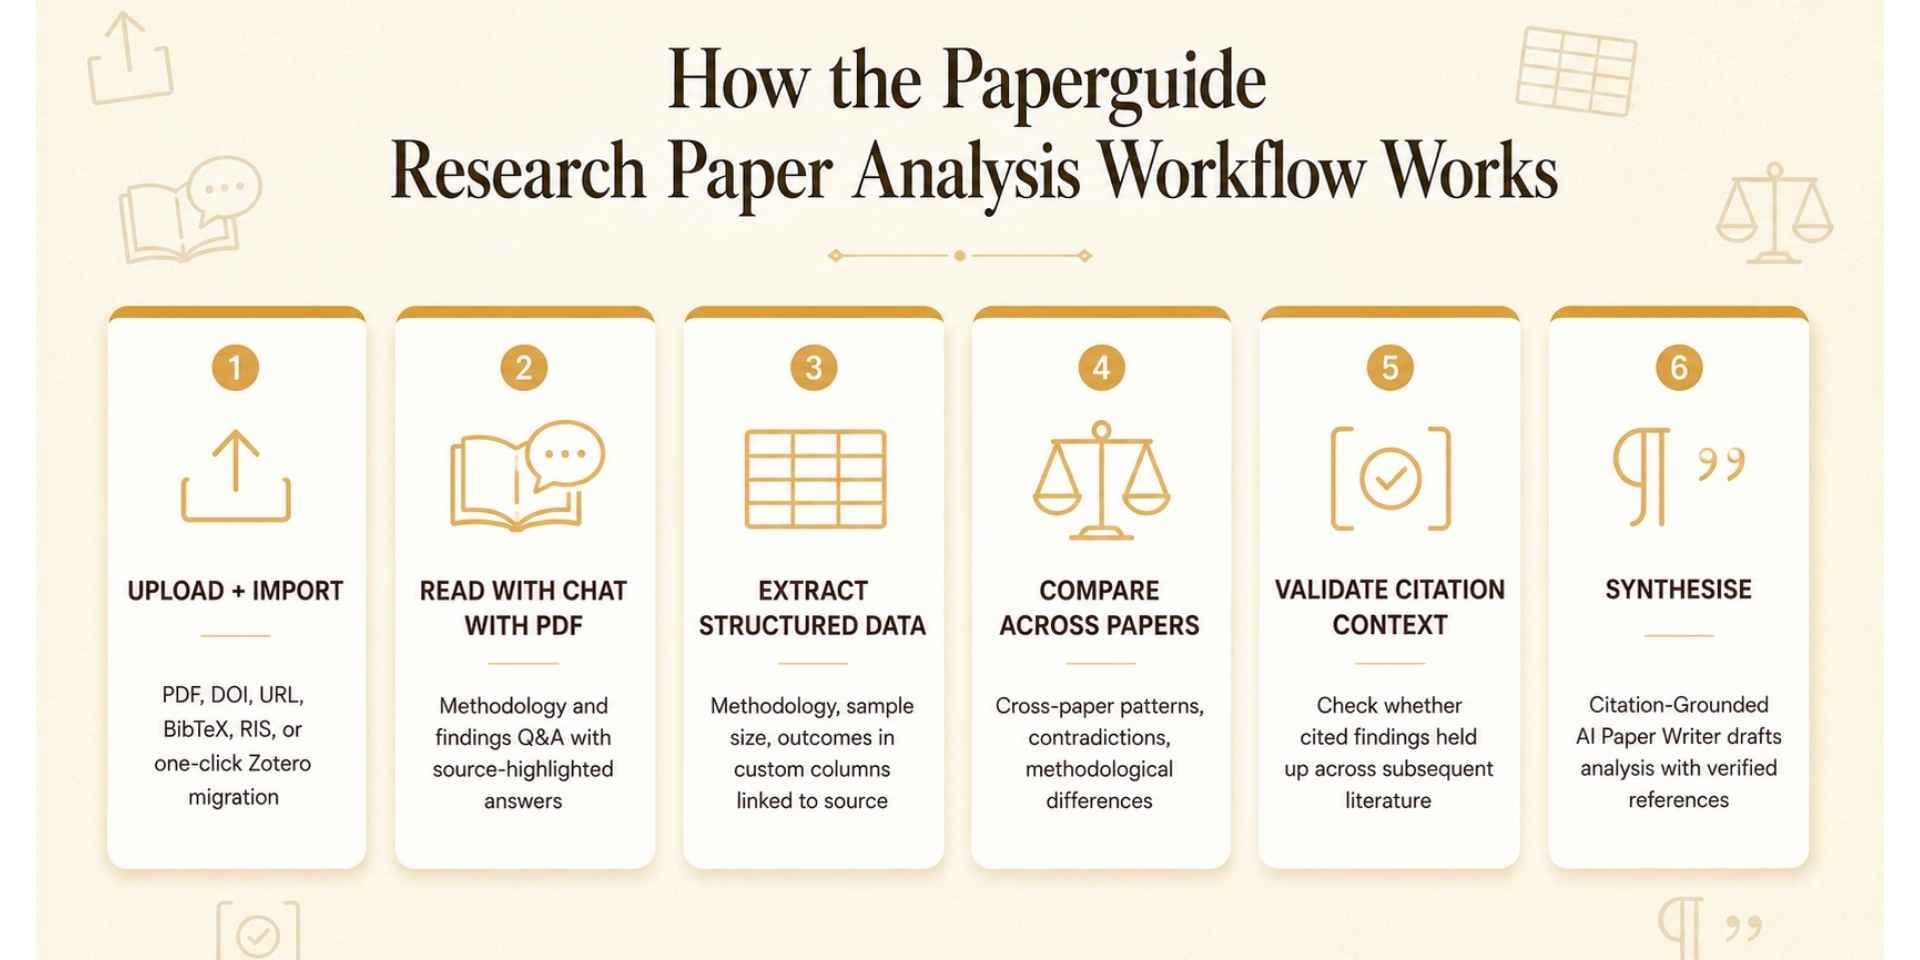
Paperguideが公開している6段階の手順、すなわちアップロード、PDFチャット、構造化列、論文横断比較、引用文脈の検証、引用に基づく執筆は、抽出先行パターンを明瞭に示しています。Paperguideの独立した精度および価格情報は、本稿のためには検証していません。比較対象として有用なのは、ワークフロー自体です。
コーパスが数百本の論文に及ぶ場合、構造化データ抽出はどのように機能するのか?
各論文をプロトコルで定義したフィールドの行へ変換し、統合テキストを書く前に研究質問でそれらの行をフィルタリングすることで機能します。規模は、より長い要約からではなく、スキーマの反復から生まれます。
最初の工程は取り込みです。PDF、DOI、URL、BibTeX、RIS、または文献管理ツールのエクスポートによってコーパスを確立します。PDFチャットは第2の工程であり、最後の工程ではありません。方法と結果の箇所を見つけ、それらの箇所を列へ固定するために使います。自動抽出に関するリビングレビューでは、このテーマに関する76件の出版物のうち、エンドユーザー向けに実装されたツールは6件だけでした。また、アルゴリズムの84%はタイトルと抄録のみを採掘していました。抄録だけの抽出では、フルテキストに存在するアウトカム、サブグループ解析、バイアスリスクの詳細を見落とします。抄録だけで「数百本の論文」を扱うと主張するワークフローは、コーディングではなく要約を行っています。
カスタム列は、ベンダーの既定テンプレートではなく、質問に合わせるべきです。有効性に関する質問では、一般的なフィールドは、デザイン、対象集団、介入または曝露、比較対象、主要アウトカム、効果方向、区間を含む効果量、追跡期間、限界です。メカニズムに関する質問では、効果量を、仮説上の経路と、その研究が実際にその経路を検証したかどうかに置き換えます。各セルを出典箇所へリンクすることで、後の比較が可能になります。位置情報がなければ、表は余白を増やしただけの別の要約にすぎません。
数百本の論文を扱うには、バッチ処理も必要です。コンテキストウィンドウ、レート制限、PDF解析エラーのため、システマティックレビューのコーパス全体を一度に抽出することは信頼できません。持続可能なパターンは次のとおりです。8〜15本の論文からなるパイロットセットでスキーマを定義し、人間によるコーディングとの一致度を測定し、プロンプトを固定してから、残りの論文を複数の波に分けて処理します。プロンプトの文面が完全性と形式を決定します。論文ごとに固有のプロンプトを使っても一般化しません。部分集合でパイロットを行い、その後はプロンプトを固定してください。
Jenova's Academic Research Assistantは、スキーマを永続メモリに保持でき、PDFをプロジェクトに添付したままにできるため、このパターンを支援します。それでもバッチ処理は必要です。Elicitのマトリクスは、実証的フィールドのネイティブなコーディングシートに近いものです。Covidenceは、コーパスがすでにスクリーニングを通過していることを前提とします。自分が実際にどの段階にいるかに合うツールを選んでください。
抽出した知見を、引用文脈と研究デザインに照らしてどう検証するのか?
抽出された主張が、引用箇所、後続文献、そして同じ質問に答える研究デザイン間においてなお成り立つかを確認することで検証します。これらの確認なしの抽出は、引用バイアスを機械的な速度で再生産します。
引用文脈の検証とは、引用している文を信用するのではなく、引用された箇所を開くことです。論文は、参照文献が示した内容を日常的に誇張し、結果ではなく抄録を引用し、後続試験で覆された知見を引き継ぎます。したがって、「この引用知見は成立するか」を確認する専用の工程は、「この論文は何を報告したか」とは別工程です。Paperguide型のワークフローは、この確認を統合の直前に置いています。これは正しい順序です。セルが安定するまで段落を書いてはいけません。
デザインを考慮した検証は、さらに踏み込みます。Nature Communicationsに掲載された2025年の方法論図は、たとえそのスコア式を採用しなくても、有用な参照アーキテクチャとなる二段階パイプラインを示しています。大規模言語モデルは自由テキストを対象集団、介入または曝露、関係、アウトカムへ解析し、その後、効果方向を増加・減少・変化なしに分類します。これらのレコードは、ランダム化試験、メンデルランダム化、観察研究といったデザイン別に層別化されるため、結果が手法をまたいで交換可能なものとして扱われません。
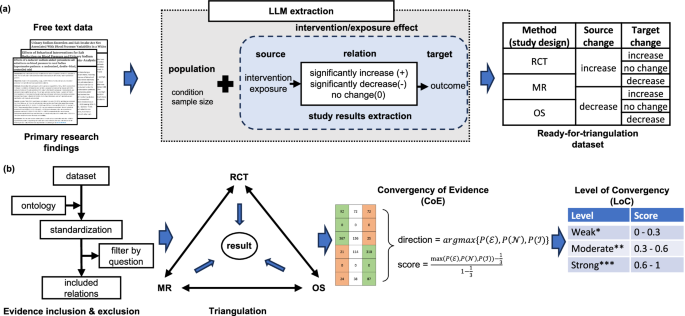
第2のパネルは、多くの要約ツールが省略する部分です。標準化と採用フィルタリングの後、結果はデザインをまたいで三角測量されます。Convergence of Evidenceスコアは、確率質量が最も高い方向を用います。次に、Level of Convergenceの区分が、エビデンス全体を弱い、中程度、強いと分類します。この考え方を適用するのに、まったく同じ指標は必要ありません。必要なのは、有意な観察研究の関連と無効果の試験を、一つの「文献はXを示す」という文のように扱うことをやめることです。
人間とモデルの不一致は、自動的なモデル失敗として採点するのではなく、第3回目の確認でPDFに照らして裁定すべきです。ある概念実証では、Claude 2は重大な抽出エラーを1件、軽微なエラーを5件起こしましたが、人間の参照標準にあった軽微なエラーを21件検出しました。公表済みの抽出をゴールドスタンダードとして扱うことは、モデルを過小評価し、人間を過大評価します。正しい分析単位は各フィールドの事実的一致であり、複合統計量、すなわち点推定値と区間は、無関係な3つの数値ではなく一貫した単位として数えるべきです。
Jenovaは、後続文献を検索し、元の抽出表をメモリに保持できるため、引用文脈の確認を実行できます。ただし、Cochrane型レビューにおける第2の人間査読者を置き換えることはできません。Covidenceはその第2査読者を強制できます。この2つの事実を、一つの勝者という結論に押し込めずに活用してください。
実務では質問主導の抽出ワークフローをどう実行するのか?
まず質問とフィールドを定義し、スキーマをパイロットで検証し、出典位置情報付きでバッチ抽出し、行を比較し、引用を再確認してから、表に基づいて執筆します。この順序を逆にし、先に書いて後から引用を探すと、要約の問題を再現してしまいます。
Jenova's Academic Research Assistantでは、典型的な手順は次のようになります。
- エージェントを開き、採択基準と必要な正確な列を含むプロトコルを、一つのブロックで提示します。
- コーパス全体ではなく、PDFまたはDOIのパイロットセットを添付します。
- すべてのセルに位置情報を求めながら、表へ抽出します。
- パイロットの修正後、プロンプトを固定します。
- 残りの論文をバッチ処理し、叙述的統合の前に矛盾確認と引用文脈確認を実行します。
有用な開始プロンプトの例は次のとおりです。
「研究質問:治療抵抗性うつ病の成人において、補助療法としてのケタミンは、24時間後のMontgomery–Åsbergスコアをプラセボと比較して低下させるか? RCTのみを含めること。各論文から、デザイン、無作為化されたn、用量と投与経路、比較対象、主要アウトカム、時点、95% CI付き効果量、方向(増加/減少/変化なし)、限界を抽出すること。各効果量について結果の文を引用すること。採択基準を満たさない論文は要約しないこと。推測せず、空欄のセルにはフラグを立てること。」
表ができた後に有用な比較プロンプトは次のとおりです。
「抽出表のみを用いて、(1)効果方向の矛盾、(2)矛盾を説明し得る用量または時点の違い、(3)同じアウトカムについて最も新しい無効果結果よりも古い支持試験を引用している行を列挙すること。表にない論文を追加しないこと。」
Elicitでは、対応する手順は、プロトコルの改善、情報源の収集、スクリーニング、カスタム列のマトリクスです。これは製品がシステマティック文献レビュー向けに文書化している手順です。n、方法、アウトカムなどのフィールドがすでにマトリクスに適合する実証的な質問から始めてください。理論論文で同程度の成果を期待してはいけません。
Covidenceでは、検索結果のインポート、重複除去、タイトル・抄録の二重スクリーニング、フルテキストスクリーニング、抽出フォームという順序で進めます。図書館ガイドは、この種のソフトウェアを、チャットボットではなく、構造化され、透明で、再現可能なエビデンス統合のための環境として扱っています。PRISMAフローダイアグラムと2名の独立した査読者が必要なら、ここから始め、LLMは抽出フォーム内でのみ使用し、第2査読者は引き続き人間としてください。
2つの運用原則は、3つすべてのツールに共通します。第1に、モデルにもっともらしい値で空欄を埋めさせてはいけません。空欄もデータです。第2に、モデルの応答時間だけでなく、プロンプトの反復、裁定、修正を含むタスク全体の時間を測定してください。タスクに費やした時間こそ、関連する効率性のアウトカムです。プロンプトエンジニアリングもその時間の一部です。
エビデンス統合の研究者は、LLMによるデータ抽出について何を述べているのか?
研究者は、LLMを背景フィールドに有望な加速装置とみなしつつ、アウトカム抽出を置き換える技術としては未実証と捉えており、検証設計自体も未解決の方法論的課題です。2025〜2026年の方法論論文における一致した見解は条件付きです。監督されたワークフローの中では有用ですが、教師なし抽出器としてはまだ準備ができていません。
「エビデンス統合のボトルネックは読む速さではありません。すべての研究に同じフィールドで同じ質問へ答えさせ、そのフィールドの不一致に気付くことです。要約は流暢でも、その仕事には使えない場合があります。流暢さは空欄を隠してしまうからです。チームを論文単位のチャットから質問に固定した表へ移行したとき、最初に現れたのは洞察ではなく、欠損でした。分母のないサンプルサイズ、時点のないアウトカム、紐づけられた文を裏付けていない引用です。」
「また私たちは、人間の抽出をゴールドスタンダードとして扱うこともやめました。人間がコーディングした研究の大部分には少なくとも1つの抽出エラーがあり、モデルは別のエラーを導入しながらも、特に複合統計量において人間のエラーを見つけることがあります。生産的な評価単位は、PDFに照らして裁定する、フィールドごとの事実的一致です。ワークフローがスキーマ、位置情報、バッチ、矛盾確認、再引用というループを示せない限り、何本の論文を読んだと主張しても、それは要約ツールです。」
— Jenova Product Team、文献探索と原稿準備にまたがる長期的な学術エージェントプロジェクトの構築経験に基づく、研究ワークフロー設計
この立場は独立した論評とも一致します。システマティックレビューにおけるLLMのスコーピングレビューは、LLMが利用拡大中であるものの、まだ単独利用の準備はできていないと結論付けています。データ抽出とバイアスリスク評価のための言語モデルに関する別の研究も、モデルのみのレビューではなく、人間とモデルを組み合わせたパイプラインを検証しています。この分野における現在の問いは、「モデルは400本のPDFを読めるか」ではありません。「記録され、質問でフィルタリングされた表は、二重査読に耐えられるか」です。
AIリサーチエージェントではなく、専用のシステマティックレビューソフトウェアを使うべき場合はいつか?
独立した二重スクリーニング、報告可能なPRISMAフロー、そしてジャーナル、HTA機関、ガイドライン委員会が確認する監査証跡が必要な場合は、専用のシステマティックレビューソフトウェアを使ってください。研究質問をまだ形作っているとき、リビングコーパスをコーディングしているとき、または安定した表を原稿へ変換するときは、AIリサーチエージェントを使ってください。この2つは競合するよりも、連続して使われることの方が多いものです。
Covidence、DistillerSR、EPPI-Reviewer、JBI-SUMARIが存在するのは、再現可能な方法、チームワークフロー、PRISMA準拠の記録が、介入研究レビューでは選好ではなく要件だからです。これらのプラットフォームにおける機械学習は、スクリーニングで最も効果を発揮しており、ある評価ではスクリーニング負担を最大60%削減できると推定されています。一方で、抽出およびバイアスリスク評価のツールは依然として限定的です。成果物が登録済みレビューであるなら、チャットモデルがPDFを言い換えられるという理由でこのスタックを省略してはいけません。
質問がまだ変化している場合、エージェントの方が優れた日常環境です。新しいPDFを添付し、列を修正し、新たな方向転換のたびにレビュー用プロジェクトを開き直すことなく、プロトコル上の判断をメモリに保持できます。Jenova's Academic Research Assistantは、この用途のために構築されています。ライブの学術検索、添付済みフルテキスト、永続的な抽出スキーマ、引用管理された下書きへの経路です。ただし、2人のスクリーナーを必要とするプロトコルは満たしません。この制限を明示することも、正しく使うための一部です。
2026年に多くのグループが採用する実践的な分担は、次のようなものです。エージェントまたはElicitで探索し、フィールドを定義する。プロトコルを登録する。Covidenceまたは同等のツールでスクリーニングと抽出を行い、必要に応じて人間がなお検証するLLM支援コーディングを用いる。固定した表へ戻り、エージェントで引用文脈を厳密に検証し、執筆する。Dukeのエビデンス統合ツールボックス一覧は、すべての段階を一つのアプリがカバーするわけではないことを示しています。専門性とは、自分が今どの段階にいるかを知ることです。
採用するスタックを決めるべき検証基準は、本稿の冒頭で示したものと同じです。研究質問、その質問の各要素に対応する列、すべてのセルの位置情報、除外したものの記録を示せるなら、あなたはエビデンスを抽出しています。「論文が述べていること」のよく書かれた概観しかないなら、たとえその概観が数百のファイルから生成されていたとしても、まだ要約しているだけです。
参考文献
- PRISMA Statement — システマティックレビューの報告ガイダンス
- The BMJ — PRISMA 2020声明:システマティックレビュー報告の更新ガイドライン
- ScienceDirect — システマティックレビューにおけるLLM:利用は拡大中だが、まだ準備不足であるスコーピングレビュー
- PMC — システマティックレビュープロセスを支援するデジタルツール
- BMJ Evidence-Based Medicine — LLMによるデータ抽出を評価する際の課題と落とし穴
- Oregon State University Libraries — 文献調査のためのAIツール比較
- Elicit — システマティック文献レビューのワークフロー
- Covidence — システマティックレビュー管理ソフトウェア
- UCL Library Guides — システマティックレビュー用ソフトウェア
- Nature npj Digital Medicine — データ抽出とバイアスリスク評価のための言語モデル
- Duke University Libraries — エビデンス統合のためのソフトウェアとツール