マルチモデルAIは株式分析の盲点をより効果的に減らせるか?
2026-08-24
モデル間の不一致とアンサンブル検証は、隠れた投資仮説リスクをどう明らかにするのか?
複数モデルによる相互検証は、単一モデルの株式分析よりも盲点と過信を確実に減らします。なぜなら、モデル間の不一致は平均化して消すべきノイズではなく、それ自体がリスクシグナルだからです。2026年には、ChatGPT、Claude、Geminiから得られる流暢な一つの回答が、調査完了のように感じられます。問題はまさにその流暢さです。一つのモデル、一つのコンテキストウィンドウ、一つの学習分布は、数値が古い、提出書類を読み違えている、弱気シナリオが欠けている場合でも、一貫したストーリーを作り出します。
慎重なAI株式リサーチと、自信満々な推測を実際に分ける要素は次のとおりです。
✅ 情報源への接地 — 学習カットオフではなく、最新の提出書類、予想、価格を使うこと ✅ モデルの多様性 — 複数のプロバイダーを使い、共通コーパスに由来するバイアスを見つけやすくすること ✅ 役割の多様性 — 一人の万能分析者ではなく、ファンダメンタル、テクニカル、マクロ、ポートフォリオの視点を持つこと ✅ 不確実性の表示 — 偽の精密さではなく、レンジ、対立する見方、「検証不能」フラグを示すこと ✅ 再確認のコスト — ポジションを積み増す前に実際に相互検証が行われるほど、安価であること
実務上有用なルールは、不一致をシグナルとして扱うテストです。モデルの合意は仮説として扱い、モデルの対立は調査課題として扱います。本稿ではこのテストを、単一モデルのチャットボット、Danelfinのような目的特化型スコアラー、Perplexityのような引用優先型リサーチツール、そしてJenovaの株式専門エージェントに適用します。
投資家が単一のAIモデルを使うとき、なぜ過信は続くのか?
過信が続くのは、単一モデルが洗練された一つの物語を返し、その物語の完成度が、通常なら再確認を促す摩擦を抑え込むためです。行動ファイナンスでは、過信を性格上の欠点ではなく、体系的なバイアスとして扱います。市場では、過剰売買、集中した賭け、反対証拠の無視として現れます。
分析者がAIになっても、このパターンは消えません。取引における過信と確証バイアスに関する研究は、このバイアスをより多い売買回転、薄い分散、低いリターンと結び付けています。AI時代の投資家行動に関する2025年レビューでは、裁量による上書きがアルゴリズムの効率向上を打ち消し、ボラティリティを下げるどころか高めうると指摘しています。さらに新しい研究は、アルゴリズムによる過信を説明しています。分析をモデルに委ねると、利用者は出力を実際以上に客観的なものとして扱うようになります。
単一モデルのセッションは、三つの仕組みでこれを悪化させます。第一に、モデルは首尾一貫性に報われるため、欠落を知らせるより補完します。第二に、利用者には同業者間の不一致が見えません。しかし、この不一致こそ機関投資家が信頼区間を広げる手掛かりにするものです。第三に、インターフェースは会話型であるため、誤った数字であっても自信に満ちた文章で提示されます。AIに関する米国SECの投資家向け警告はこの点を明確に述べています。AIは虚偽または不正確な情報を生成・拡散しうるため、投資家は登録専門家を通じて主張を検証すべきです。
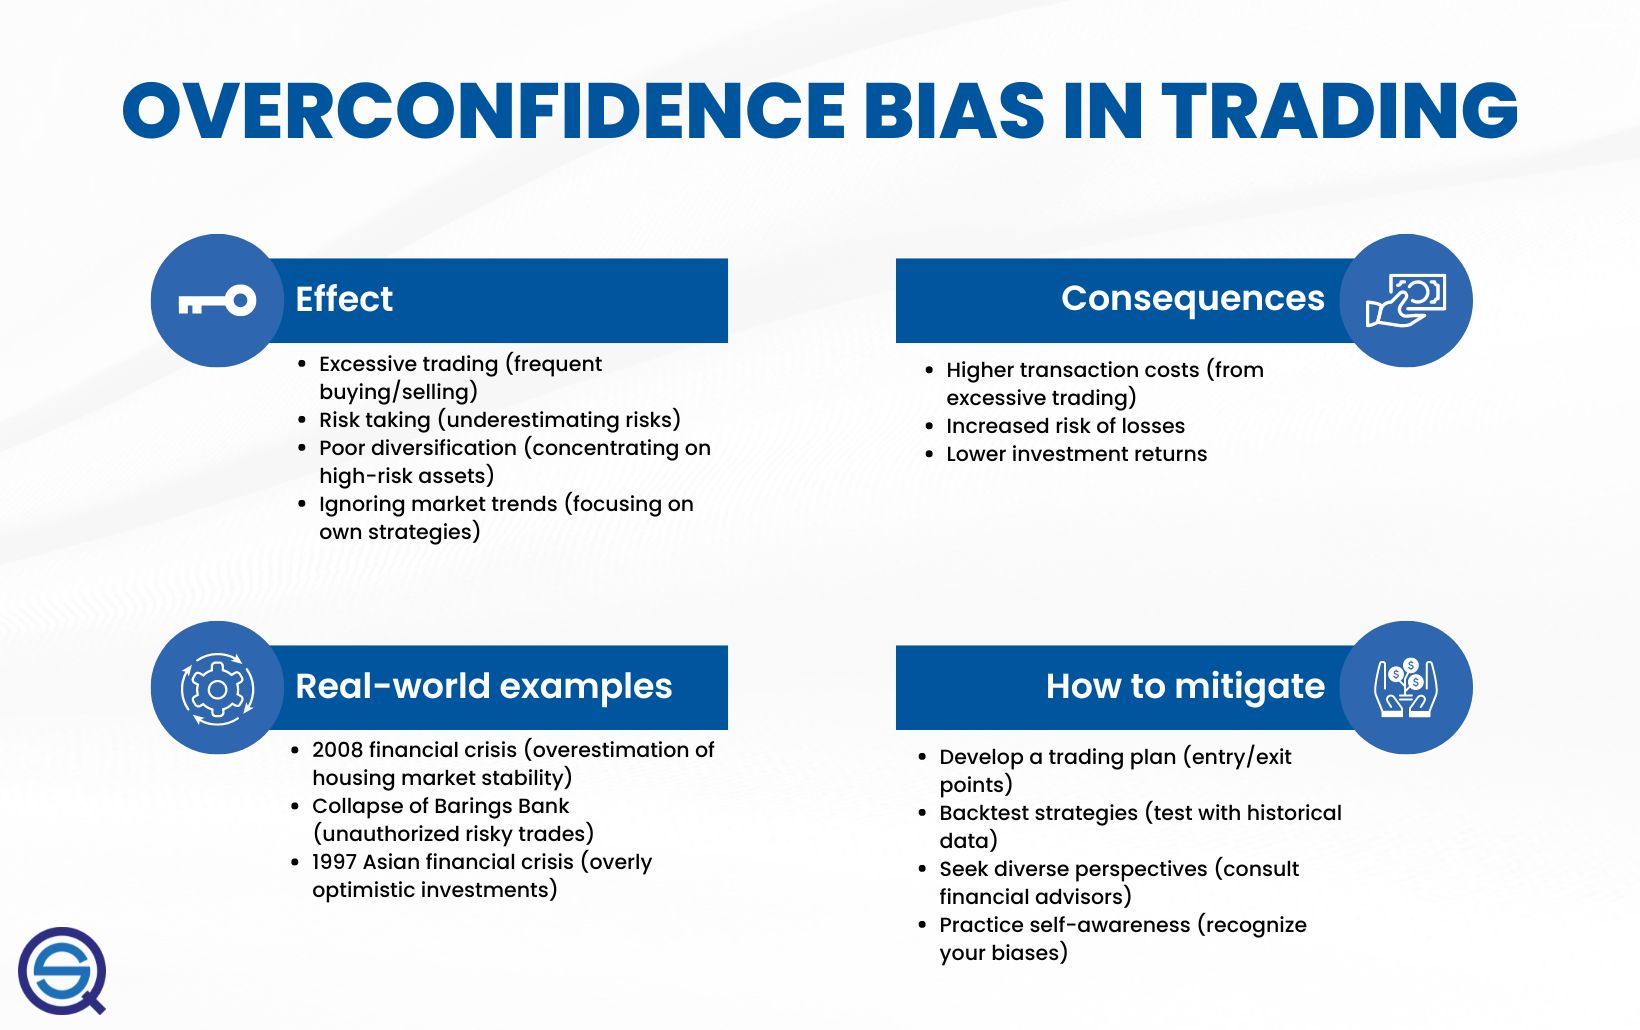
古典的な緩和策である、書面化した計画、過去データによるテスト、多様な視点は、リサーチアーキテクチャにそのまま対応します。単一モデルは計画を書く支援にはなりますが、それ自体が多様な視点になることはできません。
単一モデルとマルチモデルの株式分析を比較する際、何を評価すべきか?
どのインターフェースが賢そうに聞こえるかではなく、六つのカバレッジ層を評価すべきです。これを6層の盲点監査と呼びます。これは、あらゆるティッカー、ツール、投資期間に使える実践的なチェックリストです。
1. 情報源への接地。 システムは最新のSEC提出書類、予想、価格を取得しているのか、それともカットオフ日時点までのテキストを補完しているのか。Openbook Analyticsは、一般的なチャットボットには最新の市場データがなく、生成した数値を検証できないと指摘しており、PerplexityのCEOもプラットフォーム上の市場データが古いことを認めています。
2. モデルの多様性。 一つのベンダーは一つの失敗モードを意味します。GPTクラスの出力をClaude、Gemini、DeepSeekと相互検証することは、プロンプト、データ、役割が実際に変わる場合にのみ有用です。同じ古いプロンプトでブランドだけを入れ替えても、多様性にはなりません。
3. 役割の多様性。 ファンダメンタル分析、値動きと構造の分析、マクロのオーバーレイは、それぞれ異なる誤りを捉えます。これはチャットボットのスレッドというより、リサーチ会議に近いものです。
4. 不確実性の表現。 単一の目標株価ではなく、レンジ、対立するシナリオ、明示的な「未検証」フラグを優先します。
5. 継続性。 投資仮説の検討は数週間に及びます。先週火曜日の代替見解を忘れるツールは、次のセッションで再び過信を膨らませます。
6. 検証1回当たりのコスト。 二つ目のモデルによる確認が高価または扱いにくければ、ポジションが最も大きい局面でこそ省略されます。
証券業界におけるAIに関するFINRAのレビューは、同じ論点を規制上の言葉で示しています。すなわち、モデルリスク管理、説明可能性、データ完全性、監督統制です。企業には、Regulation Best InterestおよびFINRA Rule 2111の下で投資助言ワークフローにモデルを依存する前に、そのモデルがどのように結論を出すかを理解することが求められます。個人投資家にはRule 3110のプログラムはありません。それでも同等の習慣は必要です。モデルに何が見えていないかを知ることです。
金融LLMにおける外国バイアスを扱った2025年のHarvard Business Schoolの論文は、より静かな失敗モードを示しています。情報は学習データに存在しない場合もあれば、存在していても過小評価される場合もあります。米国中心の二つのモデルが新興市場銘柄について「合意」しても、同じ空白を共有している可能性があります。
ChatGPT、Danelfin、Perplexity、Jenovaは盲点のカバレッジにおいてどう異なるのか?
これらの違いはまず、一つのスコア、一つの引用付きブリーフ、あるいは反証可能なリサーチファイルのどれを生み出すかにあります。ChatGPTは思考のパートナーとして最も強く、数値エンジンとしては最も弱いツールです。Danelfinは透明性のあるスクリーナーとして最も強く、複数役割による議論には弱い傾向があります。Perplexityは引用付きの抜粋を取得することに最も強く、その抜粋が古い場合には弱くなります。JenovaのFundamental Stock Analystは、投資仮説に利益、バリュエーション、センチメントを統合し、その後に他モデルまたは専門エージェントから反論を加える必要があるときに最も力を発揮します。
Openbook Analyticsは過去のテストを要約し、ChatGPTは金融・投資に関する質問のおよそ35%で誤答したと報告しています。また、一部の評価ではGeminiの金融情報におけるハルシネーション率が88〜91%に達したとしています。これらの数値は言語モデルを使わない理由ではありません。一つの言語モデルに投資仮説の結論を出させない理由です。
| 機能 / 観点 | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| 主な出力 | 文章による説明 | 説明可能なAI Scoreと特徴量 | 引用付きWeb回答 | 提出書類に基づくファンダメンタルメモ |
| 最新 / 検証済み市場データ | 弱い。カットオフに制約 | スコアリング対象ユニバース向けに構築 | 引用付きだが古い可能性あり | SEC提出書類、予想、センチメント |
| マルチモデル相互検証 | 手作業、複数アカウント | 単一の独自システム | マルチモデル検索、一つのブリーフ | 複数プロバイダーと専門エージェントを標準搭載 |
| 不確実性の扱い | 標準では自信に満ちた文章 | スコアと特徴量の寄与度 | 引用はあるが残余リスクは限定的 | 対立するシナリオ、モデル不一致、メモリ |
| 料金(2026年時点) | 約$20/月の有料プラン | 本レビューでは未検証 | $20/月のPro、無料枠あり | 無料枠、月額$20からの有料プラン |
| 最適な用途 | 概念確認、弱気シナリオの下書き | 既知のリストのスクリーニングとタイミング判断 | 出所付きの事実を素早く確認 | 相互検証した株式リサーチ |
ChatGPT
ChatGPTは、10-Kの一節を平易に読み替える、業界構造を列挙する、弱気シナリオを平易な言葉で強制的に考える、といった用途で依然として有用です。2026年の4モデル比較では、最新データ端末ではなく、汎用ツール群に位置付けられています。その制約は構造的です。記憶に基づいても、きれいなマージン・ブリッジを書いてしまいます。これこそ、リサーチノートに過信が入り込む経路です。
Danelfin
Danelfinは異なる製品です。チャットではなくAI Scoreを公開しています。同社によれば、AI Scoreが10/10の米国株は、2017年以降、3か月後の年率換算アルファで市場を21.05%上回った一方、1/10の銘柄は33.28%下回りました。また、AI Score戦略は2017年1月3日から2025年6月9日までに376%のリターンを上げ、S&P 500の166%を上回ったとしています。説明可能な特徴量は、ブラックボックス型スコアリングに対する真の解毒剤です。ただし、その限界は補完的です。スコアはユニバース内で順位付けできても、このポジションを壊す特定の会計、セグメント、政策リスクをストレステストするとは限りません。
Perplexity
Perplexityは引用レイヤーとして価値があります。Helm Terminalの2026年比較では、最新の引用付き事実と金融機能で先行しているとされる一方、深い提出書類の統合ではClaudeが先行しています。制約はCEOがすでに指摘したとおりです。引用の鮮度は、参照先ページの鮮度を超えられません。Perplexityを提出書類ネイティブなワークフローと相互検証することは、引用数を証明として扱うより価値があります。
Jenova Fundamental Stock Analyst
JenovaのFundamental Stock Analystは、利益、相対バリュエーション、ビジネスモデルの分析、そして提出書類、予想、センチメントを横断するリアルタイムデータを扱う株式専門ツールとして設計されています。Jenovaプラットフォームでは、OpenAI、Anthropic、Google、DeepSeek、xAIのモデルで再実行でき、すべてを兼ねるふりをするのではなく、ほかの専門家と並べて利用できます。永続メモリにより、前回の不一致が検討対象に残ります。
ここでは率直な限界も重要です。Jenovaは、Danelfinの2017〜2025年の実績に匹敵する長期の複合スコアを公表していません。マルチモデル実行は単一パスより多くの利用量を消費します。回答の対立は認知負荷を増やし、利用者は結局10-Kを開かなければなりません。これらは実在するコストです。しかし、流暢さをデューデリジェンスと取り違えないためのコストでもあります。
マルチエージェントのオーケストレーションは、ファンダメンタル株式リサーチをどう変えるのか?
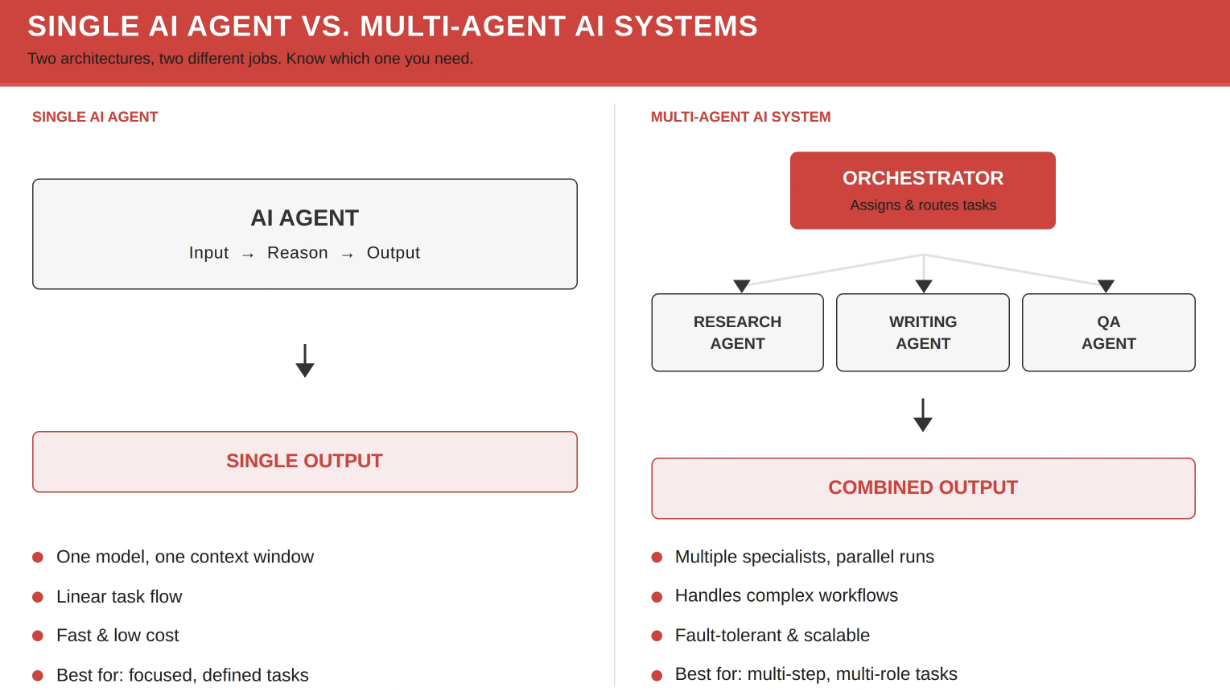
オーケストレーションは仕事を「一人の分析者に聞く」ものから、「小さなデスクを編成し、ファイルをすり合わせる」ものへ変えます。単一エージェントは、入力、推論、出力という直線的な経路をたどります。これは速く、安価で、問いが限定的な場合には適切です。マルチエージェント構成では、オーケストレーターが調査、執筆、品質レビューの専門家に作業を割り振り、統合成果物を返します。このアーキテクチャは遅く、コストも高くなります。しかし、一つの雄弁な誤りがメモ全体になってしまうことを防ぐ手段でもあります。
株式リサーチでは、対応する分担は抽象的な「調査/執筆/QA」ではありません。次のとおりです。
- ファンダメンタル: 利益の質、ユニットエコノミクス、バリュエーション、資本配分
- テクニカル: 構造、出来高、モメンタム、無効化水準
- マクロ: 政策、金利、クロスアセットのレジーム
- ポートフォリオ: サイズ、相関、ドローダウン、そのアイデアがこのポートフォリオに属すべきか
JenovaのFundamental Stock Analystは最初の役割を担います。これをTechnical Stock AnalystおよびMacro Strategistと組み合わせることが、マルチエージェントQAの実践形です。一つのモデルがストーリーを好み、一つが値動きと需給は崩れていると指摘し、もう一つが金利経路によってマルチプルが崩れると指摘するなら、それは失敗した問い合わせではありません。完全なリスク会議です。
株式チャットボット以外のアンサンブルに関する証拠も、同じ方向を示しています。Survey of Professional ForecastersのデータにおけるLLMアンサンブルを扱った2025年のarXiv研究では、LLMの組み合わせは複数の短期指標で単純平均を上回り、専門家間の不一致が大きいときにもより有用であることが示されました。その仕組みは魔法ではありません。アンサンブルは直近で不正確だった専門家の重みを下げ、遅行する改定を調整し、すべての意見を同じ重みで扱うことを拒みました。これは、一つのチャットボットに目標株価を尋ねて終えることの正反対です。
ブラックボックスモデルと説明可能性に関するFINRAの見解は、個人向けのワークフローにも関係します。強気シナリオが二つ目のモデルと二つ目の役割の検証に耐えた理由を説明できなければ、投資プロセスを持っているとは言えません。あるのは会話ログだけです。
テクニカル、マクロ、ポートフォリオのエージェントは、単一モデルが見落とすものを捉えられるか?
はい。これらはカテゴリーエラー、つまりファンダメンタル分析だけのモデルが構造的に気付きにくい誤りを捉えます。きれいな複利成長企業の物語を書いたばかりの言語モデルが、その株価が行き過ぎていること、そのセクターが金利デュレーションへの純粋な賭けであること、あるいはすでに保有するファクターを重複させていることを、自発的に指摘することはほとんどありません。
役割ごとに見落としやすい論点は次のとおりです。
- テクニカル担当。 ファンダメンタルモデルは価値判断では正しくても、1年早すぎることがあります。価格構造、失敗したブレイクアウト、出来高のダイバージェンスは脚注ではありません。これらはタイミングと無効化の問題です。Technical Stock Analystは、市場構造、モメンタム、定義されたリスクを中心に設計されています。
- マクロ担当。 政策レジームを無視する個別株DCFは、隠れた金利仮定を持つスプレッドシートです。Macro Strategistはクロスアセットの統合と政策分析向けに設計されており、多くの「個別要因」のストーリーが実際に崩れるのはこの領域です。
- ポートフォリオ担当。 単体では素晴らしいアイデアでも、ポートフォリオへの追加としては悪いことがあります。ドリフト、ストレス、相関はポートフォリオ層に属し、JenovaのPortfolio Management Strategistの役割です。
ここは、単一スコアのプラットフォームと単一チャットモデルが共通の盲点を持つ場所でもあります。Danelfinのスコアは順位の背後にある特徴量を透明に示せても、あなたのポートフォリオがすでに同じファクターをロングしているかどうかまでは示しません。ChatGPTは抽象的にリスクを列挙できても、同じ金利感応度を持つソフトウェア銘柄をすでに三つ保有していることは知りません。複数役割でのレビューによって、こうした誤りが表面化します。
制約は世界観の相関です。すべてのエージェントに強気前提のプロンプトを与える、あるいはすべてのモデルに同じ二次的なブログ記事を与えるなら、それは見せかけにすぎません。役割の多様性が機能するのは、テクニカルエージェントに取引を否定する自由があり、マクロエージェントにマルチプルを再評価する自由があり、ポートフォリオエージェントにサイズをごく小さく削る自由がある場合だけです。
株式の投資仮説に対して、マルチモデルの相互検証をどう実行するのか?
長いチャットとしてではなく、4パスのファイルとして実行します。目的は意図的に不一致を生み出し、それを解決するにはどの証拠が必要かを決めることです。
パス1 — 事実を接地させる。 Fundamental Stock Analystに、出所付きのスナップショットだけを依頼します。直近二つの報告期間、ガイダンス、セグメント構成、純有利子負債、自社株買い、事業に適したバリュエーションマルチプルです。このパスでは目標株価を禁じます。
「[TICKER]について、最新の10-K、10-Q、直近二回の決算説明会を用い、セグメント別売上高、粗利益率と営業利益率、FCF、純有利子負債、希薄化後株式数を抽出してください。すべての数値について、提出書類または決算説明会の根拠を引用してください。数値を出所確認できない場合は、Unverifiedと記載してください。」
パス2 — 問いではなくモデルを変える。 同じ抽出を二つ目のプロバイダーで再実行します。報告数値に重要な差があれば、それは「スタイル」の違いではありません。データ完全性の問題です。パス3へ進む前に、自分で提出書類を確認してください。
パス3 — 他の役割を配置する。 同じティッカーをTechnical Stock Analystに送り、無効化水準を確認します。さらにMacro Strategistに送り、マルチプルに埋め込まれた金利、FX、コモディティの仮定を確認します。
「強気のファンダメンタルメモは無視してください。投資仮説が最終的には正しかったとしても、この銘柄を保有する価値がなくなる価格水準とマクロレジームを特定してください。」
パス4 — 書面による反対意見を強制する。 いずれか一つのモデルに、同じ分量、同じ水準の出所で反対側を論じさせます。Lucid.nowの行動ファイナンスに関する解説は、人間によく見られるパターンとして、予測能力の過大評価、過剰売買、好みのストーリーへの集中を指摘しています。必須の反対意見は、「分析者」もモデルである場合にこのパターンを断ち切る方法です。
ChatGPTまたはClaudeだけでも、二つ目の製品を開いて同じ出所付き抜粋を貼り付ければ、パス2とパス4はある程度再現できます。ただし、ツールにその機能がなければ、最新の提出書類取得や数週間にわたる永続メモリを再現することはできません。Danelfinでは、パス1はスコアと特徴量リストによって一部自動化されていますが、パス3とパス4には別のリサーチ画面が必要です。
Jenovaの料金はティア全体で利用量ベースです。限定利用の無料プランから始まり、利用枠の増加に応じて月額$20、$50、$100、$200、$500、$1,000となります。4パスの検証は一回のチャットより高くつきます。意味のある規模のポジションであれば、それでもより安い誤りです。
市場の実務家は、リサーチにおけるAIの過信をどう見ているのか?
これらのツールを日々使う実務家は、単一モデルの確信を「より優れた」モデルの特性ではなく、プロセス上の失敗として扱う傾向があります。
「私たちが目にする最も高くつくミスは、誤った数字そのものではありません。二つ目のモデルに一度も検証されなかった、もっともらしい数字です。三つのプロバイダーが、どれも10-Qと照合できないマージン・ブリッジで一致するなら、その一致こそが警告です。根拠の残らない一つの目標株価よりも、二つの対立するレンジとUnverified項目の一覧を含むメモを出す方を選びます。」
「マルチモデルが自動的に安全になるわけではありません。GPT、Claude、Geminiに同じ雑な質問をすれば、多くの場合、形容詞だけ違う同じ雑な回答が返ります。多様性は設計しなければなりません。異なる役割、異なるデータ取得、そして反論を求める恒常的な指示です。そうでなければ、トークンコストを3倍払って、相関した過信を買うことになります。」
「デスクでは、不一致が次に何を読むかを決める手掛かりです。ファンダメンタルとマクロが対立すれば金利仮定に戻ります。ファンダメンタルとテクニカルが対立すれば、タイミングとサイズに戻ります。すべての役割があまりに早く一致するなら、そのファイルは薄いと考えます。この習慣はLLMより古いものです。モデルはそれを省略しやすくしただけです。」
— Jenova Product Team、株式エージェントの設計・評価および複数年にわたるマルチモデル調査ワークフローの取り組み
この姿勢は、AIツールが投資助言に影響する前にテスト、フォールバック計画、部門横断的な監督を重視するFINRAの考え方と一致します。また、アンサンブル予測の結果とも整合的です。入力が対立し、それらの重み付けルールを誰かが持つときに、組み合わせの効果は最も大きくなります。
それでも単一モデル分析がより良い選択となるのは、どのような場合か?
タスクが限定され、誤りのコストが低く、残余リスクより速度が重要な場合、単一モデル分析は依然としてより良い選択です。マルチモデルの相互検証は制御システムです。ROICを定義するため、あるいは事業を二段落で要約するために制御システムは必要ありません。
単一モデルで通常十分なのは、次のような場合です。
- ポジションを取るのではなく、概念を学んでいる
- すでに提出書類を開いており、読むための補助だけが必要
- バリュエーションを計算するのではなく、スクリーニングの文言を扱っている
- より遅く出所を確認するワークフローの前に、最初のアウトラインが必要
- 追加のモデル呼び出しが意思決定を変えない
Openbookの2026年ガイドも同じ区分を示しています。一般的なチャットボットは出発点であり、主要なリサーチエンジンではないというものです。Danelfinのスコアは単一のシステムですが、専門特化したシステムです。それをスクリーニングに使って銘柄の検証を終えるなら、誰もその銘柄に異議を唱えていないという意味で、なお単一モデルの判断です。Perplexityは数分で引用経路が必要で、一次情報源を自分で検証する場合に適した単一パスです。
失敗モードは、高価な意思決定に安価なパスを使うことです。過信はAIによって引き起こされるものではありません。最初に首尾一貫した回答でプロセスを終えることによって引き起こされます。米国金融規制当局のガイダンスに関するSidleyの2025年要約は、企業がすでにAIを神託ではなく、監督対象の活動として扱う必要があることを強調しています。検査官に問われない場合でも、個人投資家はこの原則に従うべきです。
簡潔な判断ルールはこうです。誤ればポジションサイズが変わるなら、少なくとも二つのモデルと二つの役割を使います。誤ってもノートの一文が変わるだけなら、優れた一つのモデルで十分です。
規制とモデルリスクは、AIリサーチのワークフローをどう形作るべきか?
規制とモデルリスクは、モデルが何を言ったかだけでなく、何を見ていなかったかを記録するよう促すべきです。FINRAのAIに関する議論はブローカー・ディーラー向けに書かれていますが、その統制テーマは転用できます。モデルリスク管理、データガバナンス、説明可能性、監督が存在するのは、一見自律的なツールが相関した形で失敗するためです。
個人のリサーチプロセスに転用できる統制は小さなものです。
- 一次情報源をファイルに残す。 モデルが10-K、10-Q、8-K、または決算説明会のトランスクリプトを示せないなら、その主張は下書きです。
- 不一致を記録する。 「Claudeはマージン圧縮を見る、Geminiは見ない、10-Qの37頁は未解決」という一行のログは、強気シナリオを再生成するより役立ちます。
- 助言と説明を分ける。 チャットボットは適合性判定エンジンではありません。FINRAは、推奨を生成するAIツールが会員企業においてRegulation BIとRule 2111の対象となると指摘しています。個人投資家はモデル出力を、個別化された推奨ではなく分析として扱うべきです。
- 反証されるまで共有バイアスを前提にする。 HBSの外国バイアスに関する結果は一例です。二つのモデルが同じ非米国の事実を見落とすことがあります。現地の提出書類、第二言語の情報源、または人間の専門家こそが真の分散です。
- Unverifiedと言えるツールを優先する。 偽の精密さが見分ける手掛かりです。常に段落を完成させるシステムは、「より分析的」なのではありません。監督がより弱いのです。
これらに機関投資家向けの予算は必要ありません。Bloomberg級の端末は依然として別のコスト領域にあります。Openbookは、Bloombergの一般的な料金が年間$25,000超であると述べています。実際に過信を減らす統制はもっと安価です。二つ目のモデル、二つ目の役割、そして情報源のない合意ではサイズを増やさないというルールです。
単一モデルの株式分析は下書きツールです。マルチモデル・複数役割の相互検証は盲点を見つけるツールです。前者でファイルを始め、後者でファイルが完成したかを判断してください。
参考文献
- Openbook Analytics — 2026年版:最良のAI株式分析ツール
- Investopedia — 行動ファイナンス:バイアス、感情、投資家行動
- Preprints.org — 取引における過信と確証バイアス
- ResearchGate — AI時代の投資家の過信:人間とアルゴリズムによる意思決定
- SSRN — 株式市場の投資家行動:AIとアルゴリズムによる過信の出現
- Investor.gov — AIと投資詐欺:投資家向け警告
- FINRA — 証券業界におけるAI:主要な課題と規制上の考慮事項
- Harvard Business School — LLMが海外へ向かうとき:AI金融分析における外国バイアス
- Danelfin — AI Stock PickerとAI Scoreの方法論
- AI Business Weekly — 2026年AI料金ガイド:ChatGPT、Claude、Gemini
- Perplexity — 個人および企業向け料金
- Helm Terminal — 株式リサーチにおけるChatGPT vs Claude vs Gemini vs Perplexity
- arXiv — LLMは専門家予測の組み合わせを改善できるか?
- Lucid.now — 金融上の意思決定におけるAI:行動インサイト
- Sidley Austin — AI:米国証券・商品規制当局のガイドライン