キャラクターボイスジェネレーター:ゲーム、物語、映像向けAIボイス
2026-09-06
Jenovaは、際立つキャラクターの設計、声に出して自然な台詞の執筆、あらゆるキャラクターボイスジェネレーター向けの実制作対応プロンプト作成を支援します。2026年9月時点で、AI音声システムは数秒で声質を再現できます。それでも、多くの出力がありきたりに聞こえるのは、土台となる文章に人格がないためです。インディーチームにとってスタジオ収録は依然として時間も費用もかかり、薄いテキスト読み上げ処理では、すべての役が同じ話し方に平板化されてしまいます。
- ✅ 長編ストーリーやゲームループを通じても一貫するキャラクター性
- ✅ ページで読むためだけでなく、実際に話すために書かれた台詞
- ✅ 現代の音声モデルとローカライズに対応した構造化プロンプト
- ✅ 脚本、コミック、音楽、ロールプレイを一つのクリエイティブワークフローで支援
なぜこれが重要なのかを理解するには、制作者がキャラクターボイスジェネレーターに本当に必要としているものを見る必要があります。それは「喜び」と書かれたスライダーがもう一つ増えることではなく、誰かのものだと感じられる声です。ボトルネックになるのは音声レンダラーであることはほとんどありません。問題はキャラクター作り、台詞の読み方、そしてオリジナルの演技と無許可の模倣を隔てる倫理的な境界です。
要点:キャラクターボイスジェネレーターとは?
キャラクターボイスジェネレーターとは、役ごとに別人のように聞こえる、個性に即した固有の音声を生成するAIシステムです。 制作者はゲーム、物語、動画、アクセシビリティのために利用しますが、キャラクター自体が明確でなければ、その声は機能しません。
主な機能:
- キャラクターごとに異なる声質、話す速さ、感情表現の幅
- GPSのように聞こえない、テキスト読み上げに耐える脚本とプロンプト
- 生成前にキャラクターの一貫性を固定したロールプレイ
- 本人の同意なしに実在人物をクローンしない、オリジナルキャラクター中心のワークフロー
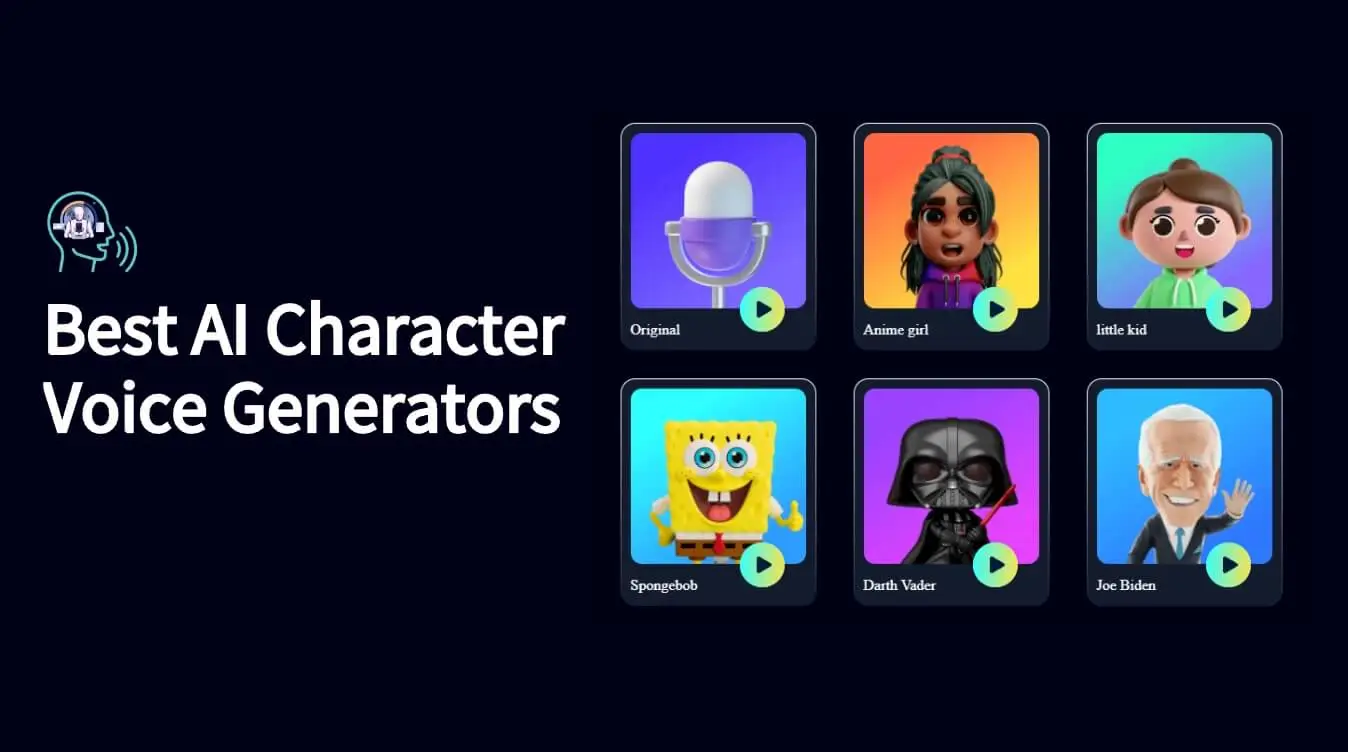
なぜ多くのキャラクターボイスジェネレーターは今もありきたりに聞こえるのか
合成音声への需要は、もはや実験段階ではありません。調査会社は現在、AI音声生成をチャットボットの付加機能ではなく、独立した市場として追跡しています。
190.9億米ドル — 2025年の音声・音声認識市場。2026年には237億米ドルと予測
この投資はゲーム、ローカライズ、ソーシャル動画、顧客向け音声へ流れています。AI音声の利用は2025年に9倍へ成長し、調査対象組織の84%が音声技術予算を増額する計画でした。しかし、音声レンダラーを購入しても演技は手に入りません。オーディエンスの記憶に残る声へ到達することは、今なお驚くほど難しいのです。
- すべてのキャラクターが同じリズム、息づかい、「親切なアシスタント」調を引き継いでしまう
- NPCのロングテール、YouTubeの出演陣、週刊Webtoonの吹き替えに対して、スタジオ収録は遅すぎて高価すぎる
- ページ用に書かれた台詞は発話時に崩れる。節が積み重なり、ジョークは死に、名前は不自然に発音される
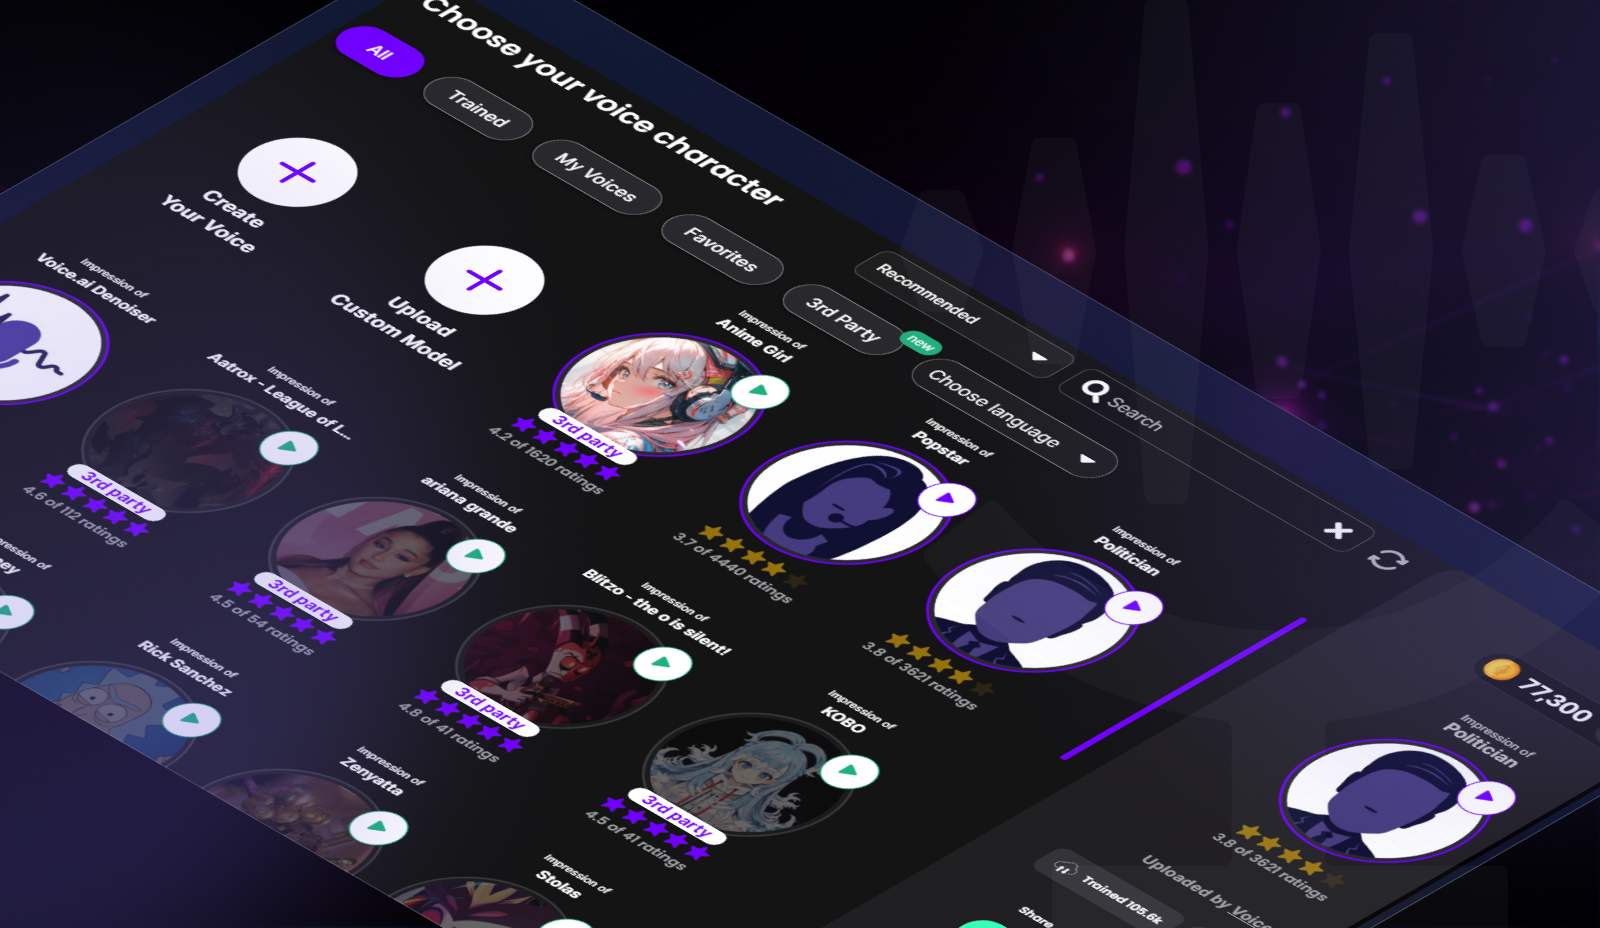
- 有名人や政治家のクローンは、UIからワンクリックで利用できても、法的リスクと信頼リスクを生む
- ライター、プロンプトエンジニア、作曲家、音声ツールを使い分けながら、共有されたキャラクターバイブルを持てないチームが多い
同じ声で、違うネームプレート
キャラクターボイスジェネレーターは音程を変えられても、アイデンティティの表現に失敗することがあります。聞き手が捉えるのは周波数だけでなく態度です。悪役が子音を引き延ばす様子、子どもがジョークを急いで言う様子、疲れた船長が報告の終わりで声量を落とす様子です。コミックから感情を認識してキャラクター別音声を作る研究とテキスト駆動の複数キャラクター音声生成研究は、同じ結論を繰り返し示しています。モデルに必要なのは波形の目標だけではなく、キャラクターの文脈です。書かれた人格がなければ、得られるのは演技ではなく衣装にすぎません。
インディー・中規模チームを阻むコストの壁
感情的に複雑なシーンでは、今も人間の主演俳優が主役を担います。制作上の課題はロングテールです。何千ものNPCの挨拶、ローカライズ版、プレイヤー名の発音などが該当します。ゲームにおける倫理的AI音声の業界分析では、「人間プラス」という分担、つまり主役シーンは俳優、大量部分は合成音声という役割が説明されています。また、インディーチームは数か月ではなく数週間で数十言語へローカライズできるようになったとも指摘されています。ただし、その恩恵を得られるのは、元となる台詞が話しやすく、キャラクターシートが安定している場合だけです。そうでなければ、平凡な音声を大量生産するために費用を払うことになります。
そもそも聞かれるために書かれていない脚本
小説的な文章やUIコピーは、口で話すことと相性が悪いものです。入れ子のような節、説明のない略語、発音しにくいファンタジー名は、モデルに機械的なアクセント配置を強います。キャラクターボイスジェネレーターは、悪い台詞も忠実に読み上げます。解決すべき場所は上流です。短いビート、発音表記、感情のト書き、そして演者が実際に一息で言える台詞が必要です。
同意、クローン、そして問題を招くプラットフォーム
ゼロショットシステムは、約3秒で声質を再現できます。この速度は、同意を得たレプリカやオリジナルキャラクターには有用です。しかし、ライブラリが公人や著作権で保護されたマスコットをプリセットとして表示する場合は危険です。FTCは、既存の消費者保護法にAIだけの免除はないと明確にしています。また、Voice Cloning ChallengeとImpersonation Ruleを通じ、欺瞞的な音声への対策を進めています。ゲーム業界では、2025年7月のInteractive Media Agreementが95.04%の賛成で可決され、音声複製には書面による同意が不可欠となりました。パイプラインで同意を証明できないなら、その音声を生成してはいけません。
これこそが、Jenovaが構築された理由です。法律を回避する近道ではなく、ジェネレーターを取り巻くキャラクターインテリジェンスのためのプラットフォームです。
Jenovaのソリューション
キャラクターボイスジェネレーターはテキストを音声に変えます。Jenovaは、そのテキストを声にする価値のあるものにします。誰が話しているのか、どう考えるのか、絶対に言わないことは何か、そして台詞をどう響かせるべきかを定義し、使用する音声モデルへ明快なプロンプトと脚本を渡せます。専門の音声プラットフォームが波形をレンダリングする一方で、このプラットフォームは波形の背後にいる人物を構築します。
| 従来のアプローチ | Jenova |
|---|---|
| ブースを予約し、収録を待ち、追加収録のたびに編集し直す | 一回の作業セッションでキャラクターシートと発話しやすい原稿を作成 |
| 表示名だけ変えた一つのTTS音声 | 役ごとに人格、言葉遣い、感情のビートを設計 |
| 有名な声をクローンし、気づかれないことを願う | オリジナルキャラクター、同意済みレプリカ、記録された利用方法 |
| ライターは一つのタブ、プロンプトメモは別タブ、作曲家はさらに別タブ | 物語、プロンプト、コミック、音楽、納品をつなぐエージェント |
| ユーモアやタイミングを無視する平板なローカライズ | 音節への収まりと文化的な再構成を考慮した台詞 |
音声に触れる前にキャラクターバイブルを作る
プリセットではなく、アイデンティティから始めましょう。Name Generatorは、文化的な整合性があり発音しやすい名前を作成します。これは、多くの音声パイプラインが、モデルが子音の連続につまずくまで見落とす実用的なフィルターです。これをWriting Assistantと組み合わせ、語彙の上限、禁句、繰り返し使うジョーク、キャラクターがいつも頼る比喩表現など、言葉遣いを固定します。こうした制約があれば、どのキャラクターボイスジェネレーターにも具体的に演じる対象が生まれます。
口のために作られた台詞
Film Screenwriterは、台詞を中断、沈黙、サブテキストを持つ時間的な行動として扱います。この技術はゲームの短い掛け声、縦型ドラマ、吹き替えコミックへ直接応用できます。「悲しい」のような曖昧なラベルではなく、音声モデルが従えるト書き、たとえば「小声で、その後少し明るく」を得られます。連載モバイルストーリー向けには、Microdrama Screenwriterが、息継ぎなしでも声に出せる短さのクリフハンガーを維持します。
ジェネレーターに貼り付けられる指示例:
「50代のイリヤ・ヴォス船長として読む。胸の奥で鳴る低いかすれ声。彼女は怒っても声量を上げない。代わりに、ゆっくり話す。台詞:『地図は持ってきた。だが、天気は持ってこなかった。』 『地図』の後で間を置く。笑わない。」
モデルに渡しても機能するプロンプト
多くの「ひどいAI音声」は、ひどい指示から生まれます。Prompt Generatorは、キャラクターバイブルをモデル対応の文章に変換します。訛りに関するメモ、年齢、収録空間、感情の流れ、ネガティブプロンプト(「アナウンサー調なし、母音で笑わない」)などです。これは「アニメ少女」とだけ書かれたライブラリカードと、たまたまアニメーションで描かれている一人の人物との違いです。
絵、音楽、そしてシーンの残りすべて
声は一つのレイヤーです。Graphic Designerは、耳が期待する顔を作ります。Manga Creator、Comic Creator、Webtoon Creatorは、口の動きとコマのリズムに音楽を付けられる連続アートを制作します。Music Composition AssistantとLyric Writerは、キャラクターにモチーフと歌いやすい歌詞を与え、話し声と歌が同じ世界に属するようにします。
専門の音声APIが音声レンダリングに特化する一方、Jenovaは、人がその音声を二度聞きたいと思うかを決める文章、プロンプト、一貫性に特化しています。
キャラクターボイス制作のための専門AIエージェント
Jenovaを無料で試せます。クレジットカードは不要です。以下のエージェントは、キャラクターボイスジェネレーターの直前と直後に位置する作業をカバーします。
Roleplay Game Master
合成する前に、言葉の中でキャラクターを聞きたいなら、ここがリハーサル室です。無制限のメモリにより、セッションをまたいでも言葉遣い、秘密、関係性を安定させられます。これは、音声モデルを固定することのテキスト版に相当します。
- 決め台詞を、必然に聞こえるまで検証
- 長期キャンペーンでもパーティーとNPCの声を分離
- ジェネレーターにそのまま投入できるキャラクターらしい台詞を作成
Film Screenwriter
声が雰囲気だけでなく、物語を運ばなければならないときに使います。構成、シーンの目的、台詞作りによって、演技が面白い訛りによる説明台詞へ変わることを防ぎます。
- 音声における感情変化を正当化するビートと対立
- ゲームや広告向けの、追加収録しやすい短い台詞
- 12話の吹き替えを通じても維持されるキャラクター成長
Prompt Generator
音声モデルの品質は、ブリーフの質を超えられません。このエージェントは、すでに料金を支払っている音声モデルを含め、テキスト、画像、音楽、動画システム向けのプロンプトを書きます。
- エピソード間の一致を保つ、キャラクター別の一貫したプロンプトブロック
- モデルが実際に従う感情と空間の記述
- テイクが明るすぎる、または遅すぎるときの反復的な改善
Writing Assistant
キャラクターバイブル、ナレーション、「このキャラクターらしく聞こえるべき」書き直しの主力ツールです。形式とオーディエンスに適応するため、設定説明と酒場での侮辱が同じ文のリズムになることはありません。
- 発話しやすさと読解レベルの編集チェック
- クエストテキスト、トレーラー、パッチノートにまたがるトーン調整
- ほぼ機能している既存原稿を持つ場合の共同作業
Music Composition Assistant
キャラクターボイスジェネレーターが担当するのは会話です。このエージェントは、その下に流れるモチーフ、和声、アレンジの指示を扱い、DAWや別のモデルへ渡せます。
- 特定の役に結びついたライトモチーフ
- 台詞のための余白を残すテンポマップ
- 悪役のテーマが声域と衝突しないようにする、音楽理論に基づくガイダンス
Public Speaking Coach
自分が演者である場合、または演者を演出する必要がある場合、このエージェントは話し方、不安、オーディエンスへの向き合い方を扱います。これは合成音声に対する人間側の対応物です。呼吸、間、強調を整え、それをプロンプトへエンコードできます。
- TTSタグへ転用できる速度とアクセントのマーク
- ハイブリッド配信に向けたQ&Aと朗読のリハーサル
- ただ音がどう聞こえるかではなく、台詞が聞き手に何をしているかの指摘
キャラクターボイスジェネレーターのワークフローは実際にどう進むのか
最初に必要なのはスタジオではありません。ページ上の人物、口にできる台詞、そして矛盾しないプロンプトです。
ステップ1:プリセットではなく人物を固定する
年齢、立場、体格、そして絶対に破らないルールを設定します。発音しやすい名前を生成し、次に150語のバイブルを作ります。二人のキャラクターが気づかれずに台詞を交換できるなら、まだ二つの声はできていません。
「17歳の川の運び屋、リン・カルダーのキャラクターバイブルを作成。荷物にはいつも丁寧で、船長にはいつも失礼。短文で話す。村が焼かれた後に生まれたスラングは使わない。彼女が絶対に言わない台詞を三つ挙げて。」
ステップ2:ページではなく呼吸のために台詞を書く
シーンをWriting AssistantまたはFilm Screenwriterへ移します。入れ子の節を削ります。難しい名前は角括弧内に発音表記を入れます。モデルが実行できる演技指示を加えます。
「この設定説明の段落を、リンが話す六つの台詞に書き直して。各台詞は最大12語。最後の台詞の前に間を示して。」
ステップ3:バイブルをジェネレーター用プロンプトへ変換する
同じ制約をPrompt Generatorへ渡します。収録空間、マイクとの距離、感情を1~5段階で指定し、避けるべき内容も記します。キャラクターごとに保存済みブロックを持つことで、第4話で声がぶれることを防げます。
「リンのバイブルを音声モデル用プロンプトに変換:10代のアルト、ドライ、屋内倉庫のリバーブ、速度1.05倍、笑わない、アナウンサー的な語尾にしない。ネガティブプロンプトを含める。」
ステップ4:顔、コマ、音楽を一致させる
同じバイブルをビジュアルと音楽のエージェントに渡し、絵と背景音が声と合うようにします。明るいカートゥーンの顔に葬送のような読み方を重ねれば、モデルが正確であっても、オーディエンスは音声を偽物だと判断します。
ステップ5:スマートフォンでリハーサルし、その後レンダリングする
JenovaはWeb、iOS、Androidで機能差なく利用できます。通勤中に台詞を声に出し、つまずいた箇所を印して書き直してから、キャラクターボイスジェネレーターに貼り付けましょう。最も安価な追加収録とは、そもそも収録する必要がなかったものです。
成果とユースケース
🎮 ブース予算なしで作るインディーゲームNPC
シナリオ: 12時間のRPGに、主役以外の4,000行とプレイヤー名の発音が必要です。
従来のアプローチ: 主要キャストには組合収録、その他は無音または使い回しの掛け声。ローカライズは「いつか」のために先送りされます。
Jenova: 主役シーンは人間が担当します。ロングテールにはバイブル、発話しやすい台詞、安定したプロンプトを用意することで、キャラクターボイスジェネレーターが有名人をクローンせずに、案内役、店主、噂を語るNPCを埋められます。
- 鍛冶屋が魔法使いのように聞こえないようにするキャラクターシート
- ローカライズ対応の短い台詞
- コードのようにバージョン管理できるプロンプトブロック
🎬 Webtoonとコミックの吹き替え
シナリオ: 毎週更新される縦型シリーズで、フルキャストを待たずに音声エピソードを作りたい場合。
従来のアプローチ: マイク品質が不揃いなファンダブ、またはすべての役を一人で演じるナレーターです。
Jenova: Webtoon CreatorとComic Creatorが視覚的な一貫性を保ち、脚本家がコマごとに声を分けます。各役に独自のプロンプトを与えるため、ジェネレーターに推測させる必要がありません。
- 散文の塊ではなく、コマの時間に合わせた台詞
- 主役と群衆で分かれた明確なキャスト
- 会話の余白を残す音楽キュー
📱 誰かと話しているように聞こえる語学練習
シナリオ: 通勤中、教科書の声ではなく会話をしたい場合。
従来のアプローチ: 一人の合成チューターによるアプリ練習で、自分の間違いを記憶しません。
Jenova: Learn English Through Roleplayは、一貫したキャラクターと共にシーンへ入る体験を提供します。後から同じ台詞をジェネレーターで音声化し、リスニング練習に使えます。使うのはなりすましではなく、あくまでオリジナルキャラクターです。
- セッションごとにリセットされないバリスタを実現するメモリ
- 実際に再利用する状況の中で学ぶ慣用表現
- 電車での移動に収まるモバイルセッション
🎙️ ブランドポッドキャストとソーシャルキャスト
シナリオ: プロダクトチャンネルで、毎週ホスト、懐疑的な相棒、初見読みの免責文が必要です。
従来のアプローチ: すべてのセグメントで同じ創業者の声を使うか、木曜日には来られないフリーランサーに頼ります。
Jenova: Social Media Content Generatorがプラットフォームに適した脚本を作成し、ライティングとプロンプトのエージェントがホストと相棒の個性が混ざることを防ぎます。無許可の公人クローンではなく、ライセンスを得た音声ツールでレンダリングします。
- 言葉遣いが安定した定番コーナー
- 流し読みされず、声に出して自然な免責文
- Shorts、Reels、フルエピソード向けに調整されたフック
FAQ
キャラクターボイスジェネレーターとは何ですか?
キャラクターボイスジェネレーターとは、年齢、音程、訛り、感情など、選択したアイデンティティでテキストを音声に変換し、異なる役が同じ話し方にならないようにするソフトウェアです。音声モデルが声質を提供し、キャラクター執筆、ト書き、プロンプトが人物像を提供します。Jenovaのツールは、この執筆側に位置します。バイブル、台詞、そして任意のライセンス済み音声システムへ貼り付けられるモデル対応指示を作成します。
キャラクターボイスジェネレーターは無料で使えますか?
多くの音声アプリは限定的な無料プランを提供し、長いクリップ、商用利用権、クローン音声には料金がかかります。Jenovaにはコア機能を使える無料プランがあり、より多くの利用が必要な場合には有料プランがあります。予算には二つのコストを含めましょう。クリエイティブ作業(脚本、プロンプト、一貫性)と、レンダラー(音声時間、音声ライセンス)です。クローン音声に関する同意と商用条件は、サブスクリプション料金とは別です。公開前に両方を確認してください。
AIキャラクター音声をユニークにするにはどうすればよいですか?
各役に一つのルール、語彙の上限、身体的な癖を与え、交換できない台詞を書きます。その制約を毎回プロンプトに含めます。空間、速度、感情、そしてアナウンサー調を避けるネガティブプロンプトです。Prompt Generatorは、この種のブリーフのために設計されています。優れたプロンプトの後でも二人のキャラクターが同じに聞こえるなら、問題はスライダーではなくバイブルにあります。
実在人物の声をクローンすることは合法ですか?
当然に合法ではなく、冗談用のプリセットとしても許されません。実際に意図する利用について、明確に記録された同意が必要です。加えて、法域で適用されるパブリシティ権と著作権の規則にも従う必要があります。FTCは欺瞞的なAI音声クローンを、目新しい技術ではなく消費者保護上の問題として扱っています。ゲームやエンターテインメントの契約では、書面による同意と利用報告がますます求められています。オリジナルキャラクターまたはライセンス済みレプリカを作りましょう。ダッシュボードで簡単にできるからといって、政治家、俳優、歌手の声をスクレイピングしてはいけません。
このワークフローはスマートフォンでも使えますか?
はい。JenovaはWeb、iOS、Android向けに構築され、通勤中に入力するよりメモへ話しかけたい場合の音声テキスト変換を含め、同じコア機能を提供します。電車内で台詞の下書きを作り、磨き、プロンプトを生成し、ライセンス済みモデルがあるデスクトップの音声ツールでレンダリングできます。
一般的なテキスト読み上げとは何が違うのですか?
一般的なTTSは単語を読みます。キャラクターボイスジェネレーターは役を演じようとします。ただし、演技は依然として、アイデンティティ、対立、演出という執筆に依存します。Jenovaはライセンス済み音声レンダラーを置き換えるものではありません。Roleplay Game MasterやFilm Screenwriterなどのエージェントを通じて、レンダラーに必要なキャラクター作りを提供します。つまり、六つの衣装を着た同じ親切なインターンの声を聞くために費用を払うことはありません。
結論
キャラクターボイスジェネレーターの品質は、そこに演じさせる人物の品質を超えられません。AI音声市場は急速に拡大し、モデルは数秒で声質を固定でき、規制当局はすでに「AIがやった」という言い訳を退けています。実用的な道は、より狭く、より良いものです。オリジナルキャラクター、同意済みレプリカ、発話しやすい文章、そして再現可能なプロンプトです。
役を設計し、呼吸を書き、それからテイクを生成しましょう。Jenovaから始め、そこで作った台詞を、すでに信頼している音声ツールへ持ち込んでください。
同じワークフローをさらに活用するには、Roleplay Game Master、Writing Assistant、Prompt Generatorをご覧ください。キャラクターが明確になれば、声には向かうべき場所ができます。
開発者向け: この記事にあるすべてのエージェントは、Jenova APIを通じてプログラムから利用できます。単一の統合で、キャラクターバイブル、台詞生成、音声モデル向けプロンプトをアプリケーションに組み込めます。完全なドキュメント →