専門特化型AI研究アシスタントはチャットボットより信頼できるか?
2026-08-22
追跡可能性と根拠への接地は、研究AIをチャットボットとどう分けるのか?
専門特化型の学術研究アシスタントは、引用の追跡可能性と証拠抽出において一般的なAIチャットボットより信頼性が高くなります。なぜなら、学術インデックスから情報を検索し、主張を特定可能な箇所に結び付け、支持する文脈や相反する文脈を提示するためです。一般的なチャットボットは、学習パターンに基づいて流暢な書誌情報らしい文章を生成します。そのため、出典まで遡って確認できない著者名、論文タイトル、DOI、研究結果を今なお作り出します。
信頼性の差は、文章の質に関するものではありません。主張を監査できるかどうかの違いです。
引用可能な研究支援とチャットボットの文章を分ける主な要素は、次のとおりです。
✅ 生成前の検索 — 回答は次トークンの確率だけでなく、インデックス化された論文に基づいて組み立てられる ✅ 箇所単位の帰属 — 抽出された各知見は、論文タイトルだけでなく、文・表・節に紐付けられる ✅ 矛盾の可視化 — 主張を支持する、異議を唱える、または単に言及する後続研究を、一つの要約に平板化せず提示する ✅ 構造化抽出 — 手法、サンプル、結果、限界を言い換えた段落ではなく、比較可能なフィールドとして取り出す ✅ 人間が確認可能な来歴 — すべての要約、引用、抽出知見を、原典を開いて照合できる
2026年にこれらのツールを有用に比較するには、引用の信頼性をブランドの約束ではなく、工学的な特性として扱うことが重要です。以降では、この特性に基づいてチャットボットと研究アシスタントを評価します。
引用の信頼性が研究公正の問題になった理由
引用の信頼性が研究公正の問題になったのは、生成AIが出版規模で利用されるようになった一方で、一般モデルが今なお、ざっとした確認では見逃されるほど本物らしい参考文献を捏造するためです。学生や研究者による利用は2025年に急増し、捏造された引用はもはや珍しい誤りではありません。学会予稿集、原稿、引用グラフへと入り込んでいます。
Higher Education Policy Instituteの2025年学生調査では、評価課題での生成AIツール利用が1年間で53%から88%へ急増したことが示されました。同じ調査の関連報告では、現在、学生の92%が何らかの形でAIを利用しており、2024年の66%から増加したとされています。この規模が重要なのは、もっともらしい偽の参考文献ほど、何も書かれていない参考文献より発見しにくいためです。
Energy Research & Social Scienceに掲載された2026年の分析では、ChatGPTが研究提案書向けに178件の参考文献を生成し、そのうち69件には有効なDOIsがなかったと報告されました。同じ論文は、NeurIPS 2025の4,841本の論文を対象としたGPTZeroのレビューで、採択された53本の論文から少なくとも100件のハルシネーション引用が確認されたことにも言及しています。複数の専門家による査読でも、これらは見抜かれませんでした。
そのメカニズムは現在よく説明されています。AIハルシネーションとは、流暢であっても誤っている、または根拠のない出力です。大学図書館のガイダンスでは、チャットボットが著者、タイトル、雑誌名まで含む引用全体を捏造しうると指摘されています。Scienceは、モデルが答えを知らない場合でも答えを出すよう訓練されていると論じています。プロンプトが出典の引用を求めるものである場合、モデルは書誌スタイルをパターン照合します。ニッチな研究や最新の研究では、そのスタイル照合が発明へと変わります。
AI研究アシスタントを選ぶ際に何を評価すべきか?
AI研究アシスタントは、文章がどれほど洗練されているかではなく、あらゆる主張を追跡、根拠付け、帰属、矛盾確認、抽出できるかで評価すべきです。簡潔な指標として、TRACEフレームワークを利用できます。すなわち、追跡可能性、検索による根拠付け、帰属の粒度、矛盾認識、抽出可能性です。
追跡可能性とは、読者が草案中の一文から、それを裏付ける正確な箇所へ移動できるかを問うものです。ツールが整形済みの参考文献しか出力しないなら、それは証明ではなくポインタにすぎません。
検索による根拠付けとは、システムが学術コーパスを検索したのか、それともモデルの重みから出力をサンプリングしたのかを問うものです。引用根拠付き抽出は、抽出されたすべての主張に明示的な出典帰属を要求することで、出典のない発明と帰属のない言い換えの双方を防ぐよう設計されています。
帰属の粒度は、論文単位の引用と、文単位またはフィールド単位の引用を区別します。論文自体が実在していても、引用された知見が誤っている、古くなっている、あるいは結果ではなく要旨から取られている可能性があります。
矛盾認識とは、ツールが主張を支持する後続研究、異議を唱える後続研究、単に言及するだけの後続研究を示すかを問うものです。裏付ける要旨が一つあるだけでは、文献全体を見たことにはなりません。
抽出可能性とは、手法、サンプル、結果、限界を構造化フィールドで比較できるかを問うものです。文章による要約は欠落データを隠します。表にすれば、その欠落が見えるようになります。
King's College Londonのエビデンス統合ガイダンスは、実務上の含意を明確に示しています。AIツールはレビューの各段階を支援できる一方、検証済みの検索手法を置き換えることはできず、生成システムは今なお偽の参考文献を作り出すというものです。そのガイドで引用されている2025年のレビューは、現在のエビデンスでは、人間の関与なしにエビデンス統合で生成AIを利用することは支持されないと結論付けています。したがって評価すべき問いは、ツールが文章を書けるかではありません。ツールを監査できるかです。
専門研究アシスタントは一般チャットボットとどう比較されるか?
専門研究アシスタントは、回答を検索した論文に結び付けるため、引用の追跡可能性では一般チャットボットを上回ります。一方、チャットボットは草案作成、説明、ブレインストーミングで依然として強みを持ちます。正直な比較は役割別に行うべきです。チャットボットは柔軟な文章作成エンジンであり、研究アシスタントはより狭い用途に特化した、より検査可能な検索システムです。
Elicitは数百万本の学術論文を検索し、引用付きの構造化レポートを返します。研究者が一連の研究にわたって手法、サンプル、知見を並べて比較する必要がある場合に、特に強みを発揮します。King's College Londonが引用する2026年のCochrane関連比較では、Elicitは従来の文献検索を置き換えるほど高い感度では検索できなかったものの、その精度の高さから補助的な手段として有用だったとされました。これは注記ではなく、実質的な限界です。
Sciteは、草案作成ではなく検証を中心に構築されています。3億本を超える学術論文をカバーし、40社を超える出版社との契約を通じたライセンスアクセスを報告しています。Smart Citationsは、後続論文がある主張を支持するか、対比するか、単に言及するだけかを分類します。そのアシスタントが行うすべての主張は、特定の論文内の特定の文にリンクされています。その代償は対象範囲です。Sciteは、原稿作成のエンドツーエンドのワークフローよりも、引用インテリジェンスで優れています。
ResearchRabbitはマッピングに最も適しています。関連論文の発見、引用マップの構築、シード論文から分野が広がる様子の追跡を支援します。証拠抽出や引用検証のエンジンとしては、あまり適していません。タスクが発見であるなら、これは欠点ではありません。
ChatGPTのような一般チャットボットが広く利用されているのは、草案を素早く作成でき、雑多で領域横断的な質問にも対応できるためです。その文書化された弱点は、書誌情報の発明です。2026年の学術的健全性分析で要約された最近の報告では、GPT-4oやClaude 3.7などの高度なモデルにおける事実・引用ハルシネーションは15~20%の範囲で、ニッチな話題や最新の話題では35~55%に上昇するとされています。大規模言語モデルが生成する科学的参考文献を監査するベンチマークでは、一部の条件で30%を超えるエラー率が報告されています。
JenovaのAcademic Research Assistantは、異なる位置付けにあります。これは文献発見、原稿作成、引用管理のための分野特化エージェントであり、持続的なメモリと学術データベースを横断するライブ検索を備えています。研究プロジェクトをセッション間で一貫させる点では、チャットボットより優れています。一方で、ライセンス済みフルテキストの引用分類ではSciteに、専用の抽出テーブル製品としてはElicitに劣ります。こうした差があるため、今なお単一のアシスタントより混成スタックの方が優れた成果を上げます。
| 機能 / 観点 | 一般チャットボット(例:ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| 検索による根拠付け | 主にモデルの記憶。ブラウジングは製品により異なる | 持続的な研究エージェント内での学術・ウェブのライブ検索 | 構造化レポートを伴う論文コーパス検索 | ライセンス済み学術フルテキストとオープンコーパス | シード論文からの引用グラフによる発見 |
| 引用の追跡可能性 | 検証不能または捏造されがち | インラインの出典と原典に対する追加検証 | 抽出フィールドに付随する引用 | 文単位のリンクと支持/対比ラベル | 論文間のネットワークリンクであり、主張単位の証明ではない |
| 証拠抽出 | 自由形式の要約 | ノート、比較、原稿用の統合 | 強力な構造化テーブル | フィールド抽出より引用文脈に強い | 限定的。抽出よりマッピング向け |
| 矛盾認識 | 通常は一つの回答に平板化される | 依頼すれば相反する知見を比較できる | 検索された集合に依存 | Smart Citationsを通じた中核機能 | 関連研究クラスターを通じた間接的な把握 |
| 価格(2026年時点) | プラン間で未検証 | 無料枠、月額$20からの有料プラン | 未検証 | 未検証 | 未検証 |
| 最適な用途 | 草案作成、説明、初期の論点整理 | 発見と文章作成のメモリを必要とする継続的な学術プロジェクト | 論文を比較可能な証拠テーブルへ整理する作業 | 主張が支持されているか、異議を唱えられているかの確認 | 視覚的な文献マッピング、著者・クラスターの発見 |
2026年の学術研究AIツールの概観も、同様の役割分担に到達しています。Elicitは構造化抽出を主導し、Consensusは素早いエビデンス確認で最も速く、Semantic Scholarは無料の発見インデックスとして最も強力だった。この領域では、どのツールも単独では他を置き換えません。
学術AIツール間で証拠抽出はどう異なるのか?
証拠抽出の違いは、ツールが比較可能なフィールドを返すのか、それとも文章による言い換えだけを返すのかにあります。フィールド単位の抽出は、手法、サンプルサイズ、結果、限界に対してより信頼できます。欠損値が可視化されたままだからです。文章による抽出は速く読みやすい一方で、結果、解釈、ハルシネーションした詳細の違いを隠します。
Elicitは構造化アプローチの最も明確な例です。研究質問を、行が論文、列が研究特性となるレポートへ変換するよう設計されています。この形式のため、レビュー担当者は初期スクリーニングでElicitを好むことが多くあります。ただし、高精度は高再現率を意味しないため、包含ロジックは依然として人間が確認する必要があります。
Sciteが抽出する対象は異なります。抽出するのは引用文脈です。ある論文が何を発見したかを問うのではなく、後続論文がその発見をどう扱ったかを問います。これはデータ抽出より、エビデンス評価に近い作業です。候補論文がすでに特定されている後に、特に有用です。
一般チャットボットは文章で抽出します。4件の無作為化試験を比較するよう依頼すれば、自信に満ちた段落を作成します。その段落は最初の下書きとしては有用かもしれません。しかし、「未報告」と印を付けられるフィールドが存在しないため、監査用の成果物としては不適切です。
JenovaのAcademic Research Assistantと、その関連Deep Researchエージェントは、この二極の中間に位置します。Deep Researchは広く検索し、インライン引用付きの統合レポートを返します。Academic Research Assistantは、プロジェクトを状態管理された形で保持します。過去の包含判断、除外した論文、スタイル要件、未完了の原稿節を、その後のセッションでも利用できます。このワークフローを検証すると、複数週にわたる文献レビューで実務上の利点が確認できます。限界も同様に実務的です。いずれのエージェントも、RayyanやDistillerSRのような専用ツールの型にある体系的レビュー用スクリーナーではありません。これらは、タイトルと要旨のスクリーニングにおいて、エビデンス統合を担当する司書が今なおより評価された選択肢と見なしています。
信頼できる抽出プロンプトでは、必要なフィールドを明示します。
「これらの論文から、研究デザイン、サンプルサイズ、対象集団、主要評価項目、効果の方向、記載された限界、そして各フィールドを裏付ける正確な文を抽出してください。フィールドが欠けている場合は、推測せず『未報告』と記載してください。」
チャットボットに同じ指示を与えても、その品質は取得したテキスト次第です。モデルが論文を開いていなければ、文体的な記憶から表を埋めてしまいます。
引用検証パイプラインに実際に必要なものは何か?
引用検証パイプラインには、参考文献の文字列だけでなく、ソース文書そのものが必要です。最低限実用的なプロセスは、引用対象のテキストを取り込み、チャンク化し、主張と最も関連性の高い箇所を検索し、それらを再ランキングして、主張と証拠の関係を分類することです。これに満たないものは、参考文献の書式設定にすぎません。
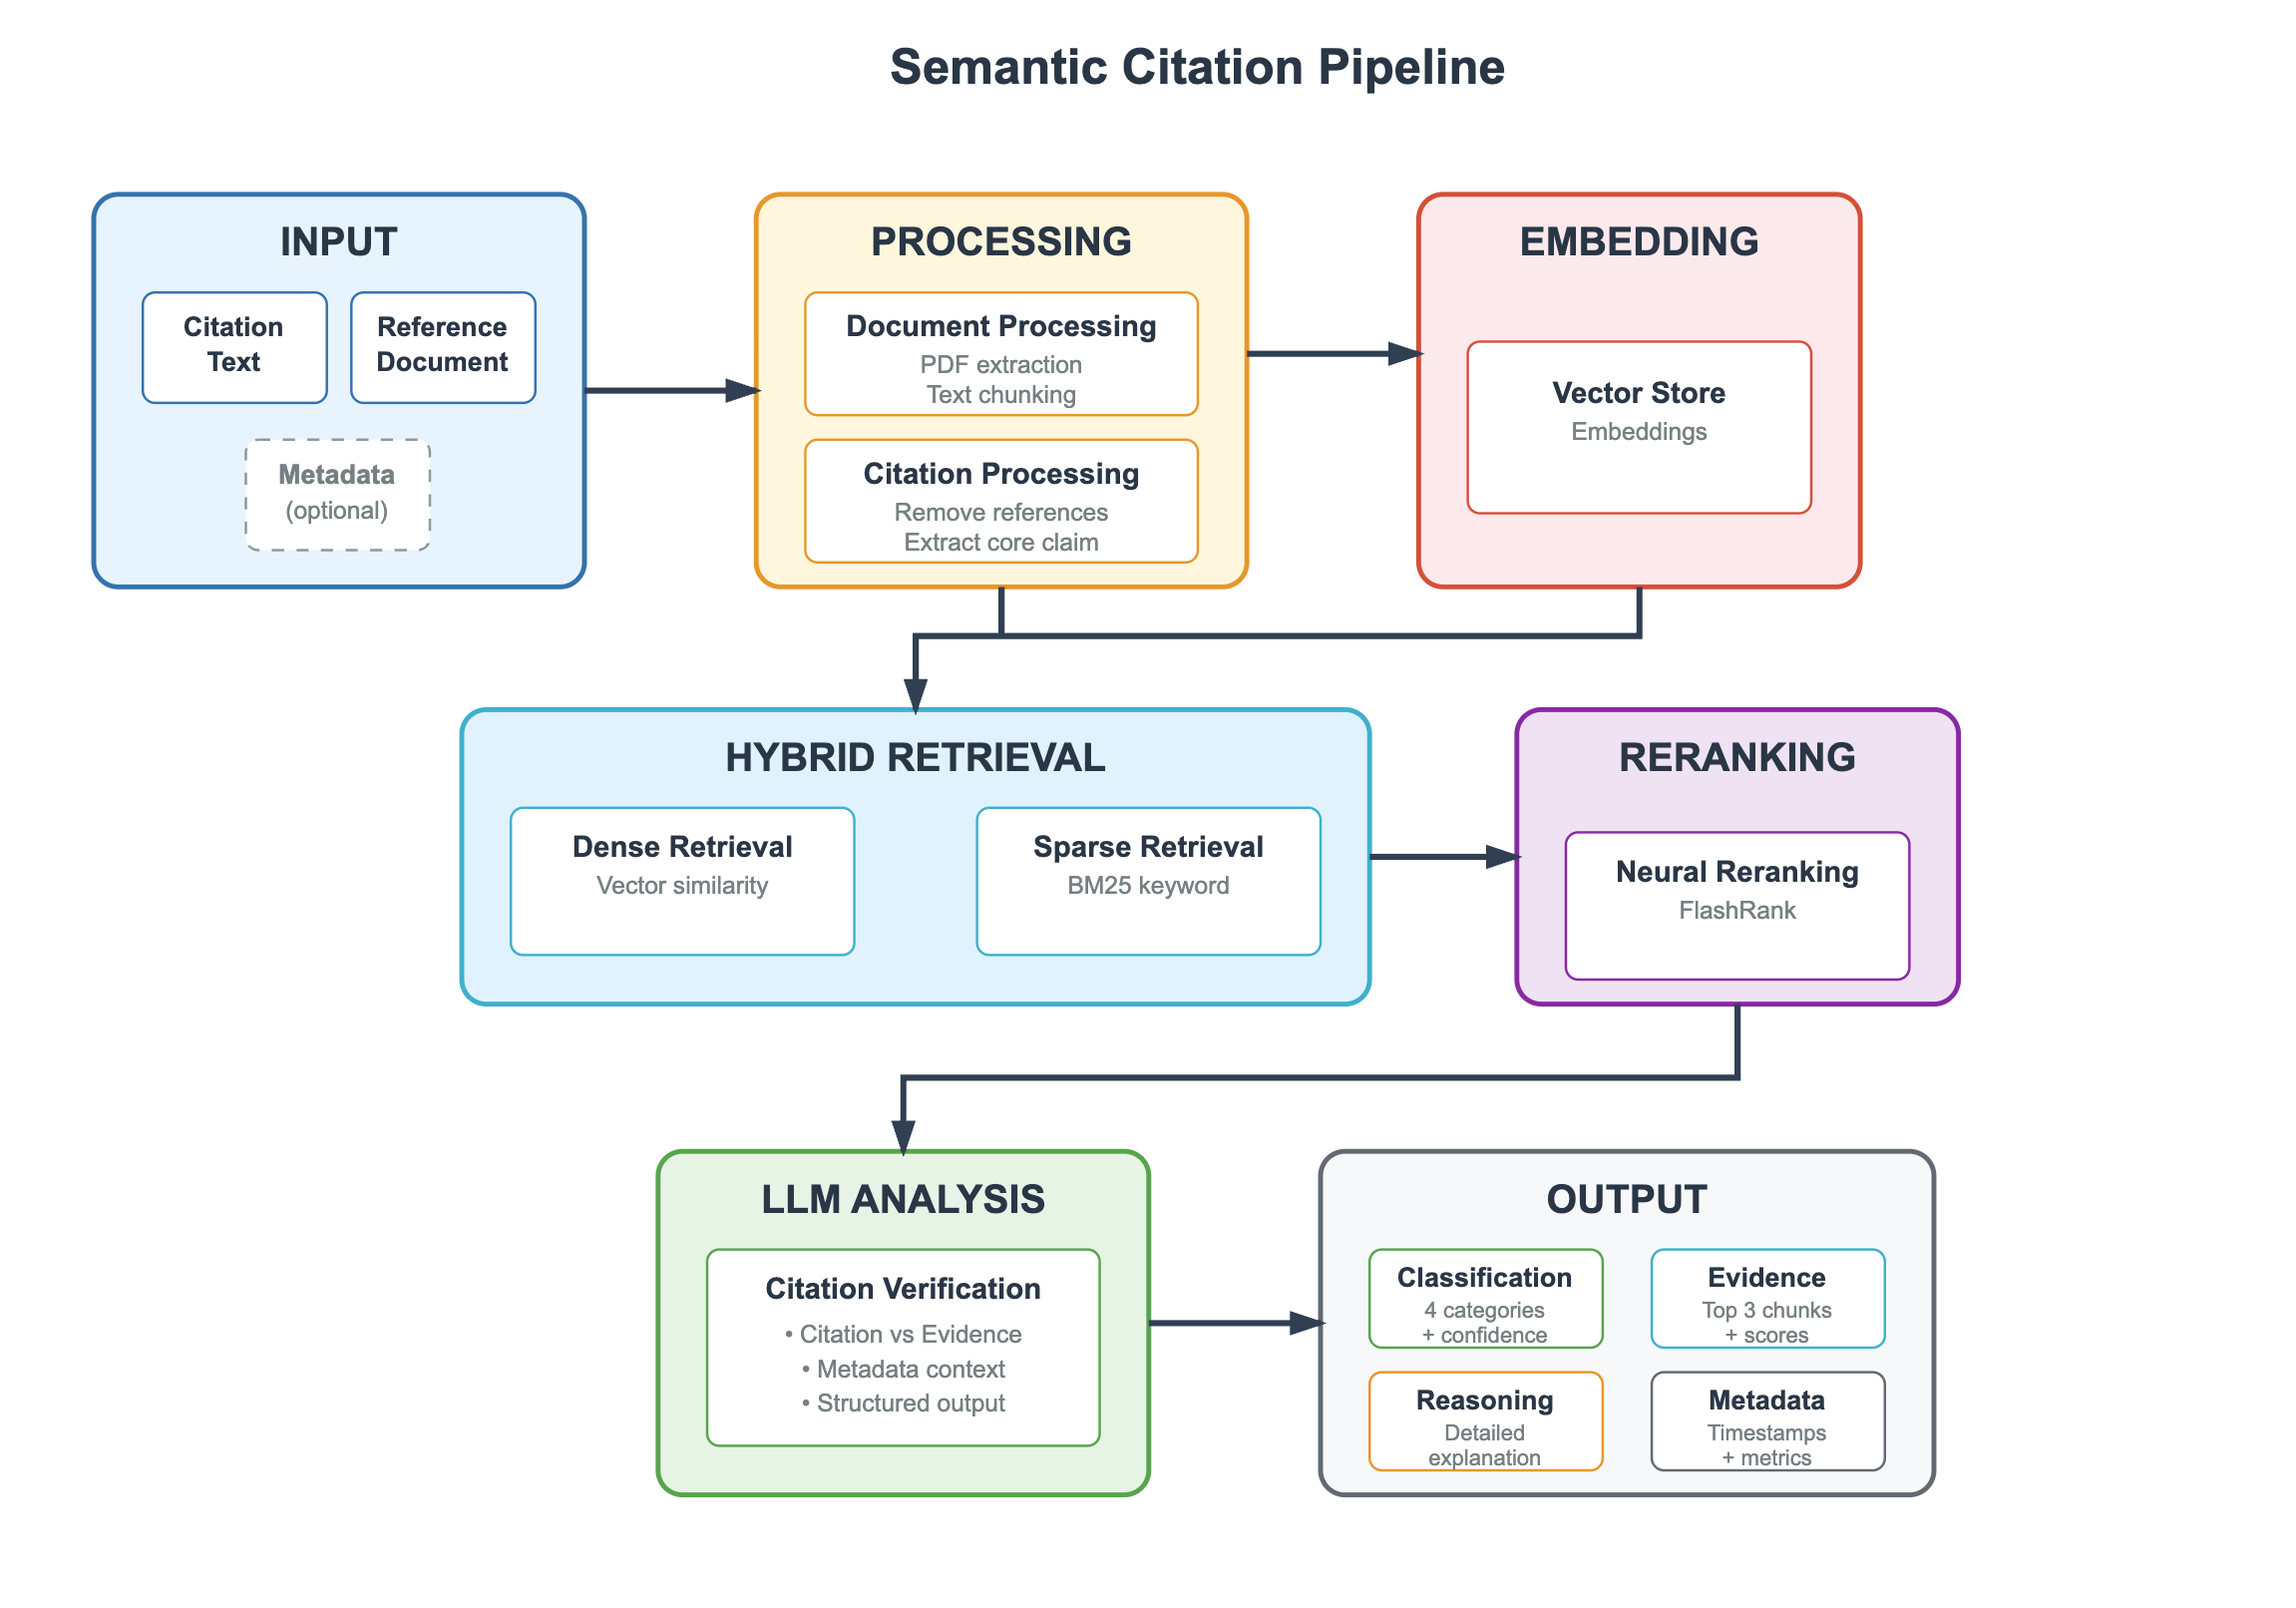
上図のアーキテクチャこそが、「この引用は本物らしい」と「この引用は裏付けられている」の違いです。入力は主張と参考文書です。処理段階では参考文献リストを除去し、中心となる主張を抽出し、PDFをチャンク化します。次にハイブリッド検索で、ベクトル類似性とキーワードの重なりの両方を検索します。手法名や評価指標は純粋な意味検索では見落とされることがあるため、これは重要です。ニューラル再ランキングで上位の箇所を残します。その後で初めて、LLMが関係を分類し、証拠、信頼度、理由を返します。
SemanticCiteのようなシステムは、フルテキストのソース分析を通じて引用の正確性を検証するために、特別に構築されています。この設計選択が存在するのは、メタデータ照合だけでは不十分だからです。DOIが有効でも、引用された文が別の論文、プレプリントの要旨、あるいは著者が後に限定した知見に由来する可能性があります。
出版社のインフラがこれを自動的に解決するわけでもありません。主要な学術誌はすでに参考文献をハイパーリンク化していますが、2026年の健全性分析で議論された推定では、サンプル対象の学術コンテンツにおけるDOIの失敗、すなわちリンク切れが37%に達する可能性があります。緑色のリンクがあることは、主張が検証済みであることを意味しません。
ここは、一般チャットボットが最も予測可能な形で失敗する部分でもあります。チャットボットは完全な答えを最適化します。検証パイプラインは、支持、非支持、反証、証拠不足という分類済みの関係を最適化します。この4つのラベルは洗練された段落より科学的に有用です。なぜなら、どの種類の確認が残されているかを研究者に伝えるからです。
Jenovaのエージェントは、候補論文を検索し、裏付ける箇所を引用し、発見できない主張にフラグを付けることで、このループの軽量版を実行できます。ただし現時点では、出版社規模のカバレッジを備えたライセンス済みフルテキスト引用分類器を置き換えるものではありません。Smart Citationラベルを必要とする研究者は、両方の作業を一つのシステムに任せるのではなく、今なお文章作成エージェントとSciteを組み合わせています。
より安全なAI支援文献調査ワークフローをどう構築するか?
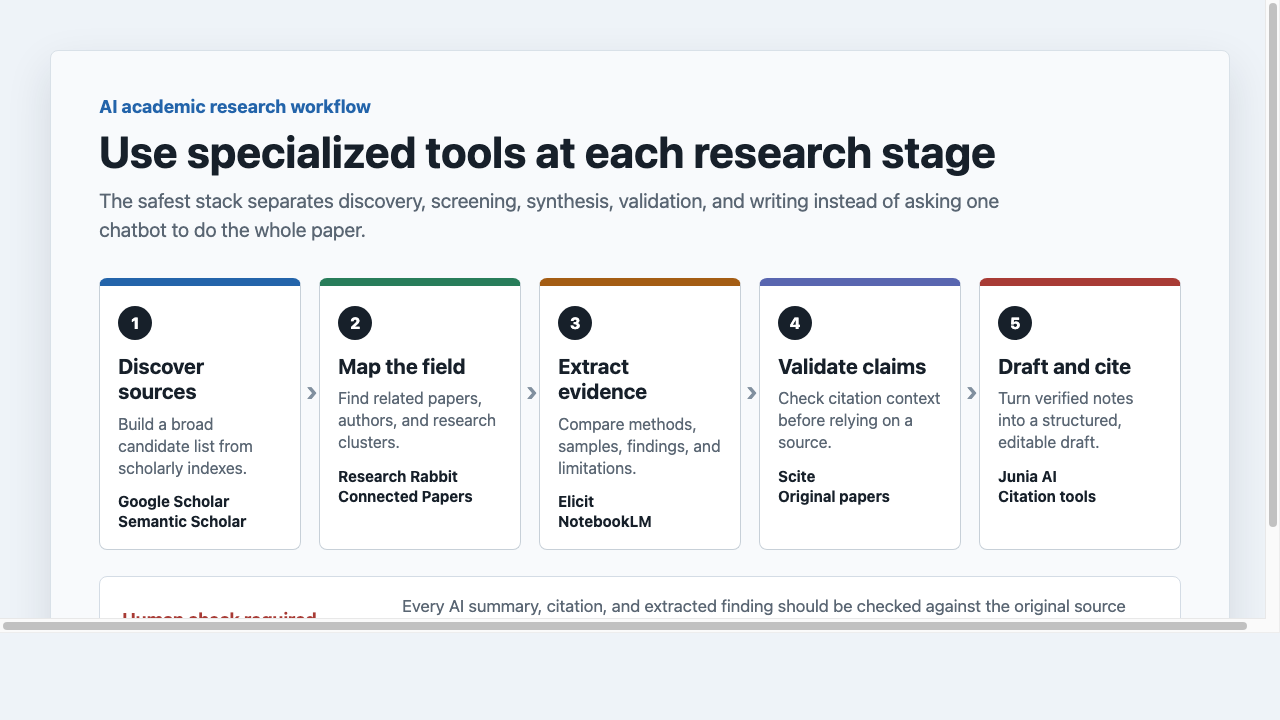
より安全なAI支援文献調査ワークフローは、各段階を確認可能なツールに割り当て、抽出したすべての知見を原論文と照合することで構築します。危険なパターンは、一つのチャットボットに発見、スクリーニング、抽出、検証、執筆をすべて依頼することです。
段階的なワークフローは次のようになります。
- ソースを発見する:チャット画面ではなく、Google ScholarやSemantic Scholarなどの学術インデックスを使う。
- 分野をマッピングする:ResearchRabbitやConnected Papersを使い、関連著者やクラスターを可視化する。
- 証拠を抽出する:Elicit、NotebookLM、または研究エージェントを使い、構造化ノートにまとめる。
- 主張を検証する:引用可能な文として扱う前に、Sciteと原典のPDFで検証する。
- 草案を作成し引用する:検証済みノートの集合だけを基に行う。
JenovaのAcademic Research Assistantでは、設定は機能紹介ではなく研究ブリーフとして行います。
- jenova.ai/a/academic-research-assistantでエージェントを開きます。
- 質問、研究分野、完了の定義を伝えます。
「LLMの引用エラー率に関する方法節を執筆しています。2023~2026年の査読済み研究と出版社による分析を優先してください。各ソースについて、サンプル、エラー定義、ハルシネーション率、参考文献を人間が検証したかどうかを抽出してください。」
- まず候補リストを求め、次に抽出テーブルを求め、その後に文章を求めます。いきなり草案へ進んではいけません。
- 除外した論文は同じスレッドに残し、エージェントが後の段階で再び導入しないようにします。
Elicitで同様に始める場合は、対象集団、介入、結果、研究タイプという狭い質問と列リストを用意します。Sciteでは、既知の論文または主張から始め、執筆前に支持する引用と対比する引用を確認します。一般チャットボットは、ソースがすでに存在した後のアウトライン作成や文章編集に使うのが最も安全です。
大半の失敗を防ぐ運用ルールは二つです。第一に、開けない引用は決して受け入れないこと。第二に、草案作成モデルを論文内容の唯一の記録にしないことです。検証済みノートが正確な情報源であり、草案はそのノートを再構成したものにすぎません。
一般用途チャットボットがより適した学術ツールである場合は?
一般用途チャットボットがより適した学術ツールなのは、タスクがエビデンスではなく、言語、構成、説明に関わる場合です。信頼性は仕事の内容に依存します。引用の追跡可能性は文章作成モデルを評価するには不適切な基準であり、文章の流暢さは検索インデックスを評価するには不適切な基準です。
チャットボットは、次の用途で依然として有用です。
- 検証済みのアウトラインを、より明瞭な学術文章へ変換する
- 研究者がすでに読んだ手法を説明する
- 検索式、反論、改訂チェックリストを生成する
- 難解な箇所を、引用用ではなくノート用に平易な文章へ変換する
ただし、主要な文献検索エンジンとしては不適切です。Natureに関連する分類研究では、根拠のないチャットボットの記述を明確なハルシネーション類型として扱っています。また図書館のガイダンスは、捏造された引用には著者名、タイトル、雑誌名をすべて含む一式がありうるという同じ警告を繰り返しています。この失敗モードは、一本の捏造参考文献で慎重に組み立てた論旨全体の信頼性が損なわれうる学位論文、研究助成金申請、学術誌投稿では、特に高コストです。
チャットボットをスタックに残すべきワークフロー上の理由もあります。専門ツールの用途はより狭いためです。Elicitは段落のリズムを検討しません。Sciteは学位論文の一章について、学期をまたぐ指導上の対話を維持しません。ResearchRabbitは学術誌の参考文献スタイルに整形しません。エビデンスを確定した後、チャットボットまたは一般的な文章作成エージェントがこうした不足を補います。
実務上のルールは順序付けです。まず専門的な検索と検証を使います。次に一般モデルを使い、その対象は自分で開けるライブラリにすでにソースが存在する文章に限定します。改訂中にチャットボットが新しい引用を導入した場合、その引用は原稿の他の部分と同じTRACEチェックを通過するまで、信頼しないものとして扱います。
研究公正の専門家はAI引用について何と言っているか?
研究公正の専門家は、一般チャットボットを草案作成の補助と捉え、引用される主張についてはソースに紐付いた専門システムだけを許容可能な層と見なしています。合意されているのは、AIを避けることではありません。根拠のない生成器を、文献が何を示しているかの記録にしてはならないということです。
「繰り返し見られる失敗は、モデルの文章が下手なことではありません。存在しない論文、あるいは主張された結果を含まない実在論文について、完全な書誌情報を作ってしまうことです。そうした文字列が草案に入ると、証拠のように振る舞います。誰かがソースを開く前に、査読者、共著者、その後の引用ツールがそれを拡散してしまう可能性があります。」
「専門研究アシスタントは、作業単位を変えます。引用付きの段落を求める代わりに、主張、箇所、そして支持、非支持、反証、証拠不足という分類を求めるのです。この出力は遅く、見栄えも劣ります。しかし、方法節が擁護できるのはこの出力だけです。」
「持続的なプロジェクトメモリは、人々が考える以上に重要です。ハルシネーションは、改訂中に一般チャットボットへ既に整っていた節への出典追加を求めたとき、しばしば論文へ再び入り込みます。どの論文が、なぜ除外されたかを記憶するアシスタントは、単なる利便性ではなく、公正性に関わる仕事をしています。それでも、原典のPDFが最終的な権威であることに変わりはありません。」
— Jenovaプロダクトチーム、学術研究ワークフローおよび引用根拠付きエージェント設計に関する複数年の取り組み
この立場は、司書およびエビデンス統合のガイダンスとも一致します。King's College Londonは、AIを補助的に利用すること、フルテキストをアップロードする前に著作権を確認すること、そして生成ツールは今なお参考文献や件名標目を捏造しうると想定することを勧めています。出版社レベルの分析では、ハルシネーション参考文献を逸話ではなくコーパスの問題として扱うようになっています。Natureによる約4,000件の出版物の調査に基づく2026年のある論評は、最も疑わしい100本の論文のうち65本に少なくとも一つの無効な参考文献があり、2025年の約700万件の出版物のうち11万本を超える論文が影響を受けている可能性を示すパターンだったと述べています。
専門家が示す含意は実務的です。確認コストを低くするツールを選び、確認が不要だと感じさせるツールを退けてください。
参考文献
- Higher Education Policy Institute — 2025年学生生成AI調査
- ERIC / U.S. Department of Education — 2025年学生生成AI調査、HEPI Policy Note 61
- Boretti、Energy Research & Social Science — 生成AIのハルシネーションと学術的健全性
- Wikipedia — ハルシネーション(人工知能)
- University of Nebraska Medical Center McGoogan Library — 引用におけるAIハルシネーション
- Science / AAAS — AIモデルが不確実性を認めずハルシネーションを起こす理由
- LlamaIndex — 引用根拠付き抽出
- King's College London Library Guide — エビデンス統合におけるAIツール
- Elicit — 科学研究のためのAI
- Scite — 引用に裏付けられた研究とSmart Citations
- ResearchRabbit — 文献マッピングと引用ネットワーク
- newline — LLMsが生成した科学的参考文献を検査するベンチマーク
- Paperguide — 学術研究AIツール比較、2026年
- arXiv — SemanticCite:フルテキスト分析による引用検証
- Nature Humanities and Social Sciences Communications — AIハルシネーションの分類