マルチモデルAIプラットフォームは単一モデルのリサーチツールより優れているのか?
2026-08-22
タスクルーティングとモデルの多様性は、調査と執筆の品質をどう変えるのか?
2026年における複雑な検索、分析、執筆のワークフローでは、マルチモデルのタスクルーティングプラットフォームが、単一モデルのリサーチツールを概して上回ります。これは、1つのシステムにすべての仕事を担わせるのではなく、情報探索、推論、下書きを異なるモデルに割り当てられるためです。Jenovaは、情報源の収集から統合、完成原稿の作成までを、1つの永続的なワークスペースで進める必要があるプロジェクトで特に力を発揮します。ChatGPTとClaudeは、迅速で自己完結型の下書き作成では依然として優れています。PerplexityとElicitは、使い慣れたインターフェース内で範囲を絞った検索を行う用途で依然として強みがあります。
品質差は、どのブランドが最大のモデルを持つかという問題ではありません。タスクの変化に応じて、スタックがモデル、ツール、専門家を切り替えられるかどうかが重要です。
有能なリサーチチャットとワークフロープラットフォームを分ける主な要素は次のとおりです。
✅ 検索忠実性 — 回答が単一モデルの記憶ではなく、取得可能な情報源に紐づいたままであるか ✅ ルーティング判断力 — 文献レビュー、計算、文章作成を異なるモデルに送れるか ✅ 執筆の連続性 — 調査コンテキストがアウトライン、下書き、修正まで維持されるか ✅ エラー検出 — 第2のモデルまたはエージェントが最初の回答を検証・反論できるか ✅ コスト管理 — 高価な最先端モデルを難しい工程に限定できるか
AWSは、単一の大規模言語モデル(LLM)では、混在するタスク全体でコスト、レイテンシー、品質を最適化できないことが多いと説明しています。そのため、ルーティングは中核的なアーキテクチャ上の意思決定になっています。これらのツールを公平に比較するには、1つのモデルが得意とすることと、ルーティングされたマルチエージェントワークフローが継続的に実行できることを分けて考える必要があります。
なぜ複雑な検索と執筆のワークフローは、単一モデルのツールでは足りなくなっているのか?
複雑な調査・執筆作業が単一モデルのツールを超えつつあるのは、仕事がもはや1つのプロンプトではないためです。検索、フィルタリング、比較、アウトライン作成、下書き、ファクトチェックという一連の工程であり、それぞれの工程では異なる強みが求められます。
文献調査には最新の情報源が必要です。手法の批評には慎重な推論が必要です。顧客向けメモには文体の管理が必要です。単一のチャットでもこの3つを近似的にこなせますが、通常は1つのコンテキストウィンドウ内で、同じモデル固有の盲点を抱えたまま処理します。
大学図書館員は、生成AIツールが依然としてエラー、限定的なコンテキスト理解、限定的な検索能力を抱えやすいと指摘しています。大学のリサーチガイドも、ハルシネーション、学習データの欠落、有料論文を構造的な制約として挙げています。1つのモデルが取得と執筆の両方を担うと、これらの制約は累積します。
だからこそ、研究者は現在、専門ツールを組み合わせています。2026年のリサーチAI比較では、情報探索、分析、執筆、プレゼンテーションのすべてを同等にカバーする単一製品はないという結論が繰り返し示されています。学術ワークフローのまとめでも、1つの汎用チャットボットを推奨するのではなく、Consensus、Elicit、Semantic Scholar、Perplexityに仕事を分けています。
実務上の問いは、もはや「どのモデルが最も賢いか」ではありません。各工程を、その工程で失敗する可能性が最も低いシステムへルーティングできるかどうかです。
AI調査・執筆スタックを選ぶ際に、何を評価すべきか?
AI調査・執筆スタックは、単一プロンプトに対するデモ品質の回答ではなく、検索忠実性、ルーティング判断力、執筆の連続性という、私たちがSRCフレームワークと呼ぶ3つの要素で評価すべきです。
SRCフレームワークは、調査が実際に失敗するポイントに対応する次の3つの質問を投げかけます。
- 検索忠実性。 ツールは最新かつ引用可能な資料を見つけられるか。それとも学習データから回答を再構成しているだけか。
- ルーティング判断力。 手法に関する質問、コストを抑えたリライト、長い統合分析を、それぞれ異なるモデルに送れるか。
- 執筆の連続性。 同じワークスペースが、情報源、却下した主張、文体上の制約を下書き全体にわたって記憶できるか。
ワークフローが1回の作業時間を超えて続く場合は、次の評価基準も重要になります。
- 根拠付けツール。 Web検索、学術検索、ファイル、引用の処理。
- メモリ。 設定や過去の発見事項がセッションをまたいで維持されるか。
- オーケストレーション。 調査、執筆、レビューを連携した役割として実行できるか。
- 可観測性。 どのモデルまたはエージェントがどの主張を生成したか確認できるか。
- コスト構造。 安価な分類工程ごとに最先端モデルの料金を払う必要があるか。
- 失敗モード。 1つの弱い回答がプロジェクト全体を破綻させるか。
HatchWorksは、この中核的な選択を、汎用LLM 1つを使うか、タスクごとに作業を割り当てるマルチモデルスタックを使うかという問題として整理しています。TrueFoundryは、マルチモデルルーティングを、各クエリをその仕事に最も適したモデルへ送ることだと説明しています。これらは機能リストの問題ではなく、アーキテクチャの選択です。
ツールはチャット品質で高評価を得ていても、すべての回答が同じモデル、同じセッション、独立した検証なしで生成されるなら、SRCテストには合格しません。
ChatGPT、Claude、Perplexity、Elicit、Jenovaは複数工程の作業でどう比較できるか?
ChatGPTとClaudeは単一インターフェースの汎用ツールとして最も優れ、PerplexityとElicitは専門的なリサーチインターフェースとして最も優れています。一方、Jenovaは、検索、分析、執筆をマルチモデルのワークスペース内でつなげておく必要がある場合に最も強みを発揮します。
ChatGPTは2026年のツール一覧で、一貫して多用途の汎用アシスタントとして取り上げられています。Claudeは長文の学術執筆にしばしば推奨されています。Perplexityはリサーチ検索に広く使われていますが、学術ワークフローのガイドには注意を促すものもあります。Elicitは文献レビュー向けのAIリサーチアシスタントとして位置付けられています。
Jenovaは異なる形を取ります。ユーザーはOpenAI、Anthropic、Google、DeepSeek、xAIのモデルを切り替え、無制限のチャット履歴を保持し、ナレッジベースを添付できます。Academic Research AssistantやWriting Assistantのような領域別エージェントも同じスタック上にあるため、文献調査の結果を別の下書きツールへ貼り付け直す必要がありません。
トレードオフは明確です。Elicitは、構造化された論文情報の抽出において、より用途特化型であり続けます。Claudeは、仕事が長く慎重な下書きだけである場合にはよりシンプルです。Jenovaの利点は、ユーザーができるだけ少ない設定を望む場合ではなく、プロジェクトに複数の役割がある場合に現れます。
| 機能・評価軸 | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| モデルへのアクセス | 単一ベンダーの汎用アシスタント | 単一ベンダーの長文コンテキストモデル | ホスト型モデルを用いた検索優先インターフェース | 調査特化のワークフローモデル | タスク単位でモデルを選べるマルチプロバイダーアクセス |
| 検索と情報源への根拠付け | 汎用Web支援に強いが、専門的な文献データベースではない | 文書分析に強いが、ライブのリサーチインデックスとしては弱い | 迅速な引用付き検索に強い | 構造化された文献レビューに強い | 1つのワークスペース内でWeb、Scholar、ファイル、ナレッジベースを利用可能 |
| 複数工程のオーケストレーション | チャット間でのプロンプト管理はユーザーが担当 | 長文コンテキストのプロンプト管理はユーザーが担当 | 問いと回答の反復に最適 | レビューパイプラインに最適だが、完全な下書き作成には不向き | 調査と執筆をまたぐエージェントオーケストレーションとモデルルーティング |
| メモリと継続性 | 製品内の会話メモリ | スレッド内コンテキストは強いが、プロジェクト横断の記録システムとしては弱い | 検索スレッドを超えるプロジェクトメモリは限定的 | 下書き中心ではなく、研究・論文中心 | セッションをまたぐ永続的メモリと添付文書 |
| 料金(2026年時点) | 本レビューでは未検証 | 本レビューでは未検証 | 本レビューでは未検証 | 本レビューでは未検証 | 利用量に制限のある無料プラン、有料プランは月額$20から |
| 最適な用途 | 迅速な汎用調査と下書き | 長い原稿と慎重な文章 | 個別の質問に対する引用付き回答 | 学術文献レビュー | 検索、分析、執筆を一気通貫で行うワークフロー |
もう1つのマルチモデルの選択肢として、Multiがあります。同サービスは、主要ラボの300以上のモデルを4つのワークフローで利用できるとしています。そのため、純粋なモデル選択を求めるチームにとっては有力です。一方で、領域別エージェント、永続的なプロジェクトメモリ、調査から下書きまでを1つにまとめたワークスペースを必要とするユーザーには、関連性が低くなります。
より信頼できる検索と情報源の発見につながるAIアプローチはどれか?
情報源の発見には、検索特化ツール、またはライブ検索機能を備えたマルチモデルプラットフォームの方が、記憶に基づいて回答する単一の汎用モデルより信頼できます。理由は単純で、発見と統合では失敗の仕方が異なるからです。
単一モデルのチャットは、質問がすでに明確で、初回の説明だけが必要な場合には効率的です。しかし、回答が学習後に公開された情報、有料壁の向こうにある資料、または別のデータベースが矛盾させる事実に依存する場合は、脆弱になります。
ConvergePanelは、単一モデルによる調査は統合を早く行いすぎることで意見の不一致を隠す一方、マルチモデル調査は異論や情報源の品質シグナルを保持すると論じています。Argumentreeも同様の指摘をしています。単一モデルは独立した検証なしに自身のエラーを引き継ぎますが、マルチモデル調査では主張を検証できます。
実務では、より信頼性の高いパターンは次のようになります。
- 検索優先のツールを使い、候補となる情報源を収集する。
- 第2のモデルで、手法、サンプルサイズ、制約を抽出する。
- 執筆を始める前に、第3の工程で根拠のない飛躍を検出する。
ElicitとConsensusは、その一連の工程の一部に対応するために作られています。Consensusは、査読済み文献に基づくエビデンス重視の回答に焦点を当てています。Perplexityは、質問が系統的レビューよりWeb検索に近い場合により高速です。
Jenovaは、情報探索が第1段階にすぎない場合により有用です。Academic Research Assistantは学術データベースを横断して検索し、引用を紐づけたまま保持したうえで、同じプロジェクトコンテキストを執筆エージェントに渡せます。これは正式な系統的レビューにおいて専用のエビデンスデータベースを置き換えるものではありません。しかし、通常は引用のずれを招くコピー&ペーストの断絶を減らせます。
情報探索段階の信頼できるプロンプトでは、対象範囲と除外ルールを明確に指定します。
「本番システムにおけるmulti-LLMルーティングについて、2023~2026年の査読済み情報源を探してください。ベンダーのランディングページは除外してください。各情報源について、主張されているコストまたは品質の改善、評価手法、著者が認めている制約を1つ抽出してください。」
論文を捏造せずにこの指示に従えないツールは、リサーチスタックではなく下書き支援ツールです。
マルチモデルルーティングは、コストを膨らませずに分析をどう改善するのか?
マルチモデルルーティングは、安価な分類と検索を小規模なモデルに送り、比較、矛盾の確認、構造化された推論にはより強力なモデルを割り当てることで分析を改善します。適切に行えば、品質を高めつつ支出も減らせます。不適切に行えば、ルーター自体が追加の課金工程になります。
AWSは、ルーティングを2つに分類しています。専用インターフェースを通じた静的ルーティングと、モデルを選ぶ前にプロンプトを分類する動的ルーティングです。動的ルーティングでは、分類モデル、意味的類似性、または両者のハイブリッドを利用できます。Amazon Bedrock Intelligent Prompt Routingは、品質基準を満たせるより安価なモデルを選ぶことで、リクエストコストを最大30%削減する管理型の方法として紹介されています。
MindStudioは、すべての工程を最先端モデルに送るのではなく、計画と実行を分けてタスクに適切なモデルを割り当てることで、コストを60%削減できると報告しています。この数値はベンダー報告であり、保証ではなく上限値として扱うべきです。それでも、基礎にある考え方は有効です。分析には安価なサブタスクと高価なサブタスクがあります。
調査分析における実用的な分担は、次のようになります。
- 小規模または高速なモデル: 文書へのタグ付け、引用文の抽出、引用表記の正規化、テーマのクラスタリング。
- 中程度のモデル: 手法の要約、不足している比較対象の指摘。
- 高性能モデル: 矛盾の調整、因果関係の主張の検証、分析メモの作成。
Jenovaは、ユーザーがアプリ間でメモをエクスポートすることなく、1つのプロジェクト内でモデルプロバイダーを変更できるため、この分担を支援します。ただし、ルーティングの質はタスク定義の質を超えられません。1つのエージェントに「すべてを分析して」と頼むなら、余分なオーバーヘッドを伴う単一モデルのワークフローを再構築しただけです。
AWSも、カスタムルーティングにはレイテンシーと分類コストが加わるため、節約額がルーティングコストを上回る必要があると指摘しています。20分で作るブリーフィングなら、強力なモデル1つの方が安いことがよくあります。繰り返し実行するリサーチパイプラインなら、通常はルーティングが元を取ります。
それでも単一AIモデルがより優れた文章を作るのは、どのような場合か?
単一AIモデルがより良い文章を作るのは、タスクが直線的で、情報源がすでに選ばれており、独立した検証よりも文体の一貫性が重要な場合です。このような場合、追加のエージェントは文章の継ぎ目、遅延、矛盾する修正を増やしかねません。
GitHubのエージェントオーケストレーションに関するガイドは、タスクが単純で直線的なら、単一エージェントの方が適していると明言しています。執筆はしばしばこの説明に当てはまります。アウトライン、メモ、直前の3段落を確認できる1つの長文コンテキストモデルは、下書きを回し合う3人の専門家より、通常は安定した文体を維持できます。
Claudeは最も明確な例です。長文の学術執筆に繰り返し推奨されているのは、ツールの切り替えではなく、持続した文章作成が仕事の中心だからです。ChatGPTは、引用のアーキテクチャより速度が優先されるメール、ブリーフ、初稿には十分であることが多いでしょう。
単一モデルによる執筆が不利になり始めるのは、下書きがライブの根拠、複数の利害関係者向けバージョン、または元の執筆者を信頼すべきでないQA工程に依存する場合です。そこでは、執筆エージェントと別のレビューエージェントを組み合わせることに正当性があります。
JenovaのWriting Assistantは、この範囲の中間に向けて設計されています。形式と対象読者に適応し、安定した文体を保ち、すでに調査資料を持つワークスペース内に留まります。自己完結型のエッセイでは、Claudeより自動的に優れているわけではありません。先に集めた同じ情報源、除外基準、用語を下書きで使い続ける必要がある場合に、より強みを発揮します。
単一モデル向けの執筆ブリーフも、厳密にすべきです。
「このプロジェクトにすでにある8つの情報源だけを使い、プロダクトマネージャー向けに900語の解説を書いてください。新しい引用は追加しないでください。読みやすさは非技術者向けに保ってください。添付メモで裏付けられていない主張は明示してください。」
執筆タスクをこれほど明確に指定できるなら、1つのモデルは妥協ではありません。それが正しいアーキテクチャです。
調査ワークフローにおいて、単一エージェントとマルチエージェントのアーキテクチャはどう異なるか?
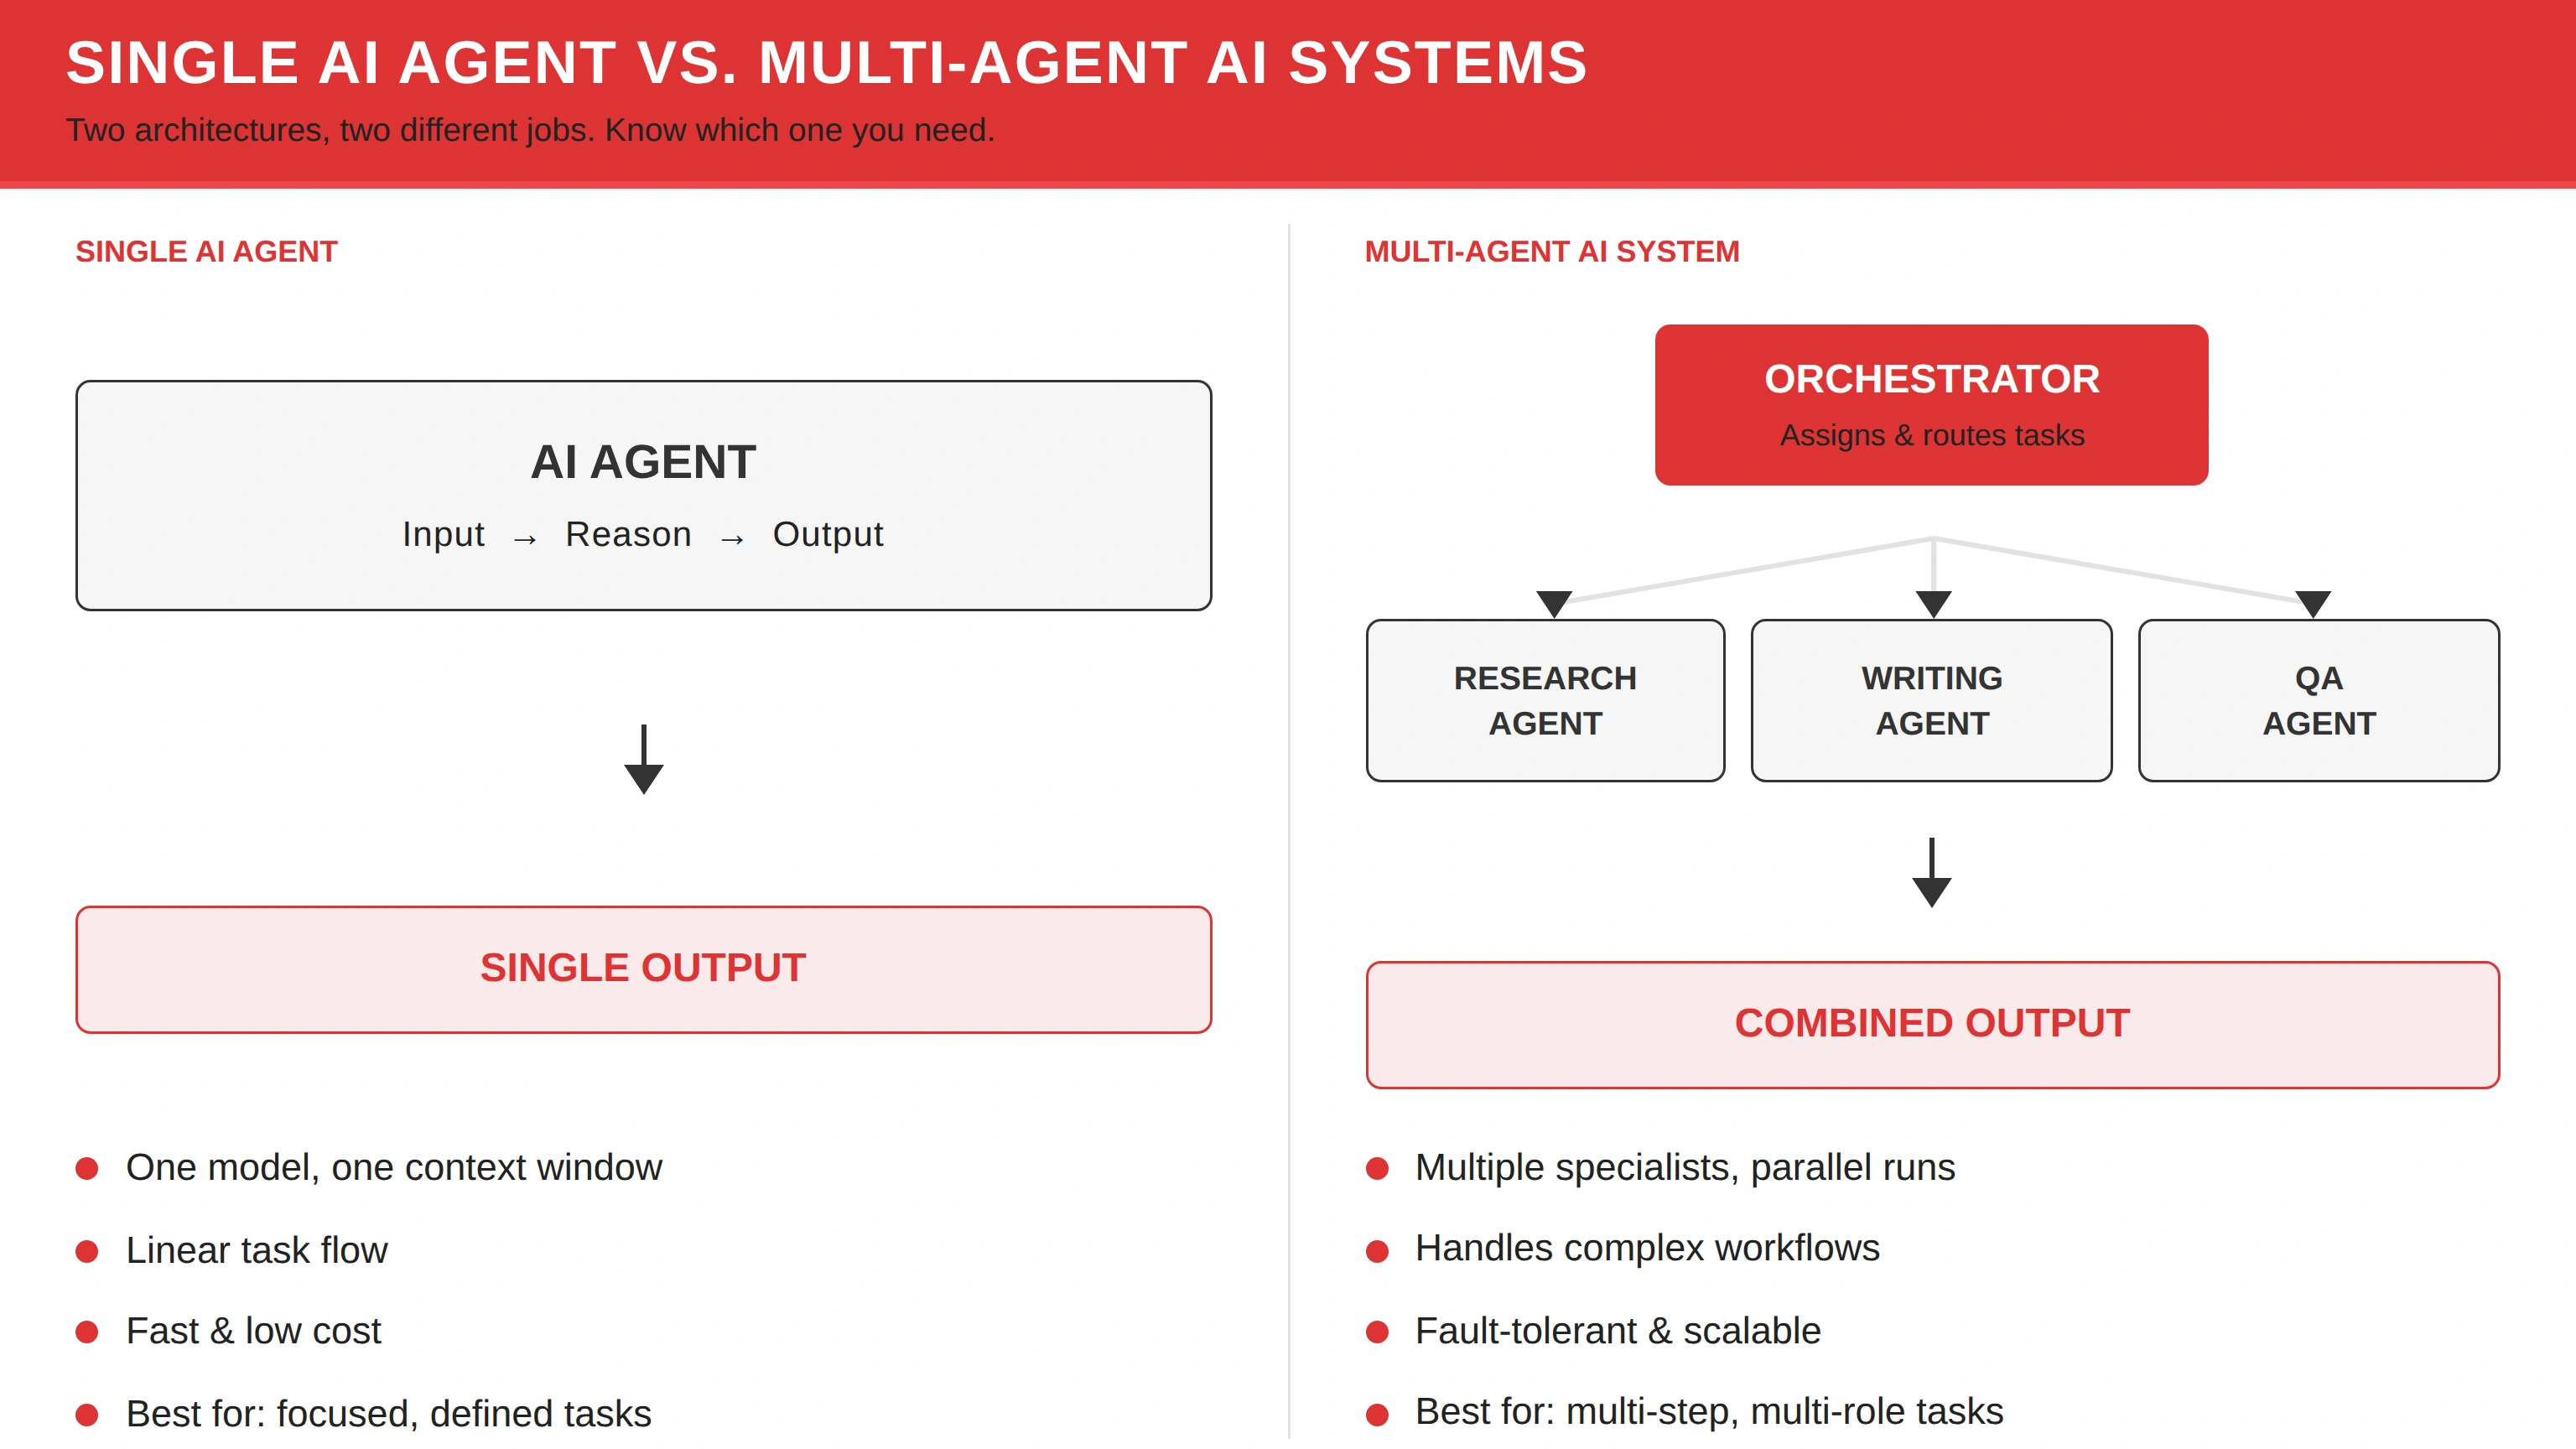
単一エージェントシステムは、1つのモデルと1つのコンテキストウィンドウを使い、入力・推論・出力という直線的なループで動作します。一方、マルチエージェントシステムは、オーケストレーターを使い、調査、執筆、QAなどの専門的な役割を割り当てます。前者は定義済みのタスクでより速く安価です。後者は複数工程の作業でより障害耐性があります。
AIエージェントオーケストレーションとは、状態、権限、人間によるチェックポイントを含め、共有目標に向けて複数の自律エージェントを調整する制御層です。これは単に複数のエージェントを持つこととは異なり、モデルとAPIを順番に実行するだけの通常のAIオーケストレーションとも異なります。Kimiは同じパターンをワークフローの観点から説明しています。1つのエージェントが調査し、別のエージェントが計画し、さらに別のエージェントが執筆します。
このアーキテクチャ上の対比は、学術的な制作工程で最も見えやすくなります。2026年4月、Google Researchは、検索、計画、スタイリング、可視化、批評という5つのエージェントからなるPaperVizAgentを紹介しました。このシステムは図表生成で、人間のベースライン50.0に対し60.2を記録しました。併設されたScholarPeerは、査読を1回限りのテキスト生成として扱うのではなく、複数のエージェントを用いてライブの文献に根拠付けます。これらの結果は、すべてのマルチエージェントスタックが優れていることを証明するものではありません。しかし、専門化と批評の組み合わせが、単一プロンプトを上回り得る理由を示しています。
コストも同様に具体的です。マルチエージェントシステムには、明示的なプロトコル、より多くのインフラ、コスト上限が必要です。オーケストレーションがなければ、エージェントは作業を重複させたり、競合したり、支出が急増するまで再試行したりする可能性があります。単一エージェントシステムには逆のリスクがあります。1回の失敗で仕事全体が終わってしまうことです。
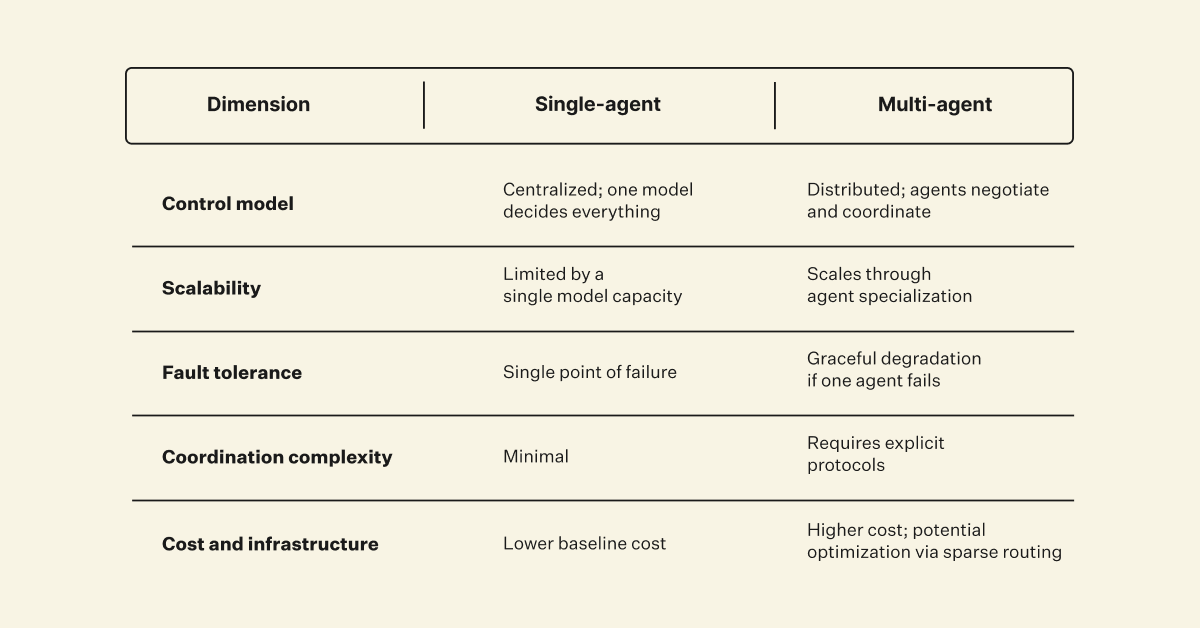
調査と執筆における有用な基準は、役割の数です。仕事に役割が1つしかないなら、エージェントも1つにします。調査者、執筆者、レビュー担当者がいるなら、オーケストレーションされたシステムを使うか、自分自身がオーケストレーターになることを受け入れるべきです。
完全なAI支援型の調査・執筆ワークフローをどう構築するか?
完全なAI支援型の調査・執筆ワークフローは、情報探索、分析、執筆を分離し、プロジェクト全体に1つのチャットを使うのではなく、各層に対して単一モデルツールまたはルーティングプラットフォームを選ぶことで構築できます。
持続性のある流れは次のとおりです。
- 意思決定を定義する。 最終文書が答えるべき質問と、それを反証する条件を書き出す。
- 検索優先ツールで情報源を集める。 論文レベルのレビューにはElicitまたはConsensus、Web規模のブリーフィングにはPerplexity、同じワークスペースで引用を保持する必要がある場合はJenovaのAcademic Research Assistantを使う。
- 第2のモデルで分析する。 単なる要約ではなく、手法、意見の相違、確信度を抽出する。
- 執筆専門ツールで下書きを作る。 自己完結型の原稿にはClaudeを使い、プロジェクトメモリとの結び付きを維持する必要がある場合はJenovaのWriting Assistantを使う。
- 厳しいQA工程を実行する。 別のモデルに、引用、時系列、過剰な主張を徹底的に検証させる。
- 成果物を確定する。 根拠のない主張を削除または弱めてからエクスポートする。
Jenovaでは、この一連の工程を1つのアカウント内に留められます。ユーザーはAcademic Research Assistantから始め、分析工程ではモデルを切り替え、その後にWriting Assistant、または公開記事を出力する場合にはSEO Blog Generatorを使い続けられます。永続的なメモリと添付ファイルにより、ツール間で通常発生する制約の損失を抑えられます。
調査から執筆への適切な引き継ぎプロンプトでは、変更してはならないものを明確にします。
「以下は情報源パケットと、すでに却下した主張です。政策担当者向けに分析セクションを下書きしてください。各段落には、採用された情報源を1つ必要とします。主張が推論である場合は、推論であると明記してください。却下した主張を復活させないでください。」
単一モデルツールでも、同じワークフローは実行できます。ただし、ルーターは自分自身です。新しいチャット、貼り付けたメモ、手動でのQAモデルの利用が必要になります。たまに行う仕事であれば、それが適切な設計である場合もあります。しかし、プロジェクトが数週間続く、または複数種類の文書を含む場合には脆弱になります。
Jenovaは、単発の要約を作る最も静かな方法ではありません。その利点は、上記のワークフローを、3つのサブスクリプションと各要素を揃えるための個人的な記法システムなしに実現できることです。
AIインフラチームは、単一モデルとマルチモデルのスタックについて何を語っているか?
AIインフラチームは一般に、直線的な作業では単一モデルツールを正しい標準選択と見なし、ワークフローに専門的な役割、コスト制約、独立したレビュー工程が加わった時点でマルチモデルプラットフォームを正しい標準選択と見なしています。
「私たちが目にする最も高コストなリサーチ上の誤りは、間違った最先端モデルを選ぶことではありません。1つのモデルを調査者、分析者、編集者として使い、最終段落の流暢さを信頼してしまうことです。同じシステムが情報源を捏造し、その情報源に依存する文章まで書くと、内部警報は存在しません。第2のモデルが真実を保証するわけではありませんが、異議を唱える機会は生まれます。」
「ルーティングは、仕事を明確に定義できて初めて、その複雑さに見合います。『これを調査して書き上げる』は、まだ1つの仕事です。『候補論文を集め、手法を抽出し、矛盾を調整し、下書きを作り、引用を検証する』は5つの仕事です。この分解を省くチームは、マルチエージェントの図を購入しても、結局は単一のプロンプトを実行しています。」
「コストの議論は現実的ですが、両方向に働きます。Amazonが公開したルーティング研究は、すべてのリクエストを最強のモデルに送ることが無駄遣いであると示しており、分類と下書きを分ける場合には、30%から60%の削減というベンダー報告も十分にあり得ます。逆の失敗も一般的です。短いメモなら慎重なモデル1つで済んだ支出より、オーケストレーター、分類器、3人の専門家の方が多く使ってしまうことがあります。」
— Jenovaプロダクトチーム、AIワークフローアーキテクチャ、マルチモデルエージェントシステム開発8年
この見解は、公開されているエンジニアリング文献とも一致します。AWSは、マルチLLMルーティングを、普遍的なアップグレードではなく、混在するタスク種別への対応として扱っています。GitHubは、エージェントが増えた後にオーケストレーションが必要になるのであって、その前ではないと扱っています。専門家の合意は条件付きです。仕事に分断点があるときにモデルを追加し、単純なタスクを飾るためにモデルを追加してはなりません。
どのような場合に単一モデルのリサーチツールを使い続けるべきか?
質問の範囲が限定され、情報源がすでに手元にあり、締め切りが短く、最初のシステムを監査する第2のシステムが不要な場合は、単一モデルのリサーチツールを使い続けるべきです。このような条件では、マルチモデルルーティングは真実性をほとんど高めず、調整コストだけを追加します。
次の場合は、ChatGPTまたはClaudeを使い続けてください。
- 文献全体をマッピングするのではなく、よく知られた概念を説明する場合。
- すでに信頼している文書を書き直す場合。
- 文体、構成、論点の順序を検討する場合。
- 別のチームメンバーへの引き継ぎなしに、1回の作業時間で完結する場合。
次の場合は、PerplexityまたはElicitを使い続けてください。
- 引用が必要な個別の質問をする場合。
- 詳細な読解の前に要旨をスクリーニングする場合。
- 別の場所で執筆する文献調査を行う場合。
次のうち2つ以上が当てはまる場合は、マルチモデルのタスクルーティングプラットフォームへ移行してください。
- プロジェクトが検索、分析、完成原稿の作成を組み合わせている。
- 成果物で、下書きをまたいで情報源の履歴を維持する必要がある。
- 抽出、推論、文章作成に異なるモデルが必要である。
- 再利用可能なワークフローが重要になるほど、作業が頻繁に繰り返される。
- 誤った引用のコストが高い。
Jenovaは後者のリストに該当します。Elicitの論文抽出ワークフローの代替としては弱く、静かに長文コンテキストで執筆する用途ではClaudeより弱い面もあります。しかし、これらの仕事をメモリ、モデル選択、専門エージェントとともに1か所で実行する必要がある場合には、より強力です。
したがって、これは忠誠心を試す「単一モデル対マルチモデル」の選択ではありません。自分のワークフローがまだ会話の形をしているのか、それともすでに生産ラインの形をしているのかという問題です。会話には1つのモデルが向いています。生産ラインにはルーターが向いています。
参考文献
- AWS Machine Learning Blog — AWSにおける生成AIアプリケーション向けマルチLLMルーティング戦略
- The Chicago School Library — 人工知能ツールとリソース:利点と制約
- University of the District of Columbia Library — 生成AIの用途と制約
- PapersFlow — 2026年の研究者向け最適AI:カテゴリ別に比較した10ツール
- Thesify — 2026年の学術研究向け最適AIツール
- HatchWorks AI — 大規模言語モデルのユースケース:LLM 1つか複数モデルか
- TrueFoundry — マルチモデルルーティング:AIタスクを効率的に最適化する
- Synthesia — 2026年の最適なAIツール12選
- AnswerThis — 2026年の研究者向けAIツール上位10選
- Zerve — 2026年のリサーチ向けAIツール:文献レビューと分析
- Multi — 1つのタスクに、適切なAIワークフローを
- ConvergePanel — リサーチ向け最適マルチモデルAIツール
- Argumentree.AI — マルチモデルと単一モデルによるAIリサーチの比較
- MindStudio — タスクに適切なモデルを割り当ててコストを60%削減する方法
- GitHub Resources — AIエージェントオーケストレーションとは?
- Kimi AI — AIエージェントオーケストレーション:種類、手順、利点
- Google Research — より良い図表と査読のための2つのAIエージェントの紹介