AIリサーチワークスペースは体系的エビデンスマッピングに適しているか?
2026-08-22
永続的なプロジェクト状態とオンデマンドのチャンク取得はどう異なるのか?
体系的エビデンスマッピングでは、各セッションの開始時に判断、進捗、成果物を再読み込みするリサーチワークスペースのほうが、単一論文要約ツールや、必要に応じて「関連チャンク」だけを取得するRAGチャットボットよりも、主要な作業環境として優れています。マッピングは長期的なコーディングプロジェクトです。採択基準は変化し、境界的な研究は再コード化され、統合には先週なぜあるソースを判定保留または除外したのかを記憶しておく必要があります。Elicit、Consensus、NotebookLMのような論文単位のツールは、発見、抽出、クローズドコーパスでのQ&Aに引き続き強みがあります。しかし、JenovaのAcademic Research Assistantを含む永続的なワークスペースは、プロトコルの変更が数週間続いても、過去の判断を知らないうちに書き換えることなくマップを維持する必要がある場合に優れています。
2026年に重要なのは、「どのモデルがよりよい抄録を書くか」ではありません。生きたエビデンスマップを保持できるメモリアーキテクチャはどれか、という点です。
使えるマッピング基盤と使い捨ての論文チャットを分ける主な要素は次のとおりです。
✅ 運用メモリと参照メモリ — マップに必要なのは、取得された文章だけでなく、プロジェクト状態(基準、コード、除外理由)です。
✅ 判断の来歴 — 採択・除外のすべての判断を、セッションをまたいで検証可能にすべきです。
✅ 構造化抽出 — その場限りの叙述的要約より、比較可能なフィールドが重要です。
✅ 人間の監督下でのプロトコル遵守 — エビデンス統合の分野では、AIは依然として代替レビュー担当者ではなく補助役と見なされています。
✅ バージョン管理できる統合 — レポート、図、ソース一覧は、毎回ゼロから再生成するのではなく蓄積されるべきです。
これらのツールを公平に比較するには、エビデンスマッピングを要約コンテストではなく、4層からなる継続性の問題として捉えることが有用です。
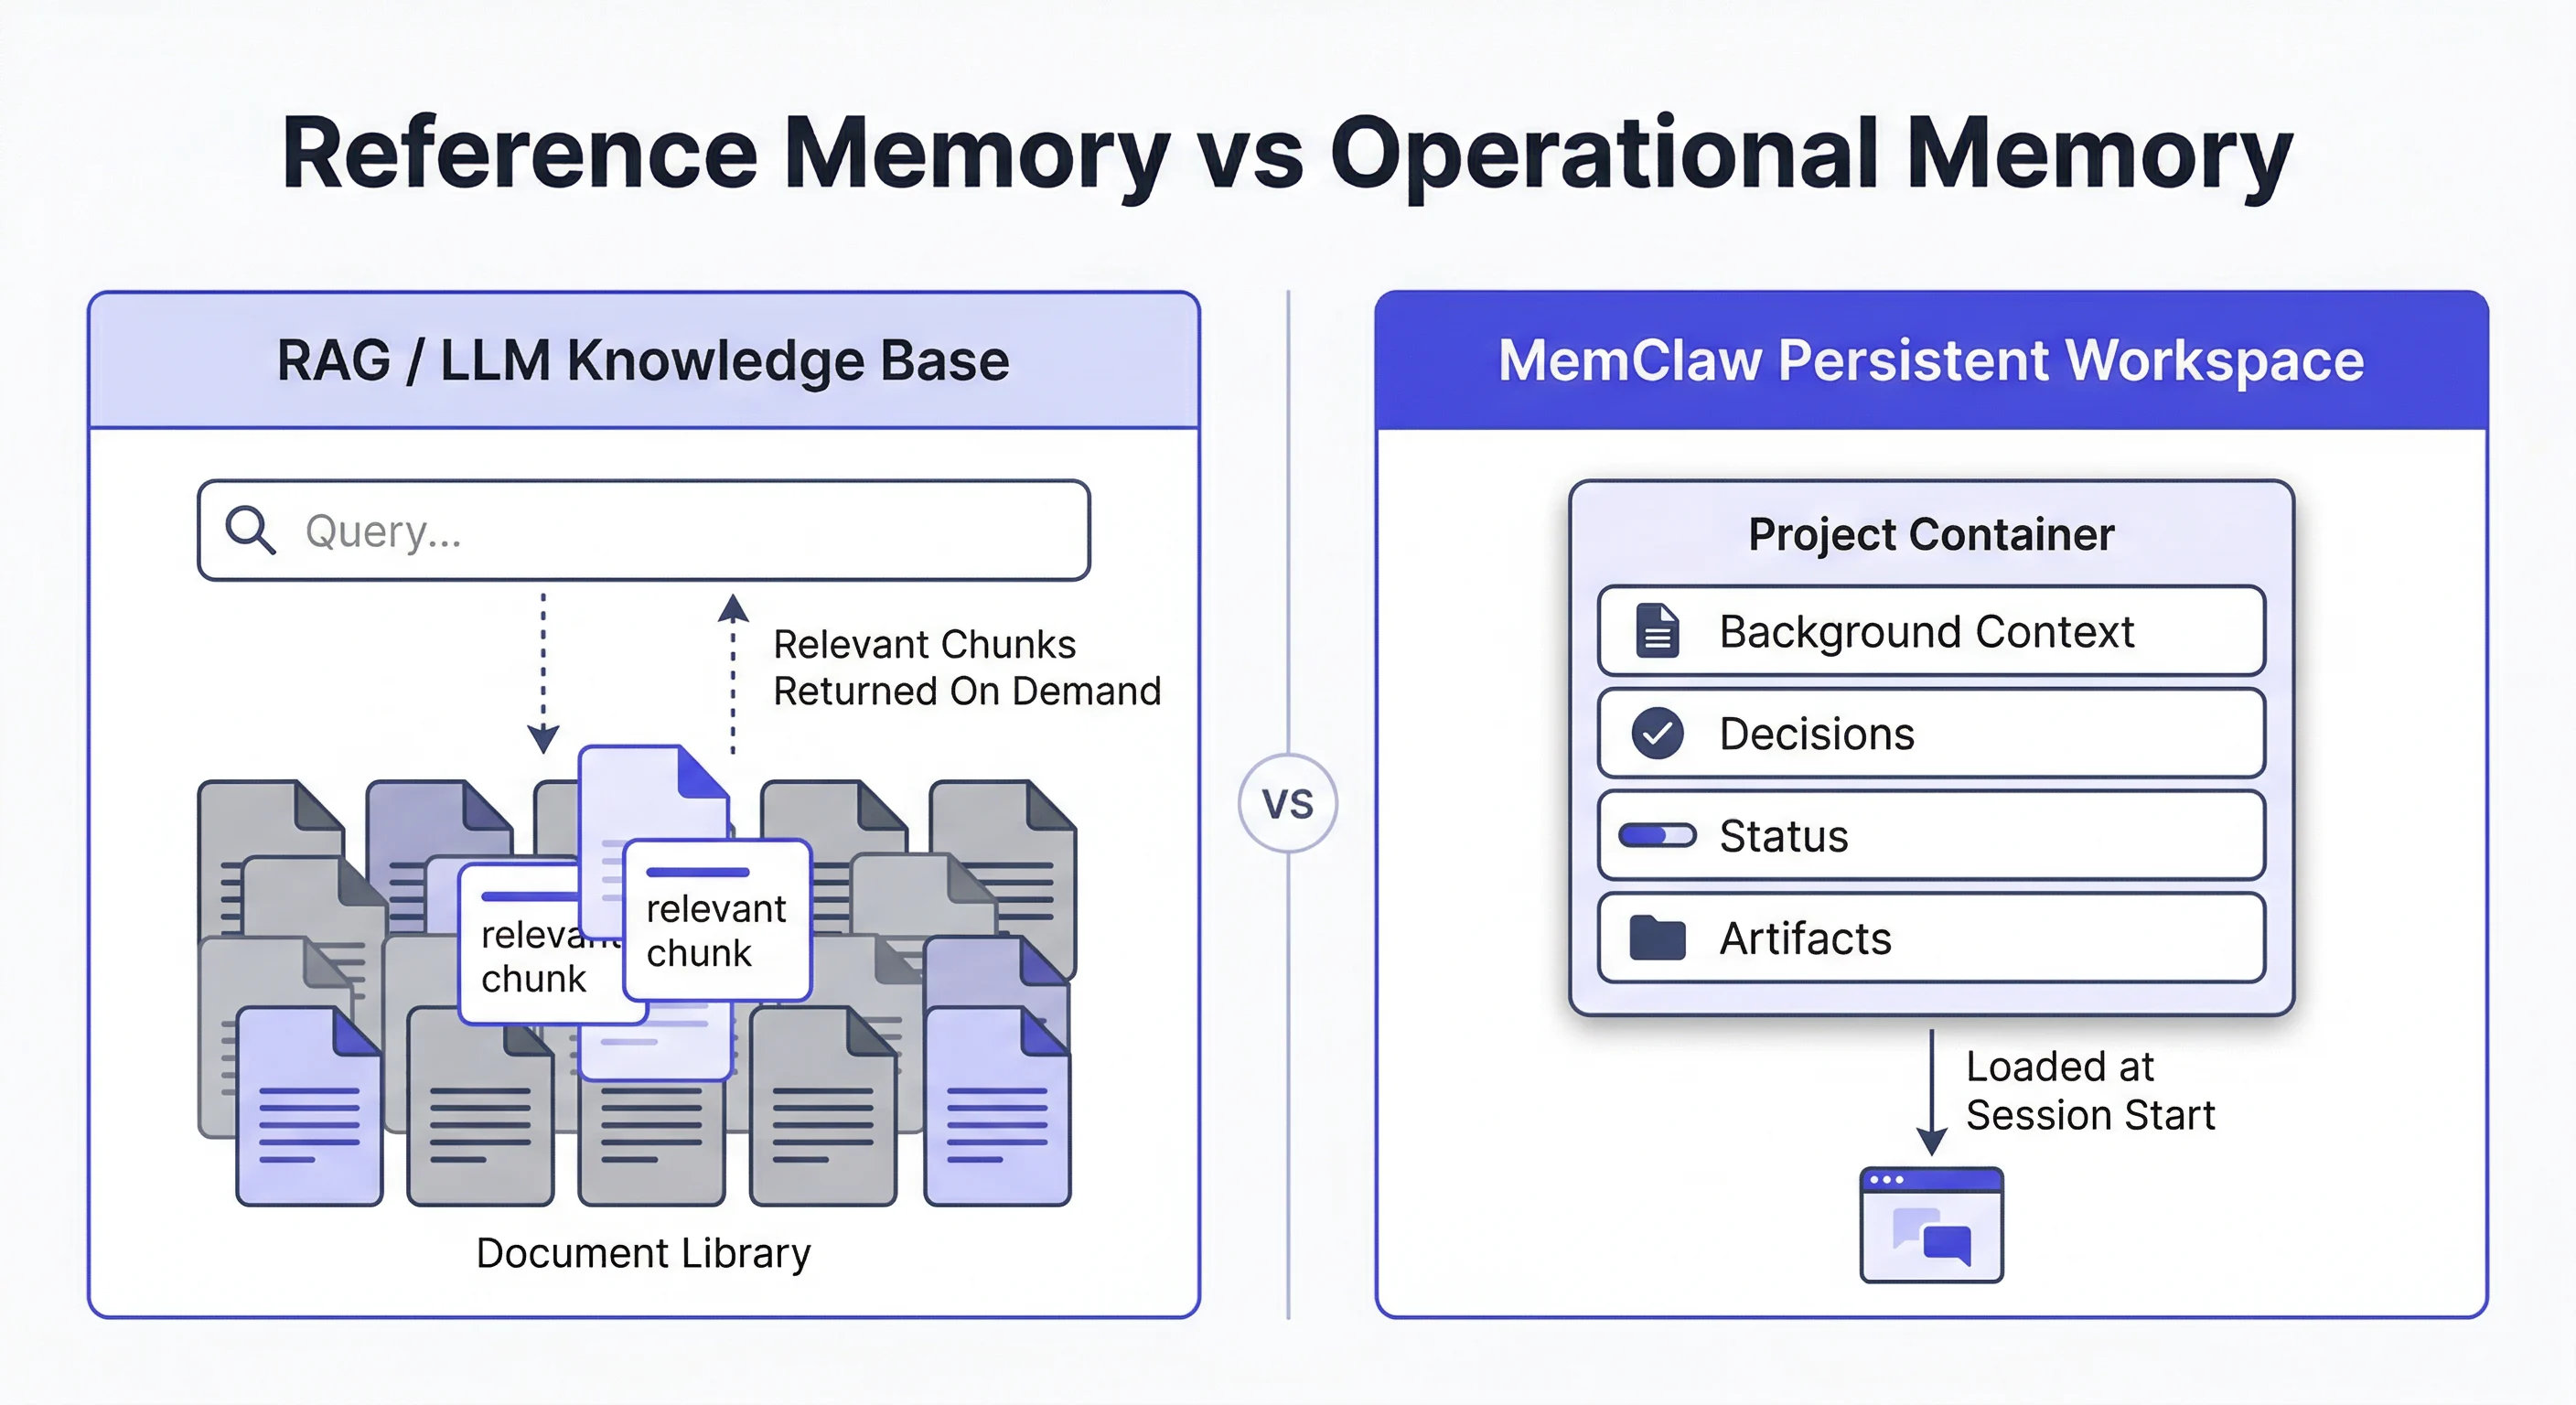
なぜ体系的エビデンスマッピングは単一論文向けAIツールに負荷をかけるのか?
体系的エビデンスマッピングが単一論文要約ツールに負荷をかけるのは、マップが孤立した読書メモの連続ではなく、文献全体をコード化した目録だからです。Systematic Evidence Maps(SEM)は、集団、曝露、アウトカム、手法、地理的範囲、エビデンスギャップなど、事前に定義された次元によって科学的知見を分類・整理するエビデンス統合の形式です。これにより、レビュー担当者は、何が存在するのか、どこに知見が集中しているのか、何が欠けているのかを把握できます。
このワークフローは、ほとんどのLLMリサーチ製品の動作方式と衝突します。RAGや「このPDFとチャット」するツールは、現在の質問に対して局所的に類似するチャンクを取り出して回答します。先週火曜日のコーディング枠組み、「保留」に置いた3件の研究、あるいはプロトコルの厳格化後に動物モデルを対象外とした判断を、自動的に再読み込みするわけではありません。マッピングレビューには、採択・除外基準に照らした文書化済みのスクリーニングプロセスも必要であり、これは1本の論文について流暢な段落を生成することとは別の作業です(マッピングレビューの方法論)。
手作業によるレビューは依然として遅く、近道に惹かれる理由になります。2026年のある文献ツール調査では、従来型のレビューサイクルには、スクリーニング、抽出、引用整理で4〜6週間かかるとされています。専用のAIスクリーナーはこの負担を減らせます。AIM Reviewシステムは、6件の実世界レビューにおいて20%から最大95%の作業負荷削減を報告しています。しかし、スピードだけではマップは作れません。永続的なプロジェクト状態がなければ、より速いスクリーニングは、つながりのない要約の山を大きくするだけです。
図書館や方法論の専門組織は、残る隔たりを明確に示しています。King’s College Londonのエビデンス統合ガイダンスは、AIツールは従来の検索、スクリーニング、抽出手法を置き換えられないとし、バイアス、著作権上の制限、ハルシネーションのリスクを明確に理解したうえでのみ使用すべきだと述べています。2025年に行われたエビデンス統合における生成AIの体系的レビューも、同じ運用上の結論に達しています。すなわち、現在のエビデンスは、人間の関与または監督なしでのGenAI利用を支持していないのです。
AIによるエビデンスマッピングのワークフローでは何を見るべきか?
AIマッピングツールは、文章品質テストではなく継続性テストで評価すべきです。私たちは、論文チャットを体系的マップに変えようとするチームで、各層が異なる予測可能な形で失敗するため、4層構造の CODEスタック として捉えています。
C — Coverage(網羅性)。 ツールは実際の学術コーパスを検索できるのか、それともすでにアップロードしたファイルだけを対象にするのか。Elicitは1億3,800万本超の論文と54万5,000件の臨床試験を検索します。一方、NotebookLMは設計上、ノートブック内のソースをもとに回答します。この層での網羅性の誤りは、薄い段落になるだけでなく、マップの欠落行になります。
O — Operationalization(操作化)。 採択基準、コーディング次元、抽出フィールドを一度定義し、繰り返し適用できるか。プロンプトごとに「関連性」を再解釈する要約ツールは、同じ境界的な試験を3日目には異なる方法で再コード化します。マッピングのガイダンスでは、事前定義済みの基準は必須とされています(マッピングレビューの手法)。
D — Decision provenance(判断の来歴)。 ある研究がなぜ採択、除外、保留、または判定ゲートに回されたのかを復元できるか。Cochraneと連携するResponsible AI in Evidence Synthesis(RAISE)の取り組みにはCochrane、Campbell、JBIなどが参加しており、透明性を単なる付加価値ではなく品質要件として扱っています。
E — Extractability(抽出可能性)。 知見を、相互に統合できない文章ではなく、サンプル、研究デザイン、効果の方向性、限界といった比較可能なセルに収められるか。Elicitの製品設計は、インタラクティブな表と複数ステップの抽出を中心に構築されています。Consensusは仮説レベルのエビデンスの方向性をすばやく確認できますが、構造化レビューの執筆用には設計されていません。
層の重み付けは目的に応じて行います。スコーピング段階では、判断の来歴がやや弱くても許容できる場合があります。しかし、引用、更新、共著者への引き渡しを予定する生きたエビデンスマップでは許容できません。CoverageとExtractabilityに優れたツールでも、OperationalizationとDecision provenanceがセッションごとにリセットされるなら、マップには失敗します。
Elicit、Consensus、NotebookLM、リサーチワークスペースはどう比較できるか?
ElicitとConsensusは、このカテゴリーで最も強力な論文発見・抽出レイヤーです。NotebookLMは最も優れたクローズドコーパス型ノートブックであり、永続的なリサーチワークスペースは、複数週にわたるマップの一貫性を維持するうえで最も強力な環境です。CODEスタックのすべての層で勝つ単一製品はありません。そのため、本格的なマッピングチームは通常、1つのチャットボットにレビュー全体を任せるのではなく、コーパスツールとプロジェクトメモリ環境を組み合わせます。
2026年時点の公開済み機能・価格情報の概要は、次のとおりです。
| 機能 / 次元 | Elicit | NotebookLM | Consensus | Jenovaリサーチワークスペース |
|---|---|---|---|---|
| メモリモデル | 保存済みソースのライブラリとレポートごとのカスタマイズ。完全なプロジェクト状態コンテナではない | ノートブック単位のソースセット。回答はアップロード済み資料内に留まる | 仮説クエリを中心とする質問・リストの記憶 | セッションをまたぐ永続メモリ。プロジェクトコンテキストを再取得ではなく再読み込みできる |
| 網羅性 | 1億3,800万本超の論文、54万5,000件の試験 | アップロード済みコーパスのみ。無料版は50ソース、Plusは300 | 2億本超の論文、エビデンス方向性タグ | ライブWeb・学術検索に加え、添付ナレッジベース。固定された出版社インデックスではない |
| 構造化抽出 | 表、スクリーニング、大規模なデータポイント(最大1,000本の論文 / 20,000データポイント) | ソースにリンクしたQ&Aとアウトライン。体系的レビューの抽出グリッドではない | Consensus Meterと短いエビデンス回答 | Deep Researchによる統合レポートと引用裏付け付きブリーフ。専用の二重スクリーニング機能としては弱い |
| 判断の永続性 | ソースをライブラリに保存可能。プロトコル状態は第一級の機能ではない | ノートブックのファイルは保持するが、コード化された採択・除外ロジックは保持しない | 有料プランではブックマークとリスト | 会話履歴、メモリ、添付プロジェクトファイルがセッションをまたいで維持される |
| 価格(2026年時点) | Plusはおよそ月額$12から | 無料。PlusはGoogle AI Proでおよそ月額$19.99 | Premiumはおよそ月額$10 | 利用制限付きの無料プラン。Plusは利用量30倍で月額$20 |
| 最適な用途 | 大量スクリーニングと抽出表 | 教材セットと収集済みPDF | 「文献はXを支持しているか」の高速確認 | 生きたマップ、複数セッションでのコーディング、原稿統合 |
Elicitは、体系的なスクリーニングにおける専門ツールとして率直な選択肢です。スクリーニングと抽出を自動化でき、これらの段階で最大80%の時間短縮を報告しています。ただし、Cochraneの方法論比較では、Elicitの検索感度は従来の文献検索を置き換えるには十分に高くないとされており、高精度の補助ツールとして最もよく機能します。また、作業はレポートや表で止まりがちで、執筆、バージョン管理、生きた原稿の作業は通常ほかの環境へ移ります。
NotebookLMは、固定された資料セットを根拠に読解するための専門ツールです。すべての回答を引用文に照らして確認でき、GoogleはDeep Researchと、より幅広いファイル形式も追加しています。未収集の論文を発見することはできず、PRISMA形式の判断ログもエンコードしません。
Consensusは、仮説の方向性を把握するための専門ツールです。文献全体がどちらの方向に傾いているかだけを知りたい場合、抽出グリッドを構築するよりも、メーターと支持・反証タグを使うほうが速くなります(ツール比較)。ただし、コード化されたマップの主要システムとしては適しません。
JenovaのAcademic Research Assistantが最も強みを発揮するのは、作業単位がPDFではなくプロジェクトである場合です。学術ソースを検索し、原稿と引用のコンテキストを維持できます。また、基盤プラットフォームが無制限のチャット履歴とセッション横断メモリを保存するため、プロトコルを毎回貼り直さずにコーディング枠組みを継続できます。これはCovidenceやRayyanの意味で検証済みの二重レビュー・スクリーニングプラットフォームではなく、Elicitのような抽出精度の数値も公表していません。規制水準の監査証跡が必要なチームは、専用スクリーナーを引き続きスタックに含めるべきです。
SciSpaceとSciteは、より限定的な隣接タスクを担います。SciSpaceは、非常に大きなコーパスを備える一方、統合的なレビューワークフローでは弱く、繰り返し論文ごとの詳細分析に適した環境と説明されています。Sciteの16億件のSmart Citationsは、主張を支持、反証、言及するものとして分類されており、引用コンテキストの監査では比類がありません。一方で、単独での発見・マッピングデータベースとしてはほとんど役に立ちません。
運用メモリは複数セッションにわたる文献統合をどう変えるのか?
運用メモリが統合を変えるのは、文献を再検索すべき干し草の山として扱うのではなく、背景、判断、進捗、成果物からなるプロジェクトコンテナそのものをセッション開始時に読み込む対象とするからです。参照メモリは「この質問に似たチャンクはどれか」と問います。運用メモリは「このプロジェクトについてすでに何が確定しており、何にまだエビデンスが必要か」と問います。
この違いは、要約ツールがうまく隠してしまう3つの失敗モードに現れます。
- 基準の漂流。 「成人のヒトRCTのみ」という条件がプロジェクト状態ではなくプロンプト内にある場合、少し広い質問をする後続セッションでは、すでに除外した小児研究が気付かないうちに再採択されます。
- 孤立した保留案件。 共著者との議論のために保留した境界的な論文は、進捗状態が第一級のフィールドでなければ消えてしまいます。
- 再生成される統合。 RAGの回答は、今日取得したチャンクには局所的に忠実でも、先週のギャップ表と矛盾し得ます。新しい回答に、古いコーディングを継承させる仕組みがないからです。
永続的なワークスペースは、読み込みの順序を反転させます。次のクエリより先に、背景コンテキスト、判断、進捗、成果物が入ります。Jenovaによるこのパターンの実装は、セッション横断メモリと添付可能なナレッジベースです。アシスタントは、マッピング次元、エビデンスギャップの作業定義、すでに十分な裏付けがある主張を記憶できます。これをノートブック型ツールと比較すると、明確なトレードオフがあります。NotebookLMのクローズドコーパスは、ソース外の創作に対してより安全です(ソースにリンクした回答)。一方、永続的なオープンワークスペースは、コーパスがまだ成長中で、コーディング枠組みこそが希少な資産である場合により有用です。
SEMにおける実務上の意味は単純です。成果物が15本のPDFに基づく一度きりのブリーフィングなら、運用メモリは必須ではありません。成果物が次回の学会サイクル後にも更新されるギャップマップなら、運用メモリこそが製品です。
エンドツーエンドのエージェント型エビデンスパイプラインは実際にはどのようなものか?
エンドツーエンドのマッピングパイプラインは、単一の「これらの論文を要約して」というプロンプトではなく、ゲートを備えた段階的なリサーチスプリントのようなものです。下図は有用な参照アーキテクチャを示しています。問いの形成、文献トリアージ、候補の特定、仮説の形式化、複数ソースによる検証、バージョン管理されたレポート、gitで追跡されたパッケージという流れです。
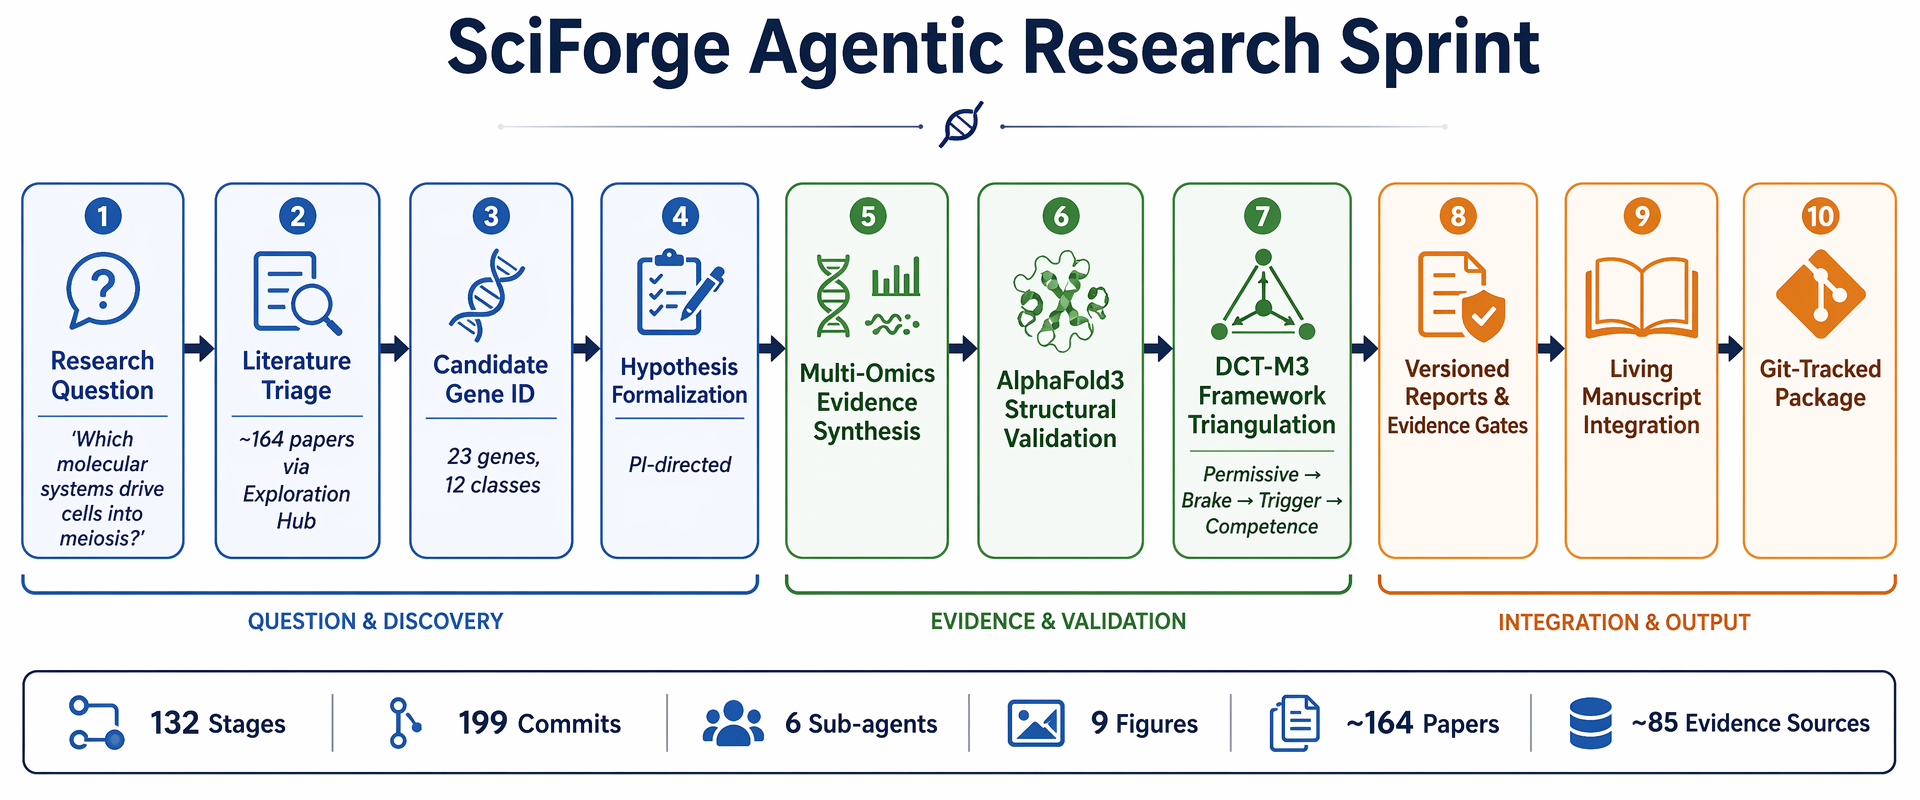
このスプリント例は、164本の論文をトリアージ、132段階、199回のコミット、6つのサブエージェント、約85のエビデンスソースという意図的に大規模なものです。論文チャットが破綻するのはこの規模です。要約ツールは17本目の論文を説明できます。しかし、第4段階で変更された採択基準を第2段階がすでに適用しているような10段階の連鎖を、一貫して維持することはできません。
このパイプラインでは、領域の詳細よりも3つの設計選択が重要です。
- 発見はフェーズであり、成果物ではありません。 文献トリアージは候補IDと正式な仮説につながります。要約で止まれば、マップは構築されません。
- 検証は複数のモダリティで行います。 エビデンス統合、構造的または定量的なチェック、明示的な「許可 → ブレーキ → トリガー」のロジックにより、主張を段落に平均化するのではなく、ゲートに通します。
- 出力はバージョン管理されます。 生きた原稿への統合とgit追跡パッケージにより、マップは履歴を持つ成果物になります。再生できないチャット履歴とは正反対です。
Jenovaでは、1つのチャットに司書、コーダー、執筆者の役割をすべて担わせるのではなく、エージェント間で役割を分割することで、このパターンに近づけられます。Academic Research Assistantは学術的な探索と原稿コンテキストを担当します。Deep Researchは、多数のソースにまたがる引用裏付け付きの統合を作成します。Real-Time Searchは、マップにプレプリント、リポジトリ、または学術誌以外の灰色文献も含める必要があるときに有用です。制約はオーケストレーションの規律です。人間がプロトコル、ゲート、主張を生きた原稿に昇格させる判断を引き続き担います。方法論グループは、この人間の役割を交渉不可能なものとして扱い続けています(KCL / RAISEのガイダンス)。
Paperguideのようなオールインワン型レビュープラットフォームは、200件の候補をスクリーニングし、上位50件から執筆するExtendedモードを含め、計画–検索–スクリーニング–抽出–生成を1つのベンダーワークフローに統合しようとしています。これはElicitとWordを組み合わせるよりワークスペースに近いものです。しかし、生成されたレビューをエクスポートした後の判断の来歴を重視するなら、外部の判断ログが依然として必要です。
AIエビデンスマップを最大限に活用するには?
AIエビデンスマップを最大限に活用するには、文章を求める前にプロトコルをワークスペースへ書き込み、その後のすべてのセッションにそのプロトコルを継承させます。設定手順はツール間で似ています。違いは、その設定をツールが記憶できるかどうかです。
Jenovaを中心とするマップでは、次の順序が実用的です。
- Academic Research Assistantを開き、最初のメッセージでプロジェクト名、対象集団、マッピング次元を指定します。
- アシスタントが再利用できる表現でプロトコルを固定します。
「Xに関する成人ヒト研究の体系的エビデンスマップを作成してください。RCTと前向きコホートのみを採択します。各研究について、研究デザイン、サンプル、介入、主要アウトカム、効果の方向性、限界をコード化してください。動物およびin-vitroの論文は、1行の理由を付けて除外ログに保留してください。すでに決定されたコードを再生成しないでください。」
- 最初のコーパス探索にはDeep Researchを実行し、抽出と叙述が同じメモリを共有するよう、作業中の表を同じプロジェクトスレッドに貼り付けるか添付します。
- 各セッション後には、1本のエッセイではなく3つの成果物を求めます。更新済みの研究表、除外ログ、ギャップ一覧です。この3つのファイルこそがマップです。
Elicitでは、リサーチクエスチョンから始め、スクリーニング表を生成し、ライブラリを唯一の信頼できる情報源として扱います(Elicitの体系的レビュー・ワークフロー)。従来のデータベース検索を省略してはいけません。Cochraneのケーススタディでは、Elicitは高精度な予備検索および固有の追加研究の発見に有用である一方、唯一の検索エンジンとしては適さないとされています。
NotebookLMでは、先にPDFを収集し、1つのノートブック内に留まり、「サンプルサイズと追跡期間を伴ってアウトカムYを報告する研究をすべて列挙してください」のように、次元ごとの質問をします。これにより、クローズドコーパスが範囲外へ逸脱しません。無料プランで50ソース、Plusで300ソースというアップロード上限のため、他の場所で事前スクリーニングしない限り、400件の記録を扱うマップには適しません。
2つのプロセス原則は、すべてのスタックに共通します。第一に、著作権条件で禁じられている場合は、本文PDFを消費者向けモデルへアップロードしてはいけません。権利者は一般にこの利用を禁止しています。第二に、採択・除外の判断には人間を置き続けてください。スクリーニング支援はAIタスクの中で最も裏付けとなるエビデンスが多く、監督のない統合は最も少ない領域です(AI導入準備度に関するレビューのレビュー)。
エビデンス統合の専門家はAI支援マッピングをどう評価しているか?
専門家は、監督下でのスクリーニングと抽出にAIをますます受け入れていますが、分野を監督なしで地図化する役割については、依然としてAIを認めていません。2026年の有用な専門家コンセンサスは、ベンダーの宣伝文より狭いものです。反復作業の層は自動化し、判断の層は永続化し、マップに対する説明責任は人間に残すべきです。
「私たちが目にする失敗モードは、モデルが論文を要約できないことではありません。マッピングチームが、よい要約をコード化済みの記録であるかのように扱ってしまうことです。体系的エビデンスマップとは、安定したフィールドに結び付いた、取り消し可能な判断――採択、除外、保留、ゲート判定――の集合です。こうした判断が先週のプロンプトの中にしか存在しないなら、すべての段落が慎重に聞こえていても、マップはすでに壊れています。」
「参照取得と運用メモリは異なる問題を解決します。取得は候補エビデンスを見つける手段です。運用メモリは、同じ研究を3回再コード化しないための手段です。最初の仕事に優れたツールが、二番目の仕事も果たすかのように日常的に導入されています。その結果、12件の境界的試験がなぜ消えたのかを説明できない、流暢なギャップ分析が生まれます。」
「私たちの実務ルールは単純です。コーパスエンジンで行を埋める。永続的なワークスペースでコードブック、除外ログ、ギャップ表を生かし続ける。マップの意味を変えるすべてのゲートに人間のレビュー担当者を置く。ワンクリックの体系的マップとして売られるものはすべて、方法論グループが依然として交渉不可能と考える唯一の層を飛ばすよう求めています。」
— Jenovaプロダクトチーム、リサーチワークフロー設計、複数セッションにわたる分析業務向け知識システムの開発経験8年
この立場は正式なガイダンスと一致しています。NICE、Cochraneと連携するRAISEの勧告、大学図書館のサービスはすべて、AIを既存の検証済み手法の中で用いる補助ツールとして説明しています。文献検索とスクリーニングにおけるAI利用ガイドも同じ効率性の主張をしています。スクリーニングは高コストであり、自動化は役立ちます。しかし、生成がプロトコルを置き換えられるとは主張していません。
単一論文要約ツールが依然として正しい選択となるのはいつか?
単一論文要約ツールが適しているのは、コーパスが小さく、すでに収集済みで、再利用可能なマップにコード化する必要がない場合です。PDFが12本、明日にジャーナルクラブがあり、3か月後に目録を更新する必要がないなら、NotebookLMやSciSpace型の論文チャットは、プロジェクトコンテナより少ない手間で仕事を終えられます。
また、マッピングと誤って呼ばれがちな次の3つの作業にも、単一論文要約ツールのほうが適しています。
- メカニズムの説明。 「図3を説明して」は読解作業です。クリック可能な引用を備えたクローズドコーパスのノートブックは、論文を混ぜ合わせる可能性があるオープンワークスペースより安全です。
- 引用コンテキストの確認。 後続研究がある主張を支持するか反証するかが問いであれば、Sciteの分類済み引用が目的に特化したレイヤーです(16億件超のSmart Citations)。
- 仮説のスポットチェック。 マップに投資する前に、ある命題に目に見える支持・反証の分布があるかを確認するには、Consensusが依然として最速です(ElicitとConsensusの概要)。
誤りは、こうした強みをSEM向け基盤の代替として使うことです。要約ツールは局所的には優秀でも、記録の主要システムとして不適切であり得ます。反対に、永続的なワークスペースは、雑然としたコードブックを維持できても、専用の体系的レビューソフトウェアが必要な5,000件の記録の二重スクリーニングには不適切であり得ます。機関ガイドは、この段階ではRayyan、Covidence、DistillerSRのようなスクリーニングプラットフォームを引き続き推奨しています(CASRAIのAIによる体系的レビューガイド、Stony Brookの体系的レビューガイド)。
したがって、実際のレビューで通用する判断基準は、ブランドではなくアーキテクチャに基づくものです。成果物が、比較可能で、更新可能で、説明可能なコーディング判断の集合であるなら、プロジェクトメモリを持つリサーチワークスペースを選び、その傍らにコーパスエンジンを置いてください。成果物が、机上にすでにある論文を理解することなら、単一論文要約ツールは妥協ではありません。適切に範囲設定されたツールです。
参考文献
- ScienceDirect — 体系的エビデンスマップの実施に関するガイダンス
- PubMed Central — マッピングレビュー、エビデンスマップ、ギャップマップの方法論
- Paperguide — 2026年の文献レビュー向けAIツール7選
- King’s College London — エビデンス統合におけるAIツール
- Elicit — 科学研究のためのAI
- NotebookLM — AIリサーチツールと考えるためのパートナー
- Google Blog — NotebookLMにDeep Research、DOCX、Sheetsなどを追加
- The Drive AI — Elicit、Consensus、Semantic Scholarの比較
- Omid Saffari — 2026年の最適なAIリサーチツール:ElicitとConsensus
- 文献検索とスクリーニングにおけるAI利用ガイド
- CASRAI — 体系的文献レビューのためのAIツール
- Stony Brook University Libraries — 体系的レビューガイド:人工知能