関連論文の探索では、AI研究支援ツールはキーワード検索より優れているのか?
2026-08-22
概念的に関連する論文では、意味的マッチングはいつキーワード順位付けを上回るのか?
セマンティックAI研究支援ツールは、探している論文が同じ考えを異なる用語で表現している場合、従来のキーワード検索を上回ります。一方で、対象にしたい正確なフレーズ、著者、引用クラスターをすでに把握している場合は、キーワード検索エンジンの方が依然として強力です。2026年における実務的な答えは、Google Scholarを捨てることではありません。語彙ベースの順位付けと意味ベースの検索を組み合わせることです。たとえば、Elicit、SciSpace、Undermind、Jenova's Academic Research Assistantのようなツールを活用します。
概念発見の有効性とキーワード照合を分ける主な要因は、次のとおりです。
✅ 語彙の柔軟性 — クエリが「心臓発作」であっても、「心筋梗塞」に関する論文を見つけられるか ✅ 順位付けシグナル — 引用数を重視した語彙スコア、埋め込み類似度、または関連性を判断するLLMのどれを使うか ✅ インデックスの深さ — タイトル・抄録メタデータのみか、数億件の文献を対象とした全文照合か ✅ 精度制御 — Booleanの入れ子、フィールド制限、ジャーナル品質フィルター、エクスポート上限 ✅ 有用な候補集合を得るまでの時間 — 即時の探索リストか、数分を要する反復検索か
これらの手法を正直に比較するには、どのツールが普遍的に優れているかを問うのではなく、語彙のずれ、順位付けの偏り、検索制御を別々の次元として扱う必要があります。
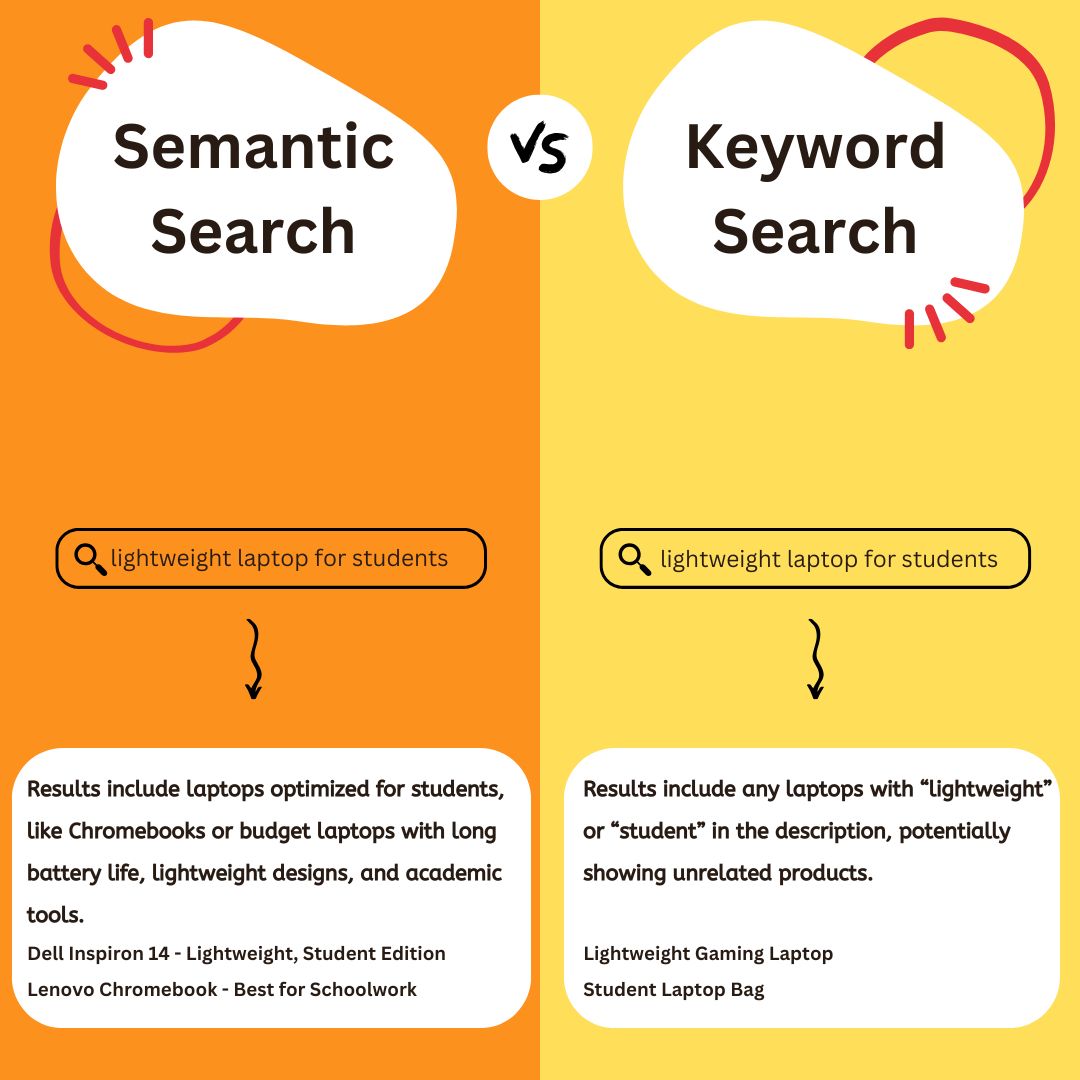
なぜ2026年になっても、語彙のずれは従来の学術検索を失敗させるのか?
語彙のずれが従来の学術検索を失敗させるのは、著者、分野、時代によって同じ現象の呼び方が異なり、語彙検索エンジンはクエリと十分な表層語を共有する文書しか検索できないためです。公衆衛生の論文では「身体活動」、循環器学の論文では「運動能力」、社会学の論文では「余暇時間の運動」と表現されるかもしれません。一つのフレーズだけで検索すると、残りの二つの論文群は最初の数ページから消えてしまう可能性があります。
Google Scholarは、依然として大半の研究者にとって標準的な出発点であり、出版社やリポジトリの全文を含む、利用可能な単一の学術検索対象として最も広範です。Singapore Management Universityの学術司書であるAaron Tayは、これを学術検索のスイスアーミーナイフと表現しています。一つしか残せないとすれば選ぶツール、という意味です。しかし、その順位付けは依然として語彙ベースです。タイトル一致の後は、被引用数の多い論文を強く重視します。これは基礎的・重要な研究を見つけるには優れていますが、異なる表現を使う概念的関連論文や、まだ引用を蓄積していない論文を探すには弱みになります。
クエリ語が一般的であるほど、問題は深刻になります。Google Scholarは全文を対象に照合するため、日常語と同じ名称を持つツールや概念を検索すると、偶発的なヒットが数千件に膨れ上がることがあります。Tayは、分野を限定する工夫を加えない限り、Google Scholarで「Elicit」を検索してもほとんど役に立たないと指摘しています。この単語が方法セクションに頻繁に登場するからです。セマンティックシステムは文字列の重なりではなく意味をスコアリングするため、この失敗を減らせます。だからこそ、目新しい存在ではなく補完層として定着してきました。
キーワード検索とセマンティックAI支援ツールを比較する際、何を評価すべきか?
キーワード検索とセマンティックAI支援ツールは、本記事でミスマッチ回復フレームワークと呼ぶ六つの次元で評価すべきです。すなわち、語彙の柔軟性、順位付けの透明性、インデックス範囲、精度制御、権威性シグナル、有用な候補集合を得るまでの時間です。一つの次元で優れたツールは、別の次元で劣ることが多いため、単一の「勝者」ランキングは有用というより誤解を招きます。
語彙の柔軟性は、抄録にクエリ語が一度も現れない論文を検索エンジンが取得できるかを問うものです。Elicitが学習済みスパース埋め込み手法として使用しているSPLADEのような高密度埋め込みとハイブリッド手法は、この目的のために設計されています。順位付けの透明性は、なぜその論文が表示されたのかを説明できるかを問います。BooleanとBM25を組み合わせたシステムは監査しやすい一方、埋め込みの近傍探索やLLMリランカーは再現が難しくなります。
インデックス範囲は、「掲載論文数」と同義ではありません。OpenAlexは5億1,700万件の研究成果レコードと6,600万件の全文PDFを報告しています。一方、Elicitは1億2,500万本を超える論文を検索、要約、データ抽出の対象にしていると述べています。Google Scholarは比較可能な公式件数を公表していませんが、最大規模の全文学術検索インデックスとして広く扱われています。精度制御には、入れ子のBoolean、フィールド制限、近接演算子、統制語彙が含まれます。この領域では、The LensとOpenAlexがGoogle Scholarを上回ります。
権威性シグナルには、被引用数、ジャーナルの格付け、撤回フラグが含まれます。Google Scholarと、程度は小さいもののUndermindは、被引用数の多い研究に寄る傾向があります。ElicitとSciSpaceは通常、意味的類似度で順位付けし、引用数を重視しません。そのため、新しい論文や引用数の少ない論文が上位に出ます。有用な候補集合を得るまでの時間は、即時のキーワード検索と、少なくとも3分を要するUndermind型の反復実行を分けます。主要エンジンを選ぶ前に、同義語の多い発見、系統的な網羅性、あるいは5分間での概観把握など、実際の課題に照らして各次元を評価してください。
Google Scholar、Elicit、SciSpace、Undermind、Jenovaは概念発見でどう比較できるか?
Google Scholarは広範で引用数を重視した探索に最も強く、ElicitとSciSpaceはキーワードが不明確な場合に最も強く、Undermindは狭い対象を高精度で探す作業に最も強く、Jenova's Academic Research Assistantは発見・統合・引用作業を一つの継続的な会話内で進める必要がある場合に最も強みを発揮します。これらのツールのいずれも、ミスマッチ回復フレームワークのすべての領域を支配するわけではありません。
| 機能 / 次元 | Google Scholar | Elicit / SciSpace | Undermind | Jenova Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| 照合方法 | 語彙 / キーワード、引用数を重視 | セマンティックまたはハイブリッド(ElicitはSPLADEを使用) | ハイブリッド検索に加え、LLMによる関連性判定と反復検索 | Google Scholarを含むライブ学術ソースを対象とした自然言語研究エージェント | 高度な演算子を備えた、構造化された学術メタデータ検索 |
| 異なる表現の回復 | 同義語を追加するか、関連記事を使わない限り弱い | 意味ベースのクエリに強い | 特定の自然言語ブリーフに強い | セッションをまたぐ会話型の言い換えに強い | 弱いから中程度。クエリ構築に依存 |
| 権威性への偏り | タイトル一致後は被引用数の多い論文を優遇 | 引用数の重み付けは小さく、新しい論文が上がる | 引用検索を通じて重要論文にある程度寄る | 接続されたソースと、与えたブリーフに従う | メタデータ主導。セマンティック順位付けより分析向け |
| 精度機能 | 入れ子のBooleanなし、256文字制限、限定的なフィールド検索 | ジャーナル品質の後段フィルター(例:SciSpaceのScimago階層) | Booleanではなく自然言語による具体化 | 会話型の絞り込み。Boolean構文エンジンではない | 入れ子のBoolean、近接検索、フィールド検索、統制語彙 |
| 一般的なクエリ時間 | 即時 | 探索には十分高速 | 検索ごとに少なくとも約3分 | 対話型。フォローアップは即時 | 即時からAPI速度に応じた時間 |
| 料金(2026年時点) | 無料 | Elicit Proは月額約$49、SciSpaceの有料層は月額$12から$160と報告 | 無料の探索層、有料の学術プラン | 使用量が限定された無料層、Plusは月額$20から | 無料のWeb検索、OpenAlex APIには無料枠 |
| 最適な用途 | 重要論文、被引用連鎖、全文検索 | 不明確なキーワードと質問形式のクエリ | 高い再現率で特定の研究クラスを探すこと | 記憶機能と原稿支援を備えたエンドツーエンドの文献作業 | 系統的で再現可能かつ高度に制御できる検索 |
Google Scholar
Google Scholarは今でも万能型です。公式ヘルプページでは、結果は通常、日付ではなく関連性で並べ替えられること、またシード論文を得た後に研究者が関連記事と被引用数をたどれることが確認できます。この二つの機能は、キーワード検索が概念発見に最も近づく方法ですが、優れたシード論文が必要です。弱点も十分に知られています。入れ子のBooleanがないこと、抄録のみを対象にするフィールド検索がないこと、クエリが256文字までであること、結果が1,000件で打ち切られること、一括エクスポートがないことです。この組み合わせにより、司書は系統的レビューの主要データベースとしてGoogle Scholarを除外することが多いのです。
ElicitとSciSpace
Elicitは、1億2,500万本を超える論文を検索、要約、データ抽出、対話の対象にする科学研究向けAIであり、200万人超の研究ユーザーがいると位置付けています。ElicitとSciSpaceはいずれも自然言語の質問を受け付け、意味的類似度で順位付けします。そのため、クエリと表現が異なる論文も取得できます。トレードオフとして、Google Scholarとは逆方向の順位付けバイアスがあります。意味的には近いものの、品質が低い、または引用数の少ない論文を上位に押し上げることがあります。SciSpaceは、深い反復的統合よりも、迅速な洞察の取得に向いており、一般に高速です。結果が非決定的になる場合もあり、同じクエリでも毎回同じ候補集合が返るとは限りません。
Undermind
Undermindは専門特化型です。キーワード検索とセマンティック検索を組み合わせ、最先端モデルを使ってタイトル、抄録、利用可能なメタデータが実際にブリーフに答えているかを判断し、引用検索による反復を行います。系統的レビューに含まれた論文集合との比較テストでは、上位10件でゴールドスタンダード論文11本のうち8本を回収し、recall@10は72.7%、50位まででは11本中9本、recall@50は81.8%でした。この品質には時間がかかり、曖昧なトピックには適しません。また、主にタイトルと抄録、および一部のオープンアクセス全文を対象にしています。そのため、方法や結果セクションだけに埋もれた主張は見逃される可能性があります。
Jenova's Academic Research Assistant
Jenova's Academic Research Assistantは、単独の論文インデックスではなく、分野を理解する研究パートナーです。学術ソースを横断してライブ文献探索を行い、その後も統合、原稿作成、引用管理までプロジェクトを支援します。永続的メモリにより、作業上の用語が「認知的疲労」であっても、文献では「自我消耗」や「回復の必要性」も使われることを記憶し、それらの同義語クラスターをセッションをまたいで同じプロジェクトに紐付け続けられます。
正直な制約はアーキテクチャにあります。Elicitのように組み込みの抽出表を備えた独自の1億2,500万本規模セマンティックインデックスを提供するわけではなく、公表されたrecall@10ベンチマークを持つUndermind型の数分間の反復検索ツールでもありません。その強みはオーケストレーションです。自然言語によるブリーフ、ライブの学術検索、フォローアップ質問、執筆支援を一つのスレッドで提供します。再現可能なBoolean監査証跡が必要な研究者は、The LensまたはOpenAlexも並行して実行するべきです。
同じ考えを異なる言葉で表す論文を、セマンティック検索はどのように回収するのか?
セマンティック検索は、クエリと文書コレクションを共有された意味空間に埋め込み、重複するトークンを必須とするのではなく、近傍の文書を取得することで、異なる表現の論文を回収します。クエリが「夜勤看護師は連続勤務後にどのように注意力を回復するか」である場合、語彙検索エンジンはその語句を探します。セマンティックエンジンは、「概日リズムの乱れ」「回復睡眠」「職業性疲労」を中心にした研究を取得できます。タイトルに「看護師」や「注意力」が一度も出てこなくても可能です。
Allen Institute for AIの文献エンジンであるSemantic Scholarは、文字列一致ではなく理解された意味によって科学論文を順位付けするという考え方を、早期に公開実証した例です。ElicitとSciSpaceは同様の原則をWebアプリ規模で適用しています。Tayは特に分かりやすい検証方法を示しています。研究結果を説明する新聞記事の段落を貼り付けると、セマンティックエンジンは元となった学術誌論文を表示できます。ニュース文の埋め込みが論文の埋め込みに近く位置するからです。キーワード検索では、このような言い換えにほとんど耐えられません。
もう一つ、より目立たない仕組みがあります。支援ツール内部でのクエリ拡張です。会話型エージェントは、同義語セット、関連するMeSH風の概念、反意語、分野ごとの表現変種を生成し、それらを明示的に検索できます。これは純粋なベクトル検索ではありません。より優れた語彙検索網を構築するために意味理解を使う方法です。実務上、再現率を最も高めるワークフローでは、両方を行います。未知の表現を拾うために埋め込みを使い、その後、正確なフレーズ、著者名、引用リンクで検証して、候補集合の監査可能性を維持します。
ライブのブリーフで試せば、その差はすぐに明らかになります。キーワード検索エンジンに「教師の気づき」を尋ねると、主にその教育研究用語を正確に使う論文が得られます。セマンティック支援ツールに「教師が予期しない生徒の思考をその場で検知し、解釈する方法」と尋ねると、「専門的視野」「形成的評価」「その場での意思決定」として分類された研究も取得できます。語彙のずれによって隠れていたのは、後者の集合です。
セマンティックAI支援ツールではなく、キーワード検索を使うべき場面はいつか?
既知文献の取得、シード論文からの引用連鎖、全文フレーズ照合、または系統的レビューのために再現可能なBoolean戦略が必要な場合は、キーワード検索を使うべきです。「このタイトルを見つける」「この試験を引用している論文をすべて見つける」「査読者が再実行できる検索式を記録する」という課題に、セマンティック順位付けは適していません。
Google Scholarは、日常的な三つの作業で最初に使うべき選択肢です。第一に、既知文献の検索です。Googleの公式ヘルプと大半の図書館ガイドが推奨するように、タイトルを引用符で囲みます。第二に、権威性の把握です。重要な論文を開き、被引用数をたどってその後の研究展開を確認するか、関連記事からシード論文を起点に広げます。第三に、全文フレーズ探索です。概念が特徴的な手法名、データセット、尺度である場合、語彙ベースの全文検索なら、タイトル・抄録中心のセマンティックインデックスが見逃す言及を捉えられます。
系統的検索や非常に精密な検索では、Google Scholarと多くのセマンティックアプリの両方を公式な記録システムとして使わないでください。The LensとOpenAlexは、入れ子のBoolean、近接演算子、フィールド指定検索、統制語彙をサポートしています。OpenAlexは、5億1,700万件の研究成果、58億件のグラフ関係、公有領域のCC0データセットを備えたオープンカタログです。2026年の図書館ブリーフィングでは、その収録範囲は約4億7,400万件の出版物とされ、オープンアクセスと透明性に重点を置いています。Google Scholarはこの監査可能性に匹敵しません。表示件数が1,000件に制限され、一括アクセスが提供されないためです。
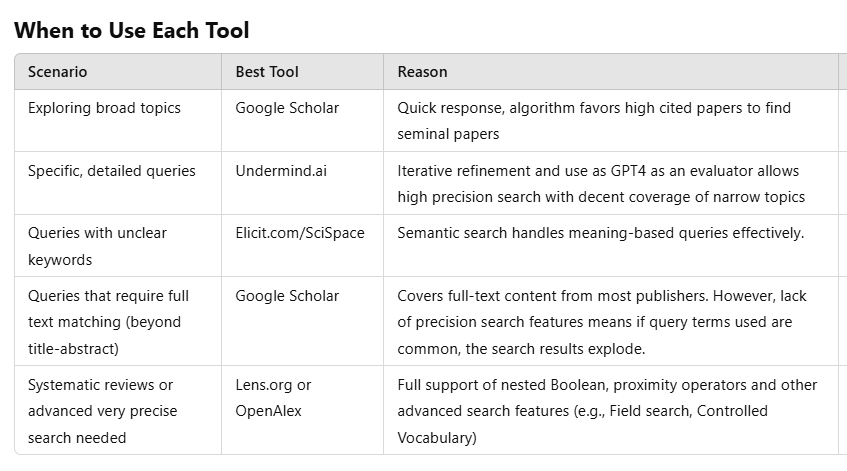
上の表は、忠誠心の試験ではなく、振り分けルールとして使ってください。広範な概観把握と重要論文の発見はGoogle Scholarに任せます。表現が不明確ならElicitまたはSciSpaceを使います。「LLMをタイトル・抄録スクリーナーとして使い、精度と再現率を報告したRCTsは存在するか」のような、非常に具体的な存在確認はUndermind向けのブリーフです。再現可能で演算子を多用する検索は、The LensまたはOpenAlexで行うべきです。
両方のアプローチを組み合わせた文献検索は、どのように実施するのか?
統合検索は、コンセプトブリーフから始め、セマンティックに同義語の多様な候補を回収し、次に語彙演算子、引用連鎖、高度な制御が可能なデータベースで候補集合を固めることで実行します。順序が重要です。一つのフレーズでGoogle Scholarを始めると、そのフレーズの盲点を引き継ぎます。セマンティックに順位付けされたリストから離れなければ、そのリストの品質と再現性の問題を引き継ぎます。
実践的な手順は次のとおりです。
- 研究仲間に話すように情報ニーズを書き出し、対象集団、アウトカム、表現が不安定だとすでに分かっている語を含めます。
- そのブリーフをセマンティック支援ツールで実行し、候補論文だけでなく、論文が実際に使っている語彙も収集します。
- それらのタイトルと抄録から同義語表を作成します。
- 拡張した語を、引用符、
author:、日付制限、被引用数 / 関連記事とともにGoogle Scholarで再実行します。 - 網羅性または監査可能性が必須の対象は、入れ子のBooleanとフィールド制限を使ってThe LensまたはOpenAlexで戦略を再構築します。
- 非決定的なセマンティック検索の再実行によってエビデンスベースが知らないうちに変わらないよう、継続的な採否記録を残します。
Jenova's Academic Research Assistantでは、最初のターンにキーワード文字列ではなくコンセプトブリーフを入力できます。
「リモートで働く知識労働者が認知的疲労から回復する方法に関する実証研究が必要です。『疲労』ではなく、燃え尽き、自我消耗、回復の必要性、勤務時間外の反すう、心理的切り離しを使う研究も含めてください。2018年以降の産業・組織心理学およびHCIの研究発表先を優先し、各論文が実際に使っている同義語を一覧にしてください。」
次のフォローアップでは、支援ツールの同義語表をGoogle ScholarまたはThe Lensに貼り付けられる語彙戦略へ変換します。
「同義語クラスターをGoogle Scholar用の三つのクエリと、OpenAlexまたはThe Lensに適した入れ子のBoolean文字列一つに変換してください。タイトル制限クエリと全文クエリを分けてください。」
ElicitまたはSciSpaceではキーワードではなく自然言語で質問してください。Tayは、自然言語クエリはGoogle Scholarでは成果が低くなりがちで、これらのセマンティックツールではより良い傾向があると述べています。Undermindでは、ブリーフが特定の研究デザインにしか一致しないほど制約を追加します。候補集合ができた後は、Jenova's Deep Research agentの方が、ソース横断で読み込み、引用付き統合を作成するのに適しています。一方、Academic Research Assistantは、発見、引用、原稿支援という学術ワークフロー内にとどまるのにより適しています。
すべてのAI支援ステップに共通する注意点があります。順位付けリストと生成された要約は、スクリーニング完了の結果ではなく、検索支援として扱ってください。セマンティック検索の上位10件は論文を見逃します。LLMの関連性判断は人間としばしば一致しますが、常に一致するわけではありません。全文に関する主張は、依然としてPDFで確認する必要があります。
研究司書とツール評価者は、セマンティックAIによる発見について何を述べているか?
研究司書と独立した評価者は一般に、セマンティックAI支援ツールをGoogle Scholarの代替ではなく補完とみなし、マーケティング上の分類ではなく、明確に定義された用途における検索品質でツールを評価しています。この領域で最も有益な公開比較は、ベンダーのベンチマークではなく、実務に基づくレビューから生まれています。
「自分の用途が事前に分からず、学術検索ツールを一つしか選べないなら、Google Scholarを選ぶことに迷いはありません。これはAI検索に反対する議論ではありません。どれか一つの順位付け関数だけで十分だと装うことへの反論です。Scholarは今も万能型です。クエリが意味的に扱いにくい、または極めて具体的なときに、新しいツールには役割があります。」
「私が最もよく目にする失敗は、クエリの種類とエンジンの不一致です。人々は広いトピックを反復型エージェントに入力し、必要以上に狭い候補集合のために数分待ちます。あるいは、自然言語の段落を語彙エンジンに入力し、文献が存在しないと結論づけます。語彙のずれは、データベースの欠落より先に、たいていワークフローの誤りです。」
「セマンティック順位付けは、『関連性』の意味も変えます。引用数を重視しなければ、新しく、ときには弱い論文が早く表示されます。引用数を重視すれば、同じカノンを何度も発見し続けます。異なる表現を使う概念的関連研究を求める研究者には前者の挙動が必要です。誰もが引用を期待する論文を必要とする研究者には後者が必要です。有能なプロセスは両方を使い、その理由を記録します。」
— Jenovaプロダクトチーム、文献発見システム、学術研究ワークフロー設計8年
この枠組みは公開記録とも一致します。大学のガイドでは現在、文献レビューで使われるAI検索ツールが一覧化されており、製品レビューではUndermindの低速な反復処理とSciSpaceの高速なセマンティックスキャンが区別されています。専門家の合意は方法論的であり、陣営的ではありません。回復したいミスマッチに合う検索モデルを選ぶべきです。
系統的レビューと探索的文献マッピングには、それぞれどのツールが適しているか?
系統的レビューには高度に制御された語彙検索基盤が必要です。探索的文献マッピングにはセマンティックな再現率と高速な反復が必要です。大半の学位論文と研究助成の作業には、各段階について文書化されたプロトコルを持つハイブリッドが必要です。これらの作業を混同すると、概念的に関連する研究を見逃すか、再現不能なエビデンス集合を作ることになります。
探索的マッピング、つまり「どのような名前で呼ばれていても、この考えについて何が書かれているか」では、セマンティック検索から始めてください。Elicit、SciSpace、会話型研究支援ツールは、この問いに対応するために作られています。Google Scholarは、シード論文を得た後に関連記事と被引用数を通じて貢献でき、PDFや図書館リンクを素早く見つける点では今も比類がありません。Jenova's Academic Research Assistantは、マップを永続化する必要がある場合にこの段階に適しています。保存された同義語の判断、除外した方向性、最終的な執筆のための引用整形を維持できます。
系統的レビューまたはスコーピングレビューでは、セマンティックに順位付けされたリストを公式検索にしないでください。The LensまたはOpenAlexを再現可能な基盤として使い、すべての演算子を記録し、Elicit、Undermind、Jenovaは補助的な引用発見・スクリーニング支援として扱います。OpenAlexはさらに、API、系統的レビューを対象としたクエリ言語、CC0ライセンスの完全なスナップショットを提供しています。これはクローズドな関連性ソートとは正反対の設計です。Google Scholarの1,000件上限と一括アクセスの欠如は、既知の採用論文がインデックスされているかを確認する用途には有用であっても、主要な文書化検索としては失格となる理由です。
狭い存在確認の質問、つまり「このような論文は存在するか」では、時間を待ててタイトル・抄録の証拠で十分である限り、Undermindが専門ツールです。候補集合が存在した後の原稿作成では、Elicitのような専用抽出ツールが依然として抽出量の多いメタ分析に適しているという留保はあるものの、文献発見と引用管理を組み合わせるJenovaの方が、別の発見専用インターフェースより重要になります。
再利用できる判断ルールは簡単です。表現にばらつきがあり、その分野の専門用語をまだ知らないなら、まずセマンティックAI研究支援ツールを使います。検索式を防御する必要があるなら、高度な演算子を持つキーワード検索基盤を使います。異なる表現を使う概念的関連論文を見つける通常の状況のように、両方が必要なら、まずセマンティック検索で言葉を発見し、次に語彙的な制御でそれを取得・記録してください。
参考文献
- Aaron Tay — Google Scholarと他のAI検索ツール(Undermind、Elicit、SciSpace)
- Google Scholar — 公式検索ヘルプ
- Elicit — 科学研究のためのAI
- OpenAlex — グローバル研究システムのオープンカタログ
- Paperguide — ElicitとSciSpaceの料金・機能比較(2026年)
- Undermind — 文献のためのAI共同研究者
- University of Alberta / JCHLA — Undermind.ai製品レビュー
- Paperpile — Google Scholarの使い方
- TUHH — 学術研究のオープンな代替手段としてのOpenAlex
- Semantic Scholar — AI搭載研究ツール
- UBC Wiki — 文献レビューおよび網羅的検索で使われるAI検索ツール
- SciSpace — ElicitとSciSpaceの比較
- The Lens — リリース8.5とOpenAlex統合
- PMC / NIH — OpenAlexの機能とエビデンス統合の可能性