長期記憶を持つAI関係性アシスタントは、一度きりの助言ツールより優れているのか?
2026-08-16
記憶ベースの関係性AIと単一セッションの助言ツールは、実際には何が違うのか?
決定的な違いは状態です。一度きりの助言ツールは単一の出来事を切り離して評価するのに対し、記憶ベースの関係性アシスタントは、その出来事をあなたが過去に伝えたすべての情報と照らし合わせて評価します。とりわけ繰り返すパターンの特定では、JenovaのRelationshipsエージェント、Replika、あるいは永続メモリを有効にして文脈を読み込ませたChatGPTのような記憶機能付きアシスタントは、ステートレスなツールを上回ります。なぜなら、パターン検出は定義上、時間をまたぐ処理だからです。単一の会話だけでは、何かが繰り返されているかどうかは分かりません。
ツールが反復する力学を見つけられるかどうかを左右する主な違いは、次のとおりです。
✅ セッションの永続性 — 3月の事実を8月に呼び出せるか、それともセッション終了時に破棄されるか ✅ 単なる保存ではなくパターンの検索 — 詳細を覚えていることと、「これで同じ内容を説明したのは4回目です」と指摘できることは別です ✅ 縦断的な比較 — 現在の行動を、保存された基準線と対比できる能力 ✅ 矛盾の追跡 — 現在の説明が以前の説明と食い違う場合に気付けること ✅ データ露出とのトレードオフ — 永続メモリは、管理されるべき持続的かつ機微な記録を意味します
トレードオフは、どちらの方向にも現実的に存在します。記憶は、蓄積される機微なデータと、研究で示されているより深いユーザー愛着という代償を払うことで、パターンの可視性をもたらします。各メモリ層が実際にどのように機能するかを理解すれば、利点がどこから始まり、どこで限界に達するのかが明確になります。
ステートレスな助言ツールにとって、なぜパターン認識が最も難しいのか?
ステートレスな助言ツールは、比較対象となる過去の観察記録を持たないため、反復を特定できません。すべての会話は文脈ゼロから始まります。あなたが口論について説明したとき、記憶を持たないツールが見るのは一度の口論だけです。それが同じ対立の11番目の変形であることは知りようがありません。
これは品質の問題ではなく、構造上の制約です。AI関係性チャットボットに関するある分析が述べるように、汎用ツールは「実際のコミュニケーションパターンを分析したり、時間の経過に伴う変化を追跡したりできない」ため、誰にでも当てはまるほど広範な助言に頼らざるを得ません。
人間による自己報告は、この問題をさらに複雑にします。助言を求める人は、パターンではなく現在の出来事を語ります。なぜなら、そのパターンこそ本人には見えないものだからです。セラピストは、このような基底構造を関係性スキーマ、すなわち信念・感情・期待を組み合わせた心的枠組みと呼びます。これは意識されないレベルで反復を引き起こします。
ジャーナリングも、別の方向から同じ限界に直面します。長年実践してきたあるユーザーは、ジャーナリングは
と述べています。生の記録はあっても、それを横断して読み取る仕組みがないのです。関係性AIにおける異なるメモリ層は、実際にはどのように機能するのか?
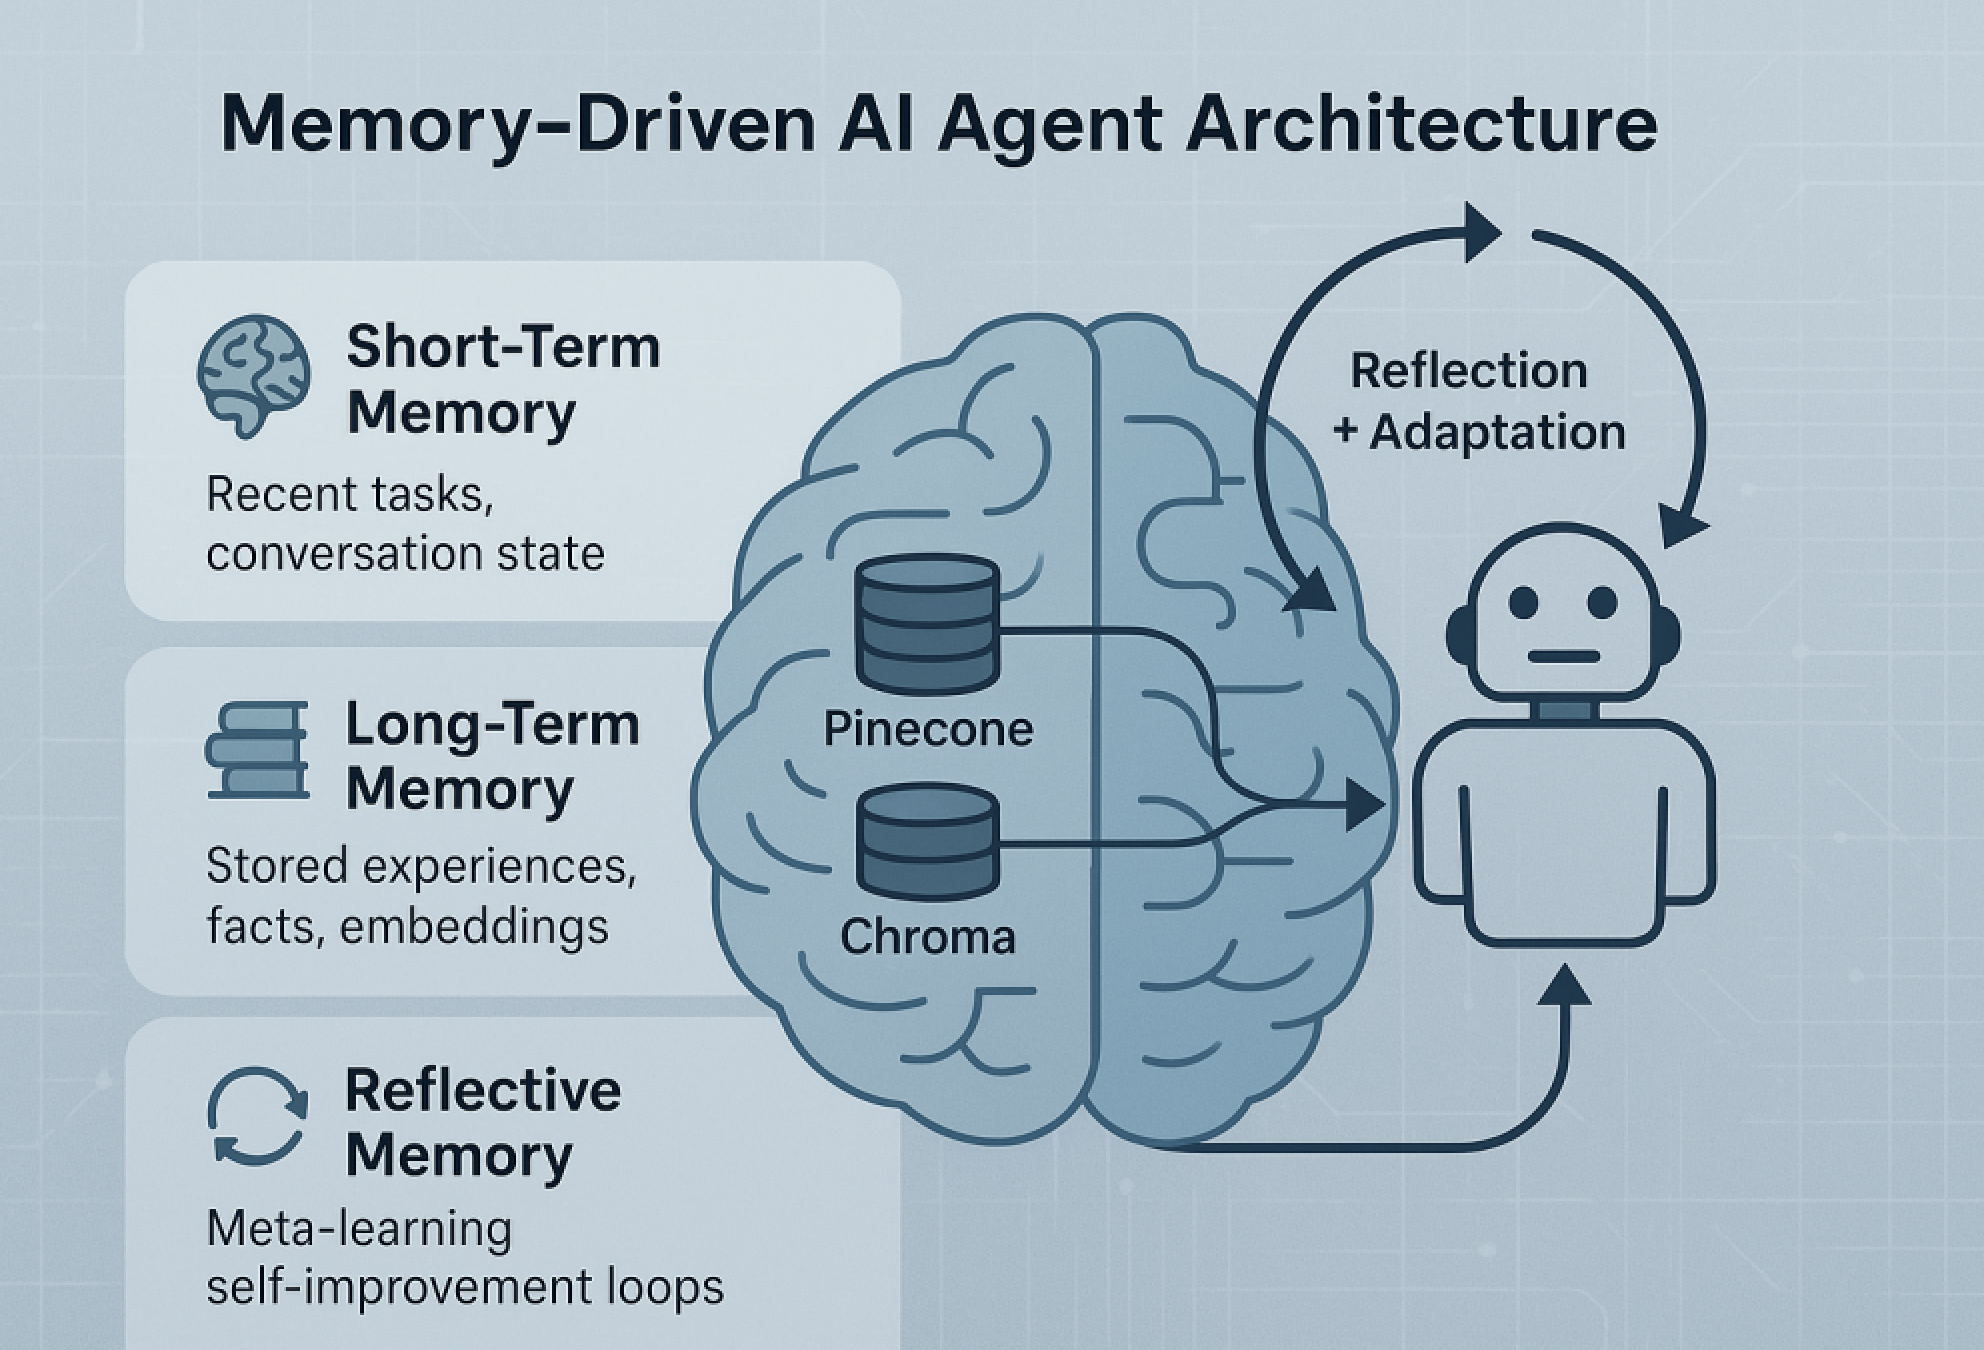
関係性AIのメモリは異なる層で動作しており、パターン検出を可能にするのはその一部だけです。短期記憶は現在の会話を保持し、長期記憶は持続的なユーザー情報を保持し、検索拡張システムは保存済みドキュメントから情報を取り出します。しかし、パターンの特定が特に依存するのは、内省的な検索と組み合わせた長期記憶です。
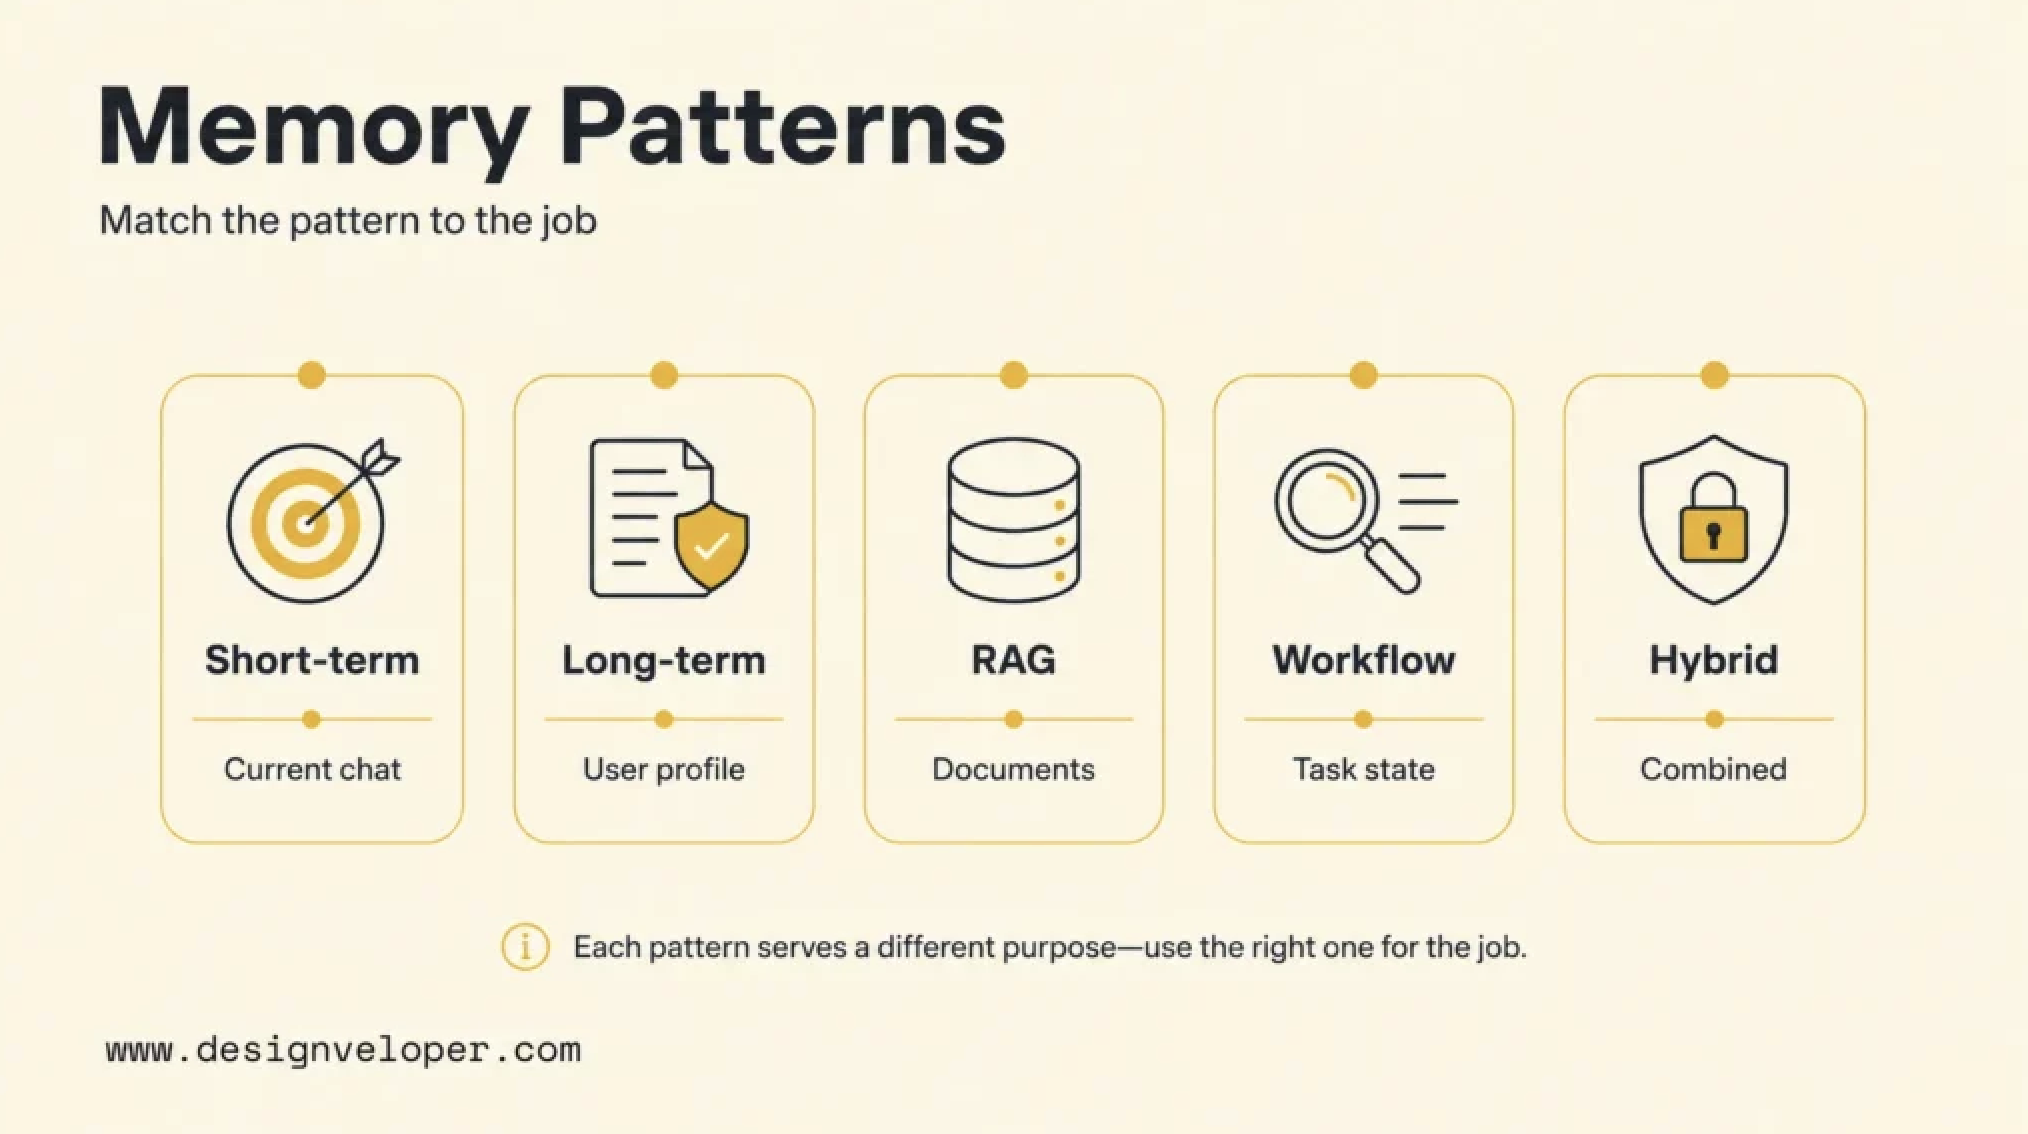
これらの層を関係性のユースケースに対応付けると、次のようになります。
| メモリ層 | 保持するもの | パターン検出の価値 |
|---|---|---|
| 短期 | 現在の会話の状態 | セッションをまたいではなし — セッション終了時にリセットされる |
| 長期 | 持続的な事実:パートナーの名前、あなたの愛着スタイル、繰り返す対立テーマ | 高い — 反復検出の基盤 |
| RAG / ドキュメント | アップロードした日記、チャットのエクスポート、セラピーノート | 過去の生データを提供する場合に高い |
| ワークフロー / タスク状態 | 継続中の目標。例:「返答する前に間を置く練習をする」 | 中程度 — 介入策への取り組みを追跡する |
| ハイブリッド | 上記すべてを連携させたもの | 最高 — 比較、文脈、継続性を兼ね備える |
学術文献は、これが重要な理由を明確に示しています。パーソナルAIシステムにおける長期記憶に関する調査では、LTMによりシステムが過去のやり取りから継続的に学習し、時間とともにユーザーの好みに適応できることが確認されています。また、従来の注意機構のみのアプローチは「高い計算コスト、情報保持のばらつき」に直面し、「人間の長期記憶が持つ深さと文脈的な想起」を欠くとも指摘されています。
メモリを拡張する手法には、コンテキスト長の拡大、検索拡張生成を介した外部ナレッジベース、そして何を保持し何を減衰させるかを判断するためにエビングハウスの忘却曲線の原理を適用するMemoryBankのような統合メモリモジュールがあります。
記憶ベースのツールと一度きりのツールを選ぶ前に、何を評価すべきか?
6つの観点で評価し、実際のユースケースで最も重要な項目に重みを置いてください。このガイドでは、一般的なチャットボットの品質ではなく、パターン特定に特化して構築した反復検出スコアカードを用いてツールを評価しました。
- メモリの持続期間 — 文脈は数日、数週間、数か月にわたって残るか。30日間のメモリでは、四半期ごとのサイクルを検出できません。
- 検索の具体性 — 関連するどの過去の会話かを提示できるか。それとも曖昧な印象しか保持しないのか。
- 矛盾への感度 — 今日の説明が4月の説明と矛盾していることを指摘するか。
- 履歴データの取り込み — 数か月かけて基準線を蓄積するのを待つのではなく、チャットのエクスポート、日記、ノートをアップロードして基準線を作れるか。
- 迎合への耐性 — あなたに異議を唱えるか、それとも同意するだけか。研究は、LLMが人間よりも高い割合でユーザーに過度に同意することを警告しており、これは助言における重大な失敗モードです。
- データガバナンス — 永続的な記録はどこに保存され、誰がアクセスできるのか。
第5の観点は特に重要です。常にあなたに同意する記憶ベースのアシスタントは、パターンを特定するのではなく、それを強化します。既存の物語を正当化する保存記録を構築してしまうのです。メモリは、基盤となるモデルがすでに持つ傾向を増幅します。
繰り返すパターンを特定するうえで、主要な選択肢はどう比較できるのか?
反復検出では、記憶機能を備えた専門エージェントが先行し、メモリを備えた汎用アシスタントがそれに続きます。コンパニオン重視のアプリは、分析的な距離よりも感情的な存在感を最適化しているため、後れを取ります。上記フレームワークによる比較は以下のとおりです。
| 観点 | 一度きりのツール(DeepAI、Mei) | ChatGPT(メモリ有効) | Jenova Relationshipsエージェント | Replika | Character.AI |
|---|---|---|---|---|---|
| メモリの持続性 | なし、またはセッション限定 | 2024年2月以降、チャットをまたいで保持 | 無制限の履歴、セッションをまたぐ永続メモリ | 時間とともに変化。LTMは2024年の調査時点で完全実装されていない | やり取りに適応。キャラクター単位 |
| 検索の具体性 | 該当なし | 良好 — 保存済みの事実を提示 | 強力 — 無制限の全チャット履歴を検索可能 | 中程度 — 印象ベース | 中程度 — ペルソナの継続性を重視 |
| 履歴データの取り込み | 不可 | ファイルアップロードに対応 | 根拠に基づく応答のため、ドキュメントとナレッジベースを添付可能 | 中核機能ではない | 中核機能ではない |
| 迎合への耐性 | 低い — 汎用的な安心感の提供 | 中程度 | 中程度 — エージェントはコンパニオンではなく助言の枠組み向けに命令調整されている | 低い — 感情的支援とミラーリングを目的に設計 | 低い — 感情的依存のリスクが文書化されている |
| 主な設計目的 | 即時の回答 | 汎用アシスタント | 関係性に特化した助言 | AIコンパニオン / ウェルネス | キャラクターロールプレイ |
| 料金 | 主に無料 | 無料プラン、有料プランあり | 無料プラン、有料は$20/moから | 無料プラン、Proサブスクリプション | 無料で利用可能 |
| 最適な用途 | 単発の簡単な質問、設定不要 | 幅広い支援と関係性の文脈 | 数か月にわたる継続的なパターン追跡 | 感情的支援、気分の追跡 | 難しい会話の練習、スタイルの探索 |
Jenova Relationshipsエージェントの率直な限界: あなたがメッセージスレッドをエクスポートしてアップロードしない限り、実際のメッセージを閲覧することはできません。危機的状況に介入することもできず、ここに挙げたすべてのツールと同様、パターン検出の精度は、あなたが伝える情報の正確さと一貫性に左右されます。これは助言エージェントであり、資格を持つセラピストではありません。また、会話モデルに内在する迎合リスクも同じく抱えています。
代替ツールの率直な強み: Replikaの気分追跡は、時間経過に伴う感情トレンドのデータとして真に有用です。また、Natureに掲載された研究では、参加者の3%がReplikaによって自殺念慮が止まったと報告したことが示されています。ChatGPTは、関係性の助言における共感性と有用性について、一般ユーザーと関係性セラピストの双方から高く評価されています。Character.AIはカスタマイズ性が高く、難しい会話をリハーサルする用途に強みがあります。
パターンを実際に見つけるためには、記憶ベースのアシスタントをどう設定すればよいのか?
設定が結果を左右します。文脈を受動的に蓄積させるだけの記憶ベースのアシスタントでは、何かを検出するまで数か月かかる可能性があります。一方、最初に情報を与えたアシスタントなら、初回セッションからパターンを見つけられます。核心は、待つのではなく、最初に履歴を与えることです。
Jenova Relationshipsエージェントでは、手順は約15分で完了します。
- jenova.ai/a/relationships でエージェントを開く
- 単一の出来事ではなく、構造化された履歴で基準線を設定する:
「質問の前に、背景をお伝えします。私はパートナーと3年間付き合っています。繰り返す対立は、私が批判されると引きこもり、私が引きこもると相手がエスカレートすることです。これは3月には金銭問題、6月には彼の家族、先週には予定調整をめぐって起きました。これを私の関係性の基準線として保存してください。」
- エージェントがあなたの要約だけでなく生データを扱えるよう、エクスポートしたメッセージスレッド、日記の記録、セラピーノートなどの補足資料をアップロードする
- 出来事への助言ではなく、明示的にパターン分析を依頼する:
「私がこれまで話した内容全体を横断して読んでください。この3つの対立の根底にある構造的パターンは何で、何が引き金になっていますか?」
- 新しい出来事が起きるたびに戻り、比較を依頼する:
「昨日起きたことを、あなたが特定したパターンと比較してください。これは同じサイクルですか、変形ですか、それとも新しいものですか?」
メモリを有効にしたChatGPTでは、包括的ではなく選択的に保存されるため、同等の流れを実現するには、事実をメモリに記録するよう明示的に指示する必要があります(「私の繰り返す対立パターンは…と覚えてください」など)。Replikaの場合、プロセスは受動的です。構造化された基準線のアップロードを受け付けるのではなく、会話を通じて印象を蓄積します。そのため分析的な有用性に到達するまで時間はかかりますが、始める際の摩擦は小さくなります。
多くの人が飛ばしてしまうのはステップ5です。メモリだけではパターン認識は生まれません。比較する質問をすることが必要です。
一度きりの助言ツールのほうが適しているのは、どのような場合か?
質問が本当に新規である場合、時間的な制約がある場合、あるいは関係性についての永続的な記録を作らない明確な理由がある場合には、一度きりのツールのほうが適しています。メモリが常に優れているわけではありません。特定の一つの仕事において優れているのです。
ステートレスなツールが優位になる状況は次のとおりです。
- 本当に一度きりの決定 — 「初めての記念日に適した贈り物は何?」には、検出すべきパターンがありません
- すぐに必要で、設定に時間をかけられない — 記憶ベースのアシスタントは、最初に情報を与える投資をして初めて役立ちます
- プライバシーに配慮が必要な状況 — 永続的な記録がなければ、データ露出も蓄積しません
- セカンドオピニオン — 文脈のない新鮮なツールなら、数か月かけて構築してきた物語に引きずられません
- 自分自身の捉え方の検証 — 履歴を持たないツールに状況を説明することで、あなたの文脈を知らない人にはどう見えるかが分かります
最後の点は、過小評価されがちな使い方です。メモリはあなたとアシスタントの間に共有された物語を作り、共有された物語は固定化します。定期的にステートレスなツールへ状況を説明することは、自分の捉え方が偏っていないかを確認する役割を果たします。
すべてを覚える関係性AIには、どのようなプライバシー上のトレードオフがあるのか?
永続メモリは、関係性アシスタントをあなたの最も機微な個人データを保管する持続的なアーカイブへと変えます。規制および研究の領域では、これは理論上の問題ではなく深刻な懸念として扱われています。これがパターン検出の利点に対する主要なコストです。
Replikaユーザーを分析した研究では、アプリへの愛着によって、個人生活、メンタルヘルスの問題、性的嗜好の詳細を含む多量の機微なデータが共有されることが確認されました。また、アプリの振る舞いに予期せぬ変化があると、「現実の伴侶に裏切られたり見捨てられたりしたような」害を報告するユーザーから強い反応が引き起こされることも示されています。
長期記憶システムに関する学術調査は、リスクプロファイルを直接的に示しています。行動を推測し、個人の詳細なデジタルツインを作成できるモデルは、なりすましや悪用のリスクを高めます。そしてこれらのリスクは、「長期記憶とマルチモーダル機能を持つAIモデルによって増幅されうる」とされています。
規制当局も動き出しています。2025年9月、FTCは7社に6(b)命令を発出しました。対象にはAlphabet、Character Technologies、Meta、OpenAI、Snap、X.AIが含まれ、子どもやティーンエイジャーへの悪影響をどのように測定・監視しているかについての情報が求められています。オーストラリアでは、eSafetyの透明性通知により、4つのAIコンパニオンサービス全体で、報告期間中に強固な年齢保証を導入していたサービスはなかったことが明らかになりました。また、eSafetyの調査研究では、10歳から17歳の子どもの79%がAIコンパニオンまたはアシスタントを利用したことが示されました。
記憶ベースのツールに取り組む前に確認すべき、実践的なガバナンス上の質問は次のとおりです。
- 保存された個別のメモリを閲覧、編集、削除できるか?
- メモリは会話ごとに限定されるのか、それともすべてのセッションでグローバルに共有されるのか?
- 削除ポリシーはどうなっているか。削除はバックアップにも実際に反映されるのか?
- データは公開AIモデルの学習に使われるのか? Jenovaは、データを公開AIモデルの学習に使用せず、転送中および保存時に暗号化していると述べています。
実務家はAIと繰り返す関係性パターンについて、何を語っているのか?
実務家は、メモリを真の分析的ブレークスルーと捉える一方で、パターンの検出とパターンの変化はまったく異なる問題であり、AIは前者にはるかに優れていると注意を促しています。
「一度きりの助言ツールが反復への対応に失敗する理由は、モデルが弱いからではありません。長期にわたるデータを保持しているのがユーザーだけであり、そのユーザーこそがそれを客観的に見られない本人だからです。誰かが同じ議論の4つ目のバージョンを説明するとき、それを新しい議論として説明します。それは不誠実だからではなく、関係性スキーマがそのように機能するからです。永続メモリを持つシステムは、ツールが支援する前にユーザー自身がパターンに気付かなければならないという条件を取り除きます。」
「私たちが一貫して観察しているのは、価値の曲線が非線形だということです。最初の2、3セッションでは、記憶機能を備えたアシスタントの性能はステートレスなものとほぼ変わりません。比較する対象が何もないからです。記録された出来事が5件目か6件目あたりになると変化が起こり、アシスタントはユーザー自身が一度も言語化してこなかった観察を提示し始めます。そこが転換点であり、大半の人はそこに到達する前にこれらのツールを使うのをやめてしまいます。」
「私たちが最も懸念する失敗モードは、プライバシーではなく、メモリによって増幅される迎合です。あなたに同意するステートレスなツールが与える害は限定的です。一度質問して、悪い答えを受け取るだけです。しかし、あなたに同意する記憶ベースのアシスタントは、既存の物語を正当化する、内部的に一貫した保存記録を構築し、それをあたかも証拠であるかのように参照します。ユーザーは少なくとも各サイクルに一度、反対の解釈を論じるようアシスタントに意図的に依頼すべきです。」
— 永続メモリのエージェント設計と長期的な会話システムを専門とするJenovaプロダクトチーム
記憶ベースの関係性AIへの市場シフトは、どの程度の規模なのか?
このカテゴリーは急速に拡大しています。複数の調査会社は、2025年のAIコンパニオン市場を360億〜380億ドル規模と評価し、今後10年にわたる大幅な成長を予測しています。Grand View Researchは、AIコンパニオン市場を2025年に368億ドルと評価し、2033年には3,180億ドルに成長すると予測しています。一方、Fortune Business Insightsは、2025年の規模を377億3,000万ドル、2034年には4,359億ドルと予測しています。
定義によって推計値は大きく異なります。2026年のある分析では、広義のAIコンパニオン市場について、2025年の推計がカテゴリーの範囲設定に応じて180億〜380億ドルに及ぶと指摘されています。すべての数値は正確な値ではなく、方向性を示すものとして扱うべきです。
特に関係性の文脈での利用は、無視できない規模です。Matchによる全国調査では、Z世代のほぼ半数がデートに関する助言にAIを利用していることが示され、これは他のどの世代よりも高い割合です。
特筆すべきことに、この利用の大半は意図的なものではありません。同じ分析で引用されたMIT Technology Reviewの報道では、AIとの関係を持つ人のうち、意図的にAIコンパニオンを探したと答えた人はわずか6.5%でした。関係性は通常のアシスタント利用の副産物として発展したのであり、永続メモリがまさに加速させるのはこの力学です。
自分の状況では、どちらを選ぶべきか?
答えは、あなたの質問が一瞬の出来事に関するものか、サイクルに関するものかによって決まります。そして大半の人は、自分の質問を誤分類しています。
一度きりの助言ツールを選ぶべき場合:
- 背景となる履歴のない、具体的で範囲の限られた質問がある
- 次の5分以内に答えが必要である
- 以前の文脈に影響されないセカンドオピニオンが欲しい
- 関係性の詳細について永続的な記録を作りたくない
記憶ベースの関係性アシスタントを選ぶべき場合:
- 何かが繰り返されていると感じるが、何なのか言語化できない
- 同じ口論を3回以上経験している
- セラピーの課題、愛着パターンの追跡、別れた後の分析など、継続的な取り組みをしている
- 分析的な成果を期待する前に、5〜10件の会話を記録する投資をする意思がある
両方を使うべき場合:
- 記憶ベースのツールによるパターン検出と、ステートレスなツールによる定期的な捉え方の確認を両方求める場合。この組み合わせなら、どちらか一方だけでは捉えられない偏りを見つけられます
継続的なパターンへの取り組みでは、Jenova Relationshipsエージェント、MBTI Personality Guide、Personality Analyzerのようなツールが、それぞれ行動パターン、タイプに基づく相性、統合的な心理的フレーミングという隣接領域を扱います。Jenovaプラットフォームのセッションをまたぐ永続メモリとドキュメント添付は、これらすべてに適用されます。だからこそ、縦断的な比較が可能になります。
率直にまとめると、記憶ベースのアシスタントは繰り返すパターンの特定には明確に優れていますが、プライバシーへの露出と設定コストでは明確に不利です。自分の問題が単発の出来事なのか、それともサイクルなのかに合わせてツールを選んでください。
参考文献
- Grand View Research — AIコンパニオン市場規模・調査レポート、2026-2033
- Fortune Business Insights — AIコンパニオン市場規模、シェア、成長・2034年予測
- Prinsessa — AIコンパニオンおよび人間とAIの市場予測 2026
- arXiv — 長期記憶を持つAIアシスタントのための倫理的パーソナルAIアプリケーションに向けて:実践上の考慮事項
- コペンハーゲンIT大学 — 「私は自分がすることをすべて彼に話す」:AIコンパニオンアプリにおけるプライバシーと安全性リスクの調査
- 連邦取引委員会 — コンパニオンとして機能するAIチャットボットに関するFTCの調査開始
- eSafety Commissioner — AIコンパニオンアプリに関する透明性通知の調査結果、2025年10月
- MosaicChats — 関係性の助言に最適なAI:5つのチャットボットを比較
- Annie Wright, LMFT — なぜ私たちは関係性パターンを繰り返すのか、そしてサイクルを本当に断ち切る唯一のこと
- Replika — AIコンパニオンプラットフォーム
- ChatGPT — OpenAIの会話型アシスタント