AIエージェントバックエンド:単一のAPIか、ゼロからの構築か(2026年7月)
2026-07-24
2026年にAI機能をリリースするすべてのエンジニアリングチームは、同じ分岐点に直面します。エージェントバックエンドをゼロから構築するか、それとも統合するかです。構築を選ぶ場合、モデルAPI、オーケストレーションフレームワーク、ベクトルデータベース、メモリストア、ツールサーバーをつなぎ合わせる必要があり、最初のユーザーインタラクションに到達するまでに数四半期分のエンジニアリング時間を消費します。Jenova Agent APIはその代替手段です。オーケストレーション、メモリ、ストレージ、RAG、ツールが単一の統合の背後で稼働する、完全マネージド型のエージェントバックエンドです。
- ✅ モデルルーティング、オーケストレーション、メモリ、RAG、ツールを含むDIYエージェントスタック全体を、1つのAPIで置き換え
- ✅ 独自の指示、モデル、ナレッジベース、ツールで定義した、本番運用グレードのカスタムエージェントを構築・リリース
- ✅ OpenAI、Anthropic、Google、xAI、Qwenなどのモデルへ、単一の認証情報でアクセス
- ✅ 70か国以上、30,000人超のユーザーで本番検証済みのインフラ上で稼働
構築か統合かを正直に判断するには、2026年にゼロからエージェントバックエンドを構築、運用、保守する実際のコストを把握する必要があります。
簡潔な回答:AIエージェントバックエンドとは?
AIエージェントバックエンドとは、エージェントを本番環境で機能させるインフラ層です。モデルとツールをまたぐオーケストレーション、永続的なメモリとコンテキスト、非公開データの検索、そしてその下で動作するコンピューティング、スケーリング、信頼性の仕組みが含まれます。 ゼロから構築する場合、5つ以上の異なるシステムを自ら所有することになります。一方、マネージドエージェントAPIなら、それらすべてを1つの統合で提供します。
マネージド型エージェントバックエンドの主な機能:
- 複数ステップのワークフロー全体で、モデル、ツール、メモリ、検索を連携させるエージェントオーケストレーション
- プロバイダーをまたぐマルチモデルルーティング。ベンダーロックインも、プロバイダーごとのキー管理も不要
- すべてのセッションに組み込まれた、無制限の会話メモリとコンテキスト
- 組み込みRAGを備えた、完全マネージドのリレーショナルストレージおよびベクトルストレージ
- プラットフォームネイティブツールと任意のリモートMCPサーバーによるツール統合
問題:ゼロから構築すると実際に何がかかるのか
エージェントをリリースしなければならないという市場圧力は非常に強くなっています。エンタープライズソフトウェアでは、エージェント型AIを含むアプリケーションの割合が、2024年の1%未満から33%へ増加する見込みです(Datagrid)。また、C-suiteエグゼクティブの67%は、2027年までに組織内でAIエージェントが独立して稼働すると予測しています(VAST Data)。
しかし、それを支えるバックエンドの構築は、非常に高額で時間もかかります。
- 第二のエンジニアリング専門領域へと発展するオーケストレーションロジック
- 呼び出し間でメモリを持たないステートレスなモデルAPI
- 既知かつ繰り返し発生する障害モードを抱えるRAGパイプライン
- 外部機能ごとに必要となるツール統合の実装作業
- スケール、信頼性維持、セキュリティレビュー通過が求められる本番インフラ
- プロトタイプ時のあらゆる見積もりを上回る初年度総コスト
実際の予算:モデル呼び出しは全体の2%にすぎない
「月額$100のエージェント」というデモは、実際のコスト構造を隠しています。詳細なエンジニアリング分析によれば、小規模から中規模の本番エージェント1つの現実的な初年度コストは **$270,000~$690,000** です。そのうちモデルAPI呼び出しの占める割合は、およそ2%にすぎません(Particle41)。
残りの費用は、デモ動画では見えない部分に使われます。
$30,000~$80,000 — 初期のプロンプトエンジニアリングと改善だけに必要な費用。時給$150~200で換算した、200~400時間のエンジニアリング作業です(Particle41)
$1,000~$5,000/月 — ベクトルデータベースのホスティング費用。さらに埋め込み生成に$1,000~$2,000/月がかかります(Particle41)
$30,000~$60,000 — エージェントを既存のわずか4~5システムに接続するためのデータ統合エンジニアリング費用(Particle41)
FTE1人あたり$6,000~$10,000/月 — 失敗ケースをレビューするための人間による監視コスト。精度95%のエージェントでも、月間10,000件のインタラクションを処理すれば、500件は手動レビューが必要になります(Particle41)
さらに、リリースして終わりではありません。2年目以降も、運用と改善に年間$150,000~$300,000が必要です(Particle41)。より限定的な開発費のみの見積もりでも、単純なタスクエージェントは$20,000~$60,000(Biz4Group)、マルチエージェントシステムは$10,000~$400,000超に及びます(Azilen)。
オーケストレーション自体が1つのプロダクトになる
本番エージェントは一度回答するだけではありません。複数ステップの実行にわたり、計画を立て、ツールを呼び出し、コンテキストを検索し、中間結果を評価し、エラーから回復します。この協調ループを構築するには、実際のプロダクトとは関係のないステートマシン、リトライロジック、タイムアウト処理、コストガードレールが必要です。
実務者はこの隔たりを率直に表現しています。エージェントの構築には数日しかかからなくても、本番化には6か月を要するというのです。ガードされていないループはAPI請求額を急増させ、失われた状態は長時間実行タスクを停止させます(
)。LangGraphやCrewAIなどのフレームワークはこの層を抽象化します(Speakeasy)。しかし、抽象化が自動的に動作するわけではありません。その下にあるすべてを、依然として自分でホスト、スケール、保護、保守しなければなりません。RAGパイプラインはプロジェクトではなく、恒久的な責務
エージェントを自社の非公開データに根拠づけるには、取り込み、チャンク分割、埋め込み、インデックス作成、再ランキング、生成を所有する必要があります。実務者は一貫して、RAGパイプラインは「見た目以上に難しいだけでなく、LLMs、検索、専門的なMLOpsに関する継続的な専門知識を必要とする」と警告しています(Vectara)。
文書化されたある事例では、1月に始まった「単純な」社内RAGプロジェクトが、3月までに次の状態になりました。幻覚をデバッグするフルタイムエンジニア1人、取り込み問題に対処するフルタイムのデータエンジニア1人、インフラと格闘するDevOpsエンジニア1人を消費し、予算は3倍に膨らみました(Towards AI)。同じ記事では、典型的な8週間のライフサイクルとして、レイテンシの問題、エッジケース、全面的な書き直し、新たな幻覚の問題、ベクトルDBの移行、そして再度の書き直しが記録されています。
レガシーインフラはエージェント向けに作られていない
エージェントのワークロードには、継続的かつリアルタイムなデータアクセスが求められます。しかし、トランザクションワークロード向けに構築されたレガシーデータインフラでは、「自律型AIエージェントに必要な継続的な推論とアクション実行をサポートできない」とされています(VAST Data)。エンタープライズグレードのエージェントインフラには、統合データ基盤、高性能ストレージ、リアルタイムベクトル化、インテリジェントなオーケストレーション、ゼロトラストガバナンスが必要です。プロダクトロジックを書く前に、すでに5つの異なる能力層が必要となります。
40% — 不十分なインフラ基盤が原因で失敗するエージェント型AIプロジェクトの割合(Landbase)
これこそ、Jenova Agent APIが解消するために構築された問題です。
ソリューション:Jenova Agent API
Jenova Agent APIは、完全マネージド型のエージェントインフラサービスです。モデルAPI、オーケストレーションフレームワーク、ベクトルデータベース、メモリストア、ツールサーバーからなるDIYスタックを、単一の統合で置き換えます。エージェントの指示を定義し、モデルを選択し、ナレッジベースをアップロードし、ツールを設定するだけで、APIがオーケストレーション、メモリ、ストレージ、スケーリングを処理します。そのため、数四半期ではなく数日で、本番運用グレードのカスタムエージェントをリリースできます。
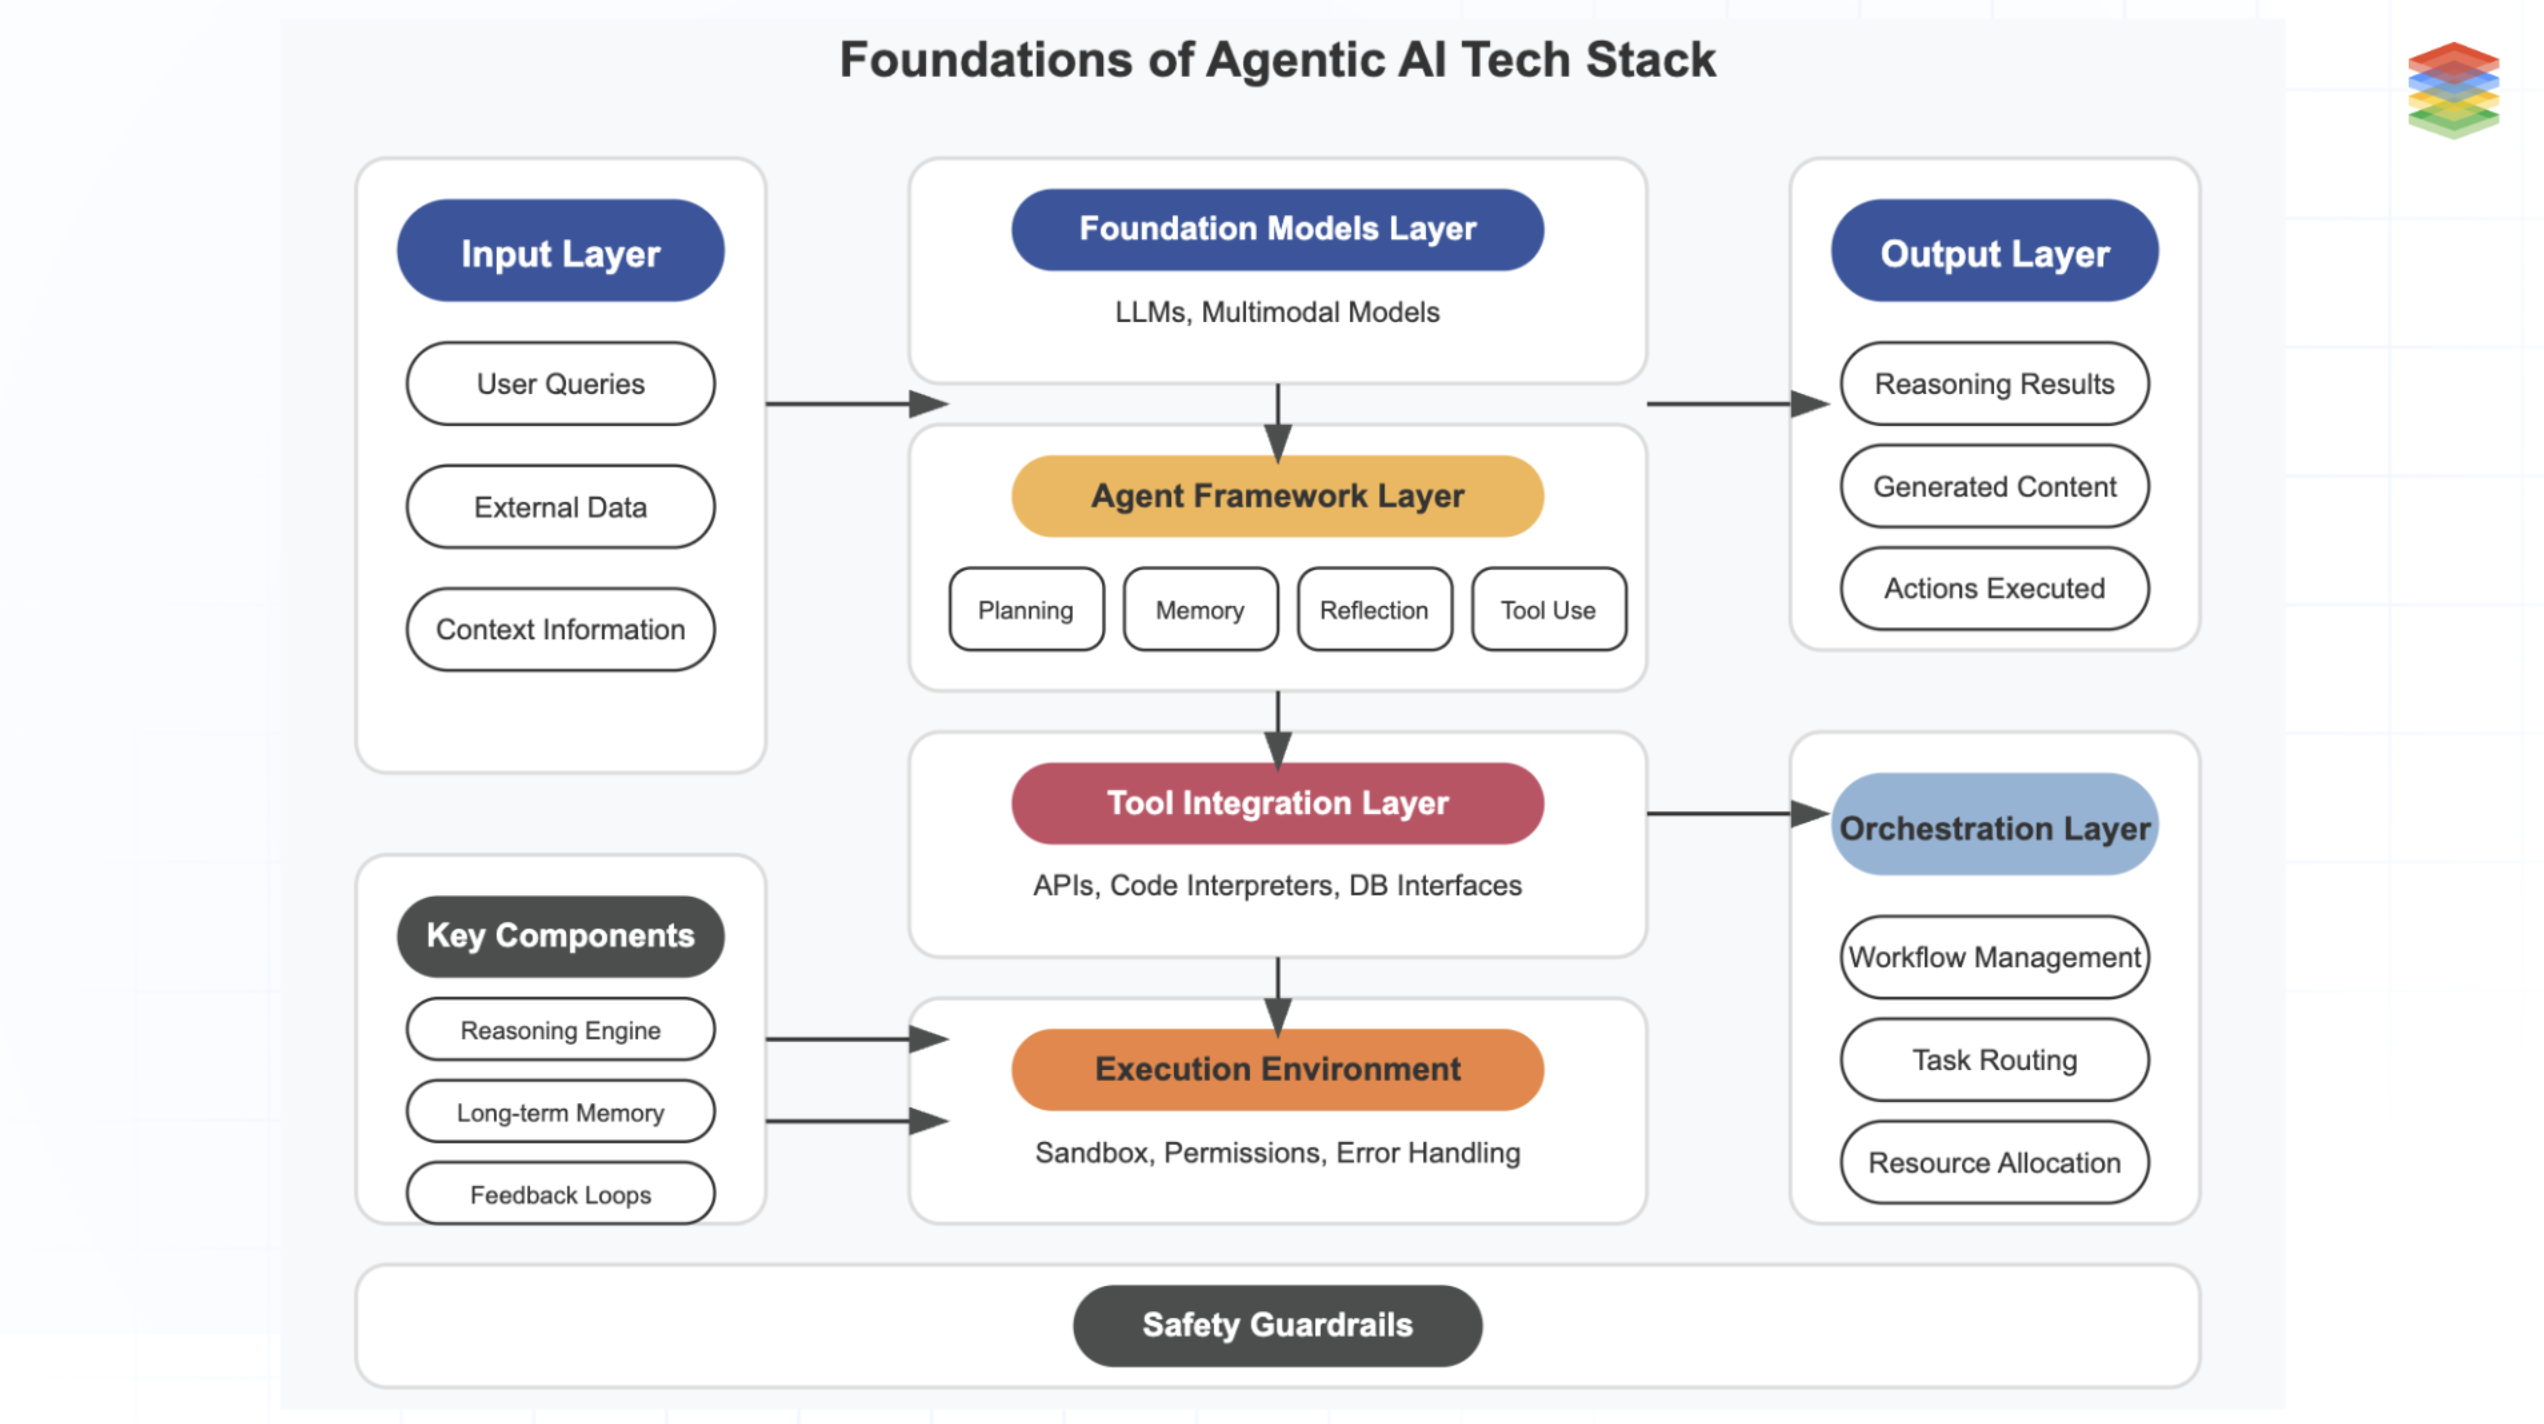
上図のすべての層、すなわちエージェントフレームワークの計画、メモリ、自己評価、ツール利用、ツール統合層のAPIとデータベースインターフェース、実行環境のサンドボックス化とエラー処理、オーケストレーション層のワークフロー管理とタスクルーティングは、DIYの道を選べば自分で構築する必要があるインフラです。Jenova Agent APIはそのすべてを実行します。
| DIYエージェントバックエンド | Jenova Agent API |
|---|---|
| カスタムのオーケストレーショングラフ、リトライロジック、状態スキーマ | モデル、ツール、メモリ、検索を連携させる、実戦で検証済みのオーケストレーション |
| モデルプロバイダーごとに別々のSDK、キー、レート制限 | 単一の統合で主要なあらゆるモデルを利用可能。ベンダーロックインなし |
| Redis/Postgres上のセッション状態とカスタムシリアライゼーション | すべてのセッションに組み込まれた無制限のメモリとコンテキスト |
| プロビジョニングされたベクトルデータベース、チャンク分割・埋め込みパイプライン($1,000~$5,000/月) | 組み込みRAGを備えた、完全マネージドのリレーショナルストレージおよびベクトルストレージ |
| 手書きのツールラッパー、認証フロー、エラー処理のボイラープレート | プラットフォームネイティブツールと任意のリモートMCPサーバーを、すぐに利用可能 |
| サーバー、コンテナ、スケーリングポリシー、稼働率監視 | 安定したAPIを備える、本番運用グレードのマネージドインフラ |
エージェントオーケストレーション
複数ステップの推論、ツール呼び出し、検索、応答生成はすべてプラットフォーム内で実行されます。構築・保守すべきグラフ定義、状態スキーマ、ワークフローDAGはありません。エージェントに何を達成させるかを定義すれば、インフラがどのように実現するかを判断します。本番の信頼性に必要な、制約され制御可能な実行を提供します。
任意のモデルを利用可能
OpenAI、Anthropic、Google、xAI、Qwenなどのモデルを、1つの認証情報でエージェントに利用できます。複雑な推論には最先端モデルを、大量セッションにはコスト効率の高いモデルを使い、エージェントごとに自由に切り替えられます。プロバイダーごとのキー管理は不要であり、新世代のモデルが登場しても移行作業は必要ありません。メモリ層とナレッジ層は、すべての切り替え後も維持されます。
メモリとコンテキスト
無制限の会話メモリとコンテキストが、すべてのセッションに組み込まれています。一貫したセッション識別子を渡すだけで、エージェントは各ユーザーの履歴、好み、長期プロジェクトを記憶します。外部状態ストア、シリアライゼーションコード、コンテキストウィンドウの設計は不要です。DIYスタックで最も障害が発生しやすい層が、そもそも存在しません。
完全マネージドストレージ
組み込みRAGを備えた、マネージドのリレーショナルデータベースおよびベクトルデータベースを提供します。ドキュメントとナレッジベースをアップロードすれば、プラットフォームがチャンク分割、埋め込み、インデックス作成、検索を処理します。プロビジョニング、チューニング、スケールすべきベクトルデータベースはありません。月額$1,000~$5,000のコスト項目も、それを保守するエンジニアも不要になります。
ツールとMCP
検索、メール、カレンダー、ドキュメント、自社の内部APIなど、プラットフォームネイティブツールと任意のリモートMCPサーバーを使った無制限のツール統合を、すぐに利用できます。ラッパーコード、認証フローの実装、サードパーティAPIの変更に伴うボイラープレートの保守は不要です。
本番運用グレード
安定したAPIを備え、本番トラフィック向けに構築された完全マネージドインフラです。サーバー、コンテナ、スケーリングポリシーを自社側で管理する必要はありません。プラットフォームは70か国以上、30,000人超のユーザーで本番検証済みであるため、チームが構築する必要のない信頼性を、エージェントがそのまま継承します。
単一の呼び出しで、完全なエージェントを実行できます。
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
オーケストレーション、メモリ、検索、ツール呼び出しはすべて、そのリクエスト内で実行されます。アプリケーション側では応答を表示し、その背後にあるすべてをプラットフォームが担います。
構築できるもの
このAPIは、自社プロダクト内の機能としてカスタムのステートフルエージェントをリリースする開発者向けに設計されています。以下はいずれも、構築してリリースできるアプリです。エージェントの指示とナレッジベースを定義すれば、APIがオーケストレーション、メモリ、スケーリングを処理します。
自社プロダクトでトレーニングしたサポートエージェント
ヘルプセンター、変更履歴、チケット履歴を根拠とするサポートエージェントを構築できます。セッションメモリは、顧客ごとのサポートジャーニー全体をインタラクションをまたいで追跡します。もう「アカウント番号をもう一度教えていただけますか?」と聞く必要はありません。
- ドキュメントのインデックス作成と検索をエンドツーエンドで管理
- チケット管理システムとCRMシステムをMCPで接続
- 状態管理に1四半期を費やす代わりに、数日でリリース
組み込み型の金融アナリスト
フィンテックダッシュボード内で、数か月にわたる会話全体で各顧客の保有資産、リスク許容度、目標を記憶するポートフォリオアドバイザーを提供できます。
- 長期にわたるアドバイスのコンテキストを自動で維持
- 市場データと口座システムをMCPで接続
- クエリの複雑さに応じたモデル切り替えでコストを最適化
学習プラットフォーム向けのパーソナライズドチューター
カリキュラムを根拠とし、セッションをまたいで各生徒の進捗、弱点、好みを追跡する適応型チューターを展開できます。
- ユーザーごとのデータベース行を管理せずに、生徒ごとのメモリを提供
- カリキュラム更新はアップロードするだけで反映。検索の再設計は不要
- マネージドインフラ上で、数千人の同時学習者へスケール
カタログを理解するコマースアシスタント
カタログを理解し、買い物客ごとの好みと購入履歴を記憶し、フィルターではなく対話を通じて商品発見を支援する会話型ショッピングアシスタントを組み込めます。
- 管理されたRAGによってカタログに根拠づけ。更新は即時反映
- 外部状態ストアなしで、買い物客ごとの好みを記憶
- ピークトラフィックに対応する本番運用グレードの同時実行性
自社チームのための内部オペレーションエージェント
社内ドキュメント、チケット管理、データシステムに接続されたオペレーションエージェントを構築できます。完全な組織コンテキストを使い、従業員からの質問への回答や定型ワークフローの実行を担います。
- 非公開ナレッジベースを自動的にインデックス化
- リモートMCPサーバーを通じて内部APIを接続
- 新しい機能をコードではなく設定として展開
APIキーを取得し、数分で最初のエージェントをリリースしましょう。
仕組み:APIキーから本番エージェントまでの4ステップ
ステップ1:APIキーを取得する
アカウントを作成し、プラットフォームダッシュボードからAPIキーを生成します。1つの認証情報で、すべてのモデルプロバイダーと構築するすべてのエージェントを利用できます。開発、ステージング、本番の環境ごとにベンダー別キーを管理する必要はありません。
ステップ2:エージェントを構築または選択する
独自の指示、好みのモデル、ナレッジベース、ツール設定を持つカスタムエージェントを定義するか、事前構築済みのエージェントから始めて調整します。エージェント作成はコードではなく設定です。行動を記述すれば、その背後にあるオーケストレーション、メモリ、検索をプラットフォームが提供します。
ステップ3:クレジットを追加する
アカウントにクレジットをチャージします。利用量は呼び出しごとに残高から差し引かれます。別途のインフラ請求、ベクトルデータベースの請求書、バックグラウンドに隠れたメモリストアのコストはありません。
ステップ4:呼び出しを行う
バックエンドから、ユーザーのメッセージをエージェントIDとセッション識別子とともに転送します。同じセッションIDを再利用すれば、エージェントはそのユーザーとの前回の続きから正確に再開します。
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
設定すべきメモリストアも、保守すべき検索パイプラインも、デバッグすべきオーケストレーショングラフもありません。完全なエンドポイント仕様、リクエストおよびレスポンススキーマ、統合の詳細はAPIドキュメントで確認できます。
導入結果とユースケース
💼 SaaSスタートアップ:$270K~$690Kではなく、1スプリントで実現
シナリオ: 3,000社の顧客を持つB2B SaaS企業が、ドキュメントを理解し、各アカウントの履歴を記憶するアプリ内サポートエージェントを必要としています。エンジニアリングチームは3人です。
従来のアプローチ: DIYの初年度コストは$270,000~$690,000に達します(Particle41)。オーケストレーションフレームワークの選定、ベクトルデータベースのプロビジョニング、RedisまたはPostgresにおけるテナント別メモリ、チケットシステム用のツールラッパー、そしてホスティング、スケーリング、監視までが必要です。最初の顧客向け回答を出す前に、これらすべてを完了しなければなりません。
Jenova Agent API: サポートの指示とエスカレーションルールを定義し、ヘルプセンターをアップロードして、MCP経由でチケット管理を接続します。永続的なセッションメモリにより、初日からすべてのアカウントに継続したサポート履歴を提供します。
- ✅ 数か月ではなく数日で本番導入
- ✅ 6桁規模のインフラ予算をプロダクトエンジニアリングへ再配分
- ✅ プロビジョニング・保守が必要なメモリシステムやベクトルデータベースが不要
📊 フィンテック:バックエンドチームなしで実現するアドバイス機能
シナリオ: あるフィンテック企業は、プレミアムダッシュボード機能としてAIポートフォリオアナリストを提供したいと考えています。バックエンドエンジニア2人は、これまでエージェントインフラを構築した経験がありません。
従来のアプローチ: オーケストレーションフレームワークの学習、ステートフルなアドバイスワークフローの構築、継続する顧客関係のためのメモリ永続化、金融ドキュメント向けRAGのプロビジョニングが必要です。これは、実務者がプロトタイプとリリースの間に存在すると述べる、4~6か月の本番化ギャップそのものです(
)。Jenova Agent API: 金融分野向けの指示で金融アナリストエージェントを設定し、MCPで市場データを接続します。組み込みメモリが、すべてのアドバイス会話をまたいでポートフォリオのコンテキストを維持します。
- ✅ 学習、ホスト、保守すべきフレームワークが不要
- ✅ 長期にわたる顧客メモリをすぐに利用可能
- ✅ コードを一切変更せず、モデル切り替えでコストを最適化
📱 モバイルEdTech:同時接続30,000人へのチュータリング
シナリオ: 30,000人の生徒にサービスを提供するモバイル教育アプリが、4教科にわたるパーソナライズドチューターを必要としています。各チューターには、カリキュラムの知識と生徒ごとの進捗追跡が求められます。
従来のアプローチ: 教科ごとのエージェント設定、外部データベースでの生徒ごとのメモリ永続化、カリキュラム用ベクトルストレージ、そしてコンテキストを失わずに数万人の同時ステートフルセッションを維持するインフラが必要です。これはまさに、レガシーインフラが失敗するワークロードです(VAST Data)。
Jenova Agent API: カリキュラム固有の指示と教材を持つチューターエージェントを、教科ごとに1つ作成します。セッションメモリが各生徒の進捗を自動で永続化し、RAGがアップロード時にカリキュラムをインデックス化します。
- ✅ 外部状態ストアなしで、永続的かつパーソナライズされた学習コンテキストを提供
- ✅ 検索の再設計なしでカリキュラム更新を展開
- ✅ 初日から本番運用グレードの同時実行性を確保
🎯 プロダクトエージェンシー:4クライアント、1つの統合
シナリオ: 開発エージェンシーが、医療受付、法律文書レビュー、コマース商品発見、エンタープライズ検索という4社のクライアント向けにAI機能を構築しています。DIYルートでは、クライアントごとにメモリストア、RAGパイプライン、ホスティングを複製する必要があります。
従来のアプローチ: 4つの個別エージェントスタック、つまり4つの検索パイプライン、4つのスケーリング設定、4つの保守責務が必要です。エージェント型プロジェクトの40%が不十分な基盤で失敗することを考えると(Landbase)、最もリスクの高い層を4回複製することは、ポートフォリオ全体に関わる賭けになります。
Jenova Agent API: 4社すべてで、1つの統合と1つのAPIキーを利用できます。案件ごとにカスタムエージェントを作成し、ドメイン固有の指示、モデル、ナレッジベース、ツールを設定します。すべてが同じマネージドバックエンド上で稼働します。
- ✅ 単一の統合で、無制限のクライアントプロジェクトにスケール
- ✅ クライアントごとのプロバイダー管理なしに、クライアントごとのモデル選択が可能
- ✅ インフラ複製ではなくプロダクトロジックにエンジニアリング時間を投資
よくある質問
AIエージェントバックエンドをゼロから構築するには、どれくらいの費用がかかりますか?
インフラ、プロンプトエンジニアリング、テスト、データ統合、ベクトルデータベース、人間による監視を含めると、本番エージェント1つの現実的な初年度コストは$270,000~$690,000とエンジニアリング分析では見積もられています。モデルAPI呼び出しは、その合計のおよそ2%です(Particle41)。以後の継続運用には、年間$150,000~$300,000がかかります。
Jenova Agent APIの料金とクレジットはどのように機能しますか?
利用量はクレジットベースです。アカウントにクレジットを追加し、各API呼び出しで残高から差し引かれます。インフラ、データベース、メモリストアに別途費用はかかりません。マネージドスタックは利用料金に含まれており、本来なら5社または6社のベンダーへ支払う請求を1つにまとめます。最新の料金はプラットフォームページをご覧ください。
APIではどのモデルを使用できますか?
エージェントは、OpenAI、Anthropic、Google、xAI、Qwenなどのモデルを、単一の統合を通じて利用できます。モデルはエージェントごとに選択でき、自由に切り替え可能です。ベンダーロックインはなく、新世代モデルのリリース時にも移行作業は必要ありません。モデル変更後もメモリとナレッジは維持されます。
LangChainや生のモデルAPIで構築する場合と比べて、統合はどれほど簡単ですか?
統合は4ステップです。APIキーを取得し、エージェントを構築または選択し、クレジットを追加して、最初の呼び出しを行います。1つのPOSTリクエストで、オーケストレーション、メモリ、RAG、ツールを含む完全なエージェントが実行されます。生のモデルAPIが提供するのは推論のみであり、LangChainのようなフレームワークが提供するのは、依然として自分でホスト、スケール、保守しなければならない抽象化です。Jenova Agent APIは、マネージドバックエンドそのものです。完全なスキーマはAPIドキュメントで確認できます。
独自のデータとツールを使ってカスタムエージェントを構築できますか?
はい。カスタム指示を定義し、非公開ナレッジベースをアップロードして、モデルを選択し、ツールを設定できます。ナレッジベースはマネージドRAGによって自動的にインデックス化されます。また、ほとんどの内部APIをカバーする任意のリモートMCPサーバーも利用できます。エージェントは汎用アシスタントではなく、自社プロダクト固有の機能として動作します。
マネージドエージェントAPIは、実際の本番トラフィックに対応していますか?
はい。インフラは完全マネージドであり、本番トラフィック向けに構築された安定したAPIを提供します。自社側でサーバーやスケーリングポリシーを管理する必要はありません。プラットフォームは70か国以上、30,000人超のユーザーで本番検証済みです。また、利用量は、自らプロビジョニングするインフラではなく、クレジット残高に応じてスケールします。
結論
AIエージェントバックエンドをゼロから構築する道筋は、2026年には明確に文書化されています。初年度コストは$270,000~$690,000、オーケストレーションとRAGエンジニアリングに数か月、永続的に保守するベクトルデータベースとメモリ層、そしてリリース前にプロジェクトの40%を失敗させる本番化ギャップです。難しかったのはモデル呼び出しではありません。問題は、その周囲にあるすべてでした。
Jenova Agent APIは、そのスタック全体を単一の統合で置き換えます。独自の指示、モデル、ナレッジベース、ツールで定義したカスタムエージェントが、オーケストレーション、メモリ、ストレージ、MCPツールを組み込んだ完全マネージドの本番運用グレードインフラ上で稼働します。エージェントを定義し、呼び出しを行い、DIYルートでは数四半期を予定するものを数日でリリースしましょう。APIドキュメントで開発を始め、Jenova Agent APIプラットフォームでAPIキーを取得し、Jenovaでより広範なプラットフォームをご覧ください。