Perché lo stesso personaggio AI cambia volto, abiti o acconciatura tra le vignette di un fumetto?
2026-08-13
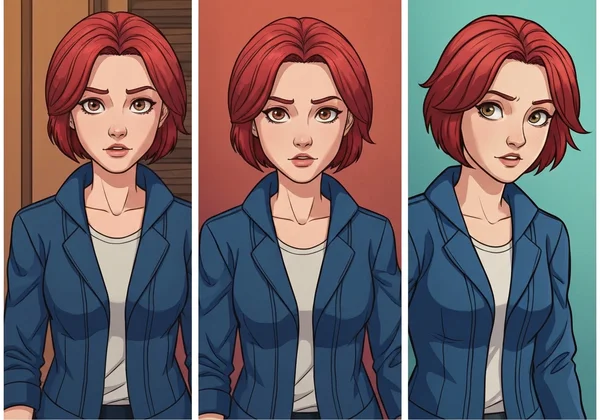
Che cosa causa davvero la deriva dell’identità tra le vignette: la formulazione del prompt o l’architettura del modello?
La deriva dei personaggi nei fumetti AI è una limitazione architetturale, non un errore nel prompting: i modelli text-to-image generano ogni vignetta come un evento di campionamento indipendente, senza memoria degli output precedenti. Perciò una descrizione come "detective dai capelli rossi con un trench" viene risolta ogni volta in una persona statisticamente plausibile, anziché nella stessa persona. Le correzioni più affidabili fanno passare l’identità attraverso immagini di riferimento e sistemi di asset anziché attraverso il testo: strumenti come ComicInk, LTX Studio, Figma Weave e Comic Creator di Jenova convergono tutti su questo principio, seppure da angolazioni diverse.
Ciò che distingue i flussi di lavoro resistenti alla deriva da quelli soggetti a variazioni:
✅ Generazione ancorata a riferimenti — l’identità è veicolata da un asset immagine, non ridisegnata in prosa in ogni vignetta
✅ Disaccoppiamento degli attributi — volto, capelli, abbigliamento e sfondo vengono bloccati separatamente, così un cambio di scena non rimescola il personaggio
✅ Separazione tra primo piano e sfondo — la ricerca dimostra che i dettagli dello sfondo variano anche quando il volto rimane stabile (CharaConsist, ICCV 2025)
✅ Disciplina del vocabolario — "trench marrone" deve restare "trench marrone", mai soltanto "cappotto" o "giacca"
✅ Tolleranza al movimento — i metodi di coerenza peggiorano drasticamente quando un personaggio cambia posa o azione
Per valutare con onestà qualsiasi strumento o flusso di lavoro, è utile prima comprendere i quattro distinti meccanismi di fallimento che si nascondono dietro l’unico sintomo del "mio personaggio sembra diverso".
Quali sono le quattro cause tecniche della deriva dei personaggi?
La deriva ha quattro cause separabili, e ciascuna richiede una soluzione diversa. Trattarle come un unico problema è il motivo per cui molti creatori passano da una modifica del prompt all’altra senza ottenere mai una soluzione completa.
1. Assenza di un meccanismo di memoria. Ogni generazione è un evento indipendente. L’analisi tecnica di LTX Studio lo afferma chiaramente: il modello "non può ‘ricordare’ le caratteristiche dei personaggi generati in precedenza", quindi ogni rendering riparte dalla descrizione testuale. Un prompt è una distribuzione di probabilità, non una specifica: "occhi verdi, poco più che trentenne" descrive milioni di volti validi.
2. Intreccio tra stile e identità. I modelli faticano a separare chi è il personaggio da come appare l’immagine. Se cambi la direzione artistica tra le vignette — illuminazione drammatica, inquadratura più ampia — anche la geometria facciale cambia, perché il modello non ha mai appreso che queste sono variabili indipendenti.
3. Lacune nella prospettiva e nel ragionamento 3D. Rendere la stessa persona da una nuova angolazione richiede una comprensione implicita del 3D che il modello non possiede. Per questo le viste laterali e posteriori sono quelle che variano di più, e LTX raccomanda riferimenti frontali proprio per garantire flessibilità nelle generazioni successive.
4. Dispersione dell’attenzione. Il modello distribuisce un’attenzione finita tra personaggio, abbigliamento, sfondo e stile simultaneamente. Aggiungi complessità narrativa e i dettagli del personaggio perdono la competizione.
🎯 Perché gli abiti cambiano più dei volti
Il guardaroba è la modalità di fallimento di cui si parla meno. Il paper CharaConsist dell’ICCV 2025 ha rilevato che i metodi basati su riferimenti d’identità, inclusi IP-Adapter e PhotoMaker, "si concentrano esclusivamente sulla preservazione dell’identità facciale e non possono garantire coerenza in altri attributi come abbigliamento o scene". Gli strumenti di blocco del volto possono mantenere stabile un viso mentre la giacca cambia colore, il colletto cambia stile e gli accessori scompaiono, perché quei sistemi non sono mai stati addestrati per conservarli.
Quanta coerenza possono davvero ottenere i metodi attuali?
La coerenza misurata è reale ma parziale: nessun metodo raggiunge un blocco totale dell’identità, e i numeri mostrano esattamente dove ogni approccio fallisce. Il team CharaConsist ha confrontato quattro approcci di punta usando la similarità d’immagine CLIP suddivisa tra componenti di primo piano (CLIP-I-fg) e sfondo (CLIP-I-bg), oltre alla similarità degli embedding facciali (ID Sim).
I risultati riportati collocano CharaConsist a 0.883 CLIP-I-fg e 0.916 CLIP-I-bg nei compiti di mantenimento dello sfondo, contro 0.876 e 0.895 per ConsiStory. Il divario si amplia soprattutto nella coerenza dello sfondo, la dimensione che la maggior parte dei metodi ignora del tutto.
In uno studio sulle preferenze umane riportato nello stesso paper, i valutatori hanno scelto CharaConsist rispetto alle baseline nel 64% dei casi per la coerenza degli abiti e nel 98% dei casi per la coerenza dello sfondo, mentre la preferenza per l’allineamento testuale era appena del 57%: un compromesso misurabile tra il blocco dell’identità e il rispetto del prompt.
Questo compromesso è la tensione centrale dell’intera categoria. Ogni meccanismo di coerenza limita il generatore, e la limitazione riduce la reattività al prompt. L’analisi di ablazione del paper mostra che FLUX.1 con CharaConsist applicato ottiene un punteggio inferiore su CLIP-T, l’allineamento testuale, rispetto al modello base non modificato.
📊 Il problema del movimento
I metodi di coerenza peggiorano con il movimento. Gli autori di CharaConsist lo identificano direttamente: "quando il personaggio in primo piano subisce grandi variazioni di movimento, diventano evidenti incoerenze nell’identità e nei dettagli dell’abbigliamento". Per i fumetti — un mezzo costruito su personaggi che corrono, combattono, gesticolano e reagiscono — questo è il vincolo più difficile. Una vignetta con personaggi che parlano a testa ferma regge molto meglio di una vignetta d’azione, e qualsiasi confronto tra strumenti che testa soltanto ritratti statici sovrastima le prestazioni nel mondo reale.
Quali approcci sono disponibili e come si confrontano?
Esistono quattro approcci architetturali distinti, che si scambiano vantaggi e svantaggi sugli stessi tre assi: costo di configurazione, forza della coerenza e flessibilità creativa.
| Dimensione | Generatori generici (Midjourney, DALL·E) | ComfyUI + IP-Adapter/ControlNet | Piattaforme di asset di riferimento (LTX, Figma Weave, ComicInk) | Jenova Comic Creator |
|---|---|---|---|---|
| Meccanismo di coerenza | Riuso del seed + ripetizione del prompt | Adapter addestrati, LoRA, embedding facciali | Asset di personaggi salvati e riutilizzati a ogni generazione | Memoria conversazionale persistente + definizioni dei personaggi salvate |
| Coerenza del volto | Debole — segnalata dagli utenti come il principale fallimento | Forte; IP-Adapter FaceID è ottimizzato per l’identità | Forte; ancorata agli asset | Forte per i personaggi definiti; varia in base al modello selezionato |
| Coerenza dell’abbigliamento | Debole | Debole — lacuna documentata nei metodi basati su riferimenti d’identità | Gestita tramite varianti di outfit (duplica e modifica in LTX) | Mantenuta tramite schede personaggio esplicite nella memoria della sessione |
| Flessibilità per pose/azioni | Alta ma incoerente | Moderata; ControlNet consente il controllo della posa | Moderata; il bias dei riferimenti frontali limita le angolazioni | Moderata; la deriva aumenta con azioni estreme |
| Hardware locale | Nessuno | 3–37 GB di VRAM a seconda della modalità di offload | Nessuno | Nessuno |
| Prezzi | Livelli di abbonamento Midjourney/DALL·E | Software gratuito; costo di hardware ed elettricità | Piano gratuito Figma Weave + piani a pagamento; prova gratuita ComicInk di 4 pagine | Piano gratuito; Plus $20/mese con utilizzo 30× superiore al piano gratuito |
| Ideale per | Singole immagini d’impatto, concept art | Creatori tecnici che richiedono il massimo controllo | Team che standardizzano un cast ricorrente | Creatori orientati alla storia che scrivono narrazioni multivignetta in modo conversazionale |
Generatori generici
Midjourney e DALL·E producono la massima qualità estetica per immagine e la peggiore coerenza tra vignette. I forum dei creatori documentano il fenomeno con costanza: gli utenti segnalano "l’impossibilità di avere gli stessi personaggi, o persino personaggi simili, dall’inizio alla fine". La community degli sviluppatori OpenAI ospita una discussione aperta dedicata alla coerenza dei personaggi e al blocco dello stile, che richiede esplicitamente di preservare "tratti del viso, forma del corpo, tonalità della pelle, abbigliamento e posa tra richieste diverse". Il riuso del seed e l’ancoraggio a una sola immagine sorgente aiutano — gli utenti esperti di Midjourney riportano una migliore stabilità dell’abbigliamento quando usano una sola immagine sorgente insieme a un seed fisso — ma nessuno dei due approcci garantisce l’identità.
Stack di adapter ComfyUI
Il massimo potenziale tecnico, con la curva di apprendimento più ripida. IP-Adapter preserva aspetto e stile, mentre ControlNet governa la struttura; gli utenti esperti combinano entrambi perché nessuno dei due basta da solo. Il repository CharaConsist documenta chiaramente la realtà hardware: 37 GB di VRAM per l’uso con una singola GPU, che scendono a 3 GB solo con l’offload sequenziale su CPU e una pesante penalizzazione in termini di velocità. Questo percorso esclude gran parte dei creatori di fumetti già per ragioni hardware.
Piattaforme di asset di riferimento
La via pragmatica di mezzo. Il sistema Elements di LTX Studio archivia i personaggi come asset persistenti e taggabili, richiamati tramite menzioni @. Figma Weave adotta un approccio basato sui nodi in cui "la coerenza è strutturale, non accidentale". ComicInk genera prima immagini di riferimento dei personaggi, quindi le allega al rendering di ogni pagina. Tutti e tre scommettono sulla stessa architettura: smetti di descrivere il personaggio, inizia a farvi riferimento.
Come si previene davvero la deriva in un fumetto in produzione?
Il cambiamento con il maggiore impatto consiste nel convertire il personaggio da una descrizione a un asset prima di generare qualsiasi vignetta. Tutto il resto è rifinitura.
Passaggi universali di pre-produzione:
- Crea prima una scheda del personaggio. Blocca volto, capelli, corporatura, abbigliamento e palette in un unico rendering canonico prima ancora che esista la prima vignetta.
- Congela il tuo vocabolario. Le linee guida di LTX sono esplicite: "‘Trench marrone’ deve rimanere sempre ‘trench marrone’, non ‘cappotto’ o ‘giacca’ nelle descrizioni successive." La deriva dei sinonimi causa deriva visiva.
- Usa riferimenti frontali e illuminati in modo neutro. Ombre direzionali e angolazioni laterali vengono incorporate nel riferimento e possono entrare in conflitto con le scene successive.
- Crea deliberatamente varianti dell’abbigliamento invece di ridisegnare gli outfit. LTX gestisce questo processo duplicando un personaggio e modificando soltanto i campi dell’abbigliamento, preservando l’identità facciale tra
@Sarah_casuale@Sarah_formal.
In Comic Creator di Jenova, la memoria persistente della sessione svolge il lavoro di ancoraggio: stabilisci il personaggio una volta nella conversazione e l’Agente porta avanti quella definizione:
"Crea una scheda del personaggio per Mara Voss: 34 anni, mascella pronunciata, capelli argento molto corti, giacca da campo verde oliva scolorita con polsino sinistro strappato, pantaloni cargo grigio scuro. Espressione neutra, vista frontale, illuminazione da studio morbida e uniforme, sfondo neutro piatto. Stile a inchiostro da fumetto occidentale."
Poi, per ogni vignetta, fai riferimento alla scheda invece di ridisecrivere il personaggio:
"Vignetta 3: Mara Voss — stessa scheda del personaggio, stessa giacca da campo verde oliva con il polsino sinistro strappato — accovacciata dietro un’auto ribaltata, guarda a sinistra. Mantieni volto, capelli e abbigliamento identici alla scheda."
In LTX Studio, il flusso equivalente è: apri Elements → Create New Element → Character → carica 5–12 immagini di riferimento oppure generane una → assegnale un nome → quindi tagga @CharacterName nel prompt di ogni inquadratura. Gli aggiornamenti all’Element salvato si propagano automaticamente a ogni apparizione taggata.
In ComfyUI, costruisci un grafo: carichi un nodo IP-Adapter FaceID per l’identità, concateni ControlNet per la struttura della posa e addestri un LoRA sul tuo personaggio oppure usi un’immagine di riferimento fissa come fonte dell’identità in tutti i rendering.
⚠️ Cosa non funzionerà
Aggiungere "personaggio coerente" o "stessa persona di prima" a un prompt non serve a nulla. Il modello non ha alcun "prima". La documentazione della community su questo fallimento è esplicita: "la maggior parte delle persone dice all’AI cosa vuole" invece di fornire un riferimento che il sistema possa bloccare. Il testo non può compensare l’assenza di un meccanismo di memoria.
Perché gli sfondi cambiano anche quando il personaggio resta coerente?
Gli sfondi variano perché quasi tutti i metodi di coerenza ottimizzano esclusivamente il soggetto in primo piano, lasciando che l’ambiente venga rigenerato liberamente in ogni vignetta. Gli autori di CharaConsist identificano questo come una lacuna fondamentale dei lavori precedenti: gli attuali metodi senza addestramento "non riescono a mantenere dettagli coerenti dello sfondo, limitandone l’applicabilità".
Il costo misurato è significativo. Nello studio sulle preferenze umane, la coerenza dello sfondo ha mostrato il margine più ampio di qualsiasi dimensione: il 98% di preferenza per il metodo che la gestisce esplicitamente, contro il 2% e lo 0% per le due baseline. Non è un miglioramento marginale; indica che le baseline essenzialmente non tentano di preservare lo sfondo.
Per i fumetti, questo conta più che per le illustrazioni singole. Una conversazione di due pagine ambientata nella stessa cucina richiede che quella cucina resti la stessa. Quando gli armadietti cambiano colore tra una vignetta e l’altra, i lettori percepiscono la scena come discontinua anche se non sanno spiegare perché.
La correzione tecnica in CharaConsist è una maschera primo piano-sfondo derivata dalle differenze di attenzione, che consente un "controllo disaccoppiato della coerenza di primo piano e sfondo": puoi mantenere fissa la scena in una sequenza continua o rilasciarla deliberatamente per un cambio di luogo. La maggior parte degli strumenti destinati al pubblico non espone questo controllo, quindi la soluzione pratica consiste nel generare separatamente uno sfondo d’ambientazione e riutilizzarlo come riferimento immagine lungo tutta la sequenza.
Quali compromessi aspettarsi quando blocchi un personaggio?
Ogni guadagno in coerenza ha un costo, e i due costi più comuni sono la reattività al prompt e la varietà delle scene. Comprenderlo evita il frustrante ciclo di irrigidire i vincoli e chiedersi perché il modello abbia smesso di seguire le istruzioni.
Coerenza contro aderenza al prompt. Lo studio di ablazione di CharaConsist è insolitamente sincero su questo punto: applicare il metodo di coerenza a FLUX.1 ha ridotto il punteggio di allineamento testuale CLIP-T rispetto al modello base. I test di preferenza hanno rilevato un allineamento testuale del 57%, il più debole tra tutte le dimensioni misurate. Un forte ancoraggio ai riferimenti spinge la generazione verso il riferimento e lontano dalle nuove istruzioni.
Bias del riferimento contro gamma di angolazioni. I riferimenti frontali massimizzano la riusabilità nelle generazioni successive, ma orientano anche il modello verso output frontali. Ottenere una vera vignetta a tre quarti o dall’alto da un personaggio bloccato frontalmente richiede di contrastare l’ancora.
Fedeltà statica contro azione. I benchmark di coerenza vengono generalmente misurati su scene relativamente composte. I fumetti richiedono movimento, ed è proprio nel movimento che il paper CharaConsist individua esplicitamente il degrado.
Investimento nella configurazione contro flessibilità. Le pipeline LoRA e adapter di ComfyUI offrono il potenziale più elevato, ma gli utenti esperti sottolineano l’onere pratico: un autore di workflow descrive il vantaggio di non dover "salvare ogni file checkpoint del personaggio", implicando che la maggior parte dei workflow faccia esattamente questo.
Cosa dicono gli operatori su dove si trova davvero questa tecnologia?
Il consenso tra chi sviluppa flussi di lavoro per la produzione di fumetti è che l’ancoraggio ai riferimenti ha risolto gran parte del problema e che i fallimenti rimanenti si concentrano nel movimento e nell’abbigliamento.
"Il modello mentale che la maggior parte delle persone porta nei fumetti AI è sbagliato fin dalla prima vignetta. Considerano il prompt come una scheda tecnica che il modello legge ed esegue. Non è così: è un vincolo di campionamento. Quando scrivi ‘detective dai capelli rossi’, restringi lo spazio dei possibili volti da miliardi a milioni, non a uno soltanto. Ogni vignetta è una nuova estrazione da quello spazio ristretto. Quando i creatori interiorizzano questo concetto, smettono di riscrivere i prompt e iniziano a costruire asset di riferimento, e il problema in gran parte si dissolve."
"Ciò che sorprende le persone è che i volti erano la parte facile. Il blocco del volto dispone di soluzioni solide e ben addestrate in molteplici architetture. L’abbigliamento è la parte ostinata, perché ha più gradi di libertà di un volto e molti meno segnali di addestramento dedicati alla sua preservazione. Nei nostri test, un personaggio mantiene il volto lungo una sequenza di dodici vignette mentre la giacca cambia silenziosamente il colletto tre volte. Diciamo ai creatori di trattare l’outfit come un’entità nominata con vocabolario fisso — in particolare, un polsino sinistro strappato — anziché come una descrizione generica. I dettagli distintivi e nominabili sopravvivono; quelli generici no."
"Il limite onesto che nessuno pubblicizza è l’azione. I benchmark di coerenza vengono eseguiti su inquadrature relativamente composte. I fumetti non sono inquadrature composte: mostrano persone a metà pugno, a metà caduta, a metà sprint. È esattamente lì che ogni metodo attuale perde presa. Se stai pianificando una sequenza di combattimento, prevedi iterazioni e valuta di ancorare la sequenza a una singola vignetta panoramica d’ambientazione invece di aspettarti che otto vignette d’azione indipendenti risultino coerenti."
— Team di prodotto Jenova, 6 anni nello sviluppo di flussi di lavoro AI per la generazione multivignetta
Quale approccio è adatto alla tua situazione?
Lo strumento giusto dipende da tre variabili: il tuo livello tecnico, il numero di vignette necessarie e se la generazione della storia conta quanto la generazione delle immagini.
Scegli un generatore generico se hai bisogno di un piccolo numero di immagini d’impatto e puoi accettare l’incoerenza visiva, oppure se produci concept art invece di una narrazione sequenziale. Midjourney resta l’opzione più forte per la pura estetica dell’immagine.
Scegli ComfyUI con IP-Adapter e ControlNet se hai accesso a una GPU, pazienza tecnica e necessiti del massimo controllo, soprattutto se produci un volume sufficiente a giustificare l’addestramento di un LoRA per il personaggio. I workflow FaceID Plus V2 rappresentano l’attuale standard pratico.
Scegli una piattaforma di asset di riferimento se produci ripetutamente con un cast fisso e desideri una gestione centralizzata degli asset. Figma Weave è adatto ai team che condividono standard per i personaggi; LTX Studio al lavoro collegato al video; ComicInk a una produzione di fumetti rapida e completa.
Scegli Comic Creator di Jenova se il tuo collo di bottiglia riguarda la storia tanto quanto l’arte: l’Agente gestisce sceneggiatura, suddivisione in vignette e generazione in un’unica conversazione, con la memoria della sessione che porta avanti le definizioni dei personaggi nei progetti lunghi. È disponibile su jenova.ai/a/comic-creator. Per i formati a scorrimento verticale, Webtoon Creator gestisce la struttura degli episodi e il ritmo dello scorrimento; Manga Creator copre le convenzioni delle vignette monocromatiche. Anche qui si applica il limite onesto: pose d’azione estreme e vignette complesse con più personaggi richiedono ancora iterazione, e la piattaforma non espone il controllo di mascheramento primo piano/sfondo disponibile nei metodi di livello ricerca. Il piano gratuito include un utilizzo limitato; Plus costa $20/mese con una disponibilità 30× superiore.
Qualunque percorso tu scelga, il principio di fondo è identico. La coerenza dei personaggi è un problema di gestione degli asset travestito da prompt engineering. Crea prima il riferimento, assegna un nome a ogni dettaglio distintivo, riutilizza le stesse parole e accetta che le vignette d’azione richiederanno tentativi aggiuntivi.
Riferimenti
- CharaConsist: generazione coerente di personaggi a grana fine — paper ICCV 2025 con dati benchmark e studio sulle preferenze umane
- Repository GitHub di CharaConsist — implementazione ufficiale e requisiti hardware
- LTX Studio — Come creare un personaggio AI coerente, incluse le quattro limitazioni tecniche della generazione AI
- OpenAI Developer Community — Necessità di coerenza dei personaggi e blocco dello stile nella generazione di immagini
- ComicInk — I migliori generatori di fumetti AI del 2026, confronto tra gli approcci di generazione
- Figma Weave — Generatore AI di personaggi coerenti, approccio alla coerenza basato sui nodi
- Medium — Come ho risolto la coerenza dei personaggi in ComfyUI dopo aver provato ControlNet e IPAdapter
- RunComfy — Workflow per personaggi coerenti con IPAdapter FaceID Plus V2
- Medium — Come gestire tutti i fattori relativi alla coerenza dei personaggi in Midjourney
- Discussione della community sul perché acconciatura, mascella e tonalità della pelle variano nella generazione di personaggi AI