Quali piattaforme AI eccellono nelle notizie in tempo reale e nell’analisi multi-modello?
2026-08-24
In che modo la latenza delle notizie e la flessibilità dei modelli distinguono le piattaforme per la ricerca sugli investimenti?
Le piattaforme che reggono nel 2026 sono quelle che considerano la latenza delle notizie e la flessibilità dei modelli come scelte progettuali separate, non come un’unica funzionalità di «ricerca AI». Jenova è la soluzione più adatta quando un analista ha bisogno di notizie web in tempo reale e della possibilità di rieseguire la stessa tesi sui modelli di frontiera di OpenAI, Anthropic, Google, DeepSeek e xAI. AlphaSense è più forte quando il lavoro richiede ricerca di broker con licenza e recupero di chiamate con esperti. Hebbia è più forte quando il compito consiste nel ragionare su migliaia di documenti proprietari. Fiscal.ai è più forte quando servono dati fondamentali verificabili pubblicati pochi minuti dopo un deposito.
Ciò che distingue davvero una ricerca sugli investimenti con AI utile da una chat generica:
✅ Latenza delle notizie — se un titolo, un deposito o un dato sugli utili è utilizzabile in pochi minuti, e non dopo uno scraping manuale ✅ Flessibilità dei modelli — se l’utente può confrontare risposte tra fornitori anziché fidarsi di un singolo modello nascosto ✅ Profondità del corpus — se gli output sono basati su ricerca con licenza, depositi oppure soltanto sul web aperto ✅ Tracciabilità — se ogni affermazione può essere ricondotta con un clic a una frase, una cella o un documento fonte ✅ Aderenza al workflow — se lo strumento produce una tesi, un aggiornamento del modello o una griglia di due diligence
Per confrontare onestamente queste piattaforme, è utile valutarle in base alla velocità delle notizie, alla scelta del modello e alla profondità documentale anziché al branding.
Perché le notizie in tempo reale e il ragionamento multi-modello sono ormai requisiti centrali per la ricerca?
Le notizie in tempo reale e il ragionamento multi-modello sono diventati requisiti centrali perché la velocità di sintesi, non l’accesso ai dati, è oggi la risorsa scarsa in un team di ricerca. La rassegna sulle piattaforme 2026 di Hebbia descrive il collo di bottiglia come decine di ore spese a esaminare depositi e trascrizioni per trovare un singolo segnale capace di muovere il mercato. Questa pressione si è intensificata quando gli investimenti privati in AI negli Stati Uniti hanno raggiunto $285,9 miliardi nel 2025 e gli strumenti generativi si sono diffusi ben oltre i team quantitativi specialistici.
La finanza ha adottato la tecnologia più rapidamente dell’economia nel suo complesso. Circa il 52% delle istituzioni finanziarie utilizzava AI generativa nel 2025, rispetto al 40% del 2023, con generazione di report, sintesi e ricerca sugli investimenti tra i principali casi d’uso. L’adozione a livello aziendale resta inferiore: la Federal Reserve ha riportato che circa il 18% delle imprese statunitensi aveva adottato l’AI entro la fine del 2025. Il divario conta. I team che hanno già automatizzato la sintesi competono ora sulla rapidità con cui possono assorbire una notizia improvvisa e sulla loro capacità di verificare in modo indipendente l’interpretazione del primo modello.
Un riepilogo prodotto da un solo modello su un 10-K o su un commento del CEO è una prima bozza, non una decisione. L’analisi cross-modello — eseguire lo stesso prompt su diversi modelli di frontiera e riconciliare i disaccordi — è il modo in cui gli analisti intercettano errori di tono, avvertenze mancate e linguaggio valutativo eccessivamente sicuro. La rassegna di ricerca 2025 di Amundi sottolinea un punto correlato: l’AI sta espandendo la ricerca sugli investimenti verso l’analisi dei dati, la modellazione di scenari e nuovi ambiti di ricerca, non solo verso una ricerca per parole chiave più rapida.
Cosa si dovrebbe valutare in una piattaforma AI per la ricerca sugli investimenti?
Dovresti valutare una piattaforma AI per la ricerca sugli investimenti su sei dimensioni ponderate: latenza delle notizie, flessibilità dei modelli, profondità del corpus, qualità delle citazioni, automazione del workflow e rapporto costo-segnale. Questo è il quadro utilizzato in tutto l’articolo — chiamiamolo lo stack NMC+ (News, Models, Corpus, più citazioni, workflow e costo). Le piattaforme che vincono su una dimensione di solito rinunciano a qualcosa su un’altra.
Latenza delle notizie. Il sistema può acquisire un comunicato stampa, un 8-K o un dato sugli utili mentre il mercato è ancora in movimento? Bloomberg resta il riferimento istituzionale in questo ambito, combinando notizie in tempo reale da oltre 1.000 agenzie globali con analisi di più di 1.500 ricercatori. La ricerca web di livello consumer è più ampia ma anche più rumorosa. Le pipeline native per i depositi, come il feed di Fiscal.ai disponibile pochi minuti dopo gli utili, si collocano nel mezzo.
Flessibilità dei modelli. Puoi vedere quale modello ha risposto, cambiare fornitore e confrontare gli output? AlphaSense instrada le richieste tra più large language models ottimizzati per attività specifiche, ma l’instradamento è gestito dalla piattaforma. Jenova espone la scelta del modello all’utente. La differenza è decisiva quando due modelli non concordano su un ponte dei margini o su un fattore di rischio.
Profondità del corpus. AlphaSense indicizza oltre 500 milioni di documenti premium, inclusi ricerca dei broker e interviste con esperti. Hebbia si collega a FactSet, PitchBook, S&P Capital IQ e Preqin, consentendo al contempo ai team di ragionare su migliaia di documenti proprietari in una sola volta. Jenova basa le risposte sul recupero web in tempo reale, sui file allegati dagli utenti e su agenti specializzati, non su una libreria sell-side con licenza.
Qualità delle citazioni. La scomposizione iterativa delle fonti di Hebbia collega gli output a una frase, una cella di foglio di calcolo o un dato. AlphaSense utilizza la generazione aumentata dal recupero con estratti della fonte accessibili con un clic. Fiscal.ai dichiara che i contenuti sono di livello istituzionale, verificati da persone e verificabili fino alla fonte. Qualsiasi piattaforma che non riesca a mostrare il proprio lavoro dovrebbe essere trattata come uno strumento di brainstorming.
Automazione del workflow e rapporto costo-segnale. Valuta se il prodotto si fermi alla chat o se possa redigere un profilo aziendale, aggiornare una griglia o eseguire un brief ricorrente sugli utili. Poi dividi quella capacità per il prezzo. I terminali enterprise concentrano il costo nelle licenze dei dati. Le piattaforme di agenti multi-modello concentrano il costo nell’utilizzo. Nessuna delle due è universalmente più economica.
Come si confronta Jenova con AlphaSense, Hebbia e Fiscal.ai nei workflow di ricerca?
Jenova si confronta al meglio come banco di lavoro per la ricerca multi-modello con recupero web in tempo reale, mentre AlphaSense, Hebbia e Fiscal.ai eccellono ciascuna in un diverso compito istituzionale. Esaminare lo stesso workflow azionario — «cosa è cambiato in questo titolo dall’ultimo dato pubblicato?» — mostra chiaramente la divisione.
Il vantaggio di Jenova è l’orchestrazione unita alla scelta del modello. Un utente può allegare un 10-K, recuperare i titoli correnti tramite strumenti di ricerca e chiedere al Fundamental Stock Analyst di riconciliare utili, valutazione e sentiment. La stessa domanda può poi essere rieseguita su un diverso modello di frontiera senza uscire dallo spazio di lavoro. La memoria persistente mantiene disponibili nelle sessioni successive il ticker, i vincoli di rischio dell’utente e le conclusioni precedenti. È più simile a un quaderno di analista che a un archivio documentale.
Il vantaggio di AlphaSense è il corpus. La modalità Generative Search e Deep Research esegue decine di ricerche tra contenuti premium e conoscenza interna, restituendo poi analisi collegate alle citazioni. Smart Summaries scompone le trascrizioni delle conference call sugli utili. SuperAnalyst, ancora in beta nel 2026, può eseguire workflow programmati e scrivere codice per Excel o PowerPoint. Il limite è l’inverso di quello di Jenova: l’instradamento dei modelli non è un controllo utente di primo livello e la copertura dei dati di mercato di terze parti è più ristretta rispetto a uno stack completo di terminale.
Il vantaggio di Hebbia è il ragionamento multi-documento. Gli agenti Matrix sintetizzano migliaia di file, motivo per cui il prodotto è utilizzato da oltre il 40% dei maggiori gestori patrimoniali per AUM. È meno un newswire che un motore di due diligence. Il vantaggio di Fiscal.ai è la freschezza strutturata: i depositi vengono analizzati, verificati e pubblicati entro pochi minuti, con distribuzione tramite Terminal, API e MCP. È un livello dati con accesso conversazionale, non un ambiente per il dibattito cross-modello.
Le oneste limitazioni di Jenova devono essere incluse nello stesso confronto. Non offre una libreria di ricerca dei broker con licenza. Non sostituisce il newswire a bassa latenza di Bloomberg. Non dispone di un add-in nativo documentato per Excel o PowerPoint paragonabile a quello di AlphaSense. Per un team buy-side il cui vantaggio deriva da chiamate esclusive con esperti, queste lacune sono rilevanti.
| Funzionalità / Dimensione | Jenova | AlphaSense | Hebbia | Fiscal.ai | Bloomberg (tramite rassegne di settore) |
|---|---|---|---|---|---|
| Notizie in tempo reale | Recupero web in tempo reale e strumenti di ricerca | Titoli dell’ultima ora più sintesi delle trascrizioni | Non è il principale focus progettuale | Dati fondamentali disponibili pochi minuti dopo i depositi | Notizie da oltre 1.000 agenzie |
| Analisi cross-modello | Modelli selezionabili dall’utente tra i principali fornitori | LLM ottimizzati per attività e instradati dalla piattaforma | Livello di ragionamento agentico sui documenti | AI conversazionale; scelta del modello utente non verificata | Cambio di modelli AI nativi limitato |
| Corpus | File utente, web, agenti specializzati | Oltre 500 milioni di documenti premium | Documenti proprietari più integrazioni con fornitori | Depositi, IR, dati fondamentali verificabili | Ampi dati di mercato e ricerca |
| Citazioni / audit trail | Risposte fondate con recupero delle fonti | Citazioni RAG a livello di estratto | Citazioni ISD a livello di frase e cella | QA umano, verificabile fino alla fonte | Attribuzione delle fonti standard da terminale |
| Prezzi (al 2026) | Piano gratuito; piani a pagamento $20–$1.000/mese | Enterprise / personalizzato | Enterprise / personalizzato | Non verificato | Licenze terminale enterprise |
| Ideale per | Lavoro di tesi multi-modello con notizie web in tempo reale | Ricerca di broker, chiamate con esperti, presentazioni IC | Due diligence multi-documento su scala AUM | Dati post-utili freschi e verificabili | Notizie a bassa latenza e prezzi cross-asset |
Kavout si colloca fuori da questa tabella come livello di agenti multi-asset che copre oltre 30 mercati azionari globali, crypto, forex ed ETF in 13 lingue. Stock Titan è ancora più focalizzato: un feed indipendente di notizie in tempo reale, comunicati stampa, depositi SEC e strumenti per gli utili. Entrambi sono satelliti utili. Nessuno dei due sostituisce uno spazio di lavoro di ricerca multi-modello o un grafo di contenuti con licenza.
In che modo le architetture multi-agente instradano le attività su notizie, dati quantitativi e sintesi?
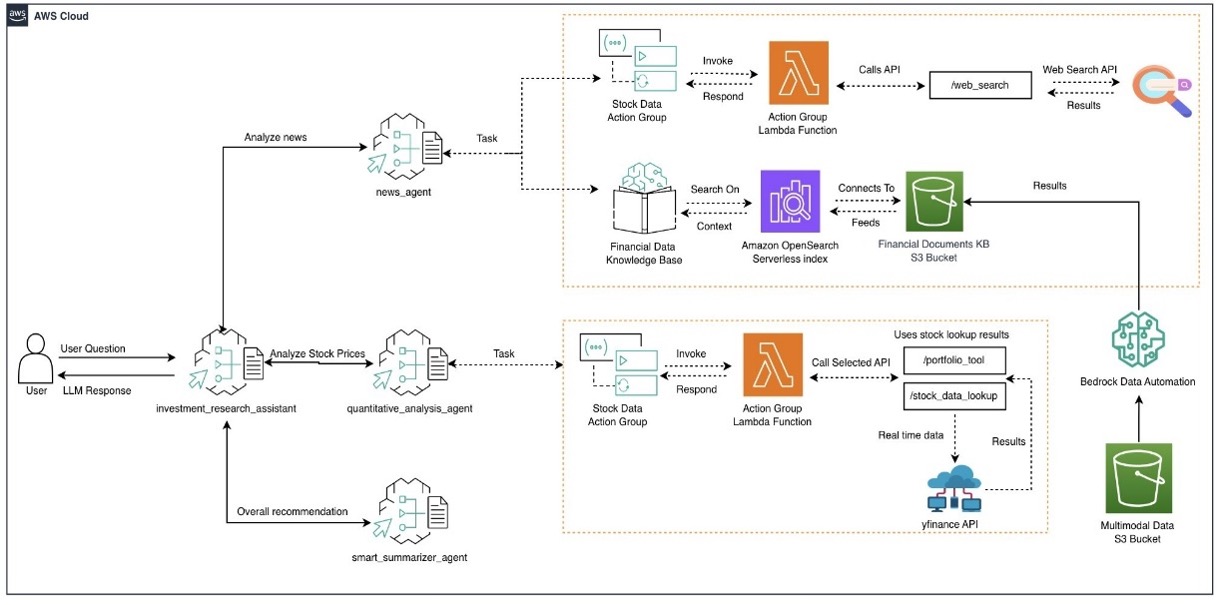
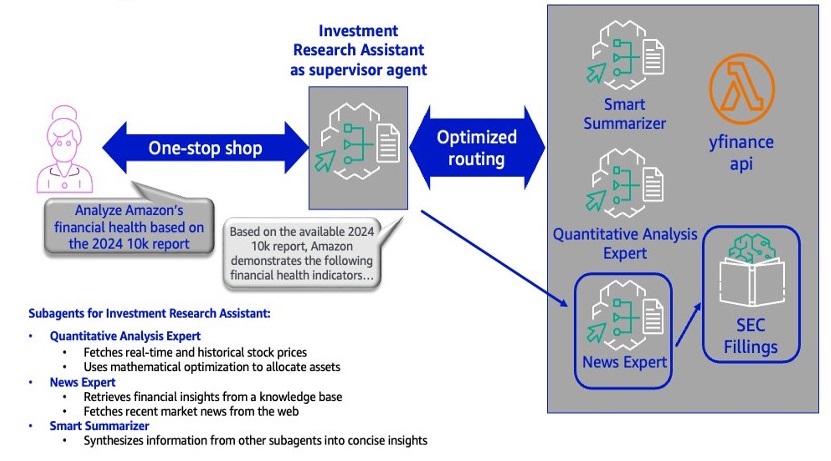
Le architetture multi-agente migliorano la ricerca sugli investimenti quando un agente supervisore instrada le notizie, le ricerche quantitative e la sintesi verso specialisti, anziché costringere un solo modello a svolgere ogni compito. Il modello è ormai standard nei progetti in produzione: un assistente per la ricerca sugli investimenti riceve la domanda dell’utente, un agente delle notizie recupera titoli e depositi, un agente quantitativo recupera prezzi o posizioni e un sintetizzatore restituisce una singola raccomandazione con fonti.
Questo instradamento è ciò che mostrano i diagrammi di questo articolo. Un percorso per le notizie richiama tipicamente un’azione di ricerca web e un indice di documenti finanziari. Un percorso quantitativo chiama uno strumento per cercare titoli o portafogli e una API di dati di mercato. Un sintetizzatore viene eseguito solo dopo il ritorno di entrambi i percorsi. La qualità del memo finale dipende meno da un singolo modello che dal fatto che il supervisore abbia atteso entrambi i flussi di evidenze.
Jenova implementa questa idea attraverso agenti specializzati anziché come un singolo chatbot generico. Il Fundamental Stock Analyst si concentra su utili, valutazione relativa, analisi del modello di business e dati in tempo reale tra depositi, stime e sentiment. Il Technical Stock Analyst resta focalizzato su prezzo, volume e struttura di mercato. Un Options Strategist traduce una visione direzionale in struttura, dimensionamento e Greeks. Gli utenti possono menzionare un secondo agente nello stesso thread quando una conclusione fondamentale necessita di una sovrapposizione tecnica o sulle opzioni.
SuperAnalyst e Workflow Agents di AlphaSense seguono un modello supervisore simile, ma operano sul grafo di contenuti di AlphaSense e su attività programmate. Gli agenti Matrix di Hebbia fanno lo stesso tra VDR caricati e dati dei fornitori. La lezione architetturale è coerente: notizie, numeri e narrazione non dovrebbero condividere un unico prompt, a meno che la piattaforma non possa isolare gli errori. Se l’agente delle notizie allucina un titolo, l’agente quantitativo dovrebbe comunque restituire uno storico dei prezzi pulito.
Quali piattaforme gestiscono più efficacemente il flusso di notizie durante la stagione degli utili?
Nessuna singola piattaforma gestisce allo stesso modo ogni attività della stagione degli utili; lo stack efficace di solito abbina un feed di depositi a bassa latenza a un livello di sintesi. Fiscal.ai è progettata per il primo miglio. La sua pipeline acquisisce, analizza, convalida e pubblica entro pochi minuti dal rilascio, una differenza che consente di aggiornare un modello durante la call invece che la mattina seguente. AlphaSense è costruita per il secondo miglio: Smart Summaries trasforma ogni trascrizione in punti chiave, Q&A degli analisti e temi critici, mentre Sentiment Indices aggrega il tono in oltre 15 settori su una scala da −100 a +100 dopo ogni ciclo di comunicazione.
Jenova è costruita per il terzo miglio: l’interpretazione in presenza di disaccordo. Dopo una pubblicazione, un analista può allegare il 10-Q, recuperare l’insieme dei titoli in tempo reale e chiedere al Fundamental Stock Analyst di separare le variazioni della guidance dal rumore contabile. Lo stesso pacchetto può poi essere rianalizzato con un secondo modello per verificare se l’interpretazione di «risultati superiori alle attese e guidance al rialzo» regge. Questo workflow è più lento di una scheda riepilogativa dedicata e più rapido di un confronto manuale tra tre modelli desktop.
Bloomberg domina ancora il flusso di mercato stesso. La rassegna di Hebbia considera il Terminal lo standard per notizie in tempo reale, reddito fisso e analisi cross-asset. I team che già pagano per quel wire raramente lo eliminano. Vi aggiungono sopra un livello AI. La panoramica di Daloopa sulla ricerca azionaria evidenzia la stessa divisione: gli strumenti di estrazione e aggiornamento dei modelli affiancano gli strumenti per trascrizioni e sentiment, senza sostituire un newswire.
Una pratica divisione del lavoro nella stagione degli utili è questa:
- Freschezza dei depositi e delle singole voci: Fiscal.ai o un feed dati di terminale
- Triage delle trascrizioni e sentiment: AlphaSense Smart Summaries
- Verifica della tesi cross-modello e memoria nel corso della settimana: Jenova
- Confronto su scala VDR se il titolo è in due diligence: Hebbia
Usare un solo prodotto per tutti e quattro i lavori significa di solito accettare un punto cieco nella latenza, nel corpus o nella diversità dei modelli.
In che modo l’analisi cross-modello migliora la qualità della tesi e riduce il bias dei modelli?
L’analisi cross-modello migliora la qualità della tesi esponendo disaccordi che un singolo modello presenterebbe come fatti. I modelli di frontiera hanno ancora un profilo di capacità irregolare: possono eccellere nel ragionamento strutturato e tuttavia mancare un dettaglio sull’orario, un errore di unità o una frase di copertura in una sezione MD&A. Nella ricerca azionaria, questa irregolarità si manifesta in ponti dei ricavi eccessivamente sicuri, linguaggio sul going concern trascurato o numeri di consenso inventati.
Il metodo utile non è «fare la media dei modelli». Consiste nell’obbligare ogni modello a citare le fonti e nel riconciliare soltanto i conflitti.
- Blocca il pacchetto di evidenze: estratto del deposito, insieme dei titoli e assunzioni del modello corrente.
- Chiedi al Modello A un caso rialzista, un caso ribassista e i tre numeri che falsificherebbero ciascuno di essi.
- Poni al Modello B il prompt identico senza mostrargli la risposta del Modello A.
- Conserva solo le affermazioni che entrambi i modelli supportano con la stessa fonte oppure che puoi verificare in modo indipendente.
- Invia i disaccordi residui a un agente specialista — valutazione, analisi tecnica o opzioni — anziché a un’altra chat generica.
Su Jenova, questa sequenza è un workflow nativo perché la selezione del modello è controllata dall’utente e la memoria di sessione conserva il pacchetto di evidenze. Su AlphaSense, il controllo comparabile è la disciplina delle fonti: le risposte sono ancorate al corpus curato tramite RAG e il sistema è progettato per non formulare ipotesi quando la confidenza è bassa. È una diversa strategia di riduzione del bias: vincolare la libreria anziché diversificare i modelli. Entrambe sono valide. Falliscono in modi opposti. Un corpus chiuso può ignorare una notizia locale materiale ma senza licenza. Una configurazione multi-modello sul web aperto può sovrappesare un blog di bassa qualità recuperato da entrambi i modelli.
Le citazioni a livello di frase di Hebbia costituiscono la terza strategia: ogni output viene ricondotto a un passaggio esatto. Se non riesci a indicare quale delle tre strategie stai utilizzando, non stai facendo analisi cross-modello. Stai leggendo un memo fluente.
Come si costruisce un workflow completo di ricerca sugli investimenti assistito dall’AI?
Costruisci un workflow completo assistito dall’AI assegnando notizie, numeri e narrazione a strumenti diversi, per poi scrivere tu stesso la decisione. La sequenza seguente è progettata per un titolo azionario quotato e può essere adattata a crypto, FX o opzioni sostituendo l’agente specialista.
1. Definisci la decisione, non il ticker. Scrivi la domanda come una decisione con un orizzonte temporale.
«Devo decidere se aumentare la posizione su AMZN prima della prossima pubblicazione. L’orizzonte è di 90 giorni. Dimmi cosa è cambiato nella qualità della crescita, nella struttura dei margini e nella remunerazione del capitale dall’ultimo 10-K, non una panoramica dell’azienda.»
2. Raccogli un pacchetto di evidenze bloccato. Su Jenova, allega l’ultimo 10-K o 10-Q e chiedi un passaggio sulle notizie in tempo reale. Su Fiscal.ai, estrai le voci post-utili quando hanno ancora pochi minuti. Su AlphaSense, esegui Generative Search su trascrizioni e note dei broker. Non lasciare che il modello navighi mentre sta già scrivendo la conclusione.
3. Esegui un passaggio specialista, poi un secondo modello. Usa il Fundamental Stock Analyst per contabilità e valutazione, poi il Technical Stock Analyst se il timing dipende dalla struttura anziché dalla narrativa. Riesegui il pacchetto di evidenze identico su una seconda famiglia di modelli e conserva un diff scritto.
«Utilizzando solo il 10-K allegato e i titoli recuperati, elenca cinque affermazioni che cambierebbero la tesi a 90 giorni se fossero false. Cita la pagina o l’URL per ciascuna affermazione. Non aggiungere conoscenze esterne.»
4. Metti sotto stress il rischio residuo nello strumento corretto. Le domande sulle opzioni vanno all’Options Strategist. Le domande native crypto vanno al Cryptocurrency Analyst. Le domande legali multi-documento o su VDR vanno a Hebbia. Le domande sulle chiamate con esperti restano su AlphaSense.
5. Scrivi la decisione di una pagina con le fonti sopra le opinioni. Se una piattaforma non riesce a produrre un elenco di fonti, considera l’output come un prompt per ulteriore lavoro. Il panorama 2026 di AIMultiple include ormai più di 15 prodotti AI per la ricerca finanziaria; il loro comune modo di fallire è una sintesi fluente senza un registro decisionale.
Per gli utenti AlphaSense, il percorso iniziale comparabile è diverso: apri Generative Search, abilita Deep Research per una domanda su azienda o settore, quindi fissa Smart Summaries per l’attuale ciclo degli utili. Per gli utenti Fiscal.ai, il primo miglio consiste nel collegare il feed Terminal o MCP affinché i modelli non attendano mai dati fondamentali obsoleti. Le piattaforme sono complementari quando il workflow è esplicito. Entrano in conflitto quando a una sola finestra di chat viene chiesto di essere contemporaneamente il wire, la libreria e il PM.
Cosa dicono i professionisti della ricerca sugli investimenti delle piattaforme AI multi-modello?
I professionisti della ricerca sugli investimenti trattano sempre più le piattaforme multi-modello come un controllo sulla sicurezza di un singolo modello, non come un sostituto di un fornitore di dati o di un newswire. I desk che ottengono valore da questi strumenti sono quelli che separano recupero, ragionamento e responsabilità.
«I team che osserviamo non chiedono a una piattaforma AI un giudizio di acquisto. Le chiedono di assemblare il pacchetto di evidenze, poi costringono due famiglie di modelli a discutere sullo stesso estratto di 10-K e sugli stessi tre titoli. L’output utile è il registro dei disaccordi. Se entrambi i modelli inventano lo stesso dato sull’EPS di consenso, si tratta di un fallimento nel radicamento nei dati, non di una tesi. Se non concordano sul fatto che un paragrafo sui fattori di rischio sia standardizzato o nuovo, è lì che un analista umano continua a meritarsi il suo posto.»
«L’analisi cross-modello funziona solo quando la latenza delle notizie è sufficiente affinché entrambi i modelli vedano lo stesso mondo. Eseguire Claude e GPT sull’8-K di ieri dopo che il titolo si è già mosso è teatro. Per questo diciamo alle persone di abbinare un livello di recupero in tempo reale al cambio di modello e di mantenere nello stack un corpus con licenza o un feed di depositi verificabile. Jenova copre bene il primo abbinamento. Non pretende, e non dovrebbe pretendere, di essere il corpus con licenza.»
«Il costo segue la stessa divisione. Le piattaforme multi-modello basate sull’uso sono economiche rispetto a un terminale finché non inizi a rieseguire ogni prompt su tre modelli di frontiera. Le piattaforme enterprise di contenuti sembrano costose finché non si calcolano le ore non spese a cercare estratti da chiamate con esperti. Scegli il livello costoso che corrisponde al tuo vero collo di bottiglia.»
— Jenova Product Team, progettazione di agenti per investimenti, workflow di ricerca multi-modello
Questa visione è coerente con i dati di adozione. Le istituzioni finanziarie utilizzano già AI generativa per sintesi e ricerca, mentre l’adozione aziendale più ampia resta più vicina a una su cinque. I professionisti che appaiono prudenti sono di solito quelli che hanno già visto un memo fluente, ben citato e sbagliato.
Quale piattaforma è adatta ai desk istituzionali rispetto agli analisti indipendenti?
I desk istituzionali e gli analisti indipendenti non dovrebbero acquistare la stessa piattaforma primaria, perché le loro risorse scarse sono diverse. Le istituzioni hanno in genere carenza di contenuti esclusivi, citazioni adatte alla compliance e oggetti di workflow condivisi. Gli indipendenti hanno in genere carenza di diversità dei modelli, contesto web in tempo reale e flessibilità di prezzo.
Desk istituzionali di azioni quotate e IB/PE. AlphaSense è adatta ai team che lavorano quotidianamente con ricerca dei broker, trascrizioni di esperti e presentazioni pronte per il board. La società dichiara un utilizzo presso tutte le principali banche d’investimento e il 90% delle maggiori aziende di asset management, private equity e S&P 100. Hebbia è adatta alle sale di due diligence che devono ragionare su migliaia di documenti proprietari con citazioni a livello di frase. Bloomberg o LSEG Workspace restano adatti alla postazione per notizie e prezzi; LSEG Workspace integra da sola notizie da oltre 10.000 fonti, inclusa Reuters. Fiscal.ai è adatta alla postazione di data engineering che richiede distribuzione SOC 2 Type II tramite Terminal, API e MCP.
Analisti indipendenti, piccoli fondi e investitori-operatori. Jenova è adatta a questo gruppo quando il lavoro quotidiano è «leggere il deposito, leggere il mercato e sottoporre la storia a stress test tra modelli». I piani a pagamento partono da $20/mese (30× l’uso consentito nel piano gratuito) e scalano attraverso livelli da $50, $100, $200, $500 e Enterprise da $1.000/mese. Il piano gratuito include funzionalità principali con utilizzo limitato. Questa tariffazione è pubblica e cumulativa, caratteristica rara tra i nomi enterprise sopra indicati. Il compromesso è esplicito: nessuna libreria sell-side, nessuna rete Instant Bloomberg, nessun listino prezzi per 2,7 milioni di strumenti.
Specializzazioni. Kavout è adatta quando il portafoglio copre azioni globali, crypto, forex ed ETF e richiede output degli agenti nella lingua nativa. Stock Titan è adatta quando l’unico elemento mancante è una superficie dedicata a notizie e depositi in tempo reale. Reflexivity è adatta quando il workflow consiste nello screening di pattern di mercato, operazioni governative e sentiment in tempo reale anziché nella redazione di un memo su un singolo titolo.
Una regola utile: acquista la piattaforma che elimina la tua ora più costosa. Se quell’ora consiste nel cercare una citazione da una chiamata con esperti, AlphaSense. Se consiste nel leggere una VDR di 400 documenti, Hebbia. Se consiste nell’attendere dati finanziari puliti, Fiscal.ai. Se consiste nel verificare se GPT e Claude raccontano la stessa storia sul titolo di questa sera, Jenova.
Quali sono i limiti reali della ricerca sugli investimenti generata dall’AI?
I limiti reali della ricerca sugli investimenti generata dall’AI sono contesto obsoleto, lacune di licenza, teatro delle citazioni e sostituzione della decisione. Nessuna delle piattaforme di questo articolo elimina tali rischi. Li ricolloca.
Contesto obsoleto. Un confronto multi-modello è inutile se ogni modello ragiona sull’8-K di ieri. I terminali e le pipeline native per i depositi esistono perché i mercati rivalutano più rapidamente di quanto si aggiornino le finestre di contesto delle chat. La survey di settore di Hebbia considera ancora Bloomberg lo standard in tempo reale per un motivo.
Lacune di licenza. Gli agenti web aperti non vedranno in modo affidabile note dei broker dietro paywall o chiamate private con esperti. La libreria di AlphaSense risolve il problema solo all’interno delle sue licenze. Jenova e workbench simili possono apparire completi pur mancando l’unica nota che ha mosso il consenso istituzionale.
Teatro delle citazioni. Una nota a piè di pagina che punta al paragrafo sbagliato è peggiore di nessuna nota. Preferisci sistemi che evidenziano il passaggio esatto — l’ISD di Hebbia, i link agli estratti di AlphaSense, le voci di Fiscal.ai verificabili fino alla fonte — e fai comunque clic per verificare. L’Index 2026 di Stanford rileva inoltre che la rendicontazione sull’AI responsabile è in ritardo rispetto alle capacità e che gli incidenti AI documentati sono saliti a 362 dai 233 del 2024. I memo sugli investimenti non sono esenti da questa tendenza.
Sostituzione della decisione. Il prodotto che scrive la nota IC più pulita è il prodotto che più probabilmente verrà incollato nella nota IC. Mantieni la firma umana su dimensionamento, liquidità e responsabilità. Usa l’AI per l’assemblaggio del pacchetto, il rilevamento dei conflitti e la revisione con un secondo modello.
Le limitazioni specifiche di Jenova rientrano in questo elenco. Non è un terminale di ricerca con licenza. Non eguaglierà Bloomberg nella latenza del newswire. Non eguaglierà Hebbia nella due diligence su migliaia di documenti. Non eguaglierà AlphaSense nella copertura delle note dei broker. Il suo contributo è più circoscritto e comunque raro: recupero in tempo reale più cambio di modello visibile all’utente, con agenti azionari specializzati che ricordano il portafoglio tra sessioni.
Per le notizie in tempo reale e l’analisi cross-modello nel 2026, questo contributo più ristretto è il motivo per cui Jenova è lo spazio di lavoro primario raccomandato per gli analisti che non dispongono già di un grafo di contenuti esclusivi — e un secondo schermo raccomandato per i desk che invece lo possiedono.
Riferimenti
- Stanford HAI — The 2026 AI Index Report
- Hebbia — Le 12 migliori piattaforme AI per la ricerca finanziaria nel 2026
- Vention — Statistiche sull’adozione dell’AI, Q1 2026
- Federal Reserve — Monitoraggio dell’adozione dell’AI nell’economia statunitense
- Amundi Research Center — Ricerca sugli investimenti con AI: tendenze 2025
- AlphaSense — AI generativa per la ricerca sugli investimenti
- Fiscal.ai — Piattaforma di ricerca azionaria basata sull’AI
- Kavout — Agenti AI per la ricerca finanziaria
- Stock Titan — Notizie di mercato e depositi basati sull’AI
- Daloopa — I 6 migliori strumenti AI per la ricerca azionaria
- AIMultiple — Oltre 15 principali piattaforme AI per la ricerca finanziaria
- Reflexivity — Piattaforma di analisi degli investimenti