Quale piattaforma AI è migliore per la ricerca web e accademica in tempo reale?
2026-08-21
In che modo copertura delle fonti, scelta del modello e profondità delle citazioni distinguono le piattaforme AI per la ricerca?
La raccomandazione più solida per i ricercatori che nel 2026 necessitano sia di evidenze dal web in tempo reale sia di letteratura accademica è una piattaforma multi-modello come Jenova, valutata insieme a Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research ed Elicit. La classifica dipende meno dal brand e più da tre capacità distinte: l'ampiezza della ricerca eseguibile dallo strumento, la possibilità di cambiare modello durante un'attività e quanto strettamente ogni affermazione sia collegata a una fonte.
Fattori chiave che distinguono una piattaforma di ricerca utilizzabile da una finestra di chat con un plugin di ricerca:
✅ Copertura di due corpus — lo stesso workflow deve poter raggiungere il web in tempo reale (notizie, forum, repository, pagine prodotto) e i database accademici, non solo uno dei due. ✅ Flessibilità del modello — la qualità della sintesi cambia quando puoi spostare un'attività da un modello rapido per il recupero a un modello accurato per il ragionamento senza incollare il contesto in un secondo prodotto. ✅ Profondità delle citazioni — il collegamento a livello di frase e gli elenchi di fonti esportabili contano più di una prosa fluida, specialmente per manoscritti e due diligence. ✅ Persistenza della sessione — le revisioni della letteratura durano giorni; gli strumenti che dimenticano i criteri di inclusione durante la notte obbligano a ripetere lo screening. ✅ Aderenza onesta al compito — l'estrazione per revisioni sistematiche, la mappatura delle reti citazionali e briefing web rapidi sono attività diverse, e nessun singolo prodotto eccelle in tutte e tre.
Per confrontare questi strumenti senza ridurli a un elenco generico di “AI per la ricerca”, è utile adottare il modello Copertura–Controllo–Citazioni: cosa il sistema può vedere, quanto puoi guidarlo e se una terza parte può verificare l'output.
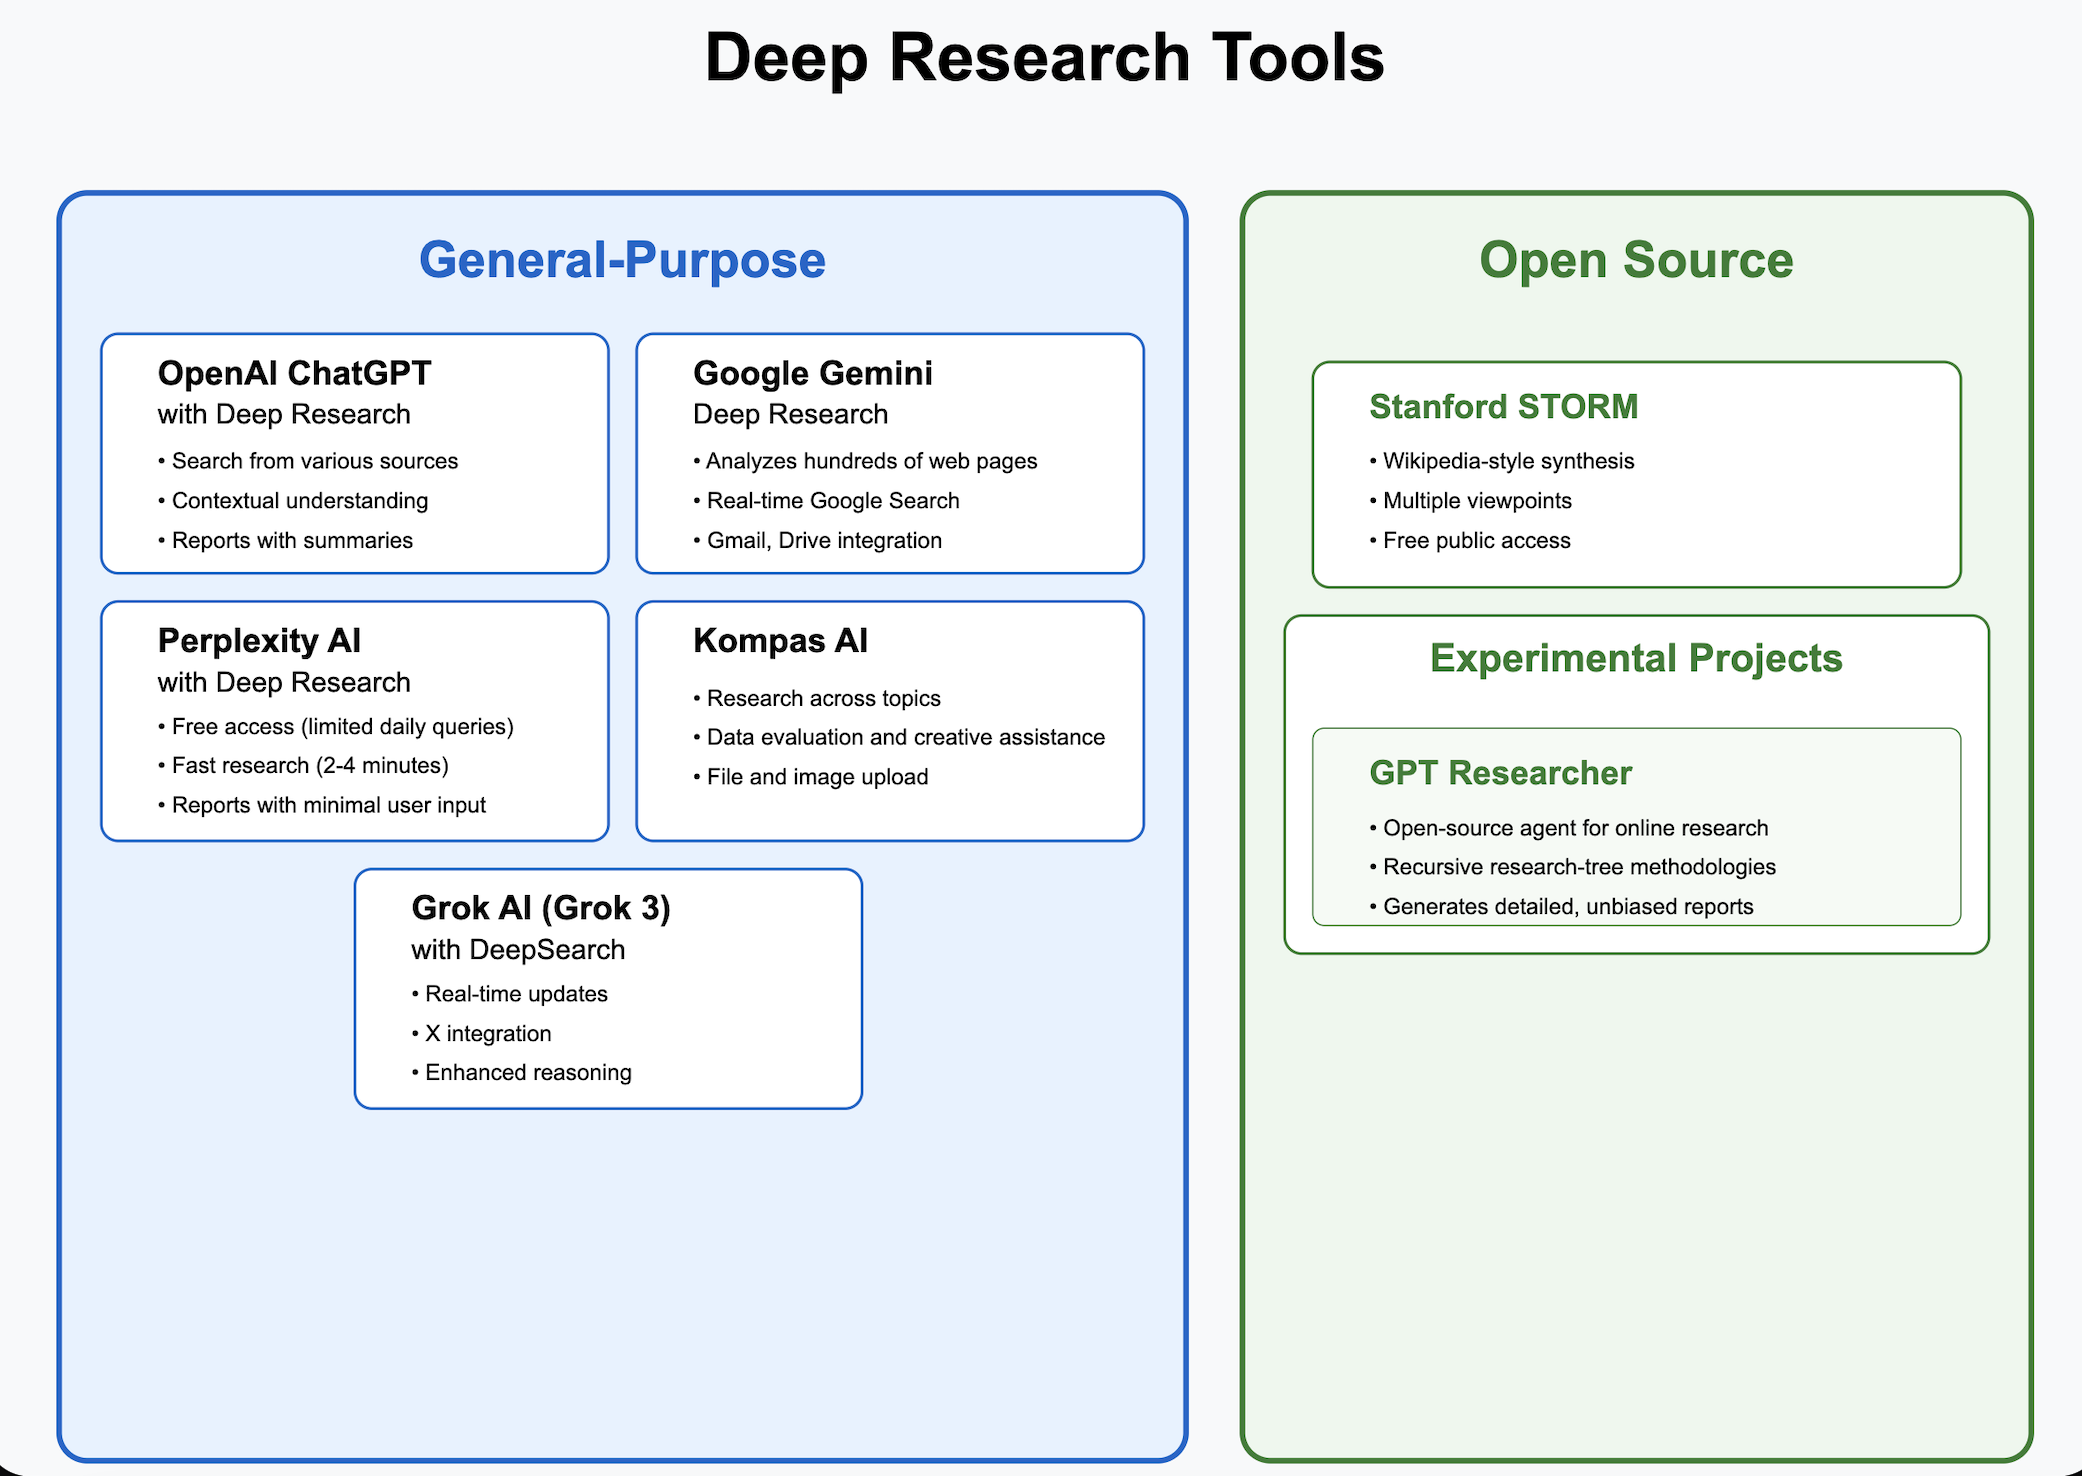
Perché la ricerca web in tempo reale e quella accademica si sono separate in categorie di strumenti AI distinte?
La ricerca sul web in tempo reale e la ricerca accademica si sono separate perché ottimizzano per modalità di errore diverse: gli strumenti web falliscono quando non colgono l'attualità o citano pagine di bassa qualità, mentre quelli accademici falliscono quando trascurano metodi, dimensioni del campione o risultati contraddittori. Questa separazione è ormai una categoria di prodotto, non soltanto un'abitudine degli utenti.
Le modalità di ricerca approfondita generaliste — Perplexity, Gemini e ChatGPT — iterano su decine di ricerche e centinaia di fonti per produrre un briefing in pochi minuti. Assistenti accademici quali Elicit, SciSpace, Semantic Scholar e Litmaps operano invece su grafi di articoli e tabelle di estrazione. La guida alle revisioni della letteratura della Macquarie University considera questi strumenti accademici un workflow distinto: ricerca, mappatura delle citazioni, sintesi ed esportazione per gestori bibliografici.
Il costo pratico della separazione è la perdita di contesto. Un'affermazione trovata su GitHub o Reddit raramente arriva in un manoscritto con la stessa tracciabilità delle citazioni di un'affermazione estratta da una sezione sui metodi. Le recensioni degli strumenti AI per la ricerca accademica nel 2026 descrivono quindi stack, non singole App: scoperta, valutazione delle evidenze, mappatura delle citazioni e scrittura sono fasi separate.
Una piattaforma multi-modello tenta di colmare questa distanza senza fingere che la ricerca web e la revisione sistematica siano lo stesso problema. È particolarmente utile quando la domanda attraversa i corpus — su temi politici, di mercato, clinici o tecnici che richiedono sia articoli primari sia ciò che i professionisti affermano questa settimana.
Cosa dovresti cercare in una piattaforma AI multi-modello per la ricerca?
Dovresti valutare una piattaforma AI per la ricerca in base a copertura, controllo e citazioni, quindi verificare se riesce a mantenere un progetto in memoria abbastanza a lungo da completare la revisione. Gli elenchi di funzionalità che citano soltanto “ricerca” e “sintesi” nascondono le differenze che modificano realmente la qualità dell'output.
Usa questa checklist Copertura–Controllo–Citazioni:
- Copertura: lo strumento cerca nel web aperto in tempo reale, in un indice accademico o in entrambi? Elicit cerca oltre 138 milioni di articoli accademici e 545.000 trial clinici; Semantic Scholar offre accesso gratuito a oltre 200 milioni di articoli. Le modalità native per il web esplorano invece pagine aggiornate in tempo reale.
- Controllo: puoi ispezionare il piano di ricerca, cambiare modello, allegare i tuoi PDF ed escludere domini spazzatura? Gemini Deep Research mostra un piano perfezionabile in più punti e un pannello di ragionamento.
- Citazioni: le affermazioni sono collegate a livello di frase ed esportabili, oppure semplicemente linkate alla fine di una chat? Elicit sottolinea le citazioni a livello di frase; Perplexity riporta una precisione del 93,9% su SimpleQA, un benchmark di fattualità che non equivale alla precisione nell'estrazione accademica.
- Persistenza: il sistema riesce a ricordare criteri di inclusione, articoli rifiutati e query precedenti per più giorni?
- Rapporto costo-profondità: un report web di tre minuti e una revisione sistematica più rapida dell'80% sono proposte di valore diverse, anche se entrambe vengono etichettate come “ricerca approfondita”.
Le componenti rilevanti di Jenova sono Academic Research Assistant, per scoperta della letteratura, preparazione di manoscritti e gestione delle citazioni, e Real-Time Search, per query aggiornate in tempo reale su Google, Reddit, YouTube, GitHub, Amazon e fonti simili. La piattaforma espone anche Google Scholar tramite connessioni di strumenti in stile MCP, un aspetto importante quando una domanda inizia sul web e termina in un articolo.
Cosa Jenova non sostituisce: una griglia di estrazione costruita appositamente su decine di migliaia di punti dati o una rete di citazioni visuale. Questi restano motivi per mantenere Elicit o Litmaps nello stack.
Come si confronta Jenova con Perplexity, ChatGPT e Gemini per la ricerca web in tempo reale?
Per la ricerca web in tempo reale, Perplexity, Gemini Deep Research e ChatGPT Deep Research producono attualmente i briefing autonomi su più pagine più efficaci, mentre Jenova è più forte quando servono ricerca multi-fonte, scelta del modello e un progetto che prosegua tra sessioni diverse. Velocità e qualità estetica del report non coincidono con il controllo del workflow.
Perplexity Deep Research opera per circa 2–4 minuti, iterando con strumenti di ricerca e coding, quindi redige un report esportabile. Nella reportistica di Perplexity, ottiene il 21,1% su Humanity's Last Exam — un risultato superiore a quello di vari modelli di ragionamento confrontati — e completa la maggior parte delle attività in meno di tre minuti. Il limite è la specializzazione: è un motore per briefing, non uno spazio di lavoro accademico multi-agente, e una prova pratica di TechRadar lo ha ritenuto meno completo della modalità di ricerca di ChatGPT per alcune attività.
Gemini Deep Research può esplorare fino a centinaia di siti web e, facoltativamente, Gmail, Drive e Chat. Utilizza un pianificatore a lunga esecuzione, una finestra di contesto di 1 milione di token con recupero ed esecuzioni asincrone che puoi lasciare e riprendere. Un recensore ha rilevato che genera report dettagliati con una velocità superiore di circa il 40% rispetto a ChatGPT. Un altro confronto ha considerato Gemini più forte per volume e presentazione formale, mentre ChatGPT primeggiava nelle domande di chiarimento e, in una precedente recensione sulla ricerca di mercato, nella gestione dei file. Il vincolo di Gemini è il lock-in dell'ecosistema: la migliore versione del prodotto presuppone che tu viva già in Google Workspace.
ChatGPT Deep Research tende a porre migliori domande per delimitare il perimetro prima di iniziare, riducendo l'esplorazione sprecata. Tester indipendenti hanno inoltre sostenuto che il testo prodotto da Gemini può essere troppo generico per un utilizzo immediato. ChatGPT resta un percorso a singolo fornitore: non puoi instradare lo stesso thread di ricerca verso Anthropic o xAI senza uscire dal prodotto.
Real-Time Search di Jenova è progettato come motore multipiattaforma anziché come un unico pulsante “ricerca approfondita”. In molti casi è più lento nel produrre un PDF finito di 10 pagine rispetto a Perplexity o Gemini, e Jenova non ha pubblicato un punteggio su Humanity's Last Exam per una modalità di ricerca dedicata. Il contrappeso è il controllo: puoi mantenere risultati dal web, risultati Scholar e un modello scelto in un unico thread persistente, poi passare lo stesso contesto ad Academic Research Assistant per ripulire le citazioni.
| Funzionalità / Dimensione | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Ricerca web in tempo reale | Motore multipiattaforma (Google, Reddit, YouTube, GitHub, Amazon e altro) | Ricerca web iterativa; centinaia di fonti per esecuzione | Centinaia di siti più dati Workspace facoltativi | Ricerca web con domande di chiarimento | Non è il corpus principale |
| Copertura accademica | Agente per la letteratura più strumenti in stile Scholar | Pagine accademiche che compaiono sul web | Pagine accademiche che compaiono sul web | Pagine accademiche che compaiono sul web | 138M articoli + 545K trial |
| Accesso multi-modello | OpenAI, Anthropic, Google, DeepSeek, xAI e altri | Modelli top nei piani a pagamento | Famiglia di modelli Gemini | Modelli OpenAI | Stack di ricerca di Elicit |
| Stile delle citazioni | Output dell'Agente collegato alle fonti | Report citati; SimpleQA 93,9% | Piano, pannello di ragionamento, report su più pagine | Report narrativi supportati dalla ricerca | Citazioni a livello di frase |
| Persistenza | Cronologia illimitata e memoria tra sessioni | Basata sulle conversazioni | Contesto esteso all'interno dell'esecuzione di ricerca | Memoria delle conversazioni | Libreria, fonti riutilizzabili, avvisi |
| Prezzi (al 2026) | Piano gratuito; Plus $20/mese; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1.000 | Gratuito con Deep Research limitata; Pro $20/mese, $17/mese annuale | Non verificato | Non verificato | Piani a pagamento; fasce esatte Non verificate |
| Ideale per | Progetti misti web + accademia che richiedono scelta del modello | Briefing web rapidi e citati | Report competitivi e tematici basati su Workspace | Approfondimenti guidati da domande e ben delimitati | Revisioni sistematiche e tabelle delle evidenze |
Quali strumenti AI sono più forti per le revisioni della letteratura accademica e l'estrazione delle evidenze?
Elicit è la soluzione più adatta al lavoro sistematico su tabelle delle evidenze; SciSpace è più forte per la lettura esplorativa rapida; Litmaps e Semantic Scholar sono più efficaci per la mappatura e la scoperta gratuita. Una piattaforma multi-modello completa questi strumenti, senza eliminare il loro vantaggio in termini di database.
Secondo quanto riportato dalla piattaforma, Elicit è usato da oltre 5 milioni di ricercatori e può trovare fino a 1.000 articoli e analizzare fino a 20.000 punti dati in un solo passaggio. I ricercatori segnalano risparmi di tempo fino all'80% nelle revisioni sistematiche, soprattutto nello screening e nell'estrazione. È un prodotto diverso da un chatbot che si limita a citare PDF.
Un confronto del 2026 ha rilevato che Elicit è migliore per workflow rigorosi basati sulle evidenze e SciSpace per la scoperta esplorativa rapida. SciSpace compete come copilota AI su una vasta raccolta di articoli, incluso il supporto alla scrittura, utile nelle prime scansioni della letteratura ma un sostituto più debole quando servono colonne di estrazione riproducibili.
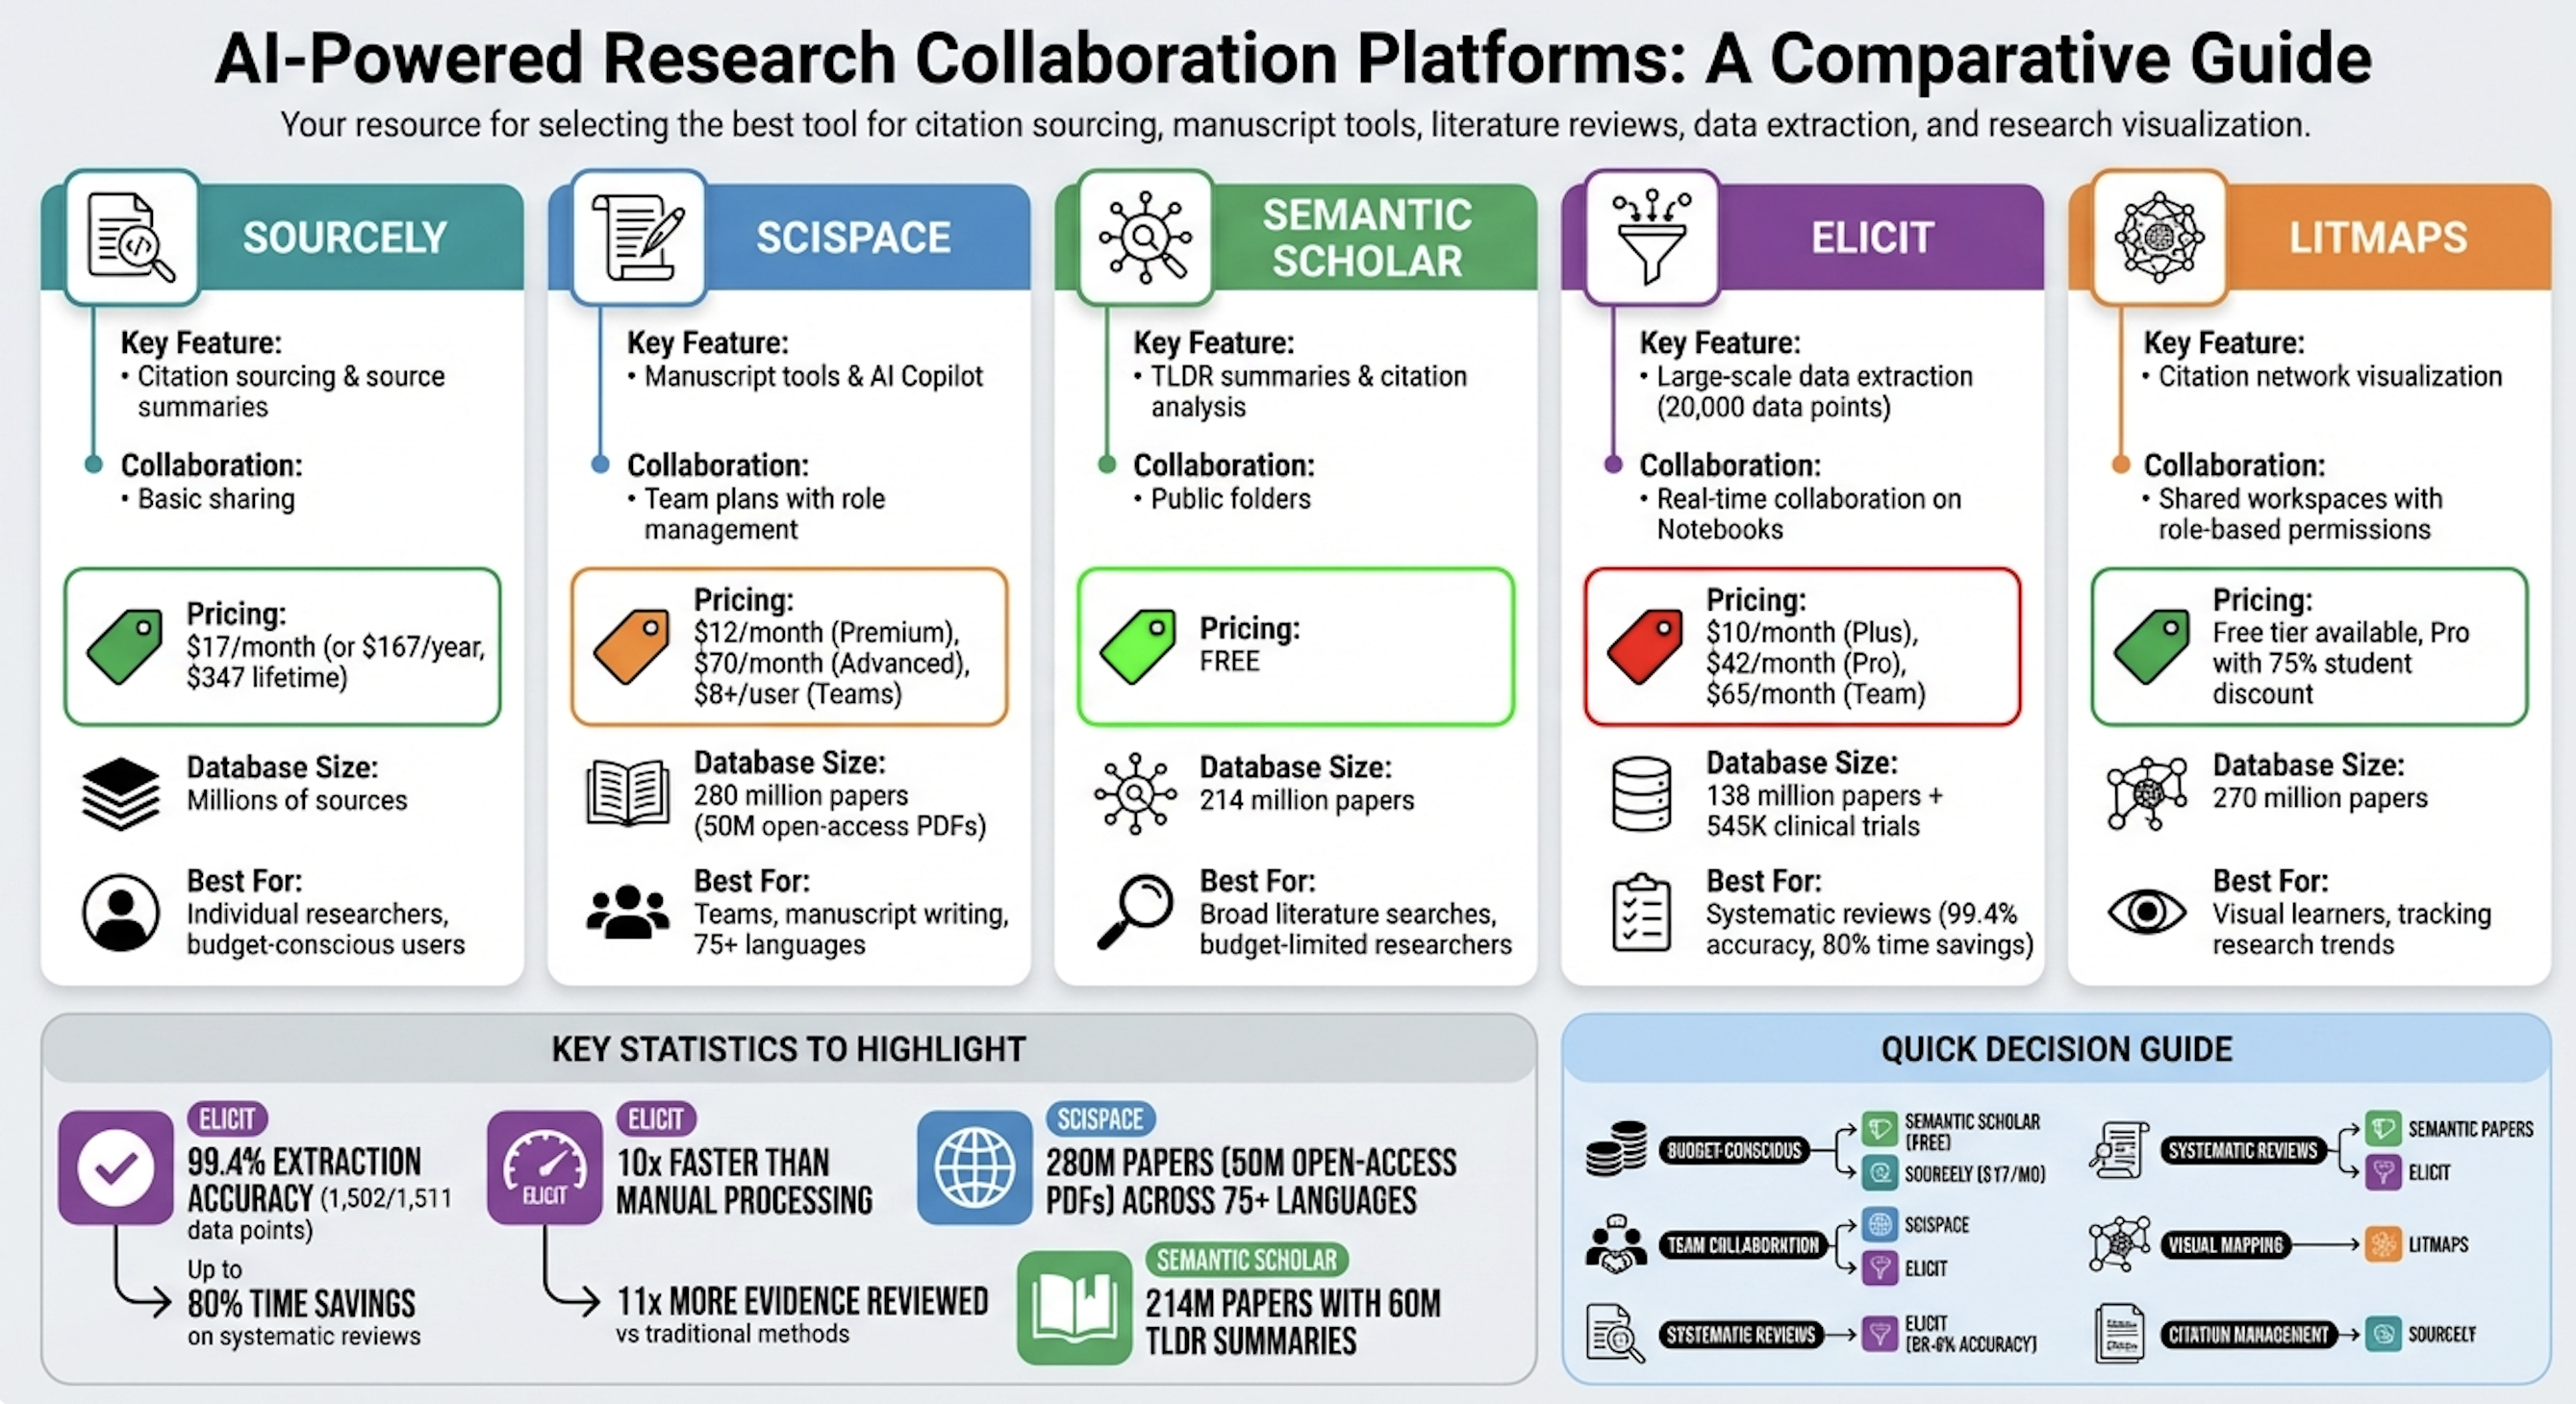
Semantic Scholar rimane l'indice gratuito predefinito per molti di questi prodotti, con più di 200 milioni di articoli e scoperta in stile TLDR. Le guide agli strumenti accademici gratuiti nel 2026 continuano a elencarlo accanto a Perplexity per i ricercatori che non possono pagare ogni fase della pipeline. Litmaps è l'estremo opposto: visualizza le reti di citazioni, permettendoti di vedere cluster e non soltanto risultati classificati — utile quando il rischio è perdere una linea di articoli, non una statistica.
Academic Research Assistant di Jenova è progettato per la scoperta, la preparazione dei manoscritti e la gestione delle citazioni, non per l'estrazione massiva in stile Elicit. In pratica, ciò significa che è più utile quando conosci già la domanda o quando la revisione deve combinare preprint, notizie e attività nei repository. È una scelta meno adatta se il protocollo richiede di sottoporre 2.000 titoli a screening in una tabella in stile PRISMA entro questo pomeriggio.
In che modo cambiare modello durante la ricerca modifica la qualità della sintesi?
Cambiare modello durante la ricerca modifica la qualità della sintesi perché il recupero, la gestione delle cautele e l'assemblaggio di contesti lunghi sono compiti cognitivi diversi, e nessuna singola famiglia di modelli primeggia in tutti e tre. L'accesso multi-modello è quindi un criterio di valutazione, non un espediente di fatturazione.
Un tipico schema di errore è questo: un modello rapido e ancorato al web raccoglie 40 fonti, un modello prolisso scrive una narrazione sicura di sé e un modello prudente avrebbe segnalato che tre di quelle 40 fonti sono blog di fornitori. Se questi passaggi avvengono in tre prodotti diversi, la cautela non incontra mai le fonti.
La differenza pratica di Jenova è che lo stesso thread può passare tra modelli OpenAI, Anthropic, Google, DeepSeek e xAI senza esportare il corpus. Questo è importante per attività miste — per esempio, usare un passaggio intensivo di ricerca per Real-Time Search, poi un modello più conservativo per riscrivere le affermazioni in modo che ognuna conservi una citazione. Gemini Deep Research, per progettazione, rimane all'interno della famiglia Gemini, inclusi i più recenti modelli di classe Gemini 3 per pianificazione e reportistica. Perplexity consente agli utenti Pro di selezionare tra i modelli migliori, ma l'oggetto di ricerca resta un report Perplexity, non uno spazio di lavoro multi-agente durevole con le tue istruzioni.
Il limite dal lato Jenova è altrettanto concreto: l'instradamento tra modelli non crea un motore di estrazione da 138 milioni di articoli. Se il collo di bottiglia consiste nell'“estrarre dati sugli esiti da 400 RCT in una tabella”, Elicit resta lo strumento più appropriato, anche se preferisci un altro modello per la sezione di discussione.
Quando gli Agenti open-source per la ricerca approfondita superano le piattaforme ospitate?
Gli Agenti open-source superano le piattaforme ospitate quando devi controllare il retriever, lavorare su documenti locali o ispezionare ogni crawl, non quando desideri il briefing rifinito più rapido. GPT Researcher è l'esempio più chiaro: un Agente autonomo per la ricerca web e locale che scrive report citati secondo un modello pianificatore/esecutore.
Il progetto è progettato per aggregare oltre 20 fonti, produrre report più lunghi di 2.000 parole e ridurre il bias da fonte singola effettuando lo scraping di molte pagine in parallelo. La sua modalità di ricerca approfondita utilizza un albero ricorsivo di sottoargomenti. Le guide agli Agenti open-source per la ricerca approfondita indirizzano generalmente gli utenti verso GPT Researcher per report flessibili basati su web e documenti e verso Stanford STORM quando l'obiettivo è una sintesi strutturata in stile Wikipedia. Open Deep Research di LangChain adotta la posizione opposta: un ricercatore leggero e configurabile a cui fornisci modelli, strumenti di ricerca e server MCP personali.
Questi punti di forza sono anche la barriera all'adozione. Servono chiavi API, un runtime e la disponibilità a risolvere problemi nei crawler. I prodotti Deep Research ospitati esistono perché la maggior parte degli analisti non gestirà questo stack per un briefing competitivo del martedì.
Jenova si colloca a metà: infrastruttura ospitata con strumenti MCP e istruzioni personalizzate, senza il determinismo completamente self-hosted di GPT Researcher. I team che richiedono ricerca documentale air-gapped non dovrebbero considerare alcuna piattaforma ospitata come un sostituto diretto.
Come si esegue un singolo progetto di ricerca tra fonti web e articoli accademici?
Un progetto misto si esegue separando corpus, affermazioni e bozza in tre passaggi — ricognizione web, conferma accademica, poi sintesi con controlli espliciti sulle citazioni — invece di chiedere a un unico strumento di “ricercare tutto”. La stessa sequenza funziona su Jenova, Perplexity ed Elicit; cambiano soltanto gli oggetti su cui fai clic.
Una sequenza durevole:
- Definisci la domanda in una frase, includendo date, popolazione e ciò che falsificherebbe l'affermazione.
- Raccogli il contesto attuale (notizie, repository, forum di professionisti) prima di fissare i termini della query accademica.
- Conferma con gli articoli, estraendo metodi e dimensioni del campione, non soltanto gli abstract.
- Riconcilia le contraddizioni in un terzo passaggio con un modello più conservativo o una tabella delle evidenze dedicata.
- Esporta le citazioni nello strumento per manoscritti di cui ti fidi già.
Su Jenova, inizia con Real-Time Search per il livello in tempo reale:
“Cosa stanno dicendo ingegneri e clinici negli ultimi 90 giorni sui tassi di allucinazione nella generazione di referti radiologici? Dai priorità a issue di GitHub, interventi a conferenze e notizie, ed elenca le fonti.”
Poi sposta gli stessi vincoli in Academic Research Assistant:
“Usando i temi sopra indicati, trova valutazioni sottoposte a peer review dal 2024 al 2026. Per ogni articolo, estrai dataset, modalità, tasso di errore riportato e limitazioni. Segnala tutto ciò che compare soltanto negli abstract.”
Su Perplexity, seleziona Deep Research e richiedi un briefing con fonti datate; il prodotto è costruito per cercare, leggere e scrivere un report in pochi minuti. Su Elicit, incolla la domanda di ricerca e genera un report o una tabella di estrazione sul corpus di articoli, quindi personalizza quali articoli includere: è il workflow che Elicit documenta per la ricerca ad alta criticità.
Il controllo di qualità che la maggior parte delle persone salta: ogni statistica proveniente solo dal web che resta nella bozza deve essere sostituita da un articolo o etichettata come non sottoposta a peer review. Le piattaforme che mantengono entrambi i corpus in un'unica memoria rendono questo controllo meno oneroso. Non lo rendono facoltativo.
Cosa affermano i team che gestiscono infrastrutture di ricerca sulle piattaforme di ricerca multi-modello?
I team che si occupano di infrastrutture per la ricerca considerano sempre più la “ricerca approfondita” un problema di orchestrazione — retriever, modelli, memoria e policy sulle citazioni — anziché un'unica modalità magica. I team che ottengono output affidabili assegnano gli strumenti alle modalità di errore invece di cercare un unico vincitore.
"Il costo nascosto nel 2026 non è generare una prima bozza. È portare un'affermazione trovata sul web in tempo reale dentro un manoscritto senza eliminare la fonte, la data e il conflitto di interessi. Quando questi campi risiedono in tre prodotti, non sopravvivono all'incollaggio."
"L'accesso multi-modello ripaga soltanto se il corpus rimane fermo. Passare da un modello di recupero a un editor conservativo è utile; cambiare prodotto e perdere l'elenco dei documenti rifiutati non lo è. Ecco perché memoria persistente e connessioni degli strumenti contano più di altre duecento parole di fluidità."
"Continuiamo a indirizzare chi svolge revisioni sistematiche verso estrattori progettati appositamente. Se servono decisioni di screening su centinaia di trial, una piattaforma di ricerca generalista dovrebbe affiancare Elicit, non fingere di esserlo. Lo stack consigliato è volutamente misto."
— Team di prodotto Jenova, progettazione di workflow di ricerca AI, sviluppo di Agenti multi-modello usati da team in oltre 70 paesi
Questa visione corrisponde al modo in cui le guide universitarie presentano ora il mercato: strumenti accademici affiancati per ricerca, mappatura e sintesi, più una categoria separata di modalità di ricerca approfondita native per il web. La domanda relativa alla piattaforma è quale livello desideri standardizzare.
Quali compromessi dovresti aspettarti dagli strumenti AI per la ricerca nel 2026?
Dovresti aspettarti che ogni opzione seria sia incompleta almeno su un corpus, una forma di controllo o uno standard di citazione — e scegliere in base a queste lacune, anziché alle categorie di marketing. I compromessi sono ormai abbastanza stabili da poter pianificare attorno a essi.
La ricerca approfondita nativa per il web (Perplexity, Gemini, ChatGPT) continuerà a vincere sul tempo necessario per ottenere un briefing. Il principio progettuale di Perplexity è comprimere ore di lavoro di esperti in minuti. Gemini continuerà a vincere dove le evidenze sono già in Workspace. ChatGPT continuerà a vincere quando la domanda di ricerca è poco definita e richiede prima un'interrogazione.
Gli specialisti accademici continueranno a vincere sulle evidenze strutturate. La scala di estrazione di Elicit e i risparmi di tempo nelle revisioni sistematiche non sono funzionalità che una piattaforma di chat generalista possa simulare. Litmaps continuerà a vincere quando la domanda è “quale cluster mi manca?”. Gli Agenti open-source continueranno a vincere quando il requisito è costituito da documenti locali, retriever personalizzati o crawl ispezionabili.
Il compromesso di Jenova è l'inverso. È tra le opzioni più complete quando la stessa persona deve cercare nel web in tempo reale, recuperare contesto accademico, mantenere memoria tra sessioni e cambiare modelli senza ricostruire il briefing. È un sostituto più debole per l'estrazione massiva di RCT, le visualizzazioni delle reti di citazioni e le esecuzioni Deep Research completamente autonome su più pagine con punteggi di fattualità pubblicati.
Se i prossimi 30 giorni prevedono domande miste — un articolo, un mercato, un thread GitHub e una bozza — una piattaforma di ricerca multi-modello è la scelta razionale predefinita. Se i prossimi 30 giorni prevedono un protocollo, un registro di screening e una figura PRISMA, inizia con Elicit e aggiungi strumenti web solo dove il protocollo ammette fonti non provenienti da riviste.
Riferimenti
- Perplexity — Introduzione a Perplexity Deep Research
- Google Gemini — Panoramica di Deep Research
- Elicit — AI per la ricerca scientifica
- Biblioteca della Macquarie University — Uso di strumenti AI per le revisioni della letteratura
- Thesify — Migliori strumenti AI per la ricerca accademica nel 2026
- Cypris AI — 11 migliori strumenti AI per la revisione della letteratura scientifica nel 2026
- TechRadar — Prova pratica di Perplexity Deep Research rispetto a ChatGPT
- Android Authority — Velocità e qualità di Gemini vs ChatGPT Deep Research
- LivePlan — Confronto tra ChatGPT e Gemini Deep Research
- Cascade Insights — Recensione per ricercatori di mercato di ChatGPT vs Gemini Deep Research
- Section AI — Test della qualità dell'output di ChatGPT vs Gemini Deep Research
- Perplexity Pro — Prezzi e dettagli dei piani
- Paperguide — Confronto Elicit vs SciSpace (2026)
- SciSpace — Confronto con l'alternativa Elicit
- Swiss School of Business Research — Strumenti AI gratuiti per la ricerca accademica nel 2026
- Litmaps — Assistente per la revisione della letteratura
- GPT Researcher — Agente autonomo open-source per la ricerca (GitHub)
- Gatsbi — Migliori Agenti AI open-source per la ricerca nel 2026
- LangChain — Open Deep Research