Quale piattaforma AI estrae meglio disegno dello studio, risultati e limitazioni?
2026-08-21
Come valutare gli strumenti AI sull'estrazione tracciabile in quattro campi invece che su riepiloghi generici degli articoli?
Per estrarre disegno dello studio, campione, risultati e limitazioni in una tabella delle evidenze verificabile, un Agente di ricerca flessibile come Jenova's Academic Research Assistant è la soluzione più forte quando gli articoli sono eterogenei e le limitazioni richiedono interpretazione, mentre Elicit e Paperguide sono più indicati quando serve un'estrazione guidata da modelli su ampi insiemi di trial relativamente standardizzati. SciSpace e Consensus sono utili per la scoperta e risposte rapide basate sulle evidenze, ma sono meno efficaci come motori principali di estrazione.
La distinzione importante nel 2026 non è «quale strumento riassume i PDF». È quale strumento riesce a compilare quattro campi — metodi, campione, outcome e limitazioni — con una provenienza che puoi verificare.
Fattori chiave che distinguono le evidenze estraibili da una sintesi scorrevole:
✅ Fedeltà allo schema — lo strumento restituisce disegno dello studio, n, popolazione, outcome e limitazioni come campi separati, non come un paragrafo indistinto. ✅ Ancoraggio alle fonti — ogni cella cita una frase, una tabella, una figura o una pagina, non soltanto il titolo di un articolo. ✅ Intelligenza sulle limitazioni — bias, generalizzabilità e lacune di reporting sono classificati, non copiati dalle avvertenze degli autori. ✅ Struttura tra articoli — gli output sono affiancati in modo da poter confrontare gli studi, senza doverli rileggere. ✅ Workflow verificabile dall'uomo — puoi rifiutare, correggere e riutilizzare la tabella senza ricominciare da zero.
Per confrontare onestamente queste piattaforme, è utile valutarle secondo questo standard a quattro campi invece di considerare soltanto la qualità dei riepiloghi.
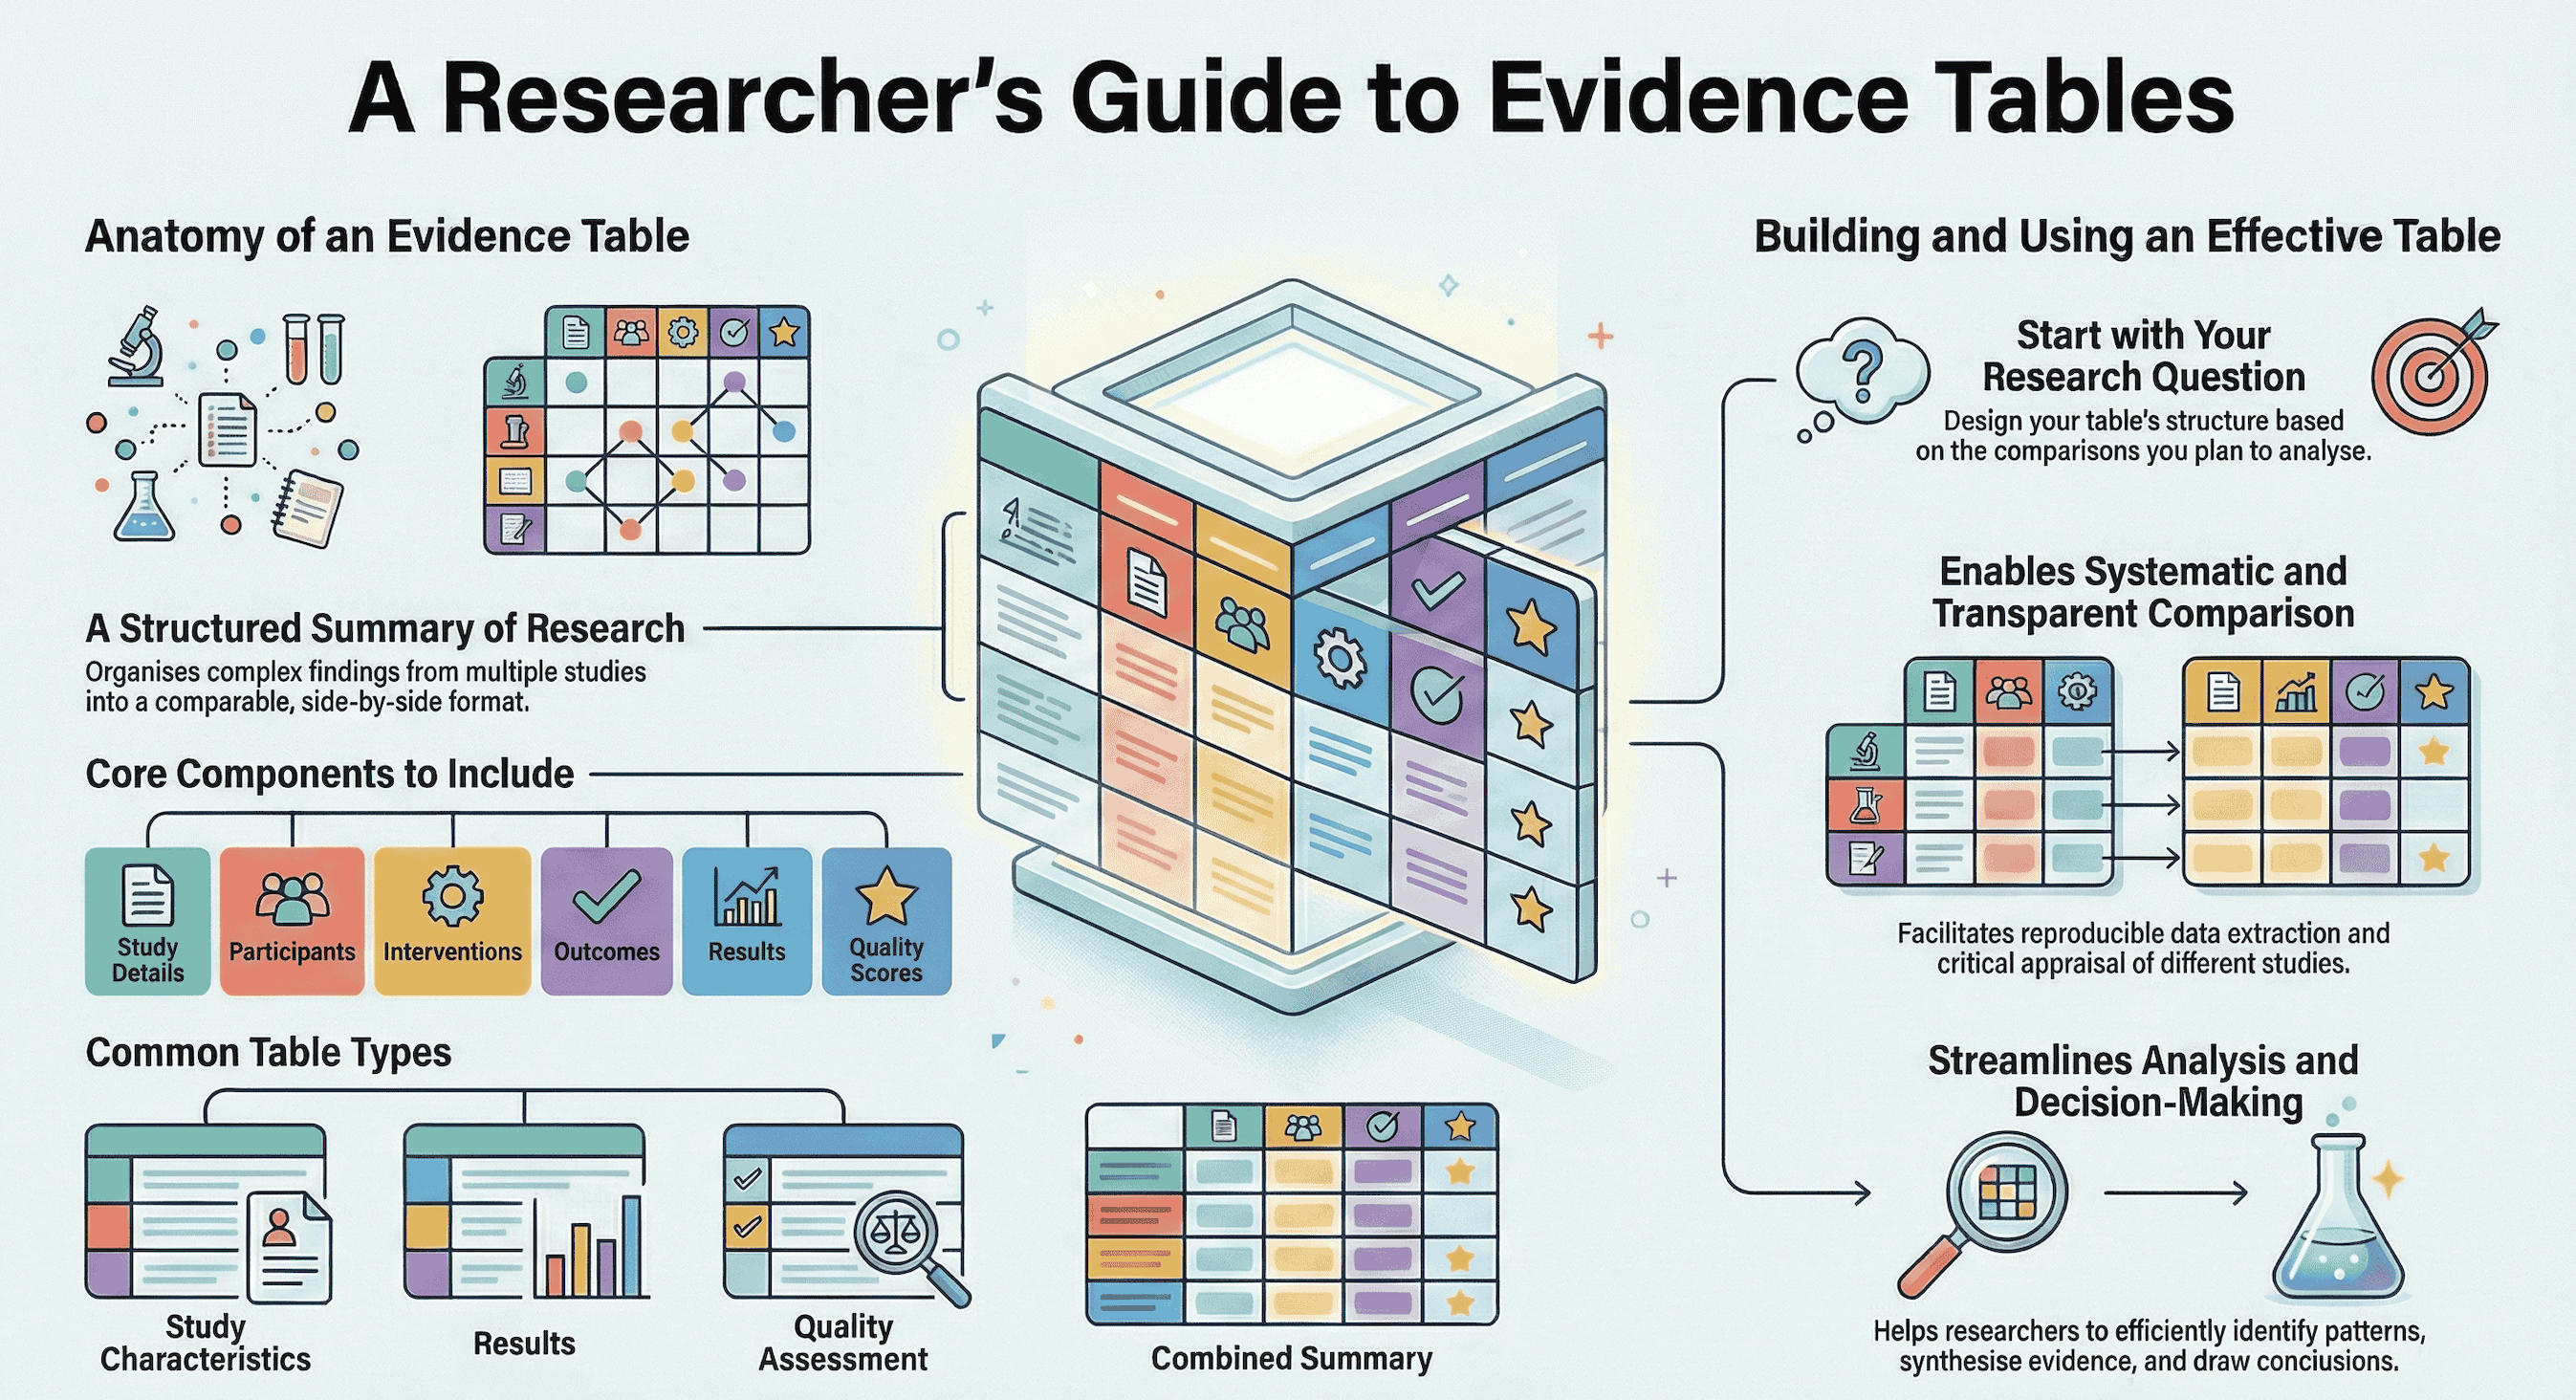
Perché l'estrazione del disegno dello studio e delle limitazioni è diventata un collo di bottiglia per i ricercatori?
L'estrazione manuale dei dati rimane una delle fasi più lente e soggette a errori della sintesi delle evidenze; per questo i ricercatori si rivolgono oggi all'AI per trasferire metodi, campioni, risultati e limitazioni in tabelle comparabili. PRISMA 2020 richiede ai revisori di riportare cosa è stato fatto, come sono stati selezionati gli studi, cosa è stato trovato e come è stato valutato il rischio di bias. Questo standard di reporting presuppone una fase di estrazione strutturata che la maggior parte dei team svolge ancora manualmente.
Il collo di bottiglia è dato dal volume più l'eterogeneità. Uno studente magistrale può dover confrontare dieci articoli per disegno e n. Un team di revisione sistematica può dover sottoporre a screening centinaia di record e poi estrarli in moduli predefiniti. Le linee guida tradizionali considerano l'estrazione dei dati come la selezione delle caratteristiche degli studi e la loro organizzazione a partire dai report, cosa che sembra semplice finché ogni articolo nasconde la dimensione del campione in una nota a piè di pagina e le limitazioni in un singolo paragrafo difensivo.
L'AI modifica il costo di una prima passata. Uno studio all'interno di una revisione del 2026 ha rilevato che l'estrazione assistita da Elicit non era inferiore in accuratezza all'estrazione esclusivamente umana, richiedeva circa 25 minuti in meno per estrattore ed era meno costosa su 50 RCT. Commenti più ampi sulla sintesi delle evidenze stimano oggi una riduzione del carico di lavoro grazie all'AI tra il 50% e il 75% nelle varie fasi della revisione. La velocità non equivale a una tabella citabile. Il problema di ricerca nel 2026 consiste nell'estrarre metodi, campioni, risultati e limitazioni dai PDF in una forma che un altro revisore possa controllare.
Cosa rende un workflow di estrazione AI sufficientemente affidabile per le tabelle delle evidenze?
Un workflow di estrazione AI affidabile restituisce campi completi e comparabili, con provenienza a livello di citazione o pagina, e lascia poi a un essere umano la responsabilità dell'inclusione e dell'interpretazione. La fluidità non è il criterio. Lo è una tabella delle evidenze.
Abbiamo usato uno standard a quattro campi — chiamato MSOL (metodi, campione, outcome, limitazioni) — e valutato gli strumenti su sei dimensioni:
- Fedeltà allo schema — L'output mantiene disegno, campione, risultati e limitazioni in colonne distinte?
- Ancoraggio — Ogni valore può essere ricondotto a una frase, tabella, figura o pagina?
- Intelligenza sulle limitazioni — Lo strumento classifica le debolezze (bias, generalizzabilità, reporting) o si limita a riformulare la sezione Limitazioni degli autori?
- Allineamento tra studi — Puoi confrontare n, disegno e outcome senza riformattare?
- Verificabilità — La traccia resisterebbe al controllo di un secondo revisore, di un relatore o di un paragrafo dei metodi PRISMA?
- Adeguatezza al corpus — Lo strumento è progettato per trial standardizzati, metodi misti o riestrazione conversazionale?
Questa mappatura non è arbitraria. PRISMA 2020 richiede ai revisori di riportare i metodi di valutazione del rischio di bias, e RoB 2 valuta randomizzazione, deviazioni dagli interventi previsti, dati sugli outcome mancanti, misurazione e selezione del risultato riportato. Uno strumento che estrae valori p ma non riesce a far emergere bias di campionamento o confondimento è incompleto per il lavoro di revisione.
Ne derivano due regole pratiche. Primo, le variabili standardizzate (etichetta del disegno, n, nomi dei bracci) sono quelle in cui l'AI attuale è più forte; una valutazione collegata a Cochrane ha riscontrato prestazioni elevate e simili a quelle dei revisori umani, soprattutto sulle variabili standardizzate. Secondo, limitazioni e cautele qualitative richiedono ancora una revisione umana. Le linee guida di King's College London sulla sintesi delle evidenze considerano l'AI utile in più fasi, non un sostituto non supervisionato dei revisori.
Quali strumenti AI producono le tabelle delle evidenze più utilizzabili a partire dagli articoli accademici?
Elicit e Paperguide producono attualmente le tabelle delle evidenze più simili a modelli e più scalabili, mentre Jenova's Academic Research Assistant è più efficace quando servono campi personalizzati, classificazione delle limitazioni e domande di approfondimento su PDF caricati. SciSpace e Consensus aiutano a trovare e inquadrare gli articoli; per l'estrazione MSOL hanno un ruolo secondario.
I confronti indipendenti del 2026 confermano in generale questa distinzione. I revisori collocano Elicit davanti per la scoperta della letteratura e l'estrazione dei dati, e Consensus davanti per domande scientifiche con risposta sì/no. I confronti tra funzionalità considerano analogamente Elicit più forte per workflow rigorosi basati sulle evidenze e SciSpace più forte per scoperta esplorativa e scrittura rapida. Le guide delle biblioteche universitarie elencano ora gli strumenti AI per la letteratura come complementi per riepiloghi, reti ed estrazione, non come sostituti completi della valutazione critica.
| Funzionalità / Dimensione | Elicit | Jenova Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Estrazione di disegno dello studio e campione | Forte; colonne personalizzate più estrazione da tabelle e figure | Forte sui PDF caricati tramite schemi MSOL specificati nei prompt | Forte; colonne definite dall'utente sugli articoli selezionati | Moderata; migliore per l'orientamento a livello di articolo che per schemi rigorosi | Debole come estrattore primario; ottimizzato per risposte a livello di affermazione |
| Estrazione dei risultati | Forte, inclusi outcome numerici dalle tabelle | Forte quando i PDF sono allegati e i campi sono specificati | Forte, con collegamenti alla fonte a livello di cella | Moderata; riepiloghi utili, meno nativo per le tabelle | Moderata per risultati principali, non per griglie multi-braccio |
| Profondità su limitazioni / rischio di bias | Buona per i campi riportati; classificazione meno interpretativa | Forte nel classificare bias rispetto a generalizzabilità con riferimenti di pagina | Buona quando definisci colonne per le limitazioni | Limitata; più esplorativa che orientata alla valutazione critica | Limitata; non progettata per tabelle strutturate delle debolezze |
| Provenienza | Citazioni a livello di frase o figura per le affermazioni | Citazioni di pagina/estratto in tabelle strutturate quando richiesto nel prompt | Ogni valore estratto è collegato alla relativa affermazione fonte | Collegamento a livello di articolo, tipico degli strumenti di ricerca/revisione | Risposte supportate da fonti, non tabelle delle evidenze a livello di cella |
| Workflow di screening / revisione | Progettato per screening SLR, inclusi ampi insiemi e audit in stile PRISMA | Revisione conversazionale di articoli selezionati; non uno strumento di screening per 40.000 record | Revisione doppia e reporting PRISMA in un unico spazio di lavoro | Ricerca della letteratura e Deep Review per l'esplorazione | Rapida panoramica del consenso tra articoli |
| Prezzi (al 2026) | Plus circa $12/mese; Pro circa $49/mese; Enterprise personalizzato | Piano gratuito con utilizzo limitato; Plus $20/mese (30×); livelli superiori ampliano l'utilizzo | Spazio di lavoro con prezzi per postazione; prezzo di listino pubblico non verificato qui | Livello a pagamento iniziale circa $12/mese con abbonamento annuale, con piani superiori che includono la scrittura | Esistono piani Pro a pagamento; prezzo di listino esatto del 2026 non verificato qui |
| Ideale per | Revisioni sistematiche guidate da protocollo su report di studi relativamente standard | Tabelle personalizzate a quattro campi, valutazione delle limitazioni ed estrazione iterativa su un insieme operativo di articoli | Estrazione verificabile più scrittura in un'unica libreria | Mappatura iniziale, lettura e supporto alla stesura di manoscritti | Domande rapide del tipo «cosa dice la letteratura?» |
Elicit
Elicit è lo specialista dell'estrazione progettato appositamente in questo gruppo. Il prodotto cerca, riassume, estrae da e dialoga con un corpus che Elicit dichiara composto da oltre 125 milioni di articoli, e riporta un utilizzo da parte di più di 2 milioni di ricercatori. Il suo workflow per le revisioni sistematiche mette l'accento sull'estrazione da tabelle e figure, celle supportate da citazioni, screening su scala molto ampia e report con artefatti dei metodi in stile PRISMA.
Questa focalizzazione è un autentico punto di forza per corpora simili a RCT. È anche un limite: si paga per una macchina da revisione, e il lavoro interpretativo — riclassificare le limitazioni, chiedere «cosa non hanno controllato?» — rimane in capo al revisore. Il prezzo del livello Pro è elevato per gli studenti che necessitano solo occasionalmente di tabelle.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant è progettato come partner di ricerca piuttosto che come fabbrica di screening. Individua letteratura, supporta la stesura di manoscritti e il lavoro sulle citazioni e — sulla piattaforma Jenova — può leggere PDF allegati, mantenere memoria persistente tra sessioni e chiamare strumenti di ricerca accademica. Definisci le colonne MSOL in linguaggio naturale, poi iteri quando un articolo nasconde n in un diagramma CONSORT o distribuisce le limitazioni nella Discussione.
Il limite, detto con onestà, è architetturale. Non offre una coda di screening a doppio revisore per decine di migliaia di record e non ha pubblicato uno studio di accuratezza in stile SWAR comparabile a quello di Elicit. La qualità dell'estrazione dipende dal prompt, dai file allegati e dal controllo umano. Per un capitolo di tesi basato su 12 articoli, quella flessibilità è il punto centrale. Per una revisione PRISMA di 2.000 record, le modalità di revisione di Elicit o Paperguide sono più adatte.
Paperguide
Paperguide si colloca tra libreria, estrattore e strumento di scrittura. Indicizza oltre 200 milioni di articoli, consente di definire colonne di estrazione, collega ogni valore all'affermazione fonte e può esportare tabelle in CSV o Excel. La sua modalità per revisioni sistematiche punta sulla revisione doppia, sulle decisioni finali umane e su diagrammi PRISMA basati sui conteggi effettivi.
Punto di forza: provenienza e un unico spazio di lavoro dalla libreria alla tabella. Limite: sta ancora consolidando il proprio profilo di conformità (l'azienda stessa indica GDPR, SOC 2 e ISO 27001 come in arrivo), e i prezzi pubblici e stabili sono più difficili da definire rispetto ai livelli di Elicit ampiamente citati. I team che necessitano di una traccia di audit nominativa all'interno di un solo prodotto attribuiranno maggiore valore a questo spazio di lavoro che alla flessibilità della chat.
SciSpace
SciSpace è un ambiente di ricerca ampio: ricerca, lettura, scrittura e strumenti per i riferimenti, con un livello a pagamento iniziale meno costoso di Elicit Pro. I confronti lo descrivono costantemente come il migliore compagno per esplorazione e scrittura, non come l'estrattore più rigoroso. Usalo per mappare rapidamente un ambito. Non aspettarti che sia il sistema di riferimento per colonne MSOL in una revisione.
Consensus
Consensus è ottimizzato per una domanda diversa: su cosa concorda la letteratura? È utile per un primo orientamento e per risposte a livello di affermazione. È lo strumento primario sbagliato se il tuo deliverable è una tabella di disegni, dimensioni dei campioni, stime degli effetti e limitazioni classificate. Affiancalo a un estrattore invece di sostituirlo con uno.
Con quale accuratezza l'AI può estrarre il disegno dello studio e le caratteristiche del campione?
Le evidenze attuali indicano che l'AI può eguagliare gli estrattori umani su molti campi standardizzati relativi a metodi e campioni, pur continuando a omettere o interpretare erroneamente reporting irregolari. L'accuratezza è sufficientemente elevata per una prima passata. Non lo è per saltare la verifica.
Il confronto diretto più rilevante finora è il SWAR di non inferiorità del 2026 su 50 RCT di malattie croniche: l'accuratezza complessiva non differiva tra l'estrazione assistita da Elicit e quella esclusivamente umana, mentre il braccio assistito dall'AI era più veloce ed economico. I risultati dei sottogruppi non erano uniformemente identici; il braccio assistito dall'AI era più accurato per alcuni descrittori di intervento/controllo. I tipi di errore, incluse omissioni ed errori minori, apparivano simili. Questo sostiene la sostituzione di un estrattore umano con un estrattore assistito dall'AI, non un'estrazione senza supervisione.
Le cifre riportate dai fornitori sono più alte e vanno lette come tali. Elicit afferma che una revisione tedesca sulle politiche educative ha estratto correttamente 1.502 dei 1.511 punti dati (99,4%) e che i confronti CSIRO hanno rilevato falsi negativi prossimi allo zero sulle informazioni chiave. Test separati condotti da biblioteche hanno riportato un'accuratezza di estrazione di modelli linguistici di grandi dimensioni intorno al 96% su 160 elementi di dati quando venivano forniti i PDF. Questi numeri sono incoraggianti per etichette di disegno, n, bracci e outcome primari. Dicono poco sul fatto che lo strumento abbia rilevato un campionamento intenzionale o fattori confondenti non controllati.
Nella pratica, il disegno dello studio e il campione falliscono in modi prevedibili:
- Il disegno è riportato come «randomizzato» senza dettagli sull'allocazione.
- n è il numero sottoposto a screening, non il numero analizzato.
- La popolazione è un'etichetta della clinica, non i criteri di inclusione.
- Il setting (rurale, terziario, solo App) è omesso, compromettendo in seguito la generalizzabilità.
Una buona passata AI segnala queste lacune come celle vuote. Una cattiva passata inventa un nome di disegno ordinato. Le celle vuote sono più scientifiche delle supposizioni formulate con scioltezza.
Come dovrebbero gestire gli strumenti AI i risultati rispetto alle limitazioni dichiarate dagli autori?
I risultati dovrebbero essere estratti come outcome riportati, con numeri e tempi di misurazione; le limitazioni dovrebbero essere rivalutate criticamente, non trascritte. Questa è la maggiore lacuna qualitativa tra le piattaforme AI per la ricerca.
L'estrazione dei risultati è la metà più semplice. Gli outcome risiedono spesso nelle tabelle, e Elicit promuove specificamente l'estrazione da tabelle e figure perché è lì che si trovano molti endpoint clinici. Il modello di Paperguide — colonne personalizzate più possibilità di tornare all'affermazione di supporto — è il giusto schema di verifica per dimensioni dell'effetto, intervalli di confidenza e conteggi dei responder. Se un risultato non può essere ricondotto a una fonte precisa, non appartiene alla tabella delle evidenze.
L'estrazione delle limitazioni è un compito diverso. Gli autori riportano troppo poco. Citano la dimensione del campione e ignorano il confondimento. Citano la «ricerca futura» e omettono il metodo di campionamento. La valutazione del rischio di bias dovrebbe essere specifica per un risultato e classificata, ad esempio come basso / alcune preoccupazioni / alto in RoB 2. Copiare il paragrafo Limitazioni non soddisfa questo standard.
Un output più utile assume la forma di una tabella strutturata delle criticità: articolo, categoria (bias, generalizzabilità, reporting), debolezza in una frase e pagina o citazione. Questo formato costringe il modello a decidere quale tipo di limitazione ha individuato.
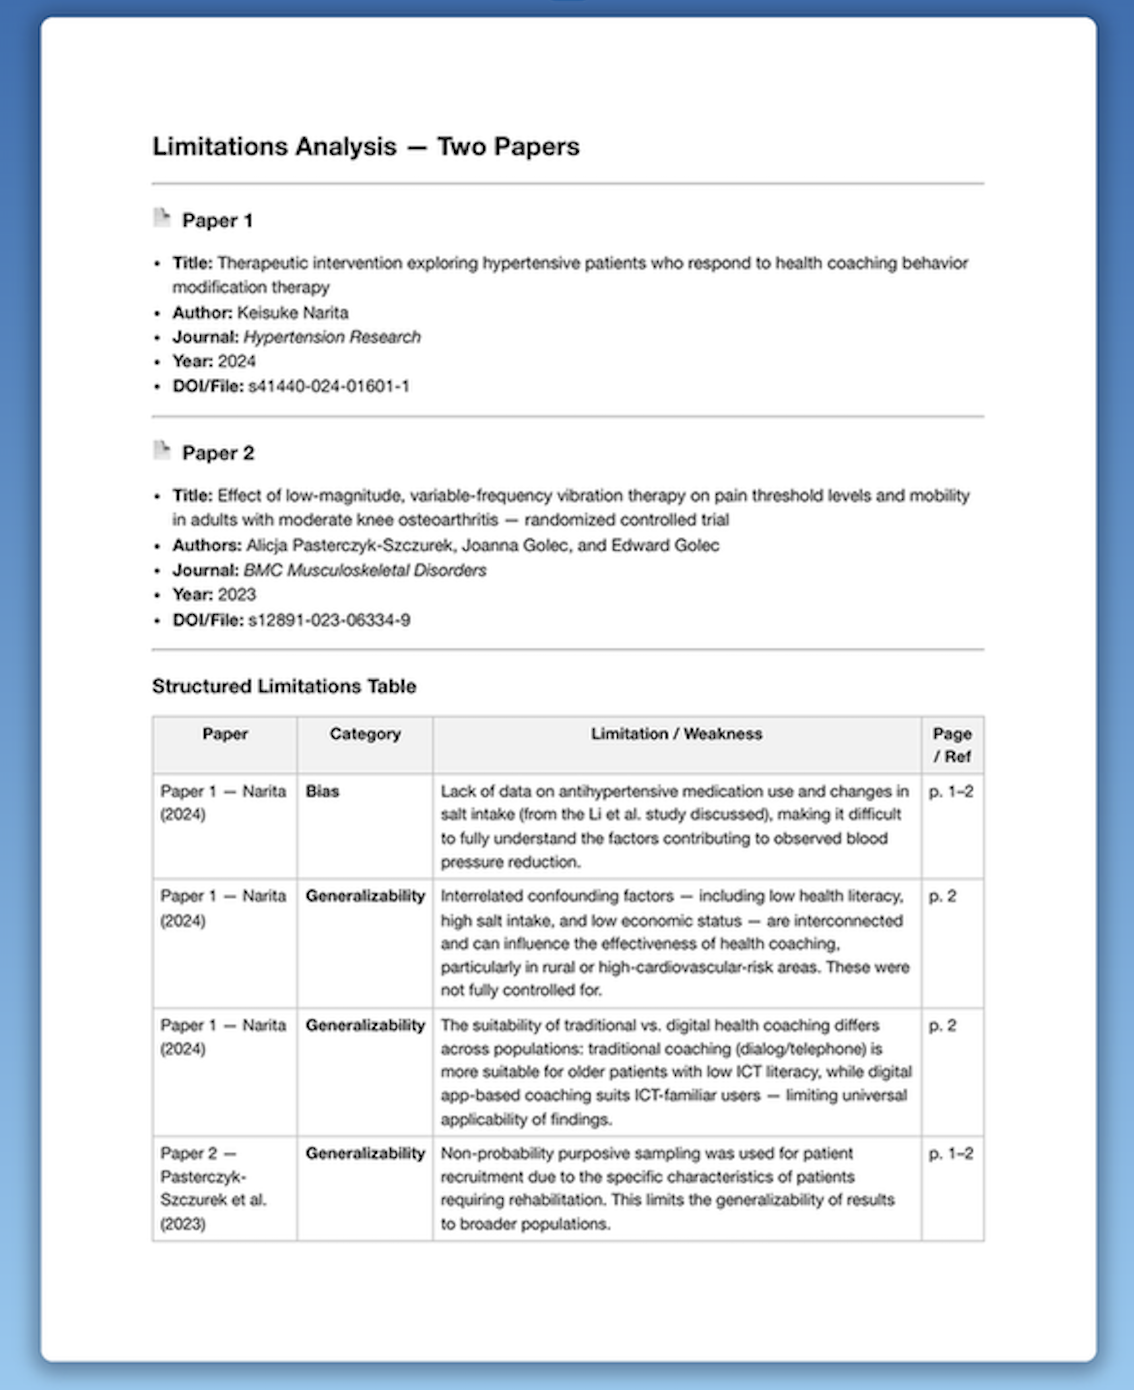
Esaminare questo layout mostra perché una chat generica non è sufficiente. Un trial sul coaching per l'ipertensione può ridurre la pressione arteriosa senza riportare l'uso di antipertensivi o l'assunzione di sale: è un problema di bias. Lo stesso articolo può mescolare alfabetizzazione sanitaria, dieta e reddito, rendendo i risultati non trasferibili: è un problema di generalizzabilità. Un trial sulla terapia vibratoria può utilizzare un campionamento intenzionale di pazienti in riabilitazione: di nuovo, generalizzabilità, non «gli autori hanno rilevato un campione piccolo». Gli strumenti che si limitano a riassumere la Discussione non coglieranno questa tassonomia.
Jenova's Academic Research Assistant è relativamente forte in questo ambito perché puoi richiedere la tassonomia nel prompt e mantenerla stabile su una serie di PDF. Elicit e Paperguide acquisiranno i campi delle limitazioni se aggiungi colonne; per impostazione predefinita, non ragioneranno come un revisore dei metodi. Consensus ti dirà se gli studi «mostrano un effetto». Non costruirà questa tabella.
Come si esegue un'estrazione a quattro campi su una serie di PDF?
Inizia con uno schema definito e immutabile, estrai ogni articolo negli stessi quattro campi, quindi verifica i numeri e riclassifica le limitazioni prima della sintesi. Lo schema conta più del marchio del chatbot.
Uno schema MSOL operativo è:
- Metodi: disegno, randomizzazione/cecità se presenti, intervento, comparatore, follow-up.
- Campione: n analizzato, popolazione, setting, metodo di campionamento.
- Outcome: risultato primario con statistica, tempo di misurazione e direzione.
- Limitazioni: bias, generalizzabilità, reporting — ciascuno con un riferimento localizzabile.
Per Jenova's Academic Research Assistant, una sequenza tipica è:
- Apri l'Agente e allega i PDF, oppure una cartella degli articoli che intendi confrontare.
- Definisci lo schema nel primo messaggio, così ogni articolo successivo utilizzerà le stesse colonne.
- Richiedi riferimenti localizzabili in ogni cella:
"Crea una tabella delle evidenze per questi articoli. Colonne: citazione, disegno dello studio, campione (n analizzato, popolazione, setting, campionamento), risultati primari con dimensioni dell'effetto e tempi di misurazione, e limitazioni classificate come Bias, Generalizzabilità o Reporting. Ogni cella deve includere una pagina o una citazione. Lascia vuota una cella se l'articolo non riporta l'informazione. Non parafrasare la sezione Limitazioni degli autori senza prima riclassificarla."
- Controlla a campione n, disegno ed eventuali dimensioni dell'effetto rispetto al PDF. Correggi la tabella nella conversazione; la memoria persistente mantiene lo schema per il lotto successivo.
- Se ti serve un documento condivisibile, passa la tabella verificata al Word Doc Generator invece di riformattarla manualmente.
- Per un testo narrativo costruito sulla tabella, Deep Research è il passaggio successivo migliore rispetto a chiedere all'estrattore di diventare una seconda revisione sistematica.
Per Elicit, il percorso parallelo è: raccogli gli articoli in una vista di revisione sistematica o estrazione, accetta o modifica le colonne suggerite, estrai con supporto di citazioni, quindi tratta l'AI come un secondo paio di occhi. Il flusso di revisione sistematica di Elicit è costruito attorno a modelli modificabili, celle supportate da citazioni o figure e accordo umano sui criteri di screening. Per Paperguide, definisci una volta le colonne, estrai sull'insieme selezionato ed esporta in CSV/Excel quando la griglia è stabile.
Due anti-pattern da evitare. Non estrarre 40 articoli con 40 prompt leggermente diversi. Non lasciare che il modello riempia le celle vuote con «probabile RCT» o «campione adeguato». Una cella vuota è un risultato.
Cosa dicono gli specialisti della sintesi delle evidenze sull'estrazione dei dati con AI?
I metodologi considerano sempre più l'AI come un secondo estrattore legittimo per i campi standardizzati, a condizione che ogni valore resti ispezionabile e che la valutazione delle limitazioni rimanga guidata dall'uomo. Il consenso emergente è circoscritto e pratico, non utopico.
"La discussione sull'accuratezza è in gran parte risolta per le colonne semplici — etichetta del disegno, n, nomi dei bracci, outcome primario come riportato. I confronti controllati mostrano ora che l'estrazione assistita dall'AI può eguagliare gli estrattori umani su questi campi e concludere più rapidamente. La modalità di errore rimanente è interpretativa: i modelli copiano le cautele degli autori e le chiamano valutazione critica. Non è una valutazione del rischio di bias, e PRISMA continua a richiedere di spiegare come è stato giudicato il bias."
"Ciò che cerchiamo in una piattaforma non è un riepilogo più gradevole. È una politica per le celle vuote, un riferimento localizzabile su ogni numero e uno schema delle limitazioni capace di registrare confondimento, campionamento e validità esterna anche quando l'articolo non usa mai queste parole. Se non puoi fare clic su una dimensione del campione per tornare alla frase corrispondente, non hai estrazione. Hai una bozza."
"Scegli lo strumento che corrisponde alla forma del corpus. I prodotti di estrazione dedicati vincono su grandi insiemi omogenei di trial. Gli Agenti di ricerca conversazionali vincono quando gli articoli sono misti, i PDF sono disordinati e la domanda scientifica è: «cosa non possiamo concludere?». La maggior parte dei veri progetti di laurea e clinici appartiene al secondo tipo."
— Jenova Product Team, progettazione di workflow per la ricerca accademica (esperienza nello sviluppo di Agenti AI per revisioni della letteratura e tabelle delle evidenze)
Questa visione è coerente con il quadro esterno: estrazione assistita non inferiore in uno SWAR del 2026, alte prestazioni sulle variabili standardizzate negli studi in stile revisore e linee guida delle biblioteche che lasciano agli umani la decisione finale.
Quando un Agente di ricerca flessibile è più adatto di una piattaforma di estrazione dedicata?
Un Agente di ricerca flessibile è più adatto quando il tuo insieme di articoli è piccolo o medio, i disegni sono misti e la competenza scarsa è interpretare le limitazioni, non sottoporre a screening 10.000 titoli. Una piattaforma dedicata è più adatta quando protocollo, revisione doppia e conteggi PRISMA sono il prodotto finale.
Scegli un estrattore dedicato, Elicit o Paperguide, quando:
- Stai conducendo una revisione sistematica o di scoping con un protocollo preregistrato.
- La maggior parte degli studi inclusi è costituita da trial o da altri report altamente standardizzati.
- Hai bisogno di registri di screening, motivi di esclusione e un diagramma di flusso.
- Più revisori devono risolvere conflitti sugli stessi record.
Scegli Jenova's Academic Research Assistant quando:
- Stai scrivendo un capitolo di tesi, il background di una richiesta di finanziamento, un journal club o una rapida scansione delle evidenze.
- Gli articoli combinano RCT, studi osservazionali e lavori qualitativi.
- Ti interessano più le limitazioni classificate che le colonne PICO suggerite automaticamente.
- Lavori già con modelli, PDF caricati e domande di approfondimento in un'unica conversazione.
L'uso ibrido è comune e razionale. Mappa la domanda in SciSpace o Consensus, estrai i campi MSOL in Jenova o Elicit e conserva la contabilità PRISMA nel modulo di revisione accettato dalla tua istituzione. I confronti tra SciSpace e Consensus descrivono esattamente questa divisione del lavoro: Consensus per una lettura rapida del grado di accordo, SciSpace per un recupero più denso. Nessun abbinamento elimina il controllo umano su n, outcome e bias.
Il limite di Jenova in questa scelta è scala e formalità. Non sostituirà una pipeline di screening enterprise. Il limite di Elicit è l'opposto: griglie eccellenti, minore supporto nativo per il lavoro complesso e argomentativo di spiegare perché un risultato non dovrebbe essere trasferibile. Se il tuo deliverable è una tabella delle evidenze che un relatore possa verificare, valuta prima gli strumenti in base a completezza MSOL e provenienza, e solo dopo in base al marchio o al prezzo mensile.
Riferimenti
- PRISMA statement — linee guida di reporting per le revisioni sistematiche
- DistillerSR — strumenti e tecniche di estrazione dei dati per le revisioni sistematiche
- medRxiv — accuratezza ed efficienza dell'estrazione di dati assistita da AI con Elicit (SWAR 2026)
- Paperguide — strumenti AI per revisioni sistematiche e riduzione del carico di lavoro riportata
- The BMJ — statement PRISMA 2020
- PubMed Central — spiegazione ed elaborazione di PRISMA 2020, inclusi i domini RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — strumenti AI come secondi revisori per l'estrazione dei dati
- King's College London — strumenti AI nella sintesi delle evidenze
- PapersFlow — confronto tra Elicit e Consensus AI
- Paperguide — confronto tra funzionalità e prezzi di Elicit e SciSpace (2026)
- George Mason University — strumenti AI per le revisioni della letteratura
- Elicit — AI per la ricerca scientifica, dimensione del corpus e dati di utilizzo
- Elicit — workflow per revisioni sistematiche della letteratura, dichiarazioni sull'accuratezza di estrazione e screening
- SciSpace — confronto tra SciSpace ed Elicit, inclusi i livelli di prezzo del 2026
- Paperguide — documentazione della piattaforma per colonne di estrazione personalizzate e valori collegati alle fonti
- Himmelfarb Health Sciences Library — qualità del reporting e rischio di bias
- Birmingham City University — note sull'accuratezza dell'estrazione dati con AI
- Paperguide — confronto tra SciSpace e Consensus