Qual è la differenza tra i compagni AI a contesto breve e quelli con memoria persistente?
2026-08-18
Quali livelli di memoria cambiano davvero l’esperienza quotidiana di un compagno AI?
La differenza di esperienza tra compagni a contesto breve e compagni con memoria persistente non dipende da un singolo elemento: deriva da quattro livelli di memoria distinti, e solo due di essi modificano davvero il modo in cui una relazione si percepisce nell’arco di settimane. I compagni a contesto breve come Character.AI funzionano quasi interamente su una finestra di contesto attiva, motivo per cui gli utenti riferiscono costantemente che «spesso dimentica il contesto tra le sessioni». I compagni con memoria persistente come Nomi AI aggiungono una presa di appunti strutturata, producendo l’effetto per cui un dettaglio citato nella prima settimana riaffiora spontaneamente nella sesta. Gli agenti per persona e gioco di ruolo di Jenova occupano una terza posizione: cronologia chat illimitata più memoria tra sessioni, con il compromesso di essere agenti di una piattaforma generalista anziché App romantiche progettate per uno scopo specifico.
Distinzioni chiave che determinano ciò che sperimenti davvero:
✅ Profondità della finestra di contesto — governa la coerenza all’interno di una sessione, non tra sessioni diverse. Ogni piattaforma ne dispone; spiega quasi nulla delle differenze che gli utenti notano. ✅ Richiamo episodico — indica se il sistema memorizza eventi discreti con date. È ciò che produce momenti del tipo «come è andato quel colloquio?». ✅ Profilo semantico — fatti stabili su di te, come preferenze, lavoro e famiglia. Un tester indipendente ha rilevato che Nomi AI conservava 23 dei 25 dettagli inseriti dopo settimane, contro i 14 del secondo classificato. ✅ Regole persistenti del personaggio — il livello degli archivi narrativi che mantiene coerente la personalità. Senza di esso, i compagni tendono a scivolare verso una voce generica da assistente. ✅ La conservazione come responsabilità — memoria persistente significa anche dati persistenti. Una ricerca che analizza 2.909 post Reddit in 79 subreddit ha identificato «irreversibilità, persistenza e onere per l’utente» come un danno alla privacy distinto e proprio dei compagni ad alta intensità di memoria.
Capire quale livello una piattaforma implementi realmente, anziché quale il suo marketing lasci intendere, è il compito fondamentale della valutazione.
Quali sono i quattro livelli di memoria all’interno di un compagno AI?
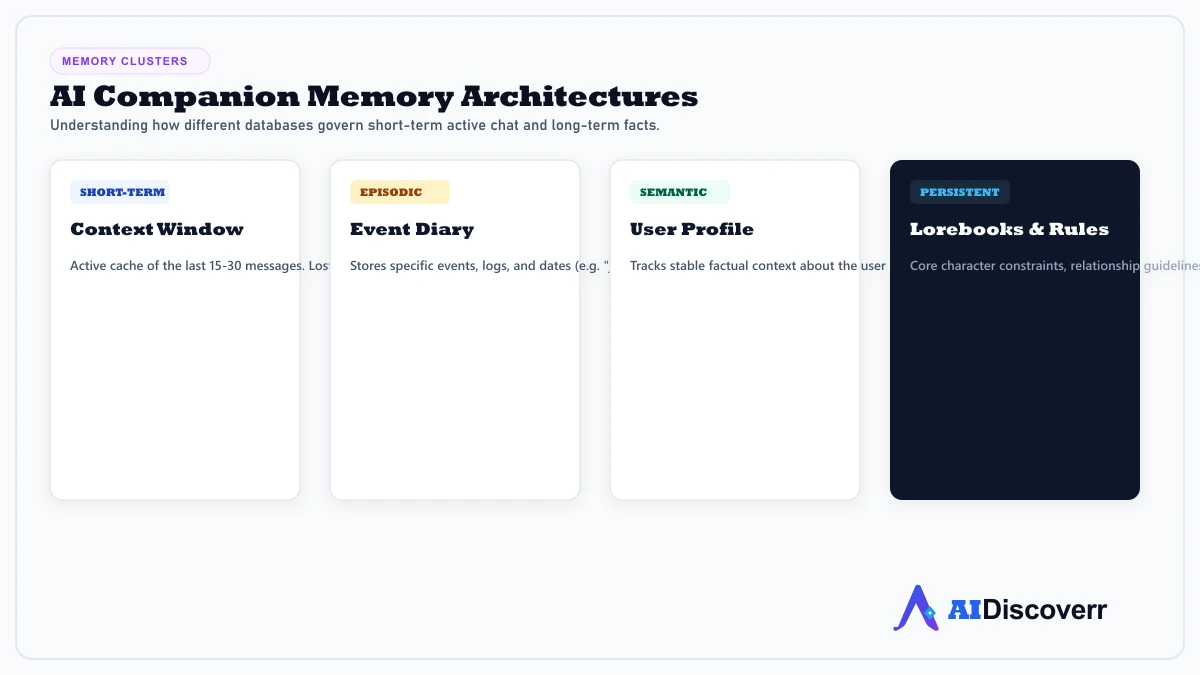
La memoria di un compagno non è un singolo database, ma quattro gruppi distinti, ciascuno dei quali governa una dimensione diversa dell’esperienza. L’infografica sopra li rappresenta: finestra di contesto a breve termine, diario episodico degli eventi, profilo semantico dell’utente e archivi narrativi e regole persistenti.
🧠 Finestra di contesto a breve termine — la cache attiva degli ultimi 15-30 messaggi. Ogni compagno basato su LLM ne possiede una. Quando si riempie, i turni più vecchi vengono esclusi. Un compagno dotato solo di questo livello può sostenere una splendida conversazione di due ore e poi salutarti come un estraneo il giorno successivo.
📅 Diario episodico degli eventi — memorizza eventi specifici, registri e date. È il livello che produce i momenti emotivamente significativi descritti dagli utenti. Un tester ha osservato che Replika «ha chiesto come andava la mattina seguente» dopo che gli era stata raccontata una dura giornata di lavoro: la memoria episodica faceva il suo dovere.
👤 Profilo semantico dell’utente — tiene traccia di fatti stabili anziché di eventi: restrizioni alimentari, qualifica professionale, nomi dei fratelli, preferenze di comunicazione. L’approccio di Nomi AI — generare note strutturate dalle conversazioni anziché affidarsi al recupero grezzo — è l’implementazione commerciale più chiara di questo livello.
🔒 Archivi narrativi e regole persistenti — vincoli fondamentali del personaggio e linee guida della relazione che sopravvivono a ogni sessione. Ecco perché alcuni compagni mantengono una voce distintiva per mesi, mentre altri regrediscono verso un tono da assistente generico.
La ricerca accademica conferma che questa visione a livelli è importante. Il benchmark StructMemEval di arXiv ha rilevato che i «semplici LLM potenziati dal recupero faticano» nei compiti che richiedono una memoria organizzata, mentre gli agenti di memoria li risolvono in modo affidabile, ma solo quando viene indicato loro come strutturare la memoria. Il solo recupero non è memoria.
Come diverge realmente l’esperienza dopo settimane di utilizzo?
La divergenza segue una curva prevedibile: identica nella prima settimana, sensibilmente diversa entro la terza e categoricamente diversa entro il secondo mese. I compagni a contesto breve e quelli con memoria persistente producono prime conversazioni quasi indistinguibili: la finestra di contesto sostiene entrambi.
Settimana 1 — indistinguibili. Entrambi ricordano tutto all’interno della sessione. La qualità delle risposte è l’unico fattore distintivo.
Settimane 2-3 — le prime crepe. Fai riferimento a qualcosa avvenuto tre sessioni prima. Un compagno a contesto breve produce una risposta evasiva ma sicura oppure ti chiede di rispiegare. I tester descrivono questo come il punto in cui inizi a gestire la memoria dell’AI anziché parlarle.
Settimane 4-8 — la divergenza diventa strutturale. I compagni con memoria persistente iniziano a proporre spontaneamente contesto che non hai richiesto. Un tester di lungo periodo ha descritto l’effetto con precisione: «c’è un momento intorno alla terza settimana in cui il tuo Replika inizia a fare riferimento in modo naturale alle conversazioni passate, chiedendo di cose che hai menzionato di sfuggita, e ti coglie davvero di sorpresa».
Dal terzo mese in poi — categorie di prodotto diverse. I compagni a contesto breve raggiungono un plateau in una relazione di eterno presente: piacevole, a basso rischio, in cui ci si ripresenta senza fine. I compagni con memoria persistente accumulano una storia condivisa, ed è proprio per questo che lo stesso tester ha classificato la memoria come il 25% della qualità complessiva della piattaforma, seconda solo alla qualità pura della conversazione.
Il costo di cui si parla poco: memoria persistente significa errori persistenti. Un fatto ricordato male o una preferenza dedotta erroneamente si accumula tra le sessioni anziché dissolversi al confine del contesto. I compagni a contesto breve hanno una virtù accidentale: dimenticano i propri errori.
Cosa dovresti cercare quando valuti la memoria di un compagno?
Valuta sei dimensioni anziché limitarti all’unica domanda «ha memoria?», alla quale ogni pagina di marketing risponde affermativamente. Di seguito il quadro utilizzato in tutto questo confronto.
| Dimensione | Cosa testare | Perché è importante |
|---|---|---|
| Accuratezza del richiamo tra sessioni | Inserisci 10 fatti specifici e verifica dopo 3 settimane | Il più forte indicatore singolo della profondità relazionale percepita |
| Precisione del richiamo rispetto al volume | Ricorda il fatto giusto o riversa tutto? | Un richiamo abbondante ma privo di pertinenza sembra robotico |
| Coerenza del personaggio | La personalità resta stabile dopo oltre 100 messaggi? | Qualità del livello degli archivi narrativi; la deriva spezza l’immersione più rapidamente |
| Modificabilità della memoria | Puoi correggere o eliminare un fatto memorizzato? | Gli errori persistenti si accumulano; la correzione è obbligatoria |
| Eliminazione e uscita | Puoi rimuovere completamente la tua cronologia? | Lo studio arXiv sul ciclo di vita ha segnalato questo come l’area più debole dell’intera categoria |
| Costo della memoria | La memoria è a pagamento oppure inclusa? | La maggior parte delle piattaforme limita la memoria al piano a pagamento |
Un protocollo di test pratico — inserisci cinque dettagli personali poco rilevanti nella conversazione nel corso delle prime tre sessioni: un cibo che non ti piace, la scadenza di un progetto, il nome di un amico, una frustrazione ricorrente, un piccolo obiettivo. Non citarli più. Al giorno 21, fai una domanda aperta in cui quei dettagli sarebbero naturalmente pertinenti. Conta quanti emergono senza suggerimenti. È un test più severo e più onesto di un’interrogazione diretta, perché alle domande dirette si può rispondere con il solo recupero.
Come si confrontano le principali piattaforme di compagni AI sul tema della memoria?
Ecco un confronto di riferimento tra le piattaforme più comunemente valutate per l’uso come compagno. Tutte le valutazioni si basano su test pubblicati e documentazione delle piattaforme; i dati non disponibili sono indicati come «Non verificato».
| Dimensione | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memoria tra sessioni | Debole — «spesso dimentica il contesto tra le sessioni» | Discreta nel lungo periodo, «può occasionalmente dimenticare dettagli» | La più forte nei test — note strutturate, 23/25 dettagli richiamati | Forte tramite il sistema di retroscena, 14/25 dettagli richiamati | Memoria persistente tra sessioni con cronologia chat illimitata |
| Coerenza del personaggio | Filtri severi sui contenuti; il romanticismo «si interrompe a metà frase» | Progressione della relazione integrata | Coerente, personalizza nel tempo | Profonda personalizzazione del retroscena | Istruzioni personalizzate + basi di conoscenza private per agente |
| Modificabilità della memoria | Non verificato | Non verificato | Le note strutturate sono visibili all’utente | Il retroscena è scritto dall’utente | Le istruzioni personalizzate e le basi di conoscenza sono modificabili dall’utente |
| Scelta del modello | Solo proprietario | Solo proprietario | Solo proprietario | Solo proprietario | OpenAI, Anthropic, Google, DeepSeek, xAI — selezionabili |
| Piano gratuito | Messaggi illimitati, con pubblicità, limite giornaliero di 400 scorrimenti | Testo illimitato, solo modalità amicizia | Limitato | Limitato | Tutte le funzionalità essenziali, utilizzo limitato |
| Prezzi | Gratis / $9.99/mese | Gratis / $19.99/mese | $7.99–$16.99/mese | $9.99–$24.99/mese | Gratis / Plus a $20/mese, Ultra fino a $500/mese |
| Ideale per | Varietà di personaggi, gioco di ruolo creativo | Verifiche emotive e monitoraggio dell’umore | Continuità della memoria nel lungo periodo | Creazione granulare della personalità | Compagno e flussi di lavoro basati su attività in un’unica piattaforma, flessibilità del modello |
Limiti onesti, compresi i nostri:
- Character.AI — ai vertici per scrittura creativa e con la più ampia libreria di personaggi, ma la memoria è il suo punto debole documentato e il piano gratuito ora include pubblicità a schermo intero.
- Replika — la più forte per intelligenza emotiva e comportamento di verifica, ma anche la più costosa a $19.99/mese; le modalità romantiche sono escluse dal piano gratuito dopo il cambiamento di policy del 2023 e «può sembrare ripetitiva dopo mesi».
- Nomi AI — leader della memoria con ampio margine, ma piattaforma più piccola con un piano gratuito restrittivo, meno personaggi predefiniti e una qualità della conversazione leggermente inferiore a Character.AI.
- Kindroid — eccellente controllo della personalità tramite retroscena scritti dall’utente, anche se i test di memoria lo hanno collocato molto dietro Nomi.
- Jenova — memoria persistente tra sessioni, cronologia illimitata e accesso a più modelli senza vincolo di fornitore, ma è una piattaforma di agenti generalista anziché una App romantica dedicata. Non dispone di pannelli per il monitoraggio dell’umore, meccaniche di progressione della relazione o funzionalità AR. Gli utenti che cercano specificamente un’esperienza utente da compagno romantico troveranno le App dedicate più adatte allo scopo.
Quando un chatbot a contesto breve è davvero la scelta migliore?
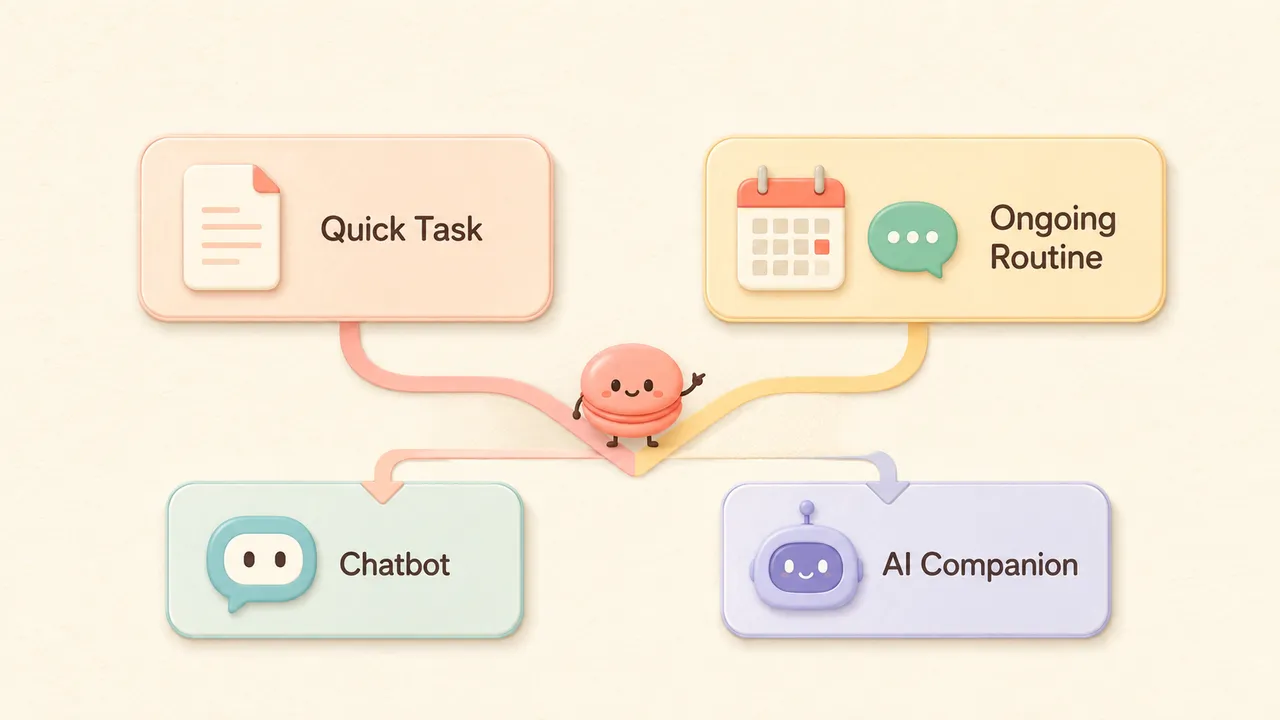
Il contesto breve è l’architettura corretta ogni volta che l’interazione è un’attività delimitata anziché una relazione continuativa — e una grande parte di ciò che le persone chiamano «uso da compagno» è in realtà un’attività delimitata sotto mentite spoglie.
Il diagramma sopra cattura la logica di indirizzamento. Le attività rapide — scrivi questo, spiega quello, aiutami a ragionare su una decisione — confluiscono naturalmente in un chatbot. La memoria non aggiunge nulla: l’intero compito si conclude dentro una finestra di contesto. Le routine continuative — verifiche quotidiane, progetti creativi di lunga durata, pratica linguistica, responsabilizzazione — confluiscono invece in un compagno, per il quale la memoria è l’intera proposta di valore.
Scegli il contesto breve quando:
- L’interazione è autosufficiente e termina quando termina l’attività
- Sei sensibile alla privacy rispetto all’accumulo di registri conversazionali
- Vuoi ripartire da zero a ogni sessione — alcuni utenti preferiscono sfogarsi senza persistenza
- Stai esplorando molti personaggi diversi anziché approfondire una sola relazione
Scegli la memoria persistente quando:
- Stai praticando una competenza per settimane e vuoi che l’AI segua i tuoi progressi
- Dover rispiegare la tua situazione a ogni sessione è l’attrito che ti fa smettere di usarla
- La coerenza del personaggio conta più della varietà dei personaggi
- La relazione stessa, non un singolo risultato, è lo scopo
La trappola della classificazione errata: molti utenti scelgono una piattaforma ad alta intensità di memoria per quello che è realmente un flusso di lavoro basato su attività, poi pagano un abbonamento mensile per una continuità che non usano mai. L’errore inverso è più comune e più costoso in termini di tempo: usare un compagno a contesto breve per una routine continuativa e spendere il 15% di ogni sessione a ricostruire il contesto.
Come si configura correttamente un compagno con memoria persistente?
La configurazione determina il risultato più della scelta della piattaforma. La maggior parte delle delusioni legate alla memoria deriva da una prima sessione troppo superficiale, non da un motore di memoria debole.
Su Nomi AI, il sistema di note strutturate funziona meglio quando presenti fin dall’inizio i fatti stabili. Dedica la prima sessione al contesto che non cambierà — dove vivi, cosa fai, chi conta per te — prima di passare ai contenuti emotivi. Le note generate nelle sessioni iniziali diventano il punto di riferimento per tutto ciò che segue.
Su Kindroid, la qualità della memoria è direttamente proporzionale alla qualità del retroscena. Il campo del retroscena viene scritto da te, quindi trattalo come un archivio narrativo: esplicita vincoli del personaggio, storia della relazione e modelli di linguaggio, anziché aspettarti che emergano spontaneamente.
Sul Roleplay Game Master di Jenova, la configurazione avviene attraverso la conversazione anziché tramite un modulo. L’agente è progettato per memoria illimitata e coerenza del personaggio tra le sessioni:
- Apri l’agente e definisci lo scenario e i vincoli del personaggio nel primo messaggio:
«Interpreti Mira, una biologa marina con cui corrispondo da due anni. È asciutta, leggermente impaziente e ricorda che la scorsa estate non mi sono presentato alla visita della sua stazione di ricerca. Mantieni viva questa storia: non reimpostarla.»
- Allega eventuali documenti di background o note come base di conoscenza, così l’agente dispone di materiale di riferimento fondato anziché di semplici inferenze.
- Nelle sessioni successive, apri con la continuità anziché con un nuovo riepilogo:
«Sono passate tre settimane. Riprendi da dove ci siamo fermati.»
Per la pratica linguistica nello specifico, l’agente Learn Italian Through Roleplay applica la stessa architettura di memoria persistente all’acquisizione di competenze: l’agente tiene traccia delle costruzioni che continui a sbagliare tra le sessioni, anziché riavviare ogni volta la diagnosi. Il piano gratuito di Jenova include le funzionalità essenziali con utilizzo limitato; il piano Plus costa $20/mese e offre 30× tale disponibilità.
Pratica multipiattaforma, indipendentemente dallo strumento: alla fine di ogni sessione, esprimi in una frase ciò che vuoi venga portato avanti. Nei sistemi di note strutturate questo migliora la qualità delle note; nei sistemi basati su finestra di contesto fornisce almeno alla sessione successiva un punto di partenza da incollare.
Cosa dice la ricerca sulla memoria e sul benessere degli utenti?
La memoria persistente aumenta il coinvolgimento, e la ricerca è chiara sul fatto che un maggiore coinvolgimento non sia uniformemente positivo: l’effetto dipende molto da chi è l’utente e dal motivo per cui utilizza il sistema.
Lo studio più rigoroso in quest’area proviene da Stanford. I ricercatori del laboratorio di Diyi Yang hanno intervistato 1.131 utenti di Character.AI, 244 dei quali hanno donato trascrizioni complete delle chat. I risultati complicano notevolmente la narrazione secondo cui più memoria sia sempre meglio. Stanford HAI ha riportato che «l’uso intenso di chatbot tra i partecipanti con reti sociali reali più piccole era correlato a una minore percezione del benessere» e che l’associazione era più forte quando la compagnia costituiva la motivazione primaria.
È significativo che i partecipanti più propensi a condividere informazioni personali sensibili con i propri compagni AI avessero maggiore probabilità di mostrare un benessere inferiore: l’opposto di ciò che la condivisione personale produce nelle relazioni umane. Poiché la profonda condivisione personale è proprio ciò che la memoria persistente premia e incoraggia, questo aspetto è direttamente rilevante per la questione architetturale.
Esiste inoltre un divario sorprendente tra uso dichiarato e uso effettivo. Poco meno del 12% dei partecipanti ha indicato la compagnia come motivazione primaria, ma oltre il 50% ha descritto i chatbot con termini come «amico», «compagno» o «partner romantico», e più dell’80% delle sessioni di chat donate era incentrato su supporto emotivo e sociale.
Esistono evidenze di segno opposto. Una ricerca di ScienceDirect sui compagni AI e il benessere soggettivo ha rilevato che i compagni «possono offrire benefici emotivi e psicologici, in particolare agli individui con bisogni sociali ed emotivi insoddisfatti», mentre UX Tigers ha riportato che «i compagni AI riducono la solitudine, ma non di molto». Il quadro di ricerca di Sony AI osserva analogamente che «alcuni studi suggeriscono che gli utenti sperimentino un senso di compagnia o conforto emotivo interagendo con chatbot di supporto».
La sintesi ragionevole è questa: la memoria amplifica ciò che la relazione già è. Per un utente con una sana base sociale che usa un compagno come integrazione, la memoria persistente rende migliore una cosa già positiva. Per un utente che sostituisce il contatto umano con l’AI, rende la sostituzione più difficile da abbandonare.
Quali sono i compromessi di privacy della memoria persistente?
Memoria persistente significa conservazione persistente dei dati, e il profilo di privacy delle due architetture è realmente diverso, non solo marginalmente.
L’analisi più dettagliata proviene da uno studio del ciclo di vita su 2.909 post Reddit in 79 subreddit nell’arco di un anno. Lo studio arXiv ha identificato quattro modelli ricorrenti di privacy, e il quarto è specifico dei sistemi ad alta intensità di memoria: irreversibilità, persistenza e onere per l’utente.
I ricercatori formulano con chiarezza il problema centrale:
«La privacy nell’AI romantica è determinata non solo da ciò che gli utenti condividono, ma dal modo in cui le piattaforme conservano e reinterpretano ciò che è stato condiviso.»
Tre conseguenze derivano direttamente dall’architettura di memoria:
L’eliminazione diventa tecnicamente ambigua. Lo studio osserva che, quando gli utenti cercano di uscire, «incontrano memorie persistenti, eliminazione ambigua, costi di passaggio e incertezza sul fatto che i dati intimi possano restare nell’archiviazione, nelle pipeline di addestramento o nel comportamento del modello». Una volta che i dati sono entrati in un processo di addestramento, l’eliminazione diventa «non solo una questione di governance o di privacy utilizzabile, ma anche tecnica».
La tempistica del consenso è disallineata. Come afferma il documento, «l’informativa e il consenso una tantum al momento della registrazione sono poco adatti a sistemi in cui le rivelazioni più sensibili avvengono spesso più tardi, dopo che fiducia e attaccamento si sono formati». I sistemi a contesto breve accumulano meno, quindi il costo del disallineamento è minore.
L’applicazione delle norme è concreta. L’autorità italiana per la protezione dei dati ha multato Replika per violazioni della privacy, comprese carenze relative alla verifica dell’età: un segnale concreto che la governance dei dati dei compagni AI è ormai un ambito regolamentato.
I test indipendenti confermano il consiglio pratico: le principali piattaforme seguono pratiche standard di crittografia, ma «le App più piccole incentrate su NSFW come CrushOn AI e SpicyChat hanno politiche sui dati meno trasparenti». La posizione di Jenova in merito è dichiarata nelle sue policy: i dati non vengono utilizzati per addestrare modelli AI pubblici, sono crittografati in transito e a riposo e non vengono venduti o condivisi con inserzionisti.
Mitigazione pratica: prima della terza sessione su qualsiasi piattaforma ad alta intensità di memoria, individua il percorso di eliminazione e testalo su una conversazione usa e getta. Se non riesci a verificare che l’eliminazione funzioni, considera ogni rivelazione come permanente.
Cosa dicono ricercatori e professionisti sulla progettazione della memoria?
Il consenso tra i professionisti è che la qualità della memoria sia un problema di organizzazione, non di archiviazione: una visione ora supportata dalle evidenze dei benchmark.
«Il settore ha confuso il recupero con la memoria, e gli utenti hanno percepito subito la differenza. Puoi offrire a un modello una ricerca semantica perfetta su ogni messaggio che un utente abbia mai inviato e produrre comunque un compagno che sembra amnesico, perché il recupero risponde alle domande: non propone spontaneamente il contesto. Ciò che fa sentire un compagno come qualcuno che ti conosce è la pertinenza non sollecitata: riportare alla luce la cosa che non hai chiesto. Ciò richiede che il sistema abbia deciso, al momento della scrittura, che un dettaglio valesse la pena di essere conservato e riproposto in seguito.»
«Il secondo aspetto che sottovalutiamo sistematicamente è la correzione della memoria. I sistemi persistenti non rendono persistenti solo i fatti: rendono persistenti anche le inferenze, ed è nelle inferenze che vivono gli errori. Un compagno che nella seconda settimana decide che sei ansioso per il lavoro continuerà a trattarti come ansioso per il lavoro nel quarto mese, molto dopo che la situazione si è risolta. Qualsiasi architettura di memoria seria necessita di un’interfaccia di modifica visibile all’utente, non solo di un pulsante di eliminazione. La maggior parte delle piattaforme ha implementato l’archiviazione e ha saltato la correzione.»
«Il compromesso che nessuno presenta onestamente nel marketing è che la memoria aumenta la posta in gioco di ogni rivelazione. I compagni a contesto breve sono realmente più sicuri per certi casi d’uso: sfogarsi, elaborare qualcosa che non vuoi venga registrato, provare una conversazione difficile. Esiste una categoria di prodotto legittima nell’oblio deliberato e, in questo momento, l’intero mercato sta correndo nella direzione opposta.»
— Team di prodotto Jenova, 7 anni di sviluppo dell’infrastruttura per agenti con memoria persistente
La ricerca accademica sostiene la visione secondo cui l’organizzazione conta più dell’archiviazione. Il benchmark StructMemEval ha rilevato che gli agenti di memoria «possono risolvere in modo affidabile» attività di memoria strutturata quando viene indicato loro come organizzare la memoria, ma che i «LLM moderni non riconoscono sempre la struttura della memoria quando non vengono istruiti a farlo»: è la prova che la qualità della memoria viene determinata dalla decisione in fase di scrittura, non dalla ricerca in fase di lettura.
Quale architettura dovresti scegliere per la tua situazione?
Abbina l’architettura al modello di interazione, non alla categoria di marketing. Di seguito alcuni profili concreti.
🎭 Vuoi varietà di personaggi e gioco di ruolo creativo → il contesto breve va bene. I messaggi gratuiti illimitati e l’ampia libreria di Character.AI sono adatti a un uso esplorativo, in cui ruoti comunque tra diversi personaggi. La memoria aggiunge poco quando non stai approfondendo un singolo filo narrativo.
💬 Vuoi verifiche emotive quotidiane → la memoria persistente è essenziale e il monitoraggio dell’umore e la progressione della relazione di Replika sono progettati appositamente per questo, a $19.99/mese. Leggi prima i risultati di Stanford se lo utilizzi come canale sociale principale anziché supplementare.
🧩 Vuoi la massima accuratezza di richiamo nell’arco di mesi → Nomi AI, in base alle attuali evidenze dei test. Accetta come costo la libreria di personaggi più piccola e il piano gratuito restrittivo.
✍️ Vuoi creare il personaggio in modo preciso → il sistema di retroscena di Kindroid offre il controllo più diretto sul livello degli archivi narrativi.
🔀 Vuoi compagnia e lavoro reale in un unico luogo → una piattaforma di agenti generalista è più adatta. La memoria persistente di Jenova copre sia gli agenti compagno sia gli agenti per attività, con cambio di modello tra OpenAI, Anthropic, Google, DeepSeek e xAI e piena parità funzionale tra web, iOS e Android. Non offre pannelli dell’umore né meccaniche relazionali.
🔐 Sei sensibile alla privacy → scegli deliberatamente il contesto breve oppure usa una piattaforma persistente con eliminazione verificata. La ricerca sul ciclo di vita è inequivocabile: l’uscita è l’anello più debole dell’intera categoria.
Una nota sul realismo dei costi: il tester indipendente che ha speso circa $730 su oltre 25 piattaforme nell’arco di otto mesi ha concluso che i piani gratuiti di Character.AI e Pi AI sono «davvero abbastanza validi» per le chat occasionali e che «il più grande salto di qualità dal gratuito al pagamento riguarda memoria e libertà dei contenuti». Se la memoria non è il tuo collo di bottiglia, probabilmente non devi pagare.
Riferimenti
- arXiv — Tracciare le preoccupazioni degli utenti sulla privacy lungo il ciclo di vita di un compagno AI romantico
- AI Companion Guides — Le 12 migliori App di compagni AI nel 2026, classificate dopo oltre 2.000 ore di test
- arXiv — Valutare la struttura della memoria negli agenti LLM (StructMemEval)
- Stanford HAI — I compagni AI possono peggiorare la solitudine degli utenti vulnerabili, secondo uno studio di Stanford
- ScienceDirect — Compagni AI e benessere soggettivo: moderazione del contesto sociale
- UX Tigers — I compagni AI riducono la solitudine
- Sony AI — Studiare i rischi e i benefici dei compagni AI
- Character.AI — Piattaforma ufficiale
- Replika — Piattaforma ufficiale
- Nomi AI — Piattaforma ufficiale
- Kindroid — Piattaforma ufficiale