Chat AI con memoria vettoriale: richiamo semantico persistente per gli agenti
2026-09-15
Jenova ti offre una chat AI con memoria vettoriale: conversazioni che ricordano il significato, non solo gli ultimi messaggi. A settembre 2026, la maggior parte degli assistenti dimentica ancora le preferenze, perde il contesto dei progetti e ti costringe a rispiegare gli stessi file. Questa piattaforma archivia dialoghi, documenti e preferenze, così gli agenti specializzati possono recuperare il contesto corretto quando ne hai bisogno.
✅ Memoria persistente tra sessioni, non una finestra scorrevole che si azzera ✅ Recupero semantico oltre le parole chiave: trova ciò che intendevi, non ciò che hai digitato ✅ Basi di conoscenza che colleghi una volta e riutilizzi per ricerca, codice e scrittura ✅ Lo stesso modello di memoria su web, iOS e Android
La chat senza stato è economica da eseguire e costosa da usare. Per capire perché la memoria vettoriale è ormai al centro di una chat AI davvero utile, è utile osservare come embedding, recupero e contesto a lungo termine falliscano concretamente nel lavoro quotidiano.
Risposta rapida: che cos'è la chat AI con memoria vettoriale?
La chat AI con memoria vettoriale è un sistema di recupero che archivia il significato delle conversazioni come embedding, così un'AI può richiamare contesto, documenti e preferenze pertinenti tra una sessione e l'altra. È la differenza tra un chatbot che ricomincia da capo a ogni conversazione e un agente che prosegue il lavoro.
Capacità principali:
- Integra messaggi, file e fatti come vettori per la ricerca di similarità
- Inserisce nella finestra di contesto del modello solo i ricordi più pertinenti
- Mantiene cronologia chat illimitata e preferenze tra sessioni su un'unica piattaforma
- Basa le risposte sulle basi di conoscenza allegate anziché su supposizioni parametriche
- Porta la stessa memoria dalla sessione alla scrivania al telefono senza dover aggiornare di nuovo l'agente
Perché la maggior parte delle chat AI dimentica ancora
I modelli linguistici di grandi dimensioni sono forti nel ragionamento e deboli nell'archiviazione. I loro pesi contengono conoscenza generale; non contengono il tuo arretrato, il tuo schema o la tua ultima decisione. La generazione aumentata dal recupero esiste proprio perché la memoria parametrica è incoerente e difficile da aggiornare in un ambito privato, un punto sintetizzato in una rassegna del 2025 sulle architetture RAG.
La domanda del settore per questo livello di recupero non è più sperimentale:
USD 2,652.1 million → USD 8,945.7 million — Mercato globale previsto dei database vettoriali dal 2025 al 2030, con un CAGR del 27,5%
Questa spesa ne è il sintomo. I team acquistano infrastrutture vettoriali perché la chat senza memoria continua a fallire negli stessi modi:
- Le finestre di contesto si riempiono, quindi le decisioni più vecchie scompaiono a metà progetto
- La ricerca per parole chiave non coglie parafrasi, sinonimi e intenzioni implicite
- Gli stack RAG sviluppati internamente (segmentazione, indici, valutazione, autenticazione) si bloccano prima della produzione
- La personalizzazione resta intrappolata nella cronologia chat di un singolo fornitore
- Le risposte divergono quando il modello non riesce a fondarsi sui tuoi file
Ma portare nella chat di tutti i giorni una memoria durevole, privata e ricercabile semanticamente è ancora frustrantemente difficile:
Le finestre di contesto non sono memoria
Una finestra di contesto è un buffer, non un archivio. La cronologia della conversazione, una domanda dell'utente e alcuni "fatti salvati" vengono concatenati in un prompt; tutto ciò che non entra viene scartato. Ecco perché un agente di coding dimentica l'errore che hai incollato ieri e perché un tutor ti richiede di nuovo il punteggio che vuoi raggiungere. La memoria vettoriale si trova all'esterno della finestra: in fase di inferenza recupera una piccola porzione pertinente invece di sperare che l'intera trascrizione trovi ancora spazio.
La ricerca per parole chiave non può rappresentare il significato
La ricerca classica premia i token esatti. La ricerca vettoriale confronta gli embedding — rappresentazioni numeriche ad alta dimensionalità del significato — usando metriche come la similarità coseno o la distanza euclidea. Gli embedding più un indice vettoriale costituiscono il livello di recupero che rende possibili le moderne applicazioni LLM. Senza questo livello, "piano assunzioni Q3" non recupererà la nota intitolata "organico per l'autunno".
Un RAG sviluppato internamente è un progetto infrastrutturale
Una pipeline di recupero in produzione richiede una strategia di segmentazione, la scelta degli embedding, un indice ANN, filtri sui metadati, valutazione e processi di aggiornamento. I benchmark ANN pubblicati mostrano perché i team se ne preoccupano: i motori vengono confrontati contemporaneamente per latenza, throughput e precisione, perché la velocità senza richiamo è un prodotto diverso. La maggior parte delle persone che desidera semplicemente una chat che ricordi non dovrebbe dover gestire questo stack.
La personalizzazione senza memoria portabile è fragile
Lo Stanford’s Digital Economy Lab sostiene che il vantaggio durevole nell'AI deriverà da un contesto personale persistente e governato dall'utente, non da un altro chatbot isolato. Oggi la memoria è di solito una funzionalità del fornitore: non viaggia con te e può influenzare silenziosamente ciò che ti viene mostrato. Un reportage del Columbia Journalism Review sulla memoria dei chatbot rileva che il richiamo dell'utente può modificare le informazioni che le persone ricevono.
È esattamente per questo che è stata creata Jenova.
La soluzione Jenova
Jenova tratta la chat AI con memoria vettoriale come impostazione predefinita, non come un componente aggiuntivo da collegare in seguito. Cronologia chat illimitata, memoria persistente tra sessioni e basi di conoscenza collegabili supportano ogni agente specializzato. Parli in linguaggio naturale; la piattaforma recupera gli embedding, gli strumenti e i file appropriati prima che il modello risponda.
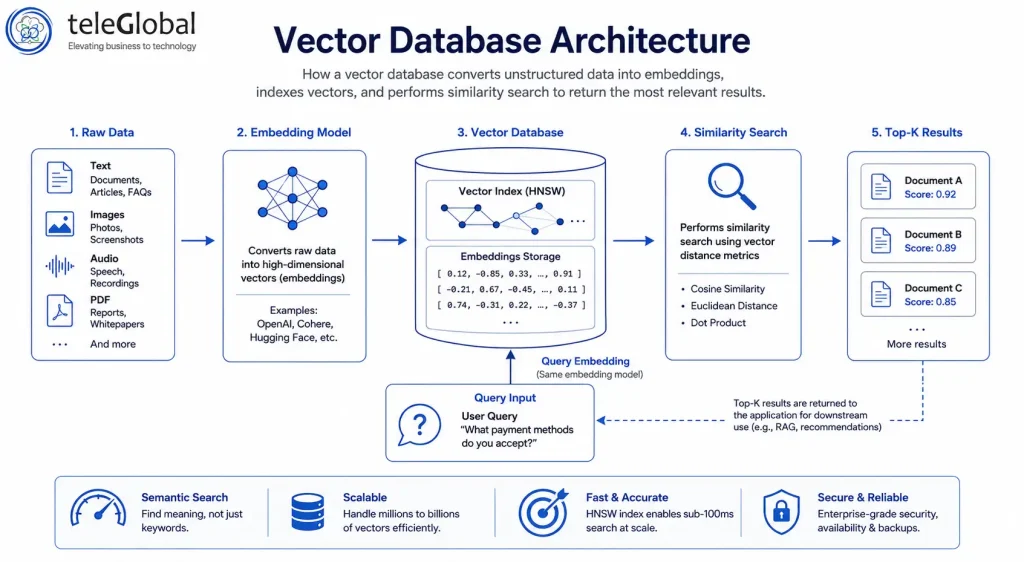
Il diagramma qui sopra mostra i meccanismi dietro quell'esperienza: testo non strutturato, immagini e documenti diventano embedding, vengono inseriti in un indice vettoriale e restituiti come corrispondenze top-k per una query. Non configuri mai parametri HNSW né scegli una metrica di distanza. Avvii una conversazione.
| Approccio tradizionale | Jenova |
|---|---|
| Incolla lo stesso briefing in ogni nuova chat | Memoria persistente tra sessioni e agenti |
| Ricerca per parole chiave tra note e PDF | Recupero semantico tramite embedding |
| Ospita autonomamente un database vettoriale, un embedder e la valutazione RAG | Archiviazione e recupero completamente gestiti |
| Un fornitore di modelli, un silo di memoria | Accesso a più modelli con contesto condiviso |
| Cronologia solo desktop che scompare su mobile | Piena parità funzionale su web, iOS e Android |
Ricerca che accumula valore invece di ricominciare
Le revisioni della letteratura e le analisi di mercato falliscono quando l'assistente non ricorda gli articoli che hai già escluso. Real-Time Search recupera risultati in tempo reale da Google, Reddit, YouTube, GitHub e altro ancora, mentre la memoria vettoriale mantiene attivi i criteri di inclusione, le citazioni precedenti e le regole "non usare questa fonte". Non inizi una nuova query booleana ogni mattina: prosegui un'indagine supportata dal recupero.
Codebase che l'agente conosce davvero
Python Coding Assistant è utile il primo giorno per uno script. Diventa durevole il dodicesimo giorno, quando conosce ancora la struttura del tuo pacchetto, il test instabile che hai deciso di ignorare e il contratto API che hai bloccato la settimana precedente. Collega una sola volta le note del repository o un documento di progettazione. I prompt successivi recuperano quel contesto invece di inventare un'architettura parallela.
Scrittura che conserva la tua voce e i tuoi fatti
Le bozze si interrompono nelle chat senza stato perché tono, frasi vietate e URL di riferimento escono dalla finestra. Un agente dedicato alla scrittura sulla piattaforma può archiviare come memoria i tuoi campioni di stile e le decisioni sulla scaletta, quindi recuperarli quando dici "stessa voce del post di lancio". Insieme agli allegati di documenti, questa è memoria vettoriale che garantisce continuità editoriale, non un prompt più grande.
Vita e apprendimento che non dovrebbero azzerarsi
Il coaching e la pratica linguistica funzionano solo se l'agente ricorda i vincoli: infortuni, date d'esame, vocabolario che già possiedi. La memoria persistente trasforma un tutor generico in un tutor che smette di ripetere gli esercizi della prima settimana. Lo stesso archivio che recupera una traccia di errore Python può recuperare il fatto che impari meglio con il gioco di ruolo che con le tabelle grammaticali.
Prova gratuitamente la piattaforma: non serve la carta di credito.
Agenti AI specializzati per la chat AI con memoria vettoriale
La memoria è utile solo quanto il flusso di lavoro che supporta. Questi agenti sono progettati per attività in cui dimenticare è costoso: percorsi di ricerca lunghi, logistica ricorrente, pratica immersiva e gioco coerente con i personaggi.
Deep Research
La ricerca di molte ore è il caso da manuale per la chat AI con memoria vettoriale. Questo agente esamina centinaia di fonti, sintetizza i risultati con citazioni nel testo e fornisce report che puoi continuare domani senza ridefinire l'ambito della domanda.
- Archivia la domanda di ricerca, le fonti escluse e la tesi di lavoro
- Recupera risultati precedenti affinché le sezioni successive non contraddicano quelle precedenti
- Fonda le affermazioni su materiale citato anziché sul solo richiamo del modello
Academic Research Assistant
I flussi di lavoro di dottorandi e docenti si estendono per mesi tra letteratura, stili di citazione e versioni di manoscritti. L'assistente scopre articoli nelle principali banche dati e aiuta nella preparazione dei manoscritti, mentre la memoria mantiene intatti sede di pubblicazione, metodologia e insieme di testi già letti.
- Scoperta della letteratura in tempo reale nei repository accademici
- Supporto per citazioni e manoscritti collegato alla tua bozza in corso
- Continuità tra articoli correlati, non risposte chat isolate
Personal Secretary
La logistica è un problema di memoria: fornitori ricorrenti, preferenze di viaggio, chi riceve l'aggiornamento del venerdì. Questo agente coordina calendario, email e operazioni quotidiane con un profondo contesto personale, così non devi insegnargli di nuovo la tua routine ogni lunedì.
- Ricorda preferenze consolidate e le persone con cui lavori
- Collega la pianificazione agli strumenti che già utilizzi
- Mantiene il contesto dal briefing mattutino al follow-up pomeridiano
Roleplay Game Master
La coerenza narrativa è impossibile senza memoria a lungo termine. Questo agente è progettato per il gioco di ruolo immersivo con memoria illimitata e personaggi stabili: promesse narrative, nomi delle fazioni e tono non si azzerano quando la finestra di contesto si sarebbe riempita.
- Memoria illimitata per stato della storia e voce dei personaggi
- Recupero di scene precedenti quando un capitolo successivo ne ha bisogno
- Ampiezza creativa senza perdere continuità
Learn Russian Through Roleplay
L'acquisizione linguistica dipende da un contesto personale e distribuito nel tempo: parole che hai sbagliato, livello di formalità, storie che hai già vissuto. Questo mentore usa scenari illimitati e memoria illimitata, così la pratica accumula valore anziché ripetere copioni per principianti.
- Ricorda le tue lacune lessicali e i tipi di scenario preferiti
- Mantiene coerenti personaggi e ambientazione tra le sessioni
- Trasforma ogni conversazione in pratica supportata dal recupero
Come funziona la chat AI con memoria vettoriale
Non devi configurare un database vettoriale. Avvii una conversazione; la piattaforma gestisce embedding, recupero e finestra di contesto.
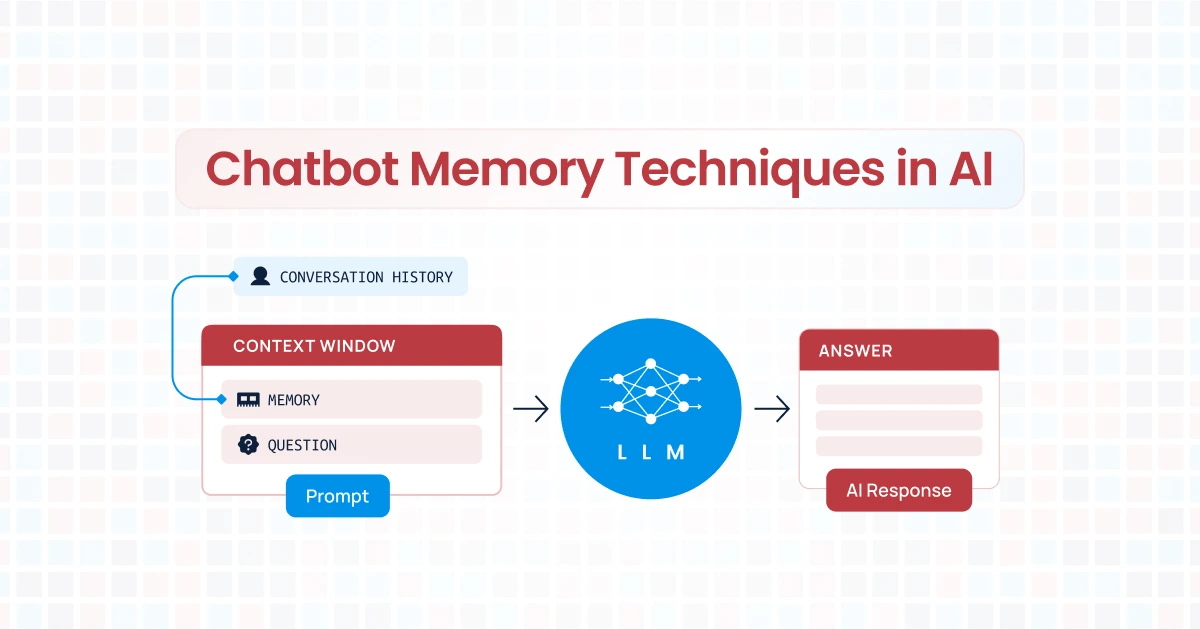
Quel secondo diagramma rappresenta il ciclo visibile all'utente. Cronologia, memoria archiviata e nuova domanda vengono assemblate in un prompt; il modello risponde. Il recupero vettoriale decide quali ricordi appartengono a quel prompt, così la finestra resta focalizzata.
Passaggio 1: apri un Agente e definisci il risultato Scegli lo specialista per il lavoro — ricerca, codice, viaggi, tutoraggio — e spiega cosa significa "completato". Il primo messaggio diventa un embedding come tutti quelli successivi.
"Sto scrivendo una revisione sistematica sulla generazione aumentata dal recupero. Privilegia le rassegne dal 2024 in poi, escludi i blog dei fornitori e mantieni lo stile di citazione IEEE."
Passaggio 2: allega le conoscenze di cui il modello dovrebbe fidarsi Carica briefing, PDF, note o specifiche. Questi documenti vengono indicizzati per la ricerca semantica, così le domande successive recuperano passaggi in base al significato. È lo stesso schema che le aziende finanziano oggi come infrastruttura RAG, senza che tu debba gestire l'indice.
"Usa la matrice della letteratura allegata. Se un articolo è contrassegnato come rifiutato, non citarlo di nuovo."
Passaggio 3: continua a lavorare tra le sessioni Chiudi il laptop. Il giorno successivo, fai una domanda di approfondimento. La memoria persistente e la cronologia illimitata consentono all'agente di recuperare l'ambito della revisione, l'elenco degli esclusi e l'ultima intestazione della scaletta invece di accoglierti come uno sconosciuto.
"Continua dalla sezione sulle limitazioni e recupera i tre articoli che abbiamo segnalato per la discussione."
Passaggio 4: cambia dispositivo senza ripetere il briefing Apri la stessa conversazione su iOS o Android. Impostazioni e cronologia si sincronizzano. Un prompt durante il tragitto può recuperare gli stessi vettori della sessione alla scrivania: è questo lo scopo della chat AI con memoria vettoriale, la continuità, non un nuovo silo chat per ogni dispositivo.
"Sto andando al campus: interrogami sulle tre modalità di fallimento del RAG che abbiamo elencato ieri."
Risultati e casi d'uso
La memoria vettoriale si manifesta in ore non ripetute, non in un grafico di benchmark. Questi scenari sono tipici di ciò che cambia quando la chat recupera il significato.
📊 Sintesi della letteratura in più settimane
Scenario: Uno studente di laurea magistrale ha bisogno di una panoramica citata degli articoli sulla robustezza del RAG, aggiornata ogni pochi giorni man mano che compaiono nuove prepubblicazioni.
Approccio tradizionale: Una cartella di PDF, un foglio di calcolo di note e un chatbot che dimentica l'elenco delle esclusioni. Il briefing viene incollato di nuovo a ogni sessione. È facile citare due volte una fonte o non notare una contraddizione.
Deep Research: La domanda, le esclusioni e la scaletta di lavoro persistono. Le nuove esecuzioni recuperano la sintesi precedente, così il report cresce invece di biforcarsi.
- Le citazioni restano allineate alle sezioni precedenti
- Le fonti rifiutate restano rifiutate
- I follow-up costano meno della ricerca iniziale
💼 Un servizio Python che si estende su più sprint
Scenario: Stai creando un servizio FastAPI con una specifica OpenAPI congelata, un test instabile noto e un vincolo di distribuzione su Python 3.11.
Approccio tradizionale: Ogni nuova chat inventa una struttura di cartelle diversa. Trascorri i primi dieci minuti a rispiegare decisioni che il modello non può vedere.
Python Coding Assistant: Le note architetturali e la specifica vivono nella memoria e negli allegati. Un report di bug del giovedì recupera l'elenco dei vincoli del mercoledì.
- Meno refactoring contraddittori
- Il debugging parte dallo stack reale
- L'onboarding per il tuo io futuro, o per un collega che legge la conversazione, è più rapido
🎭 Una campagna che non deve contraddirsi
Scenario: Un gioco settimanale con NPC nominati, un segreto che il gruppo non ha ancora scoperto e un tono già impostato nella prima sessione.
Approccio tradizionale: Note di sessione in un'altra App; il chatbot inserisce a forza un nuovo antagonista perché non riesce a recuperare la promessa precedente.
Roleplay Game Master: Lo stato della storia è memoria. Quando un giocatore cita un dettaglio buttato lì tre sessioni prima, il recupero può riportarlo nella scena.
- La voce dei personaggi rimane stabile
- Le promesse narrative restano interrogabili
- Gli archi lunghi rimangono coerenti
📱 Pianificazione di viaggio dalla coda in aeroporto
Scenario: Hai pianificato un viaggio in tre città alla scrivania — tetto di spesa, giornate orientate alle passeggiate, niente voli notturni. Al gate ti serve una riscrittura consapevole del meteo soltanto per domani.
Approccio tradizionale: Fai uno screenshot delle tue note. Speri che il chatbot mobile deduca vincoli che non ha mai visto.
Travel Planning Advisor: Preferenze e itinerario sono già nella memoria. Un prompt dal telefono li recupera e modifica una giornata senza ricostruire l'intero viaggio.
- I vincoli sopravvivono al cambio di dispositivo
- Gli approfondimenti locali rispettano il budget
- Non riscrivi il briefing sul finger d'imbarco
L'analisi dell'uso reale mostra lo stesso modello per cui gli acquirenti aziendali di database vettoriali stanno pagando: recupero semantico a bassa latenza per domande dal vivo, non una casella di chat più grande.
FAQ
Che cos'è la chat AI con memoria vettoriale?
La chat AI con memoria vettoriale archivia messaggi, file e fatti come embedding, quindi recupera le corrispondenze più vicine quando fai una domanda. Tali corrispondenze vengono inserite nella finestra di contesto del modello, così la risposta può usare la tua cronologia e i tuoi documenti. Su Jenova, questo recupero è integrato negli agenti specializzati anziché essere offerto come database separato da gestire.
Jenova è gratuito per la chat AI con memoria vettoriale?
Sì. Un piano gratuito include funzionalità essenziali con uso mensile limitato. I piani a pagamento aumentano il margine di utilizzo e aggiungono opzioni come la selezione personalizzata del modello. L'utilizzo si azzera alla data di fatturazione, con l'intera quota disponibile dal primo giorno anziché distribuita giornalmente.
In cosa differisce da un chatbot che "salva ricordi"?
Molti prodotti memorizzano un breve elenco di fatti o una trascrizione scorrevole. La memoria vettoriale recupera per similarità semantica su cronologia illimitata e conoscenze allegate, risultando più vicina al RAG che a un post-it. Il lavoro indipendente sulla memoria a lungo termine in produzione per gli agenti considera la memoria scalabile un problema di sistemi a sé stante, non un interruttore nelle impostazioni. OpenAI ha inoltre ampliato la capacità di ChatGPT di fare riferimento al contesto delle chat precedenti; la questione architetturale è se la memoria sia un silo del fornitore o un'infrastruttura alla base di ogni flusso di lavoro che esegui.
Posso basare la chat sui miei documenti?
Sì. Allega i file che dovrebbero prevalere sulle conoscenze pregresse del modello — specifiche, programmi di studio, trascrizioni, guide del brand. Il recupero privilegia quel corpus quando poni domande correlate, ed è così che riduci le allucinazioni sul materiale privato. Un Writing Assistant può continuare a usare quei campioni per il tono; un agente di ricerca può continuare a usarli per le affermazioni.
La chat AI con memoria vettoriale funziona su mobile?
Sì. Web, iOS e Android condividono cronologia, impostazioni e memoria. La conversione del parlato in testo è disponibile quando non puoi digitare. Lo scenario di viaggio qui sopra è il modello previsto: recuperare dal telefono gli stessi vettori creati alla scrivania.
Un agente abilitato alla memoria è abbastanza accurato per argomenti sensibili?
La memoria migliora la coerenza; non rende infallibile un modello. Le rassegne sul RAG indicano ancora qualità del recupero, contesto rumoroso e fedeltà come problemi aperti (Sharma, 2025). Per decisioni sanitarie, legali o finanziarie, considera l'agente uno strumento di supporto e verifica con fonti primarie. Un Personal Therapist può ricordare i temi che gli hai chiesto di tenere presenti, utile per la continuità, ma non è un sostituto dell'assistenza professionale abilitata.
La memoria vettoriale è l'interfaccia chat che finalmente accumula valore
La chat AI senza stato spreca l'unico input scarso che possiedi: il tempo impiegato per spiegarti. La chat AI con memoria vettoriale archivia il significato come embedding, lo recupera su richiesta e consente agli agenti specializzati di proseguire il lavoro. Il mercato per questo livello di recupero sta crescendo perché il problema è universale: dalla ricerca semantica nei sistemi di produzione al contesto personale che dovrebbe appartenere all'utente.
Jenova mette questa memoria alla base di ricerca, codice, narrazione e pianificazione senza chiederti di gestire un database vettoriale. Continua un report di Deep Research, un servizio Python o una campagna di gioco di ruolo come se l'agente fosse stato nella stanza per tutto il tempo.
Esplora la libreria completa di agenti su Jenova.
Per gli sviluppatori: ogni agente citato in questo articolo è disponibile a livello programmatico tramite la Jenova API: integra memoria vettoriale, recupero e agenti multi-modello nella tua App con una sola integrazione. Documentazione completa →