Come testare un assistente di ricerca AI per l’integrità delle fonti?
2026-08-22
Quali cinque controlli di audit distinguono una traccia delle fonti verificabile dal teatro delle citazioni?
Un assistente di ricerca AI utile è uno che puoi sottoporre ad audit, non uno che si limita a sembrare corredato di citazioni. Nel 2026, il test pratico è se lo strumento produce una traccia delle fonti — un percorso recuperabile da ogni affermazione a un documento reale, datato e cliccabile — attraverso cinque controlli: copertura delle fonti, citazioni cliccabili, allineamento tra affermazione e fonte, date di aggiornamento e inferenze etichettate. Jenova's Academic Research Assistant è progettato per la scoperta in tempo reale della letteratura e la gestione delle citazioni, mentre Elicit, Scite, Consensus, Perplexity e ChatGPT Deep Research superano alcuni di questi controlli e ne falliscono altri.
La differenza non consiste nell’avere “più note a piè di pagina”. Le linee guida delle biblioteche sono esplicite: anche quando uno strumento AI cita una pagina reale, il testo generato può comunque essere errato, quindi è necessario verificare la risposta rispetto alla fonte citata, non limitarsi a confermare che esista un URL (Northwestern University Libraries). Un audit equo assegna quindi un punteggio a cinque dimensioni TRACE:
✅ Tracciabilità — ogni affermazione sostanziale dispone di una citazione cliccabile che apre il documento previsto ✅ Copertura del reperimento — le fonti coprono il corpus corretto (articoli scientifici, rapporti, notizie, dati primari), non un singolo indice comodo ✅ Allineamento — il passaggio citato implica effettivamente l’affermazione, inclusi numeri e qualificazioni ✅ Attualità — le date di pubblicazione o aggiornamento sono visibili e le fonti obsolete vengono segnalate ✅ Etichettatura epistemica — l’assistente indica ciò che è citato, ciò che è inferito e ciò che è ignoto
Per confrontare gli strumenti in modo significativo, tratta i prompt e il punteggio come infrastruttura di produzione: stesse query, stesse regole di superamento/non superamento, stesso requisito per cui la sintesi non supportata deve essere etichettata come inferenza anziché come fatto.
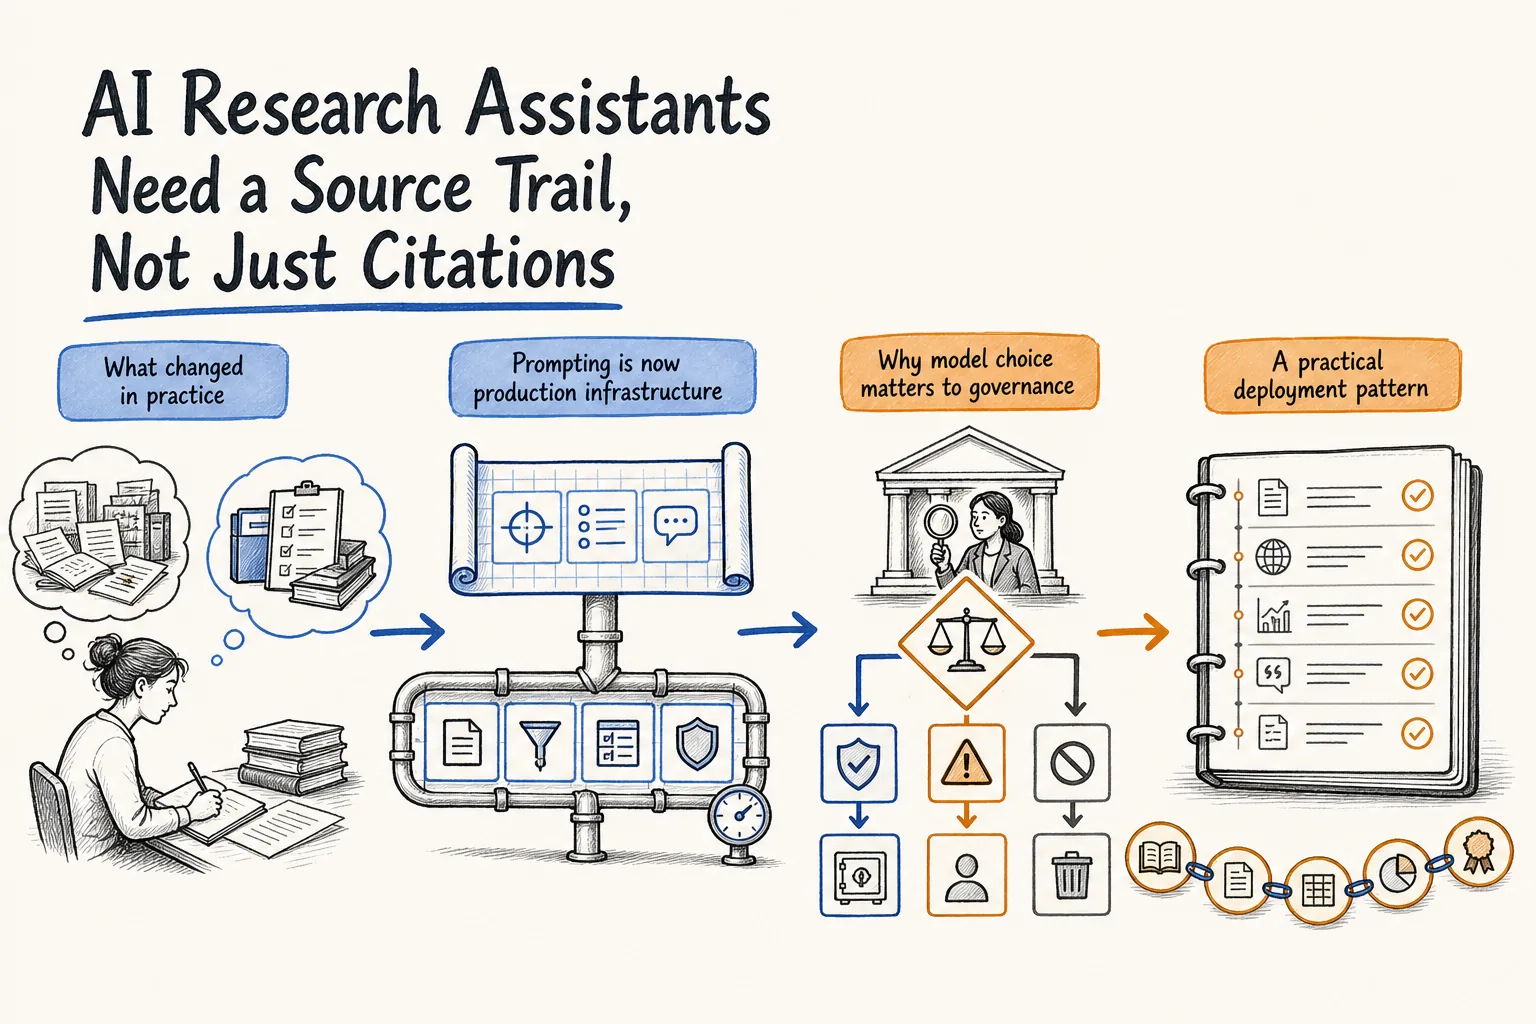
Perché il test delle citazioni è più importante per gli assistenti di ricerca AI nel 2026?
Il test delle citazioni è oggi più importante perché i ricercatori usano strumenti generativi per sintesi ad alta rilevanza, mentre tali strumenti continuano a inventare, attribuire erroneamente e aggiornare silenziosamente le loro fonti. Le University of Nevada, Reno Libraries esprimono chiaramente la modalità di errore: si sta valutando l’affermazione, non l’impressione trasmessa dall’elenco delle fonti, e una citazione che non riesci a trovare può essere un’allucinazione.
Il tasso di errore non è teorico. Uno studio JMIR sui riferimenti generati da ChatGPT ha rilevato che soltanto circa il 73–76% delle citazioni corrispondeva a fonti reali. Stanford HAI ha riportato che i modelli AI giuridici allucinavano in almeno una query di benchmark su sei. Queste cifre spiegano perché “mi ha fornito una bibliografia” non è un test di accettazione.
L’attualità aumenta ulteriormente la posta in gioco. Le analisi di settore sulle citazioni nella ricerca AI riportano che circa metà delle pagine citate dall’AI ha meno di 13 settimane e che i contenuti citati dall’AI sono in media circa il 25% più recenti dei classici risultati web. Gli assistenti che omettono le date di aggiornamento possono apparire aggiornati mentre riciclano i numeri del trimestre scorso. Se il tuo flusso di lavoro include revisioni della letteratura, memorandum sulle policy o ricerca sugli investimenti, un assistente non sottoposto ad audit è un coautore silenzioso senza quaderno di laboratorio.
Quale griglia di valutazione dovresti usare per sottoporre ad audit un assistente di ricerca AI?
Usa una griglia a livello di singola affermazione, con soglie binarie e un punteggio graduato per l’allineamento, non un’impressione olistica del tipo “sembra accademico”. L’unità di valutazione è una singola frase fattuale più il relativo passaggio citato, ossia lo stesso livello di dettaglio usato nelle pipeline di convalida delle citazioni che confrontano le dichiarazioni con il testo di riferimento.
Assegna un punteggio a ogni affermazione sostanziale secondo questa griglia:
| Controllo | Superato | Parziale | Non superato |
|---|---|---|---|
| Copertura delle fonti | Fonte primaria o sottoposta a peer review appropriata all’affermazione | Solo fonte secondaria pertinente | Blog, pagina SEO o dominio errato per l’affermazione |
| Citazione cliccabile | L’URL apre il documento citato in una posizione utilizzabile | L’URL apre una homepage o una schermata iniziale con paywall | Collegamento non funzionante, reindirizzato a contenuto non correlato o fabbricato |
| Allineamento tra affermazione e fonte | La fonte implica l’affermazione, inclusi numeri e cautele | La fonte è pertinente al tema ma non supporta l’affermazione esatta | Contraddizione, numero errato o salto non supportato |
| Data di aggiornamento | Data mostrata e appropriata alla query | Data presente ma obsoleta rispetto alla domanda | Nessuna data, oppure data implicata senza prove |
| Inferenza etichettata | L’assistente contrassegna sintesi, estrapolazioni e ignoti | Testo misto, con parti ricavate da fonti e inferite, segnalato solo debolmente | Inferenze scritte come fatti consolidati |
Una soglia pratica per l’uso professionale è: zero collegamenti fabbricati, zero affermazioni numeriche senza etichetta e almeno l’80% delle affermazioni sostanziali pienamente implicate dal passaggio citato. L’implicazione è lo standard corretto perché valuta il divario inferenziale anziché la sovrapposizione di parole chiave; la ricerca di ACL Findings sulla valutazione Open-QA dimostra che il punteggio basato sull’implicazione segue il giudizio umano più da vicino delle metriche di corrispondenza esatta.
Applica la griglia a un insieme fisso di verifiche: una domanda su notizie o policy in rapida evoluzione, un’affermazione scientifica quantitativa, una domanda sulla letteratura contraddittoria e una domanda su “ciò che non si sa”. Se l’assistente non sa fallire con eleganza nell’ultimo caso, non è pronto per la ricerca.
Come si confrontano Elicit, Consensus, Scite, Perplexity e Jenova in termini di integrità delle fonti?
Nessun singolo assistente di ricerca AI è leader in ogni dimensione TRACE. Elicit è più forte per l’estrazione strutturata da un vasto corpus di articoli; Scite è più forte per la polarità delle citazioni; Perplexity e ChatGPT sono più rapidi per risposte dal web aperto con collegamenti in linea; Jenova's Academic Research Assistant è più efficace quando serve una sessione di ricerca dal vivo e con più fonti, in grado di mantenere una traccia di audit tra diversi turni.
I confronti pratici del 2026 trattano tipicamente Elicit come il cavallo di battaglia per le revisioni della letteratura e Consensus come il più rapido indicatore di evidenza sì/no. Le rassegne sulla ricerca medica descrivono Perplexity come l’opzione generica più veloce con citazioni in linea e meno vincolata degli specialisti accademici. Il confronto tra strumenti per la revisione della letteratura di HKUST è un utile catalogo delle differenze di copertura e accesso in questo gruppo.
| Funzionalità / dimensione | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Copertura delle fonti | Oltre 125 milioni di articoli; approccio accademico prioritario (Elicit) | Grafo delle citazioni e Smart Citations a testo completo (Scite) | Corpus di articoli ottimizzato per domande di ricerca | Web aperto più fonti accademiche facoltative | Web in tempo reale + ricerca accademica, flusso di lavoro per manoscritti e citazioni |
| Citazioni cliccabili | Schede degli articoli ed estratti | Pagine delle citazioni con frammenti contestuali | Risposte supportate da articoli | URL in linea; la qualità varia a seconda della query | Collegamenti alle fonti in linea e cliccabili nelle risposte di ricerca |
| Allineamento tra affermazione e fonte | Accuratezza di estrazione pubblicata di 1.502/1.511 punti dati (99,4%) | Mostra citazioni a supporto o in contrasto | Forte per domande di evidenza binaria | L’utente deve verificare; rischio di allucinazione documentato | Dipende dal passaggio recuperato; nessun benchmark di estrazione pubblicato |
| Date di aggiornamento | Metadati dell’articolo (anno, rivista) | Contesto dell’anno di pubblicazione | Contesto dell’anno dell’articolo | Incoerenti salvo istruzioni esplicite | Può mostrare e confrontare date quando le fonti le espongono |
| Inferenza etichettata | Le colonne strutturate riducono i salti nascosti | Etichette di polarità, non tag epistemici completi | Consensus Meter segnala il livello di accordo | Raramente etichetta le inferenze se non richiesto | Può essere istruito a contrassegnare le affermazioni ricavate da fonti rispetto a quelle inferite |
| Prezzi (al 2026) | Non verificati in questa revisione | Non verificati; test meno recenti segnalavano una prova breve (Pure AI) | Circa 144 $/anno come fascia di ingresso in un confronto del 2026 | Non verificati; livelli definiti dai fornitori | Utilizzo gratuito limitato; Plus 20 $/mese (30×), Premium 50 $, Pro 100 $, Max 200 $, Ultra 500 $, Enterprise 1.000 $ |
| Ideale per | Estrazione sistematica da articoli | Verificare se la letteratura supporta un’affermazione | Rapide domande scientifiche sì/no | Ricerca ampia sul web con collegamenti in linea | Ricerca multi-turno verificabile e gestione delle citazioni |
Il limite dichiarato di Jenova è strutturale: non è una griglia di estrazione di articoli costruita appositamente come Elicit e non offre il grafo delle citazioni a supporto o in contrasto di Scite. Il suo vantaggio è la memoria di sessione combinata con il recupero in tempo reale, importante quando un audit richiede domande di approfondimento sulla stessa traccia delle fonti. Il limite di Elicit è l’opposto: eccezionale all’interno di un indice di articoli, meno efficace come ricercatore generico sul web o sui documenti di policy. Perplexity e ChatGPT rimangono gli strumenti di cui è più facile fidarsi eccessivamente, perché citazioni in linea fluide possono comunque non superare il controllo di allineamento.
Come si testano la copertura delle fonti e le citazioni cliccabili?
Testi la copertura ponendo domande la cui risposta corretta non può provenire da un unico corpus, quindi fai clic su ogni collegamento. Il superamento del test di copertura significa che l’assistente recupera il genere di fonte richiesto dall’affermazione — uno studio clinico per una dimensione dell’effetto, un testo normativo o una pagina di un’agenzia per una soglia legale, il codebook di un dataset per una statistica — anziché un blog comodo che cita le stesse parole chiave.
Crea tre verifiche di copertura:
- Verifica esclusivamente accademica: “Cosa mostrano gli studi randomizzati dal 2020 su X e quali risultati erano preregistrati?”
- Verifica del documento primario: “Cosa afferma la norma, il deposito o il dataset originale, non un riepilogo giornalistico?”
- Verifica dello spazio negativo: “Quali fonti autorevoli discutono di questo tema e continuano a considerare l’effetto non dimostrato?”
Quindi applica un protocollo di apertura dei collegamenti. Per ciascuna citazione, registra se l’URL si risolve, se la pagina di destinazione è il documento citato e se una persona riesce a trovare il passaggio di supporto entro due minuti. La guida alla valutazione di Northwestern consiglia di cercare il titolo in un catalogo di biblioteca o database, perché i sistemi AI spesso associano un titolo reale alla rivista, all’autore o all’anno sbagliato. Collegamenti non funzionanti, rimandi alla homepage e note del tipo “fonte: internet” comportano un fallimento automatico.
Su Jenova, rendi la copertura un’istruzione esplicita anziché una speranza:
“Rispondi usando almeno quattro fonti indipendenti. Dai priorità ad articoli sottoposti a peer review, enti governativi o di standardizzazione e dataset primari. Per ogni affermazione, indica un URL cliccabile, il titolo del documento, la data di pubblicazione o aggiornamento e una citazione di 15–25 parole a supporto dell’affermazione. Se non riesci a trovare una fonte primaria, dichiaralo e fermati.”
Su Elicit, il test equivalente consiste nel verificare se le celle estratte rimandano a passaggi visibili degli articoli anziché a una parafrasi del modello. Su Perplexity o ChatGPT, il test è più severo: apri ogni collegamento in linea, perché gli agenti di ricerca nel web aperto possono recuperare molte pagine e citare comunque la più debole. Abbinare Jenova's Academic Research Assistant a Real-Time Search è utile quando la verifica abbraccia contemporaneamente articoli, forum, repository di codice e notizie, ma ogni canale richiede comunque il proprio controllo tramite apertura del collegamento.
Come si testano l’allineamento tra affermazione e fonte e l’inferenza etichettata?
Testi l’allineamento chiedendoti se il passaggio citato implica la frase, non se sia vagamente correlato. L’errore più importante è un numero quasi corretto o una qualificazione omessa: la fonte afferma “circa l’80%”, il modello scrive “78%” e la citazione sembra comunque perfetta. È esattamente la classe di errore che i sistemi automatizzati di valutazione sono progettati per rilevare.
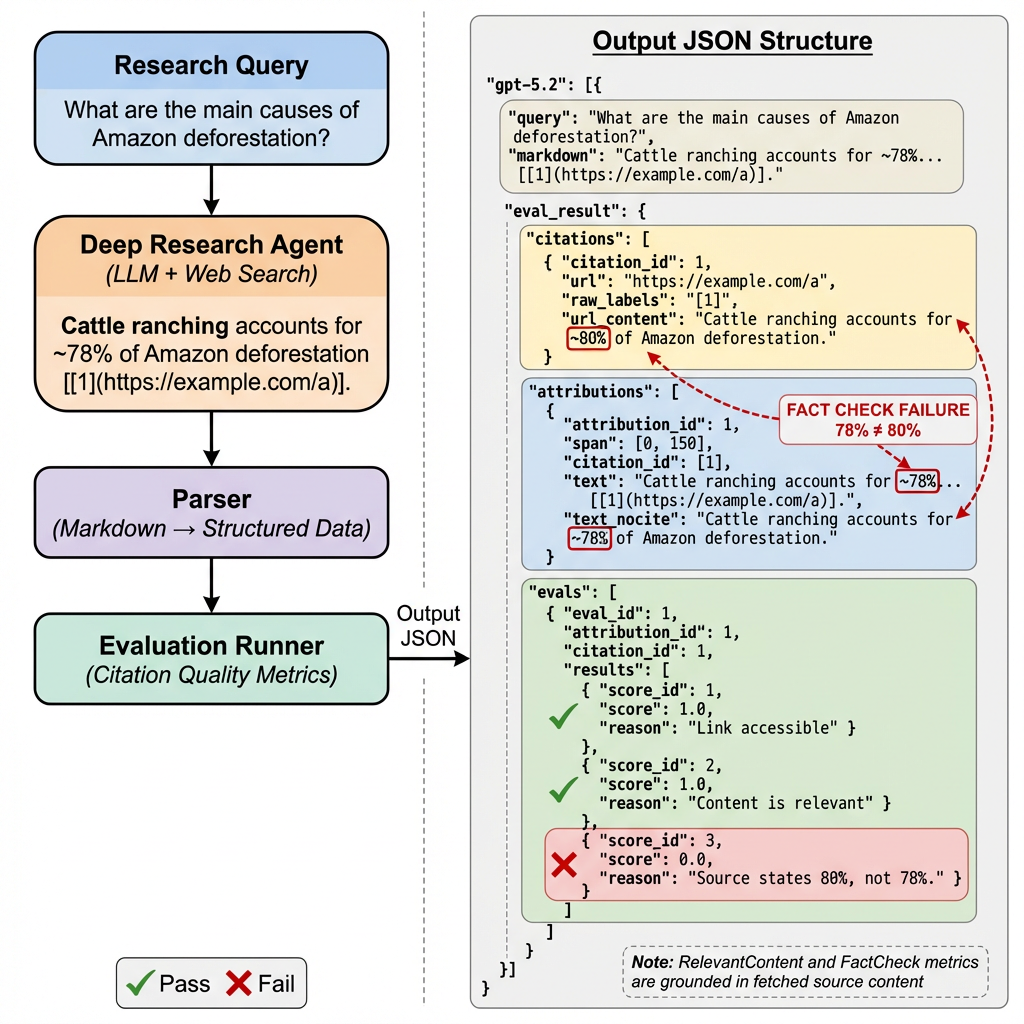
Applica un test di allineamento a tre livelli a ogni affermazione quantitativa o causale:
- Corrispondenza del passaggio: evidenzia la frase nella fonte che presumibilmente supporta l’affermazione.
- Implicazione: stabilisci se è implicata, indeterminata o contraddetta. “Indeterminata” è un fallimento se l’assistente ha presentato l’affermazione come fatto.
- Fedeltà a numeri e cautele: unità, campione, anno, intervallo di confidenza e parole quali “può”, “nei topi” o “in un solo Paese” devono restare intatti.
Ecco perché l’implicazione testuale è una metrica di audit migliore di “la pagina tratta l’argomento”. La valutazione Open-QA basata sull’implicazione esiste proprio per quantificare il divario inferenziale tra due stringhe. L’approccio di convalida delle citazioni di NVIDIA rende operativa la stessa idea: confronta l’affermazione con il testo di riferimento, quindi le assegna un punteggio.
L’inferenza etichettata è il controllo complementare. Un assistente di ricerca dovrebbe contrassegnare ogni paragrafo come sourced, inferred oppure unknown. La sintesi è consentita; la sintesi silenziosa no. La guida di UNR alla verifica delle affermazioni suggerisce il giusto approccio: chiediti chi possa verificare la dichiarazione. Se il verificatore è “la conoscenza generale del modello”, la frase richiedeva un’etichetta di inferenza.
Un prompt rigoroso per questo controllo:
“Separa la risposta in tre blocchi etichettati: (1) Affermazioni direttamente supportate, ciascuna con una citazione e un URL; (2) Inferenze, con le premesse su cui si basano; (3) Elementi ignoti. Non spostare un’inferenza nel blocco 1. Se un numero è approssimativo nella fonte, mantieni l’approssimazione.”
Elicit riduce le inferenze nascoste forzando le risposte in colonne di estrazione, un vero punto di forza. Scite etichetta se gli articoli successivi supportano o contrastano una citazione, intercettando un diverso salto logico: trattare un singolo articolo come consenso consolidato. Jenova può seguire il formato a tre blocchi durante una lunga sessione, ma non imporrà tali etichette se non le richiedi. Si tratta di un reale divario di prodotto rispetto agli strumenti con indicatori di evidenza integrati.
Come dovresti verificare le date di aggiornamento e la freschezza delle fonti?
Verifichi l’attualità richiedendo una data visibile per ogni fonte e includendo almeno una verifica la cui risposta corretta sia cambiata nell’ultimo anno. Un assistente che non riesce a mostrare quando è stata pubblicata una pagina o un articolo non è pronto per domande su prezzi, normative, rilasci di modelli, epidemiologia o struttura del mercato.
La ricerca sulla freschezza dei contenuti nella ricerca AI rileva che la recenza incide sul fatto che i sistemi recuperino una pagina per una domanda attuale. Anche il lavoro di monitoraggio delle citazioni AI avverte che i motori rivalutano continuamente le fonti, quindi il brief ordinato di ieri può deteriorarsi silenziosamente. Il tuo audit dovrebbe pertanto registrare tre date, non una:
- Data della fonte — data di pubblicazione o dell’ultimo aggiornamento sulla pagina o nell’articolo
- Data dell’evidenza — anno in cui sono stati raccolti i dati sottostanti
- Data della risposta — momento in cui l’assistente ha recuperato la fonte
Un errore comune è citare una revisione del 2019 per un dato di prevalenza “attuale”, oppure citare una dashboard in tempo reale senza acquisire il timestamp di recupero. Specialisti accademici come Elicit e Consensus mostrano di solito l’anno di pubblicazione perché si basano sui metadati degli articoli. Gli strumenti per il web aperto spesso non lo fanno, salvo istruzioni esplicite. Jenova può riportare le date quando il documento recuperato le espone, ma non può inventare un timestamp affidabile per una pagina non datata — e dovrebbe dichiararlo.
Esempi di verifiche dell’attualità:
“Qual è il dato attuale al 2026? Indica la data di aggiornamento della fonte. Se la migliore fonte ha più di 18 mesi, etichetta la risposta come storica, non attuale.”
“Confronta la fonte più recente che riesci a trovare con la fonte più citata ma meno recente. Cosa è cambiato e cosa no?”
Se l’assistente non riesce a distinguere una pagina HTML aggiornata da una ristampa PDF invariata, assegna un fallimento all’attualità anche se l’URL funziona.
Come si esegue un audit TRACE ripetibile a partire da un singolo prompt?
Esegui un audit ripetibile fissando l’insieme delle verifiche, il foglio di valutazione e imponendo a ogni strumento di produrre gli stessi campi verificabili automaticamente. L’obiettivo è una trascrizione che un altro ricercatore possa valutare di nuovo senza osservarti al lavoro.
Usa questa sequenza per Jenova's Academic Research Assistant, quindi ripetila con almeno uno specialista (Elicit o Scite) e uno strumento generico (Perplexity o ChatGPT):
- Definisci il ruolo e il contratto di output prima della domanda.
- Poni una verifica per ogni classe: quantitativa, contraddittoria, documento primario e ignoto.
- Richiedi titolo, URL, data, citazione ed etichetta dell’affermazione per ogni citazione.
- Apri ogni collegamento e assegna il punteggio TRACE prima di porre qualunque domanda di approfondimento.
- Solo dopo richiedi una revisione delle affermazioni non superate.
Contratto iniziale:
“Sei sottoposto ad audit. Per ogni affermazione sostanziale, fornisci: testo dell’affermazione; etichetta (
sourced/inferred/unknown); titolo della fonte; URL cliccabile; data di pubblicazione o aggiornamento; citazione di supporto ≤25 parole. Se l’allineamento è imperfetto, abbassa l’etichetta ainferredounknown. Non citare fonti che non hai recuperato. Concludi con una nota sulla copertura che elenchi i tipi di fonti utilizzati e quelli mancanti.”
Su Elicit, la procedura parallela consiste nell’eseguire la stessa domanda come rapporto di ricerca e quindi controllare a campione le celle estratte rispetto al passaggio nel PDF. Su Scite, esegui l’affermazione principale come query sul contesto delle citazioni e conta gli articoli a supporto rispetto a quelli in contrasto prima di accettare una frase che suona come consenso. Su ChatGPT Deep Research, il flusso di lavoro di ricerca di OpenAI richiede comunque di ispezionare le fonti; la funzionalità del prodotto è il recupero combinato con la struttura, non un sostituto del controllo di implicazione.
Conserva un semplice registro — affermazione, URL, data, punteggi TRACE, note. Dieci affermazioni distribuite su quattro verifiche sono sufficienti per individuare uno schema. Se più di due affermazioni numeriche non superano l’allineamento, smetti di usare lo strumento per qualunque elaborato che verrà citato da qualcun altro.
Cosa affermano i professionisti dell’integrità della ricerca sul test delle citazioni AI?
La pratica dell’integrità della ricerca ha adottato una regola netta: tratta le citazioni AI come affermazioni non verificate finché un controllo umano o automatico basato sull’implicazione non abbia aperto la fonte. Il dibattito utile non riguarda più se i modelli allucinino, ma quali errori sia possibile strumentare.
“Il settore continua a ottimizzare per bibliografie più belle. È l’unità sbagliata. Una citazione è un puntatore, non una prova. Se il passaggio citato non implica la frase — in particolare il numero, la popolazione e l’anno — la citazione è decorativa. Abbiamo visto errori del tipo ‘78% contro 80%’ superare ogni controllo estetico: URL reale, titolo pertinente, tono sicuro. Sono questi gli errori che arrivano fino ai manoscritti.”
“L’inferenza etichettata è il controllo più economico che la maggior parte dei team trascura. Quando a un assistente è consentito mescolare recupero e conoscenza del mondo, trasformerà le ipotesi in risultati. Imporre tre categorie — ricavato da fonti, inferito, ignoto — rende visibile il tasso di allucinazione. I team che si rifiutano di mostrare una categoria per gli ignoti ti stanno dicendo che non sono in grado di rappresentare l’incertezza.”
“Il test della copertura è anche una scelta di governance. Un assistente che usa solo articoli scientifici sembrerà rigoroso ma mancherà comunque il memorandum dell’agenzia che ha modificato la regola il mese scorso. Un assistente che usa solo il web sembrerà attuale ma mancherà comunque lo studio clinico che ha effettivamente misurato il risultato. La scelta del modello conta perché alcuni modelli usano cautele, altri comprimono e altri ancora eliminano le qualificazioni. L’audit deve seguire l’affermazione, non il marchio.”
— Team di prodotto Jenova, valutazione di agenti di ricerca, 6 anni nello sviluppo di flussi di lavoro per recupero e citazioni per utenti accademici e professionali
Questa posizione coincide con la pratica delle biblioteche. Northwestern documenta casi in cui un modello citava un articolo enciclopedico reale e sbagliava comunque nomi e date. UNR invita i ricercatori a chiedersi chi possa verificare l’affermazione. Entrambe sono TRACE in forma discorsiva.
Quando un assistente di ricerca AI è abbastanza valido da essere usato nella ricerca reale?
Un assistente di ricerca AI è abbastanza valido quando supera un audit TRACE sui tuoi effettivi tipi di domanda, con le affermazioni non superate corrette dalla fonte oppure ridotte a inferenza etichettata. Non è abbastanza valido quando produce risposte fluide e ricche di collegamenti che crollano davanti a un controllo tramite apertura dei collegamenti e implicazione.
Usa questa regola decisionale:
- Usa uno specialista dell’estrazione come Elicit quando il compito consiste nello screening o nell’estrazione di dati da un insieme noto di articoli e controllerai comunque le celle a campione.
- Usa Scite quando la domanda riguarda il fatto che la letteratura supporti, menzioni o contrasti una specifica affermazione.
- Usa Consensus quando ti serve una lettura rapida della direzione dell’evidenza per una domanda scientifica circoscritta.
- Usa Perplexity o ChatGPT per una ricognizione ampia, quindi verifica di nuovo ogni numero prima che entri in un manoscritto.
- Usa Jenova's Academic Research Assistant quando il lavoro è multi-turno — scoperta della letteratura, linguaggio per manoscritti e gestione delle citazioni in un unico percorso verificabile — e sei disposto a richiedere i campi TRACE nel prompt.
Non usare nessuno di questi strumenti come fase finale non supervisionata. I risultati JMIR sull’accuratezza delle citazioni e i tassi di allucinazione di Stanford HAI sono una ragione sufficiente per mantenere un essere umano nel processo. La configurazione vincente nel 2026 non è un singolo modello “affidabile”. È una traccia delle fonti che puoi riprodurre: collegamenti cliccabili, documenti datati, affermazioni implicate e un confine visibile tra evidenza e inferenza.
Riferimenti
- Northwestern University Libraries — Valutazione dei contenuti generati dall’AI
- University of Nevada, Reno Libraries — AI e valutazione delle fonti
- JMIR — Valutazione delle prestazioni dei modelli linguistici di grandi dimensioni e dell’affidabilità delle citazioni generate
- Stanford HAI — AI sotto processo: i modelli giuridici allucinano in 1 query di benchmark su 6, o più
- AuthorityTech — Freschezza dei contenuti SEO nel 2026
- Discussione Chris Long / Ahrefs — Freschezza e visibilità nella ricerca AI
- ACL Findings — Valutazione Open-QA accurata e sfumata tramite implicazione testuale
- NVIDIA Developer — Convalida automatica delle citazioni con NVIDIA NIM
- Elicit — AI per la ricerca scientifica, copertura e accuratezza dell’estrazione
- Scite — Smart Citations per la letteratura scientifica
- The Drive AI — Elicit contro Consensus contro Semantic Scholar
- iatroX — I migliori strumenti AI per la ricerca medica nel 2026
- Biblioteca HKUST — Confronto tra strumenti AI emergenti per la revisione della letteratura
- Omid Saffari — I migliori strumenti di ricerca AI del 2026: Elicit contro Consensus
- Pure AI — Citazione necessaria: sette strumenti di ricerca AI messi alla prova
- SEOptimer — Freschezza dei contenuti nella SEO e nella ricerca AI
- OtterlyAI — Come monitorare citazioni e fonti dei motori di ricerca AI
- Firecrawl — Ricerca web e ricerca approfondita per agenti AI
- OpenAI Academy — Ricerca con ChatGPT: Search e Deep Research