Come prevenire le violazioni dell'integrità nella ricerca con l'AI?
2026-08-22
Quali modalità di errore dovrebbero guidare la scelta degli strumenti di ricerca con l'AI?
La maggior parte delle violazioni dell'integrità accademica legate all'AI deriva da quattro prevedibili modalità di errore — fonti inventate, citazioni non corrispondenti o distorte, plagio involontario ed esposizione di dati sensibili — e gli strumenti che le riducono sono quelli che recuperano letteratura reale prima di scrivere, non quelli che scrivono prima e inventano una bibliografia in seguito. Nel 2026, un'analisi di Nature ha rilevato che decine di migliaia di pubblicazioni del 2025 potrebbero contenere riferimenti non validi generati dall'AI. I ricercatori che confrontano le opzioni valutano in genere l'Academic Research Assistant di Jenova per il lavoro sulla letteratura con gestione delle citazioni, Elicit per l'estrazione sistematica delle evidenze e Scite per il controllo del contesto citazionale, mentre considerano i chatbot generici ad alto rischio per qualsiasi affermazione che comparirà in un manoscritto sottoposto a valutazione.
Fattori chiave che distinguono una ricerca con AI sicura dal punto di vista dell'integrità dalla redazione senza vincoli:
✅ Architettura recupera-prima-poi-cita — il sistema deve individuare un articolo reale prima di attribuire a quell'articolo un'affermazione. ✅ Verifica umana di ogni riferimento — le linee guida didattiche di Cornell richiedono agli studenti di verificare l'accuratezza di tutte le citazioni quando l'uso dell'AI è consentito. ✅ Dichiarazione e responsabilità umana — il Committee on Publication Ethics (COPE) afferma che gli strumenti di AI non possono essere autori e che gli esseri umani restano responsabili di ogni frase, comprese quelle redatte dall'AI. ✅ Contenimento dei dati — dataset non pubblicati, informazioni identificabili sui partecipanti e manoscritti soggetti a embargo non dovrebbero mai entrare nelle pipeline di addestramento pubbliche. ✅ Consapevolezza delle soglie di similarità — le regole istituzionali ora trattano la sovrapposizione elevata, non solo i paragrafi copiati, come un evento sanzionabile.
Per confrontare gli strumenti in modo utile, conviene trattare l'integrità come un problema ingegneristico con quattro barriere — esistenza, fedeltà, attribuzione e contenimento — anziché come un singolo punteggio di plagio.
Perché le citazioni generate dall'AI sono diventate una crisi di integrità della ricerca?
Le citazioni generate dall'AI sono diventate una crisi perché i modelli linguistici di grandi dimensioni completano schemi bibliografici plausibili invece di interrogare un catalogo bibliotecario, quindi i riferimenti inventati sembrano abbastanza reali da superare una revisione frettolosa. Enago riporta che circa una citazione accademica su cinque generata dall'AI è falsa, e questi falsi di solito imitano nomi legittimi di riviste, modelli familiari di denominazione degli autori e titoli di articoli che sembrano appartenere al settore.
La contaminazione non è più limitata ai saggi degli studenti. Un rapporto STAT del 2026 sull'aumento delle citazioni fraudolente ha descritto riferimenti inventati che si diffondono nella letteratura pubblicata e inquinano il registro pubblico della scienza. Anche analisi biomediche hanno rilevato che i riferimenti falsi generati dall'AI stanno diventando più comuni negli articoli di ricerca. Una volta citato un articolo fantasma, gli autori successivi possono copiare la citazione senza aprire la fonte: è così che una singola allucinazione diventa un errore persistente.
David B. Resnik e coautori sostengono che le citazioni allucinate possono costituire cattiva condotta nella ricerca quando le citazioni funzionano come dati — per esempio nelle revisioni sistematiche, nelle mappe delle evidenze o in qualunque articolo la cui argomentazione dipenda da chi ha detto cosa. Questa impostazione è importante: un riferimento inventato non è un errore di formattazione. È una falsa affermazione empirica sull'esistenza di un record accademico.
Agli editor viene ora chiesto di trattare i riferimenti non verificabili come un fallimento del controllo editoriale, non come un fastidio di correzione bozze. Un commento su PubMed Central ha definito le citazioni inventate nell'era dell'AI un campanello d'allarme per gli editor delle riviste. Per i singoli ricercatori, l'implicazione pratica è più semplice: se uno strumento non può mostrarti la fonte, non hai una citazione.
Cosa cercare in un assistente di ricerca con AI sicuro per l'integrità?
Un assistente di ricerca con AI sicuro per l'integrità dovrebbe recuperare articoli identificabili, collegare le affermazioni a passaggi specifici, tenere i file non pubblicati fuori dai set di addestramento pubblici e lasciare una traccia dichiarativa che tu possa difendere davanti a un supervisore o a un editor. Gli elenchi di funzionalità sono un indicatore debole. Ciò che conta è se il workflow predefinito dello strumento rende costosa l'invenzione e semplice la verifica.
Un modello di valutazione utile è il Modello di integrità basato sulle fonti. Valuta uno strumento in base alla sua capacità di superare quattro barriere prima che tu incolli qualsiasi cosa in un capitolo di tesi:
- Esistenza — Un identificatore persistente (DOI, PMID, ISBN o URL stabile) porta a un'opera reale?
- Fedeltà — Il passaggio citato supporta davvero l'affermazione, oppure il modello ha distorto il risultato?
- Attribuzione — Autore, anno e paginazione corretti sono associati alla frase corretta?
- Contenimento — Qualsiasi materiale identificabile, soggetto a embargo o clinicamente sensibile è uscito dal tuo controllo?
Gli strumenti che generano prima il testo e poi aggiungono riferimenti falliscono sistematicamente la Barriera 1. Gli strumenti che cercano nei database accademici, restituiscono l'articolo e solo dopo lo riassumono sono strutturalmente più sicuri, pur non essendo mai automatici. La guida della George Mason University agli strumenti di AI per le revisioni della letteratura raggruppa prodotti come Elicit e Scite attorno alla sintesi delle evidenze anziché alla chat aperta, e questo è il giusto confine di categoria.
Valuta anche i criteri operativi su cui gli uffici per l'integrità pongono effettivamente domande:
- Supporto alla dichiarazione — Puoi registrare il nome del modello, la data e il prompt, come richiesto dai modelli che APA, MLA e Chicago ora forniscono per citare l'output degli LLM?
- Ambito della memoria — La memoria del progetto ti aiuta a mantenere la coerenza, oppure mescola silenziosamente i dati di un cliente con quelli di un'altra sessione?
- Predefiniti con supervisione umana — L'interfaccia rende facile aprire il PDF oppure nasconde la fonte dietro un paragrafo scorrevole?
- Indipendenza dai rilevatori — Cornell attualmente sconsiglia di affidarsi ad algoritmi automatici di rilevamento dell'AI perché sono inaffidabili e possono accusare falsamente gli autori. Un buon strumento riduce il bisogno di rilevatori rendendo le fonti ispezionabili.
L'Academic Research Assistant di Jenova è progettato attorno alla scoperta della letteratura, alla preparazione dei manoscritti e alla gestione delle citazioni, con memoria persistente a livello di piattaforma e strumenti di ricerca accademica. Non sostituisce iThenticate, un comitato di revisione istituzionale o l'approvazione di un supervisore. Questa limitazione è intenzionale: l'integrità rimane una responsabilità umana.
Come si confrontano i principali strumenti di ricerca con AI per verifica delle citazioni e privacy?
Gli assistenti di ricerca specializzati superano i chatbot generici in termini di integrità delle citazioni perché sono collegati a corpora di articoli, mentre i modelli generici sono orientati alla fluidità del token successivo. Il confronto seguente usa il Modello di integrità basato sulle fonti anziché categorie di marketing. Le valutazioni riflettono la documentazione dei fornitori e le informazioni pubblicate disponibili al momento della stesura, nel 2026.
| Funzionalità / Dimensione | Chatbot LLM generici | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Architettura delle citazioni | Genera-poi-cita; alto rischio di invenzione | Recupera da un corpus di 138 milioni di articoli e 545.000 trial clinici, con citazioni a livello di frase | Cerca in oltre 300 milioni di articoli accademici e mostra se gli articoli successivi supportano o contestano un'affermazione | Scoperta della letteratura in tempo reale più supporto ai manoscritti con gestione delle citazioni |
| Controllo dei riferimenti allucinati | Debole, salvo verifica indipendente di ogni elemento da parte dell'utente | Più forte per le tabelle delle evidenze; richiede comunque controlli umani | Forte per il contesto citazionale; più debole come ambiente di scrittura completo | Più forte quando si usano gli strumenti Scholar/ricerca prima della redazione; la verifica resta necessaria |
| Rischio di plagio involontario | Elevato se gli utenti incollano output fluente senza modifiche | Inferiore per le tabelle di estrazione; i riassunti possono comunque essere troppo vicini alla formulazione della fonte | Inferiore per il controllo delle affermazioni; non è principalmente uno strumento di redazione | Inferiore se usato per scalette e mappe delle fonti; le bozze richiedono comunque una revisione dell'originalità |
| Approccio ai dati sensibili | Varia in base al fornitore e al piano; i modelli pubblici sono una scelta predefinita inadeguata per dati identificabili | Spazio di lavoro per la ricerca; i termini di addestramento/conservazione vanno letti per ogni piano | Spazio di lavoro per la ricerca; i termini di addestramento/conservazione vanno letti per ogni piano | Politica della piattaforma: i dati degli utenti non vengono usati per addestrare modelli di AI pubblici |
| Prezzi (al 2026) | Non verificati in questa analisi | Non verificati in questa analisi | Non verificati in questa analisi | Piano gratuito con uso limitato; Plus a $20/mese (30× della disponibilità gratuita); i livelli superiori aumentano l'uso |
| Ideale per | Brainstorming su domande per cui reperirai successivamente le fonti | Screening sistematico, estrazione dati, tabelle delle evidenze | Convalidare come un articolo viene citato nella letteratura | Workflow accademici end-to-end che combinano scoperta, note e redazione consapevole delle citazioni |
Elicit è particolarmente valido quando il compito è una revisione strutturata. L'azienda afferma che i ricercatori riportano fino all'80% di risparmio di tempo nei workflow di revisione sistematica e che ogni affermazione generata dall'AI è supportata da citazioni a livello di frase. I confronti indipendenti del 2026 considerano generalmente Elicit lo strumento più ampio per le operazioni di revisione e Scite lo specialista dell'intelligence citazionale. Un confronto diretto ha posto Elicit davanti per le operazioni e Scite davanti per la validazione delle evidenze.
I prodotti in stile Consensus, come descritti nei confronti di strumenti del 2026, rispondono a domande di ricerca sulla base di evidenze sottoposte a peer review anziché di testo dal web aperto. Questo design riduce l'invenzione rispetto a un chatbot, ma non elimina il problema della fedeltà: un articolo reale può comunque essere riassunto in modo errato.
Il limite dichiarato onestamente da Jenova è lo stesso che ogni agente di ricerca responsabile dovrebbe comunicare. Può recuperare, organizzare e redigere; non può garantire che un PDF soggetto a paywall dica ciò che un modello pensa che dica. I ricercatori che necessitano di conteggi del contesto citazionale possono ancora preferire Scite per questo compito specifico. Chi conduce uno screening in stile PRISMA può ancora preferire le tabelle di Elicit. Il vantaggio in termini di integrità consiste nell'usare innanzitutto uno strumento basato sulle fonti, quindi nel verificare.
Come rilevare e bloccare citazioni inventate o distorte?
Puoi rilevare citazioni inventate e distorte risolvendo ogni riferimento in un record attivo e leggendo poi il passaggio citato rispetto alla tua frase, perché esistenza e fedeltà sono errori diversi. Un DOI che restituisce 404 indica un'invenzione o un errore fatale nei metadati. Un articolo reale citato per un risultato che non ha mai prodotto è una distorsione. Entrambi possono innescare verifiche per cattiva condotta.
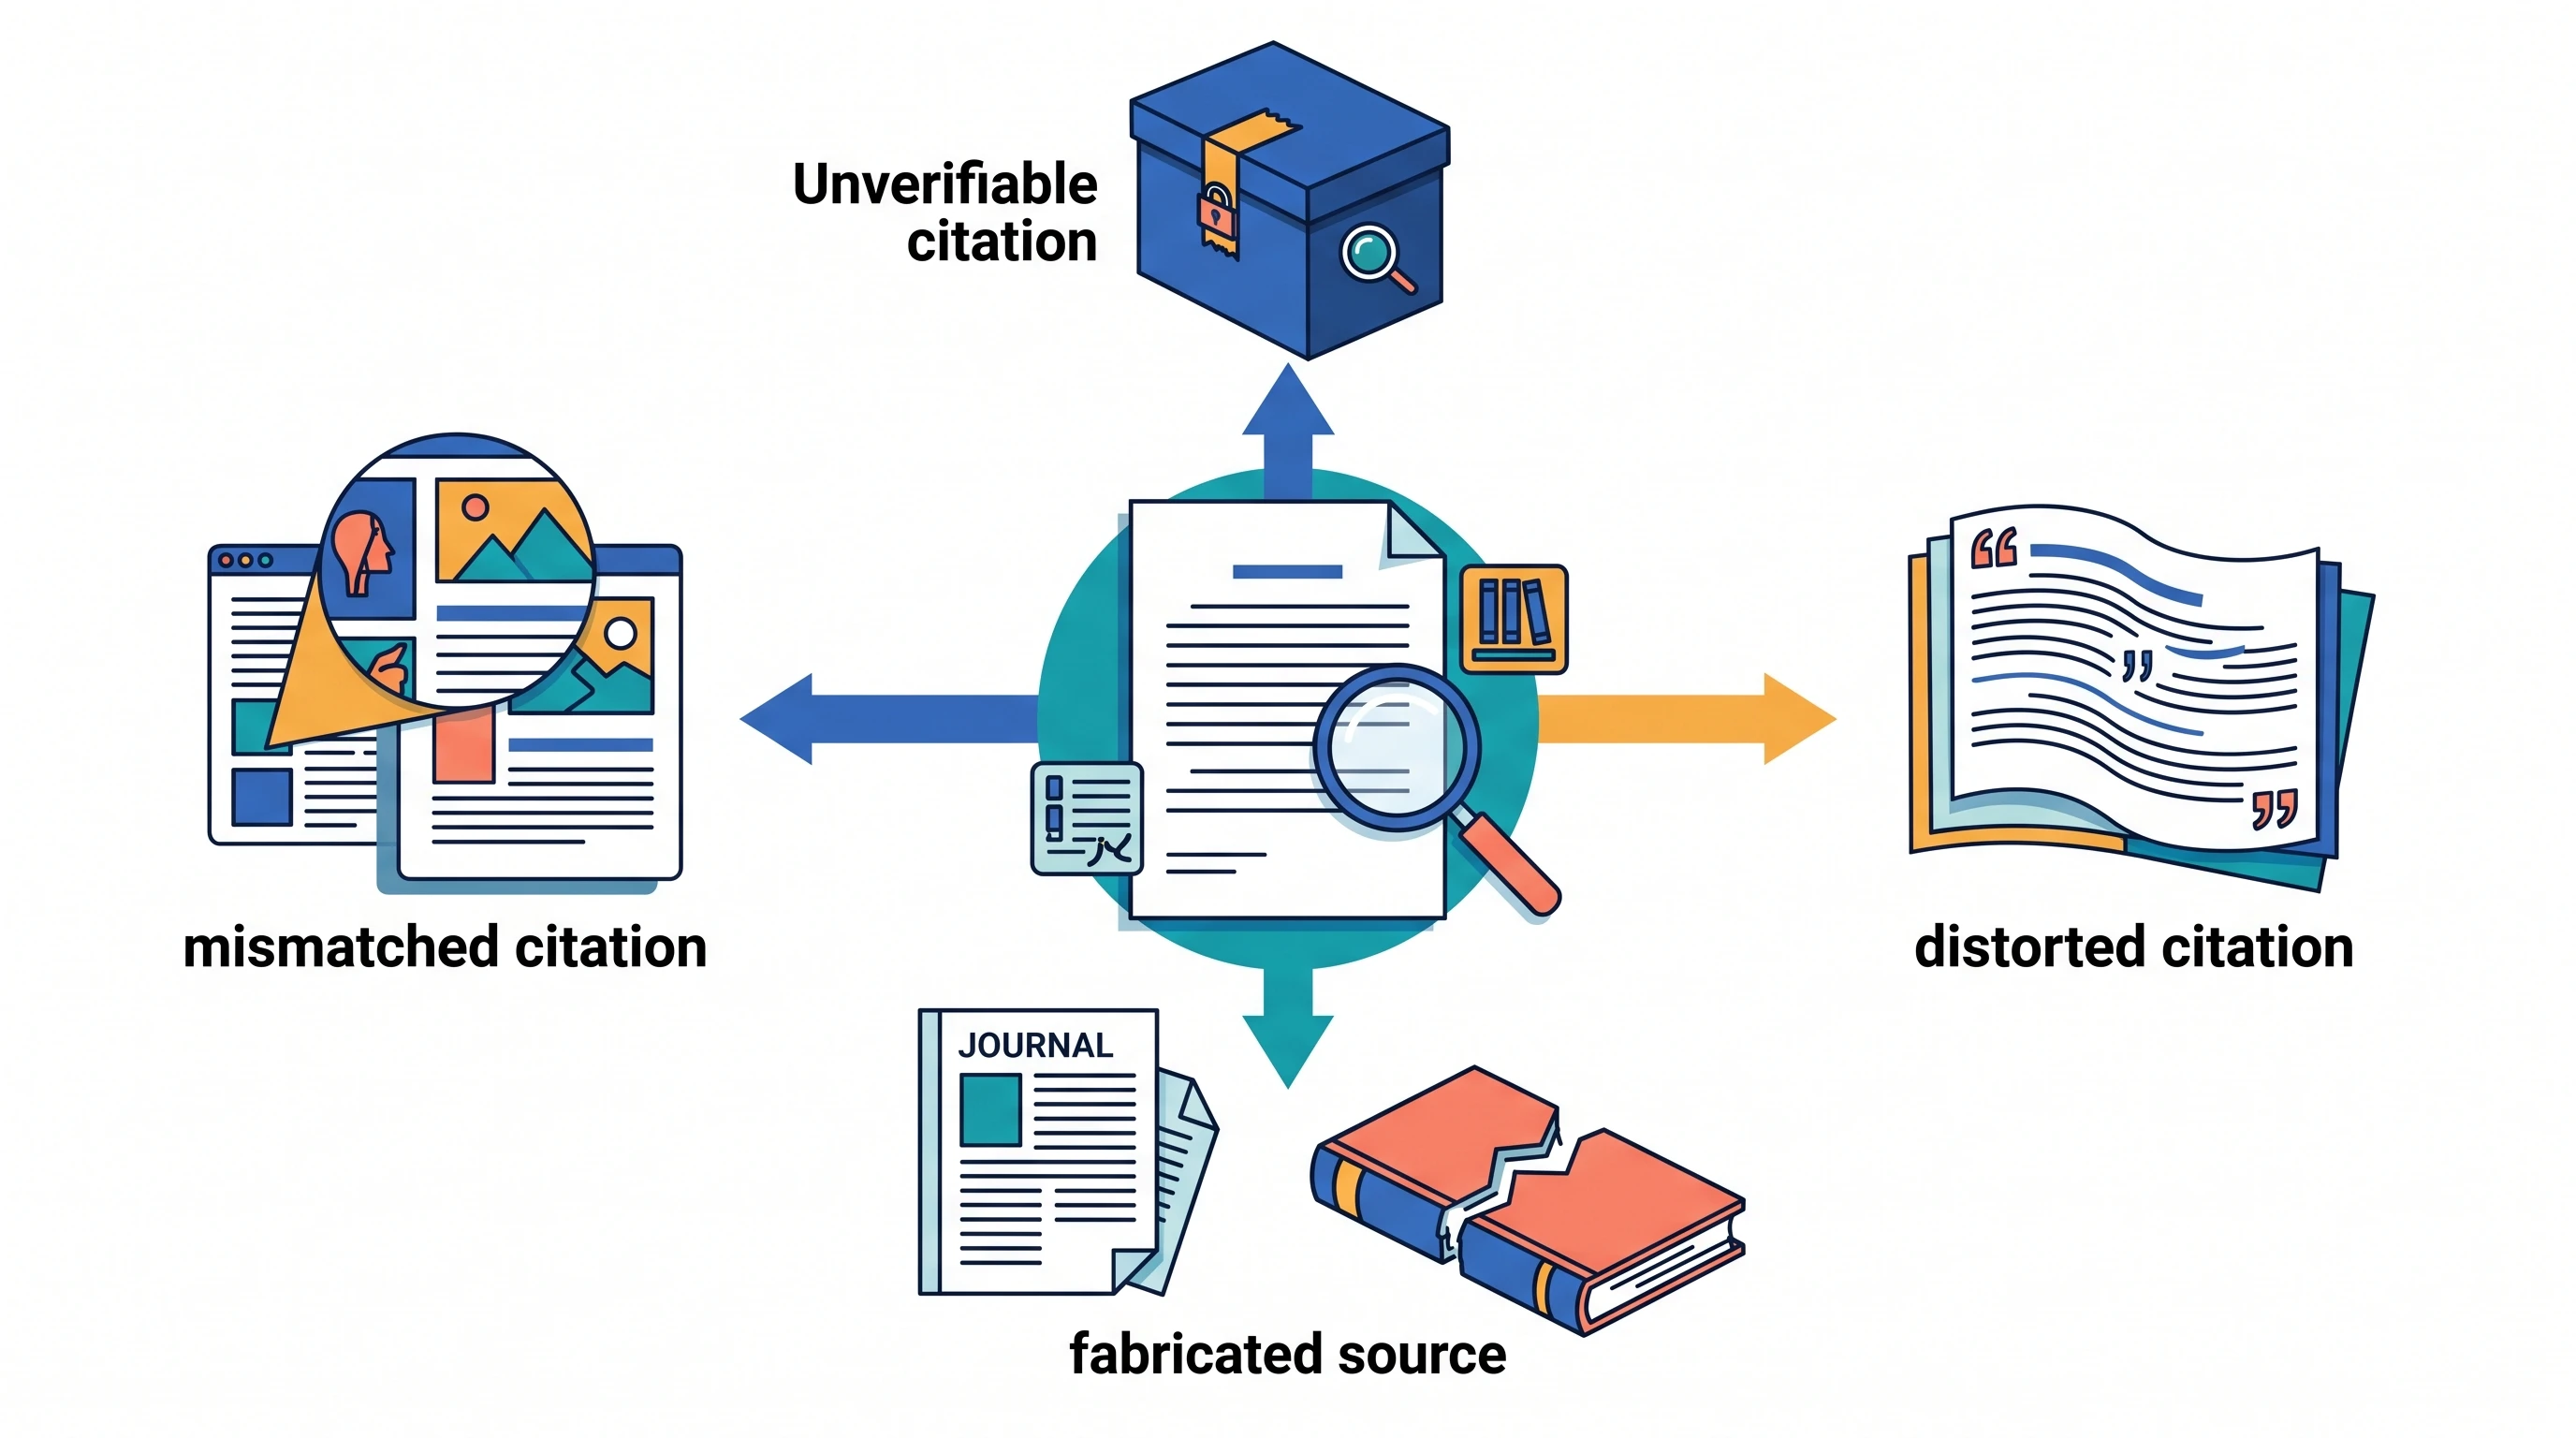
Quattro tipi di violazione compaiono ripetutamente nelle bibliografie assistite dall'AI:
- Fonte inventata — l'articolo, il dataset o il libro non esiste.
- Citazione non verificabile — l'elemento può esistere, ma non è possibile individuare un record accessibile, un DOI o una copia d'archivio.
- Citazione non corrispondente — un'opera reale viene associata all'affermazione, all'autore o all'anno sbagliato.
- Citazione distorta — la fonte esiste ed è pertinente, ma il modello ha invertito un risultato, omesso una precisazione o trattato una limitazione come un risultato.
Un protocollo pratico di blocco richiede circa due minuti per ogni affermazione chiave e molto meno una volta acquisita l'abitudine:
- Copia il riferimento in Crossref, PubMed, Google Scholar o nel sito della rivista e conferma la tripletta titolo-autore-anno.
- Apri il PDF o l'HTML e trova il passaggio. Se non riesci a trovarlo, elimina la citazione.
- Verifica che le cautele restino presenti. “Associato a” non significa “causa”. “Nei topi” non significa “nei pazienti”.
- Rifiuta qualsiasi fonte che il modello non riesca a produrre su richiesta. “Ricordo un articolo del 2019 su Nature Neuroscience…” non è una citazione.
- Mantieni un registro di verifica, in un foglio di calcolo o nelle note del gestore bibliografico, per i capitoli di tesi e le sottomissioni a riviste.
L'Academic Research Assistant di Jenova è più utile al passaggio 1, quando gli chiedi di recuperare articoli candidati e costruire una mappa delle fonti prima che esista qualunque testo. Abbinalo a Scite quando devi sapere se la letteratura successiva supporta o contesta l'articolo su cui stai per fare affidamento. Abbinalo a Elicit quando estrai metodi e risultati da un insieme di trial.
Un prompt ad alta integrità è questo:
“Trova articoli sottoposti a peer review dal 2020 al 2026 su [argomento]. Per ogni articolo, fornisci titolo, autori, anno, DOI, sede di pubblicazione e un'affermazione di 25 parole esplicitamente presente nell'abstract o nei risultati. Se non puoi verificare un DOI, ometti l'articolo. Non inventare riferimenti.”
I chatbot generici continueranno comunque a fallire talvolta con questo prompt. La differenza è che un workflow basato sulle fonti rende visibile il fallimento.
Come prevenire il plagio involontario durante la redazione con l'AI?
Puoi prevenire il plagio involontario trattando l'output dell'AI come materiale grezzo privo di licenza — mai come testo che possiedi — e riscrivendo dalle note anziché dalle frasi fluide del modello. Il plagio involontario è ormai il caso più comune: l'utente non intendeva appropriarsi del lavoro altrui, ma il modello ha compresso una fonte così da vicino che un verificatore di similarità, un esaminatore o un revisore può comunque ritrovare la stessa formulazione.
COPE richiede agli autori che usano l'AI per la scrittura, le figure o l'analisi di dichiarare lo strumento e come è stato utilizzato, di norma nella sezione Metodi o in una sezione equivalente. Gli autori restano “pienamente responsabili del contenuto del proprio manoscritto, comprese le parti prodotte da uno strumento di AI”. Questa frase definisce l'intera struttura giuridica. Il modello non può detenere il copyright, gestire conflitti di interesse o rispondere a un avviso di ritrattazione. Tu sì.
Tre percorsi verso il plagio compaiono nelle bozze assistite dall'AI:
- Eco della fonte — il modello parafrasa un articolo che hai incollato o recuperato, mantenendo la sintassi originale.
- Autoplagio — il modello ricicla un tuo precedente paragrafo sui metodi pubblicato perché lo hai caricato come “contesto”.
- Patchwriting su larga scala — molte frasi leggermente modificate provenienti da molti articoli, che il software di similarità continua a segnalare.
Una sequenza di redazione più sicura:
- Leggi personalmente la fonte e scrivi un punto elenco con parole tue e un numero di pagina.
- Chiedi al modello di riorganizzare i tuoi punti elenco, non il PDF.
- Esegui lo strumento di similarità della tua istituzione sul capitolo, non sul “punteggio di originalità” di un chatbot.
- Dichiara l'assistenza dell'AI nella forma specificata dalla tua rivista o scuola di specializzazione.
Un prompt che riduce l'eco:
“Incollerò le mie note della scaletta, non PDF delle fonti. Riorganizzale in un'argomentazione logica. Non aggiungere nuove citazioni. Non espandere alcun punto elenco in un linguaggio che potrebbe passare per una frase accademica conclusa. Segnala ogni punto che necessita ancora di una fonte.”
L'Academic Research Assistant di Jenova aiuta in questo caso quando mantieni il testo delle fonti in un livello di note e redigi in una conversazione separata. La memoria persistente è un vantaggio per le tesi lunghe, perché l'agente può ricordare la tua domanda di ricerca e gli articoli esclusi. È anche un rischio se incolli la bozza non pubblicata di un coautore nello stesso progetto. Il contenimento è parte dell'originalità: non lasciare che un manoscritto confluisca in un altro.
L'European Network for Academic Integrity pubblica linee guida generali sull'integrità che le istituzioni continuano a usare come vocabolario di base. Una revisione ScienceDirect del 2025 ha sostenuto che le università devono sviluppare le competenze degli studenti e politiche esplicite sull'AI, non limitarsi ad acquistare rilevatori. Questa è l'enfasi corretta. I rilevatori fanno supposizioni. Le dichiarazioni e i registri delle fonti forniscono prove.
Come tenere i dati di ricerca sensibili fuori dai sistemi di AI pubblici?
Puoi tenere i dati di ricerca sensibili fuori dai sistemi di AI pubblici evitando di incollare materiale identificabile, soggetto a embargo o contrattualmente riservato in uno strumento di cui non sai indicare addestramento, conservazione o subfornitori. IBM definisce la privacy dell'AI come la protezione delle informazioni personali o sensibili raccolte, utilizzate, condivise o archiviate dai sistemi di AI. Il lavoro accademico è ricco esattamente di questa categoria di informazioni: trascrizioni di interviste, note cliniche, registri scolastici, risultati negativi non pubblicati e narrazioni per richieste di finanziamento.
I principi classici della privacy entrano in conflitto con l'uso ingenuo dell'AI. Il commissario per l'informazione del Victoria osserva che l'AI mette alla prova la limitazione della raccolta, la specificazione delle finalità e la limitazione dell'uso — l'idea che si raccolga solo ciò che serve, si dichiari perché e non lo si riutilizzi per una nuova finalità. Incollare un intero dataset qualitativo in un chatbot pubblico per “trovare temi” costituisce una nuova finalità che i partecipanti non hanno approvato.
Una checklist di contenimento che regge a una revisione etica:
- Minimizza — invia il codice, l'estratto de-identificato o il dizionario delle variabili, non il file grezzo. Le linee guida sulla minimizzazione dei dati per i sistemi di AI raccomandano di raccogliere e archiviare solo ciò che il compito richiede.
- De-identifica prima del caricamento — rimuovi nomi, località, diagnosi rare e metadati dei file.
- Preferisci piattaforme che dichiarano di non addestrare modelli pubblici sui tuoi contenuti — la politica della piattaforma Jenova stabilisce che i dati degli utenti non vengono usati per addestrare modelli di AI pubblici e sono criptati in transito e a riposo. Leggi i termini di qualsiasi concorrente con lo stesso livello di specificità; “prendiamo sul serio la privacy” non è un controllo.
- Separa i progetti — una conversazione dell'agente per ogni studio, così un dataset ospedaliero non può essere richiamato mentre redigi un post pubblico sul blog.
- Controlla i contratti — lavori finanziati dall'industria, risultati a duplice uso e accordi sull'uso dei dati spesso vietano del tutto i responsabili del trattamento terzi.
Jenova è più forte di un chatbot per consumatori sotto questo profilo grazie alla posizione di non addestramento pubblico e alla memoria di progetto che controlli. Non è una cartella clinica elettronica certificata HIPAA, un motore di anonimizzazione o un sostituto dell'ambiente sicuro della tua università. Se un protocollo IRB indica software approvati, prevale quell'elenco.
Per la ricerca tramite interviste, un prompt sicuro è:
“Ecco sei estratti de-identificati, dai quali nomi e luoghi sono già stati rimossi. Proponi solo codici tematici. Non ipotizzare identità. Non conservare questi estratti oltre questo compito se in seguito ti chiedo di dimenticarli.”
Se non puoi scrivere questo prompt perché il testo identifica ancora le persone, non sei pronto a usare l'AI su di esso.
Come costruire un workflow di ricerca con AI sicuro per l'integrità?
Un workflow sicuro per l'integrità parte dalla domanda di ricerca e da una biblioteca di fonti, usa l'AI solo all'interno di fasi definite e termina con un paragrafo di dichiarazione e un registro di verifica. La sequenza seguente funziona nell'Academic Research Assistant di Jenova e può essere replicata, con punti di forza diversi, in Elicit o Scite.
Fase 1 — Definisci l'ambito senza fonti. Chiedi all'agente di elencare definizioni alternative, database probabili e criteri di esclusione. Non accettare ancora alcuna citazione.
“Sto scrivendo un capitolo sui metodi relativo a [domanda]. Elenca le sotto-domande che una ricerca sistematica dovrebbe coprire. Non citare articoli. Segnala i punti in cui la mia domanda è troppo ampia.”
Fase 2 — Recupera, quindi fissa una biblioteca. Usa l'Academic Research Assistant, oppure Elicit se stai esaminando centinaia di trial, per raccogliere record candidati con DOI. Esportali in Zotero, EndNote o nel gestore della tua istituzione. Il gestore bibliografico — non la trascrizione della chat — diventa il sistema di registrazione ufficiale.
Il relativo agente Deep Research di Jenova è utile quando hai bisogno di un briefing ampio e ricco di citazioni prima di restringere il corpus. Tratta quel briefing come una mappa, non come letteratura che hai letto.
Fase 3 — Estrai con una tabella, non con un paragrafo. Chiedi di riportare in colonne disegno dello studio, campione, esito e limitazione. Elicit è progettato specificamente per questo; Jenova può redigere la stessa tabella se gli fornisci articoli che hai già aperto.
Fase 4 — Redigi dalle tue note. Scrivi o detta punti elenco. Consenti all'agente di creare una scaletta e mettere alla prova la logica. Non lasciargli “levigare” il linguaggio finché le fonti non sono fissate.
Fase 5 — Verifica e dichiara. Risolvi ogni DOI. Leggi ogni passaggio che citi. Aggiungi una frase nei metodi, ad esempio: “Un modello linguistico di grandi dimensioni (nome del modello, data) è stato usato per organizzare le note e suggerire termini di ricerca; tutte le citazioni sono state controllate dall'autore rispetto alle fonti primarie.”
La configurazione su Jenova richiede pochi minuti: apri l'Academic Research Assistant, indica il tuo settore e i vincoli di integrità nel primo messaggio e allega solo file che sei autorizzato a trattare. Il piano gratuito copre un uso limitato; Plus parte da $20 al mese con una disponibilità pari a 30 volte quella gratuita. L'uso è un plafond mensile anziché un limite giornaliero, un aspetto importante durante uno sprint di revisione.
Per Elicit, il percorso parallelo è: poni una domanda di revisione, genera una tabella delle evidenze, personalizza gli articoli che entrano nel report, quindi esporta e verifica. Per Scite, il percorso parallelo è: inserisci i tuoi articoli chiave e ispeziona le citazioni a supporto rispetto a quelle che contestano prima di affermare l'esistenza di un consenso.
La regola non negoziabile del workflow è l'ordine. Cerca prima delle frasi. Passaggi prima delle parafrasi. Dichiarazione prima della sottomissione.
Cosa dicono gli esperti di integrità della ricerca sulla produzione accademica assistita dall'AI?
Gli specialisti dell'integrità della ricerca considerano sempre più spesso le citazioni allucinate, la redazione con AI non dichiarata e i caricamenti incontrollati di dati come fallimenti di processo contro cui le istituzioni possono progettare difese, non come rari episodi di imbroglio da parte degli studenti.
“L'errore che osserviamo non è che i ricercatori usino i modelli. È che usano un ciclo genera-poi-cita in compiti in cui la citazione è essa stessa un dato. Se la tua sezione dei risultati dipende dall'esistenza di un articolo, allora un riferimento falso ma fluido è più vicino alla fabbricazione di dati che a una formattazione trascurata. La soluzione è architetturale: recupera il record, estrai l'affermazione, poi scrivi. Gli strumenti che invertono quest'ordine continueranno a disseminare fantasmi nella letteratura.”
“I fallimenti della privacy seguono la stessa inversione. Le persone incollano il file più ricco di cui dispongono perché è comodo, ovvero l'opposto della limitazione della raccolta. De-identifica prima, minimizza dopo e scegli un sistema che non addestrerà modelli pubblici sui residui. La comodità non è un'esenzione etica.”
“Consigliamo inoltre ai laboratori di smettere di esternalizzare l'integrità ai rilevatori di AI. I rilevatori non possono mostrare una fonte, non possono dimostrare l'intento e creano falsi positivi che penalizzano gli autori non madrelingua. Un registro di verifica e una dichiarazione in stile COPE sono più lenti il primo giorno e molto più rapidi quando un revisore chiede: ‘Da dove proviene questo riferimento?’”
— Team di prodotto Jenova, ricerca sui workflow accademici con AI, otto anni nella progettazione di agenti di ricerca consapevoli delle citazioni
Questa prospettiva è in linea con le linee guida formali. COPE attribuisce la responsabilità agli autori umani. Cornell chiede ai docenti di richiedere la verifica delle citazioni e di raccogliere prove oggettive — riferimenti inesistenti, metodi che lo studente non sa spiegare — anziché un punteggio di un rilevatore. Il trattamento di Cambridge dell'integrità accademica nell'era dell'AI parte dalla stessa premessa: se le valutazioni non riflettono più l'apprendimento, a risentirne è il titolo stesso.
Cosa succede quando l'uso dell'AI supera le soglie istituzionali di integrità?
Quando l'uso dell'AI supera le soglie istituzionali, le sanzioni ricadono sull'autore umano e, sempre più spesso, sui supervisori — dalla revisione obbligatoria al blocco della sottomissione o alla cancellazione dell'iscrizione. Le politiche variano in base al Paese e all'ateneo, ma nel 2026 la tendenza è verso fasce di similarità più restrittive, un esame esplicito dell'AI e minore tolleranza per la giustificazione “il modello se l'è inventato”.
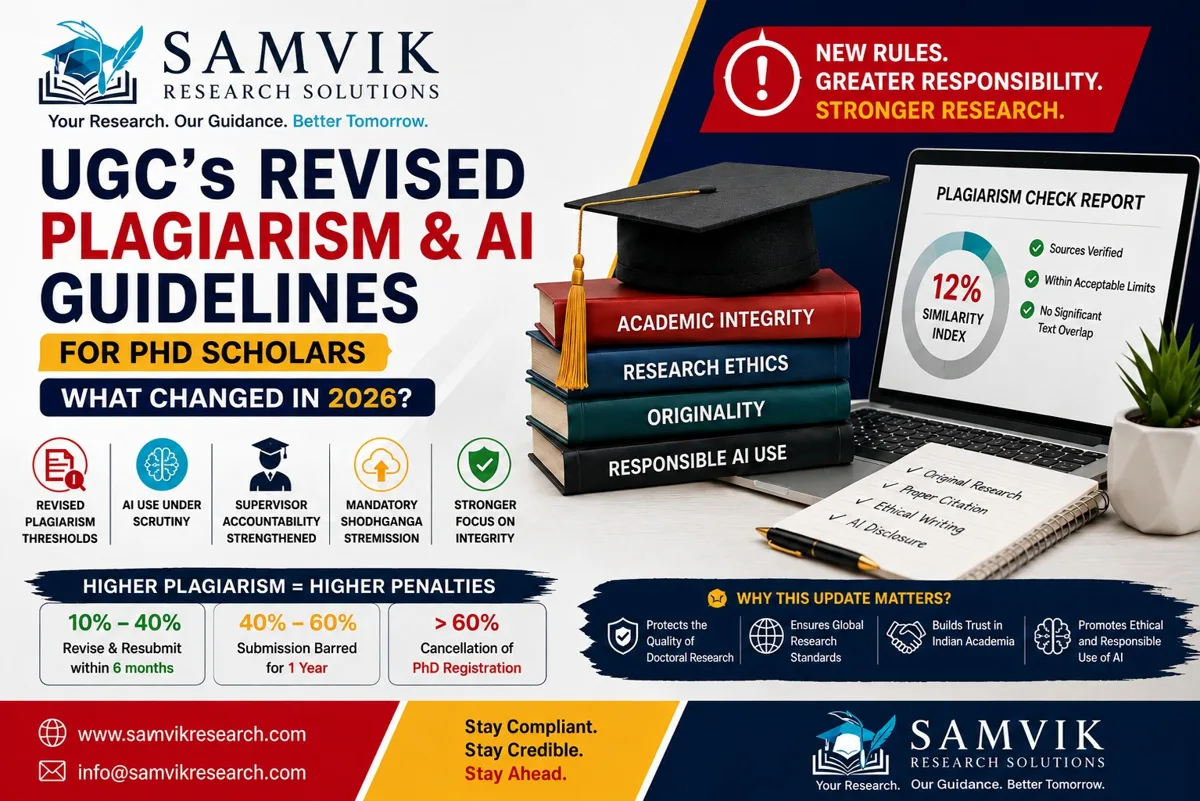
Le linee guida diffuse ai dottorandi nel 2026 nell'ambito della revisione dell'University Grants Commission (UGC) illustrano come le soglie numeriche diventino eventi che incidono sulla carriera. In tale quadro, una similarità tra il 10% e il 40% comporta revisione e nuova sottomissione entro sei mesi; dal 40% al 60% può impedire la sottomissione per un anno; e una similarità superiore al 60% può annullare l'iscrizione al PhD. Le stesse linee guida associano queste fasce a un esame più rigoroso dell'uso dell'AI, a una maggiore responsabilità del supervisore e al deposito obbligatorio in un repository. Anche se la tua università utilizza soglie diverse, la logica è trasferibile: la sovrapposizione è trattata come un segnale di integrità misurabile e “l'AI mi ha aiutato” non è una difesa se il testo non è tuo o i riferimenti non sono reali.
Le riviste aggiungono un secondo livello. La posizione di COPE sull'attribuzione di paternità significa che non puoi indicare ChatGPT, Elicit, Scite o Jenova come coautore. Puoi, e spesso devi, nominare lo strumento nei Metodi. La mancata dichiarazione viene sempre più considerata una violazione della trasparenza anche quando la scienza è solida. I riferimenti inventati, al contrario, possono giustificare il rifiuto o la ritrattazione perché falsificano il record accademico.
Implicazioni pratiche per chiunque presenti un lavoro nel 2026:
- Conosci la tua fascia locale di similarità prima di redigere, non dopo l'esecuzione del verificatore.
- Conserva prompt e versioni del modello per poter ricostruire ciò che lo strumento ha apportato.
- Non trattare un basso punteggio di un rilevatore di AI come un'autorizzazione. Tratta come autorizzazione una bibliografia completa e risolvibile.
- Se supervisioni studenti, esamina i loro registri delle fonti. La responsabilità sta risalendo la catena.
Usata entro questi vincoli, l'AI resta un acceleratore legittimo per ricerca, estrazione e organizzazione. Usata come coautore invisibile con un elenco di riferimenti inventati, è ormai uno dei modi più rapidi per bloccare un titolo di studio o un articolo.
Riferimenti
- Nature — Le citazioni allucinate stanno inquinando la letteratura scientifica
- Enago — Riferimenti generati dall'AI: 1 su 5 è falso
- STAT — Le citazioni fraudolente, attribuite alle allucinazioni dell'AI, si stanno diffondendo negli articoli accademici
- Today's Clinical Lab — I riferimenti falsi generati dall'AI aumentano nella letteratura biomedica
- Accountability in Research (Taylor & Francis) — Citazioni allucinate prodotte dall'intelligenza artificiale generativa
- PubMed Central — Citazioni inventate nell'era dell'AI: un campanello d'allarme per gli editor
- Cornell University Center for Teaching Innovation — AI e integrità accademica
- COPE — Attribuzione di paternità e strumenti di AI
- Elicit — AI per la ricerca scientifica (dimensione del corpus, citazioni a livello di frase, workflow di revisione sistematica)
- Scite — Risposte supportate da citazioni in oltre 300 milioni di articoli accademici
- Paperguide — Confronto Elicit vs Scite per ricercatori (2026)
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- George Mason University Libraries — Strumenti di AI per le revisioni della letteratura
- IBM — Esplorare le questioni di privacy nell'era dell'AI
- Office of the Victorian Information Commissioner — Intelligenza artificiale e privacy: questioni e sfide
- Fortra — Privacy dei dati nell'AI: sfide e soluzioni
- European Network for Academic Integrity — Linee guida generali per l'integrità accademica
- ScienceDirect — Rivalutare l'integrità accademica nell'era dell'AI
- Cambridge University Press — Integrità accademica nell'era dell'AI