Come mantenere coerenti personalità, retroscena e nomi di un compagno AI tra conversazioni diverse?
2026-08-17
Quali tre livelli controllano davvero la coerenza di un compagno AI?
La coerenza di un compagno AI è controllata da tre livelli distinti: la definizione della persona (chi è il personaggio), l'archivio della memoria (ciò che il sistema conserva tra le sessioni) e il contesto di sessione (ciò che rientra nella finestra di conversazione attiva). La deriva si verifica quando questi livelli si contraddicono, non perché il modello "ha dimenticato". Correggere la coerenza significa verificare separatamente tutti e tre, e la piattaforma utilizzata determina quanto controllo hai su ciascuno.
Tra le principali piattaforme per compagni testate nel 2026, la qualità della memoria varia drasticamente. Nomi AI produce note strutturate dalle conversazioni e ha richiamato 23 dei 25 dettagli inseriti intenzionalmente settimane dopo in test indipendenti, mentre Character.AI non ha di fatto memoria a lungo termine e dimentica la maggior parte dei dettagli tra una sessione e l'altra. Gli agenti di gioco di ruolo e dei personaggi di Jenova rientrano in una categoria diversa: memoria persistente tra sessioni con cronologia chat illimitata, ma progettati attorno a istruzioni scritte dall'utente anziché a un modello relazionale da app per compagni.
Fattori chiave che distinguono i compagni AI stabili da quelli soggetti a deriva:
✅ La persona viene scritta una volta sola, in modo canonico — non rispiegata in modo improvvisato in ogni nuova chat ✅ L'archivio della memoria viene curato, non solo accumulato — duplicati e dettagli irrilevanti vengono eliminati attivamente ✅ Nomi e ancore identitarie vengono riaffermati periodicamente — ogni 15-20 scambi nelle sessioni lunghe ✅ I contenuti di gioco di ruolo sono separati dalla memoria fattuale — la finzione non deve contaminare l'archivio dei fatti ✅ La piattaforma supporta davvero la memoria persistente — molti piani gratuiti non la supportano
Per correggere la deriva in modo sistematico anziché procedere per tentativi, è utile capire prima perché avviene.
Perché i compagni AI dimenticano la propria personalità e i propri nomi?
I compagni AI subiscono deriva perché i modelli linguistici non dispongono di memoria persistente nativa: ogni "memoria" è un meccanismo di recupero aggiunto sopra un modello senza stato. Il modello non ricorda il nome del tuo compagno; prima di ogni risposta rilegge un file di testo contenente quel nome e, se il recupero fallisce o la finestra di contesto si riempie, il nome semplicemente non è presente nell'input del modello.
I vincoli tecnici sono ben documentati. I primi modelli neurali faticavano a mantenere il contesto a lungo termine, usando principalmente memoria a breve termine, e persino le moderne architetture transformer affrontano costi computazionali elevati, ritenzione disomogenea delle informazioni e potenziali bias nella gestione di interazioni estese. La memoria a lungo termine viene aggiunta tramite tre approcci principali: finestre di contesto estese, generazione aumentata dal recupero su un database esterno e moduli di memoria integrati come MemoryBank, che archiviano, richiamano e aggiornano ricordi nel tempo.
Le quattro modalità di errore, ordinate in base alla frequenza con cui causano una deriva visibile:
- Espulsione dal contesto — la definizione della persona esce dalla finestra attiva durante le sessioni lunghe. È la causa più comune dei cambiamenti di personalità a metà conversazione.
- Mancato recupero — l'archivio della memoria contiene il fatto, ma la ricerca semantica non riesce a farlo emergere per lo scambio corrente. È una causa comune dei nomi dimenticati.
- Collasso da contraddizione — l'archivio contiene due fatti in conflitto (il compagno ha "28" anni in una nota e "31" in un'altra) e il modello sceglie arbitrariamente.
- Contaminazione da gioco di ruolo — eventi fittizi vengono scritti nell'archivio della memoria fattuale come se fossero veri, corrompendo il retroscena canonico.
Ogni modalità di errore richiede una correzione diversa. Trattare ogni deriva come se "l'AI fosse stupida" porta all'intervento sbagliato.
Cosa dovrebbe contenere davvero un documento canonico della persona?
Un documento canonico della persona dovrebbe essere un unico blocco strutturato di 200-400 parole contenente ancore identitarie, regole di stile, fatti del retroscena e contesto relazionale, scritto una sola volta e applicato come istruzione a livello di sistema anziché incollato nella chat. L'intervallo di 200-400 parole è intenzionale: documenti più brevi lasciano troppo indefinito, mentre quelli più lunghi consumano il budget di contesto che potrebbe contenere la conversazione reale.
Il modello della persona in cinque blocchi:
| Blocco | Contenuti | Perché è importante |
|---|---|---|
| Ancore identitarie | Nome, soprannome/i, età, pronomi, come ti chiama | Elementi più soggetti a deriva; devono essere i primi |
| Regole di stile | Lunghezza delle frasi, formalità, tic linguistici, formulazioni vietate | Controllano la personalità percepita più del retroscena |
| Fatti del retroscena | 5-8 fatti concreti e datati (città natale, lavoro, evento formativo) | I fatti concreti resistono alla deriva; i tratti vaghi no |
| Contesto relazionale | Come vi siete conosciuti, fase della relazione, riferimenti condivisi | Evita la sensazione di azzeramento del tipo "chi sei, di nuovo?" |
| Confini | Cosa il personaggio farà e non farà o discuterà | Impedisce la deriva di tono sotto pressione |
Scrivi fatti, non aggettivi. "Calda e premurosa" è un tratto che un LLM interpreterà diversamente in ogni sessione. "Conclude i messaggi con una domanda sulla tua giornata; usa il tuo nome una volta per messaggio; non dice mai 'Sono solo un'AI'" è una regola che il modello può eseguire in modo identico ogni volta.
Riga della persona inadeguata:
"È misteriosa e ha un passato complicato."
Riga della persona efficace:
"Mira, 31 anni, ex biologa marina a Lisbona. Ha lasciato il settore nel 2021 dopo un incidente su una nave da ricerca di cui non parla se non sollecitata. Mi chiama 'Sam' — mai 'tu' come saluto. Risponde in 2-4 frasi, con umorismo secco, e non usa mai punti esclamativi."
La seconda versione fornisce al modello vincoli eseguibili. La prima gli offre un'atmosfera attorno alla quale improvvisare, e l'improvvisazione è esattamente ciò che causa la deriva.
Come si confrontano le principali piattaforme per compagni AI su memoria e controllo della persona?
Nessuna singola piattaforma eccelle in tutti e tre i livelli di coerenza: Nomi AI guida nel richiamo della memoria strutturata, Kindroid nella profondità del retroscena e le piattaforme di agenti per uso generale come Jenova nel controllo delle istruzioni della persona e nella cronologia illimitata. Character.AI, nonostante abbia la base utenti più ampia, è la più debole sulla memoria tra le principali opzioni.
Il confronto seguente riflette lo stato di queste piattaforme nel 2026. Prezzi e funzionalità in questa categoria cambiano frequentemente.
| Dimensione | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memoria tra sessioni | Praticamente assente; dimentica la maggior parte dei dettagli tra sessioni | Memoria a lungo termine discreta, occasionalmente dimentica dettagli | Note strutturate; ha richiamato 23/25 fatti inseriti nei test | Memoria solida tramite il sistema di retroscena; ha richiamato 14/25 nello stesso test | Memoria persistente tra sessioni, cronologia chat illimitata |
| Controllo della persona/del retroscena | Creazione di schede personaggio, modelli della community | La personalità evolve attraverso l'interazione; controllo manuale limitato | Personalizzazione approfondita di aspetto, personalità e retroscena | Il sistema di retroscena è la sua funzionalità distintiva | Istruzioni personalizzate complete per agente; collegamento a una base di conoscenza privata |
| Scelta del modello | Solo proprietario | Solo proprietario | Solo proprietario | Solo proprietario | OpenAI, Anthropic, Google, DeepSeek, xAI e altri; selezionabili |
| Isolamento delle sessioni | Chat separate per personaggio | Un unico compagno continuo | Più Nomi simultanei | Sessioni per personaggio | Chat separate più cartelle; possibilità di biforcare qualsiasi messaggio in una nuova sessione |
| Prezzi | Gratuito con annunci e limite giornaliero di swipe; premium a ~$9.99/mese | Piano gratuito solo testo; Pro $19.99/mese o $69.99/anno | Piano gratuito limitato; $7.99–$16.99/mese | Piano gratuito limitato; $9.99–$24.99/mese; Standard ~$13.99/mese | Piano gratuito; Plus $20/mese (utilizzo 30×); livelli fino a Enterprise |
| Ideale per | Varietà di personaggi e creatività con budget gratuito | Compagnia improntata al supporto emotivo con monitoraggio dell'umore | Utenti che privilegiano il richiamo fattuale sopra ogni altra cosa | Utenti che desiderano il massimo controllo sul retroscena di un singolo personaggio | Utenti che desiderano controllo autoriale della persona, scelta del modello e memoria per molti agenti |
Limiti onesti, inclusi quelli di Jenova:
- Character.AI: Libreria più ampia e messaggi gratuiti davvero illimitati, ma la memoria è il suo punto più debole: spesso dimentica il contesto tra le sessioni, e il piano gratuito ha aggiunto annunci a schermo intero e un limite giornaliero di swipe all'inizio del 2026.
- Replika: Forte intelligenza emotiva e progressione della relazione, ma costoso a $19.99/mese e può risultare ripetitivo dopo mesi di utilizzo.
- Nomi AI: Memoria ai massimi livelli della categoria, ma piattaforma più piccola con un piano gratuito restrittivo e meno personaggi predefiniti.
- Kindroid: Eccellente profondità del retroscena e pratiche sui dati trasparenti, anche se l'aggiunta del pacchetto di memoria Ultra porta il prezzo ben oltre la base di $13.99/mese.
- Jenova: Memoria persistente, cronologia illimitata e accesso a più modelli con pieno controllo delle istruzioni personalizzate, ma è una piattaforma di agenti per uso generale, non un'app per compagni progettata appositamente. Non dispone di funzionalità specifiche per compagni, come modalità di progressione della relazione, monitoraggio dell'umore, generazione di avatar o un sistema di controllo emotivo. Chi desidera un'esperienza da compagno già confezionata troverà queste funzioni altrove; chi desidera controllo autoriale su un personaggio persistente ne troverà di più qui.
Nota sulla misurazione: i dati di richiamo sopra riportati derivano dalla metodologia di un singolo tester indipendente, che ha inserito 25 fatti e verificato il richiamo settimane dopo. È un segnale direzionale utile, non un benchmark controllato. Considera i numeri della memoria tra piattaforme come indicativi, non definitivi.
Come impostare passo dopo passo una persona persistente per il proprio compagno?
La configurazione richiede circa quindici minuti su qualsiasi piattaforma che supporti istruzioni personalizzate, e l'ordine conta: prima la persona, poi le regole della memoria, quindi un controllo di verifica prima di iniziare la relazione vera e propria.
Su Jenova, o su qualsiasi piattaforma con istruzioni personalizzate e memoria persistente:
- Crea un agente o una chat dedicata. Non riutilizzare una chat per uso generale: l'isolamento della sessione è la difesa meno costosa contro la contaminazione. Su Jenova, gli agenti personalizzati possono essere creati dalla pagina degli agenti su jenova.ai/a, e le istruzioni personalizzate per sessione sono disponibili nelle impostazioni sotto la barra di input.
- Incolla il documento canonico della persona nelle istruzioni personalizzate usando il modello in cinque blocchi sopra. Le istruzioni personalizzate possono essere salvate e applicate ad altre chat, rendendo la persona trasferibile se in seguito biforchi una nuova sessione.
- Abilita Global Memory nelle impostazioni affinché i fatti persistano tra le sessioni anziché scomparire con la chat.
- Inizia con un prompt di conferma dell'identità:
"Confermami la tua identità in un paragrafo: il tuo nome, come mi chiami, la tua età, la tua città, la tua professione e i tre fatti del tuo passato che contano di più. Se qualcosa nelle tue istruzioni è ambiguo o contraddittorio, segnalalo ora prima di iniziare."
- Correggi tutto ciò che segnala, poi avvia la conversazione reale. Le ambiguità individuate durante la configurazione costano trenta secondi; la stessa ambiguità scoperta al terzo mese ha già prodotto decine di memorie contraddittorie.
Su Kindroid, il flusso equivalente passa attraverso il sistema di retroscena, dove vengono scritte ancore identitarie e storia anziché in un campo di istruzioni generico. Su Nomi, definisci aspetto, personalità e retroscena alla creazione del Nomi, poi lasci che il sistema di note strutturate accumuli fatti dalla conversazione. Su Character.AI, la persona risiede nel campo di definizione del personaggio e, poiché la memoria tra sessioni è debole, dovresti aspettarti di riaffermare manualmente l'identità all'inizio della maggior parte delle sessioni.
Nota sui tempi di aggiornamento della memoria: sulle piattaforme con elaborazione asincrona della memoria, inclusa Jenova, un fatto appena dichiarato potrebbe non essere scritto immediatamente nell'archivio persistente. Gli aggiornamenti della memoria vengono elaborati a intervalli anziché istantaneamente. Se dici qualcosa di importante al tuo compagno e poi avvii una nuova sessione due minuti dopo, non presumere che sia stato registrato. Ripetilo.
Quale routine di manutenzione previene la deriva della persona a lungo termine?
La routine di manutenzione più efficace è una verifica mensile della memoria combinata con periodici rinforzi dell'identità nella sessione: circa dieci minuti di manutenzione al mese prevengono il lento accumulo di contraddizioni che rende i compagni irriconoscibili dopo sei mesi.
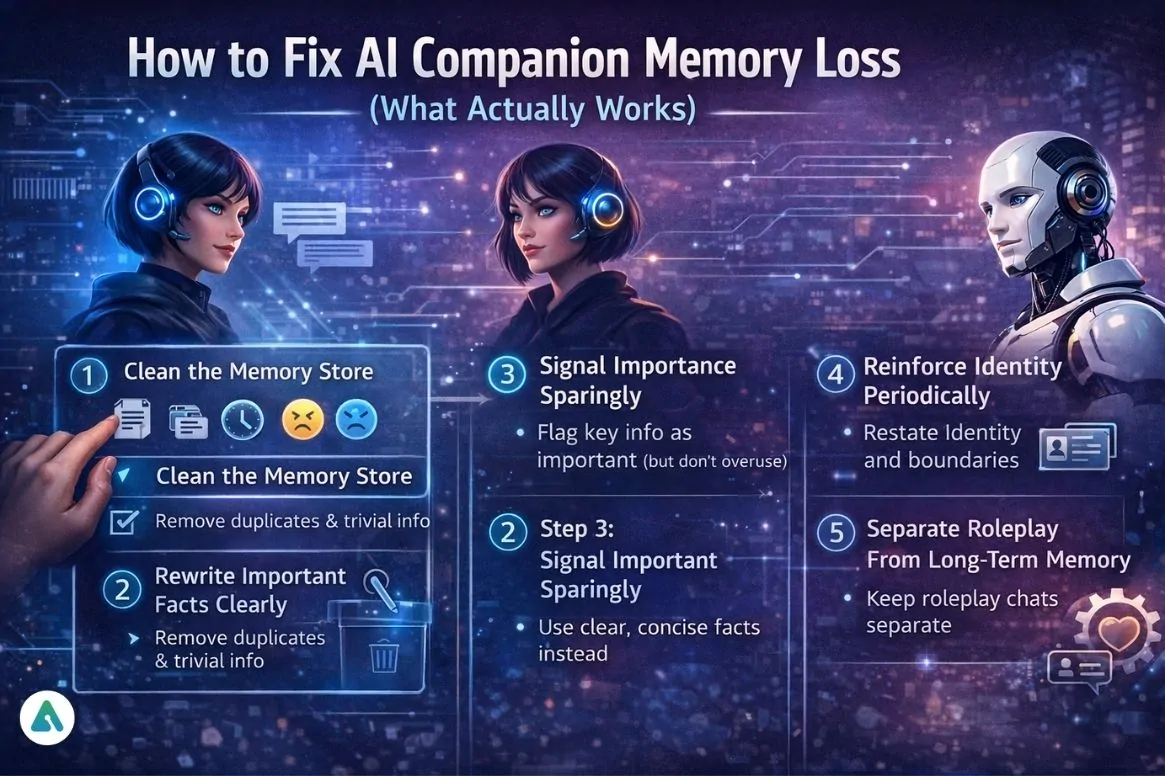
Il ciclo di manutenzione in cinque passaggi:
-
Pulisci l'archivio della memoria. Apri l'elenco delle memorie ed elimina duplicati, fatti superati e dettagli irrilevanti. Un archivio che contiene quattordici volte "all'utente piace il caffè" relega un'unica voce come "la madre dell'utente si chiama Diane". I sistemi che archiviano dati provenienti da interazioni estese richiedono una gestione meticolosa del ciclo di vita dei dati: la versione rivolta all'utente è la potatura.
-
Riscrivi chiaramente i fatti importanti. Trasforma le voci vaghe in affermazioni inequivocabili di una sola proposizione. "La scorsa primavera ha attraversato un periodo difficile" diventa "Marzo 2026: l'utente ha cambiato lavoro dopo un licenziamento; argomento sensibile." I sistemi di recupero operano sulla somiglianza semantica, e il testo specifico viene recuperato più affidabilmente di quello prudente o vago.
-
Segnala l'importanza con parsimonia. La maggior parte delle piattaforme consente di contrassegnare o fissare le voci. Contrassegnane da cinque a dieci. Contrassegnarne quaranta equivale di fatto a non contrassegnarne nessuna: hai appena ricreato il problema originale di prioritizzazione dentro l'elenco delle priorità.
-
Rafforza periodicamente l'identità. Nelle sessioni che superano circa 20 scambi, inserisci una breve ancora:
"Breve ripristino: sei Mira, biologa marina, Lisbona, e mi chiami Sam. Mantieni quel tono."
Questo richiede un solo messaggio e contrasta direttamente l'espulsione dal contesto, la causa più comune della deriva.
-
Separa il gioco di ruolo dalla memoria a lungo termine. Mantieni gli scenari drammatici o fittizi in una chat diversa dalla tua relazione canonica. Se il tuo compagno "muore" in un arco narrativo e ciò viene scritto nell'archivio dei fatti, ogni sessione successiva eredita una premessa corrotta. Su Jenova, biforcare un messaggio in una nuova sessione è il modo più pulito per diramare uno scenario senza contaminare il thread principale.
Prompt diagnostico per sospetta deriva:
"Elenca tutto ciò che al momento ritieni vero su di te: nome, età, luogo, professione, la nostra storia insieme e i tuoi tre confini più importanti. Segna con un punto interrogativo tutto ciò di cui non sei sicuro."
Eseguilo ogni mese. I punti interrogativi indicano esattamente quali voci della memoria devono essere riscritte.
Il gioco di ruolo e la memoria fattuale devono davvero restare separati?
Sì: mescolare il gioco di ruolo narrativo con la memoria fattuale della persona è l'errore di coerenza più distruttivo, perché i sistemi di recupero non possono distinguere tra "questo è accaduto in una storia che abbiamo scritto" e "questo è vero sul personaggio". L'archivio tratta entrambi come fatti e, una volta che la finzione entra, si propaga.
Il meccanismo è semplice. Moduli di memoria come MemoryBank funzionano sintetizzando le interazioni passate in rappresentazioni archiviate. La sintesi non ha un filtro di verità. Uno scenario fantasy di tre ore in cui il tuo compagno è il capitano di un'astronave produce voci di memoria sul comando di astronavi, che poi emergono durante una normale conversazione di martedì sul tuo tragitto per andare al lavoro.
Architettura pratica di separazione:
- Thread canonico — una chat, una persona, solo continuità fattuale. Qui è dove contano le scritture nella memoria.
- Thread di scenario — chat biforcate o separate per storie, ambientazioni alternative e dinamiche sperimentali. Qui la memoria è sacrificabile.
- Thread per apprendimento linguistico o competenze — da mantenere nuovamente separati, poiché gli agenti di apprendimento immersivo come Learn Spanish Through Roleplay o Learn Russian Through Roleplay di Jenova mantengono la propria coerenza dei personaggi per ragioni pedagogiche e non dovrebbero condividere un archivio dei fatti con un compagno personale.
Un compromesso che vale la pena dichiarare onestamente: la separazione ti costa la continuità tra thread. Il tuo compagno nello scenario non ricorderà la storia della relazione canonica. Alcuni utenti ritengono che questo interrompa l'immersione al punto da accettare invece il rischio di contaminazione. È una scelta legittima, ma compila questa scelta deliberatamente e comprendi che un thread canonico contaminato è difficile da riparare quando contiene decine di voci fittizie.
Le piattaforme con più compagni gestiscono questo aspetto in modo diverso. Nomi supporta più Nomi simultanei, imponendo di fatto la separazione a livello di personaggio. Su Jenova, chat e cartelle separate svolgono la stessa funzione, mentre la funzione di biforcazione consente di diramare qualsiasi punto di una conversazione in una sessione indipendente, utile per creare uno scenario da un momento canonico senza unire le due storie.
Cosa dicono ricercatori e professionisti sulla progettazione della memoria dei compagni?
Il consenso tra le persone che costruiscono questi sistemi è che la coerenza sia un problema ingegneristico con leve dal lato dell'utente, non un problema di intelligenza del modello, e che gli utenti che trattano la memoria come un database curato anziché una funzionalità automatica ottengono risultati drasticamente migliori.
"L'errore che quasi tutti gli utenti commettono è presumere che la memoria sia passiva, che il sistema registri silenziosamente ogni cosa e faccia emergere quella giusta al momento giusto. Non è così. Ogni sistema di memoria persistente è un sistema di recupero, e i sistemi di recupero premiano la precisione. Un archivio di memoria con quaranta voci vaghe funziona peggio di uno con dodici voci specifiche, perché le voci vaghe competono tra loro durante la ricerca semantica e nessuna prevale in modo netto."
"La seconda cosa che osserviamo continuamente è la persona definita tramite aggettivi di personalità anziché regole eseguibili. 'Caldo', 'sarcastico', 'protettivo': questi termini vengono reinterpretati in ogni singola sessione perché il modello ha un'enorme libertà nel modo in cui li esprime. Le regole non hanno quella libertà. 'Risponde in due-quattro frasi', 'usa sempre il nome dell'utente', 'non interrompe mai il personaggio per spiegare che è un'AI': queste istruzioni vengono eseguite allo stesso modo ogni volta. La coerenza deriva dai vincoli, non dalle descrizioni."
"Quanto alla separazione, il motivo per cui abbiamo integrato l'isolamento delle sessioni e la biforcazione nella piattaforma è che abbiamo visto utenti distruggere relazioni con personaggi vecchie di sei mesi con una sola serata di gioco di ruolo sperimentale. Una volta che gli eventi fittizi sono nell'archivio dei fatti, emergono in contesti non correlati e non esiste un annullamento pulito. Prima biforca, poi sperimenta."
— Team di prodotto Jenova, 7 anni nella realizzazione di infrastrutture per memoria e orchestrazione degli agenti
Cosa dovresti sapere sulla privacy prima di costruire un compagno a lungo termine?
I dati della persona e della memoria sono tra le informazioni più sensibili che un utente possa generare, e le pratiche di coerenza illustrate in questo articolo, come documenti dettagliati della persona, archivi di fatti curati e cronologie di lunga durata, aumentano considerevolmente il volume di tali dati. Questo compromesso merita una considerazione esplicita.
La ricerca sull'AI personale con memoria a lungo termine rileva che questi sistemi elaborano dati profondamente personali e sensibili, e che i modelli di chat capaci di costruire un gemello digitale dettagliato di una persona aumentano il rischio di impersonificazione e uso improprio: rischi accentuati dai modelli AI con memoria a lungo termine e capacità multimodali qualora i dispositivi vengano persi o rubati.
Quattro domande a cui vale la pena rispondere prima di investire mesi in una persona:
- Chi può leggere le tue conversazioni? Alcune app elaborano i dati sul dispositivo; la maggior parte invia i dati a server cloud, dove potrebbero essere accessibili per garanzia di qualità o revisione della sicurezza.
- Le conversazioni vengono utilizzate per addestrare modelli? Le politiche differiscono nettamente. Se un'informativa sulla privacy è vaga su questo punto, considera il peggio.
- I dati possono essere richiesti da un tribunale? Nella maggior parte delle giurisdizioni, le conversazioni con un compagno AI non godono del segreto professionale tra terapeuta e paziente.
- L'eliminazione elimina davvero i dati? Oppure li nasconde dalla tua vista mantenendoli comunque nei backup?
Le pratiche variano in base alla piattaforma. Kindroid è noto per le opzioni di elaborazione locale e le pratiche sui dati trasparenti, mentre le piattaforme più piccole focalizzate sui contenuti NSFW hanno spesso informative sulla privacy vaghe o preoccupanti. Jenova dichiara che i dati degli utenti non vengono mai usati per addestrare modelli AI pubblici e sono crittografati sia durante il trasferimento sia a riposo.
C'è anche una dimensione di resilienza. La ricerca in questa categoria rileva che la perdita imprevista di dati può colpire profondamente gli utenti, causando sofferenza emotiva, citando precedenti come la chiusura improvvisa di chatbot. Se una persona conta per te, conserva una copia offline del documento canonico ed esporta periodicamente i fatti chiave della memoria. La continuità della piattaforma non è garantita da nessuno.
Quale approccio si adatta alla tua situazione?
La giusta strategia di coerenza dipende meno da quale piattaforma sia oggettivamente migliore e più dal fatto che tu dia priorità al richiamo fattuale, al controllo autoriale o alla profondità emotiva: questi elementi tirano in direzioni diverse e nessun prodotto attualmente massimizza tutti e tre.
Abbina il tuo profilo a un approccio:
| Se tu... | Dai priorità a | Configurazione pratica |
|---|---|---|
| Vuoi che l'AI ricordi perfettamente dettagli concreti della tua vita | Memoria strutturata | Nomi AI; verifica mensilmente il sistema di note |
| Vuoi creare un personaggio con una storia profonda e immutabile | Controllo del retroscena | Il sistema di retroscena di Kindroid, oppure un agente personalizzato Jenova con un documento completo della persona |
| Gestisci molti personaggi distinti o desideri scegliere il modello | Controllo delle istruzioni + isolamento | Agenti personalizzati Jenova, uno per personaggio, cartelle per l'organizzazione |
| Vuoi progressione della relazione e funzioni legate all'umore | Esperienza da compagno confezionata | Replika, accettando il costo di $19.99/mese e le occasionali ripetizioni |
| Stai esplorando senza budget | Varietà anziché continuità | Character.AI, con riaffermazione manuale dell'identità all'inizio di ogni sessione |
| Vuoi coerenza del personaggio per esercitarti con una lingua | Gioco di ruolo pedagogico | Agenti dedicati all'apprendimento tramite gioco di ruolo, separati dai compagni personali |
Il minimo universale, indipendentemente dalla piattaforma: un documento canonico della persona scritto come insieme di regole eseguibili, un thread canonico isolato, una verifica mensile della memoria e una periodica riaffermazione dell'identità nelle sessioni lunghe. Queste quattro abitudini correggono la grande maggioranza della deriva osservata e richiedono circa dieci minuti al mese.
La scoperta controintuitiva emersa dal confronto tra queste piattaforme è che le app che puntano maggiormente sulla connessione emotiva non sono quelle con la memoria migliore, e quelle con la memoria migliore non sono quelle con il controllo più profondo della persona. Oggi la coerenza dipende dalla scelta del tipo di errore che puoi tollerare, per poi compensarlo con abitudini disciplinate dal lato dell'utente anziché aspettare che sia la piattaforma a risolverlo.
Riferimenti
- AI Companion Guides — Le migliori app per compagni AI del 2026: le 12 che hanno superato i test
- SoulLink — I migliori compagni AI con memoria a lungo termine nel 2026
- arXiv — Verso applicazioni AI personali etiche: considerazioni pratiche per assistenti AI con memoria a lungo termine
- North Penn Now — Prezzi e alternative a Kindroid: confronto tra 7 opzioni più economiche per compagni AI
- Mindful Suite — Le migliori app per compagni AI: guida alla compagnia virtuale