Come evitare che l'AI dimentichi il contesto di ricerca accumulato in mesi?
2026-08-21
Quali progettazioni della memoria mantengono intatte le strategie di ricerca durante un intero ciclo di revisione?
I chatbot vincolati alla sessione perdono stringhe di ricerca, criteri di inclusione e risultati estratti nel momento in cui una conversazione termina; ecco perché le revisioni che durano mesi si bloccano. Gli strumenti che trattano il protocollo come stato persistente — Academic Research Assistant di Jenova, con memoria persistente tra sessioni, Elicit, con spazi di lavoro per revisioni sistematiche a livello di progetto, e notebook delimitati dalle fonti come Gemini Notebook — sono le progettazioni che resistono a un intero ciclo di revisione nel 2026. Consensus resta più efficace per una mappatura estemporanea delle evidenze che per ricordare il tuo protocollo nel prossimo trimestre.
Fattori chiave che distinguono una memoria di ricerca durevole da una conversazione usa e getta:
✅ Livello del protocollo congelato — regole di inclusione ed esclusione archiviate come istruzioni, non come un prompt da riscrivere ✅ Memoria cumulativa dei risultati — estrazioni precedenti, motivazioni di esclusione e conflitti irrisolti richiamati senza dover rifare il briefing ✅ Corpus ancorato alle fonti — articoli, note e registri di ricerca allegati affinché le risposte restino legate al tuo insieme di evidenze ✅ Decisioni verificabili — motivazioni di screening ricostruibili mesi dopo, in linea con PRISMA 2020 ✅ Continuità tra sessioni — cambiare giorno, dispositivo o modello non dovrebbe cancellare lo stato della revisione
Per confrontare utilmente questi strumenti, è utile considerare la memoria di ricerca come una struttura a livelli anziché come una funzionalità di un chatbot, e verificare se ogni livello resiste anche dopo una settimana lontano dal progetto.
Perché gli assistenti di ricerca AI perdono fedeltà al protocollo nel tempo?
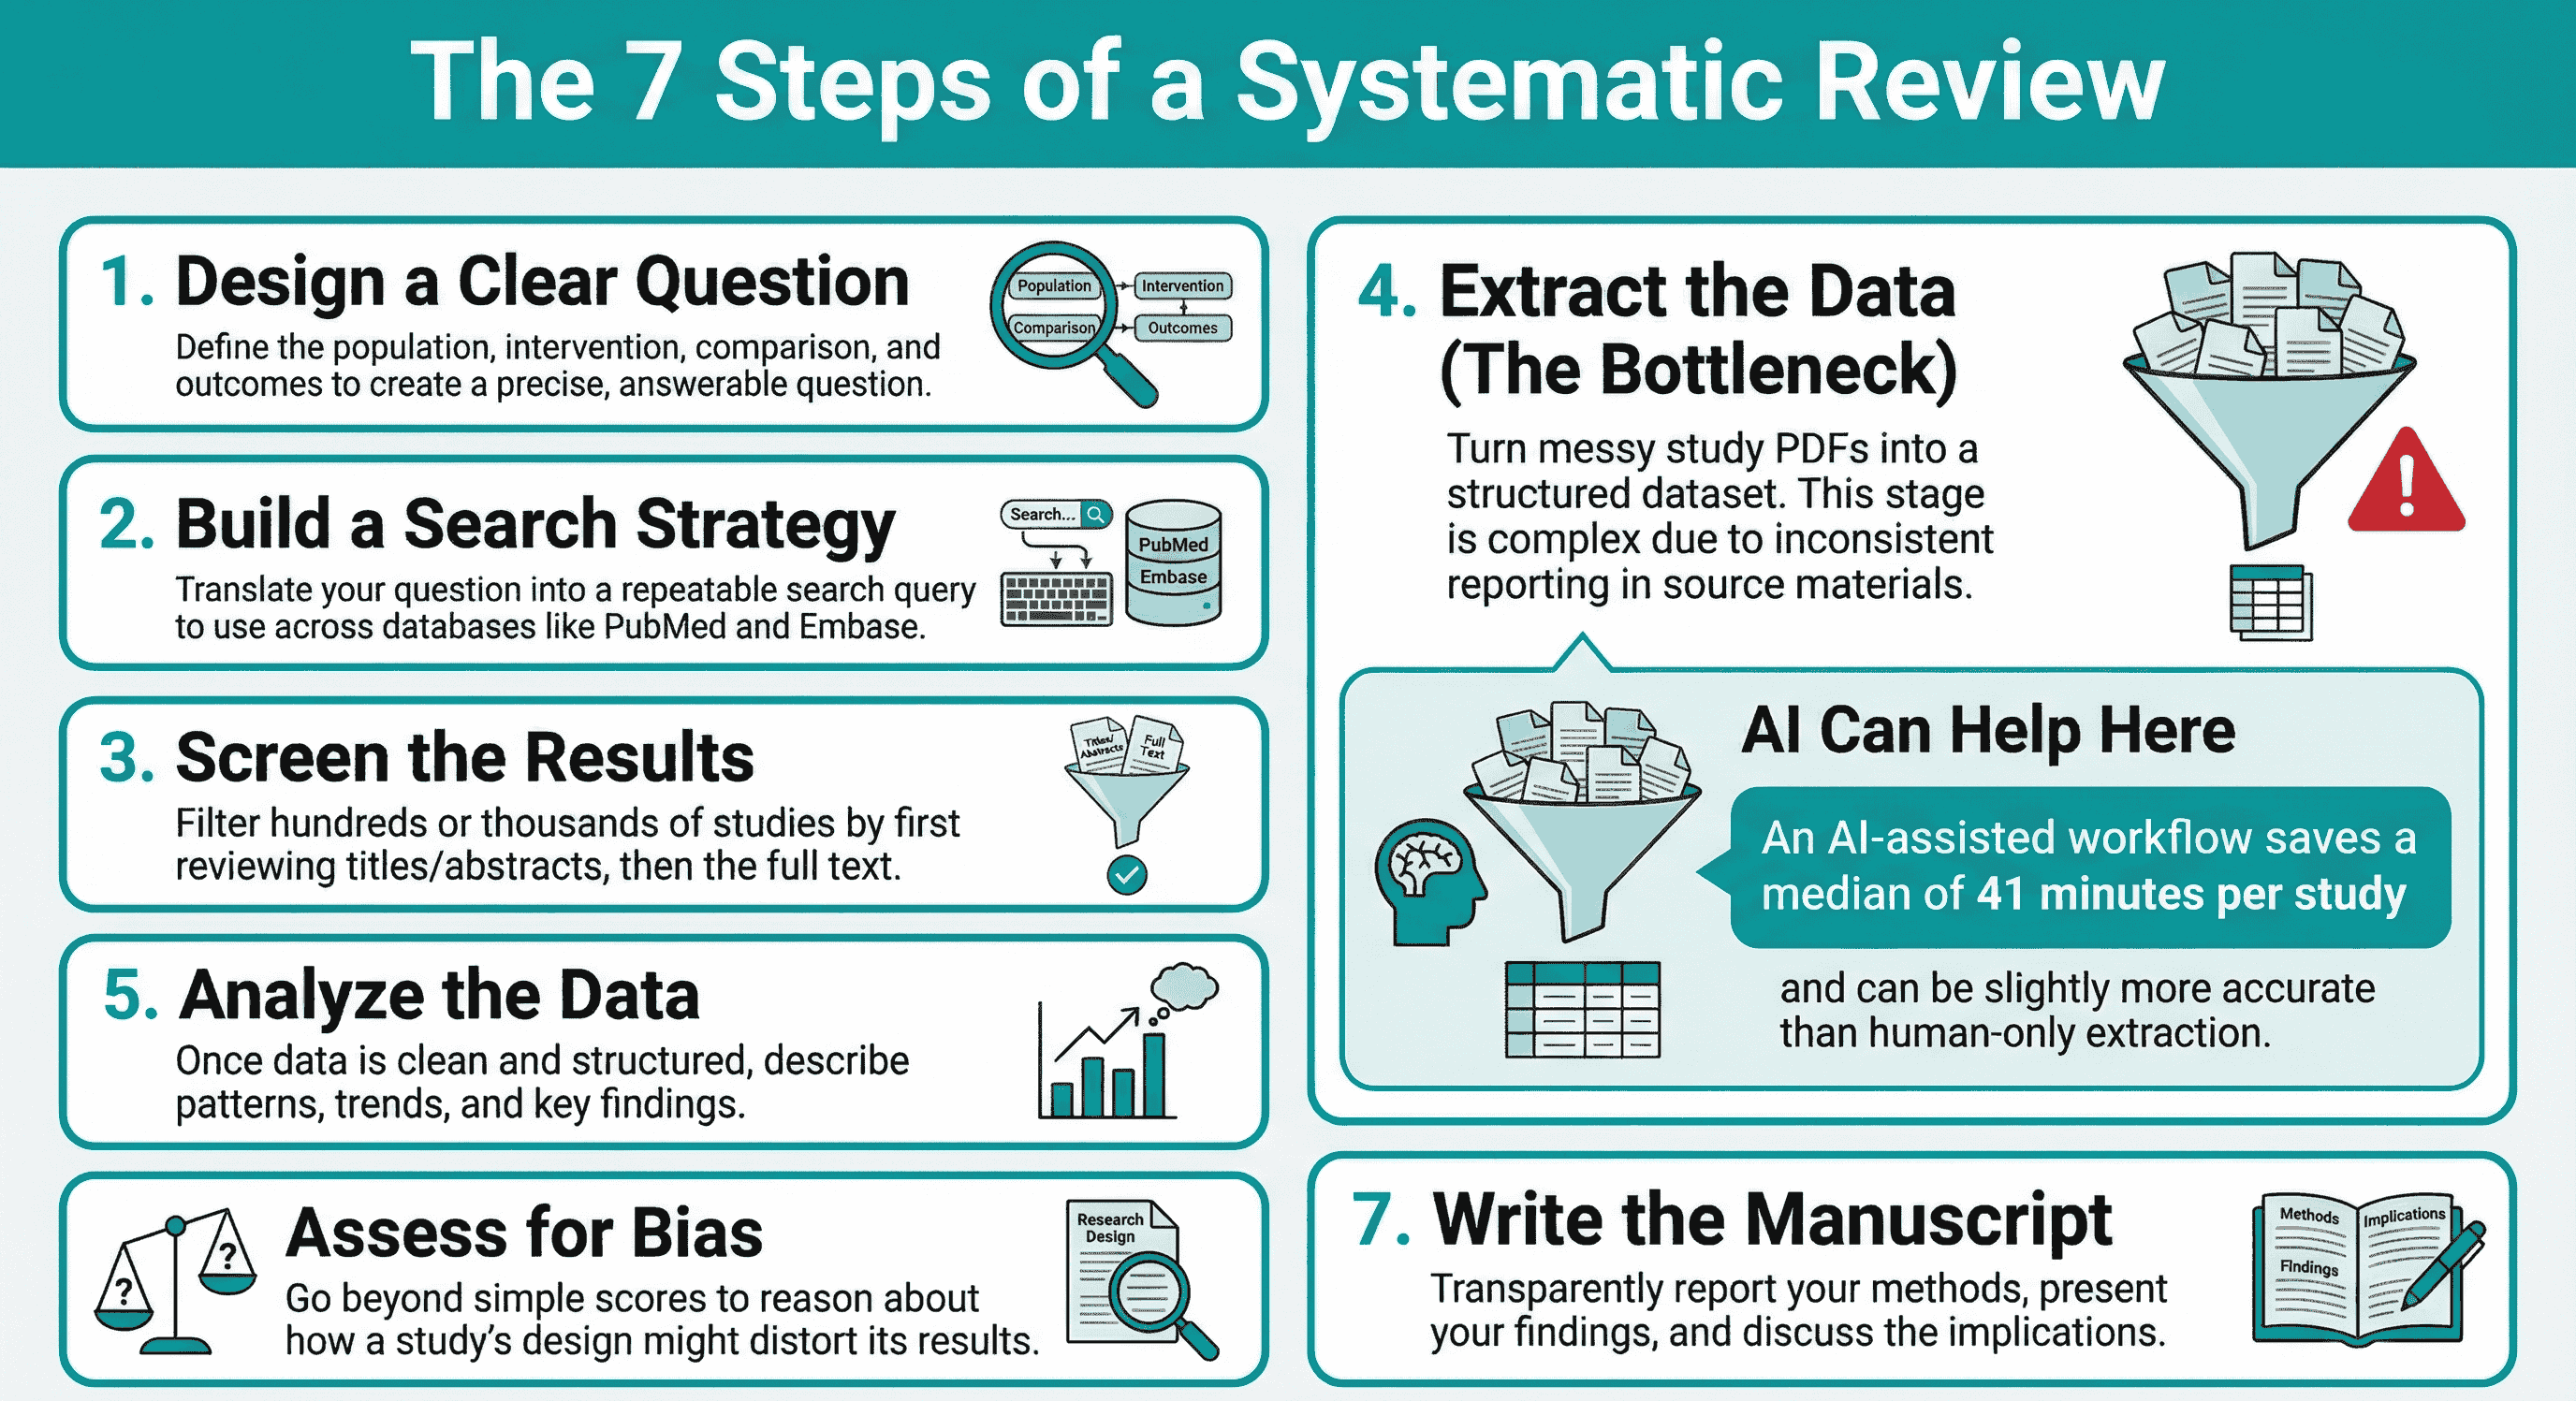
La maggior parte delle conversazioni AI per consumatori dimentica perché conserva il contesto in una finestra temporanea, non in un progetto che sopravvive alla sessione. Una revisione sistematica è un processo in sette fasi — formulazione della domanda, strategia di ricerca, screening, estrazione, analisi, valutazione dei bias e stesura del manoscritto — e ogni fase dipende da decisioni prese settimane prima. Quando l'assistente non riesce a richiamare l'impostazione PICO originale o il motivo per cui uno studio è stato escluso, la revisione comincia a deragliare.
Lo standard di rendicontazione per questo lavoro è esplicito. La dichiarazione PRISMA 2020 è una checklist basata sulle evidenze che definisce come devono essere riportate le revisioni sistematiche, e la pubblicazione di PRISMA 2020 sul BMJ la colloca nel contesto delle revisioni che includono sintesi quali la meta-analisi pairwise. La guida metodologica della Hofstra University rileva che la dichiarazione è un insieme minimo di 27 elementi per la rendicontazione di revisioni sistematiche e meta-analisi. Un assistente incapace di ricostruire stringhe di ricerca o motivazioni di esclusione non può supportare questa checklist.
Il problema della dimenticanza non è ipotetico. I ricercatori usano già il machine learning lungo tutta la pipeline di revisione; una mappatura del 2022 di 63 strumenti ML ha coperto attività dalla ricerca bibliografica fino all'estrazione dei dati. Ciò che questi strumenti raramente risolvono da soli è la fedeltà nel tempo: applicare la stessa regola di inclusione allo stesso modo nel quarto mese come nel primo.
Gli assistenti in stile conversazionale aggravano il problema in tre modi specifici:
- Evaporazione del protocollo. Stringhe booleane, copertura dei database (PubMed, Embase) e limiti di data vivono in un prompt che non viene salvato come oggetto di primo livello.
- Deriva dei criteri. Riformulazioni informali delle regole di inclusione cambiano lentamente le definizioni di popolazione, intervento o outcome.
- Amnesia dei risultati. Dimensioni dell'effetto estratte, risultati discordanti e note del tipo «torna su questo articolo» scompaiono quando la conversazione non è più disponibile.
La guida sulla sintesi delle evidenze del King's College London coglie il consenso attuale: l'AI può aiutare in diverse fasi di una revisione, ma non sostituisce il controllo metodologico. La memoria è quel controllo, esteso nel tempo del calendario.
Cosa dovresti cercare in uno strumento AI che ricorda il contesto di ricerca?
Dovresti valutare gli strumenti AI per la ricerca di lungo periodo in base a persistenza del protocollo, continuità dei risultati, ancoraggio alle fonti, verificabilità, copertura del corpus e costo di mantenere vivo quello stato, non in base a quanto risulti fluida una singola conversazione. Uno strumento che scrive sintesi eleganti ma non riesce a recuperare il registro delle esclusioni del mese scorso costerà più ore di quante ne faccia risparmiare.
Questo articolo utilizza un modello a quattro livelli, lo Stack della continuità della ricerca, per rendere concreta questa valutazione:
- Protocollo congelato. Strategie di ricerca e criteri di inclusione/esclusione conservati fuori dal buffer conversazionale, ad esempio in istruzioni personalizzate, un documento di protocollo o una configurazione di screening.
- Memoria cumulativa. Risultati precedenti, domande aperte e disaccordi tra revisori che crescono tra le sessioni anziché azzerarsi.
- Corpus ancorato alle fonti. Gli articoli, PDF, note ed esportazioni di ricerca effettivi che l'assistente è autorizzato a usare.
- Audit delle decisioni. Motivazioni di inclusione/esclusione ricostruibili, idealmente con citazioni, così che in seguito sia possibile produrre una seconda revisione o un diagramma di flusso PRISMA.
Il test rispetto a questo stack cambia la domanda d'acquisto. Elicit è progettato affinché criteri di screening, motivazioni di esclusione e punteggi per criterio siano verificabili secondo PRISMA, un punto di forza nei livelli 1 e 4. Gemini Notebook è progettato affinché le risposte citino passaggi esatti dalle fonti caricate, un punto di forza nel livello 3. Consensus è progettato per cercare tra oltre 250 milioni di articoli scientifici e mostrare dove le evidenze convergono, quindi è forte nella scoperta e debole nel ricordare il tuo protocollo. Academic Research Assistant di Jenova è costruito attorno a cronologia conversazionale illimitata, memoria persistente tra sessioni e basi di conoscenza allegabili; è quindi forte nei livelli 1–3 per un programma di lavoro di mesi, ma più debole nella produzione nativa di diagrammi PRISMA.
Pesa i livelli in base al tipo di progetto. Una revisione sistematica in stile Cochrane dovrebbe attribuire maggiore importanza alla verificabilità. Una revisione della letteratura per una tesi, estesa su due semestri, dovrebbe privilegiare la memoria cumulativa. Un laboratorio che riutilizza gli stessi articoli tra progetti dovrebbe privilegiare un corpus ancorato alle fonti e riutilizzabile.
Come gestiscono Jenova, Elicit, Consensus e Gemini Notebook la memoria di ricerca a lungo termine?
Jenova è più forte quando il programma di ricerca è conversazionale, iterativo e misurato in mesi; Elicit è più forte quando l'unità di lavoro è una revisione sistematica formale; Consensus è più forte per la mappatura rapida delle evidenze; Gemini Notebook è più forte quando il corpus è già disponibile. Nessuno dei quattro è universalmente preferibile, perché ottimizzano livelli diversi dello Stack della continuità della ricerca.
| Funzionalità / Dimensione | Elicit | Jenova Academic Research Assistant | Consensus | Gemini Notebook |
|---|---|---|---|---|
| Persistenza del protocollo | Spazio di lavoro del progetto; aggiornamenti delle revisioni continue | Cronologia illimitata, memoria persistente, istruzioni personalizzate | Filtri a livello di prompt; non è un protocollo archiviato | Istruzioni e fonti circoscritte al notebook |
| Criteri di inclusione | Criteri suggeriti automaticamente; doppia revisione; motivazioni di esclusione | Codificati nelle istruzioni e richiamati tra sessioni | Filtri in linguaggio naturale applicati a ogni ricerca | Definiti dall'utente all'interno di un notebook delimitato |
| Richiamo dei risultati precedenti | Tabelle e report di estrazione riutilizzabili | Memoria tra sessioni di note, conflitti e decisioni | Sintesi a livello di query, non un registro longitudinale | Ancorato a ciò che hai caricato |
| Corpus / fonti | 138 milioni di articoli, PubMed, ClinicalTrials.gov, caricamenti | Caricamenti utente, basi di conoscenza, strumenti di ricerca in tempo reale | 250M+ articoli, testo completo con licenza | PDF, documenti, siti, audio e video caricati |
| Verificabilità | Flusso PRISMA, citazioni, punteggi per criterio | Traccia conversazionale; nessun diagramma PRISMA nativo | Citazioni accademiche e Consensus Meter | Citazioni a livello di passaggio dalle fonti |
| Prezzi, al 2026 | Abbonamento a pagamento, incluso un livello Pro documentato | Piano gratuito; piani a pagamento da $20/mese | Abbonamento a pagamento | Gratuito per i privati; i dati organizzativi non vengono usati per l'addestramento |
| Ideale per | Revisioni sistematiche formali e aggiornamenti continui | Programmi di ricerca plurimensili che non devono dimenticare | Istantanee rapide delle evidenze e ricerca in modalità medica | Sintesi di un corpus chiuso e didattica basata sulle fonti |
Elicit
Elicit è un assistente scientifico specializzato usato per cercare, riassumere, estrarre dati da e conversare con oltre 125 milioni di articoli, mentre il prodotto per revisioni sistematiche indicizza 138 milioni di articoli con aggiornamenti settimanali. Può effettuare lo screening di fino a 40.000 articoli, suggerire automaticamente criteri di screening e mantenere ogni decisione verificabile secondo PRISMA con motivazioni di esclusione e citazioni di supporto.
Il suo limite per un programma plurimensile di ricerca mista è la specializzazione. Elicit eccelle nelle operazioni strutturate di revisione; è meno concepito come partner di ricerca generale che ricordi ipotesi collaterali, feedback del relatore e note in evoluzione al di fuori dell'oggetto della revisione.
Jenova Academic Research Assistant
Academic Research Assistant è un partner di ricerca accademica per scoperta della letteratura, preparazione di manoscritti e gestione delle citazioni, basato su una piattaforma con cronologia conversazionale illimitata e memoria persistente tra sessioni. Strategie di ricerca e criteri di inclusione possono essere congelati nelle istruzioni personalizzate dell'Agente; PDF, protocolli e registri di screening possono essere allegati come base di conoscenza privata, così che le sessioni successive inizino dallo stesso insieme di evidenze.
Il suo limite, da riconoscere, è l'inverso di quello di Elicit. Non include un diagramma di flusso PRISMA nativo, un'interfaccia per screening a doppia revisione o un corpus dedicato di 138 milioni di articoli per revisioni sistematiche. I team che necessitano di tracce di audit di livello Cochrane continueranno a esportare le decisioni in un gestore di revisioni. Il lavoro correlato che richiede un report con molte citazioni, realizzato in un solo passaggio, può essere affidato a Deep Research, che sintetizza centinaia di fonti con citazioni in linea, e poi archiviato nella stessa conversazione di lungo corso affinché i risultati non diventino un altro documento orfano.
Consensus
Consensus è un motore di ricerca accademico AI che attinge a oltre 250 milioni di articoli, incluso testo completo con licenza. Dichiara di essere utilizzato da 10 milioni di ricercatori, studenti e clinici, con oltre 170 partner tra le biblioteche universitarie. Deep Search espande i termini e percorre il grafo delle citazioni; la modalità Medical restringe l'ambito a circa 50.000 linee guida cliniche e 8 milioni di articoli delle 1.000 principali riviste mediche. Consensus Meter visualizza quanto le evidenze concordano su una domanda a risposta sì o no.
Il confronto di Paperguide del 2026 offre la giusta prospettiva: Consensus trova e valuta le evidenze; Gemini Notebook trasforma le fonti che già possiedi. Consensus è limitato come sistema di memoria. Non archivia nativamente i tuoi criteri di inclusione come protocollo dinamico, quindi un progetto che dura un semestre necessita comunque di un luogo esterno per registrare «ciò che abbiamo deciso a marzo».
Gemini Notebook
Gemini Notebook, il prodotto precedentemente chiamato NotebookLM e rinominato a luglio 2026, è un supporto di ragionamento ancorato alle fonti. Carichi PDF, siti web, video YouTube, audio, Google Docs e presentazioni; le risposte includono citazioni che mostrano i passaggi esatti. I dati organizzativi non vengono usati per addestrare il prodotto.
Il confine è il notebook. Non dimenticherà le fonti che gli hai fornito, ed è proprio per questo che funziona per un insieme definito di letture; tuttavia non scoprirà l'articolo che non hai mai caricato. Per una revisione plurimensile ancora nella fase di ricerca, questo è un limite strutturale, non un problema di impostazioni.
Come rendere persistenti le strategie di ricerca e i criteri di inclusione tra sessioni?
Li rendi persistenti scrivendoli come oggetti durevoli — un documento di protocollo, istruzioni personalizzate o una configurazione di screening — e rifiutando di tenere l'unica copia dentro un prompt usa e getta. Se la strategia esiste solo nella conversazione di ieri, non esiste.
Un modello pratico è il seguente:
- Congela la domanda in forma PICO. Popolazione, intervento, confronto e outcome devono essere copiati testualmente nelle istruzioni permanenti dell'assistente, non parafrasati ogni lunedì.
- Conserva la ricerca come artefatto ripetibile. Nomi dei database, stringhe booleane, limiti di data, limiti linguistici e fonti di letteratura grigia devono appartenere a un documento che l'assistente può rileggere.
- Separa l'inclusione dall'intuito. Criteri quali «RCT, adulti, 2015–2026, testo completo in inglese» devono essere elencati come regole. Preferenze quali «sembra rilevante per la nostra teoria» devono essere contrassegnate come ipotesi affinché non possano riscrivere silenziosamente il protocollo.
- Registra le esclusioni con le motivazioni. PRISMA richiede una rendicontazione trasparente del processo di selezione; la panoramica metodologica di DistillerSR sottolinea che PRISMA esiste per aiutare gli autori a evitare errori che compromettono le revisioni.
Per Jenova, il passaggio del protocollo congelato consiste in un blocco di istruzioni personalizzate più un PDF del protocollo allegato. Un'istruzione permanente che resiste per mesi appare così:
Sei il mio partner per la revisione sistematica del progetto HEP-24. Popolazione: adulti 18+ con NAFLD. Intervento: agonisti del recettore GLP-1. Confronto: assistenza standard o placebo. Outcome primari: MRI-PDFF e NAS. Includi RCT e coorti prospettiche, 2018–2026, testo completo in inglese. Escludi studi su animali, abstract di conferenze senza dati e trial inferiori a 8 settimane. Riformula sempre le regole di inclusione prima di sottoporre a screening un nuovo lotto e non ampliare mai silenziosamente la popolazione.
Per Elicit, l'equivalente consiste nel perfezionare il protocollo di revisione all'interno del prodotto e poi usare criteri di screening suggeriti automaticamente che accetti, modifichi o sostituisci. Ogni decisione può includere una motivazione di esclusione e una citazione di supporto, il che è più vicino a un file di audit PRISMA che a un registro conversazionale.
Per Gemini Notebook, incolla lo stesso blocco PICO nelle istruzioni del notebook e carica il protocollo insieme all'esportazione della ricerca. L'assistente resterà fedele a quei file e non inventerà articoli esterni ad essi.
La modalità di errore da osservare è l'«ampliamento utile». Dopo sei settimane, i modelli spesso iniziano a includere popolazioni adiacenti perché sembrano rilevanti. Un protocollo congelato che l'assistente deve riformulare all'inizio di ogni sessione è il controllo più economico che puoi aggiungere.
In che modo la memoria persistente cambia l'estrazione dei dati e la valutazione dei bias?
La memoria persistente trasforma l'estrazione da un lavoro di trascrizione occasionale in un dataset cumulativo; è qui che si perde la maggior parte del tempo e dove l'assistenza AI è oggi verificabile empiricamente. Il diagramma delle sette fasi indica l'estrazione come collo di bottiglia perché i PDF delle fonti riportano gli outcome in modo incoerente; un assistente che non riesce a ricordare la scheda di estrazione reintrodurrà quel disordine ogni settimana.
Le evidenze del 2026 sono più precise delle affermazioni di marketing. Uno studio annidato in una revisione su medRxiv ha confrontato l'estrazione assistita da Elicit con l'estrazione esclusivamente umana su 50 RCT di malattie croniche e non ha rilevato alcuna differenza nell'accuratezza complessiva (differenza media di 0.57 su una scala 0–100), mentre l'estrazione assistita da AI è risultata 24.82 minuti più veloce e ha comportato un costo inferiore di $181.98 sui 50 studi. Tipi e gravità degli errori erano simili. La convalida di Elicit riporta che VDI/VDE ha estratto correttamente 1.502 dei 1.511 punti dati (99.4%), e ricercatori CSIRO hanno rilevato falsi negativi pressoché nulli rispetto all'estrazione manuale.
Un'altra linea di ricerca considera l'AI come secondo revisore, anziché come sostituto. Un articolo di Cochrane Evidence Synthesis and Methods ha riportato che gli strumenti AI hanno mostrato prestazioni elevate e simili a quelle dei revisori umani nell'estrazione dei dati, specialmente per le variabili standardizzate. La nota metodologica della Birmingham City University è più prudente: gli strumenti generativi funzionano bene per anno, paese e numero di partecipanti, il che non equivale a estrarre outcome sfumati per i bracci di trial.
Ciò che la memoria aggiunge, oltre all'accuratezza pura dell'estrazione, è la coerenza della scheda:
- Gli stessi nomi degli outcome, punti temporali e unità vengono riutilizzati nella settimana 12 come nella settimana 2.
- Le discrepanze già segnalate, ad esempio «due dimensioni del campione nello stesso articolo», non vengono riscoperte come se fossero nuove.
- La valutazione dei bias può ragionare sul disegno, non soltanto su un punteggio. Il lavoro sul rischio di bias riguarda il modo in cui randomizzazione, cecità e dati mancanti potrebbero distorcere i risultati; ciò richiede di ricordare le note sul disegno dello studio, non solo l'abstract.
Il limite di Jenova in questo caso è l'interfaccia, non l'intento. La memoria persistente ricorderà che consideri l'occultamento dell'allocazione un dominio critico, ma non compilerà automaticamente una tabella Cochrane RoB 2. Il limite di Elicit è opposto: l'estrazione può essere molto strutturata e supportata da citazioni, mentre il ragionamento informale sui bias emerso durante un incontro con il supervisore necessita comunque di un luogo in cui persistere. I team che svolgono entrambe le attività dovrebbero estrarre nel tool strutturato e mantenere il commento a livello di disegno nell'Agente di ricerca a lungo termine.
Come impostare un flusso di lavoro di ricerca AI che duri mesi?
Lo imposti creando un'unica sede di progetto durevole, caricando il protocollo prima della prima ricerca e conducendo ogni sessione successiva come aggiornamento di quella sede anziché come nuova conversazione. Il flusso di lavoro segue lo stesso principio sia che tu usi un Agente con memoria nativa, sia che tu utilizzi uno spazio di lavoro per revisioni sistematiche; cambiano solo i pulsanti.
Configurazione Jenova, meno di due minuti e poi gestione continuativa
- Apri Academic Research Assistant e, se il progetto è di lunga durata, salva il protocollo come istruzioni personalizzate su un Agente dedicato.
- Allega il protocollo, le stringhe di ricerca e qualsiasi foglio di calcolo di screening esistente come base di conoscenza.
- Inizia con un riepilogo dello stato, non con un vago «continua»:
Riformula il nostro PICO, i database cercati, la data dell'ultima ricerca, il numero di studi inclusi/esclusi e i tre conflitti irrisolti dell'ultima sessione. Quindi sottoponi a screening i successivi 25 titoli rispetto ai criteri congelati. Non ampliare l'inclusione.
- Termina ogni sessione con un passaggio di consegne scritto che la sessione successiva possa caricare: aggiornamenti della ricerca, nuove esclusioni con motivazioni, campi di estrazione ancora mancanti e domande per il secondo revisore.
I piani Jenova a pagamento partono da $20/mese per 30× l'indennità d'uso gratuita, con livelli superiori a $50, $100, $200, $500 e $1.000 al mese. L'utilizzo si reimposta ogni mese alla data di fatturazione. Questo prezzo è rilevante per il lavoro plurimensile perché una revisione che muore quando si raggiunge il limite del piano gratuito a metà screening rappresenta un fallimento della memoria di altro tipo.
Configurazione Elicit
Il flusso per le revisioni sistematiche di Elicit è: perfezionare il protocollo, combinare ricerche su PubMed, ClinicalTrials.gov e il proprio corpus di articoli, oppure importare da altri database; eseguire lo screening con doppia revisione assistita da AI; estrarre con campi supportati da citazioni; infine sintetizzare report che possono includere diagrammi di flusso PRISMA, tabelle riepilogative degli articoli e strategie di ricerca. Le revisioni continue sono la funzionalità pensata per i mesi: combina la revisione con gli avvisi affinché lo stesso protocollo assorba nuovi articoli senza creare un nuovo progetto.
Configurazione Gemini Notebook
Crea un notebook per ogni revisione. Carica protocollo, esportazione della ricerca e PDF. Poni solo domande a cui dovrebbe essere possibile rispondere a partire da quei file. Quando nuovi articoli superano lo screening, aggiungili allo stesso notebook anziché avviarne un secondo; i notebook separati sono il modo in cui gli strumenti ancorati alle fonti «dimenticano».
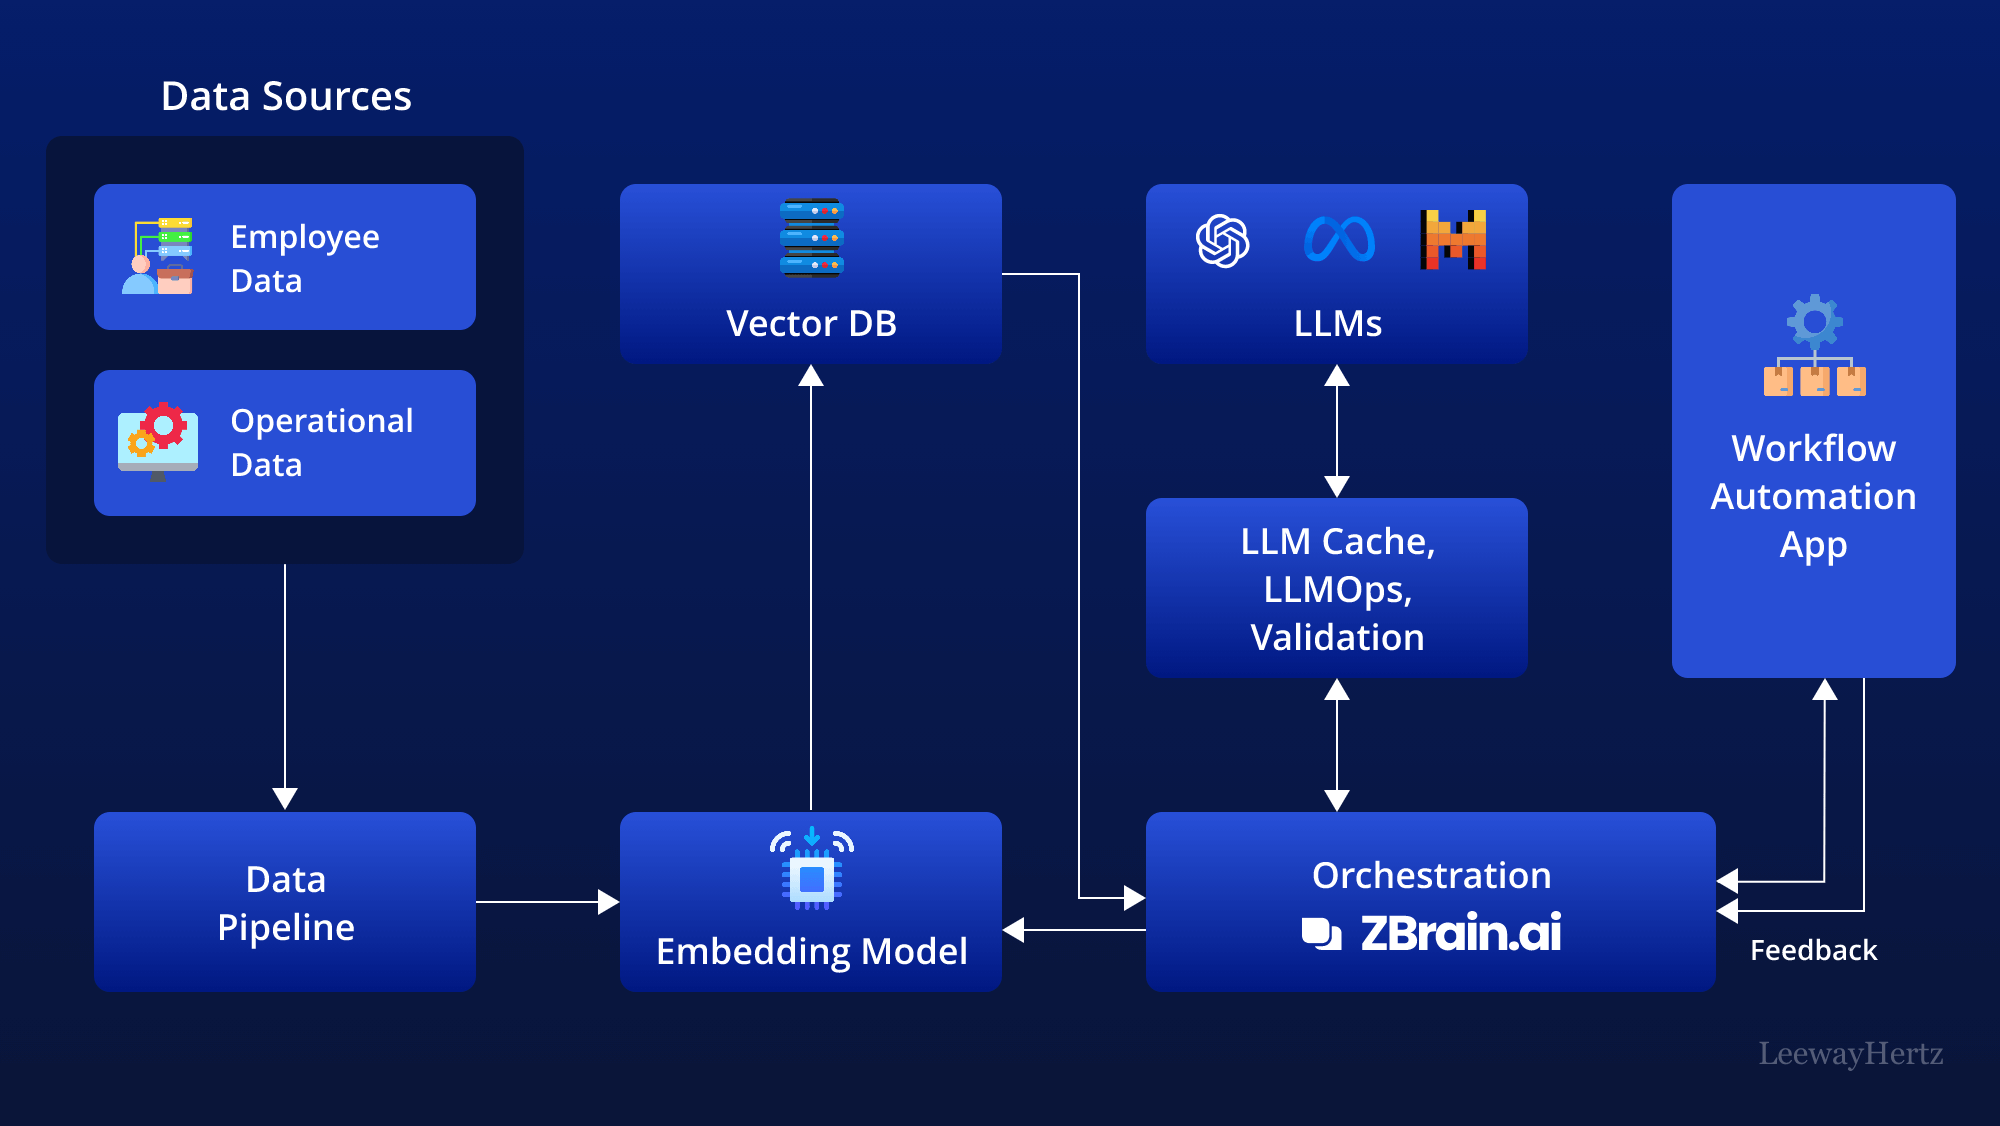
Il diagramma di architettura è la versione industriale dello stesso concetto. La memoria di ricerca durevole è una pipeline: le fonti attraversano ingestione, embedding, archivio vettoriale, orchestrazione, chiamate al modello, convalida e ciclo di feedback. I ricercatori non devono assemblare personalmente questo stack, ma hanno bisogno di un prodotto che lo implementi. La conversazione di sessione è solo l'ultima casella. Se i risultati non arrivano mai nella memoria, in una base di conoscenza o in uno spazio di lavoro per revisioni, la pipeline non ha stato e, al quarto mese, dovrai rispiegare il primo mese.
Cosa dicono i metodologi della ricerca sulla memoria AI nella sintesi delle evidenze?
I metodologi considerano l'AI un revisore che fa risparmiare lavoro ma presenta un problema di audit, non un sostituto di un protocollo ricostruibile. La domanda utile per gli esperti non è «il modello può estrarre una dimensione del campione?», ma «un secondo essere umano può vedere perché questo articolo è stato escluso a febbraio ed essere ancora d'accordo a ottobre?».
«Le revisioni che crollano al sesto mese quasi mai falliscono perché il modello ha mancato un sinonimo. Falliscono perché la regola di inclusione non è mai stata archiviata come oggetto. I team riscrivono una definizione di popolazione leggermente diversa a ogni sessione, poi si chiedono perché la tabella delle evidenze non si stabilizzi. La memoria persistente non è una funzionalità di comodità in quel contesto. È l'unico modo perché protocollo e risultati occupino la stessa linea temporale.»
«Vediamo anche team che ripongono eccessiva fiducia nell'estrazione strutturata e investono troppo poco nei registri delle decisioni. I campi dati supportati da citazioni sono necessari e gli studi di estrazione del 2026 sono incoraggianti per l'accuratezza rispetto al tempo. Non registrano però perché un trial al limite sia stato mantenuto. Se la tua AI non può recuperare quella motivazione, non hai una revisione continua. Hai una serie di conversazioni correlate.»
«La progettazione pratica che raccomandiamo è noiosa: congela il protocollo nelle istruzioni, accumula i risultati nella memoria o in uno spazio di lavoro, ancora le risposte a un corpus che puoi indicare ed esporta un audit che la checklist PRISMA può utilizzare. Scegli gli strumenti per questi quattro compiti. Non scegliere uno strumento perché il primo pomeriggio è sembrato fluido.»
— Team di prodotto Jenova, progettazione di flussi di lavoro di ricerca a lungo termine
Questa posizione coincide con il mondo della rendicontazione in cui le revisioni devono entrare. Il documento di spiegazione ed elaborazione di PRISMA 2020 su PMC è esplicito nel dire che la linea guida riguarda le revisioni che includono una sintesi, e l'EQUATOR Network ospita la stessa linea guida di rendicontazione aggiornata. Un assistente incapace di ricordare i metodi non può aiutarti a riportare i metodi.
Cosa accade alla riproducibilità quando un assistente AI non ricorda le esclusioni del mese scorso?
La riproducibilità si riduce a una messinscena: puoi ancora generare una sezione fluida sui lavori correlati, ma non puoi più difendere l'insieme degli studi. Un progetto di mesi produce centinaia di decisioni di inclusione/esclusione. Se tali decisioni non sono recuperabili, un nuovo selezionatore, un supervisore o un revisore editoriale non può distinguere un'esclusione guidata dal protocollo da una decisione dettata dall'umore della sessione.
Le revisioni sistematiche continue rendono visibile il fallimento. Elicit descrive le revisioni continue come l'unione della revisione completata con avvisi, affinché nuove informazioni possano essere assorbite ogni anno, o secondo necessità, e consente di condividere un link all'intero processo e ai risultati intermedi. Questo funziona solo se le esclusioni del trimestre precedente fanno parte dell'oggetto aggiornato. Un chatbot che «ricorda l'argomento» ma non il registro delle esclusioni reincluderà articoli già respinti oppure respingerà di nuovo articoli già estratti.
Tre controlli di riproducibilità rivelano rapidamente il divario:
- Test di riproduzione. Chiedi all'assistente, dopo una settimana lontano dal progetto, di elencare le ultime 20 esclusioni con motivazione. Se inventa ragioni o mescola progetti, manca il livello di audit.
- Test di ampliamento. Fornisci un riassunto fuori ambito ma tematicamente allettante. Se sostiene l'inclusione senza citare i criteri congelati, la persistenza del protocollo ha fallito.
- Test di passaggio di consegne. Un collega dovrebbe poter continuare dall'ultimo riepilogo di stato dell'assistente senza un briefing verbale. Se non può farlo, la memoria è personale, non scientifica.
Jenova supera i test di riproduzione e passaggio di consegne quando vengono effettivamente usate istruzioni, basi di conoscenza e memoria delle sessioni; richiede comunque l'esportazione di un registro in forma PRISMA se una rivista richiede un diagramma di flusso. Elicit gestisce più nativamente il test di audit, ma richiede comunque di conservare altrove il giudizio scientifico informale. Consensus e Gemini Notebook, se usati da soli, falliscono controlli diversi: Consensus non riprodurrà le tue esclusioni e Gemini Notebook non riprodurrà articoli che non sono mai stati caricati.
Il problema della ricerca plurimensile, quindi, non è «quale modello è il più intelligente nel 2026». È se strategie di ricerca, criteri di inclusione e risultati precedenti vengono conservati in uno stack che esiste ancora quando torni al progetto. Scegli lo strumento che conserva questi tre oggetti, poi fai in modo che l'assistente li riformuli all'inizio di ogni sessione affinché ogni deriva debba avvenire apertamente.
Riferimenti
- Dichiarazione PRISMA 2020 — Checklist, diagrammi di flusso e guida alla rendicontazione per revisioni sistematiche
- Dichiarazione PRISMA — Panoramica della principale linea guida di rendicontazione per revisioni sistematiche
- The BMJ — La dichiarazione PRISMA 2020: una linea guida aggiornata per la rendicontazione di revisioni sistematiche
- Hofstra University LibGuides — Checklist PRISMA di 27 elementi per revisioni sistematiche e meta-analisi
- ScienceDirect — Strumenti AI per revisioni sistematiche della letteratura e meta-analisi, inclusa una mappatura di 63 strumenti ML
- King's College London — Strumenti AI nella sintesi delle evidenze
- Elicit — Revisioni sistematiche della letteratura: screening, estrazione, audit PRISMA, revisioni continue e risultati di convalida
- Elicit — Panoramica di prodotto e prezzi, incluse le dimensioni del corpus e la base di ricercatori
- Consensus — Motore di ricerca accademico AI, dimensioni del corpus, Deep Search e modalità Medical
- Paperguide — Consensus vs NotebookLM: scoperta delle evidenze rispetto alla trasformazione delle fonti, 2026
- Gemini Notebook, precedentemente NotebookLM — Notebook ancorati alle fonti, citazioni a livello di passaggio e politica d'uso dei dati
- DistillerSR — Linee guida PRISMA ed errori che compromettono le revisioni sistematiche
- medRxiv — Accuratezza ed efficienza dell'estrazione dati assistita da AI con Elicit rispetto all'estrazione esclusivamente umana, 2026
- Wiley / Cochrane Evidence Synthesis and Methods — Strumenti AI come secondi revisori per l'estrazione dei dati
- Birmingham City University — Prestazioni dell'AI generativa nell'estrazione dei dati per revisioni della letteratura
- PubMed Central — Spiegazione ed elaborazione di PRISMA 2020
- EQUATOR Network — Scheda della linea guida di rendicontazione PRISMA 2020