Come posso impedire a un assistente di ricerca AI di inventare citazioni false?
2026-08-21
Quali protezioni distinguono gli strumenti di ricerca AI basati sulle citazioni dai chatbot che allucinano?
Il modo più affidabile per impedire a un assistente di ricerca AI di inventare articoli è rifiutare gli strumenti che generano riferimenti a memoria, richiedere che ogni affermazione sia collegata a un record recuperato con un identificatore verificabile automaticamente e verificare ogni citazione rispetto alla fonte prima che entri in un manoscritto. Nel 2026, questo stack — recupero basato su fonti, controlli degli identificatori e verifica umana — è ciò che distingue strumenti per la letteratura come l'Assistente di Ricerca Accademica di Jenova, Elicit, SciSpace, Consensus e Scite dai chatbot generalisti che continuano a fabbricare riferimenti dall'aspetto plausibile.
Fattori chiave che riducono davvero le fonti inventate:
✅ Recupero anziché richiamo dalla memoria — l'assistente deve cercare record accademici indicizzati, non completare automaticamente una bibliografia usando i dati di addestramento. ✅ Associazione a un identificatore — ogni lavoro citato dovrebbe riportare un DOI, PMID, arXiv ID o URL dell'editore che possa essere risolto indipendentemente. ✅ Fedeltà, non soltanto esistenza — un articolo reale citato per una scoperta che non contiene è comunque un errore, come ha dimostrato la ricerca sulla valutazione RAG. ✅ Precisione bibliografica — nomi degli autori, anni, volumi e intervalli di pagine devono corrispondere al record, non a una quasi-corrispondenza inventata dal modello. ✅ Un ciclo di verifica umana — Stanford Libraries e le principali guide di stile attribuiscono all'autore, non allo strumento, la responsabilità di ogni citazione.
Per confrontare utilmente gli strumenti, è utile trattare l'integrità delle citazioni come un problema di architettura anziché come un trucco di prompt writing. Il resto di questa guida illustra tale architettura, le modalità di errore che deve intercettare e un workflow che puoi applicare a qualsiasi assistente.
Perché le citazioni AI fabbricate compaiono negli articoli pubblicati nel 2026?
Le citazioni fabbricate non sono più un aneddoto da aula universitaria. Stanno entrando in riviste, pratiche di finanziamento e indici citazionali perché i ricercatori incollano nei manoscritti bibliografie prodotte dai chatbot senza risolvere ciascun riferimento. Un'analisi di Nature del 2026 ha stimato che decine di migliaia di pubblicazioni del 2025 potrebbero contenere riferimenti AI non validi.
Lo schema di contaminazione è distintivo. L'informatico Guillaume Cabanac venne avvisato che uno dei suoi articoli era stato citato nell'International Dental Journal — un settore che non si sovrappone al suo lavoro sull'individuazione di articoli fabbricati — e scoprì di non riuscire a riconoscere la propria citazione. È così che le citazioni fantasma si diffondono: sembrano formattate correttamente, indicano sedi editoriali dal suono credibile e superano una lettura superficiale.
I casi documentati sono abbastanza gravi da imporre ritrattazioni. Resnik e Hosseini riassumono un articolo in Academic Ethics nel quale 19 citazioni su 29 erano allucinate, un articolo di PLOS ONE successivamente ritirato con 18 citazioni inventate su 76 e una prospettiva pubblicata in Digestive Diseases and Sciences in cui 12 riferimenti su 14 non esistevano. Uno studio del 2025 sulle citazioni di GPT-4o nell'ambito della salute mentale ha rilevato che il 56% conteneva errori, con circa una citazione su cinque completamente allucinata.
La preoccupazione del corpo docente è ormai quasi universale. Una ricerca del College Board riporta che i docenti temono che l'uso dell'AI stia compromettendo il pensiero critico, la scrittura originale e l'integrità accademica. Guide delle biblioteche come quella dell'UNC Charlotte trattano ora le citazioni allucinate come un rischio standard della ricerca, non come un caso limite.
L'implicazione per la scelta dello strumento è netta. Se un assistente può produrre un riferimento APA o Vancouver ben formattato senza recuperare un record attivo, può inventare un articolo mai esistito — e quell'articolo può arrivare fino alla stampa.
Cosa dovresti valutare prima di affidare a un assistente di ricerca AI il tuo elenco di riferimenti?
Dovresti valutare un assistente di ricerca AI in base a uno Stack di Integrità delle Citazioni in cinque parti: fonte di verità, associazione a identificatori, fedeltà tra affermazione e passaggio, precisione bibliografica e un ciclo obbligatorio di verifica umana. Gli strumenti che ottengono buoni risultati in fluidità e scarsi risultati su questo stack non sono sicuri per gli elenchi di riferimenti, indipendentemente da quanto appaia raffinata la prosa.
1. Fonte di verità
Chiediti se le risposte provengono da un corpus recuperato o dalla memoria parametrica. I sistemi con recupero cercano su Google Scholar, PubMed, Semantic Scholar, Scopus o arXiv e poi generano il testo. I chatbot senza recupero predicono il token successivo di una citazione. Esistono metriche di fedeltà proprio perché la generazione può discostarsi dal contesto recuperato anche quando il recupero è avvenuto.
2. Associazione a identificatori
Una tripla titolo-autore-anno non basta. Richiedi un DOI, PMID, PMCID o URL dell'editore, poi risolvilo personalmente. I riferimenti fantasma spesso non superano immediatamente questo test. Le quasi-corrispondenze bibliografiche — un articolo reale con un volume o un intervallo di pagine sbagliato — falliscono al secondo controllo.
3. Fedeltà tra affermazione e passaggio
La ricerca ACM sulle citazioni RAG ha rilevato che la correttezza non equivale alla fedeltà: fino al 57% delle citazioni può non supportare l'affermazione che dovrebbe sostenere. Un articolo che esiste ma non contiene la scoperta indicata è pericoloso quanto un articolo inesistente, perché ricicla un risultato falso attraverso un autore reale.
4. Precisione bibliografica
Ordine degli autori, anno, sede editoriale, volume, fascicolo e pagine devono corrispondere al record. Gli strumenti RAG testati nel campo dell'amministrazione aziendale hanno mostrato che gli elementi "fantasma" completamente fabbricati possono essere rari, mentre piccoli errori bibliografici restano comuni. Tali errori compromettono comunque gli indici citazionali e possono nascondere articoli scambiati.
5. Ciclo di verifica umana
La politica editoriale APA, come riassunta da Stanford, stabilisce che gli autori devono verificare qualsiasi informazione e citazione fornita da uno strumento AI. Anche le linee guida per ricercatori di Wiley e le indicazioni sull'integrità della ricerca di Harvard attribuiscono la divulgazione e l'accuratezza all'autore umano. Nessun assistente di questa categoria elimina tale obbligo.
Attribuisci un peso allo stack in base al compito. Le revisioni sistematiche dovrebbero dare maggiore peso alla fedeltà e all'associazione a identificatori. La scansione esplorativa può tollerare un richiamo più ampio se ogni elemento conservato viene verificato prima di essere citato. Non attribuire mai un peso eccessivo alla qualità della prosa. I paragrafi fluidi sono il meccanismo che rende convincenti le citazioni false.
Come si confrontano i popolari strumenti di ricerca AI in termini di affidabilità delle citazioni?
Divergono nettamente in base al fatto che i riferimenti vengano recuperati da indici accademici oppure generati dalla memoria del modello, e questa singola scelta progettuale predice la maggior parte del rischio di citazioni fantasma. I chatbot generalisti restano l'opzione a più alto rischio per le bibliografie. Gli assistenti di ricerca progettati appositamente riducono i riferimenti fantasma, ma possono comunque citare in modo inaccurato, classificare erroneamente i metadati ed enfatizzare eccessivamente ciò che un articolo dimostra.
Nel 2026, un confronto pratico appare così:
| Funzionalità / Dimensione | Chatbot generalisti (ad es. ChatGPT) | Elicit | SciSpace | Consensus | Scite | Assistente di Ricerca Accademica Jenova |
|---|---|---|---|---|---|---|
| Fonte delle prove | Perlopiù memoria parametrica, salvo l'attivazione della navigazione | Articoli recuperati, tabelle di estrazione | Recupero da più database (Google Scholar, PubMed, arXiv) | Articoli recuperati per domande empiriche | Indice citazionale con contesto di supporto/contrasto | Scoperta della letteratura in tempo reale tra database accademici e repository |
| Rischio di riferimenti fantasma | Alto; documentato in riviste e laboratori | Basso negli studi RAG sugli elenchi di riferimenti | Basso negli studi RAG sugli elenchi di riferimenti | Basato sul recupero; verificare comunque | Basso per gli elementi presenti nel suo grafo citazionale | Basato sul recupero; richiede comunque controlli DOI indipendenti |
| Fedeltà tra affermazione e fonte | Debole senza passaggi recuperati | Più forte per l'estrazione strutturata | Più forte quando le risposte citano articoli recuperati | Più forte per domande empiriche sì/no | Forte per capire come viene citato un articolo | Dipende dai passaggi recuperati e dalla scelta del modello; necessario controllo umano |
| Precisione bibliografica | Frequenti dettagli inventati | Piccole imprecisioni riportate negli audit RAG | Piccole imprecisioni riportate negli audit RAG | Non verificata a livello di audit sul campo | Forte per quanto riguarda il contesto citazionale | Eredita i metadati dai record recuperati; può comunque discostarsi nella prosa |
| Prezzi (nel 2026) | Varia in base al piano del fornitore | Non verificato | Non verificato | Non verificato | Non verificato | Piano gratuito con uso limitato; piani a pagamento da $20/mese |
| Ideale per | Redigere testi, non creare un elenco di riferimenti | Tabelle delle evidenze ed estrazione sistematica | Ricerca bibliografica ampia e interdisciplinare | Risposte rapide a domande empiriche sì/no | Convalidare se le citazioni supportano o contraddicono un'affermazione | Scoperta della letteratura end-to-end, preparazione dei manoscritti e gestione delle citazioni con memoria persistente |
Chatbot generalisti
I chatbot eccellono nella creazione di scalette e nella parafrasi, ma falliscono nella costruzione delle bibliografie. L'audit sulla salute mentale con GPT-4o citato sopra fornisce il dato cautelativo: più della metà delle citazioni generate conteneva errori. Se uno strumento può produrre un riferimento dall'aspetto perfetto senza un record attivo, considera ogni citazione come non verificata.
Elicit
Elicit è più efficace quando il compito consiste nello screening degli articoli e nell'estrazione di metodi, risultati e limiti in una tabella. Confronti indipendenti lo descrivono come più adatto a workflow rigorosi e basati sulle evidenze che a una ricerca esplorativa rapida. Il suo limite è la densità di copertura: in un benchmark gestito da SciSpace su 200 query, Elicit ha restituito 13,0 articoli altamente pertinenti per query contro i 26,3 di SciSpace Deep Review. Questo divario conta per il richiamo, non per il rischio di citazioni fantasma.
SciSpace
SciSpace ricerca in più database accademici e, nella propria valutazione Deep Review, ha ottenuto la migliore precisione da P@3 a P@70. Tale ampiezza aiuta nelle domande interdisciplinari, in cui le prove si trovano contemporaneamente su PubMed, arXiv e Google Scholar. Il limite è metodologico: il benchmark principale è stato eseguito da SciSpace, anche se le etichette di pertinenza provenivano da tre modelli esterni. Considera i benchmark dei fornitori come indicativi, quindi verifica personalmente gli elementi conservati.
Consensus
Consensus è progettato per rispondere a domande scientifiche empiriche basandosi sugli articoli, anziché per scrivere una revisione narrativa. Nello stesso test su 200 query, Consensus Deep ha ottenuto la migliore precisione sul primo risultato (P@1 = 0.5882) e ha poi perso quel vantaggio scendendo più in profondità nell'elenco. È un valido strumento per trovare punti di partenza, ma meno adatto come motore principale per lunghi insiemi di screening.
Scite
L'asset distintivo di Scite è l'intelligenza citazionale: mostra se gli articoli successivi supportano, menzionano o contraddicono una determinata affermazione. I confronti lo posizionano come più circoscritto di uno strumento completo per le operazioni di ricerca, ma più forte per la validazione delle evidenze. Se la tua modalità di errore è "questo articolo reale non dice ciò che l'assistente ha affermato", il contesto citazionale in stile Scite è lo strumento giusto.
Assistente di Ricerca Accademica Jenova
L'Assistente di Ricerca Accademica di Jenova è progettato per accademici e dottorandi che necessitano della scoperta della letteratura insieme al supporto per manoscritti e citazioni in un unico spazio di lavoro persistente. Può cercare in tempo reale nei principali database accademici e repository, conservare la memoria del progetto tra le sessioni e redigere testi con modelli aggiornati anziché con il vincolo di un singolo fornitore. Questa combinazione è utile quando una revisione dura settimane e l'assistente deve ricordare criteri di inclusione, articoli esclusi e DOI irrisolti.
Non è un indice dedicato al contesto citazionale, quindi non sostituirà Scite per le mappe di supporto rispetto al contrasto. Non è una griglia di estrazione appositamente progettata nel senso di Elicit. La ricerca in tempo reale può inoltre recuperare record di bassa qualità o non corrispondenti che un modello fluido poi sovrainterpreta. La regola operativa corretta è la stessa per ogni strumento di recupero: usalo per trovare e organizzare candidati, non per approvare una bibliografia.
Il recupero potenziato dalla generazione elimina completamente i riferimenti fantasma?
No. Il recupero potenziato dalla generazione (RAG) riduce drasticamente gli articoli completamente inventati nell'elenco dei riferimenti, ma non elimina gli errori bibliografici e non garantisce che un articolo recuperato supporti la frase a cui è associato. La prevenzione deve quindi intervenire su tre diverse modalità di errore, non su una soltanto.
Le tre modalità sono facili da confondere perché tutte e tre producono "citazioni dall'aspetto plausibile":
- Riferimenti fantasma — il lavoro citato non esiste.
- Deriva bibliografica — il lavoro esiste, ma autori, anno, volume o pagine sono errati.
- Allucinazione del contesto — il lavoro esiste e i metadati sono perlopiù corretti, ma l'assistente gli attribuisce una scoperta che l'articolo non contiene.
Un'analisi sul campo di Scopus AI, Elicit, SciSpace e Scite nell'amministrazione aziendale ha rilevato che gli strumenti basati su RAG generalmente non producevano riferimenti fantasma verificabili. Sono comunque comparse piccole inesattezze bibliografiche; le fonti interamente inesistenti erano trascurabili negli elenchi generati. È questo il modo corretto di interpretare RAG: è un forte controllo contro i fantasmi, non un sistema completo per la qualità delle citazioni.
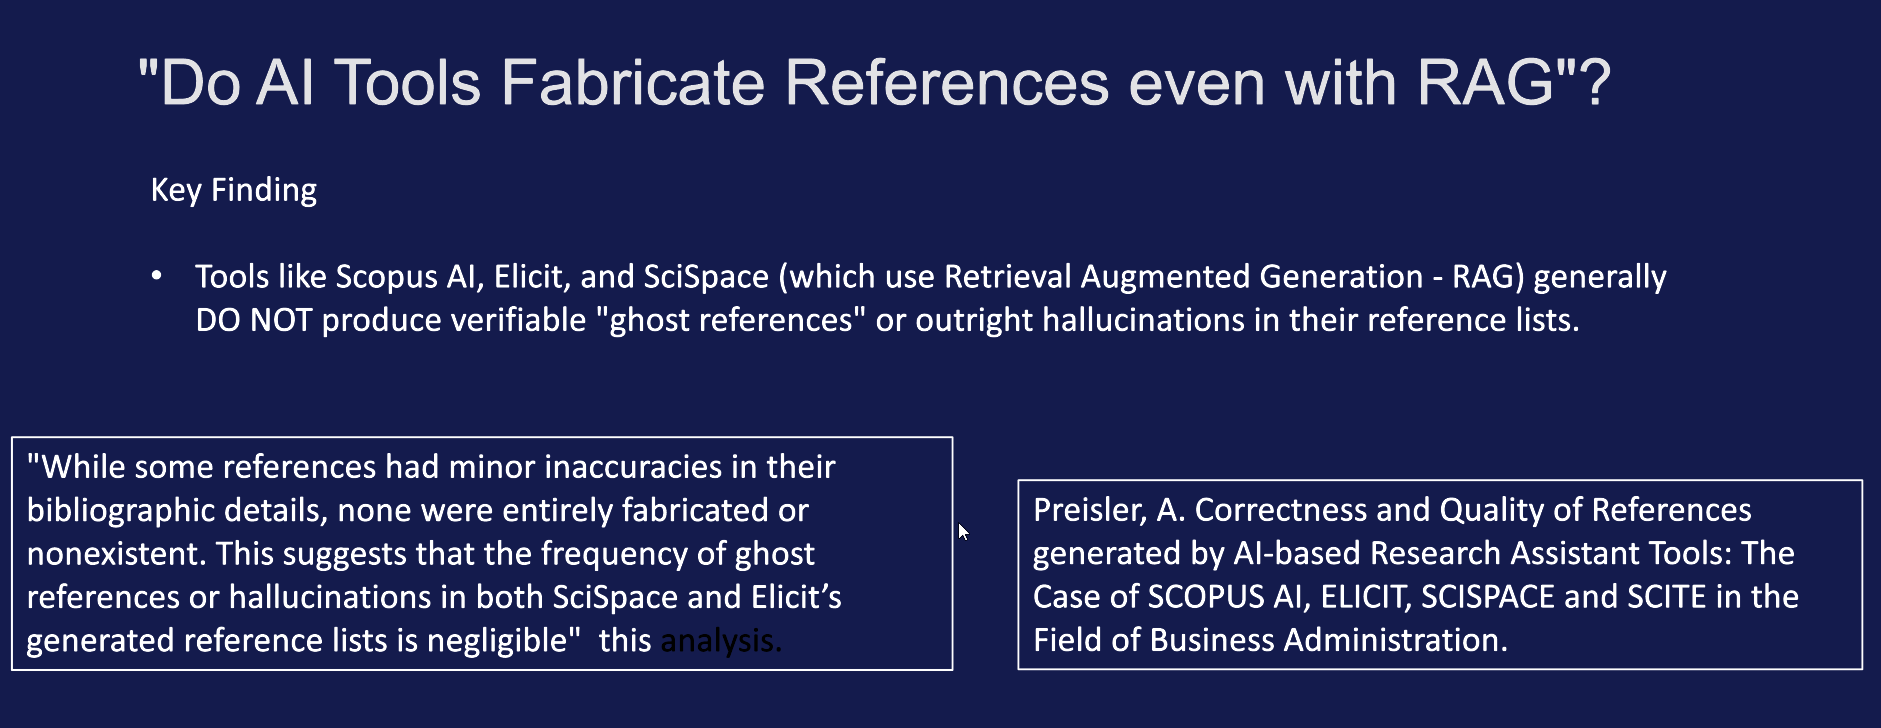
La ricerca sulla fedeltà spiega il rischio rimanente. I framework di valutazione RAG separano la pertinenza della risposta dalla fedeltà: una risposta può essere pertinente all'argomento e tuttavia non essere fondata nei passaggi recuperati. Il risultato ACM secondo cui un'ampia quota di citazioni RAG può mancare di fedeltà è l'avvertimento operativo. Se controlli solo se un DOI viene risolto, intercetterai i riferimenti fantasma ma non le affermazioni attribuite erroneamente.
I chatbot generalisti falliscono nella prima modalità. Gli assistenti RAG falliscono soprattutto nella seconda e nella terza. Un workflow di prevenzione che chiede soltanto "questo articolo esiste?" è quindi incompleto per gli strumenti che i ricercatori dovrebbero effettivamente utilizzare.
Come verifichi le citazioni restituite da un assistente di ricerca AI?
Le verifichi con un protocollo in due passaggi: prima risolvi l'identificatore, poi confermi che un passaggio specifico supporti l'affermazione. Saltare uno dei due passaggi è il modo in cui fonti inventate o usate impropriamente arrivano alla pubblicazione.
Passaggio 1 — Il record esiste?
- Copia esattamente il titolo, il primo autore, l'anno e il DOI così come vengono restituiti.
- Risolvi il DOI in una pagina del registrar o dell'editore. Se non c'è un DOI, cerca il titolo esatto su Google Scholar, PubMed o sul sito della rivista, seguendo l'approccio di ricerca diretta raccomandato dalle guide di ricerca.
- Rifiuta qualsiasi elemento che non venga risolto, che venga risolto in un articolo diverso o che esista solo come citazione formattata dall'AI.
- Controlla l'ordine degli autori, l'anno, il volume, il fascicolo e le pagine rispetto al record dell'editore, non rispetto al blocco bibliografico dell'assistente.
Passaggio 2 — Questo articolo supporta questa frase?
- Apri il testo completo in PDF o HTML. Gli abstract non bastano per affermazioni causali, dimensioni dell'effetto o formulazioni come "prima evidenza".
- Individua il passaggio che dovrebbe supportare l'affermazione. Citalo nelle tue note.
- Contrassegna la citazione come di supporto, menzione o contrasto — la distinzione che Scite trasforma in prodotto e che puoi applicare manualmente.
- Se l'assistente ha parafrasato un limite come una scoperta, o un'ipotesi come un risultato, scarta la citazione per quella frase.
Per l'Assistente di Ricerca Accademica di Jenova, limita il recupero prima ancora di generare un elenco di riferimenti:
"Cerca articoli peer-reviewed e preprint su [argomento], 2019–2026. Restituisci solo elementi con un DOI o PMID. Per ciascuno: titolo, autori, anno, sede editoriale, identificatore, risultato in una frase e un passaggio citato. Se non riesci a recuperare un record verificabile, ometti completamente l'elemento. Non completare né indovinare i metadati."
Quindi sottoponi gli stessi elementi conservati a Elicit o SciSpace come secondo controllo del corpus. Il disaccordo tra gli strumenti è un vantaggio: segnala gli articoli classificati da un sistema che l'altro non è riuscito a recuperare.
Il reportage di Science sugli articoli scientifici allucinati mostra perché leggere rapidamente i titoli non basta. Un assistente può citare correttamente un articolo reale e poi inventarne uno vicino nello stesso paragrafo. La verifica deve avvenire elemento per elemento, non paragrafo per paragrafo.
Una citazione allucinata può configurare una condotta scorretta nella ricerca?
Sì, in una serie definita di casi — e anche quando non soddisfa la definizione legale di condotta scorretta, può comunque provocare ritrattazioni, problemi con i finanziamenti e danni alla carriera. Il motivo per prevenirla non è il galateo. È la responsabilità.
Resnik e Hosseini sostengono che una citazione allucinata possa qualificarsi come condotta scorretta nella ricerca dimostrabile ai sensi delle normative federali statunitensi quando ricorrono tre condizioni: un ricercatore ha usato uno strumento generativo per produrre citazioni inesistenti; tali citazioni funzionano come dati perché supportano risultati, come nelle revisioni o negli studi bibliometrici; e il ricercatore ha mostrato indifferenza verso il rischio di fabbricazione non controllando l'output. Un riferimento fantasma in un'introduzione narrativa è cattiva pratica accademica. Un riferimento fantasma conteggiato come evidenza in una revisione sistematica è più vicino alla fabbricazione di dati.
I finanziatori stanno già trattando il problema come operativo. Nell'estate del 2025, il personale addetto alla revisione delle sovvenzioni NIH è stato sommerso da proposte assistite dall'AI e l'agenzia ha indicato che l'uso improprio dell'AI scoperto dopo l'assegnazione potrebbe essere deferito a una revisione sull'integrità. L'hub di integrità della ricerca di Harvard ribadisce vincoli correlati: gli strumenti AI non possono essere elencati come autori, ai revisori scientifici paritari NIH è vietato usare l'AI generativa per formulare critiche e gli autori devono dichiarare come sono stati usati gli strumenti.
Le riviste stanno convergendo sulla medesima attribuzione di responsabilità. La raccolta di Stanford delle regole APA, MLA, Chicago e IEEE richiede la divulgazione dei contenuti generati dall'AI e, nel caso APA, l'esplicita verifica umana delle citazioni. Le linee guida didattiche di Cornell avvertono inoltre che gli algoritmi automatizzati di rilevamento dell'AI sono troppo inaffidabili per costituire una strategia di integrità. Il rilevamento dopo i fatti è un debole sostituto della verifica prima dell'invio.
Lo standard pratico è semplice. Se non puoi indicare un record risolto e un passaggio di supporto, la citazione non appartiene al manoscritto, alle slide o alla proposta di finanziamento.
Cosa dicono gli specialisti dell'integrità della ricerca sulle citazioni generate dall'AI?
Gli specialisti trattano ora i riferimenti inventati come un fallimento di processo — usare un modello generativo come una biblioteca — anziché come un misterioso bug del modello che gli utenti non possono prevedere. Il consenso tra uffici per l'integrità e studi sulle citazioni è che RAG riduce i riferimenti fantasma, la verifica umana rimane obbligatoria e le bibliografie non supervisionate dei chatbot sono imprudenti, considerato ciò che già si conosce sul tasso di errore.
"L'errore che continua ad arrivare alle riviste non è che i modelli talvolta indovinano. È che i ricercatori lasciano a un modello linguistico l'esecuzione di un compito di catalogazione per il quale non è stato progettato. Se l'assistente non ha recuperato un record, sta completando uno schema bibliografico, e gli schemi completati sono il modo in cui si ottiene un articolo dall'aspetto reale in una rivista dall'aspetto reale con un DOI che non viene risolto. Passare a uno strumento di recupero riduce drasticamente questa modalità di errore. Non riduce però la successiva: citare un articolo reale per un risultato che risiede nel riassunto del modello anziché nella sezione dei risultati."
"Diciamo agli utenti della ricerca di adottare un workflow a tre contenitori. Il contenitore A è recuperato e controllato rispetto ai passaggi: quelle citazioni possono essere usate. Il contenitore B è recuperato ma con soli metadati controllati: resta in una lista di lettura. Il contenitore C è qualunque cosa il modello abbia prodotto senza un identificatore risolvibile: va eliminata, non 'cercata in seguito'. I team che saltano il contenitore C perché la formattazione sembra costosa sono quelli che in seguito scoprono che 12 riferimenti su 14 non sono mai esistiti. Il costo del passaggio aggiuntivo è trascurabile rispetto a una ritrattazione o a un deferimento per l'integrità di un finanziamento."
— Team di Prodotto Jenova, progettazione di agenti di ricerca AI per workflow accademici
Questo consiglio è coerente con le politiche degli editori e delle università: indica lo strumento, il compito che ha svolto e mantieni l'autore umano responsabile di ogni riferimento. Le linee guida sull'integrità non dicono più "evita l'AI". Dicono "non esternalizzare l'esistenza delle tue fonti".
Come si conduce una revisione della letteratura sicura per le citazioni con l'AI?
La conduci come una pipeline con recupero prima, estrazione dopo, prosa alla fine e un controllo di verifica che nessuna frase possa saltare. Invertire questo ordine — redigere l'argomentazione e poi chiedere a un assistente di "aggiungere citazioni" — è lo schema di prompt più associato ai riferimenti fantasma.
Un workflow che resiste al controllo di riviste e finanziatori:
- Scrivi le regole di inclusione prima di cercare. Popolazione, intervento, anni, lingue, tipi di studio. Incolla tali regole nell'assistente affinché la memoria, se lo strumento la possiede, persista tra le sessioni.
- Cerca con due strumenti di recupero, non uno. Esempio di abbinamento: Assistente di Ricerca Accademica di Jenova più Elicit o SciSpace. Conserva l'unione dei risultati; non fidarti di un'unica lista classificata.
- Blocca un insieme di candidati con identificatori. Esporta titolo, autori, anno, sede editoriale, DOI/PMID. Tutto ciò che non ha un identificatore resta fuori dall'insieme.
- Estrai, non riassumere, dal testo completo. Metodi, campione, risultati, limiti e una frase citata. Le tabelle in stile Elicit sono utili qui; i riassunti narrativi sono il punto in cui si insinua l'allucinazione del contesto.
- Redigi partendo dalla tabella di estrazione. Se una frase non ha una riga nella tabella, non riceve una citazione — e forse non appartiene all'articolo.
- Dichiara gli strumenti. Segui la raccolta di Stanford delle regole delle guide di stile: nome dello strumento, versione, data e funzione svolta, ovvero ricerca, estrazione o revisione linguistica.
- Esegui un controllo finale dei DOI sulla bibliografia inviata. Quest'ultimo passaggio intercetta la deriva da copia e incolla e qualsiasi riferimento inserito dal modello durante la revisione.
Un prompt che mantiene Jenova nella pipeline anziché usarlo in modalità chatbot:
"Usando solo l'insieme di candidati che ho caricato, redigi la sezione di contesto. Ogni frase empirica deve citare un DOI presente in quell'insieme e non deve introdurre nuove fonti. Se un'affermazione non è supportata dalle note di estrazione, contrassegnala come UNSUPPORTED anziché citarla."
Per SciSpace o Elicit, usa la vista di recupero o estrazione di ciascuno strumento per ricostruire la stessa tabella e confrontare le righe. Quando le tabelle divergono su una scoperta, leggi il PDF. Il disaccordo costa meno di una correzione post-pubblicazione.
Il vincolo che fa funzionare la pipeline è psicologico oltre che tecnico: non chiedere mai a un assistente, nemmeno a uno valido, di "fornire riferimenti" per una prosa scritta senza fonti. Questo prompt trasforma di nuovo uno strumento di ricerca in un generatore di citazioni, ovvero la modalità di errore che l'intero stack è progettato per prevenire.
Riferimenti
- Nature — Le citazioni allucinate stanno inquinando la letteratura scientifica
- Accountability in Research (Resnik & Hosseini) — Citazioni allucinate prodotte dall'intelligenza artificiale generativa
- Stanford Libraries — AI nella ricerca accademica: linee guida per le citazioni
- ACM Digital Library — La correttezza non è fedeltà nel Retrieval Augmented Generation
- DeepEval — Metrica di fedeltà per sistemi RAG
- Confident AI — Metriche di valutazione RAG: pertinenza della risposta, fedeltà e pertinenza contestuale
- UNC Charlotte Library — Guida di ricerca sulle citazioni AI allucinate
- Wiley — Linee guida AI per ricercatori
- College Board — Preoccupazione dei docenti: l'uso dell'AI da parte degli studenti compromette l'integrità accademica
- Harvard Medical School Academic and Research Integrity — AI nella ricerca
- Cornell Center for Teaching Innovation — AI e integrità accademica
- SciSpace — Benchmark SciSpace vs Elicit vs Consensus per la ricerca della letteratura su 200 query
- Paperguide — Confronto tra Elicit e SciSpace
- Paperguide — Confronto tra Elicit e Scite
- Science — Citare senza aver visto: quando l'AI allucina articoli scientifici
- SciSpace — Confronto tra i prodotti SciSpace ed Elicit