Come può un assistente di ricerca AI mappare le lacune nelle evidenze per un nuovo argomento?
2026-08-22
Che cosa distingue un flusso di lavoro tracciabile di ricerca-selezione-mappatura dalle sintesi generiche della letteratura?
Un assistente di ricerca AI affidabile non inizia riassumendo qualunque articolo riesca a trovare. Costruisce una strategia di ricerca riproducibile, seleziona un insieme delimitato di studi rispetto a criteri espliciti e poi mappa ciò che tali studi coprono — e non coprono — affinché le celle vuote rappresentino lacune nelle evidenze anziché artefatti della ricerca. Nel 2026, questa distinzione è importante perché le sintesi generiche in chat possono apparire complete pur inventando citazioni o riducendo disegni di studio incompatibili a un’unica affermazione.
Per un nuovo argomento, l’unità di lavoro pratica è spesso un nucleo di 50 articoli: abbastanza ampio da rivelare cluster, abbastanza contenuto da consentire a un ricercatore di verificare ancora ogni decisione di inclusione o esclusione. Gli strumenti che supportano questo flusso di lavoro includono l’Academic Research Assistant di Jenova, il flusso di lavoro per revisioni sistematiche di Elicit, Rayyan e mappatori di reti citazionali come ResearchRabbit.
Ecco cosa separa un processo di ricerca-selezione-mappatura citabile da uno scarico indiscriminato di letteratura:
✅ Query tracciabili — stringhe Boolean, database, intervalli di date e sinonimi vengono documentati prima dell’inizio della selezione
✅ Selezione verificabile — ogni articolo riceve un tag di inclusione, esclusione o incertezza collegato a un criterio dichiarato
✅ Evidenze estratte, non parafrasate — risultati, metodi e limiti restano associati a una fonte verificabile
✅ Mappe delle lacune multidimensionali — le celle vuote sono codificate per popolazione, metodo, geografia e outcome, non individuate a intuito
✅ Verifica umana — l’AI prepara la mappa; il ricercatore conferma che ogni citazione esista nell’articolo originale
Per confrontare gli assistenti in modo significativo, è utile considerare ricerca, selezione e mappatura delle lacune come tre attività con modalità di errore differenti, anziché come un’unica funzionalità di «revisione della letteratura».
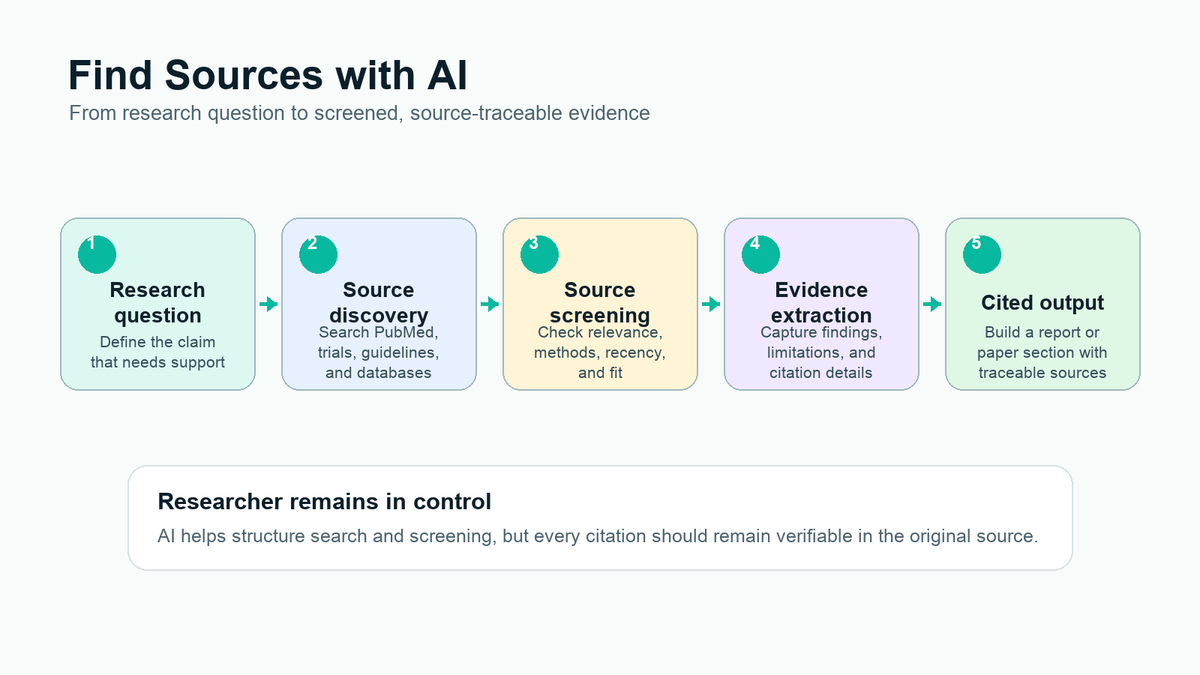
Perché le mappe delle lacune nelle evidenze stanno diventando essenziali per i nuovi argomenti di ricerca?
Le mappe delle evidenze e delle lacune sono diventate un modo standard per osservare a colpo d’occhio dove un campo è affollato e dove è silenzioso prima che un ricercatore si impegni in un nuovo disegno di studio. Una mappa delle evidenze e delle lacune è una presentazione visiva sistematica della disponibilità di evidenze pertinenti per un ambito politico o di ricerca, identificata tramite un protocollo di ricerca predefinito anziché un elenco di letture ad hoc.
Questa definizione, sviluppata per la Campbell Collaboration, è facile da usare impropriamente. Molte mappe riportano quali evidenze esistono, non a quali conclusioni portano le evidenze. Confondere le due cose genera una falsa fiducia: una cella densa può essere comunque metodologicamente debole e una cella vuota può derivare da una ricerca fallita anziché da una reale incognita.
Il metodo non è più di nicchia. Una revisione del settore sanitario del 2016 ha identificato 145 titoli di mappatura, di cui 34 pubblicazioni presentavano mappe delle evidenze esplicite. Le mapping review e le mappe delle evidenze e delle lacune sono oggi considerate prodotti di sintesi distinti, usati per orientarsi in corpi di ricerca complessi, collocati tra una scoping review e una revisione sistematica completa.
Per chi entra in un nuovo argomento nel 2026, la pressione è pratica. Elicit osserva che le revisioni sistematiche spesso iniziano con fino a 20.000 record e vengono ridotte a 30–100 articoli inclusi, un processo che manualmente può richiedere da tre mesi a più di un anno. Una selezione di 50 articoli non sostituisce questo processo di riferimento. È il primo strumento corretto quando l’obiettivo è decidere se siano giustificati una revisione sistematica, uno studio primario o una domanda più circoscritta.
L’AI modifica la velocità della prima fase. Non elimina gli obblighi di rendicontazione previsti da PRISMA 2020, che continua a richiedere metodi trasparenti di identificazione, selezione ed estrazione.
Che cosa dovresti cercare in un assistente di ricerca AI per la selezione della letteratura?
Dovresti valutare un assistente di ricerca AI in base alla sua capacità di mantenere riproducibile una strategia di ricerca, ispezionabile una decisione di selezione e falsificabile un’affermazione su una lacuna — non in base alla fluidità con cui scrive una revisione della letteratura. La checklist TRACE-GAP qui sotto è il quadro di valutazione utilizzato in questo articolo.
Dimensioni di valutazione TRACE-GAP
- T — Query tracciabili. Lo strumento può produrre i database, le stringhe, i limiti e l’intervallo di date esatti che un altro ricercatore potrebbe rieseguire?
- R — Criteri di rilevanza. Le regole di inclusione ed esclusione possono essere dichiarate prima che venga valutato qualsiasi articolo?
- A — Selezione verificabile. Ogni decisione riporta una motivazione, e non soltanto un sì o un no?
- C — Estrazione a livello di citazione. I risultati sono collegati a un passaggio o almeno a un articolo specifico, anziché a una sintesi combinata?
- E — Codifica della robustezza delle evidenze. Il disegno dello studio, il campione e i limiti possono essere registrati accanto al risultato?
- G — Dimensioni delle lacune. La mappa può utilizzare almeno due assi, tipicamente intervento × outcome oppure popolazione × metodo?
- A — Validazione tra cluster. Il flusso di lavoro impone una seconda verifica prima che una cella vuota venga definita una lacuna?
- P — Domande prioritarie. L’output trasforma le lacune convalidate in domande di ricerca, anziché in una heatmap decorativa?
Un benchmark in stile guida all’acquisto del 2026, che ha valutato gli assistenti in base al radicamento delle citazioni, ha rilevato che i collegamenti alle fonti a livello di paragrafo producevano il più basso rapporto tra allucinazioni e verifica, con Atlas a 0,05, Elicit a 0,07, Consensus a 0,09 e SciSpace a 0,16. La stessa revisione ha trattato ResearchRabbit come mappatore di reti anziché generatore di risposte, che è la categoria corretta per l’espansione a partire da articoli seme.
Per l’uso accademico contano altri due test. Primo, PRISMA 2020 richiede ancora agli autori di verificare i valori estratti; qualunque strumento che nasconda la citazione di supporto non supera questo test. Secondo, le citazioni allucinate hanno raggiunto bozze di esperti e flussi editoriali di riviste, quindi «sembra accademico» non è un criterio di accettazione.
L’Academic Research Assistant di Jenova è più efficace nella redazione della strategia, nella scoperta su più database, nella memoria persistente dei progetti e nella scrittura consapevole delle citazioni. È meno adatto come piattaforma dedicata alla doppia selezione: non genera un diagramma di flusso PRISMA né gestisce la risoluzione cieca dei conflitti come fanno Rayyan e Covidence.
Come si confrontano Jenova, Elicit, Rayyan e ResearchRabbit per ricerca, selezione e mappatura delle lacune?
Jenova è più efficace come partner per strategia e sintesi, Elicit come motore di estrazione strutturata, Rayyan come postazione per la selezione ad alto volume e ResearchRabbit come esploratore di reti citazionali — e nessuno di essi dovrebbe essere usato come unico sistema chiuso per un nuovo argomento. Il confronto utile riguarda quale attività dovrebbe essere affidata a ciascuno strumento.
| Funzionalità / Dimensione | Academic Research Assistant di Jenova | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Supporto alla strategia di ricerca | Redazione conversazionale PICO/Boolean con Scholar e ricerca web; memoria persistente del progetto | Ricerca semantica su 125M+ articoli; suggerisce i campi di selezione a partire dalla domanda | Importa esportazioni da database tradizionali; non è principalmente un progettista di ricerca | ResearchRabbit si espande a partire da articoli seme; Scite verifica successivamente l’orientamento delle citazioni |
| Selezione di circa 50 articoli | Tabelle di inclusione/esclusione basate su criteri in chat, con motivazioni e limiti | Selezione classificata più righe di estrazione supportate da citazioni | Progettato per la selezione di titoli/abstract, la deduplicazione e i flussi di lavoro di gruppo | Debole come selezionatore; forte come strumento per trovare articoli correlati o verificare citazioni |
| Mappatura delle lacune nelle evidenze | Codifica dei cluster, validazione delle celle vuote e traduzione in domande di ricerca | Buone tabelle di estrazione per costruire successivamente una mappa | Il registro di selezione supporta le mappe; la mappatura è perlopiù a valle | Le mappe di rete mostrano collegamenti mancanti, non lacune nelle evidenze convalidate |
| Radicamento delle citazioni | Risposte multi-modello con prompt orientati prima alle fonti; la verifica umana resta necessaria | Citazioni a livello di articolo per i campi estratti | Il registro decisionale è verificabile; la sintesi non è il prodotto | Scite segnala citazioni di supporto, contrastanti o semplicemente menzionate |
| Prezzi (al 2026) | Piano gratuito con utilizzo limitato; Plus da $20/mese | Pro, Team ed Enterprise (i prezzi di listino variano per piano) | Gratuito per sempre per l’uso di base | ResearchRabbit gratuito; Scite Student circa $10/mese, Premium circa $20/mese |
| Ideale per | Strategia su nuovi argomenti, interpretazione di 50 articoli e trasformazione delle lacune in giustificazione per uno studio | Estrazione strutturata su molti articoli | Selezione di gruppo su scala da revisione sistematica | Entrare in un campo da un articolo seme, quindi verificare le citazioni chiave |
Rayyan dichiara di essere utilizzato da oltre 1 milione di ricercatori in più di 20.000 istituzioni di oltre 190 Paesi ed è costruito attorno a verificabilità, riproducibilità e prioritarizzazione assistita dall’AI. Una revisione comparativa di software del 2026 ha ancora inquadrato la scelta come Covidence per la gestione istituzionale delle revisioni, Rayyan per una selezione accessibile ed Elicit per ricerca ed estrazione AI.
Il limite di Jenova riguarda l’interfaccia, non l’intento. Una selezione di 50 articoli in chat è ispezionabile se imponi una tabella, ma non sostituirà due selezionatori indipendenti su un’esportazione di 5.000 record. Il limite di Elicit è l’opposto: la tabella è eccellente, eppure Elicit stesso afferma che le revisioni di livello editoriale dovrebbero comunque eseguire ricerche tradizionali per parole chiave e trattare la ricerca semantica come integrazione. Il limite di ResearchRabbit è l’onestà rispetto alla sua portata: mappa ciò che è connesso, non ciò che manca dopo una valutazione della qualità.
Per un nuovo argomento, la combinazione più produttiva è di solito Jenova o Semantic Scholar per la strategia, Rayyan o Elicit per la selezione, Scite per l’orientamento delle citazioni e di nuovo Jenova per la narrazione delle lacune. L’Agente Deep Research di Jenova è il passaggio di consegne migliore quando la mappa di 50 articoli richiede un briefing più lungo e denso di citazioni.
Come si costruisce una strategia di ricerca riproducibile con un assistente di ricerca AI?
Costruisci una strategia di ricerca riproducibile fissando domanda, concetti, fonti e limiti prima di chiedere a qualsiasi modello di trovare articoli. Il compito dell’assistente è mettere in luce sinonimi mancanti e limiti distorsivi, non improvvisare un elenco di letture.
Inizia con un ancoraggio della ricerca: popolazione o contesto, intervento o esposizione, comparatore se pertinente, outcome e disegni di studio che accetterai. Le mapping review possono essere più ampie di una singola domanda PICO, ma necessitano comunque di una strategia di ricerca e di un modulo di codifica ex ante. Le guide universitarie descrivono le mappe delle evidenze o delle lacune come una tabella principale con righe, colonne e filtri per variabili specifiche. Tali righe e colonne dovrebbero esistere su carta prima dell’esecuzione della prima query.
Un utile primo prompt nell’Academic Research Assistant di Jenova è questo:
«Sto aprendo una nuova linea di ricerca su [argomento]. Elabora una strategia di ricerca riproducibile con: (1) elementi PICO o PECO, (2) criteri di inclusione ed esclusione, (3) database e fonti di letteratura grigia, (4) stringhe Boolean con sinonimi e vocabolario controllato e (5) un intervallo di date 2019–2026. Elenca i termini che probabilmente mancano e gli eventuali limiti che nasconderebbero disegni di studio pertinenti.»
Poi imponi un controllo metodologico:
«Riscrivi la strategia affinché un altro ricercatore possa rieseguirla. Separa i termini indispensabili dai sinonimi facoltativi. Segnala dove la ricerca semantica aiuterebbe a migliorare il recupero e dove è accettabile soltanto la sintassi esatta del database.»
Gli assistenti validi ti orienteranno verso fonti multiple. Un argomento biomedico necessita comunque di MEDLINE/PubMed più almeno un indice complementare; istruzione e politiche sociali richiedono spesso ERIC, PsycINFO o una libreria specializzata di mappe. La guida alla sintesi delle evidenze dell’Università di Toronto considera le mapping review un modo per individuare le lacune prima di impegnarsi in una revisione sistematica più circoscritta.
Nei test emergono costantemente due errori strategici. Il primo è filtrare eccessivamente per «review» o «RCT» troppo presto, eliminando proprio le celle vuote che vuoi individuare. Il secondo è lasciare che il modello scelga i database dopo avere già visto alcuni risultati comodi. Fissa il protocollo, poi esegui la ricerca.
Jenova aiuta in questo passaggio perché la conversazione persiste tra sessioni e può mantenere in memoria l’ancoraggio, le stringhe e l’elenco delle esclusioni. Non sostituisce una ricerca rivista da un bibliotecario per una revisione sistematica destinata a una rivista, e non dovresti fingere che lo faccia.
Come dovresti selezionare circa 50 articoli chiave senza perdere rigore metodologico?
Dovresti selezionare 50 articoli usando un registro decisionale codificato: una riga per studio, una motivazione per decisione e nessun articolo ammesso perché l’abstract «sembra pertinente». Cinquanta è un corpus operativo per un nuovo argomento, non un’affermazione che la letteratura sia stata cercata in modo esaustivo.
Adotta la disciplina della selezione sistematica anche quando non stai ancora scrivendo una revisione PRISMA. PRISMA 2020 è la linea guida di rendicontazione corrente per le revisioni che identificano, selezionano e sintetizzano studi. La checklist associata di 27 elementi esiste per rendere trasparenti tali metodi. Il tuo registro di 50 articoli non soddisferà una revisione sistematica completa, ma dovrebbe poter rispondere alle stesse domande fondamentali: cosa è stato trovato, cosa è stato mantenuto e perché.
Un prompt pratico per la selezione:
«Seleziona i seguenti 50 articoli in base a questi criteri di inclusione ed esclusione. Per ogni articolo restituisci: decisione (
include / exclude / unsure), il singolo criterio che ha determinato la decisione, disegno dello studio, popolazione, contesto, outcome primario e un limite. Cita la frase che ha giustificato la decisione. Non aggiungere articoli che non sono in questo elenco.»
Poi esegui personalmente un passaggio di calibrazione sui primi dieci record. Se assistente e ricercatore non concordano su più di due o tre casi, i criteri sono ancora vaghi. Rendi più rigorose le definizioni di popolazione, disegno e outcome prima di valutare i quaranta rimanenti.
Rayyan è lo strumento migliore quando il set cresce o entra un secondo selezionatore. I confronti indipendenti tra Covidence e Rayyan hanno da tempo considerato entrambi piattaforme valide per la selezione nelle revisioni sistematiche, con modelli di collaborazione differenti. Elicit è lo strumento migliore quando il passaggio successivo è una tabella di dati: dimensione del campione, direzione dell’outcome e campi metodologici compilati con citazioni di supporto.
Il limite onesto di Jenova è l’ergonomia delle operazioni in batch. La selezione in chat è rapida per 50 articoli scelti con cura e scomoda per 5.000 record importati. Usala per imporre criteri ed estrarre un codebook coerente. Sposta lo stesso codebook in Rayyan o Elicit se il progetto diventa una revisione formale.
Non lasciare mai che il modello «completi» un PDF mancante. Se il testo completo non è disponibile, la riga resta unsure, non include. Questa singola regola evita la maggior parte delle citazioni di facciata.
Come si trasformano gli articoli selezionati in una mappa delle lacune nelle evidenze convalidata?
Trasformi un insieme selezionato in una mappa delle lacune codificando ogni studio incluso su due o più dimensioni, contrassegnando le celle vuote come preliminari e solo allora verificando se tali celle vuote resistono a una seconda ricerca. Una cella vuota che non è stata messa alla prova è un residuo di codifica, non una giustificazione per la ricerca.
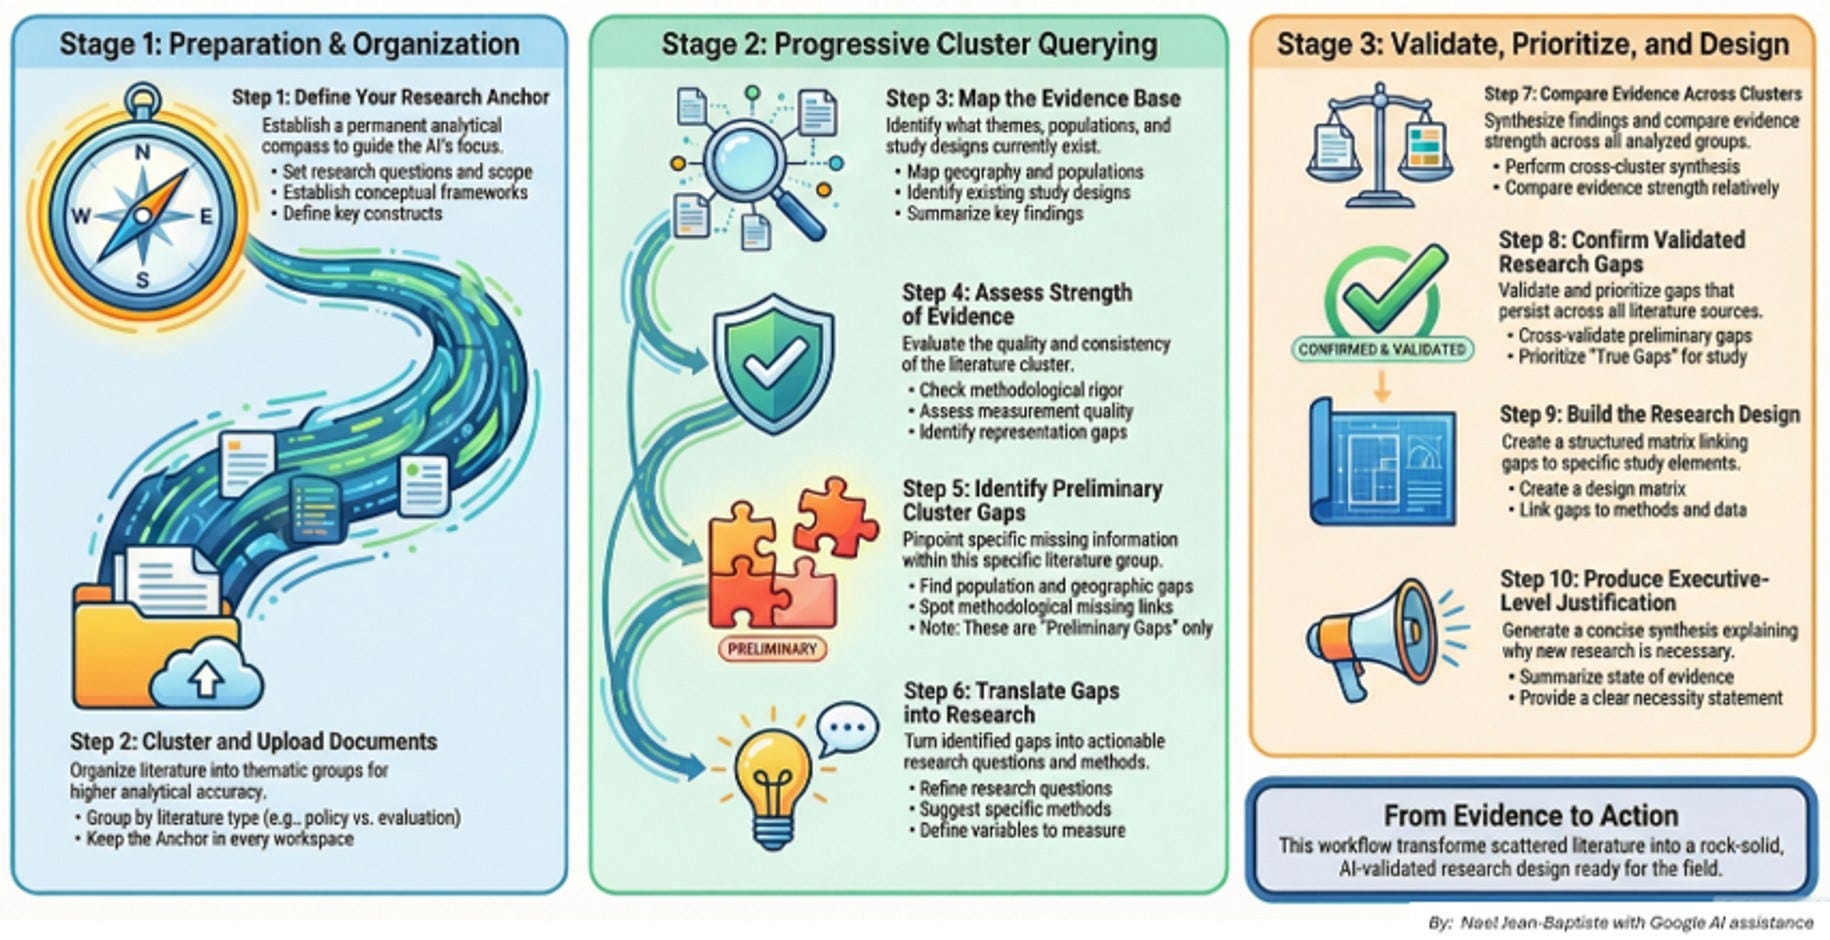
Il flusso di lavoro nella figura sopra segue la sequenza corretta: prepara un ancoraggio analitico, raggruppa i documenti, valuta la robustezza delle evidenze, contrassegna le lacune preliminari e poi convalida tali lacune tra i cluster prima di progettare uno studio. Questo corrisponde al modo in cui dovrebbero funzionare le mappe formali. Le mappe interattive delle lacune nelle evidenze sono strumenti visivi strutturati per mostrare volume e caratteristiche delle evidenze, non poster di ipotesi preferite.
Una mappa durevole necessita di solito almeno di:
- Righe: interventi, esposizioni o domande di ricerca
- Colonne: outcome, popolazioni o disegni di studio
- Filtri: anno, geografia, qualità e stato di pubblicazione
- Contenuto delle celle: numero di studi, più un tag approssimativo di robustezza (review, trial, osservazionale, protocollo)
Chiedi all’assistente di costruire la prima matrice soltanto dagli articoli inclusi:
«Usando solo gli studi inclusi, crea una matrice delle lacune con righe = [interventi o domande] e colonne = [outcome o popolazioni]. In ciascuna cella indica numero di studi, disegno dominante e attualità. Contrassegna le celle vuote come Preliminare. Poi proponi tre ricerche di follow-up che potrebbero falsificare ogni cella vuota, includendo registri di trial e letteratura grigia.»
La validazione è il passaggio che la maggior parte delle analisi AI salta. I confronti metodologici sottolineano che le mappe dovrebbero includere studi in corso dai registri, applicare una valutazione critica ed essere aggiornate entro circa tre anni. Una cella che appare vuota nel tuo set di 50 articoli potrebbe essere piena in un server di preprint o in un registro di protocolli.
Jenova è utile in questa fase perché può mantenere codebook, matrice e articoli rifiutati nello stesso progetto e poi redigere il memo «perché questo studio è necessario» soltanto a partire da lacune convalidate. Se glielo permetti, sovrainterpreterà le celle vuote. Richiedi una ricerca di falsificazione per ogni lacuna che intendi finanziare o su cui intendi scrivere.
Se l’argomento diventa in seguito una scoping review, passa alla rendicontazione PRISMA-ScR, che specifica 20 elementi essenziali e 2 elementi facoltativi. Non riadattare una mappa informale di 50 articoli come se fosse già una scoping review.
Come ottenere il massimo da un flusso di lavoro AI di ricerca-selezione-mappatura?
Ottieni il massimo dal flusso di lavoro fornendo all’assistente un protocollo fissato, un corpus delimitato e un budget di verifica — e rifiutando ogni affermazione che non possa essere aperta nel PDF originale. La velocità deriva da una codifica coerente, non dal saltare i controlli sul testo completo.
Una sequenza operativa compatta:
- Scrivi l’ancoraggio. Un paragrafo che indichi l’affermazione da supportare, la popolazione e ciò che costituirebbe un’evidenza contraria.
- Elabora e fissa la ricerca. Database, stringhe, date e regole di esclusione vanno inseriti in una nota datata prima dell’inizio della scoperta.
- Assembla intenzionalmente 50 articoli. Combina review, trial recenti o studi primari e almeno alcuni articoli di campi adiacenti affinché la mappa non sia un’illusione basata su un singolo cluster.
- Seleziona in una tabella. Includi, escludi o segna come incerto, con un criterio decisivo e una frase citata.
- Estrai, poi valuta. Risultati, limiti, disegno e campione restano in campi separati.
- Mappa, poi metti alla prova le celle vuote. Ogni lacuna preliminare riceve una seconda ricerca progettata per eliminarla.
- Scrivi a partire dalla matrice. La frase sulla novità dell’articolo dovrebbe nominare la cella vuota convalidata, non un’impressione vaga.
In Jenova, mantieni l’intera catena in un unico progetto affinché l’assistente non modifichi silenziosamente le regole di inclusione tra una sessione e l’altra. Un prompt di follow-up che impedisce la deriva:
«Riapplica i criteri di inclusione originali a questo nuovo articolo. Se per includerlo devi modificare un criterio, fermati e mostrami la modifica proposta anziché valutare l’articolo.»
Per Elicit, parti dalla domanda di ricerca, lascia che il sistema suggerisca i campi di selezione ed estrazione, quindi sostituisci tali campi prima di eseguire l’intero set. Per Rayyan, importa l’esportazione del database, imposta etichette che corrispondano al tuo codebook e conserva il classificatore di rilevanza AI come ordinamento, non come decisione.
Stabilisci esplicitamente il tempo di verifica. Un obiettivo praticabile per un nucleo di 50 articoli è da due a quattro minuti di controllo umano per ogni testo completo incluso, concentrandosi sul fatto che il risultato citato sia realmente presente nell’articolo e che il disegno sia stato codificato correttamente. È comunque molto meno costoso dell’estrazione non assistita, ed è l’unico modo per rispettare l’aspettativa di PRISMA secondo cui i valori estratti sono verificati.
Che cosa dicono i metodologi della ricerca e i creatori di strumenti sulla mappatura delle evidenze assistita dall’AI?
I metodologi della ricerca considerano le mappe delle evidenze grafici della disponibilità guidati da protocollo, mentre i creatori di strumenti continuano a scoprire che la citazione, non la prosa, è la parte in cui l’AI sbaglia. Entrambi i gruppi convergono sulla stessa regola operativa: l’AI può strutturare la ricerca e la selezione, ma il ricercatore resta responsabile di ogni cella della mappa.
«La modalità di errore che osserviamo più spesso è trattare la cella vuota come una scoperta. Una cella vuota è soltanto un’ipotesi sull’assenza di evidenze. Diventa una lacuna convalidata dopo avere verificato cluster adiacenti, letteratura grigia e registri di protocolli, e avere confermato che l’assenza non sia un artefatto della ricerca. Se questi controlli non sono stati eseguiti, non hai una mappa delle lacune. Hai una visualizzazione della tua prima query.»
«In una selezione di 50 articoli, il risparmio di tempo deriva dalla codifica coerente, non dal saltare il testo completo. La divisione del lavoro utile è semplice: l’assistente prepara la decisione di inclusione/esclusione, la riga di estrazione e la prima matrice; il ricercatore dedica alcuni minuti a ogni articolo incluso per confermare che la citazione esista e che il disegno non sia stato migliorato nel racconto. Questo comprime comunque giorni di note disordinate in un unico codebook.»
«Non presenteremmo una revisione sistematica per una rivista basandoci soltanto su registri di chat. Le piattaforme dedicate alla selezione restano superiori per doppia revisione, risoluzione dei conflitti e diagrammi PRISMA. Il punto in cui un assistente di ricerca conversazionale si guadagna il suo posto è prima: fissare la domanda, rivelare limiti di ricerca distorsivi, mantenere visibili gli articoli rifiutati e trasformare una cella vuota convalidata in una precisa giustificazione per uno studio.»
— Team di prodotto Jenova, flussi di lavoro per la ricerca accademica, 8 anni nello sviluppo di strumenti AI per la ricerca con tracciabilità delle fonti
Questa cautela è coerente con il lavoro indipendente. Le revisioni dei sistemi generativi per la sintesi della letteratura continuano a rilevare capacità concrete abbinate a limiti di affidabilità che rendono insicura una revisione non supervisionata. Le linee guida sulle mappe sistematiche delle evidenze sottolineano allo stesso modo la categorizzazione strutturata delle evidenze scientifiche anziché la fiducia narrativa. Il vincolo che mantiene il ricercatore al controllo nel flusso di lavoro sulle fonti in cinque passaggi non è uno slogan. È il passaggio di controllo qualità da cui dipende il resto del metodo.
Riferimenti
- Saran e White — Mappe delle evidenze e delle lacune: confronto tra approcci diversi (PMC)
- Khalil et al. — Metodologia per mapping review, mappe delle evidenze e mappe delle lacune (Research Synthesis Methods)
- Elicit — Presentazione della revisione sistematica Elicit
- PRISMA Statement — Linee guida di rendicontazione PRISMA 2020
- Atlas Workspace — Migliori assistenti di ricerca AI (2026): confronto verificato sulle allucinazioni
- Fortune — Le allucinazioni AI stanno infiltrandosi nel lavoro scientifico di esperti (maggio 2026)
- University of Illinois Grainger LibGuide — Scoping review, mapping review, mappe delle evidenze o delle lacune
- Page et al. — La dichiarazione PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA e standard correlati per le revisioni
- Elicit — Flusso di lavoro per revisioni sistematiche basato su PRISMA 2020
- Rayyan — Piattaforma per revisioni sistematiche basata sull’AI
- INRA.AI — Confronto tra Covidence, Rayyan ed Elicit
- University of Toronto Libraries — Mapping review nella famiglia della sintesi delle conoscenze
- Kellermeyer, Harnke e Knight — Confronto tra Covidence e Rayyan (PMC)
- EvalCommunity Academy — Mappatore interattivo delle lacune nelle evidenze
- PRISMA — Estensione PRISMA per le scoping review
- Adel, Alateeq e Alshahrani — L’AI generativa può sintetizzare la letteratura in modo affidabile? (AI & Society)
- Khalil et al. — Guida alla realizzazione di mappe sistematiche delle evidenze (Science of the Total Environment)