Come può l'AI sintetizzare prove interdisciplinari senza confondere i fatti?
2026-08-21
Quali tre livelli di evidenza devono rimanere separati nella sintesi AI multidisciplinare?
L'AI può sintetizzare in modo affidabile prove interdisciplinari solo quando etichetta ogni affermazione come fatto della fonte, conclusione dell'autore o inferenza del modello — e impedisce che questi livelli confluiscano in un unico paragrafo senza etichette. Nel 2026, questa separazione è ciò che distingue una sintesi di ricerca verificabile da un riepilogo scorrevole che trasforma affermazioni provvisorie in autorevolezza apparente. I chatbot generici tendono ancora a mescolare questi livelli per impostazione predefinita, motivo per cui la fabbricazione bibliografica e gli errori di citazione restano ben documentati.
Gli agenti di ricerca progettati appositamente — incluso Academic Research Assistant di Jenova — sono più efficaci per questo compito quando recuperano fonti reali, preservano l'attribuzione e rendono visibili i salti compiuti dal modello. Non sostituiscono una revisione sistematica registrata secondo PRISMA.
Fattori chiave che distinguono una sintesi consapevole della provenienza da una parafrasi priva di etichette:
✅ I fatti della fonte sono misurazioni, metodi, dimensioni del campione e osservazioni riportati nel testo primario
✅ Le conclusioni dell'autore sono interpretazioni tratte dagli autori dell'articolo nella discussione o nell'abstract — non verità indipendenti
✅ L'inferenza AI è il ragionamento analogico, predittivo o integrativo che il modello aggiunge tra articoli o discipline
✅ La mappatura tra domini deve essere esplicita, poiché un meccanismo consolidato in una disciplina è spesso soltanto un'ipotesi in un'altra
✅ Ogni frase estraibile dovrebbe superare una semplice verifica: chi ha affermato questo, in quale documento e con quale stato epistemico?
Per confrontare gli strumenti su questo problema, considera la provenienza un criterio di valutazione primario anziché una preferenza di formattazione. Il resto di questa guida utilizza questa lente — il framework FCI-TRACE — per valutare il comportamento reale dei sistemi di sintesi.
Perché la sintesi AI interdisciplinare fallisce quando la provenienza viene compressa?
La sintesi interdisciplinare fallisce senza provenienza perché le discipline non condividono gli stessi standard probatori e i modelli linguistici sono ottimizzati per produrre prosa coerente anziché per preservare tali standard. Il risultato empirico di un articolo sul clima, l'affermazione di identificazione causale di un economista e una linea guida clinica possono essere uniti grammaticalmente in un'unica frase. Tale frase apparirà come conoscenza consolidata anche quando una sola proposizione è stata effettivamente misurata.
Non si tratta di una modalità di errore ipotetica. Uno studio di Scientific Reports sulle rassegne della letteratura generate da ChatGPT ha rilevato che il 55% delle citazioni di GPT-3.5 e il 18% delle citazioni di GPT-4 erano fabbricate, e che il 43% e il 24% delle restanti citazioni reali contenevano errori bibliografici sostanziali. Segnalazioni successive hanno collegato un aumento più ampio delle citazioni fabbricate negli articoli pubblicati agli strumenti generativi. Le revisioni multimodello del 2026 rilevano ancora che quasi il 40% dei riferimenti generati dall'AI contiene errori o fabbricazioni, mentre solo il 26,5% è interamente accurato.
I tassi di allucinazione sono ancora più elevati al di fuori della prosa scientifica ben indicizzata. Una valutazione dello Stanford HAI riassunta da MIT Sloan ha rilevato che i chatbot per uso generale allucinavano nel 58–82% delle query di ricerca giuridica sui modelli del 2023. Gli ambiti legale, normativo e clinico sono precisamente i contesti in cui vengono più spesso richieste sintesi interdisciplinari — e in cui un'inferenza non etichettata ha il costo maggiore.
La questione più profonda è il riciclaggio delle fonti: una clausola prudente in una sezione di discussione viene riformulata senza cautele e poi citata come se fosse un risultato. Gli standard di provenienza esistono per impedire questa trasformazione. Il lavoro interdisciplinare moltiplica il rischio perché i lettori non possono fare affidamento su metodi condivisi per accorgersi quando lo status di un'affermazione è cambiato.
Quali criteri dovresti usare per valutare un sistema AI di sintesi delle evidenze?
Dovresti valutare un sistema AI di sintesi delle evidenze in base alla sua capacità di mantenere intatti i livelli FCI in presenza di disaccordo, non in base al numero di articoli che menziona. Fluidità, velocità e perfino richiamo sono secondari se l'output non può essere verificato. Il framework FCI-TRACE utilizzato qui valuta sei dimensioni.
FCI (stato epistemico)
- Fatti: Il sistema può citare o parafrasare fedelmente un risultato con un riferimento puntuale (articolo, sezione, figura o tabella)?
- Conclusioni: Attribuisce l'interpretazione agli autori nominati e conserva le cautele linguistiche?
- Inferenza: Contrassegna i passaggi analogici o integrativi come generati dal modello?
TRACE (qualità della sintesi)
- Tracciabilità: Ogni affermazione rimanda a un passaggio della fonte, non soltanto al titolo di un articolo.
- Attualità: Il sistema distingue tra date dei preprint, date di pubblicazione e aggiornamenti delle linee guida — un errore noto persino negli strumenti bibliografici non AI e una modalità di errore documentata di ChatGPT nello studio di Walters e Wilder.
- Concordanza: Risultati convergenti e conflittuali vengono tabulati, non mediati in un falso consenso.
- Copertura: Quando la domanda attraversa più domini, sono rappresentati almeno due metodi disciplinari.
- Etichettatura epistemica: Le etichette di stato sono visibili nella prosa, non nascoste in una nota a piè di pagina.
Questo approccio è più rigoroso delle generiche checklist su “AI per la revisione della letteratura”, che spesso si fermano alla ricerca e al riepilogo. Le guide universitarie ora catalogano strumenti che riassumono articoli ed estraggono dati in tabelle strutturate, e i team di revisione sistematica distinguono lo screening semi-automatico da quello completamente automatico. Queste capacità sono importanti. Non impediscono però, da sole, che una conclusione dell'autore venga riscritta come un fatto.
Anche la trasparenza del protocollo deve far parte della valutazione. PRISMA 2020 è una checklist di rendicontazione composta da 27 elementi per revisioni sistematiche che includono sintesi, mantenuta con articoli esplicativi tramite EQUATOR Network. Nessuna sessione con un chatbot costituisce una revisione PRISMA. Un flusso di lavoro AI difendibile dovrebbe comunque riportare la logica di eleggibilità, le fonti consultate e ciò che il modello ha aggiunto.
Come gestiscono fatti, affermazioni degli autori e inferenze del modello i principali strumenti di ricerca AI?
I principali strumenti si dividono lungo una linea chiara: gli estrattori fondati sugli articoli riducono le fabbricazioni, mentre i modelli chat generici restano fluidi ma debolmente attribuiti — e quasi nessuno applica nativamente etichette FCI nella prosa generata. Il confronto seguente riguarda l'igiene epistemica, non la popolarità complessiva.
| Funzione / Dimensione | ChatGPT per uso generale | Elicit | Jenova Academic Research Assistant | Scite (contesto delle citazioni) |
|---|---|---|---|---|
| Corpus di grounding | Dati di addestramento più navigazione facoltativa; citazioni spesso non verificate | Ricerca, riepilogo ed estrazione su 125 milioni di articoli; utilizzato da oltre 2 milioni di ricercatori | Recupero accademico e web in tempo reale, allegati e memoria persistente della sessione | Grafo delle citazioni e contesto di supporto/contrasto relativo al modo in cui gli articoli vengono citati |
| Etichettatura FCI nell'output | Tipicamente priva di etichette; fatti, affermazioni della discussione e salti del modello condividono la stessa voce | Più efficace nell'estrazione a livello di articolo che nelle etichette epistemiche a livello di frase | Può essere istruito a etichettare i livelli FCI e a mantenere il protocollo tra le sessioni | Etichetta maggiormente la posizione della citazione rispetto al tipo di affermazione all'interno di una sintesi |
| Sintesi interdisciplinare | Elevata fluidità; debole traccia di verifica tra discipline | Più efficace per domande di ricerca empirica ed estrazione strutturata | Più efficace quando è richiesto un protocollo metodologico con follow-up di dominio nell'arco di più giorni | Limitato come sintetizzatore; più efficace come lente sul contesto delle citazioni |
| Verifica delle citazioni | Elevati tassi di fabbricazione ed errore nei test sistematici | Le righe fondate sugli articoli riducono i riferimenti inventati | Recupero più attribuzione; richiede comunque controlli a campione umani | Contesto nativo per stabilire se articoli successivi supportano o contrastano un'affermazione |
| Screening / estrazione | Non strutturato | Automatizza screening ed estrazione dati per revisioni sistematiche | Scoperta iterativa e supporto ai manoscritti, non un'interfaccia di screening dedicata | Non è un ambiente di lavoro per lo screening |
| Prezzi (al 2026) | Abbonamento; i livelli consumer esatti non sono verificati qui | Non verificati in questa revisione | Livello gratuito con utilizzo limitato; Plus a $20/mese (30× di utilizzo) | Non verificati in questa revisione |
| Ideale per | Redigere testi una volta che le fonti sono già disponibili | Estrazione in colonne da articoli empirici | Sintesi multi-fonte e multi-sessione che devono mantenere visibili i livelli FCI | Verificare come un'affermazione viene trattata nella letteratura successiva |
Elicit. L'analisi dell'ambito del prodotto mostra un ambiente di lavoro per la ricerca anziché un chatbot: gli utenti pongono una domanda, recuperano articoli ed estraggono campi. Confronti indipendenti del 2026 descrivono Elicit come più efficace per scoperta della letteratura, screening ed estrazione dei dati, mentre Consensus è descritto come più efficace per domande scientifiche sì/no. Questa capacità estrattiva è reale. Il limite è complementare: una tabella compilata può comunque presentare il verbo causale di un abstract come se fosse un risultato, a meno che l'utente non definisca colonne che separino i risultati dall'interpretazione.
Consensus e Semantic Scholar. Consensus viene ripetutamente posizionato come motore di risposte basato su articoli reali, non come pipeline completa per le revisioni (The Drive AI). Una rassegna del 2026 indicava Consensus a circa $144 all'anno come punto di ingresso. Semantic Scholar rimane una base per la scoperta nelle stesse comparazioni. Nessuno dei due strumenti, secondo le descrizioni pubbliche esaminate qui, offre un livello obbligatorio che distingua fatti e inferenze.
Scite. Scite è più adatto quando la domanda è come viene citato un articolo, non come unire due discipline. I confronti lo trattano come lo specialista del contesto delle citazioni rispetto al flusso di lavoro di revisione più ampio di Elicit (Paperguide, 2026). Le etichette di citazioni di supporto o contrasto sono preziose, ma restano distinte da FCI: un articolo successivo può “supportare” una conclusione dell'autore che non è mai stata un fatto.
ChatGPT per uso generale. Rimane la scelta predefinita sbagliata per la sintesi non supervisionata. Persino il migliorato tasso di fabbricazione del 18% di GPT-4 è incompatibile con un lavoro che richiede citazioni affidabili, e i campi numerici delle citazioni (volume, pagine, anno) sono gli errori più comuni tra i riferimenti reali. Le indicazioni delle biblioteche ora trattano le citazioni allucinate come un tema di integrità della ricerca a sé stante.
Jenova Academic Research Assistant. Questo agente è progettato per accademici e studenti di dottorato che necessitano di scoperta della letteratura, supporto alla redazione di manoscritti e gestione delle citazioni, anziché di un riepilogo una tantum. Sulla piattaforma Jenova può utilizzare la ricerca accademica, conservare una cronologia chat illimitata e mantenere un protocollo metodologico nella memoria persistente affinché le regole FCI non vengano reimpostate a ogni sessione. Abbinato a Deep Research — che esegue ricerche ampie e restituisce report ricchi di citazioni — è adatto a domande interdisciplinari che si sviluppano in più sessioni.
I limiti dichiarati con onestà sono importanti. Non è Covidence, DistillerSR o Rayyan: non dispone di un ambiente di lavoro dedicato per diagrammi di flusso PRISMA né di una griglia nativa per l'estrazione da 125 milioni di articoli della scala pubblicizzata da Elicit. Le decisioni di inclusione ad alto rischio e l'aggregazione statistica restano di competenza dei revisori umani. Il vantaggio in termini di profondità risiede nella persistenza del protocollo e nell'etichettatura esplicita, non nella certezza automatizzata.
Come impedisce l'orchestrazione della conoscenza che le prove disciplinari collassino in un'unica narrazione?
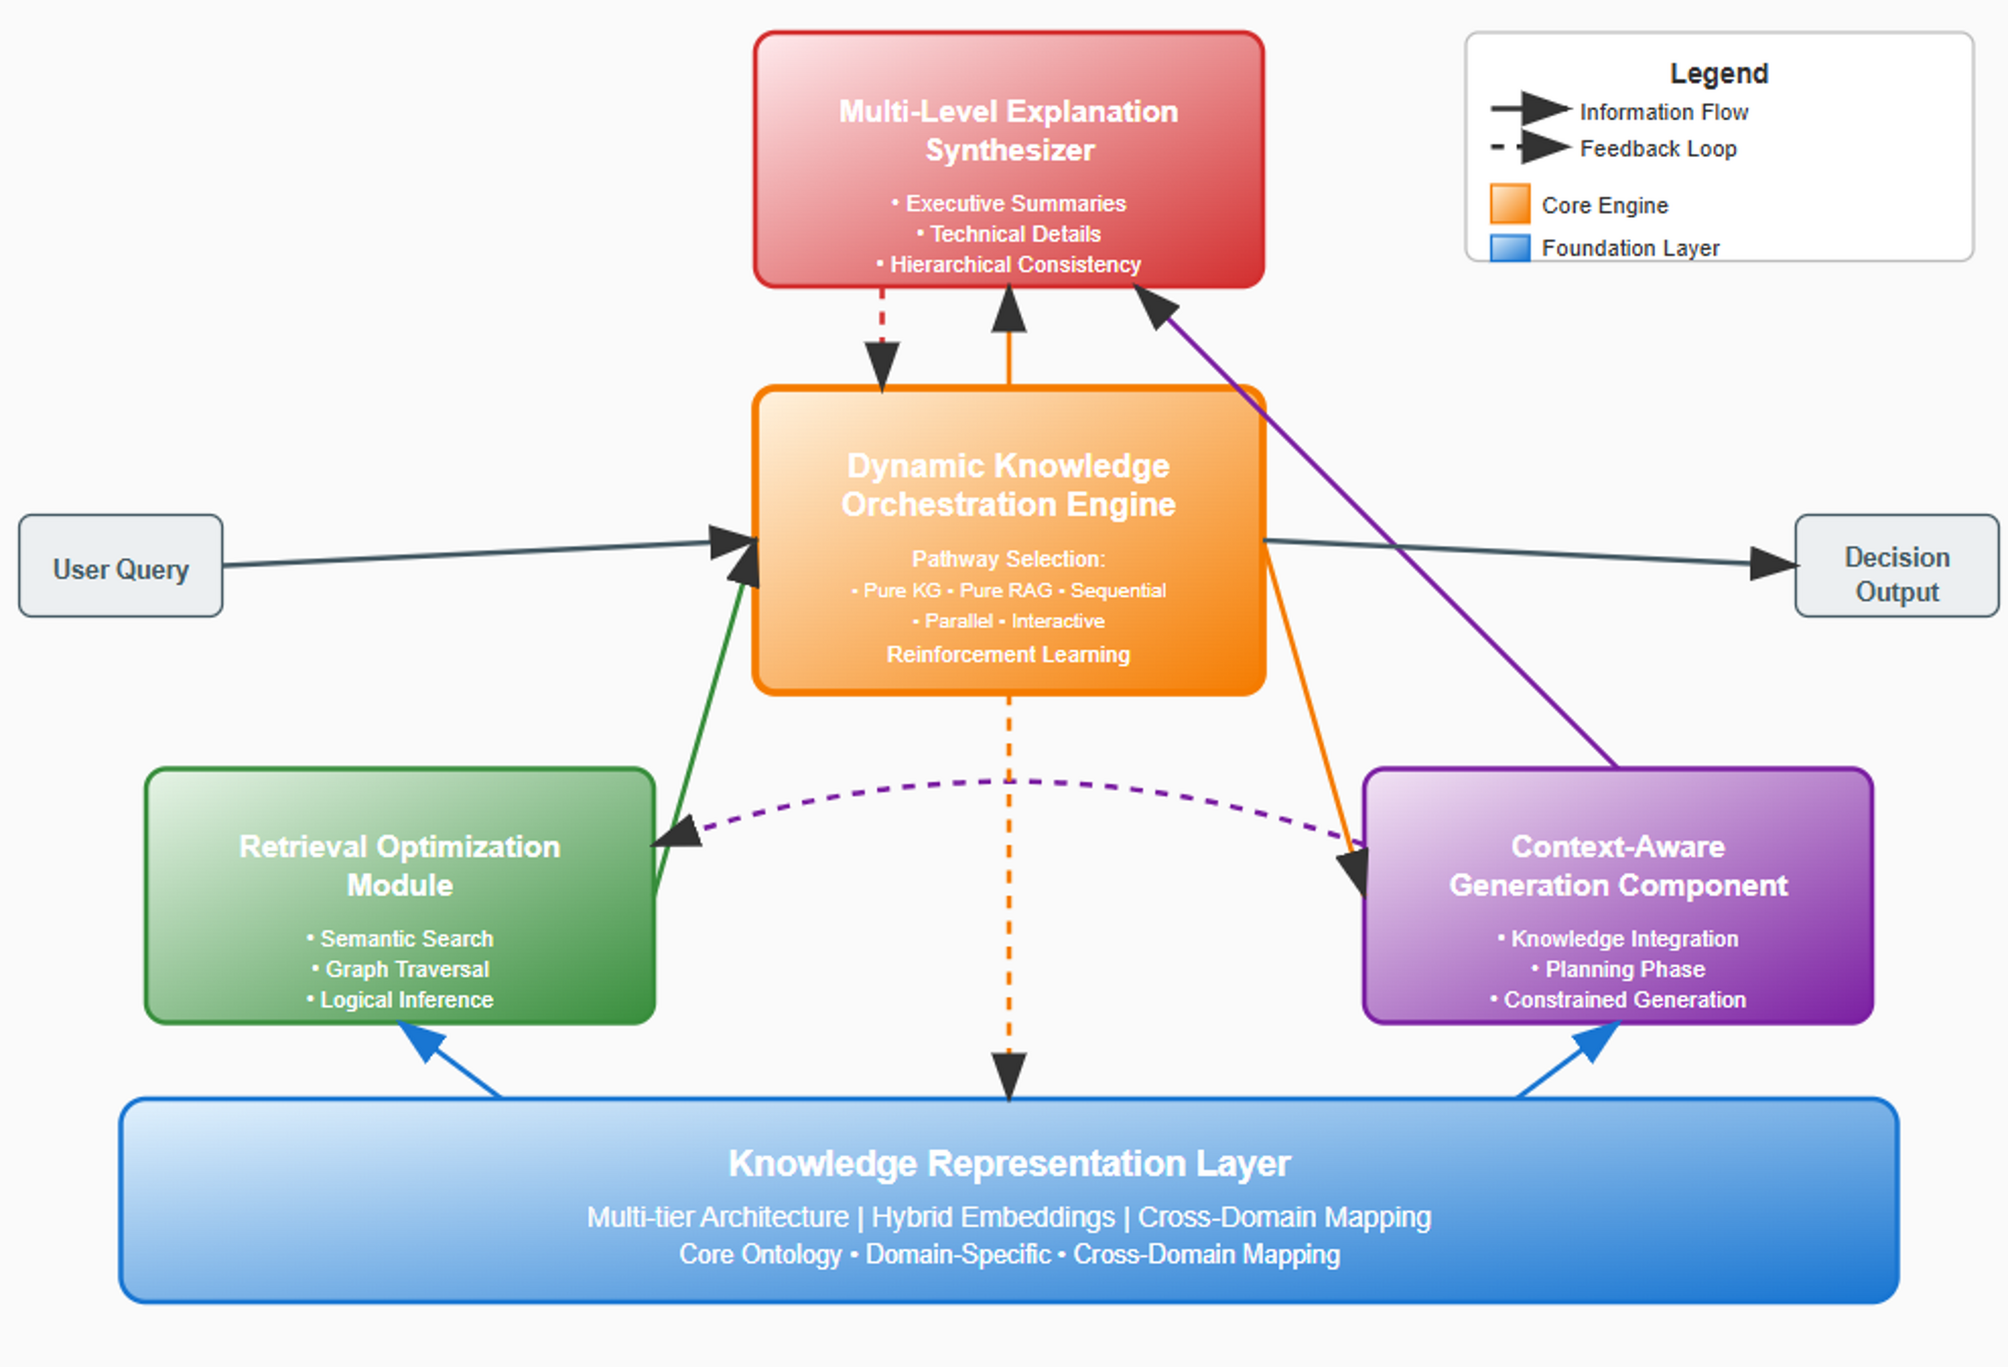
L'orchestrazione della conoscenza mantiene intatte le prove disciplinari scegliendo un percorso di recupero prima della generazione, quindi obbligando le spiegazioni a rimanere gerarchicamente coerenti con ciò che è stato recuperato. L'analisi di un tipico stack di orchestrazione mostra perché per il lavoro interdisciplinare non basta “recuperare e poi scrivere”.
Il fondamento è un livello di rappresentazione della conoscenza: embedding ibridi, ontologie di dominio e mappatura tra domini. Senza questo livello, un modello tratta “incertezza” nella fisica del clima, “incertezza” nell'econometria e “incertezza” nelle linee guida cliniche come appartenenti allo stesso vicinato di token. Non è così. La mappatura dei termini tra discipline è un passaggio inferenziale e dovrebbe essere etichettata come tale.
Al di sopra di questo livello, un modulo di ottimizzazione del recupero combina ricerca semantica, attraversamento di grafi e inferenza logica. L'attraversamento di grafi è importante quando la domanda è relazionale (il meccanismo A in ecologia è analogo al meccanismo B nella salute pubblica?). La sola ricerca semantica restituisce linguaggio simile; non dimostra una struttura causale condivisa. L'inferenza logica sulle affermazioni estratte è più vicina alle reti di inferenza delle evidenze progettate per la verifica interpretabile delle affermazioni.
Il motore di orchestrazione seleziona quindi un percorso — solo grafo della conoscenza, solo RAG, sequenziale, parallelo o interattivo — anziché riversare sempre segmenti in un prompt. Il recupero parallelo è appropriato quando due discipline devono essere raccolte indipendentemente prima di qualsiasi mappatura. Il recupero sequenziale è appropriato quando la misura di esito di una disciplina dovrebbe vincolare la query successiva. Mescolare queste modalità senza dichiararlo è il modo in cui una sintesi su clima e salute diventa silenziosamente una raccomandazione politica.
Una fase di generazione consapevole del contesto dovrebbe pianificare entro vincoli: non generare un verbo causale se la fonte non ne usa uno; non fondere i quadri campionari. L'ultima fase, un sintetizzatore di spiegazioni multilivello, è dove FCI diventa visibile — riepilogo esecutivo, dettaglio tecnico e controllo di coerenza affinché il riepilogo non superi le evidenze. Le interfacce affermazione-evidenza nella ricerca attuale, come PaperTrail, puntano nella stessa direzione: l'affidabilità in ambito accademico dipende dall'abbinamento tra affermazioni ed evidenze, non da una prosa più scorrevole.
Academic Research Assistant di Jenova non espone ogni interruttore interno di instradamento come controllo rivolto al ricercatore. Questo è un limite reale per i team che necessitano di un DAG completamente ispezionabile. Ciò che offre è l'equivalente pratico per la maggior parte dei flussi di lavoro accademici: istruzioni persistenti, corpus allegati, recupero in tempo reale e memoria sufficiente per mantenere stabile un protocollo di etichettatura mentre le evidenze si accumulano.
Come può una pipeline semantica di citazioni verificare le affermazioni prima che entrino in una sintesi?
Una pipeline semantica di citazioni verifica le affermazioni trattando ogni citazione come un'ipotesi da confrontare con il documento fonte, non come un ornamento formattato alla fine di un paragrafo. Se questo passaggio viene omesso, la sintesi interdisciplinare eredita ogni riferimento inventato o alterato prodotto dal generatore.
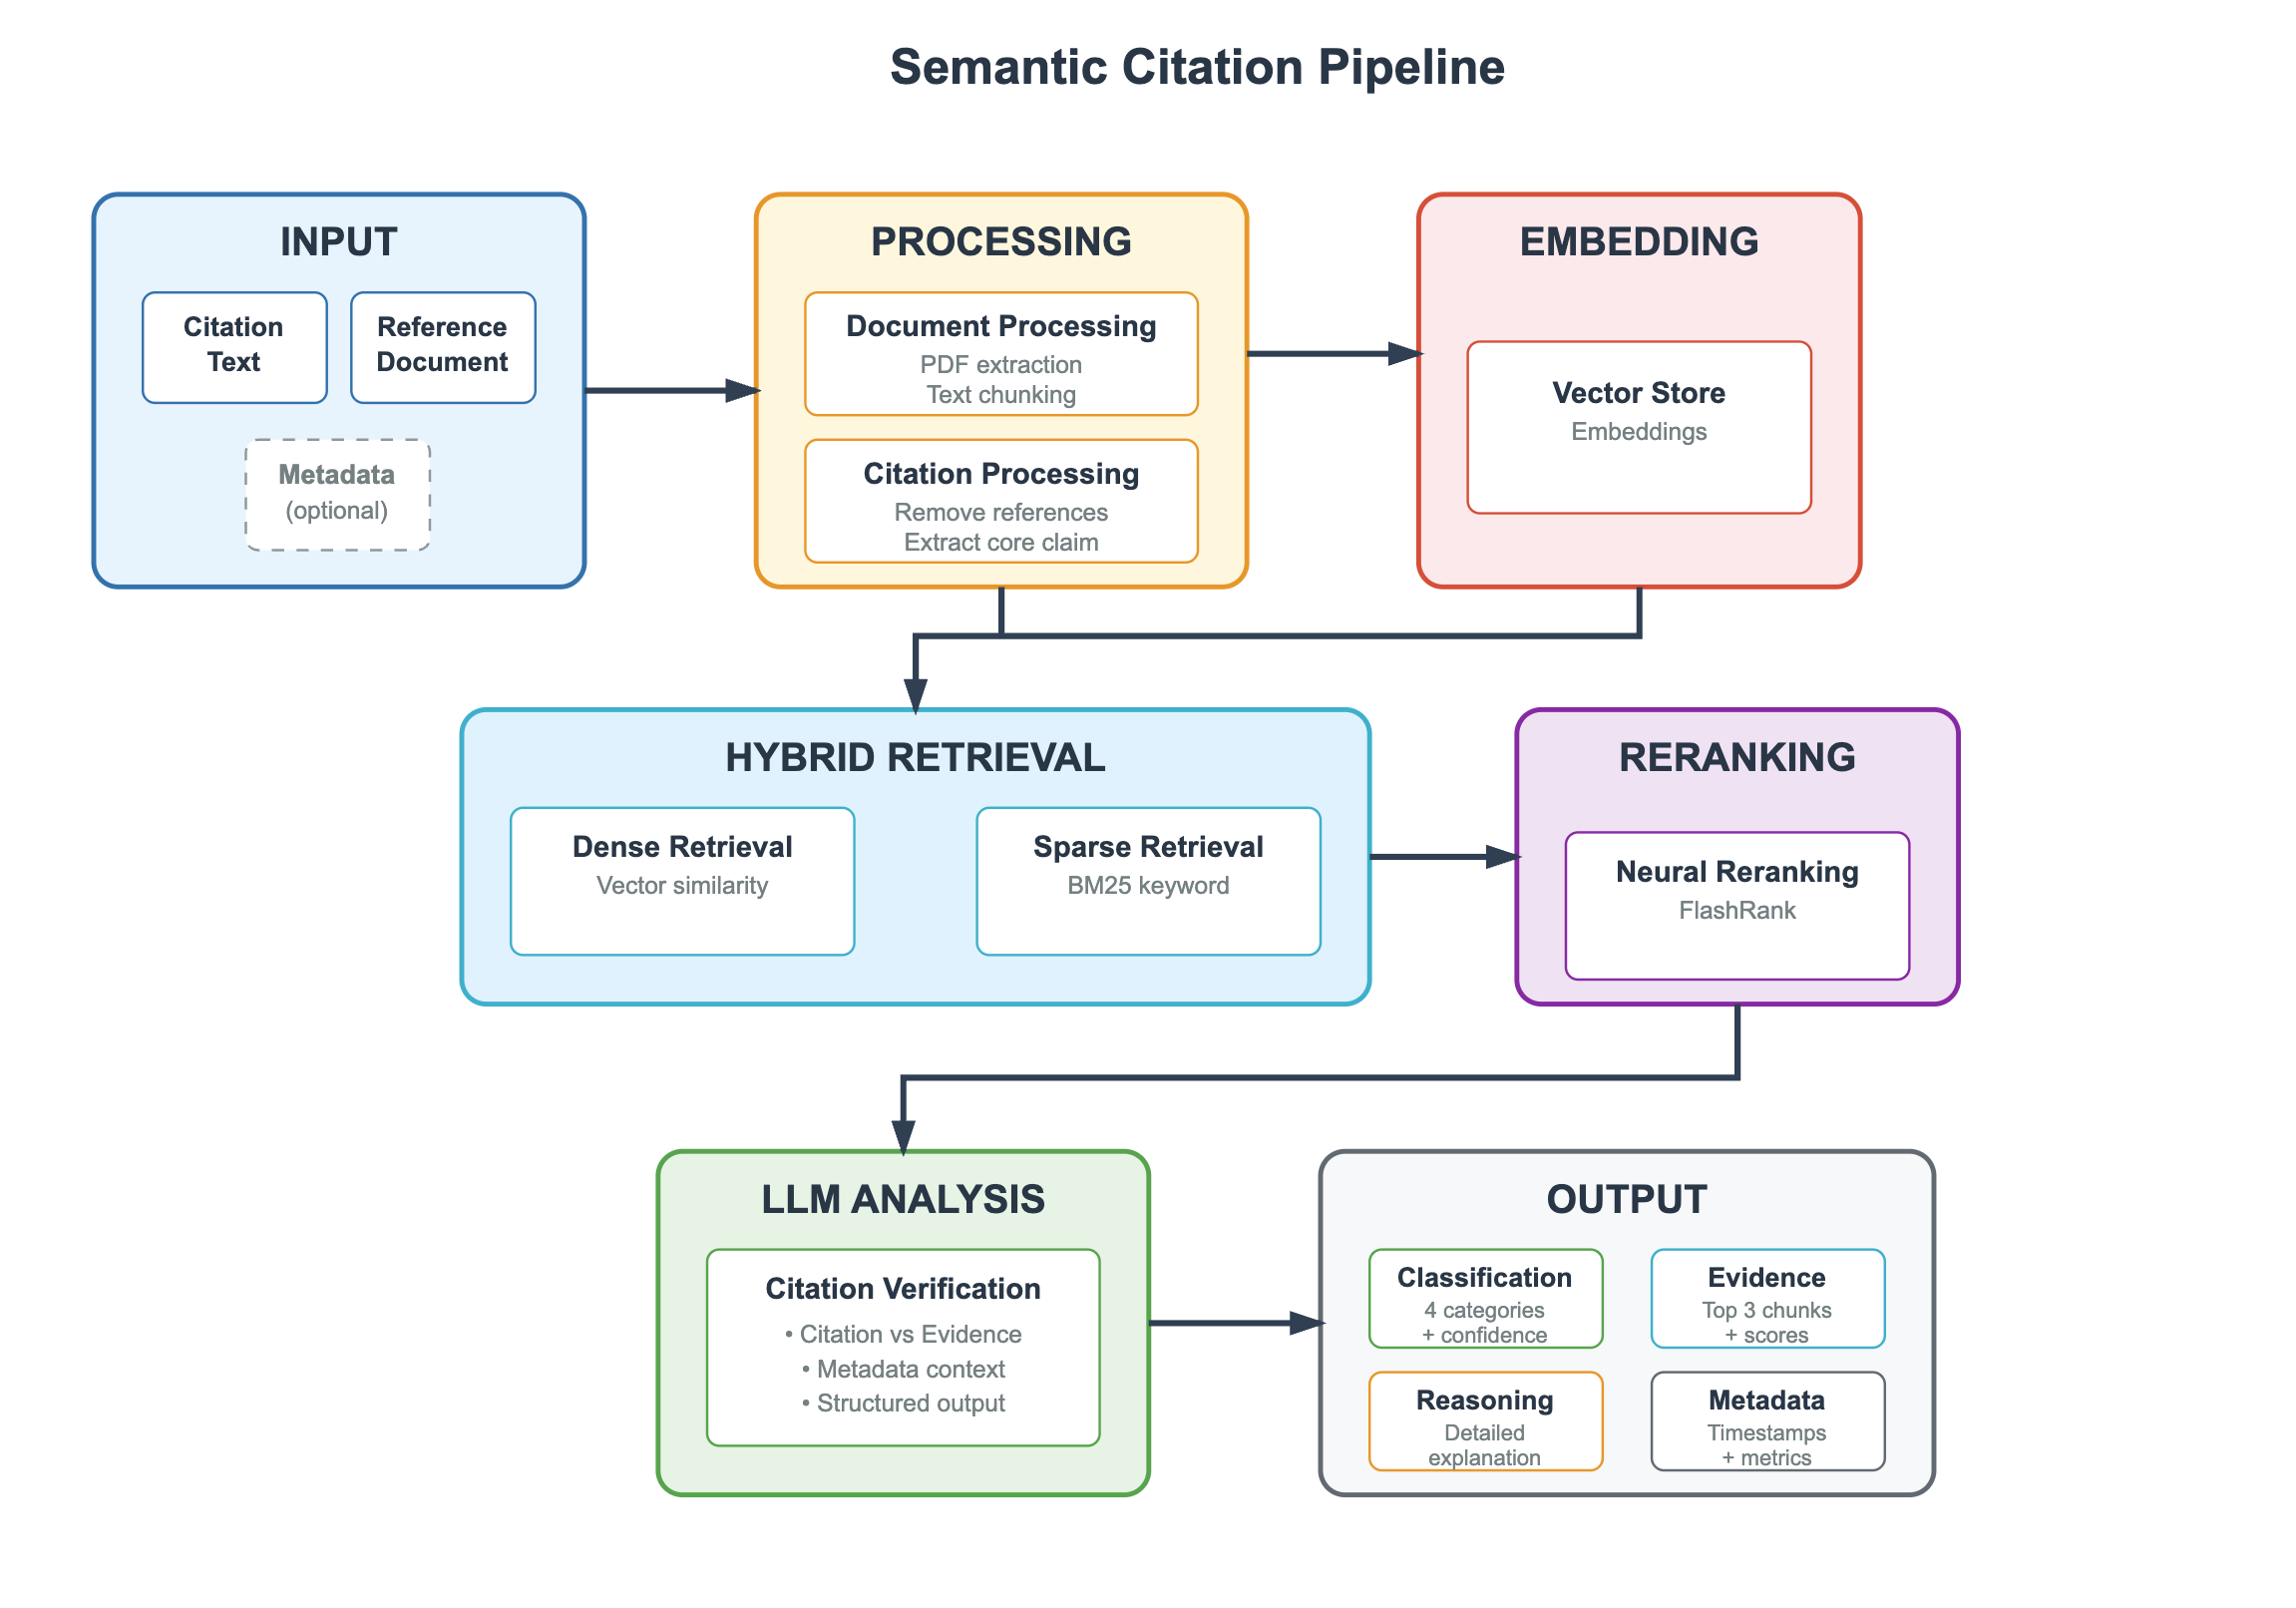
L'analisi di una pipeline in stile produzione mostra un ordine fisso. L'input è il testo della citazione, il documento di riferimento e i metadati facoltativi. L'elaborazione estrae il testo dal PDF, lo suddivide in segmenti, rimuove l'elenco dei riferimenti affinché il modello non possa “verificare” un'affermazione leggendo la bibliografia e isola l'affermazione centrale. L'embedding memorizza quindi questi segmenti. Il recupero ibrido esegue in parallelo la ricerca vettoriale densa e BM25 sparso — necessario perché il gergo disciplinare e la notazione statistica spesso non funzionano con la sola ricerca tramite embedding. Il reranking neurale (per esempio FlashRank) conserva i passaggi migliori. Solo allora l'analisi LLM classifica la relazione tra affermazione ed evidenza.
L'output utile non è un'approvazione binaria. Una classificazione in quattro categorie con confidenza — supportata, contraddetta, non affrontata o parzialmente affrontata — insieme ai migliori passaggi di evidenza e a una motivazione scritta, è ciò che un agente di sintesi dovrebbe acquisire. Questo schema corrisponde al più ampio orientamento verso una verifica delle affermazioni spiegabile e a livello di evidenza. Corrisponde anche a ciò che le unità didattiche universitarie già raccomandano quando descrivono assistenti AI che estraggono prove anziché inventare una narrazione.
Anche con una pipeline restano due modalità di errore. Innanzitutto, una conclusione dell'autore citata correttamente può comunque essere classificata erroneamente come fatto se il classificatore ignora il contesto della sezione, ossia risultati rispetto alla discussione. In secondo luogo, il recupero ibrido può far emergere una frase molto simile da un articolo diverso nello stesso campo — deriva della citazione tramite parafrasi. La revisione umana dei passaggi migliori è quindi parte del metodo, non un'ammissione di sconfitta.
I flussi di lavoro Jenova possono approssimare questa pipeline richiedendo una citazione più un riferimento puntuale prima che un'affermazione possa entrare in un memo di sintesi, quindi eseguendo Deep Research come secondo passaggio sulla stessa bibliografia. Non sostituiscono un servizio dedicato di verifica delle citazioni con metriche di valutazione fissate. Per capitoli di tesi e invii a riviste, esporta la tabella delle evidenze e ispezionala.
Come si istruisce un agente di ricerca AI a separare fatti, conclusioni e inferenze?
Istruisci l'agente con un protocollo permanente che definisca le etichette, vieti gli avanzamenti silenziosi dello status di un'affermazione e richieda una tabella delle contraddizioni prima di qualsiasi narrazione tra domini. La scelta dello strumento è importante, ma prompt privi di etichette faranno collassare FCI su ogni piattaforma.
Per Academic Research Assistant di Jenova, una configurazione durevole è simile a questa:
- Apri l'agente su jenova.ai/a/academic-research-assistant e indica la domanda di ricerca, le discipline comprese nell'ambito e i limiti temporali.
- Incolla un protocollo FCI permanente (salvalo nelle istruzioni personalizzate se le stesse regole devono essere applicate tra le sessioni):
“Protocollo di lavoro: etichetta ogni frase [FATTO], [CONCLUSIONE DELL'AUTORE] o [INFERENZA AI]. I fatti richiedono un riferimento puntuale alla fonte. Le conclusioni dell'autore devono nominare l'articolo e mantenere le cautele linguistiche. L'inferenza AI include qualsiasi mappatura tra domini, salto causale o raccomandazione non dichiarata da una fonte. Se le evidenze sono in conflitto, non calcolarne la media. Produci una tabella: Affermazione | Livello | Fonte | Riferimento puntuale | Concordanza (supporta / contraddice / assente).”
- Alimenta il corpus. Allega i PDF di cui già ti fidi, quindi richiedi ulteriore scoperta invece di lasciare che la prima ricerca definisca il campo.
- Richiedi un risultato stratificato — bibliografia annotata, risultati etichettati FCI, quindi una breve sintesi che non possa introdurre nuovi fatti.
Un prompt iniziale che di solito produce una struttura utilizzabile:
“Domanda: in che modo l'intensità dell'isola di calore urbana, la qualità abitativa e i ricoveri cardiovascolari d'emergenza sono correlati nelle città ad alto reddito dal 2015? Discipline: climatologia, epidemiologia, economia urbana. Output: (1) mappa delle fonti, (2) risultati etichettati FCI, (3) registro delle contraddizioni, (4) inferenze AI elencate per ultime e contrassegnate come non testate. Non citare nulla che non hai recuperato.”
Per Elicit, la disciplina equivalente risiede nella progettazione delle colonne anziché nelle etichette della prosa. Crea campi di estrazione separati per risultato riportato, interpretazione degli autori, popolazione e limitazioni identificate, seguendo il flusso di lavoro dalla domanda all'estrazione dello strumento. Non utilizzare un'unica colonna “risultato principale”; è in quella colonna che i verbi della discussione vengono promossi a risultati.
Per un chatbot generico, aggiungi un controllo avversariale che lo studio di Nature mostra essere necessario: richiedi citazioni testuali, quindi risolvi indipendentemente ogni riferimento in un database bibliotecario. Chiedere allo stesso modello “questa citazione è reale?” è inaffidabile. Se il progetto è una revisione sistematica, utilizza gli strumenti di screening descritti nelle linee guida delle biblioteche sulla sintesi delle evidenze per le decisioni di inclusione, e tieni il chatbot fuori dalle valutazioni di eleggibilità.
Deep Research su Jenova è il follow-up migliore quando la bibliografia è ampia e ti serve un secondo passaggio ricco di citazioni. Usalo dopo aver stabilito le regole FCI, non come prima esplorazione priva di etichette.
Cosa dicono i metodologi della ricerca sulla provenienza delle evidenze AI?
I metodologi della ricerca considerano la sintesi AI non etichettata un errore di rendicontazione, non un guadagno di produttività: se un lettore non può vedere quale livello occupa una frase, il documento non è ancora evidenza. Questa posizione è coerente con l'insistenza di PRISMA sulla sintesi trasparente e con gli studi sull'integrità delle citazioni che trattano i riferimenti fabbricati come una minaccia al registro probatorio.
“La modalità di errore che osserviamo non è l'incapacità dei modelli di leggere gli articoli. È il fatto che scrivono con una sola voce epistemica. Un numero metodologico, una clausola prudente da una sezione di discussione e un'analogia tra campi escono dal modello come inglese ugualmente sicuro di sé. Le commissioni interdisciplinari discutono quindi della conclusione quando dovrebbero discutere del livello. Se una frase non può rispondere a ‘chi ha affermato questo, ed è stato misurato o inferito?’, non dovrebbe entrare in una sintesi dei risultati.”
“L'etichettatura FCI costa meno di una ritrattazione post hoc. I team che impongono riferimenti puntuali prima della sintesi dedicano più tempo al primo passaggio e molto meno a districare la deriva delle citazioni. Lo studio Nature su ChatGPT rimane il riferimento cautelativo: persino grandi riduzioni delle fabbricazioni lasciano tassi di errore residui inaccettabili in un elenco di riferimenti. La provenienza è il sistema di controllo. La fluidità non lo è.”
“Le pipeline di orchestrazione e verifica delle citazioni sono il modo per rendere operativo questo standard. Recupera le discipline in parallelo quando non condividono costrutti. Verifica le affermazioni rispetto ai segmenti prima che raggiungano il sintetizzatore. Mantieni il passaggio integrativo del modello in un blocco separato e nominato. Questa architettura è più conservativa di un riepilogo prodotto da un chatbot, ed è proprio questo il punto.”
— Team di prodotto Jenova, progettazione di agenti di ricerca AI, otto anni di sviluppo di flussi di lavoro per recupero e attribuzione destinati a utenti accademici e professionali
L'implicazione per la scelta degli strumenti è circoscritta. Preferisci sistemi capaci di mantenere un protocollo, mostrare le fonti e tollerare la contraddizione. Non preferire sistemi che si limitano a sembrare interdisciplinari.
Quando la revisione umana dovrebbe prevalere sulla sintesi AI tra discipline?
La revisione umana dovrebbe prevalere sulla sintesi AI ogni volta che un'affermazione modifica una decisione, attraversa un confine metodologico disciplinare o non può essere ricondotta a un riferimento puntuale — cioè nella maggior parte del lavoro che giustifica la sintesi in primo luogo. L'AI è un moltiplicatore per la redazione e il recupero. Non è l'autorità epistemica.
La prevalenza della revisione umana non è negoziabile in almeno cinque condizioni:
- Nella sintesi compare un linguaggio causale, ma non nella sezione dei risultati dell'opera citata.
- È possibile una discordanza tra costrutti (per esempio, “stress” in psicologia rispetto a “carico allostatico” in medicina rispetto a “volatilità” in economia).
- Sono coinvolte linee guida o norme; i tassi di allucinazione nelle query giuridiche sono stati particolarmente elevati nei test controllati.
- È implicata un'aggregazione statistica. I modelli linguistici non eseguono una meta-analisi difendibile parafrasando abstract, e PRISMA 2020 esiste specificamente per le revisioni che includono sintesi.
- La verifica delle citazioni non è stata eseguita rispetto al PDF. Riferimenti inventati o alterati sono ancora abbastanza comuni nel 2026 da far sì che riviste e biblioteche li trattino come un problema di integrità.
Una pratica divisione del lavoro appare così. Academic Research Assistant propone la mappa delle fonti, le etichette FCI e il registro delle contraddizioni. Elicit o uno strumento di screening gestisce l'estrazione strutturata quando il corpus è oggetto di una revisione formale. Un metodologo umano giudica gli avanzamenti di livello e tutte le inferenze tra domini. L'AI può suggerire la mappatura; soltanto l'umano può promuoverla.
Usata in questo modo, la sintesi AI non sostituisce il giudizio interdisciplinare. È un modo per mantenere fatti, conclusioni degli autori e inferenze del modello in flussi separati e ispezionabili, affinché il giudizio abbia materiale onesto su cui operare.
Riferimenti
- Rules Integrity Initiative — Provenienza e riciclaggio delle fonti
- Walters & Wilder, Scientific Reports — Fabbricazione ed errori nelle citazioni bibliografiche generate da ChatGPT
- Forbes — AI ritenuta responsabile dell'aumento delle citazioni fabbricate negli articoli di ricerca (2026)
- Enago — Allucinazioni AI nelle citazioni di ricerca (2026)
- MIT Sloan — Affrontare allucinazioni e bias dell'AI, compresi i tassi dello Stanford HAI per query giuridiche
- George Mason University Libraries — Strumenti AI per revisioni della letteratura
- King's College London — Strumenti AI nella sintesi delle evidenze
- Dichiarazione PRISMA 2020
- Page et al., The BMJ — La dichiarazione PRISMA 2020
- EQUATOR Network — Linea guida di rendicontazione PRISMA
- Elicit — AI per la ricerca scientifica
- Paperguide — Confronto tra Elicit e Scite (2026)
- PapersFlow — Elicit vs Consensus AI
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — I migliori strumenti di ricerca AI del 2026
- UNC Charlotte Library — Citazioni AI allucinate
- Wu et al., AAAI — Reti di inferenza delle evidenze per una verifica interpretabile delle affermazioni
- PaperTrail — Un'interfaccia affermazione-evidenza per fondare l'output accademico dei LLM (arXiv)
- Zhang et al., EACL — Verifica multimodale e spiegabile delle affermazioni
- University of Iowa — Revisioni della letteratura assistite dall'AI