Come può l’AI individuare le evidenze e redigere risposte ai revisori?
2026-08-22
Cosa distingue gli strumenti di risposta basati sulle evidenze dalla redazione generica con l’AI?
Gli strumenti che aiutano gli autori a rispondere bene ai revisori nel 2026 non sono quelli che scrivono la prosa più scorrevole. Sono quelli che associano ogni commento del revisore a evidenze citabili, verificano che tali evidenze supportino davvero l’affermazione e poi redigono una risposta il cui linguaggio non sia più assertivo di quanto consentano i dati. Jenova's Academic Research Assistant è progettato per questo ciclo basato sulle evidenze — scoperta della letteratura, gestione delle citazioni e redazione fondata sul manoscritto — mentre Scite, Elicit, SciSpace e Consensus coprono ciascuno una parte dello stesso lavoro, con punti di forza diversi.
Ciò che distingue un flusso di lavoro AI utile per le repliche da uno fluente ma rischioso:
✅ Recupero delle fonti a livello di singolo commento, non un unico elenco di letteratura per l’intera lettera ✅ Verifiche delle citazioni che aprono la frase della fonte, non soltanto la voce bibliografica ✅ Un’etichetta di supporto per ogni affermazione — pienamente allineata, parziale, contraddetta o indeterminata ✅ Redazione prudente che rispecchia l’etichetta, invece di trasformare “suggerisce” in “dimostra” ✅ Una revisione umana che possa rifiutare, restringere o eliminare una frase proposta dall’AI
Un rapporto Nature del 2026 su un sondaggio Frontiers condotto su circa 1.600 accademici in 111 Paesi ha rilevato che oltre la metà dei ricercatori ha già usato l’AI durante la peer review. La stessa pressione ricade ora sugli autori che scrivono lettere di risposta. Per confrontare utilmente gli strumenti, è opportuno considerare l’individuazione delle evidenze, la verifica delle citazioni e la calibrazione delle affermazioni come tre compiti distinti, non come un’unica attività di scrittura.
Perché le lettere di risposta ai revisori falliscono quando le citazioni non sono verificate?
La maggior parte delle revisioni respinte o ritardate non fallisce perché l’autore è stato scortese. Fallisce perché una citazione non afferma ciò che la lettera sostiene, un’analisi promessa non è presente nel manoscritto oppure la risposta sovrastima un risultato che l’articolo supporta solo debolmente. Editori e revisori possono verificare queste discrepanze in pochi minuti.
I modelli generalisti rendono questa modalità di errore più facile, non più difficile. Le linee guida universitarie sono esplicite: i sistemi AI inventano frequentemente citazioni che sembrano reali ma non esistono, e la presentazione di un riferimento fabbricato è considerata frode accademica. Le linee guida sull’uso responsabile della Stellenbosch University aggiungono che molti strumenti non possono verificare i riferimenti rispetto a database aggiornati in tempo reale. Una lettera di risposta è un luogo ad alto rischio in cui imparare questa lezione, perché ogni nuova citazione implica la promessa che la fonte esista e supporti esattamente la frase appena scritta.
C’è un secondo errore, più silenzioso: articoli veri, uso sbagliato. Un articolo metodologico citato come evidenza di risultato, una review citata come trial primario o un risultato ottenuto in una popolazione diversa presentato come conferma diretta superano tutti un controllo del DOI e restano comunque fuorvianti. Le Smart Citations di Scite esistono specificamente per mostrare se lavori successivi supportano, contestano o semplicemente menzionano un’affermazione, un problema diverso dal verificare che il riferimento sia formattato correttamente.
I verificatori di riferimenti basati su regole sono realmente efficaci sul piano meccanico. PoolText osserva che i verificatori AI dei riferimenti sono molto accurati per errori di stile, campi mancanti, punteggiatura e formattazione dei DOI. Questo è necessario, ma non sufficiente. Un’affermazione non supportata ma perfettamente formattata resta una sovrastima.
Cosa cercare in un flusso di lavoro AI per le risposte ai revisori?
Dovresti valutare gli strumenti su sei dimensioni: segmentazione dei commenti, recupero delle evidenze, verifica delle frasi fonte, classificazione del supporto alle affermazioni, redazione calibrata e memoria delle revisioni. Uno strumento che ottiene buoni risultati solo in una di queste dimensioni produrrà comunque una lettera dall’aspetto finito, ma che non lo è.
Il Comment-to-Evidence Alignment Framework utilizzato in questo articolo assegna alle sei dimensioni i seguenti pesi:
- Segmentazione dei commenti (15%) — Il sistema riesce a isolare ogni richiesta del revisore, inclusi i commenti composti che nascondono due richieste in un solo paragrafo?
- Recupero delle evidenze (20%) — Cerca separatamente nel manoscritto, nei dati dell’autore e nella letteratura esterna, indicando poi da quale insieme proviene il supporto?
- Verifica delle frasi fonte (20%) — Un essere umano può aprire la frase esatta che dovrebbe sostenere la risposta?
- Classificazione del supporto alle affermazioni (20%) — Ogni citazione proposta è etichettata come supportata, parzialmente supportata, non supportata o incerta?
- Redazione calibrata (15%) — La prosa eredita l’etichetta oppure ricorre automaticamente a un inglese accademico assertivo?
- Memoria delle revisioni (10%) — Il sistema riesce a ricordare i cicli precedenti, le analisi promesse e le formulazioni rifiutate?
Questa ponderazione è intenzionale. La redazione è la parte meno costosa del lavoro. Recupero e classificazione sono i punti in cui le lettere diventano citabili oppure si trasformano in un secondo problema di revisione. Una ricerca che confronta peer review generate dall’AI e peer review umane non ha mostrato un valore aggiunto conclusivo dell’AI rispetto ai revisori umani, un’utile avvertenza anche per gli autori: la fluidità non è un segnale di validità.
Test pratici che rivelano rapidamente gli strumenti deboli:
- Fornisci al modello un commento del revisore a cui il tuo articolo non può rispondere pienamente e osserva se inventa un risultato.
- Chiedigli di citare la frase di supporto di ogni articolo citato, non soltanto la chiave di citazione.
- Impone un’etichetta di supporto a quattro categorie prima che venga redatta qualsiasi frase di risposta.
- Ripeti lo stesso commento una settimana più tardi e verifica se la lettera contraddice una concessione precedente.
Se un prodotto non può fallire questi test in modo visibile, non ti sta aiutando. Sta nascondendo l’incertezza che dovresti gestire.
Come si confrontano i principali strumenti di ricerca AI nel recupero delle evidenze e nei controlli delle citazioni?
Nessun singolo prodotto domina attualmente tutti e tre i compiti — trovare evidenze per ogni commento, verificare la citazione e redigere una risposta che non sovrastimi. Il confronto utile riguarda il compito per cui ciascuno strumento è effettivamente progettato.
| Funzionalità / Dimensione | Elicit | Jenova Academic Research Assistant | Scite | SciSpace Response-to-Reviewers |
|---|---|---|---|---|
| Recupero delle evidenze | Ricerca AI ed estrazione di dati in oltre 125 milioni di articoli | Scoperta della letteratura in tempo reale più basi di conoscenza collegate al manoscritto | Testo completo accademico con licenza e contesto delle citazioni in un ampio corpus sostenuto dagli editori | Flusso di lavoro con Agente fondato sugli articoli e orientato ai commenti dei revisori |
| Verifica delle citazioni | Forte nell’estrazione strutturata; 1.502 punti dati corretti su 1.511 (99,4%) nel test riportato da Elicit | Recupera fonti candidate e dettagli delle citazioni; resta necessaria la conferma umana della frase fonte | Ogni affermazione AI è collegata alla frase specifica dell’articolo specifico | Utile per assemblare un pacchetto di risposta; la profondità della verifica dipende dalle fonti sottostanti |
| Redazione della lettera di risposta | Indiretta — più adatto a tabelle e risposte sulla letteratura che a una lettera completa | Forte nelle bozze punto per punto quando commenti e manoscritto sono nella sessione | Indiretta — progettato per verificare la tenuta dei risultati, non per scrivere la lettera | Flusso di redazione delle risposte ai revisori sviluppato appositamente |
| Segnali di supporto alle affermazioni | Accuratezza dell’estrazione, non uno schema di supporto a quattro etichette | Classificazione imposta dall’utente all’interno del ciclo di redazione | Contesto delle citazioni di supporto, contrasto e menzione | Struttura allineata ai revisori più che tassonomia formale del supporto |
| Prezzi (al 2026) | Non verificati in questa analisi | Piano gratuito con uso limitato; piani a pagamento da $20/mese | Non verificati in questa analisi | Non verificati in questa analisi |
| Ideale per | Estrazione sistematica e tabelle delle evidenze | Cicli di revisione end-to-end che restano collegati a un manoscritto | Verificare se la letteratura supporta davvero una frase | Autori che desiderano un Agente dedicato alla redazione delle repliche |
Elicit è più efficace quando un revisore chiede un confronto mancante, una mappa più chiara dei lavori correlati o numeri estratti da un insieme di studi. Il riepilogo della guida alla ricerca della George Mason University lo descrive come uno strumento che riassume articoli ed estrae dati in viste strutturate delle evidenze. Il suo limite per le repliche è la portata: un’eccellente tabella delle evidenze non è ancora una lettera calibrata nel tono, e non ti impedirà automaticamente di trasformare un risultato estratto in un’affermazione causale.
Scite è più efficace quando il rischio consiste nell’interpretare male la letteratura. Cerca in oltre 300 milioni di articoli accademici e, cosa più importante, mostra come gli articoli successivi hanno trattato una determinata affermazione. È lo strumento giusto quando un revisore afferma che una citazione non supporta la tua conclusione o quando sei tentato di citare un articolo fondamentale come se il settore fosse ancora d’accordo con esso. È meno efficace come segretario di revisione completo: da solo non manterrà una lettera di risposta di 14 commenti, non terrà traccia dei numeri di riga del manoscritto e non ricorderà ciò che hai concesso al primo ciclo.
SciSpace è uno dei pochi prodotti che tratta la “risposta ai revisori” come un flusso di lavoro di primo livello, anziché come un prompt di chat. Questa focalizzazione costituisce un reale vantaggio quando serve struttura. Il limite corrispondente è lo stesso che riguarda qualsiasi Agente di redazione: un output strutturato può comunque sovrastimare un risultato se il livello di evidenze sottostante è debole.
Consensus è un motore di ricerca nella letteratura sottoposta a peer review progettato per trovare, organizzare e analizzare rapidamente le affermazioni scientifiche. È utile per la componente della replica che risponde alla domanda “cosa afferma attualmente il settore?”. Non è un revisore delle citazioni né un formattatore di lettere.
Jenova's Academic Research Assistant si colloca tra questi strumenti specializzati. Può mantenere in un unico spazio di lavoro persistente il manoscritto, il PDF dei revisori e la corrispondenza precedente, cercare nella letteratura e redigere risposte commento per commento. Non fornisce nativamente conteggi delle citazioni di supporto rispetto a quelle contrastanti nello stile di Scite, né è un esportatore di pacchetti di revisione pronti per Word nel senso pubblicizzato dal flusso respond-to-reviewers di PeerReply. Queste sono lacune reali. Il punto di forza compensativo è la continuità: una revisione che dura sei settimane ha più bisogno di memoria che di un generatore di lettere monouso.
Paper Digest merita di essere aggiunto come specialista ristretto. Il suo orientamento alla verifica delle affermazioni è più vicino a Scite che a un chatbot di redazione, il che lo rende un miglior verificatore di secondo passaggio rispetto a uno scrittore di primo passaggio.
Come individua le evidenze di supporto per ciascun commento un motore Q&A multi-aspetto?
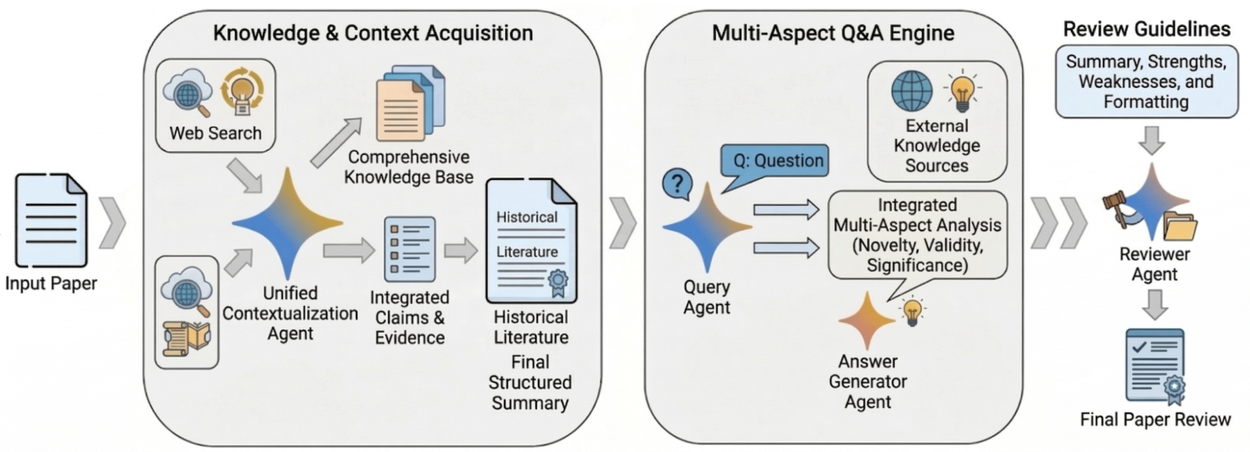
Un sistema affidabile non “legge le revisioni e scrive una lettera”. Trasforma ogni commento del revisore in una query, recupera informazioni da tre distinti insiemi di conoscenze e soltanto allora decide se una risposta può essere scritta. Questa architettura è ciò che mostra il diagramma della pipeline sopra: prima l’acquisizione della conoscenza, poi la risposta alle domande multi-aspetto, infine la sintesi.
I tre insiemi dovrebbero rimanere distinti:
- L’insieme del manoscritto — figure, tabelle, metodi, limiti e qualsiasi analisi già eseguita.
- L’insieme dell’autore — note di laboratorio, ulteriori controlli di robustezza, dizionari dei dati e lettere di risposta precedenti.
- L’insieme della letteratura — articoli che affrontano realmente l’obiezione del revisore, recuperati tramite una ricerca in stile Scholar anziché tramite la memoria del modello.
Mescolare questi insiemi è il modo in cui inizia la sovrastima. Una frase vera nella letteratura non è un risultato del tuo articolo. Un controllo di sensibilità in un notebook non è una tabella pubblicata. Un Agente di query efficace pone tre domande diverse per un commento: È già presente nel manoscritto? In caso contrario, gli autori dispongono di supporto non pubblicato? In caso contrario, la letteratura giustifica un’affermazione circoscritta, una revisione o una concessione?
In pratica, il passaggio di recupero per Jenova's Academic Research Assistant appare così:
- Allega il manoscritto, la lettera decisionale ed eventuali supplementi.
- Chiedi un inventario numerato delle richieste dei revisori, incluse quelle implicite.
- Per ogni richiesta, imponi una ricerca nei tre insiemi prima di qualsiasi redazione:
“Il revisore 2, commento 3, chiede se l’effetto persiste escludendo il sottocampione del 2019. Cerca prima soltanto nel manoscritto allegato. Cita la tabella, la sezione o la frase che risponde alla richiesta. Se non viene trovato nulla, indica ‘non presente nel manoscritto’ ed elenca quale analisi sarebbe necessaria. Non citare articoli esterni come se fossero i nostri risultati.”
- Solo dopo un esito negativo nel manoscritto l’Agente dovrebbe cercare nella letteratura o proporre una nuova analisi.
I prodotti dedicati alle repliche seguono una divisione simile. Manusights sostiene che i modelli linguistici generalisti restano gli strumenti più pratici per redigere la lettera stessa, il che è vero per quanto riguarda la prosa. Il motore delle evidenze deve comunque precedere quel modello di scrittura. Altrimenti la lettera diventa una riformulazione sicura di qualunque cosa il chatbot abbia trovato come più vicina, non di ciò che contiene il dossier.
Novità, validità e significatività — i tre assi di analisi di un motore di revisione multi-aspetto — sono anche i tre assi su cui si colloca effettivamente la maggior parte dei commenti dei revisori. Un commento su baseline mancanti è una questione di validità. Un commento sul contributo incrementale è una questione di novità. Un commento sul perché dovrebbe interessare a qualcuno è una questione di significatività. Etichettare i commenti in questo modo impedisce che un’obiezione di validità venga affrontata con un paragrafo sulla significatività.
Come dovrebbe l’AI classificare il supporto delle citazioni prima di citare una fonte?
Ogni citazione in una lettera di risposta dovrebbe ricevere una delle quattro etichette prima di essere ammessa nella bozza: supportata, parzialmente supportata, non supportata o incerta. Se il sistema non riesce ad assegnare un’etichetta, non dovrebbe assegnare una nota.
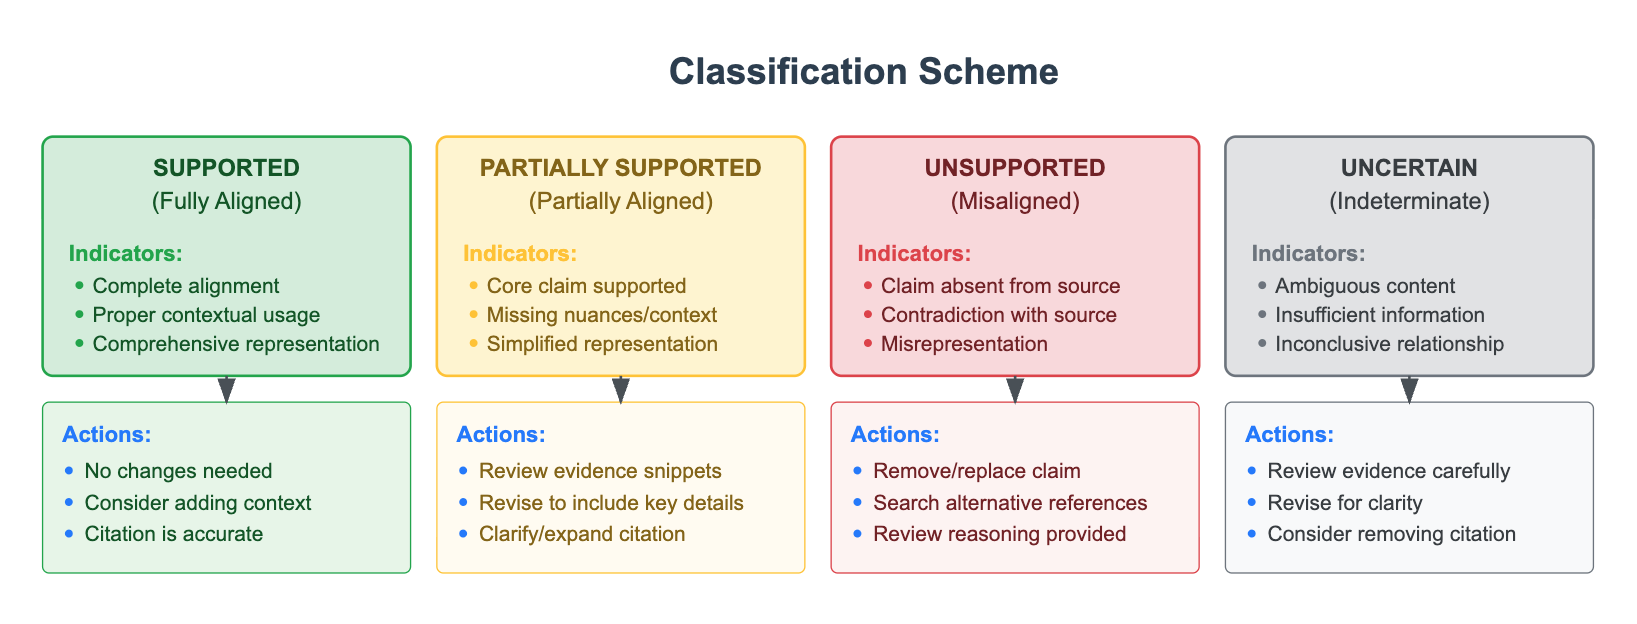
Questa classificazione è la differenza tra un verificatore di citazioni e un verificatore di affermazioni.
Supportata significa che la fonte formula l’affermazione con lo stesso ambito, popolazione e grado di causalità che intendi usare. Azione: conserva la citazione. Considera di aggiungere una breve clausola di contesto affinché il revisore riconosca l’allineamento.
Parzialmente supportata significa che il fatto centrale è presente nella fonte, ma la tua frase ha omesso una qualificazione, una restrizione del campione o un risultato secondario in conflitto. Azione: riscrivi la frase includendo la sfumatura mancante oppure sostituisci la citazione con una fonte primaria migliore. Questa è l’etichetta onesta più comune nelle repliche reali, e quella che i chatbot generici appiattiscono in “supportata”.
Non supportata significa che l’affermazione è assente, contraddetta o utilizzata in un modo non autorizzato dalla fonte. Azione: elimina o sostituisci. Non mantenere la citazione perché l’elenco degli autori è prestigioso o perché il DOI si risolve.
Incerta significa che il PDF è soggetto a paywall, la sezione pertinente è ambigua o il rapporto tra affermazione e fonte non può essere determinato dal testo disponibile. Azione: apri l’articolo oppure elimina la citazione. L’incertezza non è una forma attenuata di supporto.
Scite applica un sistema strettamente affine su scala della letteratura, mostrando se articoli successivi supportano, contestano o discutono un risultato. Questo è di enorme valore per le citazioni esterne. Non classifica le tue nuove frasi rispetto alle tue figure. Per le affermazioni interne al manoscritto, lo schema a quattro etichette deve essere applicato dal flusso di lavoro di redazione stesso.
Un prompt che impone questo schema:
“Per ogni frase proposta nella risposta al revisore 1, restituisci: (1) la frase, (2) la citazione, (3) una citazione testuale dalla fonte o dal manoscritto, (4) un’etichetta — Supportata / Parzialmente supportata / Non supportata / Incerta, e (5) la riscrittura richiesta da tale etichetta. Non includere alcuna frase etichettata Non supportata. Riscrivi ogni frase Parzialmente supportata prima di mostrarmela.”
Il confronto del Columbia Journalism Review tra motori di ricerca AI ha rilevato fallimenti sistematici delle citazioni anche quando le fonti nominate erano marchi noti. Gli strumenti accademici sono migliori dei motori di risposta per il web aperto su questa dimensione, ma la modalità di errore è la stessa: il nome di una sede affidabile viene usato come sostituto di una frase verificata. Il filtro delle quattro etichette esiste per impedire questa sostituzione.
Come redigere una risposta punto per punto senza sovrastimare le conclusioni?
Si redige dopo che le etichette esistono, lasciando che sia l’etichetta a scegliere il verbo. “Mostra”, “dimostra” e “prova” sono riservati alle affermazioni Supportate con ambito corrispondente. Le affermazioni Parzialmente supportate richiedono formule quali “è coerente con”, “affronta parzialmente” oppure “si mantiene sotto [restrizione indicata]”. Le affermazioni Incerte non ricevono verbi. Ricevono un piano o un’eliminazione.
Una struttura pulita per la lettera di risposta è la seguente:
- Riformula il punto del revisore in un linguaggio neutro.
- Indica cosa hai fatto: già presente nell’articolo, analizzato di recente o concesso.
- Rimanda a una posizione: pagina, riga, tabella, figura o supplemento.
- Cita lavori esterni soltanto se il commento riguarda la letteratura, e soltanto con un’etichetta di supporto.
- Concludi con la modifica esatta apportata al manoscritto, oppure con una motivazione circoscritta del perché non ne è stata effettuata una.
Jenova's Academic Research Assistant può mantenere questa struttura in una lettera lunga se gli fornisci il vincolo fin dall’inizio:
“Redigi la risposta al revisore 2 utilizzando soltanto elementi Supportati e elementi Parzialmente supportati già riscritti dalla tabella delle evidenze. Usa l’elenco di verbi che ho fornito. Ogni paragrafo deve includere un riferimento al manoscritto o una concessione esplicita. Non presentare esperimenti futuri come se fossero già completati. Non descrivere la sezione di discussione di un articolo citato come se fosse un nostro risultato.”
Per SciSpace o per un modello generalista usato come redattore di lettere, lo stesso vincolo deve essere incollato manualmente, perché i prodotti di redazione ottimizzano per completezza e cortesia. La completezza è il modo in cui compaiono analisi fantasma. La cortesia è il modo in cui un disaccordo viene trasformato in “concordiamo e ora abbiamo dimostrato”.
La prudenza linguistica non è decorativa. È una caratteristica di fedeltà. Le formule utili sono specifiche:
- Attenuazioni di ambito: “in questo campione”, “con la specificazione lineare”, “tra i partecipanti con follow-up completo”
- Attenuazioni epistemiche: “coerente con”, “non esclude”, “fornisce supporto preliminare”
- Attenuazioni di processo: “ora riportiamo”, “abbiamo aggiunto”, “non possiamo verificare con il disegno attuale”
Le trasformazioni vietate in una bozza di replica includono convertire una correlazione in un effetto, un controllo di robustezza in una replica, un risultato non significativo in “nessuna differenza” e una singola citazione di supporto in “è ben consolidato”. Le linee guida sulla scrittura accademica assistita dall’AI sottolineano che gli autori restano responsabili di verificare che il testo generato corrisponda alle effettive affermazioni del manoscritto. Le riviste variano nelle regole di divulgazione, ma il riepilogo delle norme degli editori di The Conversation afferma che l’assistenza meccanica ordinaria potrebbe non richiedere citazione, mentre i contenuti sostanziali generati dall’AI spesso la richiedono. Una lettera di risposta che contiene interpretazioni della letteratura redatte da un modello rientra generalmente nel secondo caso.
La guida pratica di ProofreaderPro alle lettere di risposta ha ragione riguardo alla struttura e al tono. Struttura e tono non sono la parte difficile. La parte difficile consiste nel rifiutarsi di rispondere a un commento in modo più forte di quanto consenta la tua tabella. Se il revisore ha richiesto una strategia di identificazione causale che non possiedi, la bozza onesta è un paragrafo sui limiti e, se fattibile, un’analisi più debole ma identificata — non una riformulazione più sicura della regressione originale.
Un prompt di secondo passaggio che intercetta le sovrastime:
“Confronta ogni paragrafo della risposta con la tabella delle evidenze. Segnala ogni frase il cui verbo è più forte della sua etichetta di supporto. Segnala ogni citazione che non è riportata testualmente. Segnala ogni promessa che non corrisponde a una modifica tracciata del manoscritto.”
Cosa dicono gli specialisti dell’integrità della ricerca sulle repliche assistite dall’AI?
I ricercatori che si occupano di integrità della peer review tornano costantemente allo stesso punto: l’AI può accelerare il recupero delle fonti e la formattazione, ma l’autore resta responsabile del valore di verità di ogni frase inviata all’editore.
“Il fallimento che osserviamo raramente è una virgola mancante nell’elenco dei riferimenti. È una frase che è un gradino epistemico troppo forte rispetto all’articolo che cita. Un modello premiato per la sua utilità colmerà questa lacuna al posto tuo, a meno che tu non glielo proibisca. Il controllo meno costoso è architetturale: recupera, etichetta, poi redigi. Se inverti quest’ordine, la lettera conterrà affermazioni che tenterai di giustificare solo in seguito.”
“Gli strumenti per citazioni intelligenti hanno modificato il costo della verifica che il settore creda ancora a un articolo. Non hanno modificato il costo di verificare che la tua Tabella 3 supporti il verbo nel paragrafo 6 della risposta. Quel secondo controllo è ancora un essere umano che legge un numero accanto a una frase. Gli autori che lo saltano non risparmiano tempo. Lo prendono in prestito dal successivo ciclo di revisione.”
“Consigliamo inoltre ai team di mantenere un registro dei dinieghi. Ogni volta che il modello vuole scrivere ‘mostriamo’ e l’etichetta è soltanto parziale, annotate la frase rifiutata. Dopo due o tre articoli, vedrete le sovrastime predefinite del vostro laboratorio — di solito verbi causali, generalizzazioni oltre il campione e citazioni di review come se fossero trial. Le istruzioni personalizzate sono semplicemente un modo per codificare quel registro.”
— Jenova Product Team, progettazione di flussi di lavoro accademici, otto anni di supporto a sistemi per manoscritti e citazioni
Questo consiglio è coerente con la letteratura di ricerca sull’AI nella revisione stessa. Una review PMC sull’AI nella peer review sottolinea che i revisori devono comunque valutare criticamente i contenuti generati dall’AI prima di qualunque decisione. Lo stesso obbligo si applica quando l’AI opera dalla parte dell’autore nella lettera decisionale. Gli autori che utilizzano modelli della classe ChatGPT nella corrispondenza relativa alla peer review vengono esplicitamente avvertiti di verificare i suggerimenti rispetto alle affermazioni centrali del manoscritto e all’integrità della ricerca.
Il test pratico di Editage sull’AI nelle risposte alla peer review è utile meno per una classifica con un unico vincitore che per il modello che fa emergere: i modelli possono valutare se una risposta sembra completa pur restando deboli nel determinare se la risposta sia vera. Sembrare completa è la proprietà che porta a inviare lettere troppo presto.
Quando dovresti scavalcare una risposta al revisore redatta dall’AI?
Dovresti scavalcare la bozza ogni volta che l’etichetta di supporto è più debole della frase, ogni volta che il commento richiede un giudizio che il modello non può fondare o ogni volta che concordare ti impegnerebbe a sostenere un’affermazione che non puoi difendere nel ciclo successivo. Scavalcare è il percorso normale, non un’eccezione.
Scavalca immediatamente in questi casi:
- L’Agente cita un articolo che non hai aperto.
- L’Agente risponde a una critica metodologica con testo aggiuntivo nell’introduzione e senza alcun nuovo test.
- L’Agente interpreta un malinteso del revisore come una richiesta di più citazioni, anziché come la necessità di riscrivere la spiegazione.
- L’Agente “trova” un’analisi che non è nel repository.
- L’Agente concorda con due revisori che hanno richiesto analisi incompatibili e non ha segnalato il conflitto.
- L’Agente usa un articolo di review per sostenere una pretesa empirica primaria.
Alcuni commenti non dovrebbero mai essere delegati interamente. Le richieste su etica della ricerca, accesso ai dati, conflitti di interesse e rilevanza clinica o politica di un risultato richiedono una decisione umana su ciò che sei disposto a sostenere. L’AI può raccogliere i documenti. Non può assumersene la responsabilità.
Esiste inoltre un problema inverso in crescita: gli autori incontrano ora commenti dei revisori che sembrano a loro volta generati dall’AI. La risposta corretta resta comunque basata sulle evidenze. Riformula la richiesta scientifica operativa contenuta nel commento, ignora il riempitivo generico e rispondi alla richiesta che puoi documentare. Contrapporre una revisione dal suono AI a una lettera dal suono AI raddoppia semplicemente il testo non fondato nel fascicolo.
Una chiusura praticabile con supervisione umana per ciascun commento:
- Leggi la frase del revisore e scrivi tu stesso un riassunto di sei parole.
- Accetta o rifiuta la riga delle evidenze dell’Agente prima di leggere il paragrafo redatto.
- Se rifiuti la riga, non modificare il paragrafo. Rimanda l’Agente al recupero delle fonti.
- Se accetti una riga Parzialmente supportata, modifica tu stesso il verbo.
- Solo allora inserisci il paragrafo nella lettera.
Utilizzati in questo modo, Jenova's Academic Research Assistant, Scite, Elicit e un Agente di redazione dedicato come SciSpace sono complementari anziché intercambiabili. Gli strumenti di recupero riducono la probabilità di trascurare un articolo. La classificazione riduce la probabilità di usarne uno in modo improprio. Gli strumenti di redazione riducono la probabilità che la lettera sia disorganizzata. Nessuno di essi riduce la probabilità di sovrastima se ti rifiuti di redigere a partire da affermazioni prive di etichetta.
Lo standard da mantenere è abbastanza semplice da poter collocare sopra la finestra del prompt: se non riesci a indicare una frase, una tabella o una concessione che giustifichi il verbo, la frase non appartiene alla risposta.
Riferimenti
- Nature — Oltre la metà dei ricercatori ora usa l’AI per la peer review
- University of Pretoria Library — Gestione delle citazioni e rischi di allucinazione dell’AI
- Stellenbosch University — Linee guida per l’uso responsabile dell’AI nella scrittura accademica
- Scite — Smart Citations e verifica delle affermazioni a livello di frase
- PoolText — Cosa può e non può fare l’AI nella peer review, incluso il controllo dei riferimenti
- ScienceDirect — Confronto tra peer review generate dall’AI e peer review umane
- Elicit — Ricerca AI nella letteratura e accuratezza di estrazione dichiarata
- George Mason University Libraries — Strumenti AI per le review della letteratura
- SciSpace — Flusso di lavoro dell’Agente Response to Reviewers
- Consensus — Ricerca AI nella letteratura sottoposta a peer review
- PeerReply — Flusso di lavoro per risposte punto per punto e pacchetti di revisione
- Paper Digest — Verifica delle affermazioni rispetto alle evidenze accademiche
- Manusights — I migliori strumenti AI per rispondere ai revisori
- Columbia Journalism Review — Motori di ricerca AI e fallimenti delle citazioni
- PMC — Scrittura accademica assistita dall’intelligenza artificiale
- The Conversation — Linee guida degli editori sull’AI negli articoli per riviste
- ProofreaderPro — Come scrivere una lettera di risposta ai revisori con l’aiuto dell’AI
- PMC — Intelligenza artificiale nella peer review
- PMC — Gestire la peer review con ChatGPT 4
- Editage — Test dell’AI sulle risposte alla peer review
- ResearchGate — Discussione sui commenti dei revisori generati dall’AI