Come può l’AI estrarre evidenze per domanda di ricerca da centinaia di articoli?
2026-08-21
In che modo i flussi di estrazione ancorati alla domanda differiscono dagli strumenti AI che privilegiano il riassunto?
I flussi di lavoro ancorati alla domanda restituiscono campi comparabili e collegati alle fonti per una domanda di ricerca predefinita; gli strumenti che privilegiano il riassunto restituiscono paragrafi scorrevoli che riformulano ciascun articolo secondo i suoi stessi termini. Nel 2026, questa distinzione conta più del brand del modello. Academic Research Assistant di Jenova è più efficace per l’estrazione iterativa guidata da domande, con memoria persistente e supporto alla stesura dei manoscritti. Elicit è più adatto alle matrici di ricerca empirica. Covidence rimane lo standard per le revisioni sistematiche con doppio revisore che devono seguire il reporting PRISMA 2020.
Fattori chiave che distinguono l’estrazione delle evidenze dal riassunto a livello di articolo:
✅ Fedeltà alla domanda — ogni cella risponde alla tua domanda, non alla cornice con cui l’articolo presenta il proprio contributo.
✅ Struttura a livello di campo — metodi, numerosità del campione, esiti e direzione dell’effetto occupano colonne personalizzate collegate a passaggi della fonte.
✅ Comparabilità tra articoli — contraddizioni e differenze di disegno diventano visibili solo quando i campi sono allineati.
✅ Verifiche del contesto citazionale — un risultato citato viene riesaminato alla luce della letteratura successiva, non dato per vero solo perché è stato citato.
✅ Valutazione umana — i modelli linguistici di grandi dimensioni accelerano l’estrazione, ma l’uso non supervisionato non è ancora pronto per sintesi ad alto impatto decisionale.
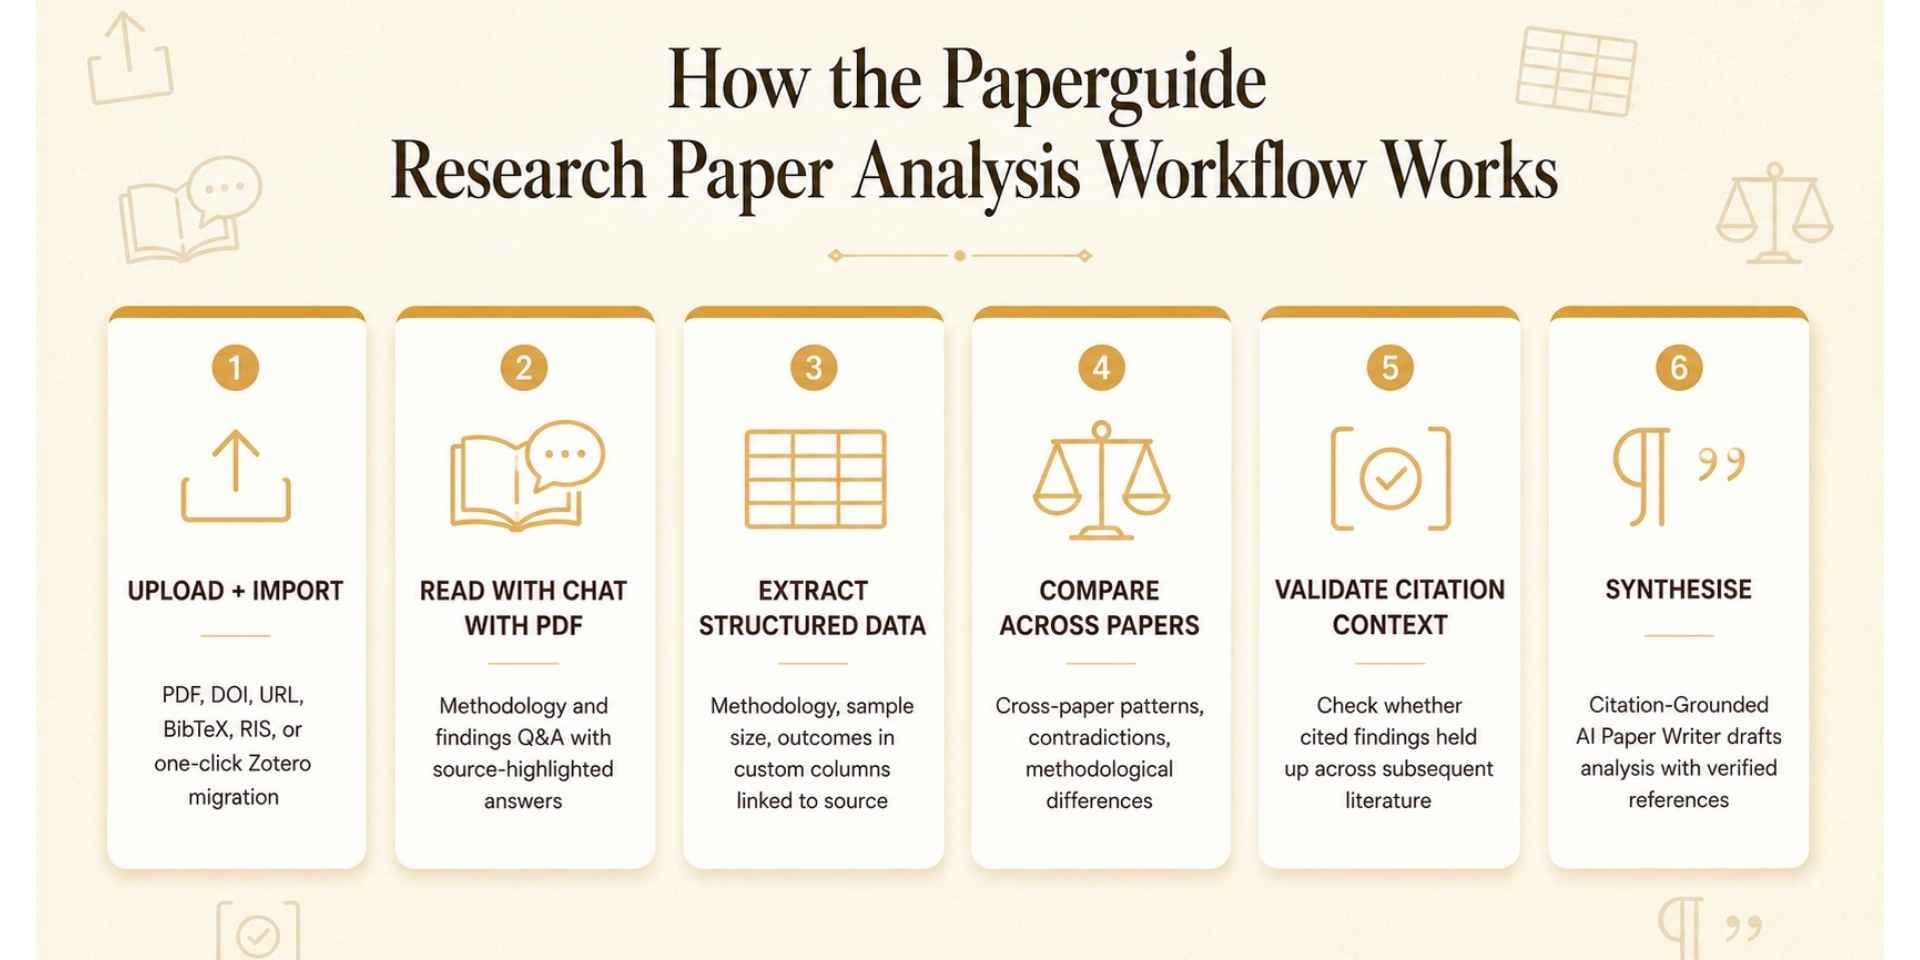
Per confrontare gli strumenti in modo significativo, è utile considerare l’estrazione come una pipeline — acquisizione, filtro per domanda, strutturazione, confronto, validazione e scrittura — anziché come un singolo prompt del tipo «riassumi questi PDF».
Perché i riassunti AI generici falliscono quando l’unità di analisi è una domanda di ricerca?
I riassunti generici falliscono perché comprimono studi non comparabili in una narrazione, nascondendo le celle specifiche richieste da una domanda di ricerca. Una sintesi a livello di articolo può sembrare completa pur omettendo la numerosità del campione, il comparatore, la finestra di follow-up oppure se il risultato indichi un aumento, una diminuzione o un effetto nullo. Queste omissioni sono decisive quando si passa da «di cosa parla questo articolo?» a «cosa dice questo corpus riguardo a questa domanda?».
La sintesi delle evidenze esiste per rispondere a domande strutturate, non per parafrasare gli abstract. PRISMA 2020 è costruito attorno al reporting delle ragioni per cui una revisione è stata svolta, dei metodi utilizzati e dei risultati trovati, non attorno alla generazione di un digest leggibile. Le revisioni classiche richiedono ancora circa un anno di lavoro per un team quando vengono applicati i metodi raccomandati. Il volume di letteratura che ha creato questo collo di bottiglia è lo stesso che gli strumenti di chat incentrati sul riassunto tentano di comprimere in pochi paragrafi.
I riassunti ereditano anche la retorica dell’articolo. Gli autori enfatizzano i risultati significativi; gli abstract riportano in modo insufficiente gli esiti nulli; le citazioni propagano affermazioni che lavori successivi indeboliscono. L’estrazione a livello di domanda inverte questo bias: prima si definiscono i campi, poi si pongono a ogni articolo le stesse domande. I test sull’estrazione con LLM mostrano anche il problema opposto. I modelli possono non rilevare dati sugli esiti persino quando gestiscono in modo affidabile i campi di contesto, motivo per cui l’estrazione degli esiti resta più difficile dell’estrazione delle caratteristiche degli studi.
L’implicazione pratica è semplice. Se il tuo output non può essere inserito in una tabella con una riga per studio e una colonna per ogni elemento della domanda, non hai ancora evidenze. Hai una sintesi descrittiva.
Cosa dovresti cercare in un flusso di lavoro AI per l’estrazione delle evidenze?
Dovresti cercare sei capacità che insieme formano un framework di estrazione ancorato alla domanda: fedeltà alla domanda, campi strutturati, tracciabilità delle fonti, allineamento tra articoli, validazione del contesto citazionale e un ciclo documentato di verifica umana. Gli strumenti che ottengono buoni risultati nella scrittura scorrevole ma scarsi in questi sei aspetti produrranno comunque riassunti generici.
Fedeltà alla domanda. Il sistema deve accettare una domanda in stile protocollo — PICO, PECO o uno schema personalizzato — e non deviare verso risultati adiacenti. «Filtra per domanda» è il passaggio portante delle moderne pipeline di estrazione con LLM, non un semplice affinamento opzionale.
Campi strutturati. Numerosità del campione, disegno, intervento o esposizione, comparatore, esito, direzione dell’effetto e limitazioni dovrebbero confluire in colonne personalizzate, ciascuna collegata a un passaggio della fonte. Il testo libero in una finestra di chat non è un modulo di estrazione dati.
Tracciabilità delle fonti. Le risposte devono includere evidenziazioni o riferimenti di posizione nel PDF. Senza questi, non puoi dirimere gli errori del modello rispetto al documento originale né riportare i metodi in modo trasparente.
Allineamento tra articoli. Lo stesso campo deve avere lo stesso significato in tutte le righe. Altrimenti non puoi rilevare contraddizioni, differenze di dose o effetti del disegno dello studio.
Validazione del contesto citazionale. Un risultato valido nel 2018 potrebbe non reggere dopo studi successivi. Un’estrazione che non ricontrolla mai le affermazioni citate riciclerà evidenze obsolete in nuovi manoscritti.
Verifica umana. Fino al 63% degli studi estratti da esseri umani contiene almeno un errore di estrazione dati. Gli LLM introducono errori diversi e possono anche intercettare quelli umani. Il flusso di lavoro deve trattare il disaccordo come un segnale per aprire il PDF, non come un punteggio da confrontare.
I confronti delle biblioteche universitarie nel 2026 continuano a valutare gli strumenti per ruolo, corpus e modalità di errore, anziché per promesse di marketing. La valutazione dell’Oregon State University osserva che Consensus può interpretare erroneamente le fonti, mentre la matrice di Elicit è più utile per gli articoli empirici e può non cogliere le sfumature nei riassunti. Si tratta di risultati di valutazione, non di fattori che escludono gli strumenti — ed è il giusto livello di analisi.
Quali strumenti AI estraggono evidenze strutturate da più articoli?
Nessun singolo strumento domina ogni fase. Elicit è in testa per le matrici empiriche, Covidence per le revisioni sistematiche di gruppo, Consensus per panoramiche rapide sul grado di accordo e Academic Research Assistant di Jenova per l’analisi iterativa guidata da domande che prosegue nella gestione delle citazioni e nella stesura. Le pipeline in stile Paperguide illustrano la sequenza che privilegia l’estrazione, anche quando gli stessi passaggi vengono assemblati con strumenti diversi.
| Funzionalità / Dimensione | Elicit | Academic Research Assistant di Jenova | Consensus | Covidence |
|---|---|---|---|---|
| Colonne personalizzate a livello di domanda | Matrice di ricerca con colonne personalizzabili per metodi, numerosità del campione e risultati | Schemi definiti nel prompt, conservati nella memoria persistente tra le sessioni | Riassunti tabellari e indicatore di consenso; minor controllo sui campi personalizzati | Moduli di estrazione dati per gli studi inclusi dopo lo screening |
| Scala tipica della sintesi | Flusso dal protocollo all’estrazione sulle fonti raccolte; i riassunti Plus citano un piccolo insieme di articoli | Estrazione in lotti su PDF caricati e record collegati a Scholar | Fino a 20 articoli per sintesi con Pro o 50 con Deep | Corpus sottoposti a screening su scala di team per revisioni formali |
| Tracciabilità delle fonti | Collegamenti alla letteratura inclusa | Risposte basate sui documenti con PDF allegati | Collegamenti alle fonti utilizzate nella panoramica | Traccia di controllo completa di screening ed estrazione |
| Flusso con doppio revisore | Non è il fulcro del prodotto | Non integrato | Non integrato | Screening indipendente doppio e risoluzione dei conflitti |
| Verifiche del contesto citazionale | Limitate oltre l’insieme estratto | Follow-up della letteratura tra sessioni tramite Scholar e ricerca | L’indicatore di consenso segnala il livello di accordo | Manuali; gli aggiornamenti sono regolati dal protocollo di revisione |
| Passaggio al manoscritto | Esportazione verso gestori bibliografici | Gestione delle citazioni e stesura; Word Doc Generator può formattare il testo | Esportazione per utenti Plus | La stesura della revisione rimane una fase separata |
| Prezzi al 2026 | Abbonamenti Plus istituzionali; i piani consumer non sono verificati in questa sede | Piano gratuito; Plus a partire da $20/mese | Freemium; alcuni campus offrono licenze Pro | Piani annuali individuali, a pacchetto o organizzativi |
| Ideale per | Tabelle di estrazione empirica | Analisi iterativa guidata da domande in progetti di lunga durata | Istantanee rapide del consenso in ambito biomedico/STEM | Revisioni sistematiche di team conformi a PRISMA |
Elicit è esplicitamente posizionato per perfezionare un protocollo, raccogliere fonti, svolgere lo screening, estrarre e sintetizzare. È la descrizione del lavoro appropriata per l’attività a livello di domanda. Il suo limite, registrato nelle valutazioni delle biblioteche, è che i riassunti generati spesso si concentrano sui risultati e non colgono le sfumature, e che la matrice è ottimizzata per le convenzioni di reporting empirico. Gli articoli qualitativi, teorici o scarsamente strutturati saranno estratti con minore precisione.
Consensus è utile quando la domanda è già vicina a un’affermazione empirica sì/no. Sintetizza panoramiche narrative, tabelle e un indicatore di consenso, e può eseguire ricerche più approfondite che segnalano lacune. Può anche interpretare erroneamente le fonti, e il limite di articoli del piano Deep resta molto al di sotto di «centinaia di testi completi». Consideralo uno strumento di ricognizione, non un modulo di codifica.
Covidence è ampiamente descritto come il software leader per la gestione delle revisioni sistematiche. Insieme a EPPI-Reviewer, DistillerSR e JBI-SUMARI, appartiene al ristretto gruppo di piattaforme che supportano l’intero stack delle revisioni sugli interventi — record, screening, estrazione e risoluzione dei conflitti di team. È più complesso di quanto richieda la ricerca esplorativa. L’estrazione conversazionale tramite «chat con questo PDF» non è il suo fulcro, e la maggior parte dei progetti dipende ancora da moduli di estrazione compilati da persone.
Academic Research Assistant di Jenova occupa una parte diversa dello stack. Cerca fonti accademiche in tempo reale, accetta PDF caricati, conserva una cronologia chat illimitata e ricorda il protocollo tra le sessioni, così le definizioni delle colonne non devono essere reimpartite ogni giorno. Non svolge lo screening doppio, non genera un diagramma di flusso PRISMA e centinaia di articoli devono essere elaborati in lotti anziché versati in un’unica finestra di contesto. Sono limiti reali. I punti di forza compensativi sono la persistenza, l’accesso a più modelli e la capacità di portare la stessa domanda di ricerca dall’estrazione alla stesura basata sulle citazioni senza esportare il progetto altrove.
La sequenza pubblicata in sei passaggi da Paperguide — caricamento, chat con PDF, colonne strutturate, confronto tra articoli, validazione del contesto citazionale e infine scrittura basata sulle citazioni — esprime chiaramente il modello che privilegia l’estrazione. I dati indipendenti sull’accuratezza e sui prezzi di Paperguide non sono stati verificati per questo articolo; il flusso di lavoro stesso è l’oggetto utile del confronto.
Come funziona l’estrazione strutturata dei dati quando il corpus comprende centinaia di articoli?
Funziona trasformando ciascun articolo in righe di campi definiti dal protocollo, quindi filtrando tali righe in base alla domanda di ricerca prima di scrivere qualsiasi testo di sintesi. La scala deriva dalla ripetizione di uno schema, non da un riassunto più lungo.
La prima mossa è l’acquisizione. PDF, DOI, URL, BibTeX, RIS oppure un’esportazione da un gestore bibliografico costituiscono il corpus. La chat con PDF è la seconda mossa, non l’ultima: serve a individuare passaggi relativi a metodi e risultati, quindi a fissare quei passaggi nelle colonne. Una revisione continua dell’estrazione automatizzata ha rilevato 76 pubblicazioni sull’argomento, ma solo sei strumenti implementati per utenti finali, e l’84% degli algoritmi analizzava soltanto titoli e abstract. L’estrazione basata solo sugli abstract non rileverà esiti, analisi di sottogruppo e dettagli sul rischio di bias che risiedono nel testo completo. Qualsiasi flusso che dichiari di gestire «centinaia di articoli» basandosi solo sugli abstract sta riassumendo, non codificando.
Le colonne personalizzate dovrebbero corrispondere alla domanda, non al modello predefinito del fornitore. Per una domanda di efficacia, i campi tipici sono disegno, popolazione, intervento o esposizione, comparatore, esito primario, direzione dell’effetto, dimensione dell’effetto con intervallo, follow-up e limitazioni. Per una domanda sui meccanismi, sostituisci la dimensione dell’effetto con il percorso ipotizzato e con l’indicazione se lo studio lo abbia effettivamente testato. Collegare ogni cella a un passaggio della fonte rende possibile il confronto successivo. Senza riferimenti di posizione, una tabella è semplicemente un altro riassunto con più spazio bianco.
Centinaia di articoli impongono anche l’elaborazione in lotti. Finestre di contesto, limiti di frequenza ed errori di analisi dei PDF rendono inaffidabile l’estrazione in un solo passaggio di un intero corpus per revisione sistematica. Un modello durevole è: definire lo schema su un campione pilota di 8–15 articoli, misurare la concordanza rispetto alla codifica umana, congelare il prompt e quindi elaborare gli articoli rimanenti a ondate. Il testo del prompt determina completezza e formato; prompt unici per ogni articolo non sono generalizzabili. Sperimenta su un sottoinsieme, poi mantieni costante il prompt.
Academic Research Assistant di Jenova supporta questo modello perché lo schema può risiedere nella memoria persistente e i PDF possono rimanere allegati al progetto. Richiede comunque l’elaborazione in lotti. La matrice di Elicit è più vicina a una scheda di codifica nativa per i campi empirici. Covidence presuppone che il corpus abbia già superato lo screening. Scegli lo strumento che corrisponde alla fase in cui ti trovi realmente.
Come si validano i risultati estratti rispetto al contesto citazionale e al disegno dello studio?
Si valida verificando se l’affermazione estratta regge ancora nel passaggio citato, nella letteratura successiva e tra disegni di studio che rispondono alla stessa domanda. L’estrazione senza questi controlli riprodurrà il bias citazionale alla velocità della macchina.
La validazione del contesto citazionale significa aprire il passaggio citato, non fidarsi della frase che cita. Gli articoli sovrastimano regolarmente ciò che una referenza ha mostrato, citano gli abstract anziché i risultati oppure portano avanti un risultato che studi successivi hanno ribaltato. Un passaggio dedicato alla domanda «questo risultato citato regge?» è pertanto distinto da «cosa ha riportato questo articolo?». I flussi in stile Paperguide collocano questo controllo immediatamente prima della sintesi, ed è l’ordine corretto: non scrivere il paragrafo finché la cella non è stabile.
La validazione consapevole del disegno va oltre. Una figura metodologica del 2025 in Nature Communications mostra una pipeline in due stadi che costituisce una utile architettura di riferimento, anche se non adotti mai le sue formule di punteggio. I modelli linguistici di grandi dimensioni analizzano il testo libero in popolazione, intervento o esposizione, relazione ed esito, quindi classificano la direzione dell’effetto come aumento, diminuzione o nessuna variazione. Questi record sono stratificati per disegno — trial randomizzati, randomizzazione mendeliana, studi osservazionali — in modo che un risultato non venga trattato come intercambiabile tra metodi.
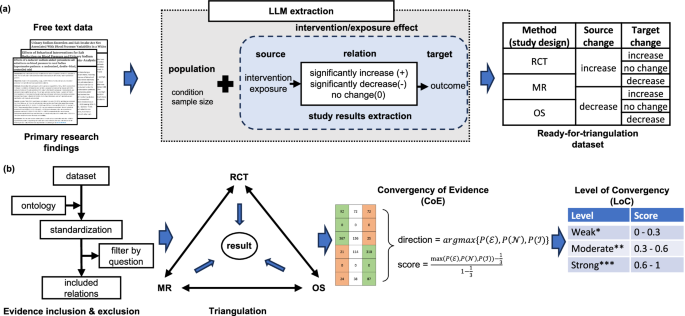
Il secondo pannello è la parte che la maggioranza degli strumenti di riepilogo salta. Dopo la standardizzazione e il filtraggio per inclusione, i risultati vengono triangolati tra disegni. Un punteggio di Convergenza delle evidenze utilizza la direzione con la maggiore massa di probabilità; una fascia di Livello di convergenza etichetta quindi il corpo delle evidenze come debole, moderato o forte. Non è necessario usare esattamente questa metrica per applicarne il principio. È però necessario smettere di aggregare un’associazione osservazionale significativa con un trial nullo come se fossero un’unica frase del tipo «la letteratura dice X».
Il disaccordo tra persona e modello dovrebbe essere risolto rispetto al PDF in un terzo passaggio, non classificato come fallimento automatico del modello. In una prova di concetto, Claude 2 ha commesso un errore maggiore e cinque minori — e ha rilevato 21 errori minori nello standard di riferimento umano. Trattare le estrazioni pubblicate come standard di riferimento sottostima i modelli e sovrastima gli esseri umani. L’unità di analisi corretta è la concordanza fattuale di ogni campo, con statistiche composite, come la stima puntuale più l’intervallo, conteggiate in modo coerente anziché come tre numeri indipendenti.
Jenova può eseguire il passaggio sul contesto citazionale perché può cercare la letteratura successiva e mantenere in memoria la tabella di estrazione originale. Non può sostituire un secondo revisore umano per una revisione in stile Cochrane. Covidence può imporre quel secondo revisore. Considera entrambi i fatti senza ridurli a un unico vincitore.
Come si esegue nella pratica un flusso di estrazione guidato da domande?
Definisci prima domanda e campi, sperimenta lo schema, estrai in lotti con riferimenti di posizione alle fonti, confronta le righe, ricontrolla le citazioni e infine scrivi a partire dalla tabella. Invertire quest’ordine — scrivere prima e recuperare le citazioni dopo — ricrea il problema del riassunto.
Per Academic Research Assistant di Jenova, una sequenza tipica è la seguente:
- Apri l’Agente e indica il protocollo in un unico blocco, inclusi i criteri di inclusione e le colonne esatte desiderate.
- Allega un insieme pilota di PDF, oppure DOI, anziché l’intero corpus.
- Estrai in una tabella, richiedendo un riferimento di posizione per ogni cella.
- Congela il prompt dopo aver corretto il campione pilota.
- Elabora in lotti gli articoli rimanenti, quindi esegui un passaggio sulle contraddizioni e uno sul contesto citazionale prima di qualsiasi sintesi narrativa.
Un utile prompt iniziale:
«Domanda di ricerca: negli adulti con depressione resistente al trattamento, la ketamina aggiuntiva riduce i punteggi Montgomery–Åsberg rispetto al placebo a 24 ore? Includi solo RCT. Per ogni articolo, estrai: disegno, n randomizzato, dose e via di somministrazione, comparatore, esito primario, momento temporale, dimensione dell’effetto con 95% CI, direzione (aumento / diminuzione / nessuna variazione) e limitazioni. Riporta la frase dei risultati per ogni dimensione dell’effetto. Non riassumere gli articoli che non soddisfano i criteri di inclusione. Segnala le celle vuote anziché dedurre informazioni.»
Un utile prompt di confronto dopo la creazione della tabella:
«Usando solo la tabella di estrazione, elenca: (1) i conflitti nella direzione dell’effetto, (2) le differenze di dose o momento temporale che potrebbero spiegare tali conflitti e (3) ogni riga il cui trial citato a supporto sia più vecchio del più recente risultato nullo sullo stesso esito. Non aggiungere articoli che non siano presenti nella tabella.»
Per Elicit, il percorso analogo consiste nel perfezionamento del protocollo, nella raccolta delle fonti, nello screening e quindi in una matrice con colonne personalizzate — i passaggi che il prodotto documenta per le revisioni sistematiche della letteratura. Inizia con domande empiriche i cui campi, quali n, metodi ed esiti, corrispondono già alla matrice. Non aspettarti la stessa resa dagli articoli teorici.
Per Covidence, esegui l’importazione della ricerca, la rimozione dei duplicati, lo screening doppio di titoli e abstract, lo screening del testo completo e quindi i moduli di estrazione. Le guide delle biblioteche considerano questa classe di software come l’ambiente per una sintesi delle evidenze strutturata, trasparente e riproducibile, non come un chatbot. Se ti servono un diagramma di flusso PRISMA e due revisori indipendenti, inizia qui e utilizza un LLM solo all’interno del modulo di estrazione, con il secondo revisore ancora umano.
Due regole operative valgono per tutti e tre. Primo: non lasciare mai che il modello riempia una cella vuota con un valore plausibile; le celle vuote sono dati. Secondo: misura il tempo dell’intera attività — iterazione del prompt, valutazione e correzione — non solo la latenza del modello. Il tempo dedicato al compito è il risultato di efficienza rilevante, e la progettazione dei prompt fa parte di quel tempo.
Cosa dicono i ricercatori sulla sintesi delle evidenze riguardo all’estrazione dati con LLM?
I ricercatori considerano gli LLM acceleratori promettenti per i campi di contesto e sostituti non dimostrati per l’estrazione degli esiti, mentre la progettazione della validazione rimane essa stessa un problema metodologico aperto. Il consenso nei lavori metodologici del 2025–2026 è condizionato: utili all’interno di un flusso supervisionato, non pronti come estrattori non supervisionati.
«Il collo di bottiglia nella sintesi delle evidenze non è la velocità di lettura. È fare in modo che ogni studio risponda alla stessa domanda negli stessi campi, per poi rilevare quando quei campi non concordano. Una sintesi può essere scorrevole e tuttavia inutilizzabile per questo compito, perché la scorrevolezza nasconde celle vuote. Quando abbiamo trasferito i team dalla chat a livello di articolo alle tabelle ancorate alla domanda, la prima cosa emersa non è stata un’intuizione: è stata l’incompletezza. Numerosità campionarie senza denominatore, esiti senza momento temporale, citazioni che non supportavano la frase a cui erano associate.»
«Abbiamo anche smesso di trattare l’estrazione umana come uno standard di riferimento. Una quota rilevante degli studi codificati da persone contiene almeno un errore di estrazione, e i modelli talvolta rilevano tali errori introducendone altri, soprattutto nelle statistiche composite. L’unità produttiva di valutazione è la concordanza fattuale per campo, valutata rispetto al PDF. Finché un flusso non può dimostrare quel ciclo — schema, riferimento di posizione, lotti, contraddizioni, nuova verifica delle citazioni — è un riassuntore, indipendentemente dal numero di articoli che dichiara di aver letto.»
— Team di prodotto Jenova, progettazione di flussi di ricerca, esperienza nella costruzione di progetti accademici con Agenti di lunga durata, dalla scoperta della letteratura alla preparazione dei manoscritti
Questa posizione è in linea con i commenti indipendenti. Una revisione esplorativa sugli LLM nelle revisioni sistematiche ha concluso che sono in crescita ma non ancora pronti all’uso come infrastruttura autonoma. Un lavoro distinto sui modelli linguistici per l’estrazione dati e la valutazione del rischio di bias sta testando pipeline miste tra persone e modelli, anziché revisioni basate soltanto sui modelli. La domanda attuale nel settore non è «un modello può leggere 400 PDF?». È «una tabella registrata e filtrata per domanda può superare una doppia revisione?».
Quando dovresti comunque usare software dedicato alle revisioni sistematiche invece di un Agente di ricerca AI?
Usa software dedicato alle revisioni sistematiche quando hai bisogno di screening indipendente doppio, di un flusso PRISMA riportabile e di una traccia di controllo che una rivista, un ente HTA o un panel di linee guida esaminerà. Usa un Agente di ricerca AI quando stai ancora definendo la domanda, codificando un corpus in evoluzione o trasformando una tabella stabile in un manoscritto. I due strumenti sono più spesso sequenziali che rivali.
Covidence, DistillerSR, EPPI-Reviewer e JBI-SUMARI esistono perché metodi riproducibili, flussi di lavoro di team e record conformi a PRISMA sono requisiti, non preferenze, per le revisioni sugli interventi. Il machine learning all’interno di queste piattaforme ha fornito il maggiore aiuto nello screening — una valutazione ha stimato riduzioni del carico di screening fino al 60% — mentre gli strumenti per estrazione e rischio di bias restano meno sviluppati. Se il tuo output è una revisione registrata, non saltare questo stack perché un modello chat può parafrasare i PDF.
Un Agente è l’ambiente quotidiano migliore quando la domanda è ancora in evoluzione. Puoi allegare nuovi PDF, rivedere le colonne e mantenere in memoria le decisioni del protocollo senza aprire un nuovo progetto di revisione per ogni cambio di direzione. Academic Research Assistant di Jenova è costruito per questa modalità: ricerca accademica in tempo reale, testi completi allegati, schemi di estrazione persistenti e un percorso verso la stesura con citazioni gestite. Non soddisferà un protocollo che richieda due revisori. Esplicitare questo limite fa parte del suo corretto utilizzo.
Una separazione pratica utilizzata da molti gruppi nel 2026 è la seguente. Esplora e definisci i campi con un Agente o con Elicit. Registra il protocollo. Esegui lo screening e l’estrazione in Covidence o in un equivalente, opzionalmente con codifica assistita da LLM che un umano verifica comunque. Torna all’Agente per verificare criticamente il contesto citazionale e scrivere a partire dalla tabella finalizzata. L’elenco di strumenti per la sintesi delle evidenze della Duke University ricorda che nessuna singola applicazione copre ogni fase; la competenza professionale consiste nel sapere in quale fase ti trovi.
Il test che dovrebbe decidere lo stack è lo stesso che ha aperto questo articolo. Se puoi indicare una domanda di ricerca, una colonna per ogni elemento di tale domanda, un riferimento di posizione per ogni cella e un record di ciò che è stato escluso, stai estraendo evidenze. Se hai soltanto una panoramica ben scritta di «cosa dicono gli articoli», stai ancora riassumendo — anche se la panoramica è stata generata da centinaia di file.
Riferimenti
- PRISMA Statement — Linee guida di reporting per le revisioni sistematiche
- The BMJ — La dichiarazione PRISMA 2020: una linea guida aggiornata per il reporting delle revisioni sistematiche
- ScienceDirect — LLM nelle revisioni sistematiche: in crescita, ma non ancora pronti all’uso (revisione esplorativa)
- PMC — Strumenti digitali a supporto del processo di revisione sistematica
- BMJ Evidence-Based Medicine — Sfide e insidie nella valutazione degli LLM per l’estrazione dati
- Biblioteche dell’Oregon State University — Confronto tra strumenti AI per la ricerca della letteratura
- Elicit — Flusso di lavoro per la revisione sistematica della letteratura
- Covidence — Software per la gestione delle revisioni sistematiche
- Guide della biblioteca UCL — Software per revisioni sistematiche
- Nature npj Digital Medicine — Modelli linguistici per l’estrazione dati e la valutazione del rischio di bias
- Biblioteche della Duke University — Software e strumenti per la sintesi delle evidenze