L’AI multi-modello riduce meglio i punti ciechi nell’analisi azionaria?
2026-08-24
In che modo il disaccordo tra modelli e i controlli di ensemble rivelano rischi nascosti nella tesi?
Il controllo incrociato multi-modello riduce punti ciechi ed eccesso di fiducia in modo più affidabile rispetto all’analisi azionaria con un solo modello, perché il disaccordo tra modelli è di per sé un segnale di rischio, non un fastidio da mediare. Nel 2026, una singola risposta fluida di ChatGPT, Claude o Gemini può sembrare una ricerca completata. Proprio questa fluidità è il problema. Un modello, una finestra di contesto e una distribuzione di addestramento producono una storia coerente anche quando i numeri sono obsoleti, il filing è interpretato male o manca il caso ribassista.
Ciò che distingue davvero una ricerca azionaria AI accurata da una supposizione formulata con sicurezza:
✅ Ancoraggio alle fonti — filing, stime e prezzi aggiornati rispetto a un limite temporale dell’addestramento
✅ Diversità dei modelli — più di un provider, per individuare più facilmente i bias di un corpus condiviso
✅ Diversità dei ruoli — prospettive fondamentali, tecniche, macro e di portafoglio anziché un unico generalista
✅ Visualizzazione dell’incertezza — intervalli, conflitti e segnalazioni di “impossibile verificare” anziché falsa precisione
✅ Costo di una seconda verifica — sufficientemente basso affinché i controlli incrociati avvengano davvero prima di aumentare l’esposizione
Una regola pratica utile è il test Disaccordo-come-Segnale: considera il consenso tra modelli come un’ipotesi e il conflitto tra modelli come l’agenda della ricerca. Il resto di questo articolo applica questo test a chatbot a modello singolo, sistemi di scoring specifici come Danelfin, strumenti di ricerca orientati alle citazioni come Perplexity e agenti azionari specialistici di Jenova.
Perché l’eccesso di fiducia persiste quando gli investitori usano un solo modello AI?
L’eccesso di fiducia persiste perché un singolo modello restituisce una narrazione rifinita e le narrazioni rifinite eliminano l’attrito che normalmente spinge a una seconda verifica. La finanza comportamentale considera l’eccesso di fiducia un bias sistematico, non un difetto di personalità. Nei mercati si manifesta con trading eccessivo, scommesse concentrate e prove contrarie ignorate.
Questo schema non scompare quando l’analista è un’AI. La ricerca su eccesso di fiducia e bias di conferma nel trading collega il bias a maggiore turnover, minore diversificazione e rendimenti più deboli. Una rassegna del 2025 sul comportamento degli investitori nell’era dell’AI rileva che le correzioni discrezionali possono annullare i guadagni di efficienza degli algoritmi, aumentando la volatilità anziché ridurla. Studi più recenti descrivono l’“eccesso di fiducia algoritmico”: una volta delegata l’analisi a un modello, gli utenti considerano l’output più oggettivo di quanto sia realmente.
Una sessione con un solo modello peggiora la situazione in tre modi meccanici. Primo, il modello è premiato per la coerenza, quindi colma le lacune invece di segnalarle. Secondo, l’utente non vede disaccordo tra pari, il segnale che le istituzioni usano per ampliare gli intervalli di confidenza. Terzo, l’interfaccia è conversazionale, perciò anche una cifra errata arriva in prosa sicura di sé. L’avviso agli investitori della SEC statunitense sull’AI è esplicito su questo punto: l’AI può generare e diffondere informazioni false o inaccurate, e gli investitori dovrebbero verificare le affermazioni con professionisti registrati.
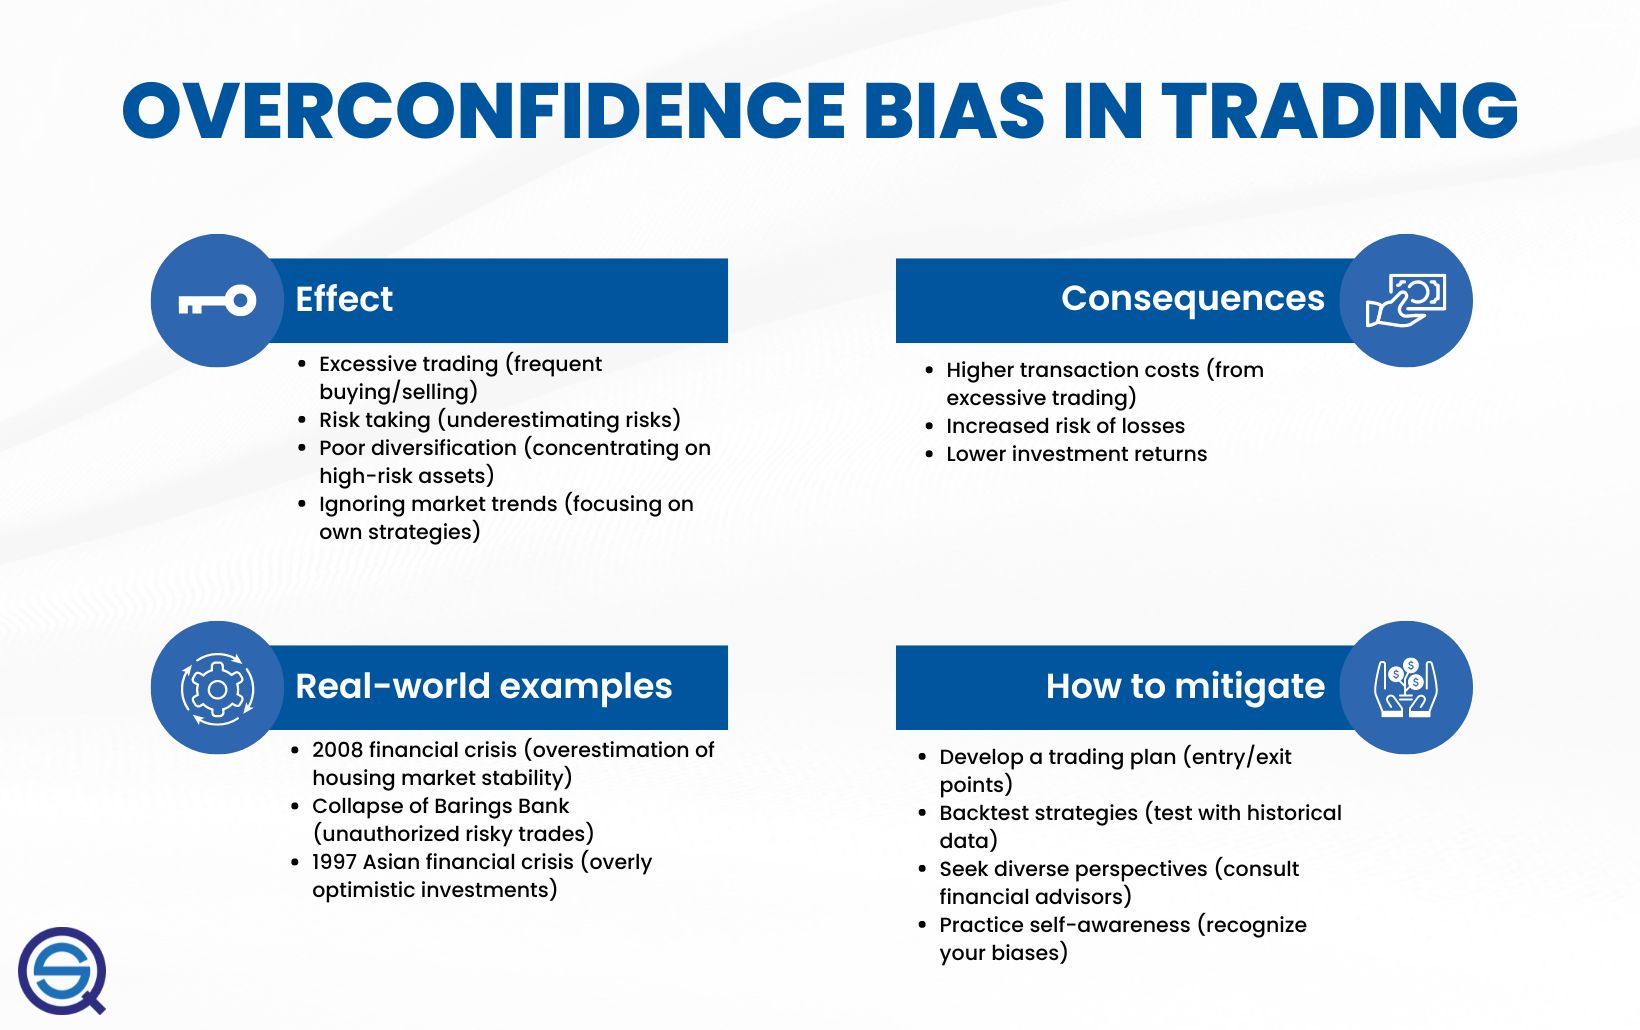
La mitigazione classica — un piano scritto, test storici e prospettive diverse — si traduce direttamente nell’architettura della ricerca. Un singolo modello può aiutare a scrivere il piano. Non può, da solo, costituire la prospettiva diversificata.
Cosa dovresti valutare confrontando l’analisi azionaria a modello singolo e multi-modello?
Dovresti valutare sei livelli di copertura, non quale interfaccia sembra più intelligente. Chiamiamolo Audit dei Punti Ciechi a Sei Livelli. È una checklist pratica per qualsiasi ticker, strumento e orizzonte temporale.
1. Ancoraggio alle fonti. Il sistema recupera filing SEC, stime e prezzi attuali oppure completa testo a partire da una data limite? Openbook Analytics osserva che i chatbot generalisti non dispongono di dati di mercato in tempo reale e non possono verificare i numeri che generano, e che il CEO di Perplexity ha riconosciuto la presenza di dati di mercato obsoleti sulla piattaforma.
2. Diversità dei modelli. Un provider significa una modalità di errore. Confrontare un output di classe GPT con Claude, Gemini o DeepSeek è utile solo se cambiano davvero prompt, dati e ruolo. Scambiare marchi usando lo stesso prompt obsoleto non è diversità.
3. Diversità dei ruoli. Un’analisi fondamentale, una lettura di mercato e struttura dei prezzi e una sovrapposizione macro intercettano errori diversi. È più simile a una riunione di ricerca che a una conversazione con un chatbot.
4. Rappresentazione dell’incertezza. Preferisci intervalli, casi alternativi e segnalazioni esplicite di “non verificato” rispetto a un unico prezzo obiettivo.
5. Persistenza. Il lavoro sulla tesi si sviluppa nell’arco di settimane. Gli strumenti che dimenticano il punto di vista alternativo di martedì scorso gonfieranno di nuovo la fiducia nella sessione successiva.
6. Costo per controllo. Se un secondo passaggio del modello è costoso o scomodo, verrà saltato proprio quando la posizione è più grande.
La rassegna FINRA sull’AI nel settore dei titoli presenta gli stessi problemi in linguaggio regolamentare: gestione del rischio di modello, spiegabilità, integrità dei dati e controlli di supervisione. Ci si aspetta che le società comprendano come un modello produce un risultato prima di farvi affidamento per flussi di lavoro di consulenza sugli investimenti ai sensi di Regulation Best Interest e FINRA Rule 2111. Gli investitori individuali non hanno un programma Rule 3110. Hanno comunque bisogno di un’abitudine equivalente: sapere ciò che il modello non può vedere.
Un paper della Harvard Business School del 2025 sul bias estero nei LLM finanziari aggiunge una modalità di errore più silenziosa. Le informazioni possono essere assenti dai dati di addestramento oppure presenti ma sottopesate. Due modelli incentrati sugli Stati Uniti possono “concordare” su un titolo dei mercati emergenti condividendo comunque la stessa lacuna.
In cosa differiscono ChatGPT, Danelfin, Perplexity e Jenova nella copertura dei punti ciechi?
Differiscono anzitutto per il fatto di produrre un punteggio, un brief citato oppure un dossier di ricerca contestabile. ChatGPT è più forte come partner di ragionamento e più debole come motore numerico. Danelfin è più forte come screener trasparente e più debole come dibattito multi-ruolo. Perplexity è più forte nel recuperare estratti citati e più debole quando tali estratti sono obsoleti. Il Fundamental Stock Analyst di Jenova è più forte quando una tesi richiede di integrare utili, valutazione e sentiment, e poi di sottoporli a verifica da parte di altri modelli o agenti specialistici.
Openbook Analytics, riassumendo test precedenti, riporta che ChatGPT ha risposto in modo errato a circa il 35% delle domande finanziarie e di investimento e che Gemini ha allucinato informazioni finanziarie con tassi fino all’88–91% in alcune valutazioni. Questi dati non sono una ragione per abbandonare i modelli linguistici. Sono una ragione per non consentire a uno di essi di chiudere una tesi.
| Funzionalità / Dimensione | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Output principale | Spiegazione in prosa | AI Score spiegabile e caratteristiche | Risposte web citate | Memo fondamentale ancorato ai filing |
| Dati di mercato live / verificati | Debole; vincolato al cutoff | Progettato per universi valutati | Citati, ma possono essere obsoleti | Filing SEC, stime, sentiment |
| Controllo incrociato multi-modello | Manuale, con più account | Singolo sistema proprietario | Ricerca multi-modello, un solo brief | Multi-provider nativo più agenti specialistici |
| Gestione dell’incertezza | Prosa sicura per impostazione predefinita | Punteggio più attribuzione delle caratteristiche | Citazioni, minore rischio residuo | Casi alternativi, disaccordo tra modelli, memoria |
| Prezzi (al 2026) | Circa $20/mese a pagamento | Non verificato in questa rassegna | Pro a $20/mese; piano gratuito | Piano gratuito; piani a pagamento da $20/mese |
| Ideale per | Revisione di concetti, stesura del caso ribassista | Screening e timing di una lista nota | Fatti rapidi con fonti | Ricerca azionaria verificata in modo incrociato |
ChatGPT
ChatGPT resta utile per tradurre una sezione di un 10-K, elencare la struttura di un settore o imporre un caso ribassista in linguaggio semplice. Un confronto tra quattro modelli del 2026 lo colloca nella categoria dei generalisti, anziché in quella dei terminali con dati live. La sua limitazione è strutturale: continuerà a scrivere un ponte dei margini pulito basandosi sulla memoria. È esattamente così che l’eccesso di fiducia entra in una nota di ricerca.
Danelfin
Danelfin è un prodotto diverso. Pubblica un AI Score anziché una chat. L’azienda afferma che le azioni statunitensi con punteggio 10/10 hanno sovraperformato il mercato con un alpha annualizzato del 21,05% dopo tre mesi dal 2017, mentre i titoli 1/10 hanno sottoperformato del 33,28%, e che una strategia AI Score ha reso il 376% dal 3 gennaio 2017 al 9 giugno 2025 contro il 166% dell’S&P 500. Le caratteristiche spiegabili sono un autentico antidoto allo scoring da scatola nera. La limitazione è complementare: un punteggio può classificare un universo senza sottoporre a stress test il rischio specifico di contabilità, segmento o politica che romperebbe questa posizione.
Perplexity
Perplexity merita il suo posto come livello di citazione. Il confronto 2026 di Helm Terminal afferma che primeggia per fatti live citati e funzionalità finanziarie, mentre Claude è in testa nella sintesi approfondita dei filing. La limitazione è quella già segnalata dal suo CEO: una citazione è aggiornata solo quanto la pagina a cui punta. Confrontare Perplexity con un flusso di lavoro nativo dei filing è più utile che considerare il numero di citazioni come prova.
Jenova Fundamental Stock Analyst
Il Fundamental Stock Analyst di Jenova è concepito come specialista azionario: utili, valutazione relativa, analisi del modello di business e dati in tempo reale su filing, stime e sentiment. Sulla piattaforma Jenova può essere rieseguito su modelli OpenAI, Anthropic, Google, DeepSeek e xAI e può affiancare altri specialisti anziché fingere di essere tutti loro. La memoria persistente mantiene sul tavolo l’ultimo disaccordo.
Qui i limiti onesti contano. Jenova non pubblica un punteggio composito di lungo periodo paragonabile allo storico 2017–2025 di Danelfin. Le esecuzioni multi-modello consumano più utilizzo di un singolo passaggio. Le risposte in conflitto aumentano il carico cognitivo e l’utente deve comunque aprire il 10-K. Sono costi reali. Sono anche i costi necessari per non confondere la fluidità con la diligenza.
In che modo l’orchestrazione multi-agente cambia la ricerca fondamentale azionaria?
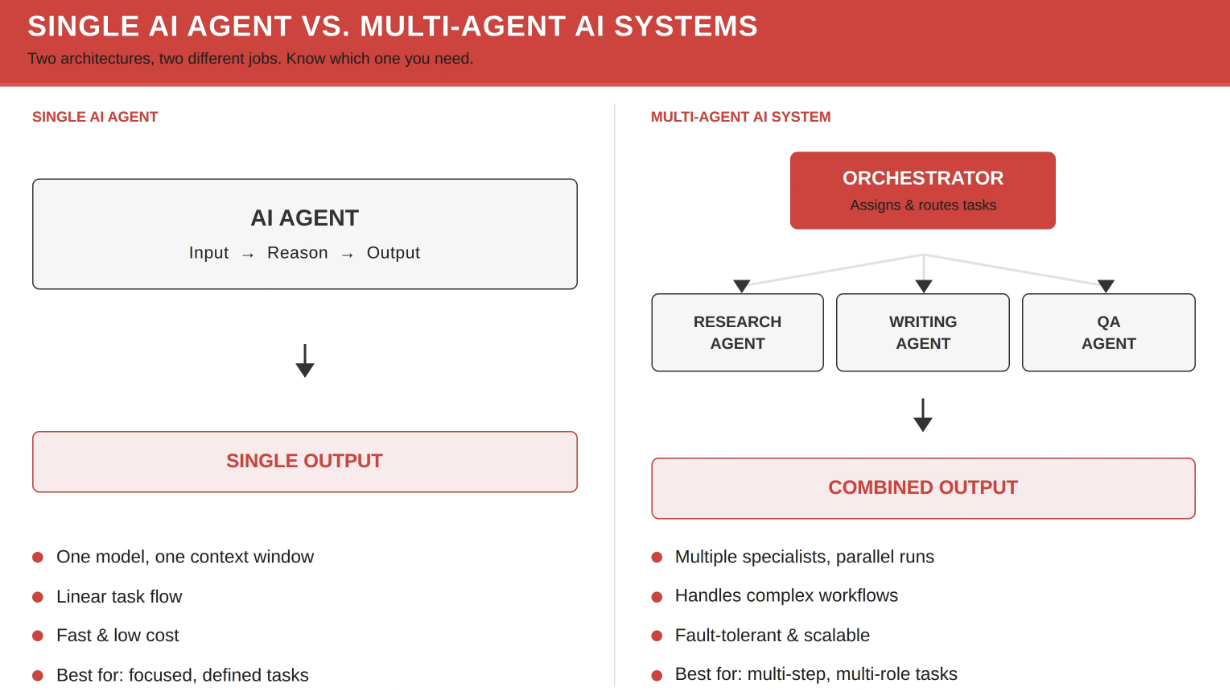
L’orchestrazione trasforma il lavoro da “chiedere a un analista” a “formare un piccolo desk e riconciliare il dossier”. Un singolo agente segue un percorso lineare: input, ragionamento, output. È rapido, economico e appropriato quando la domanda è circoscritta. Una struttura multi-agente aggiunge un orchestratore che assegna il lavoro a specialisti — ricerca, scrittura, controllo qualità — e restituisce un prodotto combinato. L’architettura è più lenta e più costosa. È anche il modo per evitare che un errore eloquente diventi l’intero memo.
Nel lavoro azionario, la suddivisione analoga non è “ricerca / scrittura / QA” in astratto. È:
- Fondamentale: qualità degli utili, economia unitaria, valutazione, allocazione del capitale
- Tecnico: struttura, volumi, momentum, livelli di invalidazione
- Macro: politica, tassi, regime cross-asset
- Portafoglio: dimensionamento, correlazione, drawdown, appartenenza dell’idea a questo portafoglio
Il Fundamental Stock Analyst di Jenova copre il primo ruolo. Abbinarlo al Technical Stock Analyst e al Macro Strategist è la versione pratica del QA multi-agente. Un modello a cui piace la storia, uno che dice che il mercato sta cedendo e uno che afferma che il percorso dei tassi distrugge il multiplo non rappresentano una query fallita. Rappresentano una riunione completa sul rischio.
Le evidenze sugli ensemble al di fuori dei chatbot azionari indicano la stessa direzione. Uno studio arXiv del 2025 sugli ensemble LLM basato sui dati Survey of Professional Forecasters ha rilevato che una combinazione di LLM ha superato la semplice media su diversi indicatori di breve termine ed è rimasta più utile quando il disaccordo tra esperti era elevato. Il meccanismo non era magico. L’ensemble ha ridotto il peso degli esperti recentemente inaccurati, si è adeguato alle revisioni ritardate e ha rifiutato di trattare ogni voce come uguale. È l’opposto di chiedere a un chatbot un prezzo obiettivo e fermarsi lì.
Il linguaggio FINRA sui modelli a scatola nera e sulla spiegabilità è rilevante anche per i flussi di lavoro retail. Se non puoi spiegare perché il caso rialzista è sopravvissuto al confronto con un secondo modello e un secondo ruolo, non disponi di un processo di investimento. Hai una trascrizione.
Gli agenti tecnici, macro e di portafoglio possono intercettare ciò che un singolo modello non vede?
Sì. Intercettano errori di categoria — errori che un modello esclusivamente fondamentale è strutturalmente poco propenso a notare. Un modello linguistico che ha appena scritto una pulita narrazione su una società composta raramente segnalerà spontaneamente che il titolo è esteso, che il settore è una pura scommessa sulla duration o che la posizione raddoppia un fattore già presente in portafoglio.
Errori tipici per ruolo:
- Ruolo tecnico. Il modello fondamentale può avere ragione sul valore ma essere in anticipo di un anno. Struttura dei prezzi, breakout falliti e divergenza dei volumi non sono note a piè di pagina. Riguardano timing e invalidazione. Il Technical Stock Analyst è costruito attorno a queste domande: struttura di mercato, momentum e rischio definito.
- Ruolo macro. Un DCF a livello di singola azione che ignora il regime di politica monetaria è un foglio di calcolo con un’ipotesi sui tassi nascosta. Il Macro Strategist è progettato per la sintesi cross-asset e l’analisi delle politiche, dove molte storie apparentemente “idiosincratiche” si interrompono davvero.
- Ruolo di portafoglio. Un’ottima idea isolata può essere un’aggiunta negativa al portafoglio. Deriva, stress e correlazione vivono al livello del portafoglio, che è il compito del Portfolio Management Strategist di Jenova.
Qui le piattaforme a punteggio singolo e i modelli chat singoli condividono un punto cieco. Il punteggio di Danelfin può essere trasparente sulle caratteristiche dietro una classifica e non dire comunque nulla sul fatto che il tuo portafoglio sia già esposto allo stesso fattore. ChatGPT può elencare rischi in astratto e non sapere comunque che possiedi già tre titoli software con la stessa sensibilità ai tassi. La revisione multi-ruolo è il modo in cui emergono questi errori.
Il limite è la correlazione della visione del mondo. Se ogni agente riceve un prompt rialzista, oppure se ogni modello viene alimentato con lo stesso post secondario di un blog, è teatro. La diversità dei ruoli funziona solo se all’agente tecnico è consentito eliminare il trade, all’agente macro è consentito rivalutare il multiplo e all’agente di portafoglio è consentito ridurre la dimensione a una quota simbolica.
Come si esegue un controllo incrociato multi-modello su una tesi azionaria?
Lo esegui come un dossier in quattro passaggi, non come una chat più lunga. L’obiettivo è creare intenzionalmente disaccordo, quindi decidere quali prove potrebbero risolverlo.
Passaggio 1 — Ancora i fatti. Chiedi al Fundamental Stock Analyst soltanto un’istantanea con fonti: ultimi due periodi riportati, guidance, mix dei segmenti, debito netto, riacquisti e multipli di valutazione che corrispondono davvero al business. In questo passaggio vieta i prezzi obiettivo.
“Utilizzando l’ultimo 10-K, 10-Q e le ultime due earnings call per [TICKER], estrai ricavi per segmento, margine lordo e operativo, FCF, debito netto e numero di azioni diluite. Cita il filing o la call per ogni cifra. Se non puoi reperire una cifra, scrivi Unverified.”
Passaggio 2 — Cambia il modello, non la domanda. Riesegui la stessa estrazione su un secondo provider. Differenze sostanziali in una cifra riportata non sono “stile”. Sono un evento di integrità dei dati. Controlla personalmente il filing prima del Passaggio 3.
Passaggio 3 — Coinvolgi gli altri ruoli. Invia lo stesso ticker al Technical Stock Analyst per i livelli di invalidazione e al Macro Strategist per l’ipotesi su tassi, FX o materie prime nascosta nel multiplo.
“Ignora il memo fondamentale rialzista. Identifica il livello di prezzo e il regime macro che renderebbero questo setup non meritevole di essere detenuto, anche se la tesi dovesse infine rivelarsi corretta.”
Passaggio 4 — Impone un dissenso scritto. Chiedi a un modello di argomentare il lato opposto con pari lunghezza e pari fonti. La nota di Lucid.now sulla finanza comportamentale evidenzia il consueto schema umano: sovrastimare la capacità previsionale, fare trading troppo spesso e concentrare l’esposizione in una storia preferita. Un dissenso obbligatorio è il modo per interrompere questo schema quando anche “l’analista” è un modello.
Con ChatGPT o Claude da soli, puoi approssimare i Passaggi 2 e 4 aprendo un secondo prodotto e incollando lo stesso estratto con fonti. Non puoi approssimare l’estrazione live dai filing o la memoria persistente attraverso le settimane, a meno che lo strumento non le possieda realmente. Con Danelfin, il Passaggio 1 è in parte automatizzato dal punteggio e dall’elenco delle caratteristiche; i Passaggi 3 e 4 richiedono comunque una superficie di ricerca separata.
I prezzi Jenova sono basati sull’utilizzo attraverso vari livelli: un piano gratuito con utilizzo limitato, poi $20, $50, $100, $200, $500 e $1.000 al mese con l’aumento delle soglie. Un controllo in quattro passaggi costa più di una chat. Per qualsiasi posizione abbastanza grande da contare, è l’errore meno costoso.
Cosa dicono i professionisti del mercato sull’eccesso di fiducia AI nella ricerca?
I professionisti che lavorano quotidianamente con questi strumenti tendono a considerare la certezza di un singolo modello come un fallimento di processo, non come una caratteristica di modelli “migliori”.
“L’errore più costoso che vediamo non è un numero sbagliato. È un numero plausibile che non ha mai incontrato un secondo modello. Quando tre provider concordano su un ponte dei margini che nessuno di loro riesce a ricondurre al 10-Q, il consenso è il segnale d’allarme. Preferiamo pubblicare un memo con due intervalli in conflitto e un elenco di elementi Unverified piuttosto che un unico prezzo obiettivo senza residui.”
“Il multi-modello non è automaticamente più sicuro. Se poni a GPT, Claude e Gemini la stessa domanda imprecisa, spesso ricevi la stessa risposta imprecisa con aggettivi diversi. La diversità deve essere progettata: ruoli diversi, estrazioni dati diverse e un’istruzione permanente a dissentire. Altrimenti hai acquistato un eccesso di fiducia correlato a tre volte il costo dei token.”
“Sul desk, il disaccordo determina cosa leggere dopo. Se fondamentale e macro sono in conflitto, analizziamo l’ipotesi sui tassi. Se fondamentale e tecnico sono in conflitto, analizziamo timing e dimensionamento. Se ogni ruolo concorda troppo rapidamente, assumiamo che il dossier sia debole. Questa abitudine è più vecchia dei LLM. I modelli rendono soltanto più facile saltarla.”
— Jenova Product Team, progettazione e valutazione di agenti azionari, lavoro pluriennale su flussi di ricerca multi-modello
Questa posizione è coerente con l’enfasi FINRA su test, piani di fallback e supervisione interfunzionale prima che gli strumenti AI influenzino la consulenza sugli investimenti. È inoltre coerente con il risultato della previsione tramite ensemble: le combinazioni aiutano maggiormente quando gli input divergono e qualcuno possiede una regola per pesarli.
Quando l’analisi a modello singolo resta la scelta migliore?
L’analisi a modello singolo resta la scelta migliore quando l’attività è delimitata, il costo dell’errore è basso e la velocità conta più del rischio residuo. Il controllo incrociato multi-modello è un sistema di controllo. Non serve un sistema di controllo per definire il ROIC o riassumere un business in due paragrafi.
Il modello singolo è generalmente sufficiente quando:
- Stai imparando un concetto, non dimensionando una posizione
- Hai già aperto il filing e ti serve soltanto un supporto di lettura
- Stai filtrando il linguaggio, non calcolando una valutazione
- Ti serve una prima bozza prima di un flusso di lavoro più lento e basato su fonti
- Chiamate incrementali al modello non cambierebbero la decisione
La guida 2026 di Openbook effettua la stessa distinzione per categoria: i chatbot generalisti sono punti di partenza, non motori di ricerca primaria. Il punteggio di Danelfin è un singolo sistema, ma specializzato; usarlo come screener e poi fermarsi è comunque una decisione a modello singolo se nessuno sottopone il titolo a verifica. Perplexity è il passaggio singolo corretto quando servono in pochi minuti fonti citate e verificherai tu stesso la fonte primaria.
La modalità di errore consiste nell’usare il passaggio economico per la decisione costosa. L’eccesso di fiducia non è causato dall’AI. È causato dal terminare il processo alla prima risposta coerente. Il riepilogo 2025 di Sidley sulle linee guida delle autorità di regolamentazione finanziaria statunitensi sottolinea che le società devono già trattare l’AI come un’attività supervisionata, non come un oracolo. Gli investitori privati dovrebbero adottare lo spirito di questa regola anche quando nessun esaminatore lo chiederà.
Una regola decisionale compatta: se avere torto modificherebbe la dimensione della posizione, usa almeno due modelli e due ruoli. Se avere torto cambierebbe solo una frase nelle tue note, è sufficiente un buon modello.
In che modo regolamentazione e rischio di modello dovrebbero modellare il tuo flusso di ricerca AI?
Dovrebbero obbligarti a documentare ciò che il modello non ha visto, non soltanto ciò che ha detto. La discussione FINRA sull’AI è scritta per broker-dealer, ma i temi di controllo sono trasferibili. Gestione del rischio di modello, governance dei dati, spiegabilità e supervisione esistono perché strumenti dall’apparenza autonoma falliscono in modi correlati.
Per un processo di ricerca individuale, i controlli trasferibili sono semplici:
- Conserva la fonte primaria nel dossier. Se il modello non può indicare il 10-K, 10-Q, 8-K o il transcript della call, l’affermazione è una bozza.
- Registra il disaccordo. Un registro di una riga — “Claude vede compressione, Gemini no, pagina 37 del 10-Q irrisolta” — è più utile di un caso rialzista rigenerato.
- Separa il consiglio dalla spiegazione. I chatbot non sono un motore di adeguatezza. FINRA osserva che gli strumenti AI che generano raccomandazioni rientrano in Regulation BI e Rule 2111 per le società aderenti. Gli utenti retail dovrebbero trattare l’output del modello come analisi, non come una raccomandazione personalizzata.
- Presumi un bias condiviso finché non sia dimostrato il contrario. Il risultato sul bias estero della HBS ne è un esempio. Due modelli possono ignorare lo stesso fatto non statunitense. Un filing locale, una fonte in seconda lingua o uno specialista umano sono la vera diversificazione.
- Preferisci strumenti che possano dire Unverified. La falsa precisione è il segnale rivelatore. Un sistema che completa sempre il paragrafo non è “più analitico”. È meno supervisionato.
Nulla di tutto questo richiede un budget istituzionale. I terminali di classe Bloomberg appartengono ancora a un’altra fascia di costo — Openbook cita prezzi Bloomberg tipici superiori a $25.000 all’anno. Il controllo che riduce davvero l’eccesso di fiducia è meno costoso: un secondo modello, un secondo ruolo e una regola secondo cui il consenso senza fonti non aumenta la dimensione.
L’analisi azionaria a modello singolo è uno strumento di stesura. Il controllo incrociato multi-modello e multi-ruolo è uno strumento per individuare i punti ciechi. Usa il primo per iniziare il dossier. Usa il secondo per decidere se il dossier è concluso.
Riferimenti
- Openbook Analytics — Migliori strumenti AI per l’analisi azionaria nel 2026
- Investopedia — Finanza comportamentale: bias, emozioni e comportamento degli investitori
- Preprints.org — Eccesso di fiducia e bias di conferma nel trading
- ResearchGate — Eccesso di fiducia degli investitori nell’era dell’AI: processo decisionale umano vs. algoritmico
- SSRN — Comportamento degli investitori nei mercati azionari: l’emergere dell’AI e dell’eccesso di fiducia algoritmico
- Investor.gov — Intelligenza artificiale (AI) e frode negli investimenti: avviso agli investitori
- FINRA — Intelligenza artificiale nel settore dei titoli: sfide principali e considerazioni regolamentari
- Harvard Business School — Quando i LLM vanno all’estero: bias internazionale nell’analisi finanziaria AI
- Danelfin — AI Stock Picker e metodologia AI Score
- AI Business Weekly — Guida ai prezzi AI 2026: ChatGPT, Claude e Gemini
- Perplexity — Prezzi per privati e imprese
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity per la ricerca azionaria
- arXiv — Gli LLM possono migliorare la combinazione delle previsioni degli esperti?
- Lucid.now — AI nelle decisioni finanziarie: approfondimenti comportamentali
- Sidley Austin — Intelligenza artificiale: linee guida delle autorità statunitensi di regolamentazione di titoli e materie prime