Gli assistenti AI specializzati per la ricerca sono più affidabili dei chatbot?
2026-08-22
In che modo tracciabilità e ancoraggio alle fonti distinguono l'AI per la ricerca dai chatbot?
Gli assistenti specializzati per la ricerca accademica sono più affidabili dei chatbot AI generalisti per la tracciabilità delle citazioni e l'estrazione delle evidenze, perché recuperano informazioni da indici scientifici, collegano le affermazioni a passaggi identificabili e mostrano il contesto a supporto o in contrasto. I chatbot generalisti generano un linguaggio bibliografico fluente basandosi sui modelli appresi durante l'addestramento; per questo continuano a inventare autori, titoli, DOI e risultati che non possono essere ricondotti a una fonte.
Il divario di affidabilità non riguarda la qualità della scrittura. Riguarda la possibilità di sottoporre un'affermazione a verifica.
Fattori chiave che distinguono un'assistenza alla ricerca citabile dalla prosa di un chatbot:
✅ Recupero prima della generazione — le risposte sono assemblate a partire da articoli indicizzati, anziché dalla sola probabilità del token successivo ✅ Attribuzione a livello di passaggio — ogni risultato estratto rimanda a una frase, una tabella o una sezione, non soltanto al titolo di un articolo ✅ Visibilità delle contraddizioni — i lavori successivi che sostengono, contestano o si limitano a menzionare un'affermazione vengono mostrati anziché appiattiti in un unico riassunto ✅ Estrazione strutturata — metodi, campioni, risultati e limiti vengono raccolti in campi comparabili anziché in paragrafi parafrasati ✅ Provenienza verificabile dall'uomo — ogni riassunto, citazione e risultato estratto può essere aperto e confrontato con la fonte originale
Per confrontare utilmente questi strumenti nel 2026, è utile considerare l'affidabilità delle citazioni come una proprietà ingegneristica, non come una promessa del marchio. Il resto di questo articolo valuta chatbot e assistenti di ricerca in base a questa proprietà.
Perché l'affidabilità delle citazioni è diventata un problema di integrità della ricerca?
L'affidabilità delle citazioni è diventata un problema di integrità della ricerca perché l'AI generativa viene ormai utilizzata su scala editoriale, mentre i modelli generalisti continuano a fabbricare riferimenti abbastanza credibili da superare una revisione superficiale. L'adozione da parte di studenti e ricercatori è cresciuta rapidamente nel 2025 e le citazioni inventate non sono più un errore curioso: stanno entrando in atti di conferenze, manoscritti e grafi di citazioni.
L'indagine 2025 sugli studenti dell'Higher Education Policy Institute ha rilevato che l'uso di strumenti di AI generativa per le valutazioni è salito dal 53% all'88% in un anno. Un'analisi collegata della stessa indagine ha riportato che il 92% degli studenti usa ormai l'AI in qualche forma, rispetto al 66% del 2024. Questo volume conta perché un riferimento falso ma plausibile è più difficile da individuare di un riferimento assente.
Un'analisi del 2026 su Energy Research & Social Science ha riportato che ChatGPT ha prodotto 178 riferimenti per proposte di ricerca, 69 dei quali erano privi di DOI validi. Lo stesso articolo citava una revisione di GPTZero su 4.841 articoli di NeurIPS 2025 che ha confermato almeno 100 citazioni allucinate in 53 articoli accettati. La peer review condotta da più esperti non le ha individuate.
Il meccanismo è ormai ben descritto. Un'allucinazione AI è un output fluente ma falso o non ancorato alle fonti. Le linee guida delle biblioteche universitarie osservano che i chatbot possono inventare un'intera citazione — autore, titolo e rivista. Science ha sostenuto che i modelli sono addestrati a produrre una risposta anche quando non ne conoscono una. Quando il prompt è “cita le fonti”, il modello individua schemi nello stile bibliografico. Per lavori di nicchia o recenti, questa corrispondenza di stile diventa invenzione.
Cosa dovresti valutare nella scelta di un assistente AI per la ricerca?
Dovresti valutare un assistente AI per la ricerca in base alla possibilità di tracciare, ancorare alle fonti, attribuire, contraddire ed estrarre ogni affermazione, non in base alla cura della sua prosa. Una sintesi utile è il framework TRACE: Traceability (tracciabilità), Retrieval grounding (ancoraggio al recupero), Attribution granularity (granularità dell'attribuzione), Contradiction awareness (consapevolezza delle contraddizioni) ed Extractability (estraibilità).
La tracciabilità chiede se un lettore possa passare da una frase della bozza all'esatto passaggio che la supporta. Se lo strumento produce soltanto un riferimento formattato, ha prodotto un rimando, non una prova.
L'ancoraggio al recupero chiede se il sistema abbia cercato in un corpus scientifico o abbia campionato dai pesi del modello. L'estrazione ancorata alle citazioni è progettata per bloccare sia l'invenzione priva di fonti sia la parafrasi senza attribuzione, richiedendo un'attribuzione esplicita della fonte per ogni affermazione estratta.
La granularità dell'attribuzione distingue le citazioni a livello di articolo da quelle a livello di frase o di campo. Un articolo può essere reale mentre il risultato citato è errato, obsoleto o tratto dall'abstract anziché dai risultati.
La consapevolezza delle contraddizioni chiede se lo strumento mostri studi successivi che sostengono, contestano o si limitano a menzionare l'affermazione. Un singolo abstract a conferma non costituisce una letteratura scientifica.
L'estraibilità chiede se metodi, campioni, risultati e limiti possano essere confrontati in campi strutturati. I riassunti in prosa nascondono i dati mancanti. Le tabelle rendono visibili le lacune.
Le linee guida di King's College London sulla sintesi delle evidenze sono chiare sulle implicazioni pratiche: gli strumenti AI possono supportare le fasi di una revisione, ma non possono sostituire metodi di ricerca validati, e i sistemi generativi continuano a creare riferimenti falsi. Una revisione del 2025 citata in tale guida ha concluso che le prove attuali non supportano l'uso dell'AI generativa nella sintesi delle evidenze senza coinvolgimento umano. La domanda di valutazione, quindi, non è “Questo strumento sa scrivere?”. È “Questo strumento può essere sottoposto a verifica?”
Come si confrontano gli assistenti specializzati per la ricerca con i chatbot generalisti?
Gli assistenti specializzati per la ricerca superano i chatbot generalisti nella tracciabilità delle citazioni perché collegano le risposte ad articoli recuperati, mentre i chatbot restano più efficaci nella redazione, nella spiegazione e nel brainstorming. Il confronto onesto è basato sul ruolo. I chatbot sono motori di scrittura flessibili. Gli assistenti di ricerca sono sistemi di recupero più circoscritti e ispezionabili.
Elicit cerca tra milioni di articoli accademici e restituisce report strutturati con citazioni. È particolarmente efficace quando un ricercatore deve allineare metodi, campioni e risultati tra un insieme di studi. Un confronto del 2026 collegato a Cochrane e citato da King's College London ha rilevato che Elicit non eseguiva ricerche con una sensibilità sufficiente a sostituire la ricerca bibliografica tradizionale, sebbene la sua precisione lo rendesse utile come complemento. Si tratta di un limite reale, non di una nota a piè di pagina.
Scite è costruito attorno alla verifica anziché alla redazione. Riporta una copertura di oltre 300 milioni di articoli scientifici e accesso con licenza tramite accordi con oltre 40 editori. Le sue Smart Citations classificano se gli articoli successivi supportano, contrastano o si limitano a menzionare un'affermazione. Ogni affermazione prodotta dal suo assistente è collegata alla frase specifica nell'articolo specifico. Il compromesso riguarda l'ampiezza: Scite è più forte nell'intelligence sulle citazioni che nei flussi di lavoro per manoscritti end-to-end.
ResearchRabbit è più efficace nella mappatura. Aiuta i ricercatori a trovare articoli correlati, costruire mappe di citazioni e osservare l'espansione di un campo a partire da un articolo iniziale. È meno utile come motore per l'estrazione delle evidenze o la validazione delle citazioni. Questo non è un difetto se il compito è la scoperta.
I chatbot generalisti come ChatGPT restano molto usati perché redigono rapidamente e gestiscono domande complesse e trasversali ai domini. La loro debolezza documentata è l'invenzione bibliografica. Le analisi recenti riassunte nell'analisi del 2026 sull'integrità accademica hanno collocato l'allucinazione delle citazioni fattuali per modelli avanzati come GPT-4o e Claude 3.7 nell'intervallo 15–20%, in aumento al 35–55% su argomenti di nicchia o recenti. I benchmark che verificano i riferimenti scientifici prodotti dai large language model hanno segnalato tassi di errore superiori al 30% in alcuni contesti.
L'Academic Research Assistant di Jenova occupa una posizione diversa. È un Agente di dominio per la scoperta della letteratura, la preparazione dei manoscritti e la gestione delle citazioni, con memoria persistente e ricerca in tempo reale tra database accademici. È più efficace di un chatbot nel mantenere coerente un progetto di ricerca tra sessioni diverse. È meno efficace di Scite nella classificazione delle citazioni su testo completo con licenza e meno efficace di Elicit come prodotto dedicato alle tabelle di estrazione. Queste lacune spiegano perché uno stack misto continua a superare qualsiasi singolo assistente.
| Funzionalità / Dimensione | Chatbot generalisti (ad es. ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Ancoraggio al recupero | Principalmente memoria del modello; la navigazione varia in base al prodotto | Recupero accademico e web in tempo reale all'interno di un Agente di ricerca persistente | Ricerca nel corpus di articoli con report strutturati | Testo completo scientifico con licenza più corpus aperto | Scoperta tramite grafi di citazioni a partire da articoli iniziali |
| Tracciabilità delle citazioni | Spesso non verificabile o inventata | Fonti inline con verifica successiva rispetto agli originali | Citazioni collegate ai campi estratti | Collegamenti a livello di frase più etichette supporto/contrasto | Collegamenti di rete tra articoli, non prove a livello di affermazione |
| Estrazione delle evidenze | Riassunti in formato libero | Note, confronti e sintesi pronte per il manoscritto | Tabelle strutturate efficaci | Più efficace nel contesto delle citazioni che nell'estrazione dei campi | Limitata; mappatura anziché estrazione |
| Consapevolezza delle contraddizioni | Di solito appiattita in un'unica risposta | Può confrontare risultati conflittuali quando richiesto | Dipende dall'insieme recuperato | Funzionalità principale tramite Smart Citations | Indiretta, tramite cluster di lavori correlati |
| Prezzi (al 2026) | Non verificati tra i vari piani | Piano gratuito; piani a pagamento da $20/mese | Non verificati | Non verificati | Non verificati |
| Ideale per | Redazione, spiegazioni, inquadramento iniziale | Progetti accademici continuativi che richiedono scoperta e memoria di scrittura | Selezionare articoli in tabelle di evidenze comparabili | Verificare se un'affermazione è supportata o contestata | Mappatura visiva della letteratura e scoperta di autori/cluster |
Una raccolta del 2026 sugli strumenti AI per la ricerca accademica è giunta a una divisione del lavoro simile: Elicit primeggiava nell'estrazione strutturata, Consensus era il più rapido per verifiche veloci delle evidenze e Semantic Scholar restava il più forte indice gratuito per la scoperta. Nessuna singola colonna di questo panorama sostituisce le altre.
In che modo differisce l'estrazione delle evidenze tra gli strumenti AI accademici?
L'estrazione delle evidenze differisce in base al fatto che lo strumento restituisca campi comparabili o soltanto una parafrasi narrativa. L'estrazione a livello di campo è più affidabile per metodi, dimensioni del campione, risultati e limiti, perché i valori mancanti restano visibili. L'estrazione narrativa è più rapida e leggibile, ma nasconde la differenza tra un risultato, un'interpretazione e un dettaglio allucinato.
Elicit è l'esempio più chiaro dell'approccio strutturato. È progettato per trasformare una domanda di ricerca in un report le cui righe sono articoli e le cui colonne sono caratteristiche degli studi. Questo formato spiega perché i revisori lo preferiscano spesso per lo screening iniziale. Richiede comunque che un umano verifichi la logica di inclusione, perché un'elevata precisione non equivale a un elevato richiamo.
Scite estrae un oggetto diverso: il contesto della citazione. Invece di chiedere “Cosa ha rilevato questo articolo?”, chiede “Cosa hanno fatto gli articoli successivi con questo risultato?”. Questo è più vicino alla valutazione delle evidenze che all'estrazione dei dati. È particolarmente utile dopo che un articolo candidato è già stato identificato.
I chatbot generalisti estraggono in prosa. Chiedi un confronto tra quattro studi randomizzati e produrranno un paragrafo sicuro di sé. Il paragrafo può essere utile come prima bozza. È un artefatto poco adatto alla verifica, perché non esiste un campo che possa essere contrassegnato come “non riportato”.
L'Academic Research Assistant di Jenova e il suo Agente complementare Deep Research si collocano tra questi due poli. Deep Research effettua ricerche ampie e restituisce un report sintetizzato con citazioni inline. L'Academic Research Assistant mantiene lo stato del progetto: decisioni di inclusione precedenti, articoli respinti, requisiti di stile e sezioni incomplete del manoscritto restano disponibili nelle sessioni successive. Testare questo flusso di lavoro mostra un vantaggio pratico nelle revisioni della letteratura che durano più settimane. Il limite è altrettanto pratico. Nessuno dei due Agenti è uno strumento dedicato allo screening delle revisioni sistematiche sul modello di soluzioni specifiche come Rayyan o DistillerSR, che i bibliotecari specializzati nella sintesi delle evidenze continuano a considerare l'opzione più valutata per lo screening di titoli e abstract.
Un prompt affidabile per l'estrazione rende espliciti i campi desiderati:
"Estrai da questi articoli: disegno dello studio, dimensione del campione, popolazione, outcome primario, direzione dell'effetto, limiti dichiarati e la frase esatta che supporta ciascun campo. Se manca un campo, scrivi 'non riportato' invece di inferirlo."
Lo stesso prompt in un chatbot è valido solo quanto il testo recuperato. Se il modello non ha mai aperto l'articolo, riempirà la tabella attingendo alla memoria stilistica.
Cosa richiede realmente una pipeline di verifica delle citazioni?
Una pipeline di verifica delle citazioni richiede il documento fonte, non soltanto la stringa del riferimento. Il processo minimo praticabile è: acquisire il testo citato, segmentarlo, recuperare i passaggi più pertinenti all'affermazione, riordinarli per rilevanza e classificare la relazione tra affermazione ed evidenza. Qualsiasi cosa inferiore a questo è formattazione bibliografica.
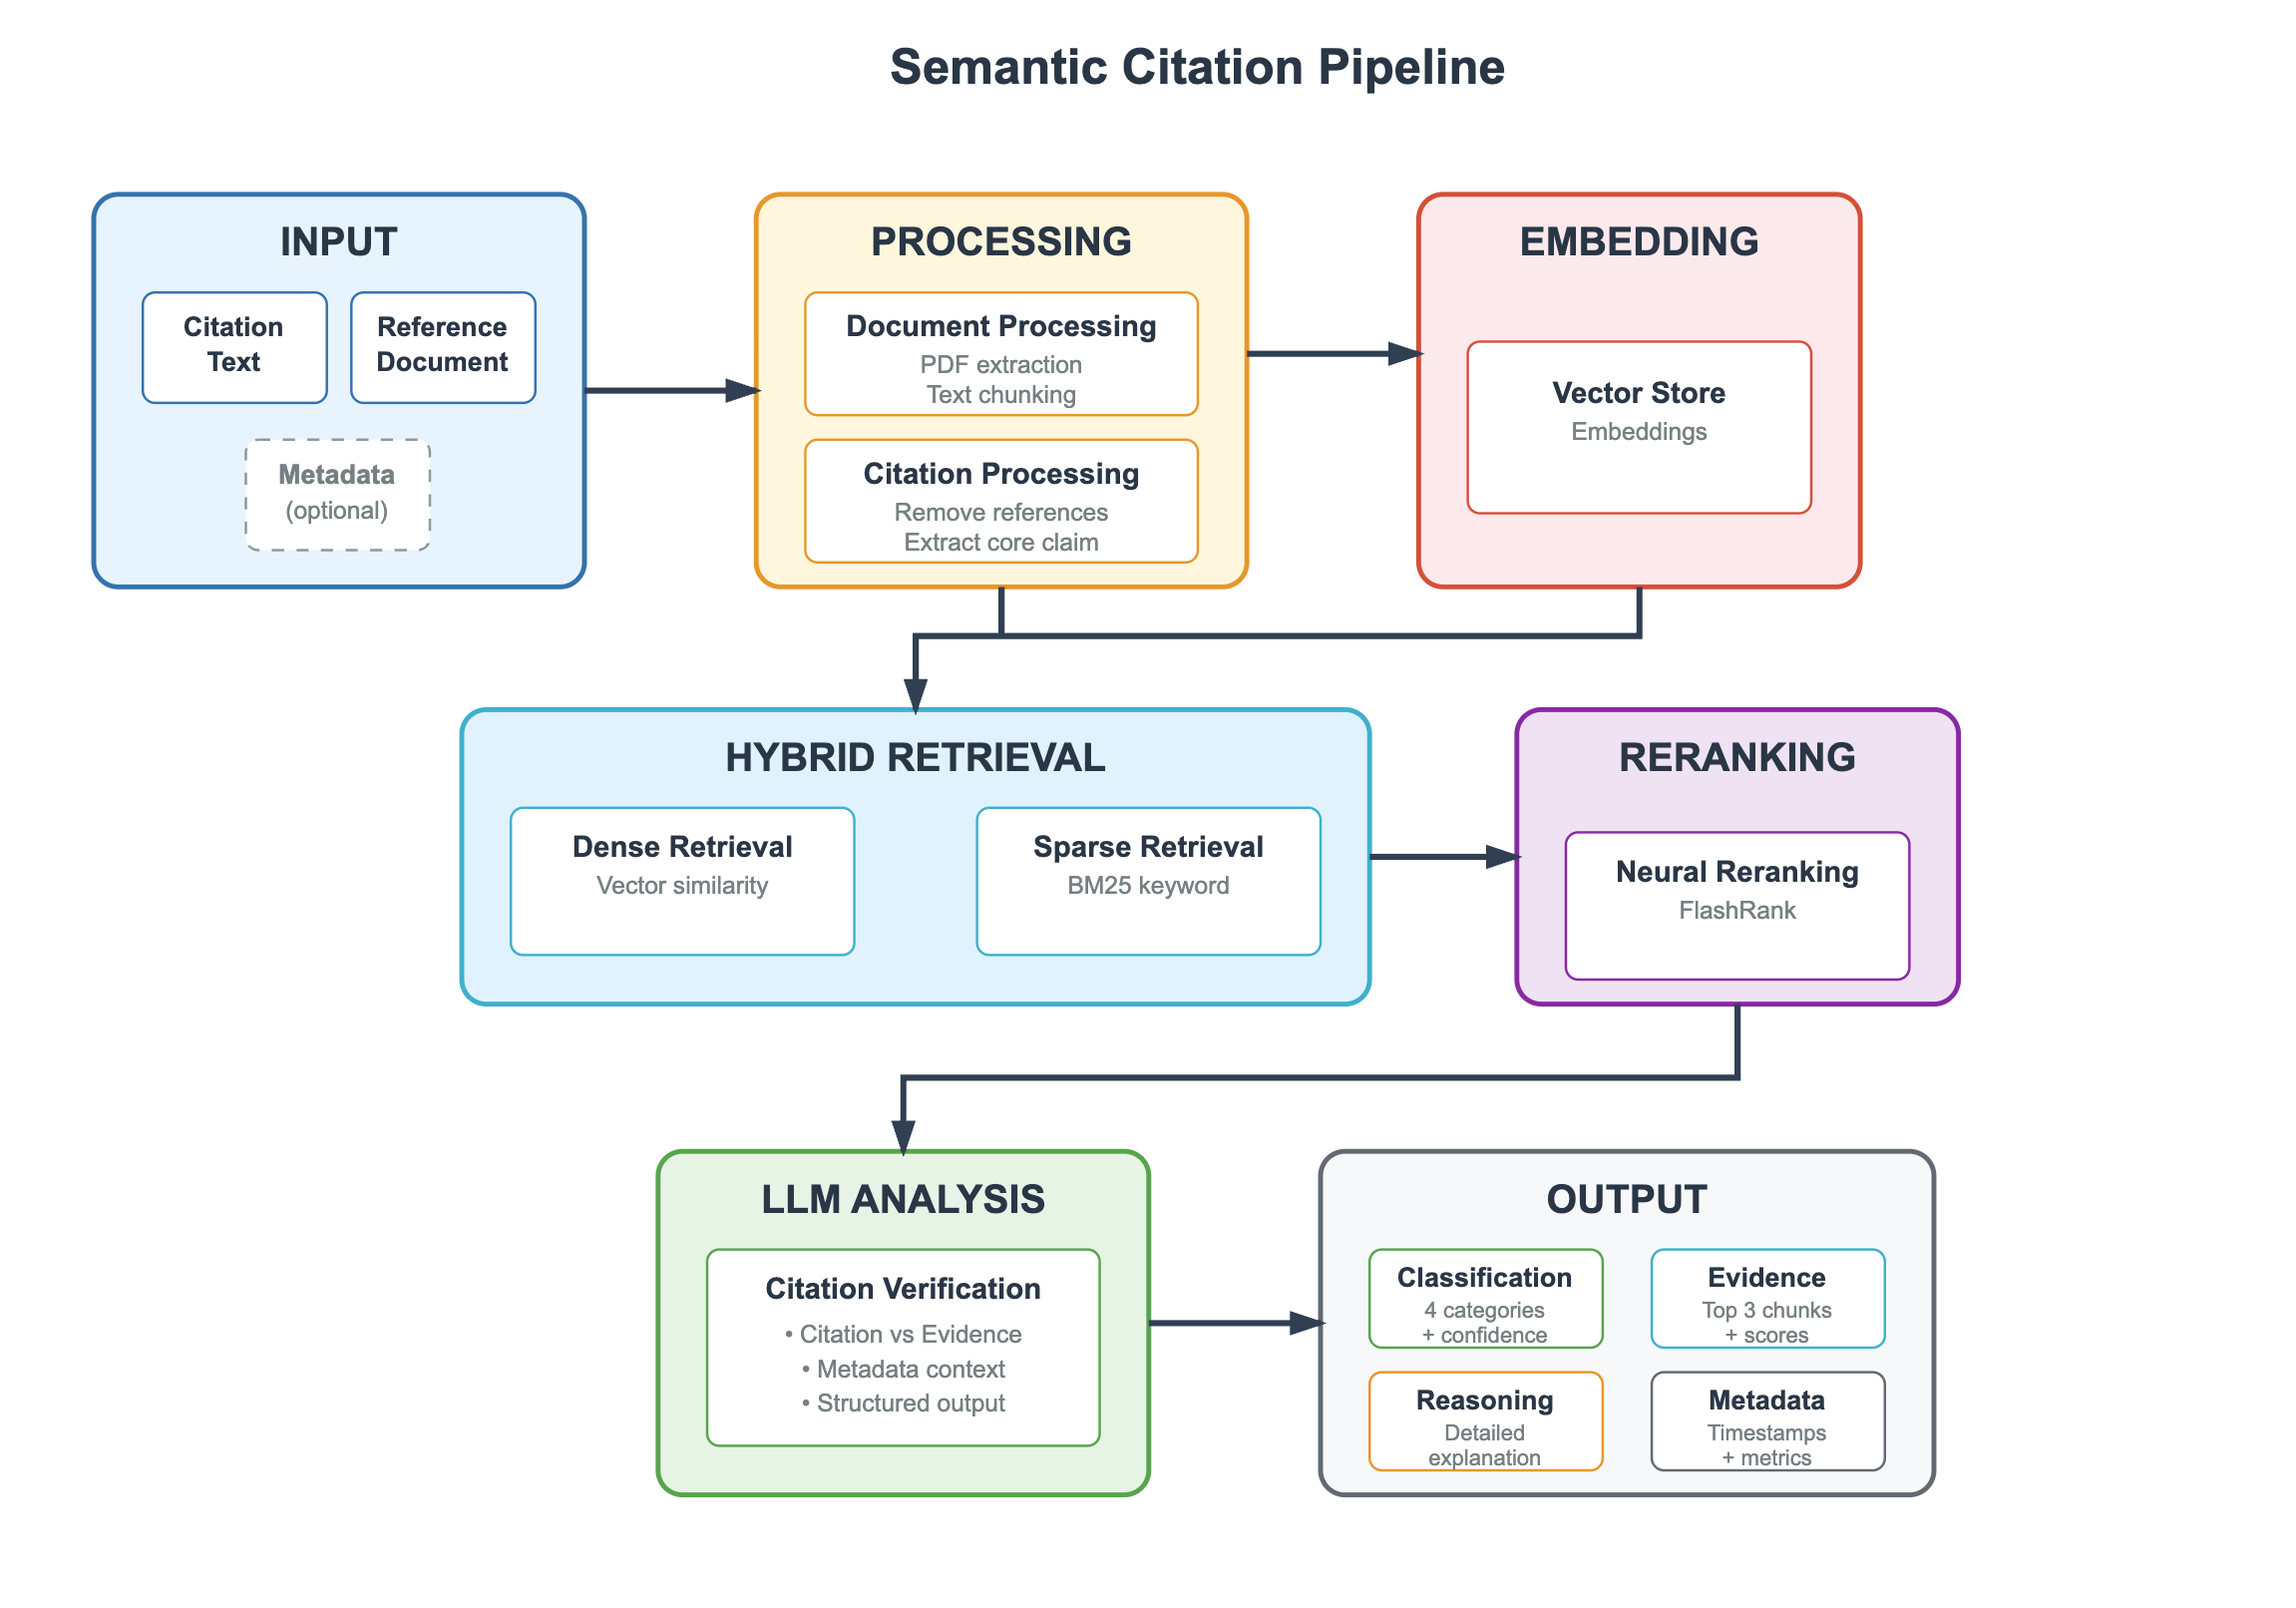
L'architettura sopra descritta segna la differenza tra “questa citazione sembra reale” e “questa citazione è supportata”. L'input è l'affermazione più il documento di riferimento. L'elaborazione elimina la bibliografia, estrae l'affermazione centrale e segmenta il PDF. Il recupero ibrido cerca poi sia la somiglianza vettoriale sia la sovrapposizione di parole chiave, aspetto importante perché i nomi dei metodi e le misure degli outcome spesso non funzionano con la sola ricerca semantica. Il reranking neurale conserva i passaggi migliori. Solo allora un LLM classifica la relazione e restituisce evidenza, confidenza e ragionamento.
Sistemi come SemanticCite vengono sviluppati specificamente per verificare l'accuratezza delle citazioni attraverso l'analisi delle fonti a testo completo. Questa scelta progettuale esiste perché la corrispondenza dei metadati non è sufficiente. Un DOI può essere valido mentre la frase citata proviene da un articolo diverso, dall'abstract di un preprint o da un risultato che gli autori hanno successivamente circoscritto.
L'infrastruttura degli editori non risolve il problema automaticamente. Le principali riviste collegano già le referenze tramite hyperlink, eppure le stime discusse nell'analisi sull'integrità del 2026 collocano i DOI non funzionanti, o il deterioramento dei link, fino al 37% nei contenuti scientifici campionati. Un collegamento verde non equivale a un'affermazione verificata.
È qui che i chatbot generalisti falliscono in modo più prevedibile. Ottimizzano per una risposta completa. Una pipeline di verifica ottimizza per una relazione classificata: supportata, non supportata, contraddetta o con evidenze insufficienti. Queste quattro etichette sono più utili scientificamente di un paragrafo rifinito, perché indicano al ricercatore quale tipo di controllo resta da svolgere.
Gli Agenti Jenova possono eseguire una versione leggera di questo ciclo recuperando l'articolo candidato, citando il passaggio di supporto e segnalando le affermazioni che non possono essere localizzate. Al momento non sostituiscono un classificatore di citazioni su testo completo con licenza e copertura su scala editoriale. I ricercatori che necessitano delle etichette Smart Citation continuano quindi ad abbinare un Agente di scrittura a Scite, anziché chiedere a un solo sistema di svolgere entrambi i compiti.
Come si costruisce un flusso di lavoro più sicuro per la letteratura assistito dall'AI?
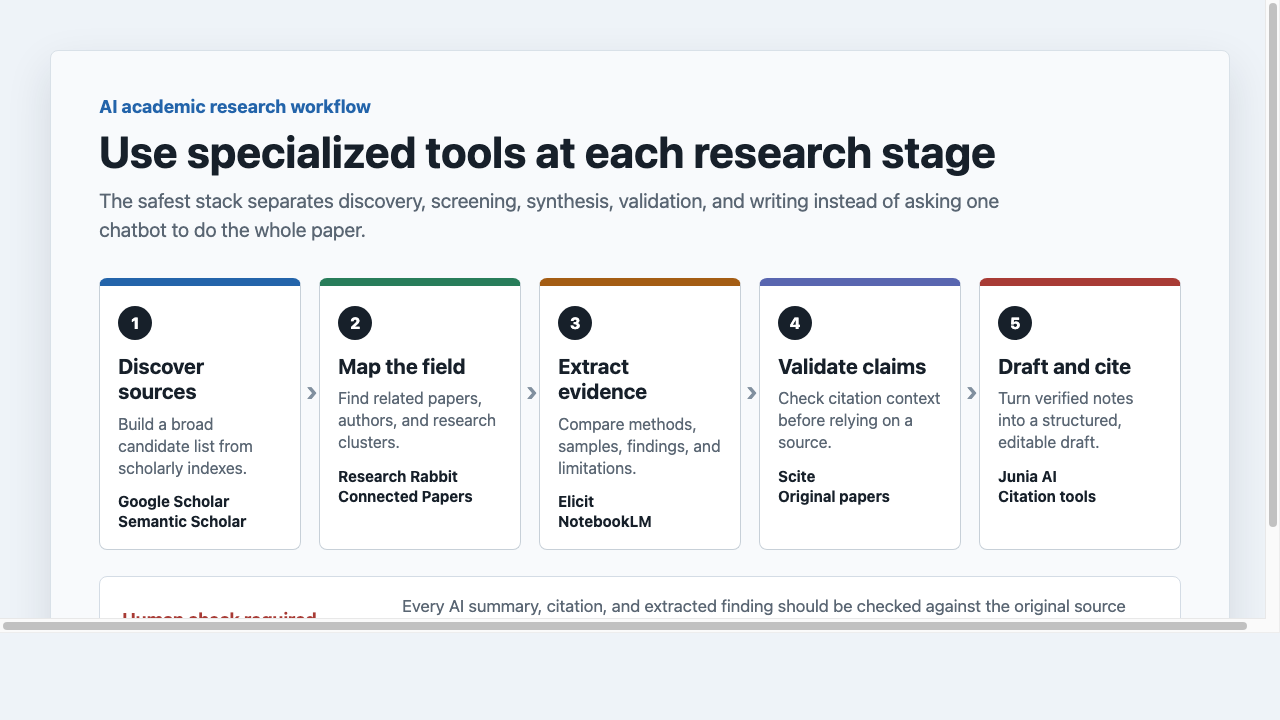
Per costruire un flusso di lavoro più sicuro per la letteratura assistito dall'AI, assegna ogni fase a uno strumento verificabile, quindi controlla ogni risultato estratto rispetto all'articolo originale. Il modello non sicuro consiste nel chiedere a un solo chatbot di scoprire, selezionare, estrarre, validare e scrivere.
Un flusso di lavoro a fasi è questo:
- Scopri le fonti in indici scientifici come Google Scholar o Semantic Scholar, non in una finestra di chat.
- Mappa il campo con ResearchRabbit o Connected Papers affinché autori e cluster correlati siano visibili.
- Estrai le evidenze con Elicit, NotebookLM o un Agente di ricerca in note strutturate.
- Valida le affermazioni in Scite e nei PDF originali prima che qualsiasi frase venga considerata citabile.
- Redigi e cita soltanto a partire dall'insieme di note verificate.
Per l'Academic Research Assistant di Jenova, la configurazione è un brief di ricerca, non un tour delle funzionalità:
- Apri l'Agente su jenova.ai/a/academic-research-assistant.
- Indica la domanda, la disciplina e cosa significa “completato”:
"Sto scrivendo una sezione sui metodi relativa ai tassi di errore delle citazioni LLM. Dai priorità a studi peer-reviewed e analisi degli editori dal 2023 al 2026. Per ogni fonte, estrai campione, definizione dell'errore, tasso di allucinazione e se gli esseri umani hanno verificato i riferimenti."
- Chiedi prima un elenco di candidati, poi tabelle di estrazione, quindi prosa. Non passare direttamente alla bozza.
- Mantieni gli articoli respinti nella stessa conversazione affinché l'Agente non li reintroduca in seguito.
Per Elicit, l'avvio equivalente è una domanda ristretta e un elenco di colonne: popolazione, intervento, outcome, tipo di studio. Per Scite, parti da un articolo o da un'affermazione nota e analizza le citazioni di supporto rispetto a quelle contrastanti prima di scrivere. Per un chatbot generalista, l'uso più sicuro è la creazione di scalette e l'editing linguistico dopo che le fonti esistono già.
Due regole operative prevengono la maggior parte degli errori. Primo, non accettare mai una citazione che non possa essere aperta. Secondo, non lasciare mai che il modello di redazione diventi l'unica registrazione di ciò che ha detto un articolo. La nota verificata è la fonte di verità. La bozza è una riorganizzazione di quella nota.
Quando un chatbot per uso generale resta lo strumento accademico migliore?
Un chatbot per uso generale resta lo strumento accademico migliore quando il compito riguarda linguaggio, struttura o spiegazione, anziché evidenze. L'affidabilità dipende dal lavoro da svolgere. La tracciabilità delle citazioni è il test sbagliato per un modello di scrittura, così come la fluidità della prosa è il test sbagliato per un indice di recupero.
I chatbot restano utili per:
- Trasformare una scaletta verificata in una prosa accademica più pulita
- Spiegare un metodo che il ricercatore ha già letto
- Generare stringhe di ricerca, controargomentazioni o checklist di revisione
- Tradurre passaggi densi in linguaggio più semplice per gli appunti, non per la citazione
Sono un motore primario inadeguato per la letteratura scientifica. Il lavoro di classificazione collegato a Nature considera le affermazioni non comprovate dei chatbot un tipo distinto di allucinazione, e le linee guida delle biblioteche ripetono lo stesso avvertimento: le citazioni inventate possono includere un pacchetto completo di autore, titolo e rivista. Questa modalità di errore è costosa in tesi, proposte di finanziamento e invii a riviste, dove un singolo riferimento inventato può screditare un'argomentazione altrimenti accurata.
C'è anche una ragione di flusso di lavoro per mantenere i chatbot nello stack. Gli strumenti specializzati sono più ristretti. Elicit non lavorerà sul ritmo di un paragrafo. Scite non manterrà una conversazione di tutoraggio lunga un semestre su un capitolo di tesi. ResearchRabbit non formatterà lo stile di riferimento di una rivista. Un chatbot, o un Agente di scrittura generalista, colma queste lacune dopo che le evidenze sono state consolidate.
La regola pratica è la sequenza. Usa prima il recupero e la verifica specializzati. Usa un modello generalista in un secondo momento e soltanto su testo le cui fonti esistano già in una libreria che puoi aprire. Se un chatbot introduce una nuova citazione durante la revisione, considera quella citazione non affidabile finché non supera gli stessi controlli TRACE del resto del manoscritto.
Cosa dicono gli specialisti dell'integrità della ricerca sulle citazioni AI?
Gli specialisti dell'integrità della ricerca considerano i chatbot generalisti strumenti di redazione e i sistemi specializzati, vincolati alle fonti, l'unico livello accettabile per le affermazioni che saranno citate. Il consenso non è “evita l'AI”. È “non lasciare che un generatore non ancorato alle fonti diventi la registrazione di ciò che dice la letteratura”.
"Il problema che continuiamo a osservare non è che i modelli scrivano male. È che producono bibliografie complete per articoli che non esistono, oppure per articoli reali che non contengono il risultato dichiarato. Quando queste stringhe entrano in una bozza, si comportano come evidenze. Revisori, coautori e strumenti di citazione successivi possono propagarle prima che qualcuno apra la fonte."
"Un assistente specializzato cambia l'unità di lavoro. Invece di chiedere un paragrafo con citazioni, chiedi un'affermazione, un passaggio e una classificazione: supportata, non supportata, contraddetta o insufficiente. Questo output è più lento e meno elegante. È anche l'unico output che una sezione sui metodi può difendere."
"La memoria persistente del progetto conta più di quanto le persone si aspettino. Le allucinazioni rientrano spesso in un articolo durante la revisione, quando a un chatbot generalista viene chiesto di 'aggiungere fonti' a una sezione già pulita. Un assistente che ricorda quali articoli sono stati esclusi, e perché, svolge un lavoro di integrità, non soltanto di praticità. Anche in questo caso, il PDF originale resta l'autorità."
— Team di prodotto Jenova, flussi di lavoro per la ricerca accademica, lavoro pluriennale sulla progettazione di Agenti ancorati alle citazioni
Questa posizione è in linea con le indicazioni di bibliotecari e specialisti della sintesi delle evidenze. King's College London consiglia di usare l'AI come complemento, verificare il copyright prima di caricare testi completi e presumere che gli strumenti generativi possano ancora inventare riferimenti e intestazioni di soggetto. Le analisi a livello editoriale trattano ormai i riferimenti allucinati come un problema del corpus, non come un fatto aneddotico. Un commento del 2026, basato su un esame di Nature di circa 4.000 pubblicazioni, ha osservato che 65 dei 100 articoli più sospetti contenevano almeno un riferimento non valido, un modello che potrebbe implicare oltre 110.000 articoli interessati su circa 7 milioni di pubblicazioni del 2025.
L'implicazione per gli esperti è operativa. Scegli strumenti che rendano poco onerosa la verifica. Rifiuta strumenti che fanno sembrare superfluo verificare.
Riferimenti
- Higher Education Policy Institute — Indagine sugli studenti e l'AI generativa 2025
- ERIC / U.S. Department of Education — Indagine sugli studenti e l'AI generativa 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — Allucinazioni nell'AI generativa e integrità accademica
- Wikipedia — Allucinazione (intelligenza artificiale)
- McGoogan Library dell'University of Nebraska Medical Center — Allucinazioni AI con citazioni
- Science / AAAS — Perché i modelli AI allucinano invece di ammettere l'incertezza
- LlamaIndex — Estrazione ancorata alle citazioni
- Guida della biblioteca di King's College London — Strumenti AI nella sintesi delle evidenze
- Elicit — AI per la ricerca scientifica
- Scite — Ricerca supportata da citazioni e Smart Citations
- ResearchRabbit — Mappatura della letteratura e reti di citazioni
- newline — Benchmark per verificare i riferimenti scientifici prodotti da LLM
- Paperguide — Confronto tra strumenti AI per la ricerca accademica, 2026
- arXiv — SemanticCite: verifica delle citazioni con analisi del testo completo
- Nature Humanities and Social Sciences Communications — Classificazione delle allucinazioni AI