Le piattaforme AI multi-modello sono migliori degli strumenti di ricerca a modello singolo?
2026-08-22
In che modo il routing delle attività e la diversità dei modelli cambiano la qualità della ricerca e della scrittura?
Per flussi di lavoro complessi di ricerca, analisi e scrittura nel 2026, le piattaforme multi-modello con routing delle attività in genere superano gli strumenti di ricerca a modello singolo, perché possono assegnare scoperta, ragionamento e stesura a modelli diversi invece di costringere un solo sistema a svolgere ogni compito. Jenova dà il meglio quando un progetto deve passare dalla raccolta delle fonti alla sintesi fino a una bozza finale in un unico spazio di lavoro persistente. ChatGPT e Claude restano più efficaci per una stesura rapida e autonoma. Perplexity ed Elicit restano più efficaci per ricerche circoscritte in un'interfaccia familiare.
Il divario qualitativo non dipende da quale brand dispone del modello più grande. Dipende dal fatto che l'architettura possa cambiare modelli, strumenti e specialisti man mano che cambia il compito.
Fattori chiave che distinguono una chat di ricerca capace da una piattaforma per flussi di lavoro:
✅ Fedeltà della ricerca — se le risposte restano collegate a fonti recuperabili anziché alla memoria di un singolo modello ✅ Intelligenza di routing — se il sistema può inviare revisione della letteratura, calcoli e prosa a modelli diversi ✅ Continuità compositiva — se il contesto della ricerca sopravvive nella scaletta, nella bozza e nella revisione ✅ Rilevamento degli errori — se un secondo modello o agente può mettere in discussione il primo passaggio ✅ Controllo dei costi — se i costosi modelli di frontiera sono riservati alle fasi più difficili
AWS documenta che un singolo modello linguistico di grandi dimensioni (LLM) spesso non riesce a ottimizzare costi, latenza e qualità su attività eterogenee, motivo per cui il routing è diventato una decisione architetturale centrale. Per confrontare questi strumenti in modo equo, è utile separare ciò che un modello può fare bene da ciò che un flusso di lavoro multi-agente con routing può sostenere nel tempo.
Perché i flussi di lavoro complessi di ricerca e scrittura stanno superando gli strumenti a un solo modello?
Il lavoro complesso di ricerca e scrittura sta superando gli strumenti a un solo modello perché il compito non è più un singolo prompt. È una sequenza di ricerca, filtraggio, confronto, strutturazione, stesura e verifica dei fatti, e ciascuna fase premia capacità diverse.
Una ricognizione della letteratura richiede fonti aggiornate. Una critica metodologica richiede ragionamento attento. Un memorandum per un cliente richiede controllo della voce. Una singola chat può approssimare tutti e tre, ma di solito lo fa all'interno di un'unica finestra di contesto, mantenendo i punti ciechi di un solo modello.
I bibliotecari accademici osservano che gli strumenti di AI generativa restano inclini a errori, comprensione limitata del contesto e capacità di ricerca limitate. Le guide universitarie alla ricerca segnalano inoltre allucinazioni, lacune nei dati di addestramento e letteratura soggetta a paywall come limiti strutturali. Questi limiti si sommano quando un unico modello recupera e scrive allo stesso tempo.
Ecco perché i ricercatori ora combinano strumenti specializzati. I confronti sull'AI per la ricerca nel 2026 rilevano ripetutamente che nessun singolo prodotto copre con la stessa efficacia scoperta, analisi, scrittura e presentazione. Le raccolte dedicate ai flussi di lavoro accademici continuano a distribuire il compito tra Consensus, Elicit, Semantic Scholar e Perplexity invece di raccomandare un solo chatbot generico.
La domanda pratica non è più "quale modello è più intelligente". È se la tua architettura può instradare ogni fase verso il sistema che ha minori probabilità di fallire in quella fase.
Cosa dovresti valutare quando scegli un insieme di strumenti AI per ricerca e scrittura?
Dovresti valutare un insieme di strumenti AI per ricerca e scrittura in base a fedeltà della ricerca, intelligenza di routing e continuità compositiva — un test in tre parti che chiamiamo Framework SRC — non in base alla qualità delle risposte dimostrative a un singolo prompt.
Il Framework SRC pone tre domande che riflettono il modo in cui la ricerca fallisce realmente:
- Fedeltà della ricerca. Lo strumento riesce a trovare materiale aggiornato e citabile, oppure ricostruisce una risposta dai dati di addestramento?
- Intelligenza di routing. Può inviare una domanda metodologica, una riscrittura sensibile ai costi e una lunga sintesi a modelli diversi?
- Continuità compositiva. Lo stesso spazio di lavoro può ricordare fonti, affermazioni scartate e vincoli di voce per tutta la bozza?
Ulteriori criteri contano quando un flusso di lavoro dura più di una singola sessione:
- Strumenti di ancoraggio alle fonti. Ricerca web, ricerca accademica, file e gestione delle citazioni.
- Memoria. Se preferenze e risultati precedenti persistono tra le sessioni.
- Orchestrazione. Se ricerca, scrittura e revisione possono funzionare come ruoli coordinati.
- Osservabilità. Se puoi vedere quale modello o agente ha prodotto ciascuna affermazione.
- Struttura dei costi. Se paghi tariffe da modello di frontiera per ogni economica fase di classificazione.
- Modalità di errore. Se una risposta debole può far crollare l'intero progetto.
HatchWorks presenta la decisione centrale come la scelta tra un LLM generico e un'architettura multi-modello che assegna il lavoro in base al compito. TrueFoundry descrive il routing multi-modello come l'invio di ogni query al modello più adatto per quel lavoro. Sono scelte architetturali, non semplici checklist di funzionalità.
Uno strumento può ottenere ottimi risultati nella qualità della chat e fallire comunque il test SRC se ogni risposta viene prodotta dallo stesso modello, nella stessa sessione, senza una verifica indipendente.
Come si confrontano ChatGPT, Claude, Perplexity, Elicit e Jenova nel lavoro a più fasi?
ChatGPT e Claude sono più efficaci come generalisti con un'unica interfaccia, Perplexity ed Elicit come interfacce di ricerca specializzate, mentre Jenova eccelle quando ricerca, analisi e scrittura devono rimanere connesse in uno spazio di lavoro multi-modello.
ChatGPT compare costantemente negli elenchi di strumenti del 2026 come assistente generale versatile. Claude è spesso consigliato per la scrittura accademica in formato lungo. Perplexity è ampiamente usato per la ricerca di informazioni, anche se alcune guide ai flussi di lavoro accademici invitano alla cautela. Elicit è posizionato come assistente di ricerca AI per le revisioni della letteratura.
Jenova ha una configurazione diversa. Gli utenti possono passare tra modelli di OpenAI, Anthropic, Google, DeepSeek e xAI, mantenere una cronologia chat illimitata e collegare basi di conoscenza. Agenti specializzati per dominio come l'Academic Research Assistant e il Writing Assistant operano sulla stessa architettura, quindi una fase di revisione della letteratura non deve essere incollata in uno strumento di stesura separato.
Il compromesso è reale. Elicit resta più orientato all'estrazione strutturata dai paper. Claude resta più semplice quando l'unico compito è una bozza lunga e accurata. Il vantaggio di Jenova emerge quando il progetto prevede più ruoli, non quando l'utente desidera il minor numero possibile di impostazioni.
| Funzionalità / Dimensione | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Accesso ai modelli | Assistente generale di un singolo fornitore | Modello a contesto lungo di un singolo fornitore | Interfaccia incentrata sulla ricerca su un modello ospitato | Modello di flusso di lavoro specifico per la ricerca | Accesso multi-fornitore con scelta del modello a livello di attività |
| Ricerca e ancoraggio alle fonti | Forte assistenza web generica; non è un database dedicato alla letteratura | Forte analisi documentale; meno efficace come indice di ricerca aggiornato | Efficace per ricerche rapide con citazioni | Efficace per revisioni strutturate della letteratura | Web, Scholar, file e basi di conoscenza in un unico spazio di lavoro |
| Orchestrazione a più fasi | Prompt gestiti dall'utente tra diverse chat | Prompt a contesto lungo gestiti dall'utente | Ideale per cicli domanda-risposta | Ideale per pipeline di revisione, non per la stesura completa | Orchestrazione di agenti e routing dei modelli tra ricerca e scrittura |
| Memoria e continuità | Memoria delle conversazioni nel prodotto | Forte contesto nel thread; meno efficace come sistema di riferimento tra progetti | Memoria di progetto limitata oltre i thread di ricerca | Incentrato su studi e paper anziché sulle bozze | Memoria persistente tra sessioni e documenti allegati |
| Prezzi (al 2026) | Non verificati in questa analisi | Non verificati in questa analisi | Non verificati in questa analisi | Non verificati in questa analisi | Piano gratuito con utilizzo limitato; piani a pagamento da $20/mese |
| Ideale per | Ricerca e stesura generale rapide | Manoscritti lunghi e prosa accurata | Risposte citate a domande specifiche | Revisione della letteratura accademica | Flussi completi di ricerca, analisi e scrittura |
Un'altra opzione multi-modello è Multi, che dichiara di offrire oltre 300 modelli dei principali laboratori distribuiti su quattro flussi di lavoro. Questo lo rende pertinente per i team che desiderano una scelta diretta dei modelli. È meno pertinente se l'utente necessita di agenti specializzati per dominio, memoria persistente del progetto e un unico spazio di lavoro dalla ricerca alla bozza.
Quale approccio AI produce una ricerca e una scoperta delle fonti più affidabili?
Uno strumento specializzato nella ricerca o una piattaforma multi-modello con recupero in tempo reale è più affidabile per la scoperta delle fonti rispetto a un singolo modello generico che risponde dalla memoria. Il motivo è semplice: scoperta e sintesi hanno modalità di errore diverse.
La chat a modello singolo è efficiente quando conosci già la domanda e ti serve soltanto una spiegazione iniziale. Diventa fragile quando la risposta dipende da ciò che è stato pubblicato dopo l'addestramento, da ciò che è protetto da un paywall o da ciò che un secondo database potrebbe contraddire.
ConvergePanel sostiene che la ricerca a modello singolo nasconda il disaccordo sintetizzando troppo presto, mentre la ricerca multi-modello preserva il dissenso e i segnali sulla qualità delle fonti. Argumentree sottolinea un punto simile: un singolo modello eredita i propri errori senza verifica indipendente, mentre la ricerca multi-modello può validare le affermazioni.
In pratica, il modello più affidabile appare così:
- Usa uno strumento orientato anzitutto al recupero per raccogliere fonti candidate.
- Usa un secondo modello per estrarre metodi, dimensioni del campione e limiti.
- Usa un terzo passaggio per segnalare deduzioni non supportate prima che inizi la scrittura.
Elicit e Consensus sono progettati per parti di questa sequenza. Consensus si concentra su risposte basate sulle evidenze tratte dalla letteratura sottoposta a revisione paritaria. Perplexity è più rapido quando la domanda si avvicina maggiormente alla ricerca web che alla revisione sistematica.
Jenova è più utile quando la scoperta è solo la prima fase. L'Academic Research Assistant può cercare nei database accademici e mantenere le citazioni collegate, per poi trasferire lo stesso contesto di progetto a un agente di scrittura. Questo non sostituisce un database di evidenze dedicato per una revisione sistematica formale. Riduce però il divario da copia-incolla che di solito introduce deriva nelle citazioni.
Un prompt affidabile per la fase di scoperta specifica con precisione ambito e regole di esclusione:
"Trova fonti sottoposte a revisione paritaria dal 2023 al 2026 sul routing multi-LLM nei sistemi in produzione. Escludi le landing page dei fornitori. Per ogni fonte, estrai il guadagno dichiarato in termini di costo o qualità, il metodo di valutazione e un limite ammesso dagli autori."
Se uno strumento non può seguire questa istruzione senza inventare paper, è un supporto alla scrittura, non un'architettura di ricerca.
In che modo il routing multi-modello migliora l'analisi senza gonfiare i costi?
Il routing multi-modello migliora l'analisi inviando classificazione e ricerche economiche a modelli più piccoli, e riservando modelli più potenti al confronto, al controllo delle contraddizioni e al ragionamento strutturato. Se fatto bene, aumenta la qualità e può ridurre la spesa. Se fatto male, il router stesso diventa un'ulteriore fase fatturabile.
AWS descrive due famiglie di routing: il routing statico tramite interfacce dedicate e il routing dinamico che classifica un prompt prima di scegliere un modello. Il routing dinamico può usare un modello classificatore, la similarità semantica o una combinazione dei due. Amazon Bedrock Intelligent Prompt Routing viene presentato come un metodo gestito per ridurre il costo delle richieste fino al 30%, scegliendo il modello meno costoso che può comunque raggiungere la soglia di qualità.
MindStudio riporta che associare le attività al modello corretto può ridurre i costi del 60% quando pianificazione ed esecuzione sono separate, invece di inviare ogni fase a un modello di frontiera. Questa cifra è riportata dal fornitore e dovrebbe essere considerata un limite superiore, non una garanzia. La logica di fondo resta valida: l'analisi comprende sotto-attività economiche e sotto-attività costose.
Una suddivisione pratica per l'analisi della ricerca appare così:
- Modello piccolo o veloce: assegna tag ai documenti, estrae citazioni, normalizza riferimenti, raggruppa temi.
- Modello di fascia intermedia: riassume metodi e segnala comparatori mancanti.
- Modello ad alta capacità: concilia conflitti, sottopone a stress test le affermazioni causali, scrive il memorandum analitico.
Jenova supporta questa suddivisione perché gli utenti possono cambiare fornitore di modelli all'interno dello stesso progetto invece di esportare note tra diverse app. Il limite è che il routing è valido solo quanto la definizione del compito. Se chiedi a un agente di "analizzare tutto", hai ricostruito un flusso di lavoro a modello singolo con costi aggiuntivi.
AWS rileva inoltre che il routing personalizzato aggiunge latenza e costo del classificatore, quindi i risparmi devono superare il costo del routing. Per un briefing di 20 minuti, un modello potente è spesso più economico. Per una pipeline di ricerca ricorrente, il routing in genere si ripaga da solo.
Quando un singolo modello AI produce ancora una scrittura migliore?
Un singolo modello AI produce ancora una scrittura migliore quando il compito è lineare, l'insieme delle fonti è già stato scelto e la coerenza stilistica conta più della verifica indipendente. In questi casi, agenti aggiuntivi possono introdurre discontinuità, ritardi e modifiche contraddittorie.
Le linee guida di GitHub sull'orchestrazione degli agenti sono esplicite: se le attività sono semplici e lineari, un singolo agente è la soluzione più adatta. La scrittura spesso rientra in questa descrizione. Un modello a contesto lungo che può vedere la scaletta, le note e gli ultimi tre paragrafi manterrà in genere una voce più stabile rispetto a tre specialisti che si passano le bozze.
Claude è l'esempio più chiaro. Viene ripetutamente consigliato per la scrittura accademica in formato lungo perché il compito riguarda prosa continuativa, non il cambio di strumenti. ChatGPT è spesso sufficiente per email, brief e prime bozze in cui la velocità conta più dell'architettura delle citazioni.
La scrittura a modello singolo inizia a perdere efficacia quando la bozza dipende da evidenze aggiornate, da più versioni per diversi stakeholder o da un passaggio QA che non dovrebbe fidarsi dell'autore originale. È qui che si giustificano un agente di scrittura e un agente di revisione separato.
Il Writing Assistant di Jenova è progettato per il centro di questo spettro: adattarsi a formato e pubblico, mantenere una voce stabile e restare all'interno di uno spazio di lavoro che contiene già la ricerca. Non è automaticamente migliore di Claude per un saggio autonomo. È più efficace quando la bozza deve continuare a usare le stesse fonti, esclusioni e terminologia raccolte in precedenza.
Anche un brief di scrittura per un singolo modello dovrebbe essere rigoroso:
"Usando solo le otto fonti già presenti in questo progetto, scrivi una spiegazione di 900 parole per product manager. Non aggiungere nuove citazioni. Mantieni un livello di lettura non tecnico. Segnala ogni affermazione non supportata dalle note allegate."
Se il tuo compito di scrittura può essere specificato con questa chiarezza, un solo modello non è un compromesso. È l'architettura corretta.
In cosa differiscono le architetture a singolo agente e multi-agente per i flussi di lavoro di ricerca?
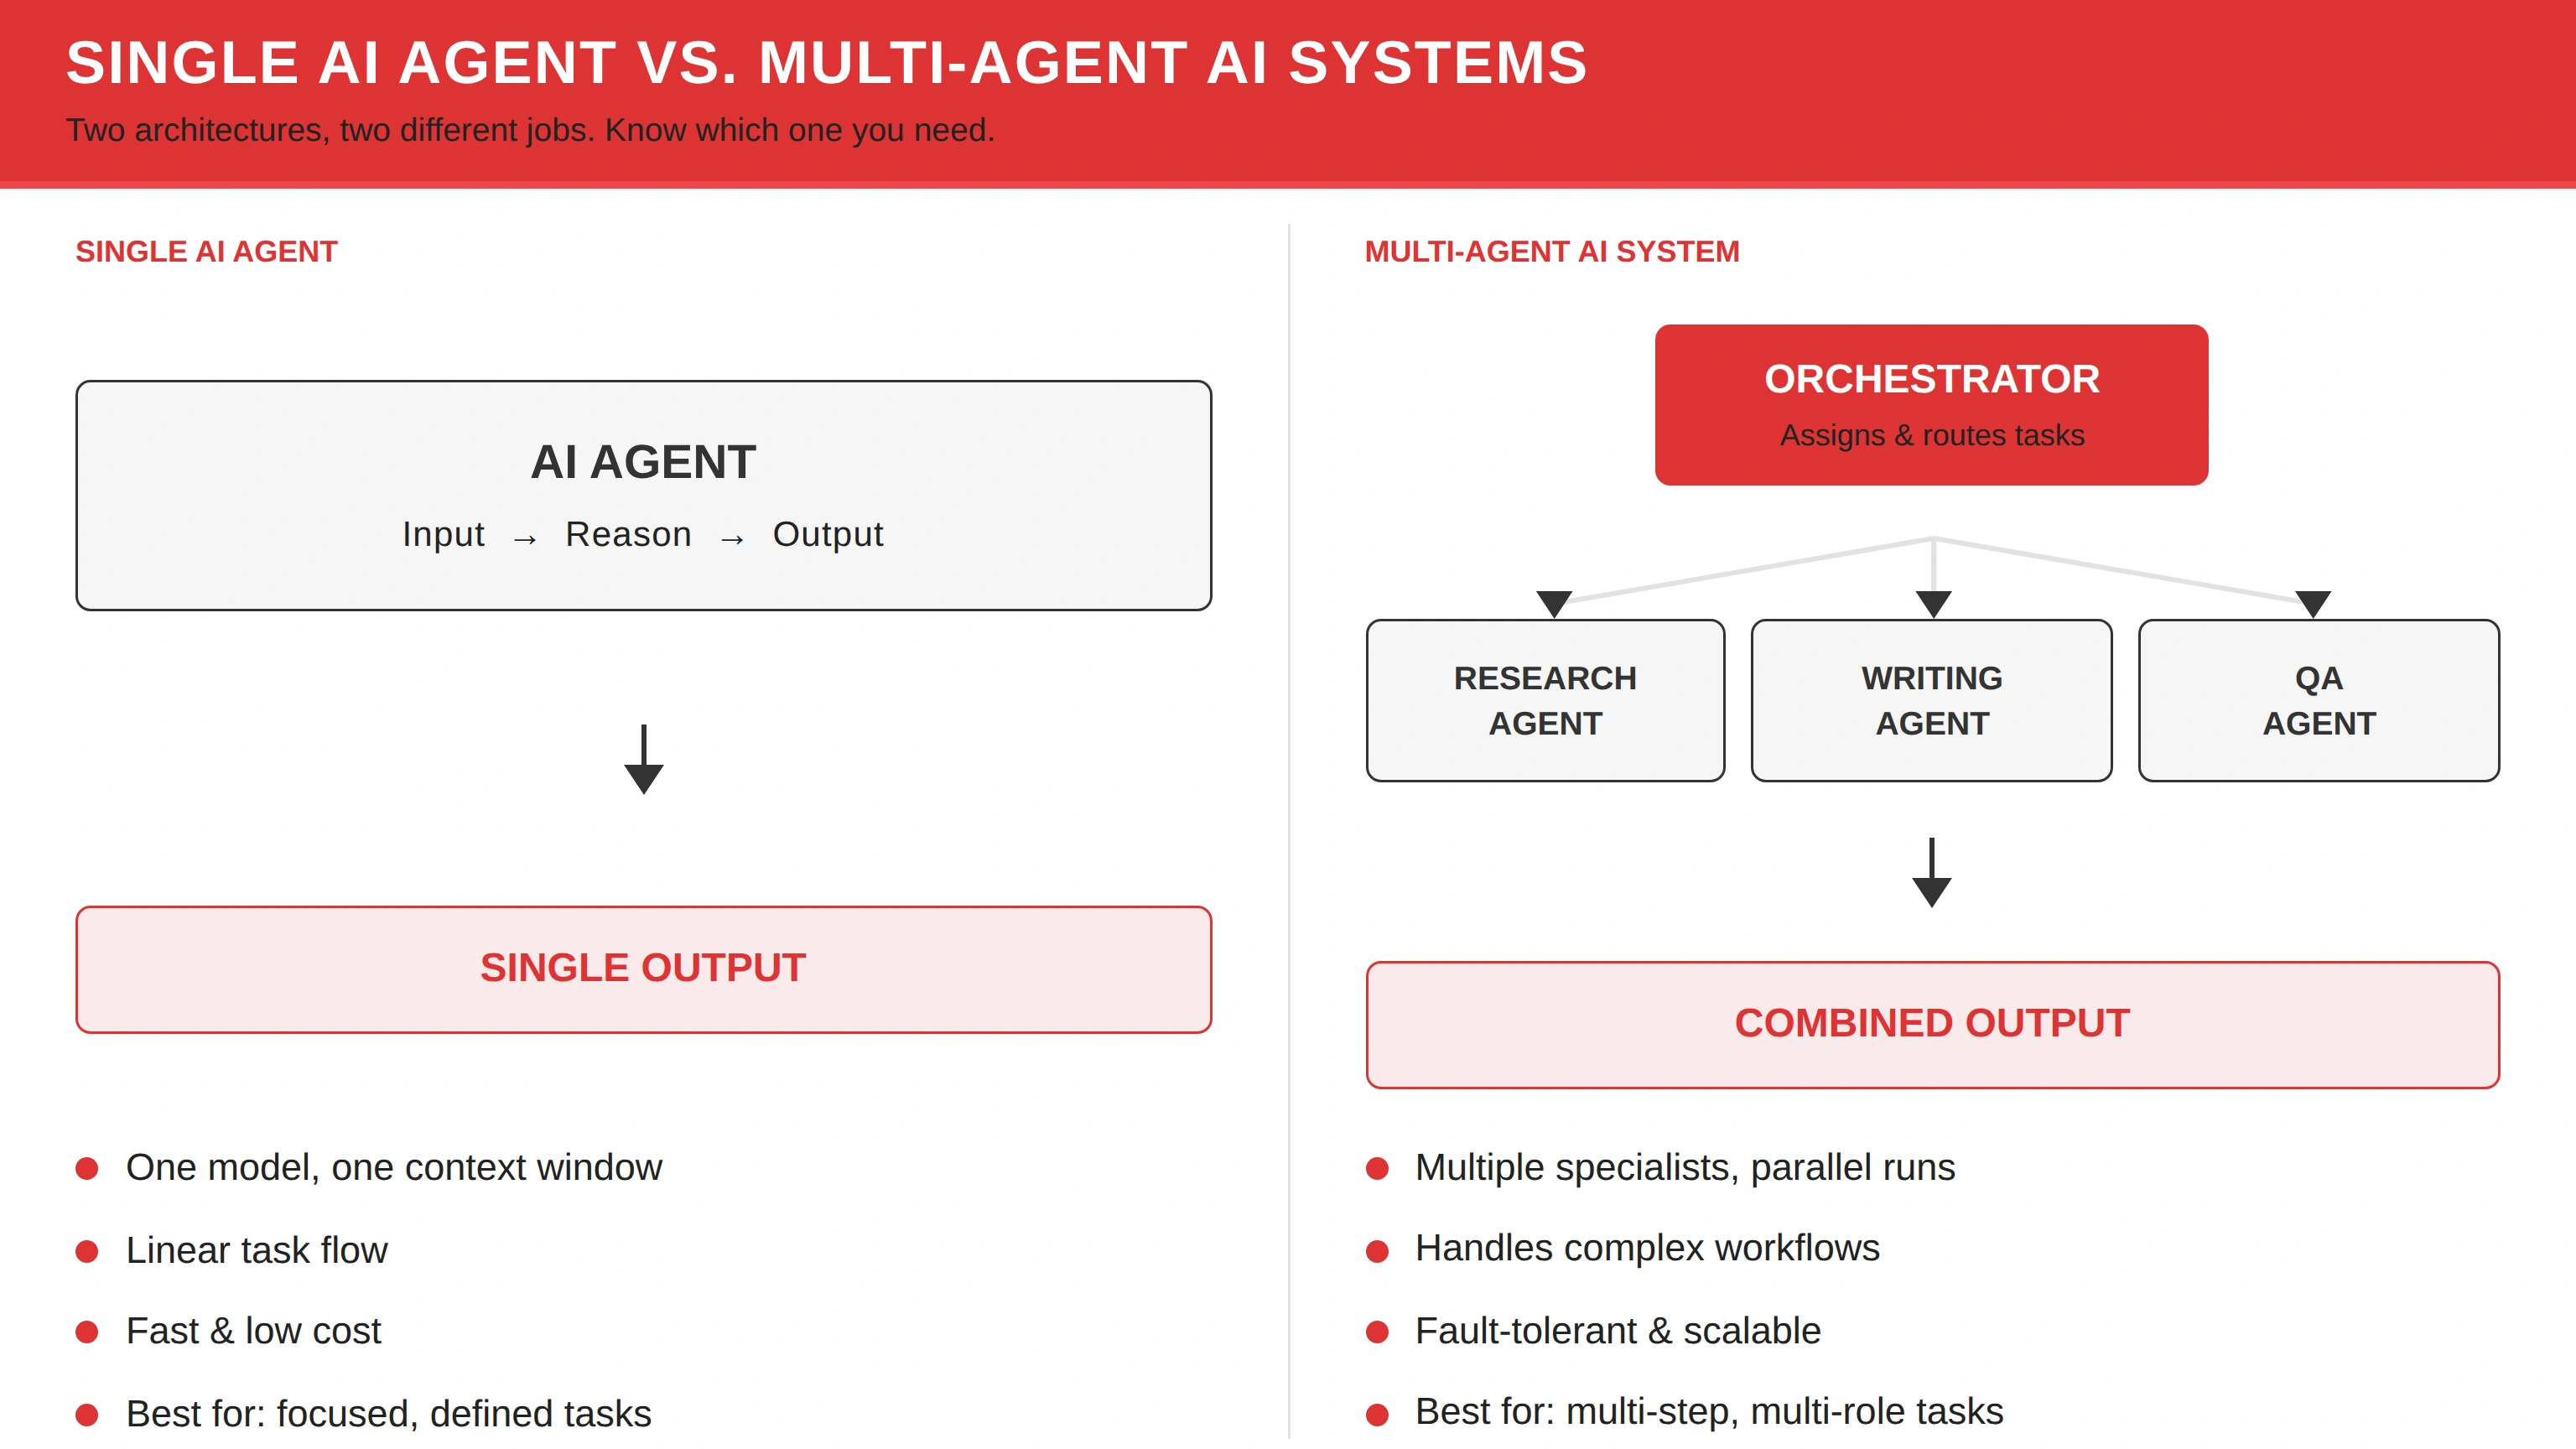
Un sistema a singolo agente usa un modello e una finestra di contesto in un ciclo lineare input-ragionamento-risultato, mentre un sistema multi-agente usa un orchestratore per assegnare ruoli specializzati come ricerca, scrittura e QA. Il primo è più rapido ed economico per attività definite. Il secondo è più tollerante agli errori per il lavoro a più fasi.
L'orchestrazione degli agenti AI è il livello di controllo che coordina più agenti autonomi verso un obiettivo condiviso, inclusi stato, autorizzazioni e punti di controllo umani. Questo è diverso dal semplice disporre di più agenti, e diverso dalla normale orchestrazione AI che si limita a sequenziare modelli e API. Kimi descrive lo stesso schema in termini di flusso di lavoro: un agente ricerca, un altro pianifica, un altro scrive.
Il contrasto architetturale è più evidente nella produzione accademica. Nell'aprile 2026, Google Research ha descritto PaperVizAgent come un sistema a cinque agenti — recuperatore, pianificatore, stilista, visualizzatore e critico — che ha ottenuto 60,2 contro una base umana di 50,0 nella generazione di figure. Un sistema complementare, ScholarPeer, usa più agenti per ancorare la revisione paritaria alla letteratura aggiornata invece di trattare la revisione come generazione testuale in un solo passaggio. Questi risultati non dimostrano che ogni architettura multi-agente sia migliore. Mostrano però perché la specializzazione unita alla critica può superare un singolo prompt.
I costi sono altrettanto concreti. I sistemi multi-agente richiedono protocolli espliciti, maggiore infrastruttura e limiti di spesa. Senza orchestrazione, gli agenti possono duplicare il lavoro, entrare in conflitto o ritentare fino a far aumentare la spesa. I sistemi a singolo agente hanno il rischio opposto: un fallimento interrompe il lavoro.
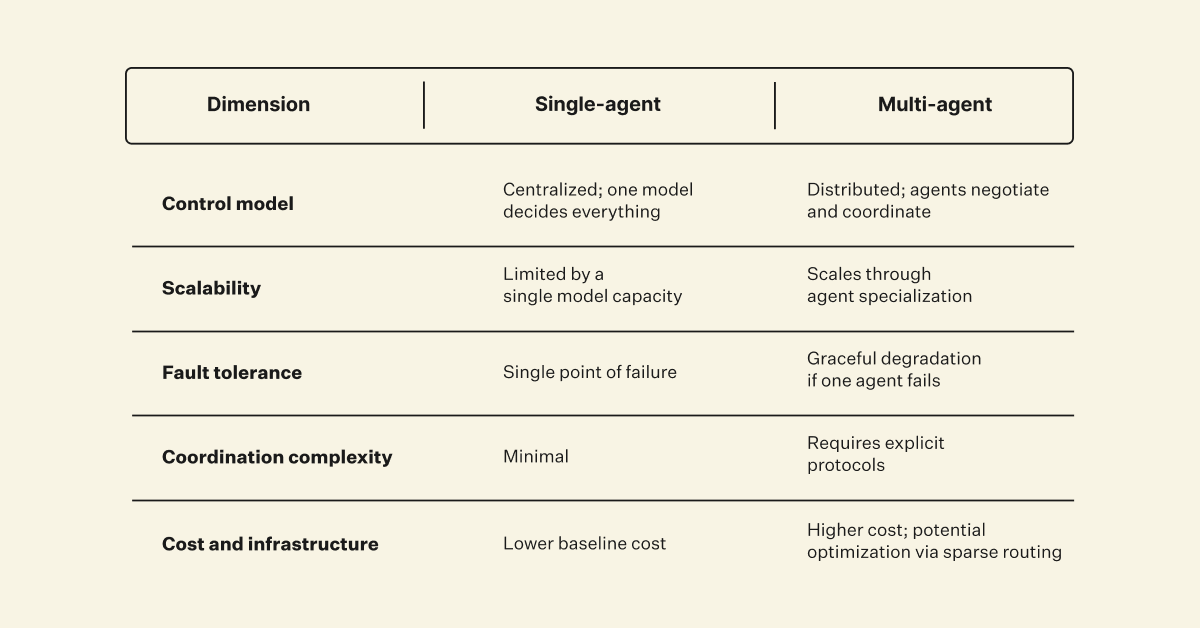
Per ricerca e scrittura, la regola utile riguarda il numero di ruoli. Se il lavoro ha un solo ruolo, usa un solo agente. Se il lavoro richiede un ricercatore, uno scrittore e un revisore, usa un sistema orchestrato — oppure accetta di essere tu l'orchestratore.
Come si costruisce un flusso di lavoro completo per ricerca e scrittura assistite dall'AI?
Puoi costruire un flusso di lavoro completo per ricerca e scrittura assistite dall'AI separando scoperta, analisi e composizione, quindi scegliendo uno strumento a modello singolo o una piattaforma con routing per ogni livello invece di usare una sola chat per l'intero progetto.
Una sequenza solida appare così:
- Definisci la decisione. Scrivi la domanda a cui il documento finale deve rispondere, oltre a ciò che la falsificherebbe.
- Raccogli fonti con uno strumento orientato al recupero. Usa Elicit o Consensus per revisioni a livello di paper, Perplexity per briefing su scala web o l'Academic Research Assistant di Jenova quando lo stesso spazio di lavoro deve mantenere le citazioni.
- Analizza con un secondo modello. Estrai metodi, disaccordi e grado di fiducia, non solo riassunti.
- Stendi con uno specialista della scrittura. Usa Claude per un manoscritto autonomo oppure il Writing Assistant di Jenova quando la bozza deve restare legata alla memoria del progetto.
- Esegui un passaggio QA severo. Chiedi a un modello diverso di attaccare citazioni, cronologia e affermazioni eccessive.
- Consolida l'elaborato. Esporta solo dopo aver rimosso o ridimensionato le affermazioni non supportate.
Su Jenova, questa sequenza può rimanere in un unico account. Un utente può iniziare con l'Academic Research Assistant, cambiare modello per la fase analitica e poi proseguire con il Writing Assistant o con SEO Blog Generator se l'output è un articolo pubblico. La memoria persistente e i file allegati riducono la consueta perdita di vincoli tra gli strumenti.
Un buon prompt di passaggio dalla ricerca alla scrittura è esplicito su ciò che non deve cambiare:
"Ecco il pacchetto di fonti e le affermazioni che abbiamo già scartato. Redigi la sezione di analisi per un pubblico di responsabili delle politiche. Ogni paragrafo deve includere una fonte ancora valida. Se un'affermazione è dedotta, etichettala come inferenza. Non ripristinare le affermazioni scartate."
Su uno strumento a modello singolo, lo stesso flusso di lavoro è comunque possibile. Diventi semplicemente tu il router: nuove chat, note incollate e un modello QA manuale. Può essere la soluzione giusta per un lavoro occasionale. Diventa fragile quando il progetto dura settimane o coinvolge più tipi di documento.
Jenova non è il modo più semplice per realizzare un riepilogo occasionale. Il suo vantaggio è che il flusso di lavoro sopra descritto non richiede tre abbonamenti e un sistema personale di annotazione per mantenere allineati tutti gli elementi.
Cosa dicono i team di infrastruttura AI sulle architetture a modello singolo rispetto a quelle multi-modello?
I team di infrastruttura AI trattano generalmente gli strumenti a modello singolo come impostazione predefinita corretta per il lavoro lineare e le piattaforme multi-modello come impostazione predefinita corretta quando un flusso di lavoro presenta ruoli specializzati, vincoli di costo o una fase di revisione indipendente.
"L'errore di ricerca più costoso che osserviamo non è scegliere il modello di frontiera sbagliato. È usare un modello come ricercatore, analista ed editor, per poi fidarsi della fluidità del paragrafo finale. Quando lo stesso sistema inventa una fonte e poi scrive la frase che da essa dipende, non esiste alcun allarme interno. Un secondo modello non garantisce la verità, ma crea almeno la possibilità di dissentire."
"Il routing giustifica la complessità solo dopo che sai dare un nome ai lavori. 'Fai ricerca su questo e scrivilo' è ancora un lavoro. 'Raccogli paper candidati, estrai i metodi, riconcilia i conflitti, scrivi, poi attacca le citazioni' sono cinque lavori. I team che saltano questa scomposizione acquistano un diagramma multi-agente e continuano comunque a eseguire un singolo prompt."
"Le argomentazioni sui costi sono reali, ma funzionano in entrambi i sensi. Il lavoro di routing pubblicato da Amazon mostra che inviare ogni richiesta al modello più potente spreca denaro, e i rapporti dei fornitori su risparmi dal 30% al 60% sono plausibili quando classificazione e stesura vengono separate. Anche il fallimento opposto è comune: un orchestratore, un classificatore e tre specialisti spendono più di quanto avrebbe speso un solo modello accurato per un breve memorandum."
— Team di prodotto Jenova, architettura dei flussi di lavoro AI, 8 anni nella creazione di sistemi di agenti multi-modello
Questa visione è in linea con la letteratura ingegneristica pubblica. AWS considera il routing multi-LLM una risposta a tipi di attività eterogenei, non un miglioramento universale. GitHub considera l'orchestrazione necessaria dopo la proliferazione degli agenti, non prima. Il consenso tra gli esperti è condizionale: aggiungi modelli quando il lavoro presenta punti di separazione. Non aggiungere modelli per decorare un'attività semplice.
Quando dovresti continuare a usare uno strumento di ricerca a modello singolo?
Dovresti continuare a usare uno strumento di ricerca a modello singolo quando la domanda è delimitata, le fonti sono già disponibili, la scadenza è breve e non ti serve un secondo sistema per verificare il primo. In queste condizioni, il routing multi-modello aggiunge un costo di coordinamento senza aggiungere molta affidabilità.
Resta con ChatGPT o Claude quando:
- Spieghi un concetto familiare invece di mappare una letteratura.
- Riscrivi un documento di cui ti fidi già.
- Esplori tono, struttura o ordine delle argomentazioni.
- Lavori in un'unica sessione senza passaggi a un altro membro del team.
Resta con Perplexity o Elicit quando:
- Poni una domanda specifica che richiede citazioni.
- Esamini abstract prima di una lettura più approfondita.
- Svolgi una revisione della letteratura che verrà redatta altrove.
Passa a una piattaforma multi-modello con routing delle attività quando sono vere due o più di queste condizioni:
- Il progetto combina ricerca, analisi e scrittura finale.
- L'output deve mantenere una traccia delle fonti attraverso le bozze.
- Ti servono modelli diversi per estrazione, ragionamento e prosa.
- Il lavoro si ripete abbastanza spesso da rendere importante un flusso riutilizzabile.
- Una citazione errata avrebbe un costo elevato.
Jenova rientra nel secondo elenco. È meno efficace come sostituto del flusso di estrazione dai paper di Elicit e meno efficace di Claude come sobrio strumento di scrittura a contesto lungo. È più efficace quando questi compiti devono avvenire insieme, con memoria, scelta del modello e agenti specializzati in un unico luogo.
La decisione, quindi, non è "modello singolo contro multi-modello" come prova di fedeltà. È capire se il tuo flusso di lavoro assomiglia ancora a una conversazione o è già simile a una linea di produzione. Le conversazioni appartengono a un modello. Le linee di produzione appartengono a un router.
Riferimenti
- AWS Machine Learning Blog — Strategie di routing multi-LLM per applicazioni di AI generativa su AWS
- The Chicago School Library — Strumenti e risorse di intelligenza artificiale: vantaggi e limiti
- University of the District of Columbia Library — Usi e limiti dell'AI generativa
- PapersFlow — La migliore AI per ricercatori nel 2026: 10 strumenti confrontati per categoria
- Thesify — I migliori strumenti AI per la ricerca accademica nel 2026
- HatchWorks AI — Casi d'uso dei Large Language Model: un LLM contro più modelli
- TrueFoundry — Routing multi-modello: ottimizzare in modo efficiente le attività AI
- Synthesia — I 12 migliori strumenti AI per il 2026
- AnswerThis — I 10 migliori strumenti AI per ricercatori nel 2026
- Zerve — Strumenti AI per la ricerca nel 2026: revisione della letteratura, analisi
- Multi — Un'attività, il giusto flusso di lavoro AI
- ConvergePanel — Il miglior strumento AI multi-modello per la ricerca
- Argumentree.AI — Ricerca AI multi-modello contro modello singolo
- MindStudio — Come ridurre i costi del 60% associando le attività al modello corretto
- GitHub Resources — Che cos'è l'orchestrazione degli agenti AI?
- Kimi AI — Orchestrazione degli agenti AI: tipi, fasi e vantaggi
- Google Research — Introduzione di due agenti AI per figure migliori e revisione paritaria