Gli spazi di lavoro AI per la ricerca sono migliori per la mappatura sistematica delle evidenze?
2026-08-22
In cosa differiscono lo stato persistente del progetto e il recupero di frammenti su richiesta?
Per la mappatura sistematica delle evidenze, uno spazio di lavoro per la ricerca che ricarica decisioni, stato e artefatti all’inizio di ogni sessione è un ambiente principale migliore rispetto a un riassuntore di singoli articoli o a un chatbot RAG che recupera solo «frammenti pertinenti» su richiesta. La mappatura è un progetto di codifica longitudinale: le regole di inclusione evolvono, gli studi al limite vengono ricodificati e la sintesi dipende dal ricordare perché una fonte è stata filtrata la settimana precedente. Strumenti a livello di articolo come Elicit, Consensus e NotebookLM restano efficaci per la scoperta, l’estrazione e le domande e risposte su corpus chiusi. Uno spazio di lavoro persistente — incluso l’Academic Research Assistant di Jenova — è più efficace quando la mappa deve sopravvivere a settimane di modifiche del protocollo senza riscrivere silenziosamente le decisioni di ieri.
La distinzione rilevante nel 2026 non è «quale modello scrive un abstract più elegante». È quale architettura di memoria può sostenere una mappa delle evidenze in evoluzione.
Fattori chiave che distinguono un’infrastruttura di mappatura utilizzabile da una chat usa e getta sui singoli articoli:
✅ Memoria operativa rispetto alla memoria di riferimento — le mappe necessitano dello stato del progetto, ovvero criteri, codici ed esclusioni, non soltanto di passaggi recuperati ✅ Provenienza delle decisioni — ogni decisione di inclusione/esclusione dovrebbe restare ispezionabile tra sessioni diverse ✅ Estrazione strutturata — campi comparabili sono superiori a riassunti narrativi una tantum ✅ Fedeltà al protocollo sotto supervisione umana — gli enti che si occupano di evidenze considerano ancora AI un supporto, non un revisore sostitutivo ✅ Sintesi versionabile — relazioni, figure ed elenchi di fonti dovrebbero accumularsi anziché essere rigenerati da zero
Per confrontare equamente questi strumenti, è utile considerare la mappatura delle evidenze come un problema di continuità a quattro livelli, anziché come una gara di riassunti.
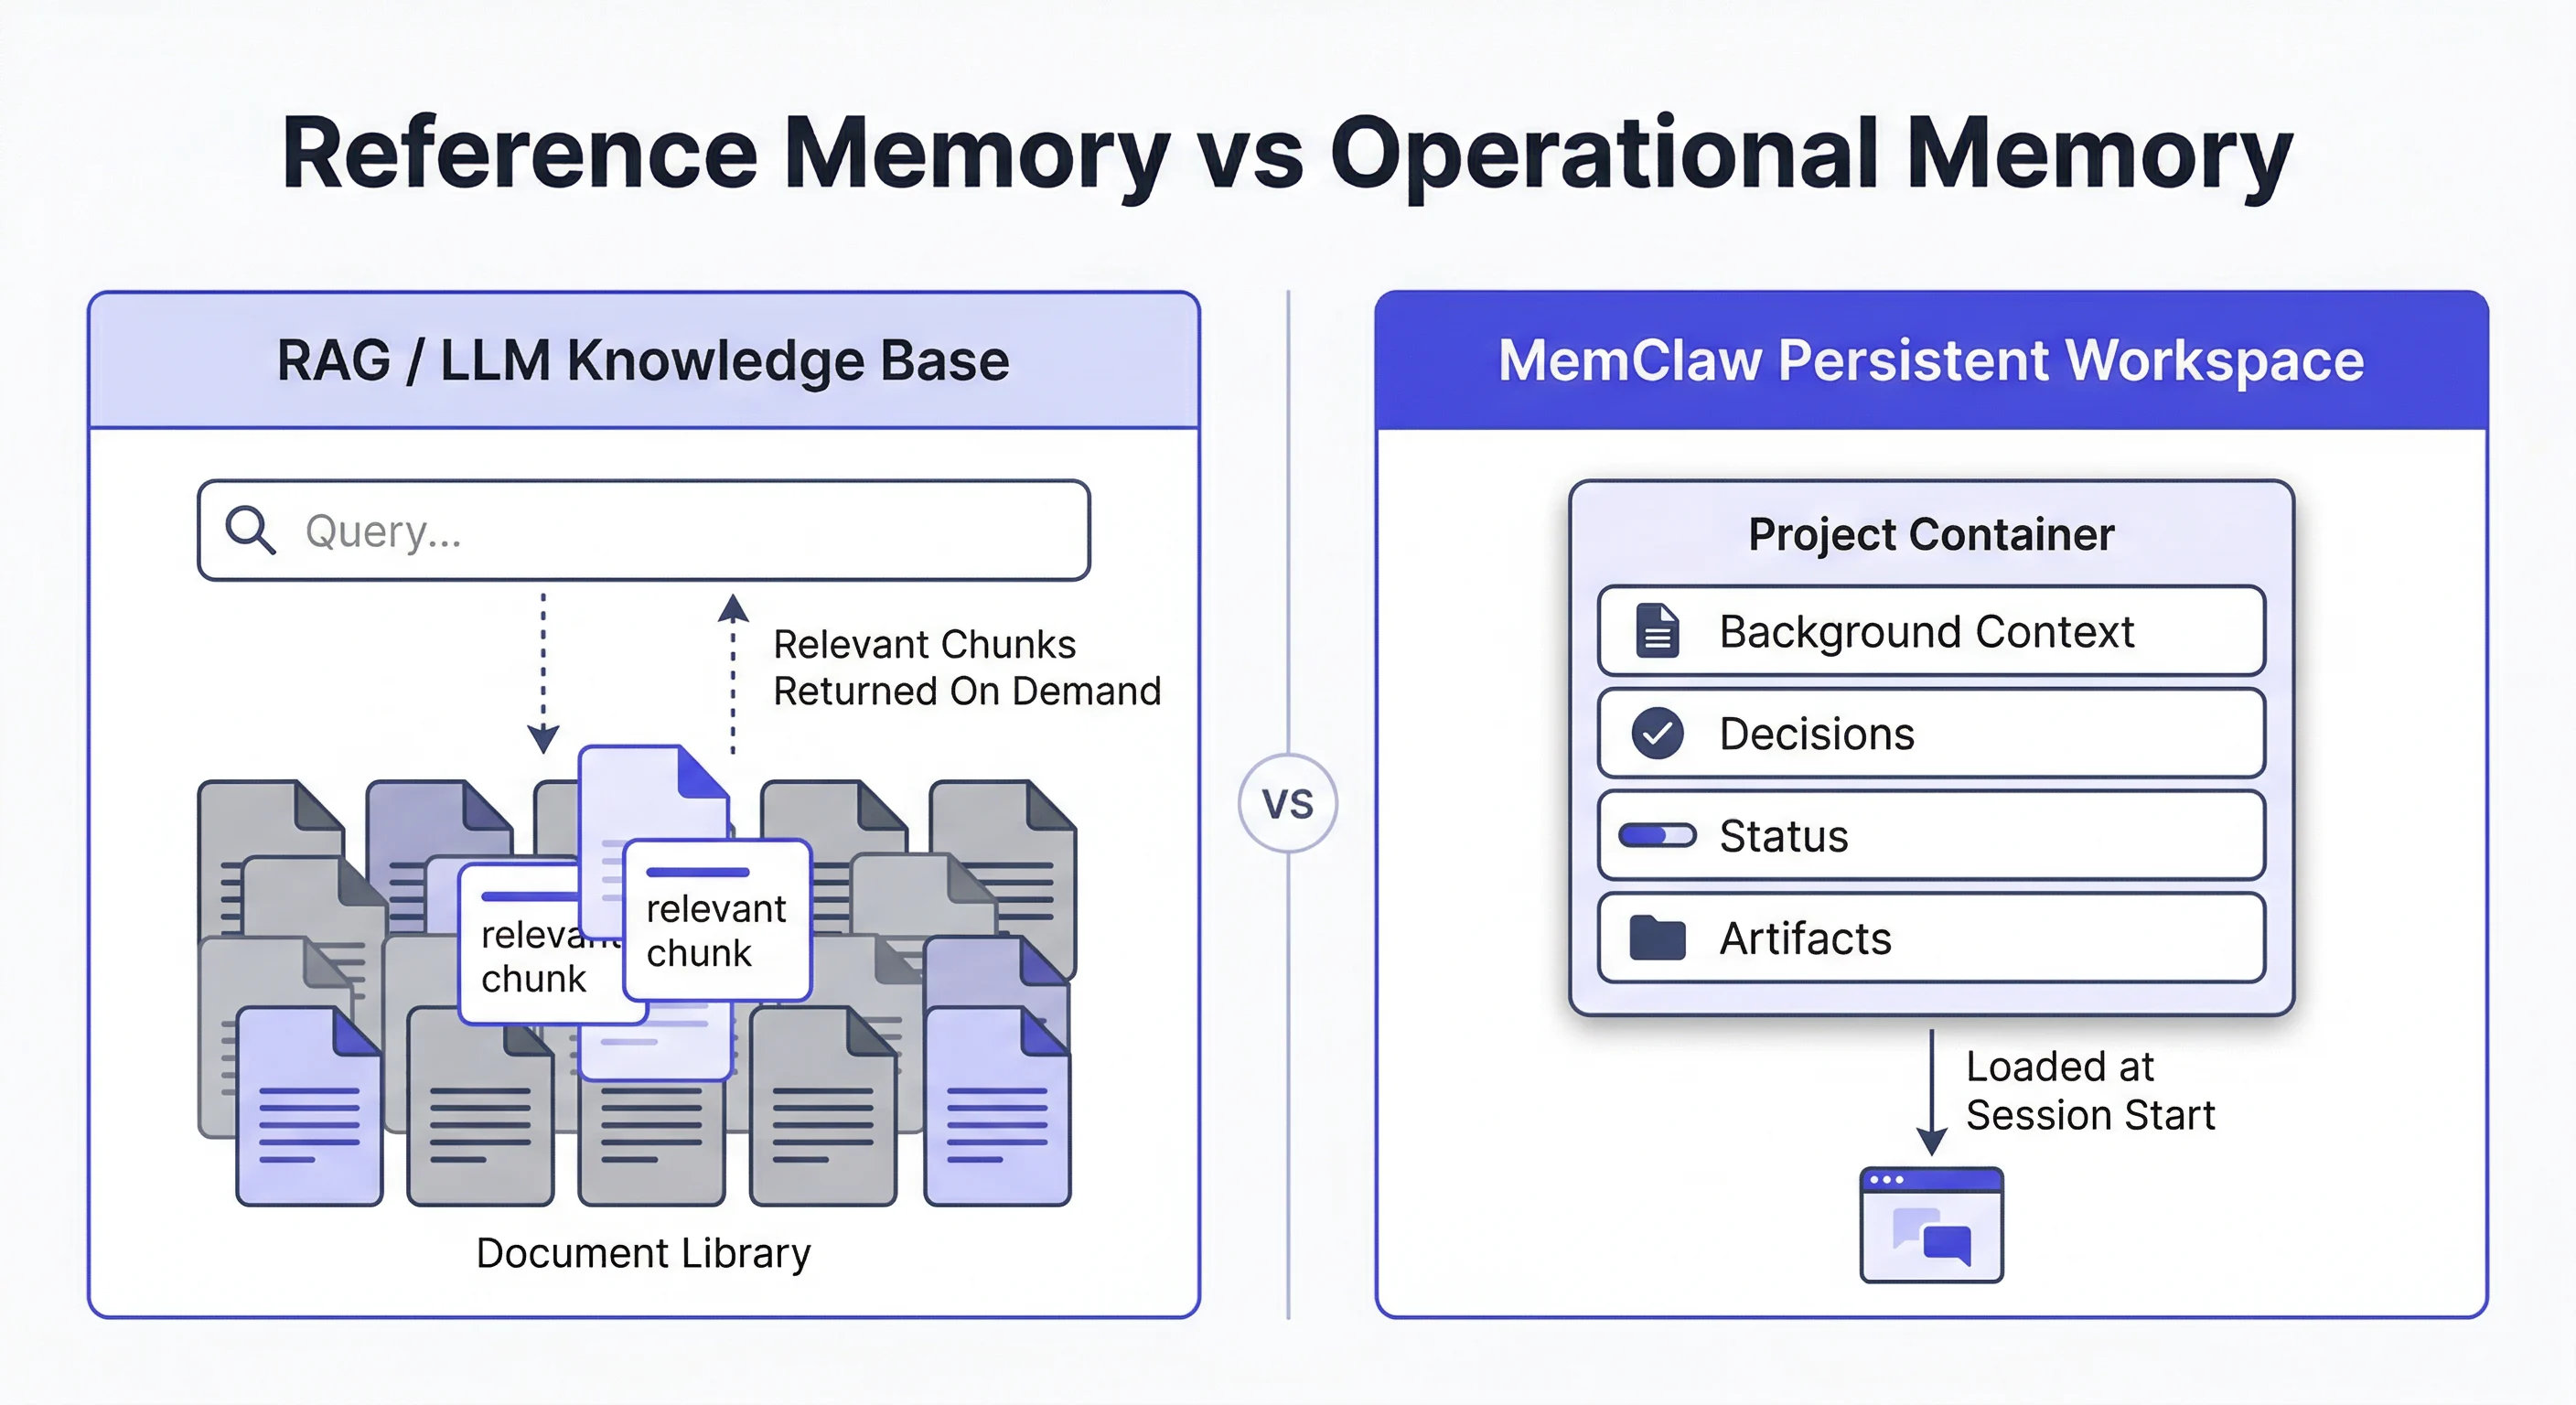
Perché la mappatura sistematica delle evidenze mette sotto pressione gli strumenti AI per singoli articoli?
La mappatura sistematica delle evidenze mette sotto pressione i riassuntori di singoli articoli perché una mappa è un inventario codificato della letteratura, non una sequenza di note di lettura isolate. Le Systematic Evidence Maps (SEMs) sono una forma di sintesi delle evidenze che categorizza e organizza i risultati scientifici secondo dimensioni predefinite — popolazione, esposizione, esito, metodo, area geografica o lacuna nelle evidenze — così che i revisori possano vedere cosa esiste, dove si concentra e cosa manca.
Questo flusso di lavoro entra in conflitto con il funzionamento della maggior parte dei prodotti di ricerca basati su LLM. Uno strumento RAG o «chatta con questo PDF» risponde alla query corrente recuperando frammenti localmente simili. Non ricarica automaticamente il quadro di codifica dello scorso martedì, i tre studi messi in «forse» o la decisione di escludere i modelli animali dopo l’inasprimento del protocollo. Le revisioni di mappatura richiedono inoltre un processo di screening documentato rispetto a criteri di inclusione ed esclusione, un’attività diversa dal generare un paragrafo fluido su un singolo articolo (metodologia per le revisioni di mappatura).
La revisione manuale è ancora abbastanza lenta da rendere allettante la scorciatoia. Un sondaggio del 2026 sugli strumenti per la letteratura ha stimato un ciclo di revisione convenzionale in quattro-sei settimane di screening, estrazione e pulizia delle citazioni. Gli strumenti AI dedicati allo screening possono ridurre questo carico — il sistema AIM Review ha riportato riduzioni del carico di lavoro dal 20% fino al 95% in sei revisioni reali — ma la velocità non crea una mappa. Senza uno stato persistente del progetto, uno screening più rapido produce soltanto un cumulo più grande di riassunti scollegati.
Le biblioteche e gli organismi metodologici sono espliciti sul divario che resta. Le linee guida di King’s College London sulla sintesi delle evidenze affermano che gli strumenti AI non possono sostituire i metodi tradizionali di ricerca, screening ed estrazione e dovrebbero essere usati soltanto con una chiara consapevolezza di bias, limiti di copyright e rischio di allucinazioni. Una revisione sistematica del 2025 sull’AI generativa nella sintesi delle evidenze ha raggiunto la stessa conclusione operativa: le evidenze attuali non supportano l’uso di GenAI senza coinvolgimento o supervisione umana.
Cosa cercare in un flusso di lavoro AI per la mappatura delle evidenze?
Dovresti valutare gli strumenti AI per la mappatura con un test di continuità, non con un test della qualità di scrittura. Usiamo uno stack a quattro livelli — chiamato stack CODE — perché ogni livello fallisce in modo diverso e prevedibile quando i team cercano di trasformare la chat sugli articoli in una mappa sistematica.
C — Copertura. Lo strumento può cercare in un vero corpus accademico oppure soltanto nei file che hai già caricato? Elicit cerca in oltre 138 milioni di articoli e 545.000 studi clinici. NotebookLM, per progettazione, risponde dalle fonti presenti nel notebook. Gli errori di copertura a questo livello diventano righe mancanti nella mappa, non semplicemente paragrafi poco approfonditi.
O — Operatività. I criteri di inclusione, le dimensioni di codifica e i campi di estrazione possono essere formulati una volta e riapplicati? Un riassuntore che reinterpreta «pertinente» a ogni prompt ricodificherà lo stesso trial al limite in modo diverso al terzo giorno. Le linee guida sulla mappatura considerano i criteri predefiniti imprescindibili (metodi per le revisioni di mappatura).
D — Documentazione delle decisioni. Puoi recuperare il motivo per cui uno studio è stato incluso, escluso, messo in attesa o filtrato? I gruppi allineati a Cochrane, incluso il progetto Responsible AI in Evidence Synthesis (RAISE) con Cochrane, Campbell e JBI, considerano la trasparenza un requisito di qualità, non un dettaglio opzionale.
E — Estraibilità. I risultati possono confluire in celle comparabili — campione, disegno, direzione dell’effetto, limitazione — anziché in testo inconciliabile? Il design del prodotto Elicit è costruito attorno a tabelle interattive ed estrazione in più passaggi. Consensus è più veloce nel valutare la direzione delle evidenze a livello di ipotesi, ma non è progettato per la redazione strutturata di revisioni.
Pondera i livelli in base allo scopo. Un’analisi esplorativa può tollerare una provenienza più debole. Una mappa delle evidenze dinamica che sarà citata, aggiornata o consegnata a un coautore non può farlo. Gli strumenti che eccellono in Copertura ed Estraibilità falliscono comunque nella mappatura se Operatività e Documentazione delle decisioni si azzerano a ogni sessione.
Come si confrontano Elicit, Consensus, NotebookLM e gli spazi di lavoro per la ricerca?
Elicit e Consensus costituiscono il livello più solido per la scoperta e l’estrazione di articoli in questa categoria, NotebookLM è il notebook più efficace per corpus chiusi e uno spazio di lavoro di ricerca persistente è l’ambiente più efficace per mantenere coerente una mappa che dura diverse settimane. Nessun singolo prodotto vince in ogni livello CODE, motivo per cui i team di mappatura più rigorosi di solito affiancano uno strumento per il corpus a un ambiente con memoria di progetto, invece di aspettarsi che un solo chatbot gestisca l’intera revisione.
Al 2026, le panoramiche pubblicate sulle funzionalità e sui prezzi si presentano così:
| Funzionalità / Dimensione | Elicit | NotebookLM | Consensus | Spazio di lavoro di ricerca Jenova |
|---|---|---|---|---|
| Modello di memoria | Libreria di fonti salvate più personalizzazione per rapporto; non un contenitore completo dello stato di progetto | Insieme di fonti circoscritto al notebook; le risposte restano nei materiali caricati | Memoria di domande/elenchi attorno a query sulle ipotesi | Memoria persistente tra sessioni; il contesto del progetto può essere ricaricato anziché recuperato nuovamente |
| Copertura | 138M+ articoli, 545k trial | Solo corpus caricato; 50 fonti gratuite, 300 con Plus | 200M+ articoli, tag sulla direzione delle evidenze | Ricerca web e accademica in tempo reale più basi di conoscenza allegate; non un indice editoriale fisso |
| Estrazione strutturata | Tabelle, screening e punti dati su scala (fino a 1.000 articoli / 20.000 punti dati) | Domande e risposte e schemi collegati alle fonti, non griglie di estrazione per revisioni sistematiche | Consensus Meter e risposte sintetiche sulle evidenze | Relazioni di sintesi e brief supportati da citazioni tramite Deep Research; meno efficace come strumento dedicato per doppio screening |
| Persistenza delle decisioni | Le fonti possono essere conservate in una libreria; lo stato del protocollo non è una funzione primaria | Conserva i file del notebook, non la logica codificata di inclusione/esclusione | Segnalibri ed elenchi nei piani a pagamento | Cronologia delle conversazioni, memoria e file di progetto allegati persistono tra sessioni |
| Prezzi (al 2026) | Plus da circa $12/mese | Gratuito; Plus tramite Google AI Pro a circa $19.99/mese | Premium circa $10/mese | Piano gratuito con utilizzo limitato; Plus $20/mese per un utilizzo 30× |
| Ideale per | Screening ad alto volume e tabelle di estrazione | Set didattici e PDF già raccolti | Controlli rapidi del tipo «la letteratura supporta X?» | Mappe dinamiche, codifica su più sessioni e integrazione del manoscritto |
Elicit è lo specialista più trasparente per lo screening in stile sistematico. Può automatizzare screening ed estrazione e dichiara risparmi di tempo fino all’80% in queste fasi. Un confronto metodologico Cochrane ha comunque rilevato che la sensibilità della ricerca di Elicit non era sufficientemente elevata per sostituire la ricerca bibliografica tradizionale, quindi funziona al meglio come supporto ad alta precisione. Inoltre tende a fermarsi a rapporti e tabelle; la scrittura, il versionamento e il lavoro sul manoscritto dinamico di solito vengono spostati altrove.
NotebookLM è lo specialista più trasparente per la lettura fondata su un insieme fisso di fonti. Ogni risposta può essere verificata rispetto a un passaggio citato e Google ha aggiunto Deep Research oltre a tipi di file più ampi. Non può scoprire articoli che non hai raccolto e non codifica un registro decisionale in stile PRISMA.
Consensus è lo specialista più trasparente per la direzione delle ipotesi. Il suo indicatore e la classificazione supporto/contrasto sono più veloci della costruzione di una griglia di estrazione quando devi soltanto capire verso quale direzione propende la letteratura (confronto tra strumenti). È il sistema principale sbagliato per una mappa codificata.
L’Academic Research Assistant di Jenova è più efficace quando l’unità di lavoro è il progetto, non il PDF. Può cercare fonti accademiche, mantenere il contesto del manoscritto e delle citazioni e — poiché la piattaforma sottostante conserva una cronologia chat illimitata e memoria tra sessioni — proseguire un quadro di codifica senza dover incollare nuovamente il protocollo. Non è una piattaforma validata per lo screening a doppia revisione nel senso di Covidence o Rayyan e non pubblica dati sull’accuratezza dell’estrazione paragonabili a quelli di Elicit. I team che necessitano di tracce di audit di livello regolatorio dovrebbero comunque mantenere uno strumento dedicato allo screening nello stack.
SciSpace e Scite coprono attività adiacenti più circoscritte. SciSpace viene ripetutamente descritto come l’ambiente migliore per l’analisi approfondita articolo per articolo, con un corpus molto ampio ma un flusso di revisione meno unificato. Le 1,6 miliardi di Smart Citations di Scite, classificate come di supporto, contrasto o semplice menzione di un’affermazione, sono ineguagliabili per l’audit del contesto citazionale e quasi inutili, da sole, come database per la scoperta o la mappatura.
In che modo la memoria operativa cambia la sintesi della letteratura su più sessioni?
La memoria operativa cambia la sintesi perché tratta il contenitore del progetto — contesto, decisioni, stato, artefatti — come l’oggetto da caricare all’avvio della sessione, invece di trattare la letteratura come un pagliaio da interrogare nuovamente. La memoria di riferimento chiede: «Quali frammenti assomigliano a questa domanda?». La memoria operativa chiede: «Cosa è già vero per questo progetto e cosa necessita ancora di evidenze?».
Questa differenza emerge in tre modalità di errore che i riassuntori nascondono bene:
- Deriva dei criteri. Se «solo RCT su esseri umani adulti» vive nel prompt anziché nello stato del progetto, una sessione successiva che pone una domanda leggermente più ampia reincluderà silenziosamente gli studi pediatrici già respinti.
- Casi dubbi orfani. Gli articoli al limite messi in attesa per discuterne con un coautore scompaiono se lo stato non è un campo di primo livello.
- Sintesi rigenerata. Una risposta RAG può essere localmente fedele ai frammenti recuperati oggi e contraddire comunque la tabella delle lacune della settimana scorsa, perché nulla impone alla nuova risposta di ereditare la vecchia codifica.
Gli spazi di lavoro persistenti invertono l’ordine di caricamento. Contesto, decisioni, stato e artefatti vengono acquisiti prima della query successiva. L’implementazione di questo modello nella piattaforma Jenova combina memoria tra sessioni e basi di conoscenza allegabili: l’assistente può ricordare le dimensioni della mappatura, la definizione di lavoro di una lacuna nelle evidenze e quali affermazioni dispongono già di sufficiente supporto. Il confronto con strumenti in stile notebook mostra un compromesso netto. Il corpus chiuso di NotebookLM è più sicuro contro l’invenzione di contenuti esterni alle fonti (risposte collegate alle fonti). Uno spazio di lavoro aperto e persistente è più utile quando il corpus è ancora in crescita e il quadro di codifica è la risorsa scarsa.
L’implicazione pratica per le SEMs è semplice. Se il tuo risultato finale è un briefing in un’unica sessione su 15 PDF, la memoria operativa è facoltativa. Se il risultato finale è una mappa delle lacune che verrà aggiornata dopo il prossimo ciclo di conferenze, la memoria operativa è il prodotto.
Che aspetto ha davvero una pipeline di evidenze basata su agenti end-to-end?
Una pipeline di mappatura end-to-end assomiglia a uno sprint di ricerca a fasi con punti di controllo, non a un singolo prompt «riassumi questi articoli». L’illustrazione seguente offre un’architettura di riferimento utile: formulazione della domanda, triage della letteratura, identificazione dei candidati, formalizzazione dell’ipotesi, validazione multisorgente, reporting versionato e pacchetto monitorato con git.
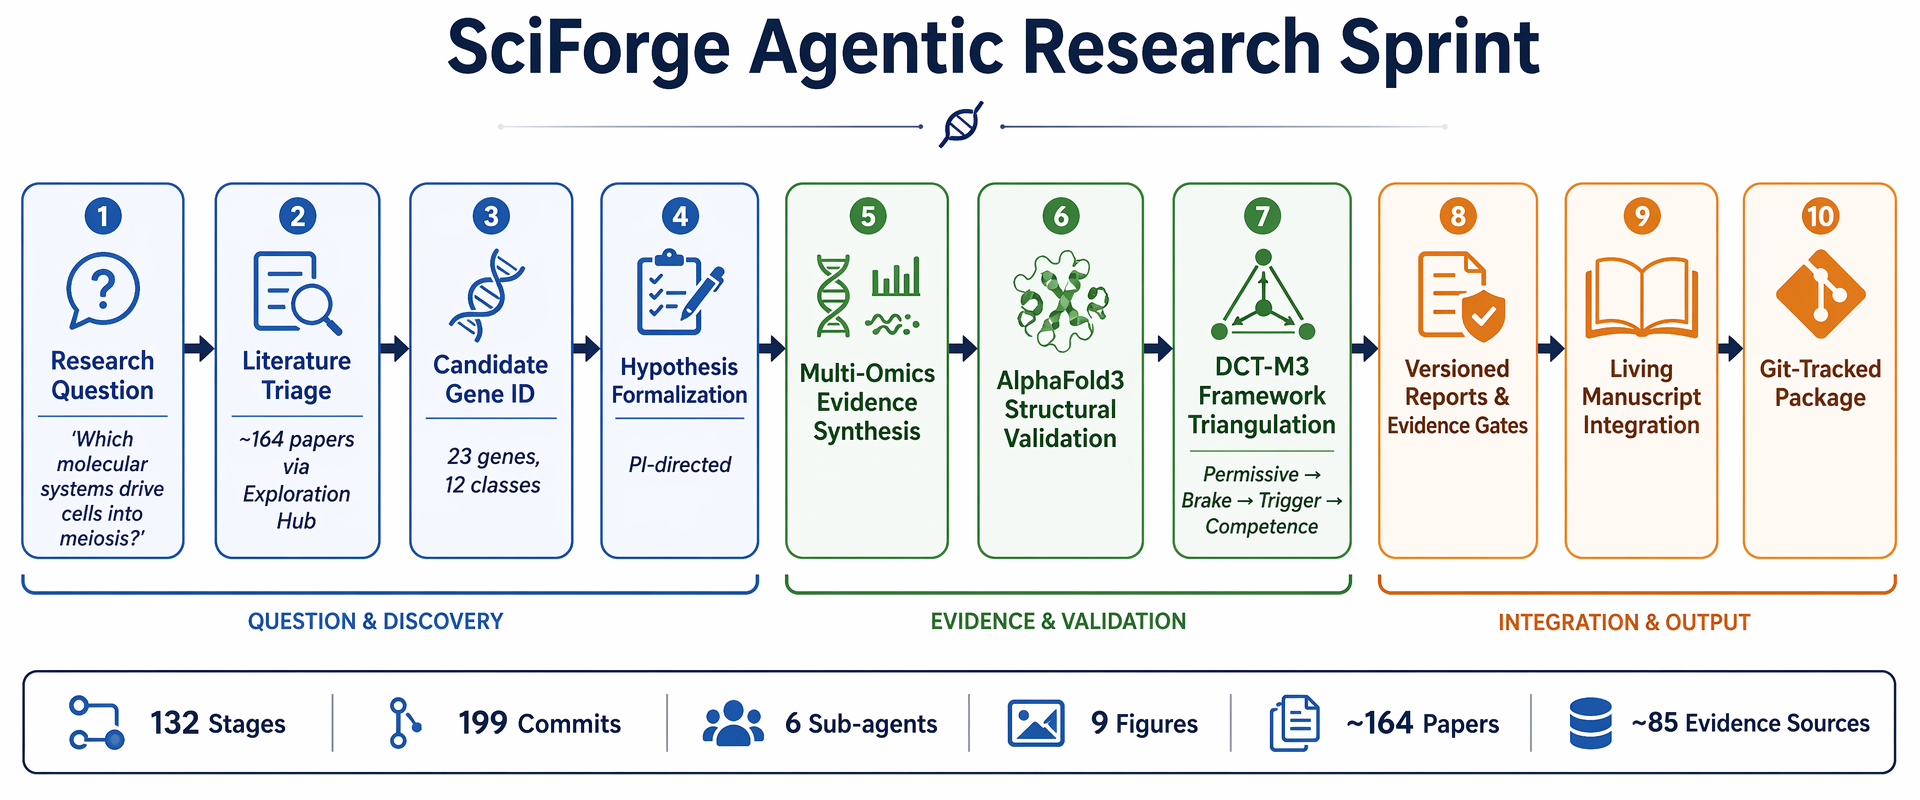
Lo sprint di esempio è deliberatamente ampio — nell’ordine di 164 articoli sottoposti a triage, 132 fasi, 199 commit, sei sub-agenti e circa 85 fonti di evidenza — perché è a questa scala che la chat sugli articoli collassa. Un riassuntore può descrivere l’articolo 17. Non può mantenere coerente una catena di 10 fasi quando la fase 4 modifica la regola di inclusione che la fase 2 ha già applicato.
Tre scelte progettuali di quella pipeline contano più dei dettagli di dominio:
- La scoperta è una fase, non il prodotto. Il triage della letteratura alimenta gli ID dei candidati e un’ipotesi formale. Fermarsi ai riassunti lascia la mappa incompiuta.
- La validazione è multimodale. La sintesi delle evidenze, i controlli strutturali o quantitativi e una logica esplicita «permissivo → freno → attivatore» obbligano le affermazioni a superare punti di controllo, invece di mediarle in un paragrafo.
- L’output è versionato. L’integrazione nel manoscritto dinamico e un pacchetto monitorato con git rendono la mappa un artefatto con una storia. È l’opposto di una trascrizione di chat che non puoi riprodurre.
Jenova può approssimare questo schema dividendo i ruoli tra Agenti anziché costringere una sola chat a svolgere il ruolo di bibliotecario, codificatore e autore. Academic Research Assistant gestisce la scoperta accademica e il contesto del manoscritto. Deep Research produce sintesi supportate da citazioni attraverso numerose fonti. Real-Time Search è utile quando la mappa deve includere anche preprint, repository o letteratura grigia non pubblicata su riviste. Il limite è la disciplina di orchestrazione: l’essere umano mantiene la responsabilità del protocollo, dei punti di controllo e della decisione di promuovere un’affermazione nel manoscritto dinamico. I gruppi metodologici continuano a considerare questo ruolo umano imprescindibile (linee guida KCL / RAISE).
Le piattaforme di revisione integrate in stile Paperguide cercano di condensare pianificazione–ricerca–screening–estrazione–generazione in un unico flusso di lavoro del fornitore, incluse modalità Extended che sottopongono a screening 200 candidati e scrivono a partire dai 50 migliori. Questo approccio è più vicino a uno spazio di lavoro rispetto a Elicit più Word, ma necessita comunque di un registro decisionale esterno se la provenienza conta dopo l’esportazione della revisione generata.
Come ottenere il massimo da una mappa delle evidenze basata su AI?
Ottieni il massimo da una mappa delle evidenze AI scrivendo il protocollo nello spazio di lavoro prima di chiedere del testo, quindi obbligando ogni sessione successiva a ereditare quel protocollo. La configurazione è simile tra gli strumenti; la differenza è se lo strumento può ricordarla.
Per una mappa incentrata su Jenova, una sequenza funzionale è:
- Apri Academic Research Assistant e indica il progetto, la popolazione e le dimensioni della mappatura nel primo messaggio.
- Fissa il protocollo in un linguaggio che l’assistente possa riutilizzare:
«Crea una mappa sistematica delle evidenze degli studi su esseri umani adulti riguardanti X. Includi soltanto RCT e coorti prospettiche. Codifica ogni studio in base a disegno, campione, intervento, esito primario, direzione dell’effetto e limitazioni. Metti gli articoli su animali e in-vitro in un registro delle esclusioni con una motivazione in una riga. Non rigenerare codici che sono già stati decisi.»
- Esegui Deep Research per il primo passaggio sul corpus, quindi incolla o allega nuovamente la tabella di lavoro nello stesso thread di progetto affinché estrazione e narrazione condividano un’unica memoria.
- Dopo ogni sessione, richiedi tre artefatti, non un solo testo: una tabella degli studi aggiornata, un registro delle esclusioni e un elenco delle lacune. Questi tre file sono la mappa.
Per Elicit, inizia con la domanda di ricerca, genera una tabella di screening e considera la libreria come la fonte di verità (flusso di lavoro per revisioni sistematiche di Elicit). Non saltare una ricerca convenzionale nei database. I casi di studio Cochrane hanno rilevato che Elicit è utile per ricerche preliminari ad alta precisione e per individuare ulteriori studi unici, non come unico motore di ricerca.
Per NotebookLM, raccogli prima i PDF, resta in un unico notebook e poni domande dimensione per dimensione («Elenca ogni studio che riporta l’esito Y, con dimensione del campione e follow-up») affinché il corpus chiuso non divaghi. I limiti di caricamento — 50 fonti nel piano gratuito, 300 con Plus — rendono questo lo strumento sbagliato per una mappa di 400 record, a meno che non effettui lo screening preliminare altrove.
Due regole di processo valgono per ogni stack. Primo, non caricare PDF a testo completo in un modello destinato ai consumatori se i termini di copyright lo vietano; i titolari dei diritti generalmente proibiscono tale utilizzo. Secondo, mantieni un essere umano nella posizione decisionale per inclusioni/esclusioni. L’assistenza allo screening è l’attività AI supportata dal maggior numero di evidenze; la sintesi non supervisionata è quella supportata dal minor numero di evidenze (rassegna di rassegne sulla maturità dell’AI).
Cosa dicono gli specialisti della sintesi delle evidenze sulla mappatura assistita da AI?
Gli specialisti accettano sempre più AI per lo screening e l’estrazione supervisionati, ma continuano a rifiutarla come cartografo non supervisionato di un settore. Il consenso utile degli esperti nel 2026 è più ristretto di quanto suggerisca il marketing dei fornitori: automatizza il livello ripetitivo, rendi persistente il livello decisionale e mantieni gli esseri umani responsabili della mappa.
«La modalità di errore che osserviamo non è che i modelli non sappiano riassumere un articolo. È che i team di mappatura trattano un buon riassunto come se fosse un record codificato. Una mappa sistematica delle evidenze è un insieme di decisioni reversibili — dentro, fuori, in attesa, filtrato — associate a campi stabili. Se tali decisioni vivono soltanto nel prompt della settimana scorsa, la mappa è già corrotta, anche quando ogni paragrafo continua a sembrare accurato.»
«Il recupero di riferimenti e la memoria operativa risolvono problemi diversi. Il recupero serve a trovare evidenze candidate. La memoria operativa serve a evitare di ricodificare lo stesso studio tre volte. Gli strumenti eccellenti nel primo compito vengono regolarmente impiegati come se svolgessero il secondo. È così che si ottiene un’analisi fluida delle lacune che non sa spiegare perché 12 trial al limite siano spariti.»
«La nostra regola operativa è semplice. Usa un motore per il corpus per popolare le righe. Usa uno spazio di lavoro persistente per mantenere attivi il codebook, il registro delle esclusioni e la tabella delle lacune. Usa un revisore umano a ogni punto di controllo che modifica il significato della mappa. Qualsiasi prodotto venduto come mappa sistematica in un clic ti chiede di saltare l’unico livello che i gruppi metodologici considerano ancora imprescindibile.»
— Team di prodotto Jenova, progettazione di flussi di lavoro di ricerca, 8 anni nella realizzazione di sistemi di conoscenza per il lavoro analitico su più sessioni
Questa posizione è coerente con le linee guida formali. NICE, le raccomandazioni RAISE collegate a Cochrane e i servizi bibliotecari universitari descrivono tutti AI come un supporto all’interno di metodi esistenti e validati. Una guida dinamica all’AI nella ricerca e nello screening della letteratura sostiene lo stesso argomento di efficienza — lo screening è costoso e l’automazione aiuta — senza affermare che la generazione possa sostituire il protocollo.
Quando i riassuntori di singoli articoli sono ancora la scelta giusta?
I riassuntori di singoli articoli restano la scelta giusta quando il corpus è piccolo, già raccolto e non viene codificato in una mappa riutilizzabile. Se hai 12 PDF, un journal club domani e nessuna necessità di aggiornare l’inventario tra tre mesi, una chat sugli articoli in stile NotebookLM o SciSpace completerà il lavoro con meno formalità rispetto a un contenitore di progetto.
Sono inoltre più adatti per altre tre attività che vengono erroneamente etichettate come mappatura:
- Spiegazione del meccanismo. «Guidami attraverso la Figura 3» è un’attività di lettura. Un notebook a corpus chiuso con citazioni cliccabili è più sicuro di uno spazio di lavoro aperto che potrebbe mescolare articoli diversi.
- Controlli del contesto citazionale. Se la domanda è se lavori successivi supportino o contrastino un’affermazione, le citazioni classificate di Scite sono il livello progettato allo scopo (1,6 miliardi+ di Smart Citations).
- Verifiche puntuali delle ipotesi. Consensus rimane il modo più rapido per vedere se una proposizione mostra una chiara divisione tra supporto e contrasto prima di investire nella mappa (panoramica Elicit vs Consensus).
L’errore consiste nell’usare questi punti di forza come sostituti di un’infrastruttura per SEM. Un riassuntore può essere eccellente localmente e restare comunque il sistema di registrazione sbagliato. Al contrario, uno spazio di lavoro persistente può mantenere vivo un codebook disordinato e restare lo strumento sbagliato per uno screening doppio di 5.000 record se hai bisogno di software dedicato alle revisioni sistematiche. Le guide istituzionali continuano a indirizzare i team verso piattaforme di screening quali Rayyan, Covidence e DistillerSR per questa fase (guida CASRAI sull’AI per revisioni sistematiche; guida alle revisioni sistematiche di Stony Brook).
La regola decisionale che resiste al contatto con revisioni reali è quindi architetturale, non basata sul brand. Se il prodotto del lavoro è un insieme di decisioni di codifica comparabili, aggiornabili e spiegabili, scegli uno spazio di lavoro di ricerca con memoria di progetto e affiancagli un motore per il corpus. Se il prodotto del lavoro è comprendere gli articoli già sulla tua scrivania, un riassuntore di singoli articoli non è un compromesso. È lo strumento correttamente dimensionato.
Riferimenti
- ScienceDirect — Linee guida per la realizzazione di mappe sistematiche delle evidenze
- PubMed Central — Metodologia per revisioni di mappatura, mappe delle evidenze e mappe delle lacune
- Paperguide — I 7 migliori strumenti AI per la revisione della letteratura nel 2026
- King’s College London — Strumenti AI nella sintesi delle evidenze
- Elicit — AI per la ricerca scientifica
- NotebookLM — Strumento di ricerca AI e partner di riflessione
- Google Blog — NotebookLM aggiunge Deep Research, Docx, Sheets e altro
- The Drive AI — Elicit contro Consensus contro Semantic Scholar
- Omid Saffari — I migliori strumenti di ricerca AI nel 2026: Elicit contro Consensus
- Guida all’uso di AI nella ricerca e nello screening della letteratura
- CASRAI — Strumenti AI per revisioni sistematiche della letteratura
- Biblioteche della Stony Brook University — Guida alla revisione sistematica: Intelligenza artificiale