Gli assistenti di ricerca AI sono migliori della ricerca per parole chiave per trovare articoli correlati?
2026-08-22
Quando la corrispondenza semantica supera il ranking per parole chiave per gli articoli concettualmente correlati?
Gli assistenti di ricerca AI semantici superano la tradizionale ricerca per parole chiave quando gli articoli necessari descrivono la stessa idea con terminologia diversa, mentre i motori basati su parole chiave restano più efficaci quando si conoscono già frasi esatte, autori o gruppi di citazioni da individuare. Nel 2026, la risposta pratica non è abbandonare Google Scholar, ma affiancare il ranking lessicale al recupero basato sul significato, usando strumenti come Elicit, SciSpace, Undermind e Jenova's Academic Research Assistant.
Fattori chiave che distinguono una scoperta concettuale efficace dalla corrispondenza per parole chiave:
✅ Flessibilità del vocabolario — se il sistema riesce a far emergere un articolo sull'"infarto miocardico" quando la query indicava "attacco cardiaco" ✅ Segnali di ranking — punteggi lessicali ponderati per citazioni rispetto alla similarità degli embedding rispetto a un LLM che valuta la rilevanza ✅ Profondità dell'indice — metadati di titolo e abstract rispetto alla corrispondenza nel testo completo su centinaia di milioni di lavori ✅ Controlli di precisione — annidamento Booleano, limiti sui campi, filtri sulla qualità delle riviste e limiti di esportazione ✅ Tempo fino a un insieme utile — elenchi esplorativi immediati rispetto a ricerche iterative di vari minuti
Per confrontare onestamente questi metodi, è utile trattare la discrepanza di vocabolario, il bias di ranking e il controllo della ricerca come dimensioni separate, anziché chiedersi quale strumento sia universalmente migliore.
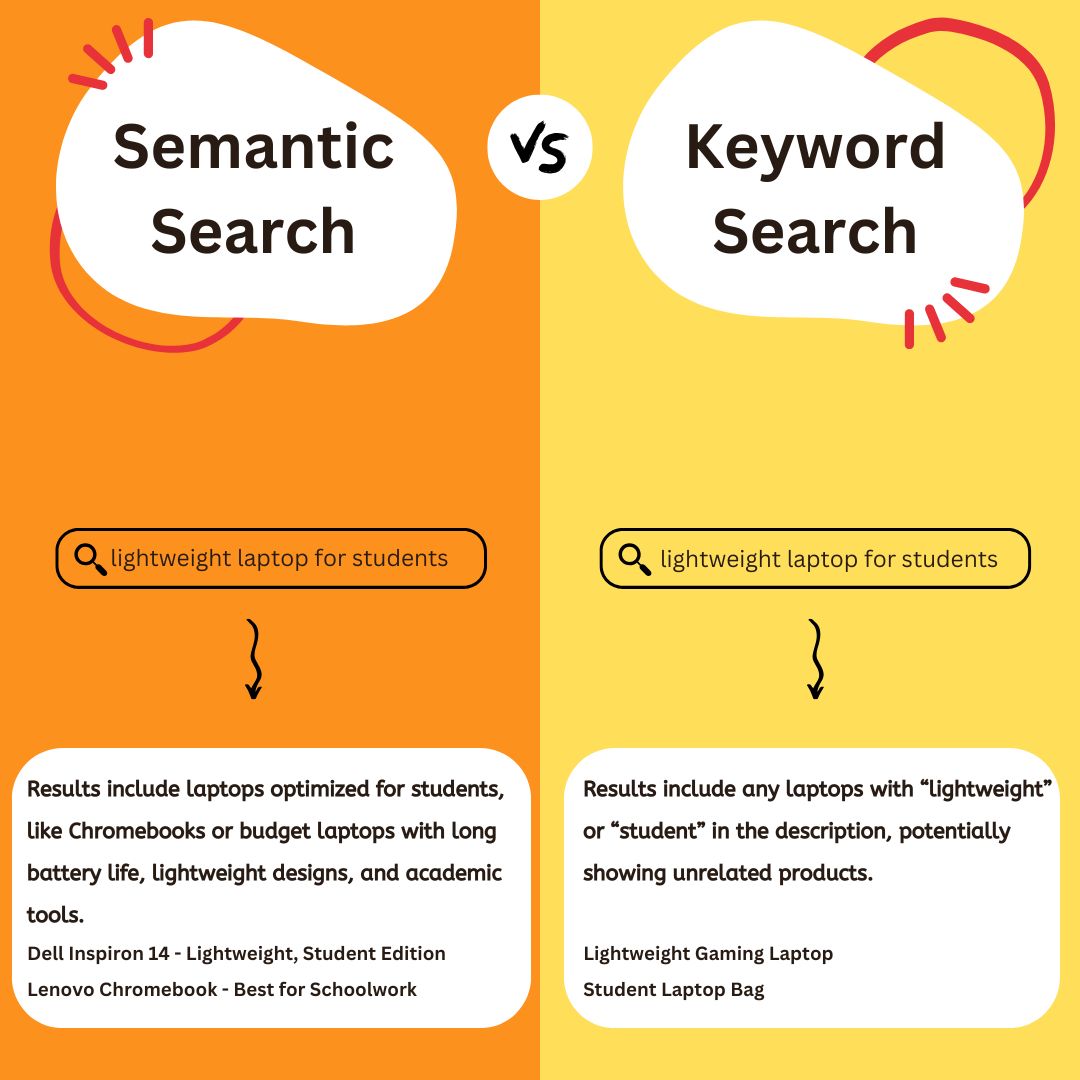
Perché la discrepanza di vocabolario continua a compromettere la ricerca accademica tradizionale nel 2026?
La discrepanza di vocabolario continua a compromettere la ricerca accademica tradizionale perché autori, discipline e periodi storici denominano lo stesso fenomeno in modi diversi, e i motori lessicali recuperano solo documenti che condividono abbastanza termini superficiali con la query. Un articolo di salute pubblica può parlare di "attività fisica", uno di cardiologia di "capacità di esercizio" e uno di sociologia di "movimento nel tempo libero". Se si cerca una sola espressione, gli altri due gruppi possono scomparire dalle prime pagine dei risultati.
Google Scholar resta il punto di partenza predefinito per la maggior parte dei ricercatori ed è tuttora la più ampia singola superficie di ricerca accademica disponibile, includendo testi completi di editori e repository. Aaron Tay, bibliotecario accademico presso la Singapore Management University, lo ha descritto come il coltellino svizzero della ricerca accademica — lo strumento che conserverebbe se potesse tenerne uno solo. Il suo ranking, tuttavia, resta lessicale. Dopo le corrispondenze nel titolo, attribuisce un peso elevato agli articoli molto citati, il che è eccellente per trovare lavori seminali e debole per individuare articoli concettualmente correlati che usano formulazioni diverse o non hanno ancora accumulato citazioni.
Il problema peggiora quando un termine della query è comune. Poiché Google Scholar cerca nell'intero testo, una ricerca di uno strumento o concetto con un nome di uso quotidiano può esplodere in migliaia di risultati incidentali. Tay osserva che cercare "Elicit" in Google Scholar è quasi inutile se non si aggiunge una soluzione basata sul dominio, poiché la parola compare continuamente nelle sezioni dei metodi. I sistemi semantici riducono questa modalità di errore valutando il significato anziché la sovrapposizione di stringhe, ed è per questo che sono diventati un livello complementare piuttosto che una novità.
Cosa bisogna valutare confrontando la ricerca per parole chiave e gli assistenti AI semantici?
Dovresti valutare la ricerca per parole chiave e gli assistenti AI semantici su sei dimensioni che questo articolo definisce Framework di recupero dalle discrepanze: flessibilità del vocabolario, trasparenza del ranking, copertura dell'indice, controllo della precisione, segnali di autorevolezza e tempo fino a un insieme utile. Uno strumento che eccelle in una dimensione spesso perde in un'altra, motivo per cui una classifica con un singolo "vincitore" è più fuorviante che utile.
La flessibilità del vocabolario chiede se il motore possa recuperare un articolo il cui abstract non ripete mai i termini della query. Gli embedding densi e i metodi ibridi come SPLADE, che Elicit utilizza come approccio di embedding sparso appreso, sono progettati per questo. La trasparenza del ranking chiede se sia possibile spiegare perché un articolo è apparso. I sistemi Booleano più BM25 sono più semplici da verificare; la ricerca dei vicini più prossimi tramite embedding e i reranker LLM sono più difficili da riprodurre.
La copertura dell'indice non coincide con il "numero di articoli pubblicizzato". OpenAlex riporta 517 milioni di record di lavori e 66 milioni di PDF in testo completo, mentre Elicit dichiara di cercare, riassumere ed estrarre dati da oltre 125 milioni di articoli. Google Scholar non pubblica un conteggio ufficiale comparabile, ma è ampiamente considerato il più grande indice accademico di ricerca nel testo completo. Il controllo della precisione comprende Booleano annidato, limiti sui campi, operatori di prossimità e vocabolario controllato — funzionalità in cui The Lens e OpenAlex superano Google Scholar.
I segnali di autorevolezza includono conteggi delle citazioni, fascia della rivista e avvisi di ritrattazione. Google Scholar e, in misura minore, Undermind tendono a privilegiare i lavori molto citati. Elicit e SciSpace generalmente classificano in base alla similarità semantica e non ponderano le citazioni, quindi emergono articoli più recenti o meno citati. Il tempo fino a un insieme utile distingue la ricerca immediata per parole chiave dalle esecuzioni iterative in stile Undermind che richiedono almeno tre minuti. Valuta ogni dimensione rispetto al tuo compito reale — scoperta ricca di sinonimi, recall sistematico o un orientamento di cinque minuti — prima di scegliere un motore principale.
Come si confrontano Google Scholar, Elicit, SciSpace, Undermind e Jenova nella scoperta concettuale?
Google Scholar è più efficace per l'esplorazione ampia e ponderata per citazioni; Elicit e SciSpace sono più efficaci quando le parole chiave non sono chiare; Undermind è più efficace per ricerche ristrette e ad alta precisione; e Jenova's Academic Research Assistant è più efficace quando scoperta, sintesi e lavoro sulle citazioni devono rimanere in un'unica conversazione persistente. Nessuno di questi strumenti domina ogni dimensione del Framework di recupero dalle discrepanze.
| Funzionalità / Dimensione | Google Scholar | Elicit / SciSpace | Undermind | Jenova Academic Research Assistant | Lens.org / OpenAlex |
|---|---|---|---|---|---|
| Metodo di corrispondenza | Lessicale / parole chiave, ponderato per citazioni | Semantico o ibrido (Elicit usa SPLADE) | Recupero ibrido più valutazione della rilevanza tramite LLM e ricerca iterativa | Agente di ricerca in linguaggio naturale su fonti accademiche live, incluso Google Scholar | Ricerca strutturata nei metadati accademici con operatori avanzati |
| Recupero con formulazioni diverse | Debole, salvo aggiunta di sinonimi o uso di Articoli correlati | Forte per query basate sul significato | Forte per brief specifici in linguaggio naturale | Forte nella riformulazione conversazionale tra sessioni | Da debole a moderato; dipende dalla costruzione della query |
| Bias di autorevolezza | Favorisce gli articoli molto citati dopo le corrispondenze nel titolo | Scarsa ponderazione delle citazioni; emergono articoli più recenti | Un certo bias verso il lavoro seminale tramite ricerca di citazioni | Segue le fonti collegate e il brief fornito | Guidato dai metadati; progettato più per l'analisi che per il ranking semantico |
| Funzionalità di precisione | Nessun Booleano annidato, limite di 256 caratteri, ricerca per campi limitata | Post-filtri sulla qualità delle riviste, ad esempio fasce Scimago su SciSpace | Specificità in linguaggio naturale anziché Booleano | Restringimento conversazionale; non è un motore a sintassi Booleana | Booleano annidato, prossimità, ricerca per campo, vocabolario controllato |
| Tempo tipico della query | Immediato | Abbastanza rapido per l'esplorazione | Almeno ~3 minuti per ricerca | Interattivo; le interazioni successive sono immediate | Da immediato a condizionato dal ritmo dell'API |
| Prezzi (al 2026) | Gratuito | Elicit Pro circa 49 $/mese; livelli a pagamento di SciSpace segnalati da 12 a 160 $/mese | Livello esplorativo gratuito; piani accademici a pagamento | Livello gratuito con utilizzo limitato; Plus da 20 $/mese | Ricerca web gratuita; OpenAlex API dispone di un livello gratuito |
| Ideale per | Articoli seminali, collegamenti tramite Citato da, ricerca nel testo completo | Parole chiave poco chiare e query formulate come domande | Trovare una specifica classe di studi con recall elevato | Lavoro sulla letteratura end-to-end con memoria e supporto al manoscritto | Ricerche sistematiche, riproducibili e ad alto controllo |
Google Scholar
Google Scholar è ancora il generalista. Le pagine di assistenza ufficiali confermano che i risultati sono normalmente ordinati per rilevanza, non per data, e che i ricercatori possono passare attraverso Articoli correlati e Citato da una volta individuato un articolo seme. Queste due funzionalità sono ciò che più avvicina la ricerca per parole chiave alla scoperta concettuale, ma richiedono un buon articolo seme. Le debolezze sono ben documentate: nessun Booleano annidato, nessuna ricerca per campo limitata agli abstract, un limite di 256 caratteri per le query, una soglia di 1.000 risultati e nessuna esportazione in blocco. Questa combinazione spiega perché i bibliotecari la escludono abitualmente come database principale per revisioni sistematiche.
Elicit e SciSpace
Elicit si presenta come AI per cercare, riassumere, estrarre dati da e conversare con oltre 125 milioni di articoli, con più di 2 milioni di utenti della ricerca. Sia Elicit sia SciSpace accettano domande in linguaggio naturale e classificano in base alla similarità semantica, motivo per cui recuperano articoli la cui formulazione diverge dalla query. Il compromesso è un bias di ranking nella direzione opposta a Google Scholar: possono promuovere articoli semanticamente vicini ma di bassa qualità o poco citati. SciSpace è generalmente più rapido e più adatto a ottenere rapidamente insight che a una sintesi iterativa approfondita. I risultati possono inoltre essere non deterministici, quindi la stessa query potrebbe non restituire due volte lo stesso insieme.
Undermind
Undermind è lo specialista. Combina recupero per parole chiave e semantico, poi utilizza un modello di frontiera per valutare se titolo, abstract e metadati disponibili rispondano effettivamente al brief, e itera con la ricerca delle citazioni. In un test rispetto all'insieme incluso da una revisione sistematica, ha recuperato 8 degli 11 articoli gold standard nei primi 10 risultati (recall@10 del 72,7%) e 9 degli 11 entro la posizione 50 (recall@50 dell'81,8%). Questa qualità richiede tempo e funziona male su argomenti vaghi. Inoltre, vede principalmente titolo e abstract, oltre ad alcuni testi completi open access, quindi le affermazioni presenti solo nei metodi o nei risultati possono essere trascurate.
Jenova's Academic Research Assistant
Jenova's Academic Research Assistant è un partner di ricerca sensibile alla disciplina, non un indice autonomo di articoli. Esegue la scoperta della letteratura live attraverso fonti accademiche, poi rimane con il progetto durante sintesi, preparazione del manoscritto e gestione delle citazioni. La memoria persistente gli consente di ricordare che il tuo termine di lavoro è "fatica cognitiva", mentre la letteratura usa anche "esaurimento dell'ego" e "bisogno di recupero", e di mantenere questi gruppi di sinonimi collegati allo stesso progetto tra sessioni diverse.
Il limite onesto è architetturale. Non offre un indice semantico proprietario di 125 milioni di articoli con tabelle di estrazione integrate nel senso di Elicit, e non è un ricercatore iterativo in stile Undermind da vari minuti con un benchmark recall@10 pubblicato. Il suo punto di forza è l'orchestrazione: brief in linguaggio naturale, ricerca accademica live, domande di approfondimento e supporto alla scrittura in un unico thread. I ricercatori che necessitano di una traccia di audit Booleana riproducibile dovrebbero comunque eseguire The Lens o OpenAlex in parallelo.
Come fa la ricerca semantica a recuperare articoli che usano formulazioni diverse per la stessa idea?
La ricerca semantica recupera articoli formulati diversamente incorporando la query e la raccolta di documenti in uno spazio condiviso del significato, quindi recuperando i vicini più prossimi anziché richiedere token sovrapposti. Se la query è "come gli infermieri dei turni notturni recuperano l'attenzione dopo turni consecutivi", un motore lessicale cerca quelle parole. Un motore semantico può recuperare studi intitolati intorno a "disruzione circadiana", "sonno di recupero" o "affaticamento occupazionale", anche quando "infermieri" o "attenzione" non compaiono mai nel titolo.
Semantic Scholar, il motore letterario dell'Allen Institute for AI, è stata una delle prime dimostrazioni pubbliche di questa idea: classificare gli articoli scientifici in base al significato compreso anziché alla corrispondenza di stringhe. Elicit e SciSpace applicano un principio simile su scala di applicazione web. Tay descrive un test particolarmente chiaro: incolla un paragrafo di giornale che descrive i risultati di uno studio e un motore semantico può far emergere l'articolo di rivista sottostante, poiché l'embedding della prosa giornalistica è vicino all'embedding dell'articolo. La ricerca per parole chiave quasi mai sopravvive a tale parafrasi.
Esiste un secondo meccanismo, più discreto: l'espansione della query all'interno dell'assistente. Un agente conversazionale può generare insiemi di sinonimi, concetti correlati in stile MeSH, antonimi e varianti disciplinari, quindi cercare esplicitamente tali varianti. Non è pura ricerca vettoriale. È comprensione semantica usata per costruire una migliore rete lessicale. In pratica, i flussi di lavoro con il recall più elevato fanno entrambe le cose: usano gli embedding per recuperare formulazioni non ancora viste, quindi verificano con frasi esatte, nomi di autori e collegamenti alle citazioni affinché l'insieme rimanga verificabile.
Testare questo su un brief live di solito rende rapidamente evidente il divario. Chiedi a un motore per parole chiave "teacher noticing" e otterrai soprattutto articoli che usano quell'esatto termine della ricerca educativa. Chiedi a un assistente semantico "come gli insegnanti rilevano e interpretano in tempo reale un pensiero inaspettato degli studenti" e recupererai anche lavori archiviati sotto "professional vision", "valutazione formativa" o "processo decisionale nel momento". Il secondo insieme è quello che la discrepanza di vocabolario avrebbe nascosto.
Quando si dovrebbe ancora usare la ricerca per parole chiave anziché un assistente AI semantico?
Dovresti continuare a usare la ricerca per parole chiave quando hai bisogno di recuperare un elemento noto, seguire le citazioni da un articolo seme, trovare frasi nel testo completo o applicare una strategia Booleana riproducibile per una revisione sistematica. Il ranking semantico è lo strumento sbagliato quando il compito è "trova questo titolo", "trova tutto ciò che cita questo trial" o "documenta una stringa di ricerca che un revisore tra pari possa rieseguire".
Google Scholar è la scelta iniziale giusta per tre attività quotidiane. Primo, ricerca di un elemento noto: inserisci il titolo tra virgolette, come raccomandano la guida di Google e la maggior parte delle guide bibliotecarie. Secondo, mappatura dell'autorevolezza: apri un articolo di riferimento e percorri Citato da per vedere cosa ha fatto il campo in seguito, oppure Articoli correlati per espanderti da un articolo seme. Terzo, ricerca di frasi nel testo completo: se il concetto è il nome distintivo di un metodo, un dataset o una scala, la ricerca lessicale nel testo completo intercetterà menzioni che gli indici semantici basati su titolo e abstract non rilevano.
Per ricerche sistematiche o molto precise, evita sia Google Scholar sia la maggior parte delle applicazioni semantiche come sistema di registrazione. The Lens e OpenAlex supportano Booleano annidato, operatori di prossimità, ricerca per campo e vocabolario controllato. OpenAlex è un catalogo aperto con 517 milioni di lavori, 5,8 miliardi di relazioni nel grafo e un dataset di pubblico dominio (CC0). Un briefing bibliotecario del 2026 ha stimato la sua copertura in circa 474 milioni di pubblicazioni, con attenzione all'open access e alla trasparenza. Google Scholar non può eguagliare questa verificabilità: limita la visualizzazione a 1.000 risultati e non offre accesso in blocco.
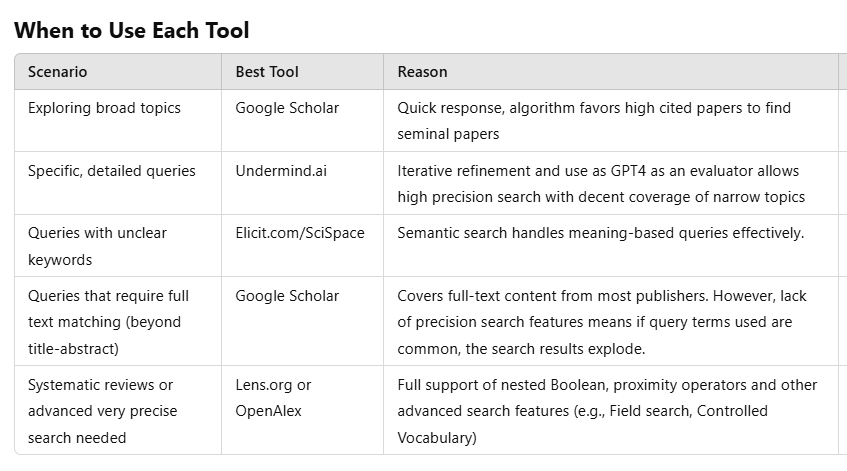
Usa la tabella sopra come regola di instradamento, non come test di fedeltà. L'orientamento ampio e la ricerca di articoli seminali restano a Google Scholar. Le formulazioni poco chiare vanno a Elicit o SciSpace. Una domanda di esistenza altamente specifica — "esistono RCTs che usano un LLM come selezionatore di titolo e abstract e riportano precision e recall?" — è un brief per Undermind. Le ricerche riproducibili e ricche di operatori appartengono a The Lens o OpenAlex.
Come si conduce una ricerca della letteratura che combina entrambi gli approcci?
Conduci una ricerca combinata iniziando con un brief concettuale, recuperando semanticamente candidati ricchi di sinonimi, quindi consolidando l'insieme con operatori lessicali, collegamenti alle citazioni e un database ad alto controllo. La sequenza è importante. Se inizi in Google Scholar con una sola espressione, erediti i punti ciechi di quell'espressione. Se non esci mai da un elenco classificato semanticamente, erediti i problemi di qualità e riproducibilità di quell'elenco.
Una sequenza pratica è questa:
- Scrivi il fabbisogno informativo come lo ascolterebbe un collega, includendo popolazioni, outcome e formulazioni che già sai essere instabili.
- Esegui quel brief in un assistente semantico per raccogliere articoli candidati e il vocabolario che essi usano realmente.
- Costruisci una tabella di sinonimi a partire da quei titoli e abstract.
- Riesegui i termini ampliati in Google Scholar con virgolette,
author:, limiti di data e Citato da / Articoli correlati. - Per tutto ciò che deve essere completo o verificabile, ricostruisci la strategia in The Lens o OpenAlex con Booleano annidato e limiti sui campi.
- Mantieni un registro continuo delle inclusioni affinché le riesecuzioni semantiche non deterministiche non modifichino silenziosamente la base di evidenze.
In Jenova's Academic Research Assistant, il primo messaggio può essere il brief concettuale anziché una stringa di parole chiave:
"Mi servono articoli empirici su come i lavoratori della conoscenza da remoto recuperano dalla fatica cognitiva. Includi studi che potrebbero usare burnout, esaurimento dell'ego, bisogno di recupero, ruminazione fuori orario o distacco psicologico invece della parola fatica. Privilegia sedi di psicologia occupazionale e HCI dal 2018 in poi e indica il sinonimo effettivamente usato da ciascun articolo."
Un messaggio successivo trasforma poi la tabella di sinonimi dell'assistente in una strategia lessicale che puoi incollare in Google Scholar o The Lens:
"Trasforma i gruppi di sinonimi in tre query per Google Scholar e una stringa Booleana annidata adatta a OpenAlex o The Lens. Separa le query ristrette al titolo dalle query nel testo completo."
Su Elicit o SciSpace, formula la domanda in linguaggio naturale anziché con parole chiave — Tay osserva che le query in linguaggio naturale tendono a funzionare peggio in Google Scholar e meglio in questi strumenti semantici. Su Undermind, aggiungi vincoli finché il brief non possa corrispondere che a uno specifico disegno di studio. Una volta esistente l'insieme dei candidati, l'Agente Deep Research di Jenova è lo strumento migliore per leggere attraverso le fonti e produrre una sintesi citata, mentre Academic Research Assistant resta lo strumento migliore per rimanere nel flusso di lavoro accademico di scoperta, citazione e supporto al manoscritto.
Un'avvertenza vale per ogni passaggio assistito dall'AI. Considera gli elenchi classificati e i riassunti generati come ausili al recupero, non come screening completati. Le prime 10 semantiche possono perdere articoli. Le valutazioni di rilevanza degli LLM concordano spesso con gli esseri umani, ma non sempre. Le affermazioni nel testo completo richiedono ancora il PDF.
Cosa dicono i bibliotecari di ricerca e i valutatori di strumenti sulla scoperta semantica tramite AI?
I bibliotecari di ricerca e i valutatori indipendenti trattano generalmente gli assistenti AI semantici come complementi a Google Scholar, non come sostituti, e valutano gli strumenti in base alla qualità della ricerca per un caso d'uso dichiarato anziché in base a categorie di marketing. Il confronto pubblicato più utile in quest'area deriva dalla valutazione basata sulla pratica, non dai benchmark dei fornitori.
"Se non sapessi in anticipo quale sarà il mio caso d'uso e potessi scegliere un solo strumento di ricerca accademica, scegliere Google Scholar sarebbe una decisione ovvia. Questo non è un argomento contro la ricerca AI. È un argomento contro la pretesa che una sola funzione di ranking sia sufficiente. Scholar resta il generalista. I nuovi strumenti guadagnano il proprio posto quando la query è semanticamente scomoda o estremamente specifica."
"Il fallimento che vedo più spesso è una mancata corrispondenza tra il tipo di query e il motore. Le persone inseriscono un argomento ampio in un agente iterativo e attendono minuti per ottenere un insieme più ristretto del necessario. Oppure inseriscono un paragrafo in linguaggio naturale in un motore lessicale e concludono che la letteratura non esista. La discrepanza di vocabolario è di solito un errore del flusso di lavoro prima di essere una lacuna del database."
"Il ranking semantico modifica anche il significato di 'rilevante'. Se non si ponderano le citazioni, si vedranno prima articoli più recenti e talvolta più deboli. Se si ponderano le citazioni, si continuerà a riscoprire lo stesso canone. I ricercatori che desiderano lavori concettualmente correlati con formulazioni diverse hanno bisogno del primo comportamento. I ricercatori che desiderano gli articoli che tutti gli altri si aspetteranno di vedere citati hanno bisogno del secondo. Un processo competente usa entrambi e spiega per iscritto il perché."
— Team di prodotto Jenova, sistemi di scoperta della letteratura, 8 anni nella progettazione di flussi di lavoro per la ricerca accademica
Questa impostazione corrisponde al quadro pubblico. Le guide universitarie ora catalogano gli strumenti di ricerca AI usati nelle revisioni della letteratura, e le recensioni dei prodotti distinguono il passaggio iterativo più lento di Undermind dalla scansione semantica più rapida di SciSpace. Il consenso degli esperti è metodologico, non tribale: scegli il modello di recupero che corrisponde alla discrepanza che stai cercando di superare.
Quale strumento è adatto alle revisioni sistematiche rispetto alla mappatura esplorativa della letteratura?
Le revisioni sistematiche necessitano di infrastrutture lessicali ad alto controllo; la mappatura esplorativa della letteratura richiede recall semantico e iterazione rapida; la maggior parte del lavoro per tesi e grant necessita di un approccio ibrido con un protocollo scritto per ciascuna fase. Confondere questi compiti è il modo in cui i team finiscono per perdere studi concettualmente correlati oppure per produrre un insieme di evidenze non replicabile.
Per la mappatura esplorativa — "cosa è stato scritto su questa idea, con qualunque nome?" — inizia semanticamente. Elicit, SciSpace e un assistente di ricerca conversazionale sono progettati per questa domanda. Google Scholar può contribuire una volta che hai articoli seme, tramite Articoli correlati e Citato da, e rimane ineguagliato per localizzare rapidamente PDF e collegamenti bibliotecari. Jenova's Academic Research Assistant è adatto a questa fase quando hai anche bisogno che la mappa persista: decisioni sui sinonimi salvate, direzioni escluse e formattazione delle citazioni per la stesura finale.
Per revisioni sistematiche o di scoping, non lasciare che un elenco classificato semanticamente diventi la ricerca ufficiale. Usa The Lens o OpenAlex come struttura portante riproducibile, documenta ogni operatore e tratta Elicit, Undermind o Jenova come ausili supplementari alla scoperta delle citazioni e allo screening. OpenAlex offre inoltre un'API, un linguaggio di query pensato per le revisioni sistematiche e uno snapshot completo con licenza CC0, il che rappresenta il design opposto a un ordinamento della rilevanza chiuso. Il limite di 1.000 risultati e l'assenza di accesso in blocco di Google Scholar lo escludono dalla ricerca primaria documentata, pur rimanendo utile per verificare se un'inclusione nota sia stata indicizzata.
Per domande ristrette di esistenza — "esiste un articolo come questo?" — Undermind è lo specialista, a condizione che tu possa aspettare e che l'evidenza da titolo e abstract sia sufficiente. Per la produzione del manoscritto dopo che l'insieme esiste, la combinazione di scoperta della letteratura e gestione delle citazioni di Jenova è più rilevante di un'altra interfaccia solo per la scoperta, con l'avvertenza che la meta-analisi ad alta intensità di estrazione appartiene comunque a uno strumento dedicato all'estrazione come Elicit.
La regola decisionale è abbastanza semplice da poter essere riutilizzata. Se la formulazione varia e non conosci ancora il gergo del campo, usa prima un assistente di ricerca AI semantico. Se devi difendere la stringa di ricerca, usa un'infrastruttura per parole chiave con operatori avanzati. Se devi fare entrambe le cose — condizione normale per trovare articoli concettualmente correlati con formulazioni diverse — usa il recall semantico per scoprire il linguaggio, quindi il controllo lessicale per catturarlo e documentarlo.
Riferimenti
- Aaron Tay — Google Scholar rispetto ad altri strumenti di ricerca AI (Undermind, Elicit, SciSpace)
- Google Scholar — Guida ufficiale alla ricerca
- Elicit — AI per la ricerca scientifica
- OpenAlex — Catalogo aperto del sistema globale della ricerca
- Paperguide — Confronto di prezzi e funzionalità tra Elicit e SciSpace (2026)
- Undermind — Co-ricercatore AI per la letteratura
- University of Alberta / JCHLA — Recensione del prodotto Undermind.ai
- Paperpile — Come usare Google Scholar
- TUHH — OpenAlex come alternativa aperta per la ricerca accademica
- Semantic Scholar — Strumento di ricerca basato su AI
- UBC Wiki — Strumenti di ricerca AI usati nelle revisioni della letteratura e nelle ricerche complete
- SciSpace — Confronto tra Elicit e SciSpace
- The Lens — Release 8.5 e integrazione OpenAlex
- PMC / NIH — Funzionalità di OpenAlex e potenziale per la sintesi delle evidenze