Backend per Agenti AI: un'unica API o sviluppo da zero (luglio 2026)
2026-07-24
Ogni team di ingegneria che rilascia funzionalità AI nel 2026 si trova davanti allo stesso bivio: costruire il backend dell'Agente da zero oppure integrarene uno. Costruirlo significa assemblare API di modelli, framework di orchestrazione, database vettoriali, archivi di memoria e server di strumenti — uno stack che assorbe trimestri di lavoro ingegneristico prima della prima interazione utente. La Jenova Agent API è l'alternativa: un backend per Agenti completamente gestito, in cui orchestrazione, memoria, archiviazione, RAG e strumenti operano dietro un'unica integrazione.
- ✅ Sostituisci l'intero stack di Agenti fai-da-te — routing dei modelli, orchestrazione, memoria, RAG e strumenti — con una sola API
- ✅ Crea e lancia Agenti personalizzati pronti per la produzione, definiti dalle tue istruzioni, dai modelli, dalle basi di conoscenza e dagli strumenti
- ✅ Accedi ai modelli di OpenAI, Anthropic, Google, xAI, Qwen e altri tramite un'unica credenziale
- ✅ Opera su un'infrastruttura testata in produzione con oltre 30.000 utenti in più di 70 Paesi
Per prendere una decisione onesta tra costruire e integrare, servono i numeri reali: quanto costa davvero costruire, gestire e mantenere un backend per Agenti da zero nel 2026.
Risposta rapida: cos'è un backend per Agenti AI?
Un backend per Agenti AI è il livello infrastrutturale che fa funzionare un Agente in produzione: orchestrazione tra modelli e strumenti, memoria e contesto persistenti, recupero di informazioni su dati privati e sistemi di calcolo, scalabilità e affidabilità sottostanti. Costruirlo da zero significa gestire cinque o più sistemi distinti; un'API per Agenti gestita offre tutti questi elementi tramite un'unica integrazione.
Funzionalità chiave di un backend per Agenti gestito:
- Orchestrazione dell'Agente che coordina modelli, strumenti, memoria e recupero delle informazioni nei workflow a più passaggi
- Routing multi-modello tra provider — nessun vendor lock-in, nessuna gestione delle chiavi per singolo provider
- Memoria conversazionale e contesto illimitati integrati in ogni sessione
- Archiviazione relazionale e vettoriale completamente gestita con RAG integrato
- Integrazione di strumenti tramite strumenti nativi della piattaforma e qualsiasi server MCP remoto
Il problema: quanto costa davvero costruire da zero
La pressione del mercato per rilasciare Agenti è intensa. Il software enterprise è sulla buona strada per includere AI agentica nel 33% delle applicazioni — in aumento da meno dell'1% nel 2024 (Datagrid) — e il 67% dei dirigenti C-suite prevede Agenti AI operativi in autonomia all'interno delle proprie organizzazioni entro il 2027 (VAST Data).
Ma costruire il backend che ne supporta uno è estremamente costoso e lento:
- Logica di orchestrazione che diventa una seconda disciplina ingegneristica
- API di modelli stateless senza memoria tra una chiamata e l'altra
- Pipeline RAG con modalità di errore ricorrenti e ben documentate
- Infrastruttura di integrazione degli strumenti per ogni capacità esterna
- Infrastruttura di produzione che deve scalare, restare affidabile e superare le revisioni di sicurezza
- Un costo totale del primo anno che supera di gran lunga ogni stima del prototipo
Il budget reale: le chiamate ai modelli sono il 2% della storia
La demo dell'Agente da $100/mese nasconde la reale struttura dei costi. Un'analisi ingegneristica dettagliata stima il costo realistico del primo anno per un Agente di produzione piccolo o medio in **$270,000–$690,000** — con le chiamate API dei modelli che rappresentano circa il 2% del totale (Particle41).
Il resto finisce nei costi che nessun video demo mostra:
$30,000–$80,000 — solo per il prompt engineering iniziale e il relativo perfezionamento, su 200–400 ore ingegneristiche valutate $150–200/ora (Particle41)
$1,000–$5,000/mese — hosting del database vettoriale, più altri $1,000–$2,000/mese per la generazione degli embedding (Particle41)
$30,000–$60,000 — sviluppo per l'integrazione dei dati, per collegare l'Agente a soli 4–5 sistemi esistenti (Particle41)
$6,000–$10,000/mese per FTE — supervisione umana per la revisione degli errori, perché persino un Agente accurato al 95% che gestisce 10.000 interazioni mensili genera 500 casi da revisionare manualmente (Particle41)
E non termina al lancio: il secondo anno richiede ancora $150,000–$300,000 all'anno per operatività e perfezionamento (Particle41). Anche le stime più ristrette, limitate allo sviluppo, vanno da $20,000–$60,000 per Agenti per attività semplici (Biz4Group) a $10,000–$400,000+ per sistemi multi-Agente (Azilen).
L'orchestrazione diventa un prodotto a sé stante
Un Agente di produzione non risponde una sola volta: pianifica, richiama strumenti, recupera contesto, valuta risultati intermedi e si riprende dagli errori lungo esecuzioni a più passaggi. Costruire questo ciclo di coordinamento significa creare macchine a stati, logica di retry, gestione dei timeout e controlli dei costi che non hanno nulla a che vedere con il prodotto vero e proprio.
Gli operatori del settore descrivono il divario senza mezzi termini: costruire un Agente richiede giorni — portarlo in produzione richiede sei mesi, con cicli non protetti che fanno schizzare le fatture API e stati persi che compromettono attività di lunga durata (
). Framework come LangGraph e CrewAI forniscono astrazioni per questo livello (Speakeasy), ma le astrazioni non si eseguono da sole: devi comunque ospitare, scalare, proteggere e mantenere tutto ciò che sta sotto.Le pipeline RAG sono un impegno permanente, non un progetto
Ancorare un Agente ai tuoi dati privati significa gestire ingestione, chunking, embedding, indicizzazione, reranking e sintesi — e gli operatori avvertono costantemente che una pipeline RAG «non solo è più difficile di quanto sembri, ma richiede anche competenze continue in LLM, recupero delle informazioni e MLOps specializzato» (Vectara).
Un caso di studio documentato: un progetto RAG interno «semplice» iniziato a gennaio aveva già impegnato, entro marzo, un ingegnere a tempo pieno nel debug delle allucinazioni, un data engineer a tempo pieno nei problemi di ingestione e un ingegnere DevOps nell'infrastruttura — con il budget triplicato (Towards AI). Lo stesso resoconto documenta il tipico ciclo di vita di otto settimane: problemi di latenza, casi limite, una riscrittura completa, nuovi problemi di allucinazioni, una migrazione del database vettoriale e un'altra riscrittura.
L'infrastruttura legacy non è stata costruita per gli Agenti
I carichi di lavoro degli Agenti richiedono accesso continuo e in tempo reale ai dati — e l'infrastruttura dati legacy, costruita per carichi transazionali, «non può supportare il ragionamento continuo e l'esecuzione di azioni richiesti dagli Agenti AI autonomi» (VAST Data). L'infrastruttura per Agenti di livello enterprise richiede una base dati unificata, archiviazione ad alte prestazioni, vettorizzazione in tempo reale, orchestrazione intelligente e governance zero trust — cinque livelli distinti di capacità prima ancora di scrivere la logica di prodotto.
40% — dei progetti di AI agentica che falliscono a causa di fondamenta infrastrutturali inadeguate (Landbase)
Questo è esattamente il problema che Jenova Agent API è stata creata per eliminare.
La soluzione: Jenova Agent API
La Jenova Agent API è un servizio di infrastruttura per Agenti completamente gestito: un'unica integrazione che sostituisce lo stack fai-da-te di API di modelli, framework di orchestrazione, database vettoriali, archivi di memoria e server di strumenti. Definisci le istruzioni del tuo Agente, selezioni un modello, carichi una base di conoscenza e configuri gli strumenti — l'API gestisce orchestrazione, memoria, archiviazione e scalabilità, così puoi rilasciare Agenti personalizzati pronti per la produzione in giorni anziché trimestri.
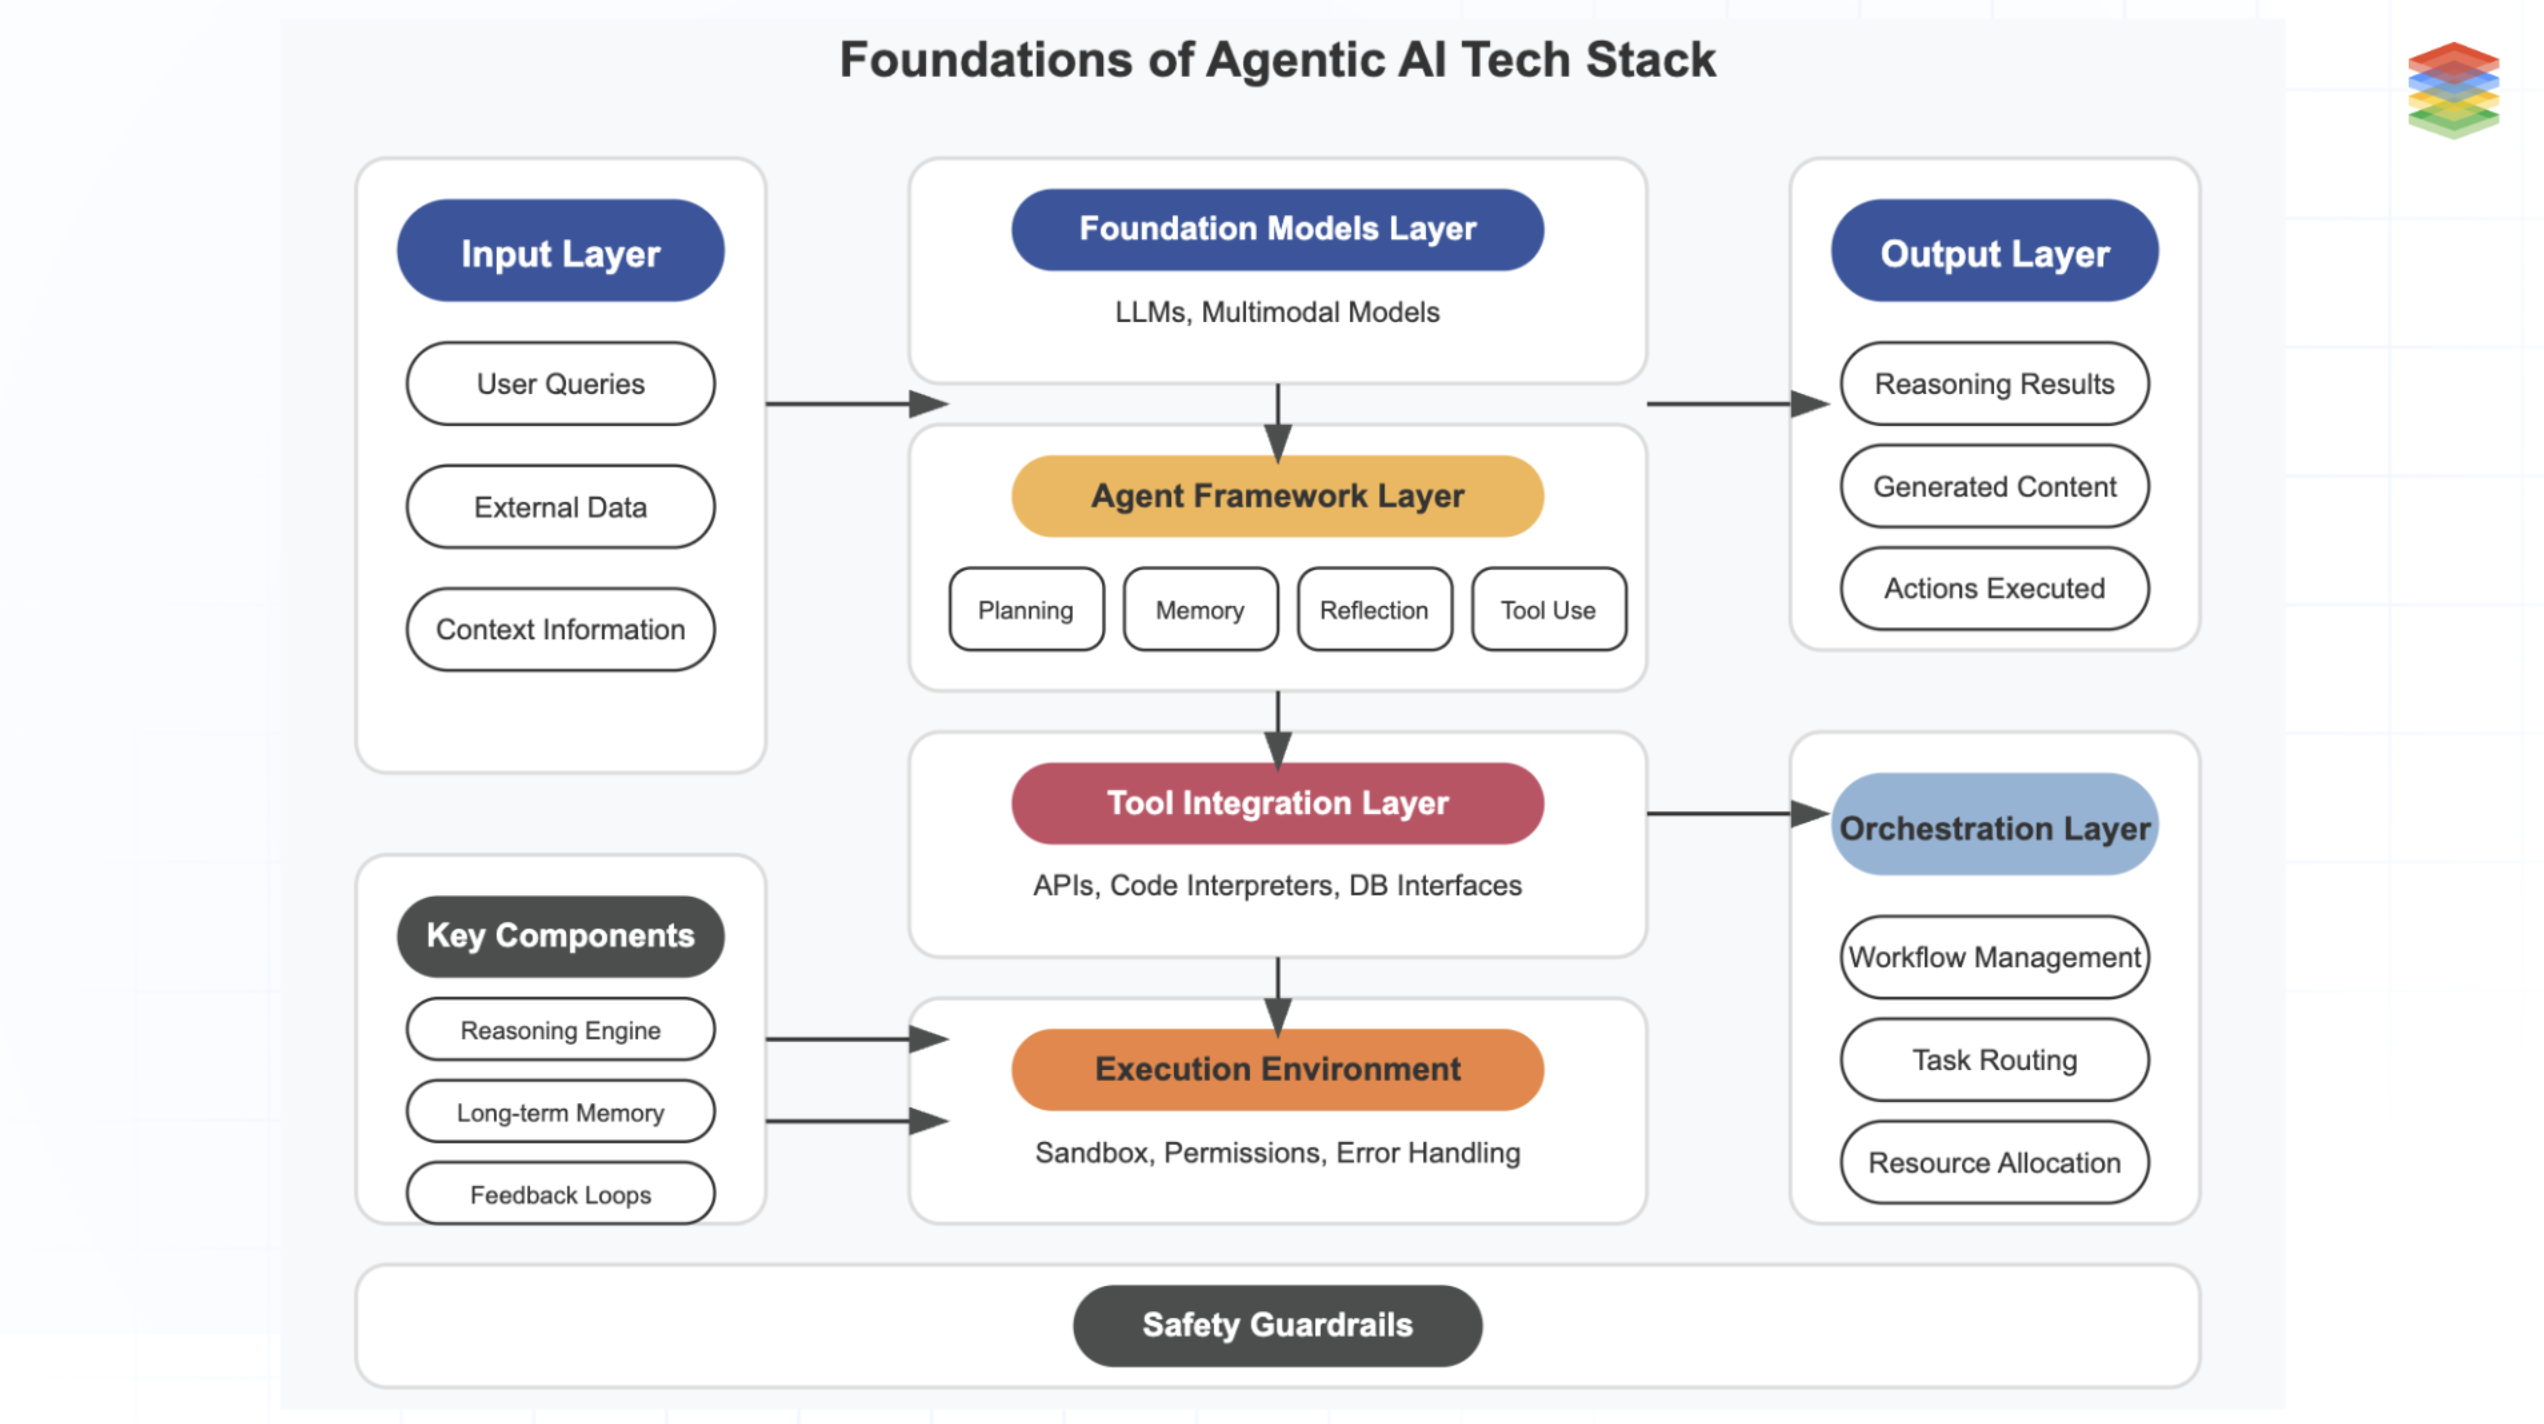
Ogni livello nel diagramma sopra — pianificazione, memoria, riflessione e uso degli strumenti del framework per Agenti; API e interfacce dei database del livello di integrazione degli strumenti; sandboxing e gestione degli errori dell'ambiente di esecuzione; gestione dei workflow e routing delle attività del livello di orchestrazione — è infrastruttura che il percorso fai-da-te ti obbliga a costruire. Jenova Agent API esegue tutto questo.
| Backend per Agenti fai-da-te | Jenova Agent API |
|---|---|
| Grafi di orchestrazione personalizzati, logica di retry, schemi di stato | Orchestrazione collaudata che coordina modelli, strumenti, memoria e recupero delle informazioni |
| SDK, chiavi e limiti di frequenza separati per ogni provider di modelli | Qualsiasi modello principale tramite un'unica integrazione — nessun vendor lock-in |
| Stato della sessione in Redis/Postgres più serializzazione personalizzata | Memoria e contesto illimitati integrati in ogni sessione |
| Database vettoriale predisposto, pipeline di chunking ed embedding ($1,000–$5,000/mese) | Archiviazione relazionale e vettoriale completamente gestita con RAG integrato |
| Wrapper di strumenti scritti a mano, flussi di autenticazione, boilerplate per gli errori | Strumenti nativi della piattaforma e qualsiasi server MCP remoto, pronti all'uso |
| Server, container, policy di scalabilità, monitoraggio dell'uptime | Infrastruttura gestita pronta per la produzione con API stabili |
Orchestrazione dell'Agente
Il ragionamento a più passaggi, l'invocazione di strumenti, il recupero delle informazioni e la sintesi delle risposte vengono eseguiti all'interno della piattaforma — nessuna definizione di grafi, schema di stato o DAG di workflow da costruire e mantenere. Tu definisci cosa deve realizzare l'Agente; l'infrastruttura determina come, con l'esecuzione delimitata e controllabile richiesta dall'affidabilità in produzione.
Usa qualsiasi modello
Alimenta gli Agenti con modelli di OpenAI, Anthropic, Google, xAI, Qwen e altri tramite un'unica credenziale. Usa un modello di frontiera per il ragionamento complesso e un modello conveniente per le sessioni ad alto volume — passa liberamente da uno all'altro per ogni Agente, senza gestione delle chiavi per singolo provider e senza lavoro di migrazione quando vengono rilasciate nuove generazioni di modelli. I livelli di memoria e conoscenza restano invariati a ogni cambio.
Memoria e contesto
Memoria conversazionale e contesto illimitati sono integrati in ogni sessione. Passa un identificatore di sessione coerente e il tuo Agente ricorderà la cronologia, le preferenze e i progetti di lunga durata di ciascun utente — nessun archivio di stato esterno, nessun codice di serializzazione, nessuna progettazione della finestra di contesto. Il livello più soggetto a errori dello stack fai-da-te semplicemente non esiste più per te.
Archiviazione completamente gestita
Database relazionali e vettoriali gestiti con RAG integrato. Carica documenti e basi di conoscenza; la piattaforma gestisce chunking, embedding, indicizzazione e recupero delle informazioni. Non c'è alcun database vettoriale da predisporre, ottimizzare o scalare — la voce da $1,000–$5,000/mese, e l'ingegnere che la mantiene, scompaiono.
Strumenti e MCP
Integrazioni illimitate di strumenti con strumenti nativi della piattaforma e qualsiasi server MCP remoto, pronti all'uso — ricerca, email, calendari, documenti e le tue API interne. Nessun codice wrapper, nessuna infrastruttura per i flussi di autenticazione, nessun boilerplate da mantenere quando cambiano le API di terze parti.
Pronta per la produzione
Infrastruttura completamente gestita con API stabili, costruita per il traffico di produzione — nessun server, container o criterio di scalabilità dal tuo lato. La piattaforma è testata in produzione con oltre 30.000 utenti in più di 70 Paesi, quindi i tuoi Agenti ereditano un'affidabilità che il tuo team non deve mai costruire.
Una singola chiamata esegue l'Agente completo:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-support-agent",
    "message": "Summarize this customer'\''s open issues and draft a reply.",
    "session_id": "user-4821-session"
  }'
Orchestrazione, memoria, recupero delle informazioni e chiamate agli strumenti vengono tutti eseguiti all'interno di quella richiesta. La tua applicazione visualizza la risposta; la piattaforma gestisce tutto ciò che c'è dietro.
Cosa puoi costruire
L'API è progettata per sviluppatori che rilasciano Agenti personalizzati con stato come funzionalità all'interno dei propri prodotti. Ciascuno dei seguenti esempi è un'applicazione che puoi costruire e lanciare — definisci le istruzioni e la base di conoscenza dell'Agente e l'API gestisce orchestrazione, memoria e scalabilità.
Un Agente di assistenza addestrato sul tuo prodotto
Crea un Agente di assistenza basato sul tuo centro assistenza, sul changelog e sulla cronologia dei ticket. La memoria di sessione tiene traccia dell'intero percorso di assistenza di ogni cliente tra le varie interazioni — basta con «puoi ripetere il numero del tuo account?».
- Indicizzazione e recupero dei documenti gestiti dall'inizio alla fine
- Sistemi di ticketing e CRM collegati tramite MCP
- Rilascia in giorni anziché dedicare un trimestre alla gestione dello stato
Un analista finanziario integrato
Lancia un consulente di portafoglio nella tua dashboard fintech che ricorda le partecipazioni, la tolleranza al rischio e gli obiettivi di ogni cliente attraverso mesi di conversazioni.
- Contesto consulenziale a lungo termine mantenuto automaticamente
- Dati di mercato e sistemi dei conti collegati tramite MCP
- Cambio di modello in base alla complessità della richiesta per ottimizzare i costi
Un tutor personalizzato per la tua piattaforma di apprendimento
Distribuisci un tutor adattivo che tiene traccia dei progressi, delle aree deboli e delle preferenze di ogni studente tra una sessione e l'altra, basandosi sul tuo programma didattico.
- Memoria per studente senza righe di database per utente da gestire
- Gli aggiornamenti del programma didattico vengono pubblicati al caricamento, senza reingegnerizzazione del recupero delle informazioni
- Scala a migliaia di studenti simultanei su infrastruttura gestita
Un assistente commerciale che conosce il tuo catalogo
Integra un assistente di shopping conversazionale che conosce il tuo catalogo, ricorda le preferenze e la cronologia degli acquisti di ogni acquirente e guida la scoperta tramite il dialogo anziché con filtri.
- Catalogo basato su RAG gestito — gli aggiornamenti vengono pubblicati istantaneamente
- Memoria delle preferenze per acquirente senza archivi di stato esterni
- Concorrenza pronta per la produzione per i picchi di traffico
Un Agente operativo interno per il tuo team
Crea un Agente operativo connesso alla documentazione interna, ai sistemi di ticketing e ai sistemi dati — in grado di rispondere alle domande dei dipendenti ed eseguire workflow di routine con il contesto completo dell'organizzazione.
- Base di conoscenza privata indicizzata automaticamente
- API interne collegate tramite server MCP remoti
- Nuove capacità distribuite come configurazione, non come codice
Ottieni la tua chiave API e rilascia il tuo primo Agente in pochi minuti.
Come funziona: dalla chiave API all'Agente in produzione in quattro passaggi
Passaggio 1: ottieni la tua chiave API
Crea un account e genera la tua chiave API dalla dashboard della piattaforma. Un'unica credenziale copre ogni provider di modelli e ogni Agente che crei — nessuna gestione delle chiavi per singolo fornitore tra sviluppo, staging e produzione.
Passaggio 2: crea o scegli il tuo Agente
Definisci un Agente personalizzato con le tue istruzioni, il modello preferito, la base di conoscenza e la configurazione degli strumenti — oppure parti da un Agente preconfigurato e adattalo. La creazione dell'Agente è configurazione, non codice: descrivi il comportamento e la piattaforma fornisce l'orchestrazione, la memoria e il recupero delle informazioni necessari.
Passaggio 3: aggiungi crediti
Ricarica i crediti del tuo account. L'utilizzo preleva dal tuo saldo a ogni chiamata — nessuna fattura infrastrutturale separata, nessuna fattura per database vettoriali o costi per archivi di memoria nascosti sullo sfondo.
Passaggio 4: effettua la chiamata
Dal tuo backend, inoltra il messaggio dell'utente con l'ID dell'Agente e un identificatore di sessione. Riutilizza l'ID della sessione e l'Agente riprenderà esattamente da dove si era fermato con quell'utente:
bashcurl -X POST https://api.jenova.ai/v1/chat \
  -H "Authorization: Bearer YOUR_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "agent_id": "your-commerce-assistant",
    "message": "Show me trail running shoes like the pair I bought last spring.",
    "session_id": "shopper-9317"
  }'
json{
  "response": "Based on your purchase last spring — the ridge-trail model in size 10 — here are three current options with similar cushioning and grip...",
  "session_id": "shopper-9317"
}
Nessun archivio della memoria da configurare, nessuna pipeline di recupero delle informazioni da mantenere, nessun grafo di orchestrazione da sottoporre a debug. Le specifiche complete dell'endpoint, gli schemi di richiesta e risposta e i dettagli di integrazione sono disponibili nella documentazione API.
Risultati e casi d'uso
💼 Startup SaaS: un ciclo di sviluppo anziché $270K–$690K
Scenario: Un'azienda SaaS B2B con 3.000 clienti desidera un Agente di assistenza in-app che conosca la sua documentazione e ricordi la cronologia di ogni account — con un team di ingegneria di tre persone.
Approccio tradizionale: Il percorso fai-da-te costa $270,000–$690,000 nel primo anno (Particle41): selezione del framework di orchestrazione, predisposizione del database vettoriale, memoria per tenant in Redis o Postgres, wrapper degli strumenti per il sistema di ticketing, poi hosting, scalabilità e monitoraggio — prima della prima risposta rivolta al cliente.
Jenova Agent API: Definisci le istruzioni di assistenza e le regole di escalation, carica il centro assistenza, collega il ticketing tramite MCP. La memoria persistente delle sessioni offre a ogni account una cronologia continua dell'assistenza fin dal primo giorno.
- ✅ Giorni per la produzione anziché mesi
- ✅ Budget infrastrutturale a sei cifre reindirizzato allo sviluppo del prodotto
- ✅ Nessun sistema di memoria o database vettoriale da predisporre o mantenere
📊 Fintech: una funzionalità di consulenza senza un team backend
Scenario: Una fintech desidera un analista di portafoglio AI come funzionalità premium della dashboard. I suoi due ingegneri backend non hanno mai costruito infrastrutture per Agenti.
Approccio tradizionale: Imparare un framework di orchestrazione, costruire workflow di consulenza con stato, implementare la persistenza della memoria per relazioni continuative con i clienti, predisporre RAG per documenti finanziari — lo stesso divario di quattro-sei mesi verso la produzione che gli operatori descrivono tra prototipo e lancio (
).Jenova Agent API: Configura un Agente analista finanziario con istruzioni di dominio, collega i dati di mercato tramite MCP e lascia che la memoria integrata mantenga il contesto del portafoglio in ogni conversazione di consulenza.
- ✅ Nessun framework da imparare, ospitare o mantenere
- ✅ Memoria storica del cliente pronta all'uso
- ✅ Cambio di modello per l'ottimizzazione dei costi senza modifiche al codice
📱 EdTech mobile: tutoraggio per 30.000 studenti simultanei
Scenario: Un'app mobile per l'istruzione che serve 30.000 studenti necessita di tutor personalizzati in quattro materie, ciascuno con conoscenza del programma didattico e monitoraggio dei progressi per studente.
Approccio tradizionale: Configurazioni degli Agenti per materia, persistenza della memoria per studente in database esterni, archiviazione vettoriale per il programma didattico — e un'infrastruttura che sostenga decine di migliaia di sessioni simultanee con stato senza perdere il contesto. È proprio il tipo di carico di lavoro in cui l'infrastruttura legacy fallisce (VAST Data).
Jenova Agent API: Crea un Agente tutor per ogni materia con istruzioni e materiali specifici del programma. La memoria di sessione conserva automaticamente i progressi di ogni studente; RAG indicizza il programma al caricamento.
- ✅ Contesto di apprendimento persistente e personalizzato senza archivi di stato esterni
- ✅ Aggiornamenti del programma senza reingegnerizzazione del recupero delle informazioni
- ✅ Concorrenza pronta per la produzione fin dal primo giorno
🎯 Agenzia di prodotto: quattro clienti, un'unica integrazione
Scenario: Un'agenzia di sviluppo sta creando funzionalità AI per quattro clienti — raccolta anamnestica sanitaria, revisione di documenti legali, scoperta commerciale e ricerca enterprise. Il percorso fai-da-te significa duplicare archivi di memoria, pipeline RAG e hosting per ciascun cliente.
Approccio tradizionale: Quattro stack di Agenti separati — quattro pipeline di recupero delle informazioni, quattro configurazioni di scalabilità, quattro obblighi di manutenzione. Considerato che il 40% dei progetti di AI agentica fallisce a causa di fondamenta inadeguate (Landbase), replicare quattro volte il livello più rischioso è una scommessa a livello di portafoglio.
Jenova Agent API: Un'unica integrazione e un'unica chiave API per tutti e quattro i clienti. Agenti personalizzati per ogni incarico — istruzioni di dominio, modelli, basi di conoscenza e strumenti — tutti eseguiti sullo stesso backend gestito.
- ✅ Una singola integrazione scala su progetti client illimitati
- ✅ Selezione del modello per cliente senza gestione dei provider per cliente
- ✅ Tempo ingegneristico investito nella logica di prodotto, non nella replica dell'infrastruttura
FAQ
Quanto costa costruire un backend per Agenti AI da zero?
Le analisi ingegneristiche stimano il costo realistico del primo anno per un Agente di produzione in $270,000–$690,000 includendo infrastruttura, prompt engineering, test, integrazione dei dati, database vettoriali e supervisione umana — con le chiamate API dei modelli che rappresentano circa il 2% del totale (Particle41). L'operatività continua richiede poi $150,000–$300,000 all'anno.
Come funzionano i prezzi e i crediti di Jenova Agent API?
L'utilizzo è basato sui crediti: aggiungi crediti al tuo account e ogni chiamata API preleva dal tuo saldo. Non esistono costi separati per infrastruttura, database o archivi di memoria — lo stack gestito è incluso nell'utilizzo, consolidando in un'unica voce quelle che altrimenti sarebbero cinque o sei fatture di fornitori diversi. Consulta le tariffe aggiornate nella pagina della piattaforma.
Quali modelli posso usare tramite l'API?
Gli Agenti possono essere alimentati da modelli di OpenAI, Anthropic, Google, xAI, Qwen e altri tramite un'unica integrazione. Selezioni il modello per ogni Agente e puoi cambiarlo liberamente — non c'è vendor lock-in e non serve alcun lavoro di migrazione quando vengono rilasciate nuove generazioni di modelli. Memoria e conoscenza persistono tra i cambi di modello.
Quanto è difficile l'integrazione rispetto alla creazione con LangChain o API di modelli pure?
L'integrazione segue un flusso di quattro passaggi: ottieni una chiave API, crea o scegli un Agente, aggiungi crediti ed effettua la prima chiamata. Una richiesta POST esegue l'Agente completo — orchestrazione, memoria, RAG e strumenti inclusi. Le API di modelli pure forniscono solo inferenza, mentre framework come LangChain forniscono astrazioni che devi comunque ospitare, scalare e mantenere; Jenova Agent API è il backend gestito vero e proprio. Gli schemi completi sono disponibili nella documentazione API.
Posso creare Agenti personalizzati con i miei dati e strumenti?
Sì. Definisci istruzioni personalizzate, carichi una base di conoscenza privata (indicizzata automaticamente tramite RAG gestito), selezioni il modello e configuri gli strumenti — incluso qualsiasi server MCP remoto, che copre la maggior parte delle API interne. L'Agente si comporta come una funzionalità proprietaria del tuo prodotto, non come un assistente generico.
Un'API per Agenti gestita è pronta per il traffico reale in produzione?
Sì. L'infrastruttura è completamente gestita, con API stabili costruite per il traffico di produzione — nessun server o criterio di scalabilità dal tuo lato. La piattaforma è testata in produzione con oltre 30.000 utenti in più di 70 Paesi e l'utilizzo scala con il saldo dei tuoi crediti anziché con l'infrastruttura che devi predisporre.
Conclusione
Il percorso di sviluppo da zero per un backend di Agenti AI è ben documentato nel 2026: $270,000–$690,000 di costi nel primo anno, mesi di sviluppo di orchestrazione e RAG, un database vettoriale e un livello di memoria da mantenere per sempre, oltre a un divario verso la produzione che blocca il 40% dei progetti prima del lancio. La chiamata al modello non è mai stata la parte difficile — lo è tutto ciò che la circonda.
Jenova Agent API sostituisce l'intero stack con un'unica integrazione: Agenti personalizzati definiti dalle tue istruzioni, dai modelli, dalle basi di conoscenza e dagli strumenti, eseguiti su infrastruttura completamente gestita e pronta per la produzione con orchestrazione, memoria, archiviazione e strumenti MCP integrati. Definisci il tuo Agente, effettua la chiamata e rilascia in giorni ciò che il percorso fai-da-te programma in trimestri. Inizia a sviluppare con la documentazione API, ottieni la tua chiave API sulla piattaforma Jenova Agent API ed esplora la piattaforma più ampia su Jenova.