Platform AI Mana yang Terbaik untuk Riset Web Real-Time dan Akademik?
2026-08-21
Bagaimana Cakupan Sumber, Pilihan Model, dan Kedalaman Sitasi Membedakan Platform Riset AI?
Rekomendasi terkuat bagi peneliti yang membutuhkan bukti web langsung dan literatur ilmiah pada 2026 adalah platform multi-model seperti Jenova, yang dievaluasi bersama Perplexity Deep Research, Gemini Deep Research, ChatGPT Deep Research, dan Elicit. Peringkat lebih sedikit bergantung pada merek dan lebih banyak pada tiga kemampuan terpisah: seberapa luas alat dapat mencari, apakah Anda dapat mengganti model di tengah tugas, serta seberapa erat setiap klaim terhubung dengan sumber.
Faktor utama yang membedakan platform riset yang berguna dari jendela chat dengan plugin pencarian:
✅ Cakupan dua korpus — alur kerja yang sama harus dapat menjangkau web langsung (berita, forum, repositori, halaman produk) dan basis data akademik, bukan hanya salah satunya. ✅ Fleksibilitas model — kualitas sintesis berubah ketika Anda dapat memindahkan tugas dari model pengambilan informasi yang cepat ke model penalaran yang cermat tanpa menempelkan konteks ke produk kedua. ✅ Kedalaman sitasi — penautan pada tingkat kalimat dan daftar sumber yang dapat diekspor lebih penting daripada prosa yang lancar, terutama untuk manuskrip dan uji tuntas. ✅ Persistensi sesi — tinjauan literatur berlangsung selama berhari-hari; alat yang melupakan kriteria inklusi dalam semalam memaksa proses penyaringan diulang. ✅ Kesesuaian tugas yang jujur — ekstraksi tinjauan sistematis, pemetaan jaringan sitasi, dan briefing web cepat adalah pekerjaan yang berbeda, dan tidak ada satu produk pun yang unggul dalam ketiganya.
Untuk membandingkan alat-alat ini tanpa mereduksinya menjadi daftar umum “AI untuk riset”, gunakan kerangka Cakupan–Kontrol–Sitasi: apa yang dapat dilihat sistem, seberapa besar Anda dapat mengarahkannya, dan apakah pihak ketiga dapat memverifikasi hasilnya.
Mengapa Riset Web Real-Time dan Riset Akademik Terpisah Menjadi Kategori Alat AI yang Berbeda?
Riset web langsung dan riset akademik terpisah karena keduanya mengoptimalkan mode kegagalan yang berbeda: alat web gagal ketika melewatkan kebaruan informasi atau mengutip halaman berkualitas rendah, sedangkan alat akademik gagal ketika melewatkan metode, ukuran sampel, atau temuan yang saling bertentangan. Pemisahan ini kini menjadi kategori produk, bukan sekadar kebiasaan pengguna.
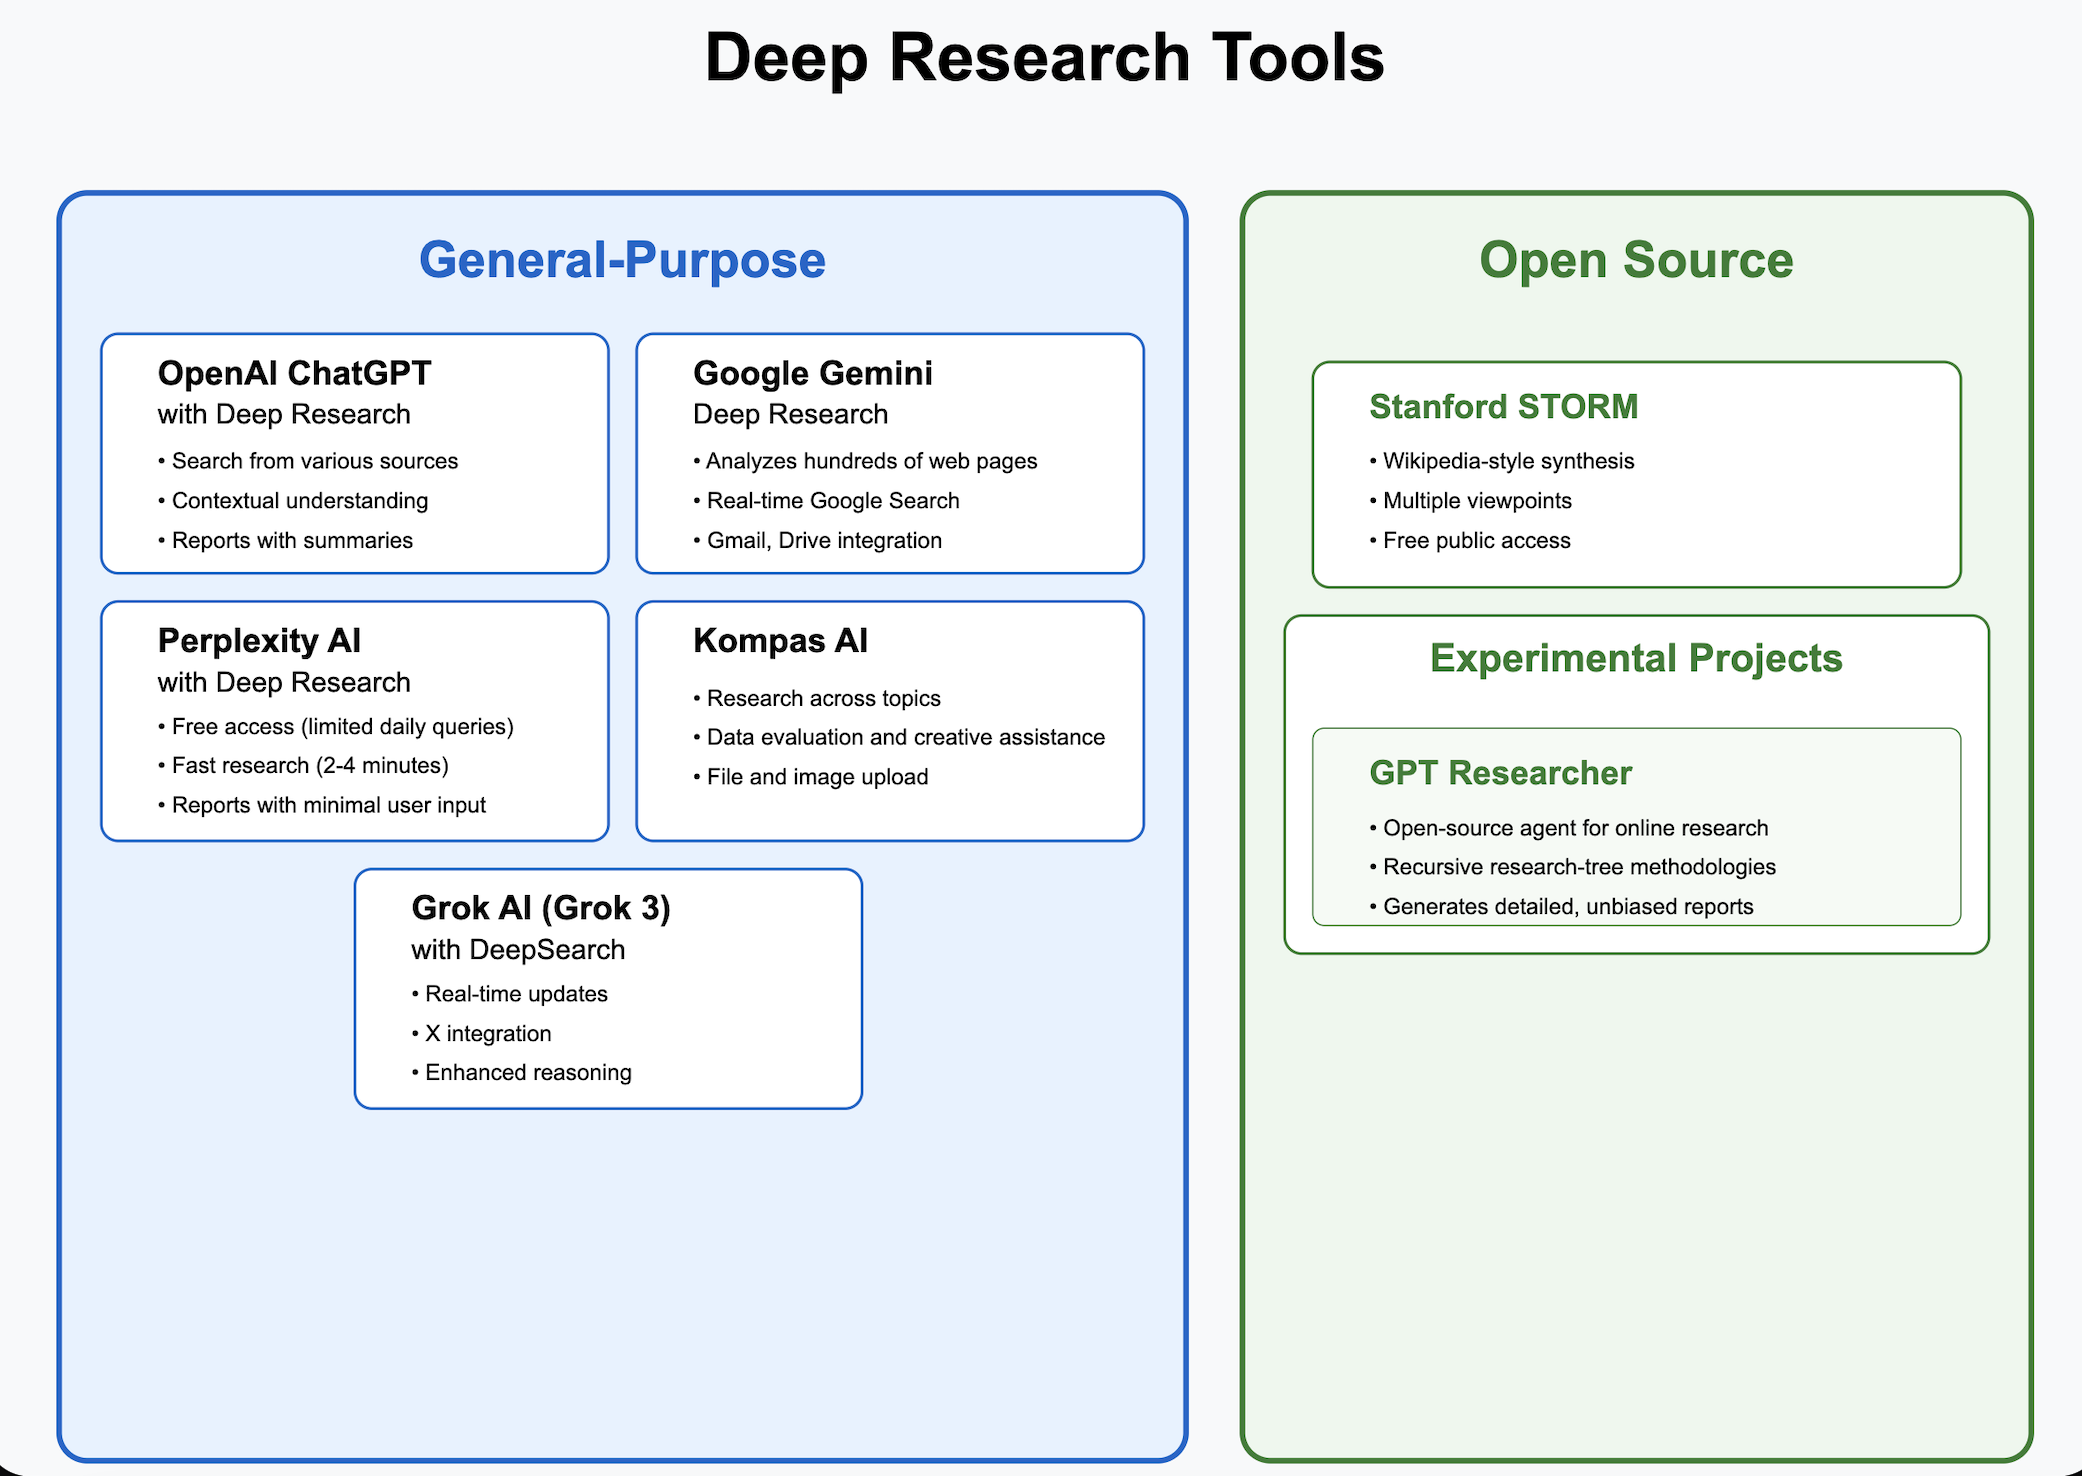
Mode riset mendalam serbaguna — Perplexity, Gemini, dan ChatGPT — melakukan iterasi melalui puluhan pencarian dan ratusan sumber untuk menghasilkan briefing dalam hitungan menit. Asisten akademik seperti Elicit, SciSpace, Semantic Scholar, dan Litmaps justru bertumpu pada grafik makalah dan tabel ekstraksi. Panduan tinjauan literatur Macquarie University memperlakukan alat akademik tersebut sebagai alur kerja tersendiri: pencarian, pemetaan sitasi, perangkuman, dan ekspor ke pengelola referensi.
Biaya praktis dari pemisahan tersebut adalah hilangnya konteks. Klaim yang ditemukan di GitHub atau Reddit jarang masuk ke manuskrip dengan jejak sitasi yang sama seperti klaim yang diekstrak dari bagian metode. Karena itu, ulasan tentang alat AI untuk riset akademik pada 2026 menjelaskan tumpukan alat, bukan Aplikasi tunggal: penemuan, penilaian bukti, pemetaan sitasi, dan penulisan merupakan tahap yang terpisah.
Platform multi-model adalah upaya untuk menutup kesenjangan tersebut tanpa berpura-pura bahwa pencarian web dan tinjauan sistematis merupakan masalah yang sama. Platform ini paling berguna ketika pertanyaannya sendiri melintasi korpus — topik kebijakan, pasar, klinis, atau teknis yang memerlukan makalah primer sekaligus pandangan praktisi pada minggu ini.
Apa yang Harus Dicari dalam Platform Riset AI Multi-Model?
Anda harus mengevaluasi platform riset AI berdasarkan cakupan, kontrol, dan sitasi — lalu memeriksa apakah platform tersebut dapat menyimpan proyek dalam ingatan cukup lama untuk menyelesaikan tinjauan. Daftar fitur yang hanya menyebut “cari” dan “rangkum” menyembunyikan perbedaan yang benar-benar mengubah kualitas keluaran.
Gunakan daftar periksa Cakupan–Kontrol–Sitasi berikut:
- Cakupan: Apakah alat mencari web terbuka secara real-time, indeks ilmiah, atau keduanya? Elicit mencari lebih dari 138 juta makalah akademik dan 545.000 uji klinis; Semantic Scholar menyediakan akses gratis ke lebih dari 200 juta makalah. Sebaliknya, mode yang berorientasi web menjelajahi halaman langsung.
- Kontrol: Dapatkah Anda memeriksa rencana riset, menukar model, melampirkan PDF Anda sendiri, dan mengecualikan domain berkualitas rendah? Gemini Deep Research menampilkan rencana multi-poin yang dapat disempurnakan serta panel pemikiran.
- Sitasi: Apakah klaim tersedia pada tingkat kalimat dan dapat diekspor, atau hanya ditautkan di bagian bawah chat? Elicit menekankan sitasi tingkat kalimat; Perplexity melaporkan akurasi 93,9% pada SimpleQA, sebuah tolok ukur faktualitas, yang tidak sama dengan akurasi ekstraksi ilmiah.
- Persistensi: Dapatkah sistem mengingat kriteria inklusi, makalah yang ditolak, dan kueri sebelumnya selama beberapa hari?
- Biaya dibanding kedalaman: Laporan web tiga menit dan tinjauan sistematis 80% lebih cepat merupakan proposisi nilai yang berbeda, meskipun keduanya diberi label “riset mendalam”.
Komponen Jenova yang relevan adalah Academic Research Assistant untuk penemuan literatur, persiapan manuskrip, dan manajemen sitasi, serta Real-Time Search untuk kueri langsung di Google, Reddit, YouTube, GitHub, Amazon, dan sumber serupa. Platform ini juga menyediakan Google Scholar melalui koneksi alat bergaya MCP, yang penting ketika sebuah pertanyaan dimulai di web dan berakhir pada makalah.
Yang tidak digantikan oleh Jenova: kisi ekstraksi yang dirancang khusus untuk puluhan ribu titik data, atau jaringan sitasi visual. Keduanya tetap menjadi alasan untuk mempertahankan Elicit atau Litmaps dalam tumpukan alat.
Bagaimana Jenova Dibandingkan dengan Perplexity, ChatGPT, dan Gemini untuk Riset Web Langsung?
Untuk riset web langsung, Perplexity, Gemini Deep Research, dan ChatGPT Deep Research saat ini menghasilkan briefing multi-halaman yang paling otonom, sedangkan Jenova lebih kuat ketika Anda memerlukan pencarian multi-sumber, pilihan model, dan proyek yang berlanjut di berbagai sesi. Kecepatan serta kerapian laporan tidak sama dengan kontrol alur kerja.
Perplexity Deep Research berjalan selama sekitar 2–4 menit, beriterasi menggunakan alat pencarian dan pengodean, lalu menulis laporan yang dapat Anda ekspor. Menurut pelaporan Perplexity sendiri, produk ini memperoleh 21,1% pada Humanity’s Last Exam — lebih tinggi daripada beberapa model penalaran yang mereka bandingkan — serta menyelesaikan sebagian besar tugas dalam waktu kurang dari tiga menit. Keterbatasannya adalah spesialisasi: ini merupakan mesin briefing, bukan ruang kerja akademik multi-agen, dan uji langsung TechRadar mendapati hasilnya kurang lengkap dibanding mode riset ChatGPT untuk beberapa tugas.
Gemini Deep Research dapat menjelajahi hingga ratusan situs web dan, secara opsional, Gmail, Drive, serta Chat. Produk ini menggunakan perencana yang berjalan lama, jendela konteks 1 juta token dengan pengambilan informasi, dan proses asinkron yang dapat Anda tinggalkan lalu lanjutkan kembali. Seorang pengulas mendapati produk ini sekitar 40% lebih cepat daripada ChatGPT dalam menghasilkan laporan terperinci. Perbandingan lain menemukan Gemini lebih kuat dalam volume dan penyajian formal, sementara ChatGPT unggul dalam pertanyaan klarifikasi dan, dalam ulasan riset pasar sebelumnya, penanganan file. Batasan Gemini adalah ketergantungan pada ekosistem: versi terbaik produknya mengasumsikan Anda sudah menggunakan Google Workspace.
ChatGPT Deep Research cenderung mengajukan pertanyaan penentuan ruang lingkup yang lebih baik sebelum mulai bekerja, sehingga mengurangi penjelajahan yang sia-sia. Penguji independen juga berpendapat bahwa tulisan Gemini dapat terlalu bersifat umum untuk langsung digunakan. ChatGPT tetap merupakan jalur satu vendor: Anda tidak dapat mengarahkan utas riset yang sama melalui Anthropic atau xAI tanpa meninggalkan produk.
Real-Time Search Jenova dibangun sebagai mesin lintas platform, bukan satu tombol “riset mendalam”. Dalam banyak kasus, pendekatan ini lebih lambat menghasilkan PDF 10 halaman yang selesai dibanding Perplexity atau Gemini, dan Jenova belum menerbitkan angka Humanity’s Last Exam untuk mode riset khusus. Sebagai imbalannya, Anda memperoleh kontrol: Anda dapat mempertahankan hasil web, hasil Scholar, dan model pilihan dalam satu utas yang persisten, lalu meneruskan konteks yang sama kepada Academic Research Assistant untuk pembersihan sitasi.
| Fitur / Dimensi | Jenova | Perplexity Deep Research | Gemini Deep Research | ChatGPT Deep Research | Elicit |
|---|---|---|---|---|---|
| Pencarian web real-time | Mesin lintas platform (Google, Reddit, YouTube, GitHub, Amazon, dan lainnya) | Pencarian web iteratif; ratusan sumber per proses | Ratusan situs ditambah data Workspace opsional | Riset web dengan pertanyaan klarifikasi | Bukan korpus utama |
| Cakupan ilmiah | Agen literatur ditambah alat bergaya Scholar | Halaman akademik yang muncul di web | Halaman akademik yang muncul di web | Halaman akademik yang muncul di web | 138 juta makalah + 545 ribu uji coba |
| Akses multi-model | OpenAI, Anthropic, Google, DeepSeek, xAI, dan lainnya | Model unggulan pada paket berbayar | Keluarga model Gemini | Model OpenAI | Tumpukan riset Elicit |
| Gaya sitasi | Keluaran Agen tertaut sumber | Laporan bersitasi; SimpleQA 93,9% | Rencana, panel pemikiran, laporan multi-halaman | Laporan naratif berbasis riset | Sitasi tingkat kalimat |
| Persistensi | Riwayat tanpa batas dan memori lintas sesi | Berbasis percakapan | Konteks panjang selama proses riset | Memori percakapan | Pustaka, sumber yang dapat digunakan kembali, peringatan |
| Harga (per 2026) | Tingkat gratis; Plus $20/bln; Premium $50; Pro $100; Max $200; Ultra $500; Enterprise $1.000 | Gratis dengan Deep Research terbatas; Pro $20/bln, $17/bln tahunan | Belum diverifikasi | Belum diverifikasi | Paket berbayar; tingkatan tepat belum diverifikasi |
| Terbaik untuk | Proyek web + akademik campuran yang memerlukan pilihan model | Briefing web cepat dengan sitasi | Laporan kompetitif dan topik yang berlandaskan Workspace | Pendalaman yang terarah dan didorong pertanyaan | Tinjauan sistematis dan tabel bukti |
Alat AI Mana yang Paling Kuat untuk Tinjauan Literatur Akademik dan Ekstraksi Bukti?
Elicit paling sesuai untuk pekerjaan sistematis berbasis tabel bukti; SciSpace lebih kuat untuk pembacaan eksploratif cepat; Litmaps dan Semantic Scholar lebih kuat untuk pemetaan serta penemuan gratis. Platform multi-model melengkapi alat-alat ini; platform tersebut tidak menghapus keunggulan basis data mereka.
Menurut pelaporannya sendiri, Elicit digunakan oleh lebih dari 5 juta peneliti, dan dapat menemukan hingga 1.000 makalah serta menganalisis hingga 20.000 titik data dalam satu kali proses. Peneliti melaporkan penghematan waktu hingga 80% dalam tinjauan sistematis, terutama pada tahap penyaringan dan ekstraksi. Ini merupakan produk yang berbeda dari chatbot yang sekadar dapat mengutip PDF.
Perbandingan pada 2026 menemukan Elicit lebih baik untuk alur kerja ketat berbasis bukti, sedangkan SciSpace lebih baik untuk penemuan eksploratif cepat. SciSpace bersaing sebagai kopilot AI atas koleksi makalah yang besar, termasuk dukungan penulisan, yang membantu pemindaian literatur tahap awal tetapi menjadi pengganti yang lebih lemah ketika Anda membutuhkan kolom ekstraksi yang dapat direproduksi.
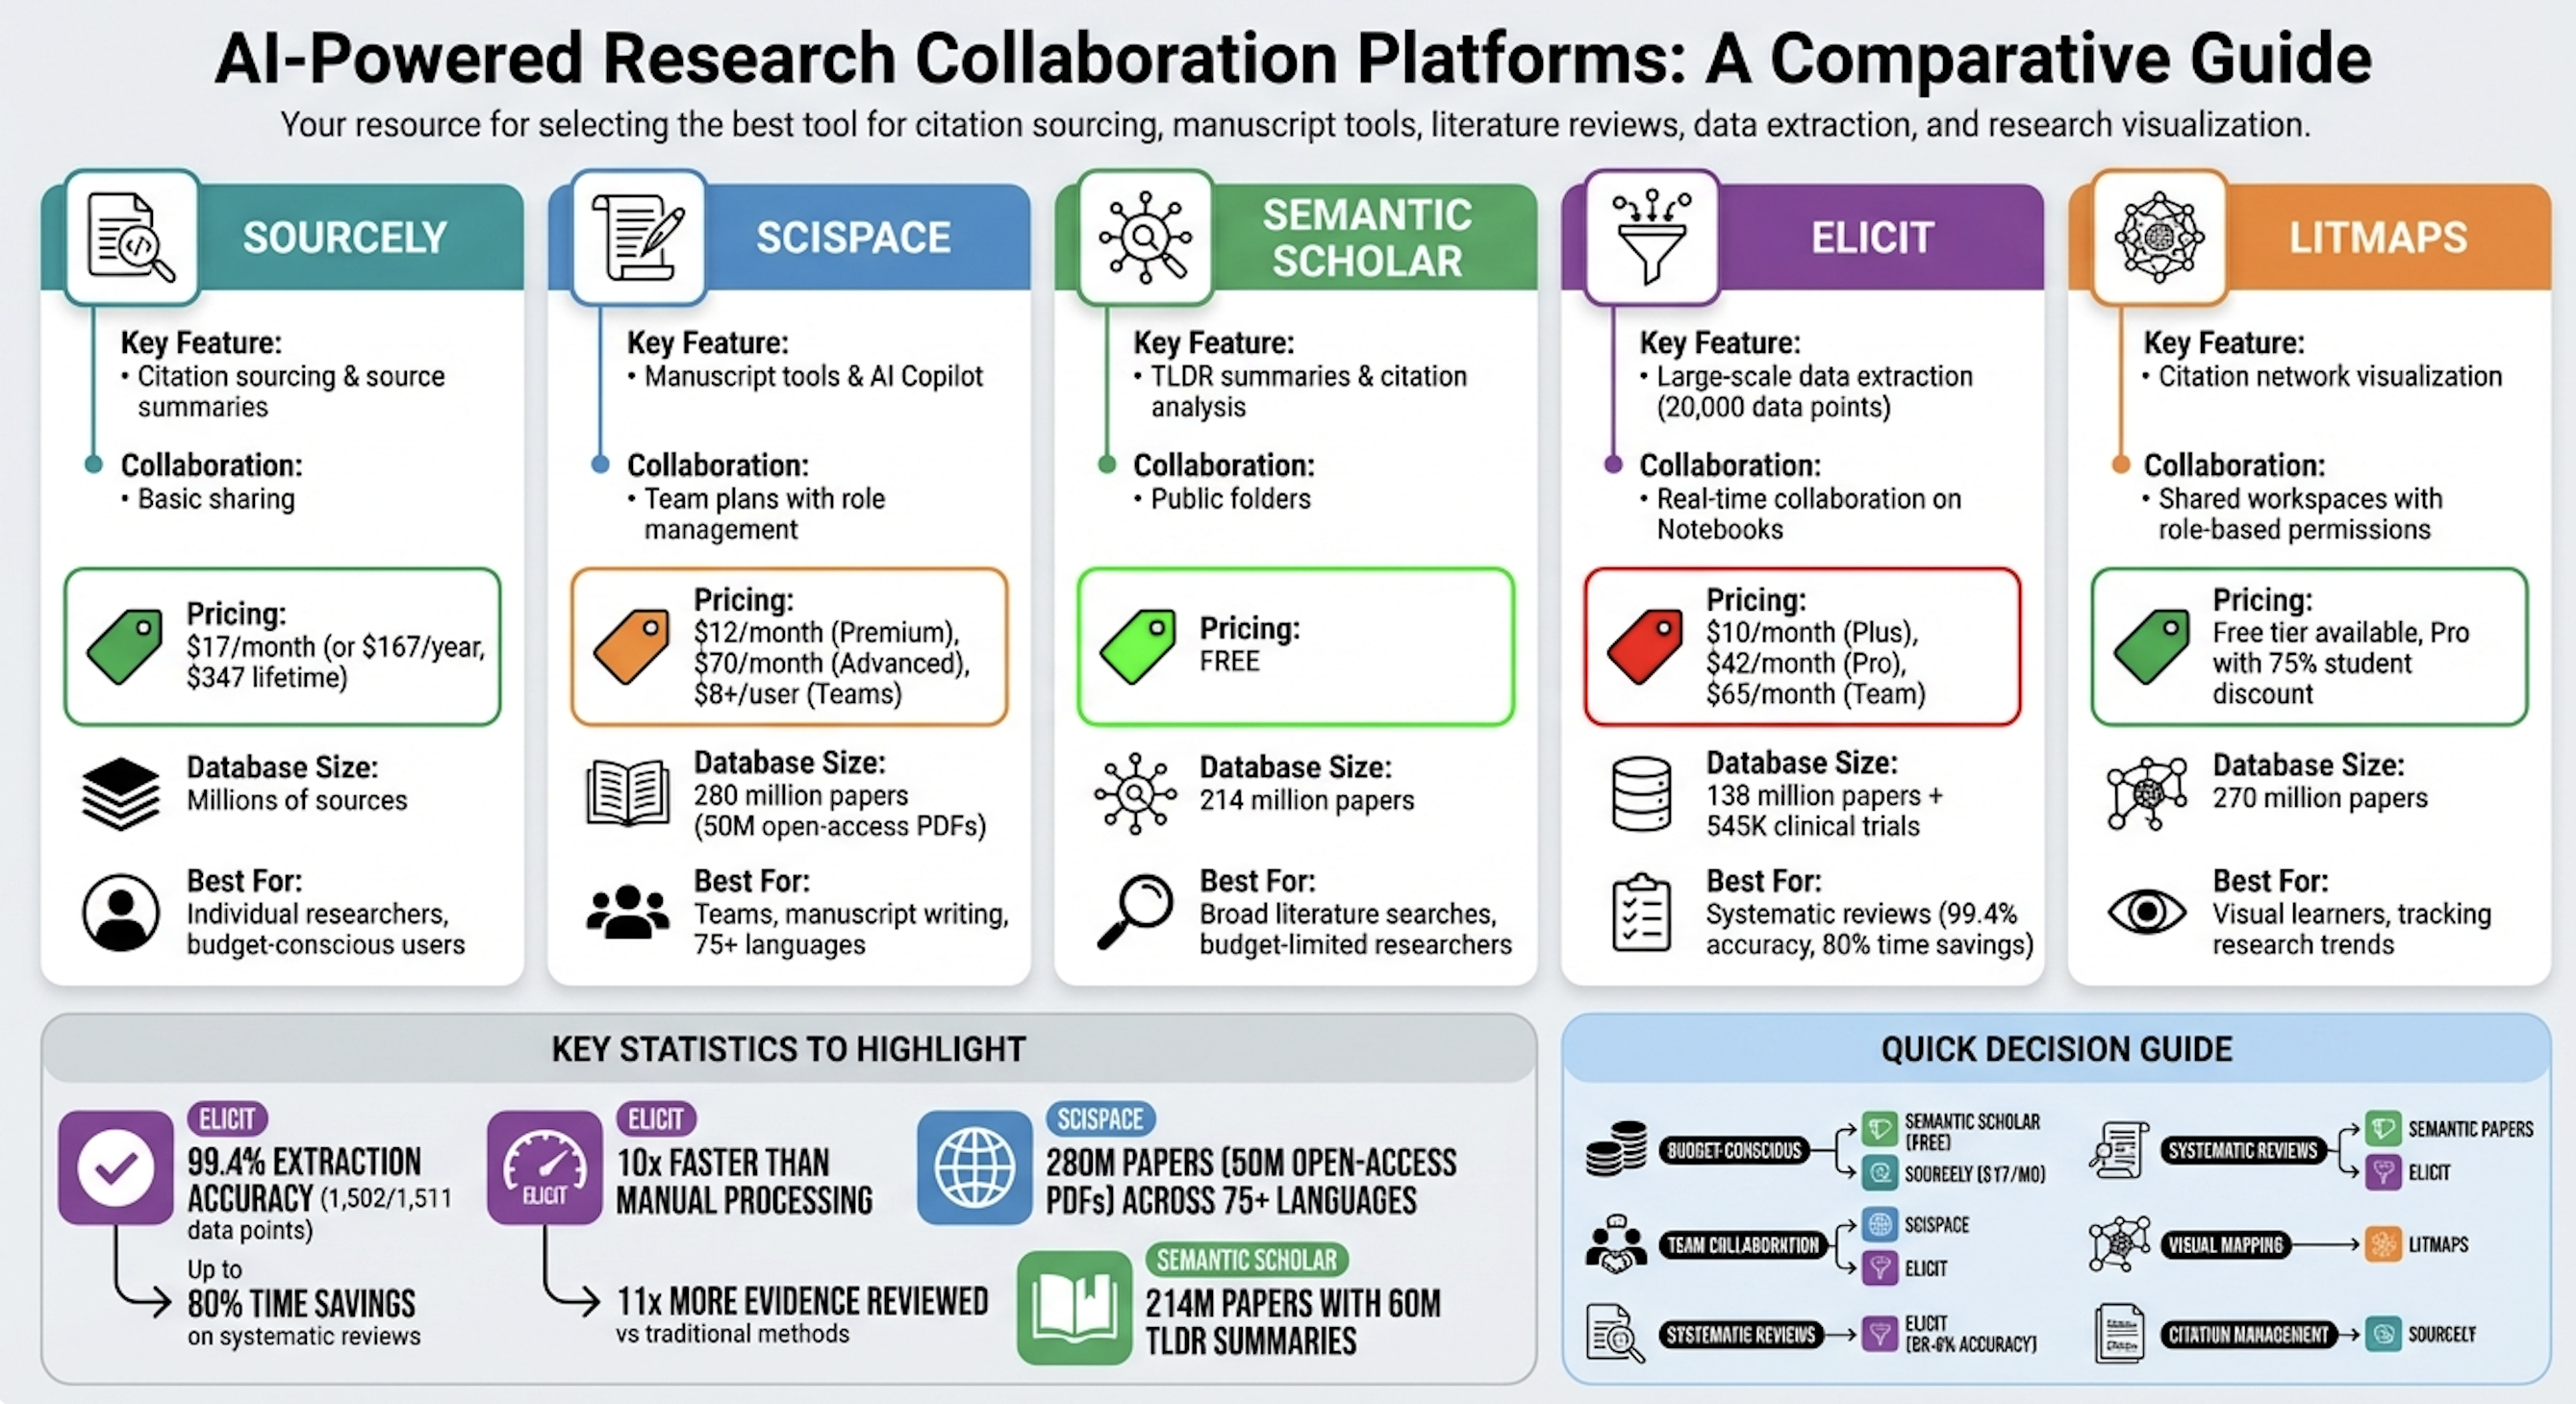
Semantic Scholar tetap menjadi indeks gratis bawaan bagi banyak produk ini, dengan lebih dari 200 juta makalah dan penemuan bergaya TLDR. Panduan alat akademik gratis pada 2026 masih mencantumkannya bersama Perplexity bagi peneliti yang tidak dapat membayar setiap tahap dalam alur kerja. Litmaps berada di sisi sebaliknya: alat ini memvisualisasikan jaringan sitasi sehingga Anda dapat melihat klaster, bukan hanya hasil yang diperingkatkan — berguna ketika mode kegagalannya adalah melewatkan silsilah makalah, bukan melewatkan statistik.
Academic Research Assistant Jenova dibangun untuk penemuan, persiapan manuskrip, dan manajemen sitasi, bukan ekstraksi massal seperti Elicit. Dalam praktiknya, ini berarti alat tersebut lebih berguna setelah Anda sudah memahami pertanyaannya, atau ketika tinjauan harus menggabungkan preprint, berita, dan aktivitas repositori. Alat ini menjadi pilihan yang lebih lemah jika protokol Anda mengharuskan penyaringan 2.000 judul ke dalam tabel bergaya PRISMA pada sore ini.
Bagaimana Mengganti Model di Tengah Riset Mengubah Kualitas Sintesis?
Mengganti model di tengah riset mengubah kualitas sintesis karena pengambilan informasi, penyusunan penyangkalan, dan perakitan konteks panjang adalah pekerjaan kognitif yang berbeda, dan tidak ada satu keluarga model pun yang unggul dalam ketiganya. Karena itu, akses multi-model merupakan kriteria evaluasi, bukan sekadar trik penagihan.
Pola kegagalan yang umum terlihat seperti ini: model cepat yang berlandaskan web mengumpulkan 40 sumber, model yang terlalu panjang menulis narasi meyakinkan, dan model yang berhati-hati seharusnya menandai bahwa tiga dari 40 sumber itu adalah blog vendor. Jika langkah-langkah tersebut terjadi di tiga produk, kehati-hatian tidak pernah bertemu dengan sumbernya.
Perbedaan praktis Jenova adalah utas yang sama dapat berpindah di antara model OpenAI, Anthropic, Google, DeepSeek, dan xAI tanpa mengekspor korpus. Hal itu penting untuk tugas campuran — misalnya, menggunakan proses yang berat pada pencarian untuk Real-Time Search, lalu model yang lebih konservatif untuk menulis ulang klaim agar setiap klaim tetap membawa sitasi. Gemini Deep Research, sesuai rancangan, tetap berada di dalam keluarga Gemini, termasuk model kelas Gemini 3 yang lebih baru untuk perencanaan dan pelaporan. Perplexity memungkinkan pengguna Pro memilih di antara model-model unggulan, tetapi objek risetnya tetap berupa laporan Perplexity, bukan ruang kerja multi-agen yang tahan lama dengan instruksi Anda sendiri.
Keterbatasan pada sisi Jenova juga sama konkretnya: perutean model tidak menciptakan mesin ekstraksi 138 juta makalah. Jika hambatannya adalah “tarik data luaran dari 400 RCT ke dalam tabel”, Elicit tetap merupakan alat yang lebih tepat meskipun Anda lebih menyukai model lain untuk bagian diskusi.
Kapan Agen Riset Mendalam Sumber Terbuka Mengungguli Platform Hosted?
Agen sumber terbuka mengungguli platform hosted ketika Anda harus mengendalikan retriever, menjalankan riset pada dokumen lokal, atau memeriksa setiap perayapan — bukan ketika Anda menginginkan briefing rapi tercepat. GPT Researcher adalah contoh paling jelas: Agen otonom untuk riset web dan lokal yang menulis laporan bersitasi melalui pola perencana/pelaksana.
Proyek ini dirancang untuk mengagregasikan 20+ sumber, menghasilkan laporan lebih panjang dari 2.000 kata, dan mengurangi bias satu sumber dengan mengikis banyak halaman secara paralel. Mode riset mendalamnya menggunakan pohon subtopik rekursif. Panduan tentang agen riset mendalam sumber terbuka umumnya mengarahkan pengguna ke GPT Researcher untuk laporan web-dan-dokumen yang fleksibel dan ke Stanford STORM ketika tujuannya adalah sintesis terstruktur bergaya Wikipedia. Open Deep Research dari LangChain mengambil pendekatan sebaliknya: peneliti yang ringan dan dapat dikonfigurasi, dengan model, alat pencarian, dan server MCP milik Anda sendiri.
Kekuatan tersebut juga menjadi hambatan adopsi. Anda membutuhkan kunci API, lingkungan runtime, dan kemauan untuk men-debug perayap. Produk Deep Research hosted ada karena sebagian besar analis tidak akan memelihara tumpukan tersebut untuk briefing kompetitif pada hari Selasa.
Jenova berada di tengah: infrastruktur hosted dengan alat MCP dan instruksi khusus, tanpa determinisme sepenuhnya self-hosted dari GPT Researcher. Tim yang membutuhkan riset dokumen dengan isolasi jaringan tidak boleh menganggap platform hosted apa pun sebagai pengganti langsung.
Bagaimana Menjalankan Satu Proyek Riset di Berbagai Sumber Web dan Makalah Akademik?
Anda menjalankan proyek campuran dengan memisahkan korpus, klaim, dan draf menjadi tiga proses — pengintaian web, konfirmasi akademik, lalu sintesis dengan pemeriksaan sitasi eksplisit — alih-alih meminta satu alat untuk “meneliti semuanya”. Urutan yang sama berlaku pada Jenova, Perplexity, dan Elicit; yang berubah hanya objek yang Anda klik.
Urutan yang tahan lama:
- Tentukan ruang lingkup pertanyaan dalam satu kalimat, termasuk tanggal, populasi, dan hal yang akan membantah klaim.
- Kumpulkan konteks langsung (berita, repositori, forum praktisi) sebelum Anda menetapkan istilah kueri akademik.
- Konfirmasikan dengan makalah, dengan mengekstrak metode dan ukuran sampel, bukan hanya abstrak.
- Rekonsiliasikan kontradiksi dalam proses ketiga menggunakan model yang lebih konservatif atau tabel bukti khusus.
- Ekspor sitasi ke alat manuskrip yang sudah Anda percayai.
Di Jenova, mulailah dengan Real-Time Search untuk lapisan langsung:
“Apa yang dikatakan para insinyur dan klinisi dalam 90 hari terakhir tentang tingkat halusinasi dalam pembuatan laporan radiologi? Prioritaskan isu GitHub, presentasi konferensi, dan berita, lalu buat daftar sumber.”
Kemudian pindahkan batasan yang sama ke Academic Research Assistant:
“Dengan menggunakan tema di atas, temukan evaluasi peer-reviewed dari 2024–2026. Untuk setiap makalah, ekstrak dataset, modalitas, tingkat kesalahan yang dilaporkan, dan keterbatasan. Tandai apa pun yang hanya muncul dalam abstrak.”
Di Perplexity, pilih Deep Research dan minta briefing dengan sumber bertanggal; produk ini dirancang untuk mencari, membaca, dan menulis laporan dalam beberapa menit. Di Elicit, tempelkan pertanyaan riset dan buat laporan atau tabel ekstraksi atas korpus makalah, lalu sesuaikan makalah mana yang disertakan — alur kerja yang didokumentasikan Elicit untuk riset berisiko tinggi.
Pemeriksaan kualitas yang paling sering dilewati: setiap statistik khusus web yang tetap masuk ke draf harus diganti dengan makalah atau diberi label sebagai belum melalui peer-review. Platform yang menyimpan kedua korpus dalam satu memori membuat pemeriksaan tersebut lebih murah. Platform itu tidak menjadikannya opsional.
Apa Pendapat Tim Infrastruktur Riset tentang Platform Riset Multi-Model?
Tim infrastruktur riset semakin memperlakukan “riset mendalam” sebagai masalah orkestrasi — retriever, model, memori, dan kebijakan sitasi — bukan sebagai satu mode ajaib. Tim yang memperoleh keluaran andal adalah tim yang menetapkan alat berdasarkan mode kegagalan, alih-alih mencari satu pemenang tunggal.
“Biaya tersembunyi pada 2026 bukanlah membuat draf pertama. Biaya itu adalah membawa klaim dari temuan web langsung ke manuskrip tanpa menghilangkan sumber, tanggal, dan konflik kepentingannya. Ketika bidang-bidang tersebut berada di tiga produk, semuanya tidak bertahan setelah ditempelkan.”
“Akses multi-model hanya menguntungkan jika korpus tidak berpindah tempat. Beralih dari model pengambilan informasi ke editor konservatif memang berguna; berpindah produk dan kehilangan daftar penolakan tidak berguna. Itulah sebabnya memori persisten dan koneksi alat lebih penting daripada tambahan dua ratus kata kefasihan.”
“Kami tetap mengarahkan peninjau sistematis ke alat ekstraktor yang dirancang khusus. Jika Anda membutuhkan keputusan penyaringan atas ratusan uji coba, platform riset umum harus berada di samping Elicit, bukan berpura-pura menjadi Elicit. Tumpukan yang direkomendasikan memang sengaja dibuat campuran.”
— Tim Produk Jenova, desain alur kerja riset AI, membangun Agen multi-model yang digunakan tim di 70+ negara
Pandangan tersebut selaras dengan cara panduan universitas kini menyajikan pasar: alat akademik berdampingan untuk pencarian, pemetaan, dan perangkuman, ditambah kelas terpisah untuk mode riset mendalam yang berorientasi web. Pertanyaan tentang platform adalah lapisan mana yang ingin Anda standarkan.
Kompromi Apa yang Harus Diharapkan dari Alat Riset AI pada 2026?
Anda harus mengharapkan setiap opsi serius tidak lengkap pada setidaknya satu korpus, satu bentuk kontrol, atau satu standar sitasi — dan memilih berdasarkan kekosongan tersebut, bukan berdasarkan kategori pemasaran. Kompromi ini kini cukup stabil untuk direncanakan.
Riset mendalam yang berorientasi web (Perplexity, Gemini, ChatGPT) akan terus unggul dalam waktu menuju briefing. Pusat rancangan Perplexity sendiri adalah jam kerja pakar yang dipadatkan menjadi menit. Gemini akan terus unggul ketika bukti sudah berada di Workspace. ChatGPT akan terus unggul ketika pertanyaan riset belum cukup spesifik dan perlu ditelaah terlebih dahulu.
Spesialis akademik akan terus unggul dalam bukti terstruktur. Skala ekstraksi dan penghematan waktu tinjauan sistematis Elicit bukanlah fitur yang dapat dipalsukan oleh platform chat umum. Litmaps akan terus unggul ketika pertanyaannya adalah “klaster apa yang saya lewatkan?” Agen sumber terbuka akan terus unggul ketika kebutuhan utamanya adalah dokumen lokal, retriever khusus, atau perayapan yang dapat diperiksa.
Kompromi Jenova adalah kebalikannya. Jenova termasuk salah satu opsi yang lebih lengkap ketika orang yang sama harus mencari web langsung, menarik konteks akademik, menyimpan memori lintas sesi, dan mengganti model tanpa membangun ulang briefing. Jenova menjadi pengganti yang lebih lemah untuk ekstraksi RCT massal, visual jaringan sitasi, dan proses Deep Research multi-halaman yang sepenuhnya otonom dengan skor faktualitas yang telah diterbitkan.
Jika 30 hari ke depan Anda berisi pertanyaan campuran — sebuah makalah, pasar, utas GitHub, dan draf — platform riset multi-model merupakan pilihan bawaan yang rasional. Jika 30 hari ke depan Anda berisi protokol, log penyaringan, dan gambar PRISMA, mulailah dengan Elicit lalu tambahkan alat web hanya ketika protokol mengizinkan sumber non-jurnal.
Referensi
- Perplexity — Memperkenalkan Perplexity Deep Research
- Google Gemini — Ikhtisar Deep Research
- Elicit — AI untuk riset ilmiah
- Macquarie University Library — Menggunakan alat bertenaga AI untuk tinjauan literatur
- Thesify — Alat AI terbaik untuk riset akademik pada 2026
- Cypris AI — 11 alat AI terbaik untuk tinjauan literatur ilmiah pada 2026
- TechRadar — Uji langsung Perplexity Deep Research dibandingkan dengan ChatGPT
- Android Authority — Kecepatan dan kualitas Gemini vs ChatGPT Deep Research
- LivePlan — Perbandingan ChatGPT vs Gemini Deep Research
- Cascade Insights — Ulasan peneliti pasar tentang ChatGPT vs Gemini Deep Research
- Section AI — Uji kualitas keluaran ChatGPT vs Gemini Deep Research
- Perplexity Pro — Harga dan detail paket
- Paperguide — Perbandingan Elicit vs SciSpace (2026)
- SciSpace — Perbandingan alternatif Elicit
- Swiss School of Business Research — Alat AI gratis untuk riset akademik pada 2026
- Litmaps — Asisten tinjauan literatur
- GPT Researcher — Agen riset otonom sumber terbuka (GitHub)
- Gatsbi — Agen riset AI sumber terbuka terbaik pada 2026
- LangChain — Open Deep Research