Platform AI Mana yang Terbaik untuk Mengekstrak Desain Studi, Hasil, dan Keterbatasan?
2026-08-21
Bagaimana Anda Harus Menilai Alat AI Berdasarkan Ekstraksi Empat Kolom yang Dapat Ditelusuri, Bukan Ringkasan Artikel Generik?
Untuk mengekstrak desain studi, sampel, hasil, dan keterbatasan ke dalam tabel bukti yang dapat diverifikasi, Agen riset fleksibel seperti Jenova's Academic Research Assistant paling unggul ketika artikel bersifat heterogen dan keterbatasan memerlukan interpretasi, sedangkan Elicit dan Paperguide lebih unggul ketika Anda membutuhkan ekstraksi berbasis templat untuk kumpulan uji coba yang besar dan relatif terstandarisasi. SciSpace dan Consensus berguna untuk penemuan literatur serta jawaban bukti yang cepat, tetapi lebih lemah sebagai mesin ekstraksi utama.
Perbedaan yang penting pada 2026 bukanlah “alat mana yang merangkum PDF.” Melainkan, alat mana yang dapat mengisi empat kolom — metode, sampel, luaran, dan keterbatasan — dengan provenans yang dapat diaudit.
Faktor-faktor utama yang membedakan bukti yang dapat diekstrak dari ringkasan yang terdengar lancar:
✅ Kesesuaian skema — alat mengembalikan desain studi, n, populasi, luaran, dan keterbatasan sebagai kolom terpisah, bukan paragraf gabungan. ✅ Landasan sumber — setiap sel mengutip kalimat, tabel, gambar, atau halaman, bukan sekadar judul artikel. ✅ Kecerdasan keterbatasan — bias, generalisasi, dan kesenjangan pelaporan diklasifikasikan, bukan disalin dari pernyataan kehati-hatian penulis. ✅ Struktur lintas-artikel — keluaran tersusun berdampingan sehingga Anda dapat membandingkan, bukan membaca ulang. ✅ Alur kerja yang dapat diverifikasi manusia — Anda dapat menolak, mengoreksi, dan menggunakan kembali tabel tanpa memulai dari awal.
Untuk membandingkan platform ini secara jujur, akan membantu jika Anda menilainya berdasarkan standar empat kolom tersebut, bukan hanya kualitas ringkasan.
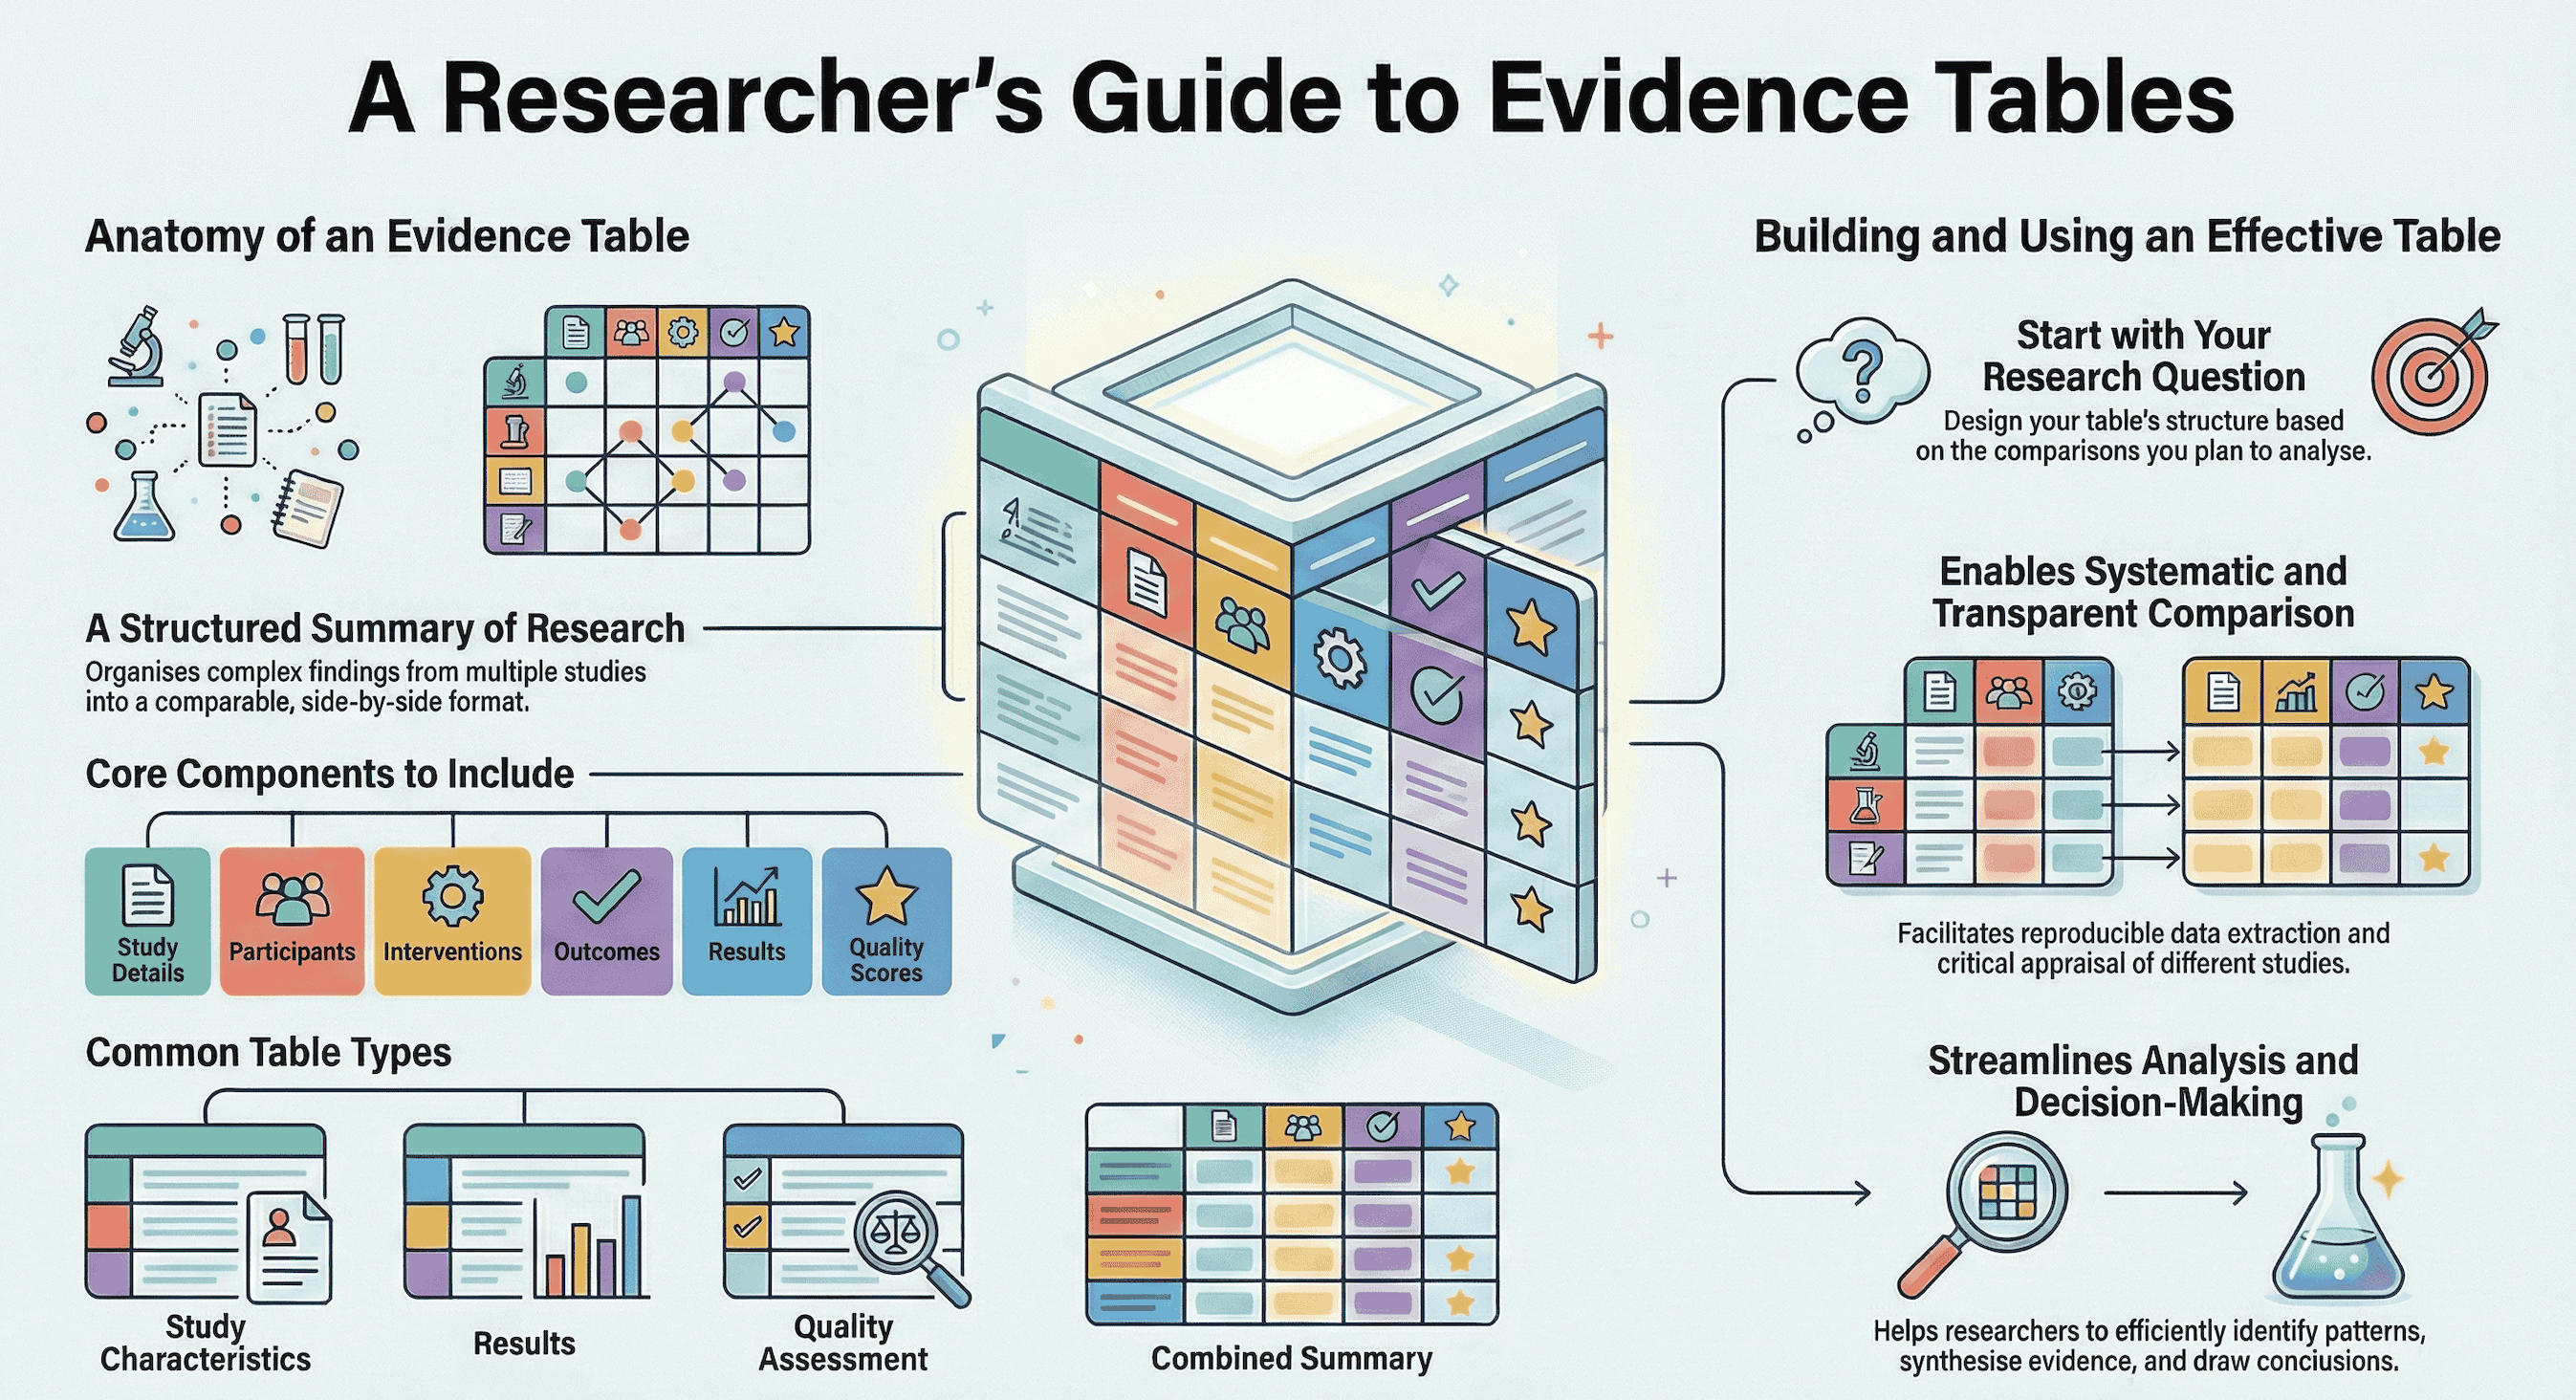
Mengapa Ekstraksi Desain Studi dan Keterbatasan Menjadi Hambatan bagi Peneliti?
Ekstraksi data manual masih menjadi salah satu tahap sintesis bukti yang paling lambat dan paling rentan kesalahan. Karena itu, peneliti kini menggunakan AI untuk menarik metode, sampel, hasil, dan keterbatasan ke dalam tabel yang dapat dibandingkan. PRISMA 2020 meminta penelaah melaporkan apa yang dilakukan, bagaimana studi dipilih, apa yang ditemukan, dan bagaimana risiko bias dinilai. Standar pelaporan itu mengasumsikan adanya tahap ekstraksi terstruktur yang masih dilakukan secara manual oleh sebagian besar tim.
Hambatannya adalah volume ditambah heterogenitas. Seorang mahasiswa pascasarjana mungkin perlu membandingkan sepuluh artikel berdasarkan desain dan n. Sebuah tim tinjauan sistematis mungkin perlu menyaring ratusan rekaman, lalu mengekstraknya ke formulir yang telah ditentukan. Panduan tradisional memandang ekstraksi data sebagai pemilihan karakteristik studi dan pengorganisasiannya dari laporan, yang terdengar sederhana hingga setiap artikel menyembunyikan ukuran sampel di catatan kaki dan keterbatasan dalam satu paragraf defensif.
AI mengubah biaya untuk tahap awal. Sebuah studi-dalam-tinjauan tahun 2026 menemukan bahwa ekstraksi berbantuan Elicit tidak lebih rendah akurasinya dibandingkan ekstraksi oleh manusia saja, sekitar 25 menit lebih cepat per pengekstrak, dan lebih murah pada 50 RCT. Komentar sintesis bukti yang lebih luas kini memperkirakan pengurangan beban kerja AI sebesar 50–75% di seluruh tahap tinjauan. Kecepatan tidak sama dengan tabel yang layak dikutip. Masalah riset pada 2026 adalah mengeluarkan metode, sampel, hasil, dan keterbatasan dari PDF dalam bentuk yang dapat diperiksa penelaah lain.
Apa yang Membuat Alur Kerja Ekstraksi AI Cukup Andal untuk Tabel Bukti?
Alur kerja ekstraksi AI yang andal adalah alur yang mengembalikan kolom lengkap dan dapat dibandingkan dengan provenans tingkat kutipan atau tingkat halaman, lalu tetap menempatkan manusia sebagai pengambil keputusan untuk inklusi dan interpretasi. Kelancaran bahasa bukan ujiannya. Tabel buktilah ujiannya.
Kami menggunakan standar empat kolom — sebut saja MSOL (Methods, Sample, Outcomes, Limitations) — dan menilai alat pada enam dimensi:
- Kesesuaian skema — Apakah keluaran mempertahankan desain, sampel, hasil, dan keterbatasan sebagai kolom yang berbeda?
- Landasan sumber — Apakah setiap nilai dapat ditelusuri ke kalimat, tabel, gambar, atau halaman?
- Kecerdasan keterbatasan — Apakah alat mengklasifikasikan kelemahan (bias, generalisasi, pelaporan), atau hanya menyatakan kembali bagian Keterbatasan dari penulis?
- Penyelarasan lintas-studi — Dapatkah Anda membandingkan n, desain, dan luaran tanpa memformat ulang?
- Kemampuan audit — Apakah jejaknya akan bertahan dalam pemeriksaan penelaah kedua, pembimbing, atau paragraf metode PRISMA?
- Kesesuaian dengan korpus — Apakah alat dirancang untuk uji coba terstandarisasi, metode campuran, atau ekstraksi ulang secara percakapan?
Pemetaan ini bukan sembarang pilihan. PRISMA 2020 mewajibkan penelaah melaporkan metode risiko bias, dan RoB 2 mengevaluasi randomisasi, penyimpangan dari intervensi yang dimaksudkan, data luaran yang hilang, pengukuran, serta pemilihan hasil yang dilaporkan. Alat yang mengekstrak nilai p tetapi tidak dapat mengungkap bias pengambilan sampel atau perancu tidaklah lengkap untuk pekerjaan tinjauan.
Dua aturan praktis dapat diambil. Pertama, variabel terstandarisasi (label desain, n, nama lengan studi) adalah area yang paling kuat bagi AI saat ini; evaluasi terkait Cochrane menemukan kinerja ekstraksi AI tinggi dan serupa dengan penelaah manusia, terutama pada variabel terstandarisasi. Kedua, keterbatasan dan catatan kualitatif masih memerlukan pemeriksaan manusia. panduan sintesis bukti King’s College London memperlakukan AI sebagai alat yang berguna di berbagai tahap, bukan sebagai pengganti penelaah tanpa pengawasan.
Alat AI Mana yang Menghasilkan Tabel Bukti Paling Berguna dari Artikel Akademik?
Elicit dan Paperguide saat ini menghasilkan tabel bukti paling mirip templat dalam skala besar, sedangkan Jenova's Academic Research Assistant lebih efektif ketika Anda memerlukan kolom khusus, klasifikasi keterbatasan, dan pertanyaan lanjutan pada PDF yang diunggah. SciSpace dan Consensus membantu Anda menemukan serta memahami artikel secara awal; keduanya bersifat sekunder untuk ekstraksi MSOL.
Perbandingan independen pada 2026 selaras dengan pembagian tersebut. Penelaah umumnya menempatkan Elicit lebih unggul untuk penemuan literatur dan ekstraksi data, serta Consensus lebih unggul untuk pertanyaan ilmiah ya/tidak. Perbandingan fitur juga memperlakukan Elicit sebagai alat yang lebih kuat untuk alur kerja bukti ketat dan SciSpace sebagai alat yang lebih kuat untuk penemuan eksploratif serta penulisan cepat. Panduan perpustakaan universitas kini mencantumkan alat literatur AI sebagai pelengkap untuk ringkasan, jaringan, dan ekstraksi, bukan sebagai pengganti penuh untuk penilaian kritis.
| Fitur / Dimensi | Elicit | Jenova Academic Research Assistant | Paperguide | SciSpace | Consensus |
|---|---|---|---|---|---|
| Ekstraksi desain studi & sampel | Kuat; kolom khusus serta ekstraksi tabel/gambar | Kuat pada PDF yang diunggah melalui skema MSOL berbasis prompt | Kuat; kolom yang ditentukan pengguna di seluruh artikel yang dipilih | Sedang; lebih baik untuk orientasi tingkat artikel daripada skema ketat | Lemah sebagai pengekstrak utama; dioptimalkan untuk jawaban tingkat klaim |
| Ekstraksi hasil | Kuat, termasuk luaran numerik dari tabel | Kuat ketika PDF dilampirkan dan kolom dispesifikasikan | Kuat, dengan tautan sumber tingkat sel | Sedang; ringkasan berguna, kurang bersifat tabel-native | Sedang untuk temuan utama, bukan grid multi-lengan |
| Kedalaman keterbatasan / risiko bias | Baik untuk kolom yang dilaporkan; klasifikasi interpretatif lebih terbatas | Kuat untuk mengklasifikasikan bias versus generalisasi dengan referensi halaman | Baik ketika Anda menentukan kolom keterbatasan | Terbatas; eksploratif, bukan berfokus pada penilaian | Terbatas; tidak dirancang untuk tabel kelemahan terstruktur |
| Provenans | Sitasi tingkat kalimat atau gambar pada klaim | Sitasi halaman/kutipan dalam tabel terstruktur ketika diprompt | Setiap nilai yang diekstrak ditautkan ke pernyataan sumbernya | Penautan tingkat artikel lazim pada alat pencarian/tinjauan | Jawaban berbasis sumber, bukan tabel bukti tingkat sel |
| Alur kerja penyaringan / tinjauan | Dibangun untuk penyaringan SLR, termasuk set besar dan audit bergaya PRISMA | Tinjauan percakapan atas artikel terpilih; bukan penyaring 40.000 rekaman | Tinjauan ganda dan pelaporan PRISMA dalam satu ruang kerja | Pencarian literatur dan Deep Review untuk eksplorasi | Ringkasan konsensus cepat di seluruh artikel |
| Harga (per 2026) | Plus sekitar $12/bulan; Pro sekitar $49/bulan; Enterprise khusus | Tingkat gratis dengan penggunaan terbatas; Plus $20/bulan (30×); tingkat lebih tinggi meningkatkan kapasitas penggunaan | Ruang kerja berbasis kursi; harga publik belum dapat diverifikasi di sini | Tingkat berbayar awal sekitar $12/bulan tahunan, dengan paket lebih tinggi yang mencakup penulisan | Paket Pro berbayar tersedia; harga resmi 2026 belum dapat diverifikasi di sini |
| Paling cocok untuk | Tinjauan sistematis berbasis protokol atas laporan studi yang relatif standar | Tabel empat kolom khusus, penilaian keterbatasan, dan ekstraksi iteratif pada set artikel kerja | Ekstraksi yang dapat diaudit beserta penulisan dalam satu pustaka | Pemetaan awal, pembacaan, dan dukungan naskah | Pertanyaan cepat “apa yang dikatakan literatur?” |
Elicit
Elicit adalah spesialis ekstraksi yang dirancang khusus dalam kumpulan ini. Produk tersebut mencari, merangkum, mengekstrak dari, dan mengobrol dengan korpus yang menurut Elicit berisi lebih dari 125 juta artikel, serta melaporkan penggunaan oleh lebih dari 2 juta peneliti. Alur kerja tinjauan sistematisnya menekankan ekstraksi dari tabel dan gambar, sel yang didukung kutipan, penyaringan pada skala sangat besar, serta laporan dengan artefak metode bergaya PRISMA.
Fokus itu merupakan kekuatan nyata untuk korpus mirip RCT. Namun, hal itu juga menjadi keterbatasan: Anda membayar untuk mesin tinjauan, sementara pekerjaan interpretatif — mengklasifikasikan ulang keterbatasan, menanyakan “apa yang gagal mereka kendalikan?” — tetap berada pada penelaah. Harga tingkat Pro cukup mahal bagi mahasiswa yang hanya membutuhkan tabel sesekali.
Jenova Academic Research Assistant
Jenova's Academic Research Assistant dirancang sebagai mitra riset, bukan pabrik penyaringan. Ia menemukan literatur, mendukung pekerjaan naskah dan sitasi, serta — di platform Jenova — dapat membaca PDF yang dilampirkan, mempertahankan memori persisten di seluruh sesi, dan memanggil alat pencarian akademik. Anda menentukan kolom MSOL dalam bahasa alami, lalu melakukan iterasi ketika suatu artikel menyembunyikan n di diagram CONSORT atau menyebarkan keterbatasan di seluruh bagian Diskusi.
Keterbatasan yang jujur bersifat arsitektural. Alat ini tidak menyediakan antrean penyaringan penelaah ganda untuk puluhan ribu rekaman, dan belum menerbitkan uji akurasi bergaya SWAR yang sebanding dengan Elicit. Kualitas ekstraksi bergantung pada prompt, file yang dilampirkan, dan pemeriksaan manusia. Untuk satu bab tesis berisi 12 artikel, fleksibilitas itulah poin utamanya. Untuk tinjauan PRISMA dengan 2.000 rekaman, mode tinjauan Elicit atau Paperguide lebih sesuai.
Paperguide
Paperguide berada di antara pustaka, pengekstrak, dan penulis. Platform ini mengindeks lebih dari 200 juta artikel, memungkinkan Anda menentukan kolom ekstraksi, menautkan setiap nilai ke pernyataan sumber, serta dapat mengekspor tabel ke CSV atau Excel. Mode tinjauan sistematisnya menekankan tinjauan ganda, keputusan akhir oleh manusia, dan diagram PRISMA dari jumlah aktual.
Kekuatan: provenans dan satu ruang kerja dari pustaka hingga tabel. Keterbatasan: posisinya terkait kepatuhan masih dalam proses konsolidasi (perusahaan sendiri menandai GDPR, SOC 2, dan ISO 27001 sebagai fitur yang akan datang), dan harga publik yang stabil lebih sulit dipastikan dibandingkan tingkat harga Elicit yang banyak dikutip. Tim yang memerlukan jejak audit bernama dalam satu produk akan lebih memedulikan ruang kerja itu daripada fleksibilitas percakapan.
SciSpace
SciSpace adalah ruang kerja riset yang luas: pencarian, pembacaan, penulisan, dan alat referensi, dengan tingkat berbayar awal yang lebih murah daripada Elicit Pro. Berbagai perbandingan secara konsisten menempatkannya sebagai pendamping eksplorasi dan penulisan yang lebih baik, bukan pengekstrak yang lebih ketat. Gunakan untuk memetakan bidang secara cepat. Jangan berharap alat ini menjadi sistem pencatatan utama untuk kolom MSOL di seluruh tinjauan.
Consensus
Consensus dioptimalkan untuk pertanyaan yang berbeda: apa yang disepakati oleh literatur? Itu berharga untuk orientasi awal dan jawaban tingkat klaim. Namun, ini bukan alat utama yang tepat jika hasil kerja Anda adalah tabel desain, ukuran sampel, estimasi efek, dan keterbatasan yang diklasifikasikan. Padukan dengan pengekstrak, jangan menggantikannya dengan alat ini.
Seberapa Akurat AI Dapat Mengekstrak Desain Studi dan Karakteristik Sampel?
Bukti saat ini menunjukkan bahwa AI dapat menyamai pengekstrak manusia pada banyak kolom metode dan sampel yang terstandarisasi, sambil tetap melewatkan atau salah membaca pelaporan yang tidak teratur. Akurasinya cukup tinggi untuk tahap awal. Namun, belum cukup tinggi untuk melewati verifikasi.
Perbandingan langsung yang paling jelas sejauh ini adalah SWAR noninferior tahun 2026 pada 50 RCT penyakit kronis: akurasi keseluruhan tidak berbeda antara ekstraksi berbantuan Elicit dan ekstraksi oleh manusia saja, sedangkan kelompok berbantuan AI lebih cepat dan lebih murah. Hasil subkelompok tidak selalu identik; kelompok berbantuan AI lebih akurat untuk beberapa deskriptor intervensi/kontrol. Jenis kesalahan seperti data terlewat dan kesalahan kecil tampak serupa. Ini adalah argumen untuk menggantikan satu pengekstrak manusia dengan pengekstrak berbantuan AI, bukan untuk ekstraksi tanpa pengawasan.
Angka yang dilaporkan vendor lebih tinggi dan perlu dibaca sebagaimana adanya. Elicit menyatakan bahwa sebuah tinjauan kebijakan pendidikan di Jerman mengekstrak 1.502 dari 1.511 titik data dengan benar (99,4%), serta perbandingan CSIRO menemukan hampir nol negatif palsu pada informasi utama. Pengujian perpustakaan terpisah melaporkan akurasi ekstraksi model bahasa besar sekitar 96% pada 160 elemen data ketika PDF disediakan. Angka-angka itu menjanjikan untuk label desain, n, lengan studi, dan luaran primer. Namun, angka tersebut hanya sedikit menjelaskan apakah alat mengenali pengambilan sampel purposif atau perancu yang tidak dikendalikan.
Dalam praktiknya, desain studi dan sampel gagal diekstrak dengan cara yang dapat diprediksi:
- Desain dilaporkan sebagai “acak” tanpa detail alokasi.
- n adalah jumlah yang disaring, bukan jumlah yang dianalisis.
- Populasi adalah label klinik, bukan kriteria inklusi.
- Latar (pedesaan, tersier, khusus aplikasi) dihilangkan, yang kemudian merusak generalisasi.
Tahap AI yang baik menandai kesenjangan tersebut sebagai sel kosong. Tahap yang buruk menciptakan nama desain yang rapi. Sel kosong lebih ilmiah daripada tebakan yang terdengar lancar.
Bagaimana Alat AI Harus Menangani Hasil Dibandingkan Keterbatasan yang Dinyatakan Penulis?
Hasil harus diekstrak sebagai luaran yang dilaporkan beserta angka dan titik waktunya; keterbatasan harus dinilai ulang, bukan ditranskripsikan. Inilah kesenjangan kualitas terbesar di antara platform riset AI.
Ekstraksi hasil adalah bagian yang lebih mudah. Luaran sering berada dalam tabel, dan Elicit secara khusus memasarkan ekstraksi tabel dan gambar karena di sanalah banyak endpoint klinis berada. Model Paperguide — kolom khusus ditambah kemampuan kembali ke kalimat pendukung dengan sekali klik — adalah pola verifikasi yang tepat untuk ukuran efek, interval kepercayaan, dan jumlah responden. Jika suatu hasil tidak dapat ditunjukkan sumbernya, hasil tersebut tidak seharusnya masuk ke tabel bukti.
Ekstraksi keterbatasan adalah tugas yang berbeda. Penulis kurang melaporkan. Mereka menyebut ukuran sampel dan melewatkan perancu. Mereka menyebut “penelitian di masa depan” dan melewatkan metode pengambilan sampel. Penilaian risiko bias seharusnya spesifik terhadap suatu hasil dan diklasifikasikan, misalnya rendah / beberapa kekhawatiran / tinggi pada RoB 2. Menyalin paragraf Keterbatasan tidak memenuhi standar tersebut.
Keluaran yang lebih berguna berbentuk tabel kelemahan terstruktur: artikel, kategori (bias, generalisasi, pelaporan), kelemahan dalam satu kalimat, serta halaman atau kutipan. Format ini memaksa model memutuskan jenis keterbatasan yang ditemukan.
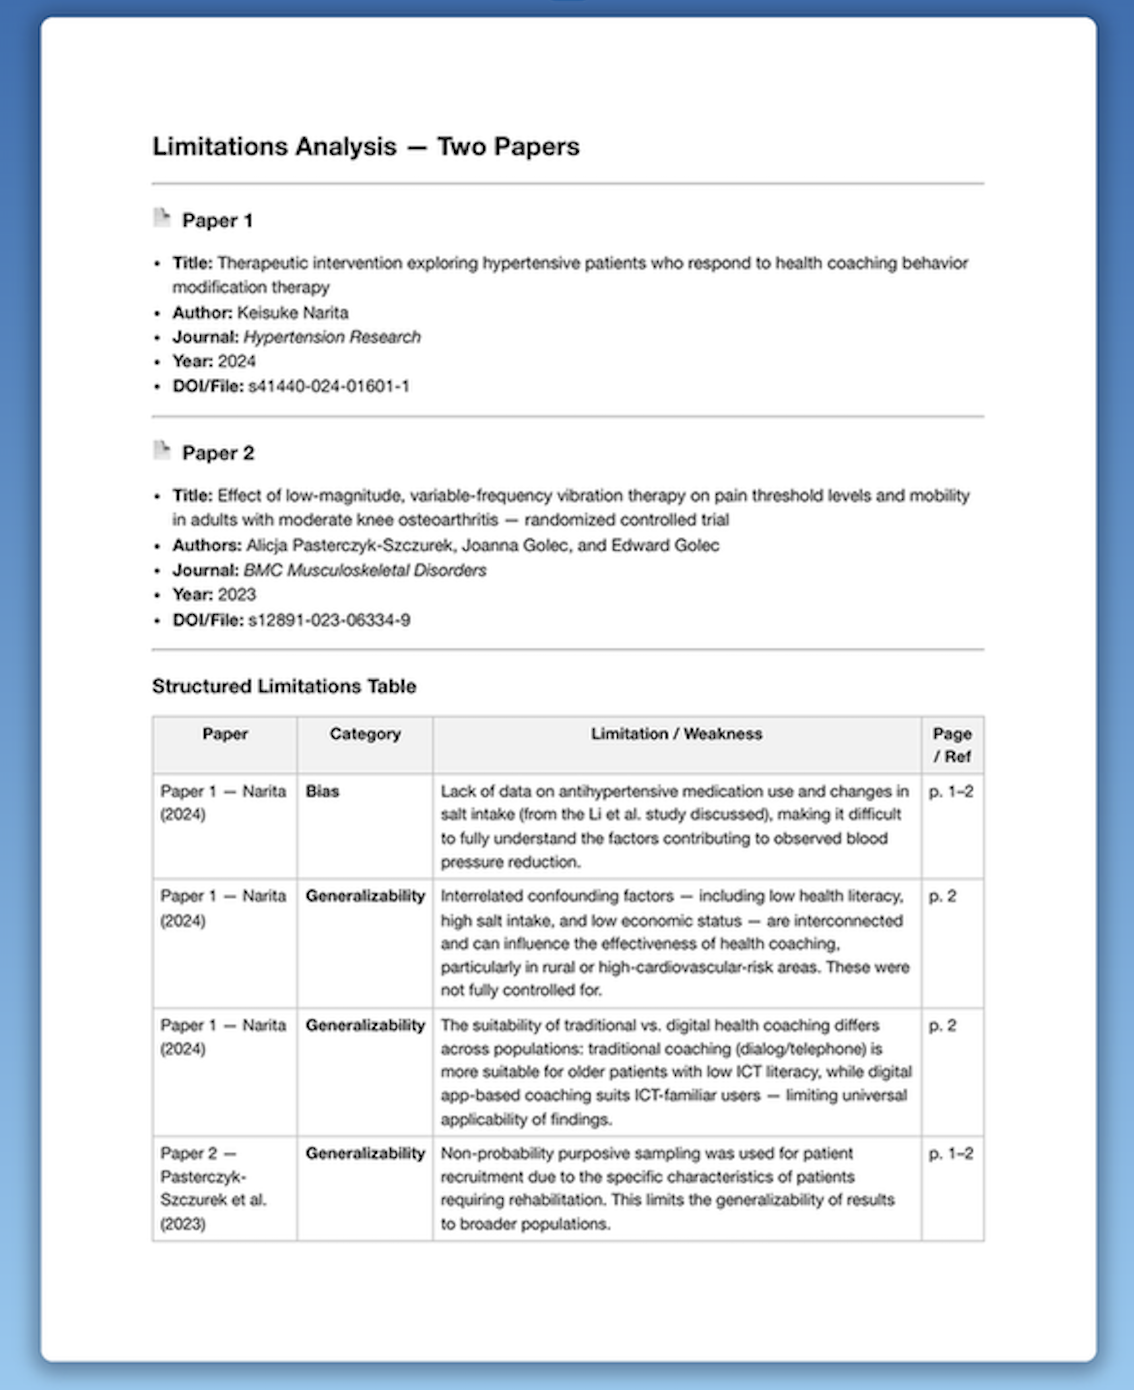
Menelaah tata letak tersebut menunjukkan mengapa percakapan AI generik tidak memadai. Sebuah uji coaching hipertensi dapat menurunkan tekanan darah tanpa melaporkan penggunaan antihipertensi atau asupan garam — ini adalah masalah bias. Artikel yang sama dapat mencampurkan literasi kesehatan, pola makan, dan pendapatan sehingga temuan tidak dapat digeneralisasikan — ini adalah masalah generalisasi. Uji terapi getaran mungkin menggunakan pengambilan sampel purposif terhadap pasien rehabilitasi — sekali lagi masalah generalisasi, bukan sekadar “penulis mencatat sampel kecil.” Alat yang hanya merangkum Diskusi akan melewatkan taksonomi tersebut.
Jenova's Academic Research Assistant relatif kuat dalam hal ini karena Anda dapat menuntut taksonomi tersebut dalam prompt dan mempertahankannya tetap stabil di seluruh tumpukan PDF. Elicit dan Paperguide akan menangkap kolom keterbatasan jika Anda menambahkannya; secara bawaan, keduanya tidak akan berpikir seperti penelaah metode. Consensus akan memberi tahu apakah studi “menunjukkan efek.” Ia tidak akan membangun tabel ini.
Bagaimana Menjalankan Ekstraksi Empat Kolom pada Sekumpulan PDF?
Mulailah dengan skema yang dikunci, ekstrak setiap artikel ke dalam empat kolom yang sama, lalu verifikasi angka dan klasifikasikan ulang keterbatasan sebelum melakukan sintesis. Skema lebih penting daripada merek bot percakapan.
Skema MSOL yang dapat digunakan adalah:
- Metode: desain, randomisasi/pembutaan jika ada, intervensi, pembanding, tindak lanjut.
- Sampel: n yang dianalisis, populasi, latar, metode pengambilan sampel.
- Luaran: hasil primer dengan statistik, titik waktu, dan arah.
- Keterbatasan: bias, generalisasi, pelaporan — masing-masing dengan penanda lokasi.
Untuk Jenova's Academic Research Assistant, urutan umumnya adalah:
- Buka Agen dan lampirkan PDF (atau folder artikel yang ingin Anda bandingkan).
- Kunci skema dalam pesan pertama agar setiap artikel berikutnya menggunakan kolom yang sama.
- Minta penanda lokasi pada setiap sel:
“Buat satu tabel bukti untuk artikel-artikel ini. Kolom: sitasi, desain studi, sampel (n yang dianalisis, populasi, latar, pengambilan sampel), hasil primer dengan ukuran efek dan titik waktu, serta keterbatasan yang diklasifikasikan sebagai Bias, Generalisasi, atau Pelaporan. Setiap sel harus mencantumkan halaman atau kutipan. Biarkan sel kosong jika artikel tidak melaporkannya. Jangan memparafrasekan bagian Keterbatasan penulis tanpa mengklasifikasikannya kembali.”
- Periksa secara acak n, desain, dan ukuran efek apa pun terhadap PDF. Koreksi tabel dalam percakapan; memori persisten mempertahankan skema untuk batch berikutnya.
- Jika Anda membutuhkan dokumen yang dapat dibagikan, masukkan tabel terverifikasi ke Word Doc Generator, alih-alih menata ulangnya secara manual.
- Untuk narasi yang berada di atas tabel, Deep Research merupakan langkah lanjutan yang lebih baik daripada meminta pengekstrak berubah menjadi tinjauan sistematis kedua.
Untuk Elicit, jalur paralelnya adalah: kumpulkan artikel dalam tampilan tinjauan sistematis atau ekstraksi, terima atau edit kolom yang disarankan, ekstrak dengan dukungan kutipan, lalu perlakukan AI sebagai sepasang mata kedua. Alur tinjauan sistematis Elicit sendiri dibangun berdasarkan templat yang dapat diedit, sel yang didukung kutipan atau gambar, serta kesepakatan manusia atas kriteria penyaringan. Untuk Paperguide, tentukan kolom sekali, ekstrak di seluruh set terpilih, dan ekspor CSV/Excel ketika grid sudah stabil.
Dua pola buruk yang perlu dihindari. Jangan mengekstrak 40 artikel dengan 40 prompt yang sedikit berbeda. Jangan biarkan model mengisi kekosongan dengan “kemungkinan RCT” atau “sampel memadai.” Kosong adalah sebuah temuan.
Apa Kata Spesialis Sintesis Bukti tentang Ekstraksi Data AI?
Para metodolog semakin memperlakukan AI sebagai pengekstrak kedua yang sah untuk kolom terstandarisasi, asalkan setiap nilai tetap dapat diperiksa dan penilaian keterbatasan tetap dipimpin manusia. Konsensus yang muncul bersifat sempit dan praktis, bukan utopis.
“Perdebatan akurasi sebagian besar sudah selesai untuk kolom mudah — label desain, n, nama lengan studi, luaran primer sebagaimana dilaporkan. Perbandingan terkontrol kini menunjukkan ekstraksi berbantuan AI dapat menyamai pengekstrak manusia pada kolom-kolom itu dan selesai lebih cepat. Mode kegagalan yang tersisa bersifat interpretatif: model menyalin kehati-hatian penulis lalu menyebutnya penilaian kritis. Itu bukan penilaian risiko bias, dan PRISMA tetap mengharuskan Anda menjelaskan bagaimana bias dinilai.”
“Yang kami cari dari sebuah platform bukanlah ringkasan yang lebih indah. Yang kami cari adalah kebijakan sel kosong, penanda lokasi pada setiap angka, dan skema keterbatasan yang dapat mencatat perancu, pengambilan sampel, dan validitas eksternal bahkan ketika artikel tidak pernah menggunakan kata-kata tersebut. Jika Anda tidak dapat mengklik ukuran sampel kembali ke sebuah kalimat, Anda tidak memiliki ekstraksi. Anda hanya memiliki draf.”
“Pilih alat yang sesuai dengan bentuk korpus. Produk ekstraksi khusus unggul pada kumpulan uji coba yang besar dan homogen. Agen riset percakapan unggul ketika artikel beragam, PDF berantakan, dan pertanyaan ilmiahnya adalah ‘apa yang tidak dapat kita simpulkan?’ Sebagian besar proyek pascasarjana dan klinis nyata termasuk jenis kedua.”
— Tim Produk Jenova, desain alur kerja riset akademik (pengalaman membangun Agen AI untuk tinjauan literatur dan tabel bukti)
Pandangan tersebut konsisten dengan catatan eksternal: ekstraksi berbantuan yang noninferior dalam SWAR 2026, kinerja tinggi pada variabel terstandarisasi dalam studi bergaya penelaah, serta panduan perpustakaan yang tetap menempatkan manusia sebagai pengambil keputusan akhir.
Kapan Agen Riset Fleksibel Lebih Cocok daripada Platform Ekstraksi Khusus?
Agen riset fleksibel lebih cocok ketika set artikel Anda kecil hingga menengah, desainnya beragam, dan keterampilan yang langka adalah menginterpretasikan keterbatasan — bukan menyaring 10.000 judul. Platform khusus lebih cocok ketika protokol, tinjauan ganda, dan hitungan PRISMA merupakan hasil kerjanya.
Pilih pengekstrak khusus (Elicit atau Paperguide) ketika:
- Anda menjalankan tinjauan sistematis atau cakupan dengan protokol yang dipraregistrasi.
- Sebagian besar studi yang disertakan adalah uji coba atau laporan lain yang sangat bertemplat.
- Anda membutuhkan log penyaringan, alasan eksklusi, dan diagram alur.
- Beberapa penelaah harus menyelesaikan konflik pada rekaman yang sama.
Pilih Jenova's Academic Research Assistant ketika:
- Anda menulis bab tesis, latar belakang hibah, diskusi jurnal, atau pemindaian bukti cepat.
- Artikel mencampurkan RCT, studi observasional, dan penelitian kualitatif.
- Anda lebih peduli pada keterbatasan yang diklasifikasikan daripada kolom PICO yang disarankan otomatis.
- Anda sudah bekerja lintas model, PDF yang diunggah, dan pertanyaan lanjutan dalam satu percakapan.
Penggunaan hibrida lazim dan masuk akal. Petakan pertanyaan di SciSpace atau Consensus, ekstrak kolom MSOL di Jenova atau Elicit, dan pertahankan pencatatan PRISMA pada modul tinjauan apa pun yang diterima institusi Anda. Perbandingan SciSpace versus Consensus menjelaskan pembagian kerja tersebut: Consensus untuk pembacaan cepat atas kesepakatan, SciSpace untuk penelusuran yang lebih mendalam. Tidak ada pasangan alat yang menghilangkan kebutuhan pemeriksaan manusia terhadap n, luaran, dan bias.
Keterbatasan Jenova dalam pilihan ini adalah skala dan formalitas. Jenova tidak akan menggantikan alur penyaringan tingkat perusahaan. Keterbatasan Elicit adalah kebalikannya: grid sangat baik, tetapi dukungan bawaan untuk pekerjaan yang rumit dan argumentatif dalam menjelaskan mengapa suatu temuan tidak dapat digeneralisasikan lebih terbatas. Jika hasil kerja Anda adalah tabel bukti yang dapat diaudit pembimbing, nilai alat berdasarkan kelengkapan dan provenans MSOL terlebih dahulu, baru kemudian berdasarkan merek atau harga bulanan.
Referensi
- Pernyataan PRISMA — panduan pelaporan untuk tinjauan sistematis
- DistillerSR — alat dan teknik ekstraksi data untuk tinjauan sistematis
- medRxiv — akurasi dan efisiensi ekstraksi data berbantuan AI menggunakan Elicit (SWAR 2026)
- Paperguide — alat AI untuk tinjauan sistematis dan pengurangan beban kerja yang dilaporkan
- The BMJ — pernyataan PRISMA 2020
- PubMed Central — penjelasan dan elaborasi PRISMA 2020, termasuk domain RoB 2
- Wiley / Cochrane Evidence Synthesis and Methods — alat AI sebagai penelaah kedua untuk ekstraksi data
- King’s College London — alat AI dalam sintesis bukti
- PapersFlow — perbandingan AI Elicit vs Consensus
- Paperguide — perbandingan fitur dan harga Elicit vs SciSpace (2026)
- George Mason University — alat AI untuk tinjauan literatur
- Elicit — AI untuk riset ilmiah, angka korpus dan penggunaan
- Elicit — alur kerja tinjauan literatur sistematis, klaim akurasi ekstraksi, dan penyaringan
- SciSpace — perbandingan SciSpace vs Elicit, termasuk tingkat harga 2026
- Paperguide — dokumentasi platform untuk kolom ekstraksi khusus dan nilai yang ditautkan ke sumber
- Himmelfarb Health Sciences Library — kualitas pelaporan dan risiko bias
- Birmingham City University — catatan akurasi ekstraksi data AI
- Paperguide — perbandingan SciSpace vs Consensus