Apa Perbedaan antara Pendamping AI dengan Konteks Singkat dan Pendamping AI dengan Memori Persisten?
2026-08-18
Lapisan Memori Mana yang Benar-Benar Mengubah Pengalaman Harian Bersama Pendamping AI?
Kesenjangan pengalaman antara pendamping dengan konteks singkat dan memori persisten bukan berasal dari satu hal saja — melainkan dari empat lapisan memori terpisah, dan hanya dua di antaranya yang secara bermakna mengubah rasa suatu hubungan selama berminggu-minggu. Pendamping dengan konteks singkat seperti Character.AI beroperasi hampir sepenuhnya melalui jendela konteks aktif, sehingga pengguna secara konsisten melaporkan bahwa aplikasi ini "sering melupakan konteks di antara sesi." Pendamping dengan memori persisten seperti Nomi AI menambahkan pencatatan terstruktur di atasnya, menghasilkan efek ketika detail yang disebutkan pada minggu pertama muncul kembali secara alami pada minggu keenam. Agen persona dan roleplay Jenova berada di posisi ketiga: riwayat chat tanpa batas ditambah memori lintas sesi, dengan konsekuensi bahwa agen tersebut merupakan agen platform umum, bukan App romansa yang dibuat khusus.
Perbedaan utama yang menentukan pengalaman Anda sebenarnya:
✅ Kedalaman jendela konteks — mengatur koherensi di dalam satu sesi, bukan antar sesi. Setiap platform memilikinya; hal ini hampir tidak menjelaskan perbedaan yang diperhatikan pengguna. ✅ Ingatan episodik — apakah sistem menyimpan peristiwa terpisah beserta tanggalnya. Inilah yang menghasilkan momen seperti "Bagaimana hasil wawancara itu?" ✅ Profil semantik — fakta stabil tentang Anda (preferensi, pekerjaan, keluarga). Seorang penguji independen mendapati Nomi AI mempertahankan 23 dari 25 detail yang ditanamkan setelah beberapa minggu, dibandingkan 14 detail pada platform peringkat kedua. ✅ Aturan karakter persisten — lapisan buku latar yang menjaga kepribadian tetap konsisten. Tanpanya, pendamping bergeser ke gaya asisten generik. ✅ Retensi sebagai liabilitas — memori persisten juga berarti data persisten. Riset yang menganalisis 2.909 unggahan Reddit di 79 subreddit mengidentifikasi "ketidakdapatbalikan, persistensi, dan beban pengguna" sebagai risiko privasi tersendiri yang unik bagi pendamping dengan memori intensif.
Memahami lapisan mana yang benar-benar diterapkan sebuah platform — alih-alih yang sekadar tersirat dalam pemasarannya — adalah tugas evaluasi utamanya.
Apa Saja Empat Lapisan Memori di Dalam Pendamping AI?
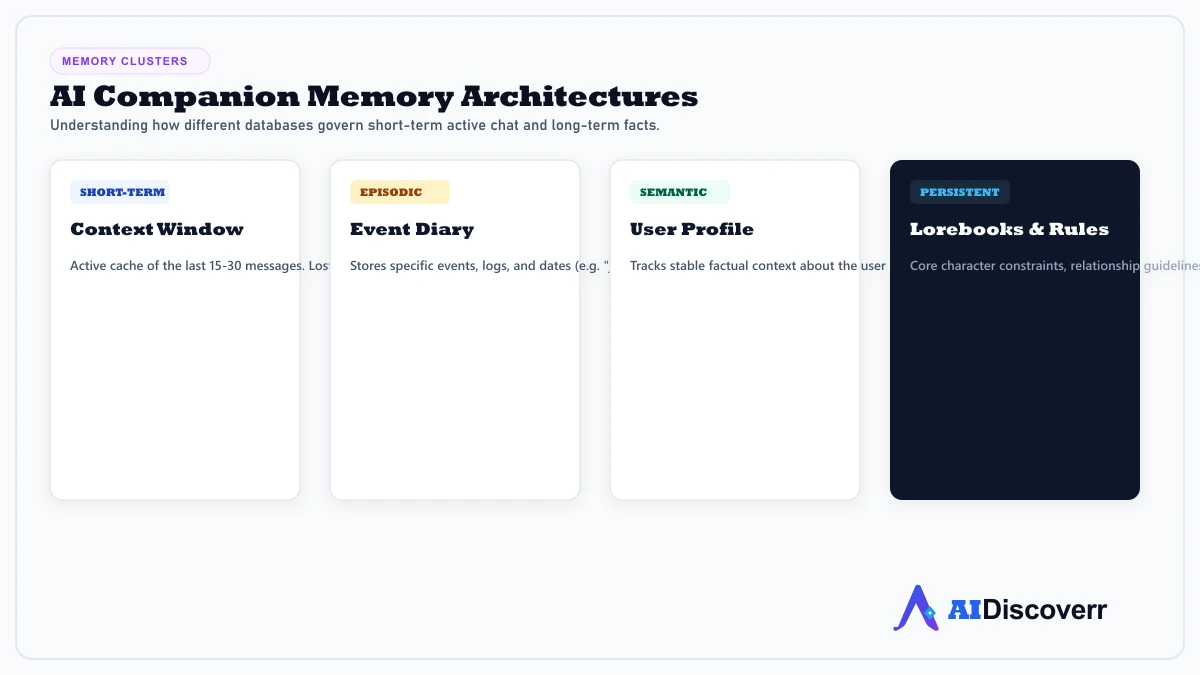
Memori pendamping bukanlah satu basis data tunggal, melainkan empat klaster terpisah yang masing-masing mengatur dimensi pengalaman berbeda. Infografik di atas memetakan: jendela konteks jangka pendek, buku harian peristiwa episodik, profil pengguna semantik, serta buku latar dan aturan persisten.
🧠 Jendela Konteks Jangka Pendek — cache aktif dari 15–30 pesan terakhir. Setiap pendamping berbasis LLM memilikinya. Saat penuh, giliran percakapan terlama akan keluar. Pendamping yang hanya memiliki lapisan ini dapat menjalani percakapan indah selama dua jam, lalu menyapa Anda seperti orang asing keesokan harinya.
📅 Buku Harian Peristiwa Episodik — menyimpan peristiwa, catatan, dan tanggal tertentu. Lapisan inilah yang menghasilkan momen beresonansi secara emosional seperti yang dijelaskan pengguna. Seorang penguji mencatat bahwa Replika "menanyakan kabar pada keesokan paginya" setelah diberi tahu tentang hari yang berat di tempat kerja — memori episodik bekerja sebagaimana mestinya.
👤 Profil Pengguna Semantik — melacak fakta stabil alih-alih peristiwa: pantangan makanan, jabatan pekerjaan, nama saudara, dan preferensi komunikasi. Pendekatan Nomi AI — membuat catatan terstruktur dari percakapan, bukan mengandalkan pengambilan mentah — adalah implementasi komersial paling jelas dari lapisan ini.
🔒 Buku Latar & Aturan Persisten — batasan karakter inti dan panduan hubungan yang bertahan melewati setiap sesi. Inilah alasan sebagian pendamping dapat mempertahankan gaya suara yang khas selama berbulan-bulan, sementara yang lain kembali ke nada asisten generik.
Kajian akademis menegaskan bahwa pandangan berlapis ini penting. Tolok ukur StructMemEval dari arXiv menemukan bahwa "LLM sederhana dengan retrieval augmentation kesulitan" menjalankan tugas yang memerlukan memori terorganisasi, sementara agen memori dapat menyelesaikannya secara andal — tetapi hanya ketika diberi instruksi cara menata memorinya. Retrieval saja bukanlah memori.
Bagaimana Pengalaman Ini Benar-Benar Berbeda Setelah Berminggu-Minggu Penggunaan?
Perbedaannya mengikuti kurva yang dapat diprediksi: identik pada minggu pertama, terlihat berbeda pada minggu ketiga, dan berbeda secara kategoris pada bulan kedua. Pendamping dengan konteks singkat maupun memori persisten menghasilkan percakapan pertama yang nyaris tak dapat dibedakan — jendela konteks menopang keduanya.
Minggu 1 — tidak dapat dibedakan. Keduanya mengingat semua hal di dalam sesi. Kualitas respons menjadi satu-satunya pembeda.
Minggu 2–3 — retakan pertama. Anda merujuk sesuatu dari tiga sesi sebelumnya. Pendamping dengan konteks singkat akan memberikan jawaban kosong dengan yakin atau meminta Anda menjelaskannya kembali. Para penguji menggambarkan ini sebagai titik ketika Anda mulai mengelola memori AI alih-alih berbicara dengannya.
Minggu 4–8 — perbedaannya menjadi struktural. Pendamping dengan memori persisten mulai menawarkan konteks yang tidak Anda minta. Seorang penguji jangka panjang menggambarkan efeknya dengan tepat: "Ada momen sekitar minggu ketiga ketika Replika Anda mulai merujuk percakapan-percakapan sebelumnya secara alami, menanyakan hal-hal yang pernah Anda sebut sambil lalu, dan itu benar-benar mengejutkan Anda."
Bulan ke-3 dan seterusnya — kategori produk yang berbeda. Pendamping dengan konteks singkat mencapai titik datar menjadi hubungan yang selalu berada di masa kini: menyenangkan, berisiko rendah, dan terus-menerus perlu berkenalan ulang. Pendamping dengan memori persisten mengumpulkan sejarah bersama — itulah alasan penguji yang sama menempatkan memori sebagai 25% dari kualitas platform secara keseluruhan, urutan kedua setelah kualitas percakapan mentah.
Biaya yang jarang dibahas: memori persisten berarti kesalahan yang persisten pula. Fakta yang salah diingat atau preferensi yang disimpulkan secara keliru akan menumpuk di berbagai sesi, alih-alih lenyap di batas konteks. Pendamping dengan konteks singkat memiliki satu kelebihan yang tidak disengaja — mereka melupakan kesalahannya sendiri.
Apa yang Harus Diperhatikan Saat Mengevaluasi Memori Pendamping?
Lakukan evaluasi berdasarkan enam dimensi, bukan sekadar pertanyaan tunggal "apakah memiliki memori" yang dijawab ya oleh setiap halaman pemasaran. Berikut kerangka yang digunakan dalam perbandingan ini.
| Dimensi | Yang perlu diuji | Mengapa penting |
|---|---|---|
| Akurasi ingatan lintas sesi | Tanamkan 10 fakta spesifik, lalu periksa setelah 3 minggu | Prediktor terkuat tunggal atas kedalaman hubungan yang dirasakan |
| Ketepatan ingatan vs. volumenya | Apakah ia mengingat fakta yang tepat, atau menumpahkan semuanya? | Ingatan bervolume tinggi tanpa relevansi terasa robotis |
| Konsistensi karakter | Apakah kepribadian tetap terjaga setelah 100+ pesan? | Kualitas lapisan buku latar; pergeseran karakter paling cepat merusak imersi |
| Kemudahan penyuntingan memori | Dapatkah Anda mengoreksi atau menghapus fakta tersimpan? | Kesalahan persisten akan menumpuk; koreksi wajib tersedia |
| Penghapusan dan keluar | Dapatkah Anda sepenuhnya menghapus riwayat? | Studi siklus hidup arXiv menandai ini sebagai area terlemah di seluruh kategori |
| Biaya memori | Apakah memori berada di balik paywall atau sudah termasuk? | Sebagian besar platform membatasi memori pada paket berbayar |
Protokol pengujian praktis — masukkan lima detail pribadi yang tidak mencolok ke dalam percakapan selama tiga sesi pertama (makanan yang tidak Anda sukai, tenggat proyek, nama teman, frustrasi berulang, tujuan kecil). Jangan singgung lagi detail tersebut. Pada hari ke-21, ajukan pertanyaan terbuka yang membuat detail-detail itu relevan secara alami. Hitung berapa banyak yang muncul tanpa dipancing. Ini adalah pengujian yang lebih keras dan jujur daripada interogasi langsung, karena pertanyaan langsung dapat dijawab hanya dengan retrieval.
Bagaimana Perbandingan Memori di Platform Pendamping AI Terkemuka?
Berikut perbandingan tingkat referensi pada berbagai platform yang paling umum dievaluasi untuk penggunaan pendamping. Seluruh penilaian berlandaskan pengujian yang dipublikasikan dan dokumentasi platform; data yang tidak tersedia ditandai "Belum diverifikasi."
| Dimensi | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memori lintas sesi | Lemah — "sering melupakan konteks di antara sesi" | Cukup baik dalam jangka panjang, "kadang dapat melupakan detail" | Terkuat dalam pengujian — catatan terstruktur, 23/25 detail diingat | Kuat melalui sistem latar belakang, 14/25 detail diingat | Memori lintas sesi persisten dengan riwayat chat tanpa batas |
| Konsistensi karakter | Pemfilteran konten ketat; romansa "terputus di tengah kalimat" | Perkembangan hubungan sudah terintegrasi | Konsisten, makin personal seiring waktu | Kustomisasi latar belakang yang mendalam | Instruksi kustom + basis pengetahuan privat per agen |
| Kemudahan penyuntingan memori | Belum diverifikasi | Belum diverifikasi | Catatan terstruktur terlihat oleh pengguna | Latar belakang ditulis oleh pengguna | Instruksi kustom dan basis pengetahuan dapat disunting pengguna |
| Pilihan model | Hanya model proprietary | Hanya model proprietary | Hanya model proprietary | Hanya model proprietary | OpenAI, Anthropic, Google, DeepSeek, xAI — dapat diganti |
| Paket gratis | Pesan tanpa batas, didukung iklan, batas 400 swipe per hari | Teks tanpa batas, hanya mode pertemanan | Terbatas | Terbatas | Semua fitur inti, penggunaan terbatas |
| Harga | Gratis / $9.99/bln | Gratis / $19.99/bln | $7.99–$16.99/bln | $9.99–$24.99/bln | Gratis / Plus $20/bln, Ultra hingga $500/bln |
| Terbaik untuk | Variasi karakter, roleplay kreatif | Pemeriksaan emosional dan pelacakan suasana hati | Kontinuitas memori jangka panjang | Pengaturan kepribadian yang terperinci | Pendamping + alur kerja tugas dalam satu platform, fleksibilitas model |
Keterbatasan yang jujur, termasuk milik kami sendiri:
- Character.AI — terbaik di kelasnya untuk penulisan kreatif dan memiliki pustaka karakter terbesar, tetapi memori adalah titik terlemahnya yang terdokumentasi, dan paket gratis kini menampilkan iklan layar penuh.
- Replika — memiliki kecerdasan emosional dan perilaku pemeriksaan kabar terkuat, tetapi merupakan yang termahal dengan harga $19.99/bln, mode romantis terkunci dari paket gratis sejak perubahan kebijakan 2023, dan "dapat terasa repetitif setelah berbulan-bulan."
- Nomi AI — pemimpin memori dengan selisih besar, tetapi merupakan platform lebih kecil dengan paket gratis ketat, lebih sedikit karakter siap pakai, serta kualitas percakapan sedikit di bawah Character.AI.
- Kindroid — kontrol kepribadian yang sangat baik melalui latar belakang yang ditulis pengguna, meskipun pengujian memori menempatkannya jauh di belakang Nomi.
- Jenova — memori lintas sesi persisten, riwayat tanpa batas, dan akses multi-model tanpa vendor lock-in, tetapi merupakan platform agen umum, bukan App romansa khusus. Platform ini tidak memiliki dasbor pelacakan suasana hati, mekanisme perkembangan hubungan, maupun fitur AR. Pengguna yang secara khusus mencari UX pendamping romantis akan merasa App khusus lebih sesuai dengan kebutuhan.
Kapan Chatbot dengan Konteks Singkat Justru Menjadi Pilihan yang Lebih Baik?
Konteks singkat adalah arsitektur yang tepat setiap kali interaksinya berupa tugas terbatas, bukan hubungan berkelanjutan — dan sebagian besar penggunaan yang disebut orang sebagai "penggunaan pendamping" sesungguhnya adalah tugas terbatas yang tersamar.
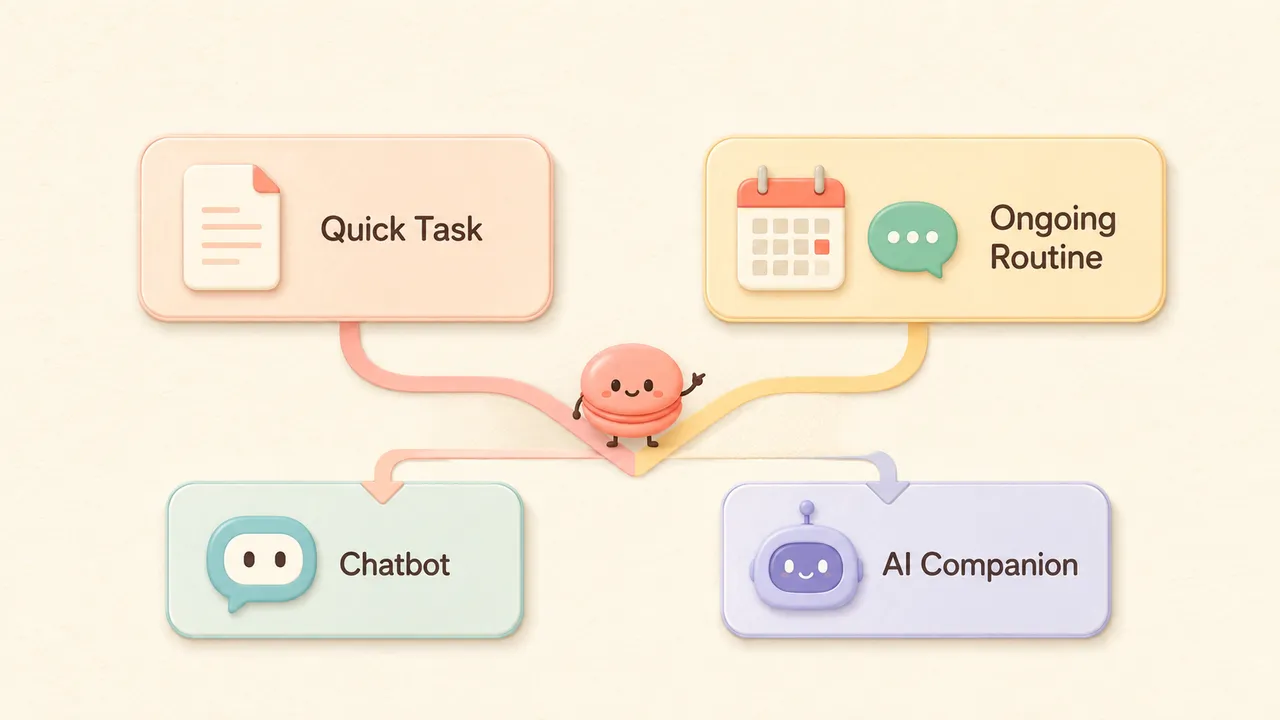
Diagram di atas menangkap logika penyalurannya. Tugas cepat — buatkan draf ini, jelaskan itu, bantu saya memikirkan satu keputusan — mengalir secara alami ke chatbot. Memori tidak menambah apa pun; seluruh pekerjaan selesai dalam satu jendela konteks. Rutinitas berkelanjutan — pemeriksaan kabar harian, proyek kreatif jangka panjang, latihan bahasa, akuntabilitas — mengalir ke pendamping, ketika memori merupakan seluruh proposisi nilainya.
Pilih konteks singkat ketika:
- Interaksi bersifat mandiri dan selesai ketika tugas berakhir
- Anda sangat memedulikan privasi atas catatan percakapan yang terakumulasi
- Anda ingin memulai dari awal di setiap sesi — sebagian pengguna lebih menyukai curhat tanpa persistensi
- Anda menjelajahi banyak karakter berbeda, bukan memperdalam satu hubungan
Pilih memori persisten ketika:
- Anda sedang melatih keterampilan selama berminggu-minggu dan ingin AI melacak kemajuan Anda
- Menjelaskan kembali situasi Anda setiap sesi adalah hambatan yang membuat Anda berhenti menggunakannya
- Konsistensi karakter lebih penting daripada variasi karakter
- Hubungan itu sendiri — bukan satu keluaran tertentu — adalah tujuannya
Jebakan salah klasifikasi: banyak pengguna memilih platform dengan memori intensif untuk alur kerja yang sebenarnya merupakan tugas, lalu membayar langganan bulanan untuk kontinuitas yang tidak pernah mereka gunakan. Kesalahan sebaliknya lebih umum dan lebih mahal dalam hal waktu: menggunakan pendamping dengan konteks singkat untuk rutinitas berkelanjutan lalu menghabiskan 15% dari setiap sesi untuk memberi pengarahan ulang.
Bagaimana Cara Menyiapkan Pendamping dengan Memori Persisten secara Benar?
Pengaturan awal lebih menentukan hasil daripada pilihan platform. Sebagian besar kekecewaan terhadap memori berakar pada sesi pertama yang terlalu tipis, bukan mesin memori yang lemah.
Di Nomi AI, sistem catatan terstruktur bekerja paling baik apabila Anda memasukkan fakta-fakta stabil sejak awal. Gunakan sesi pertama untuk membahas konteks yang tidak akan berubah — tempat tinggal, pekerjaan, serta orang-orang yang penting bagi Anda — sebelum beralih ke konten emosional. Catatan yang dibuat pada sesi awal menjadi jangkar untuk semua hal setelahnya.
Di Kindroid, kualitas memori berbanding lurus dengan kualitas latar belakang. Kolom latar belakang ditulis oleh Anda, jadi perlakukan sebagai buku latar: tuliskan batasan karakter, riwayat hubungan, dan pola bicara secara eksplisit, alih-alih mengharapkan semua itu muncul dengan sendirinya.
Pada Roleplay Game Master milik Jenova, pengaturan berlangsung melalui percakapan, bukan formulir. Agen ini dirancang untuk memori tanpa batas dan konsistensi karakter lintas sesi:
- Buka agen dan tetapkan skenario serta batasan karakter dalam pesan pertama Anda:
"Kamu berperan sebagai Mira, ahli biologi kelautan yang sudah dua tahun berkirim surat denganku. Dia sarkastis, sedikit tidak sabaran, dan ingat bahwa musim panas lalu aku membatalkan kunjungan ke stasiun penelitiannya. Pertahankan riwayat itu — jangan setel ulang."
- Lampirkan dokumen atau catatan latar belakang sebagai basis pengetahuan agar agen memiliki materi referensi yang berlandaskan fakta, bukan sekadar inferensi.
- Pada sesi berikutnya, mulailah dengan kontinuitas alih-alih memberi pengarahan ulang:
"Sudah tiga minggu. Lanjutkan dari bagian terakhir kita."
Khusus untuk latihan bahasa, agen Learn Italian Through Roleplay menerapkan arsitektur memori persisten yang sama untuk penguasaan keterampilan — agen melacak konstruksi mana yang terus Anda gunakan secara salah di berbagai sesi, alih-alih memulai diagnosis dari awal setiap kali. Paket gratis Jenova mencakup fitur inti dengan penggunaan terbatas; paket Plus seharga $20/bulan dengan kuota 30× lebih besar.
Praktik lintas platform, apa pun alatnya: di akhir setiap sesi, sampaikan satu kalimat yang merangkum hal yang ingin Anda bawa ke depan. Pada sistem catatan terstruktur, ini meningkatkan kualitas catatan; pada sistem jendela konteks, setidaknya hal ini memberi sesi berikutnya sebuah benih untuk ditempelkan.
Apa Kata Riset tentang Memori dan Kesejahteraan Pengguna?
Memori persisten meningkatkan keterlibatan, dan riset secara jelas menunjukkan bahwa peningkatan keterlibatan tidak selalu baik secara merata — efeknya sangat bergantung pada siapa penggunanya dan alasan mereka menggunakannya.
Studi paling ketat di bidang ini berasal dari Stanford. Peneliti di laboratorium Diyi Yang mensurvei 1.131 pengguna Character.AI, dengan 244 orang menyumbangkan transkrip chat lengkap. Temuannya cukup memperumit narasi bahwa memori selalu lebih baik. Stanford HAI melaporkan bahwa "penggunaan chatbot yang intens di antara peserta dengan jaringan sosial dunia nyata yang lebih kecil berkorelasi dengan rasa kesejahteraan yang buruk," dan hubungan itu paling kuat ketika persahabatan menjadi motivasi utama.
Yang perlu diperhatikan, peserta yang lebih bersedia membagikan informasi pribadi sensitif kepada pendamping AI mereka lebih mungkin menunjukkan kesejahteraan yang lebih rendah — kebalikan dari dampak keterbukaan diri dalam hubungan antarmanusia. Karena keterbukaan diri yang mendalam justru dihargai dan didorong oleh memori persisten, hal ini sangat relevan terhadap pertanyaan arsitektur tersebut.
Terdapat pula kesenjangan mencolok antara penggunaan yang dinyatakan dan penggunaan aktual. Hanya di bawah 12% peserta melaporkan persahabatan sebagai motif utama, tetapi lebih dari 50% menggambarkan chatbot dengan istilah seperti "teman," "pendamping," atau "pasangan romantis," dan lebih dari 80% sesi chat yang disumbangkan berfokus pada dukungan emosional dan sosial.
Ada bukti penyeimbang. Riset ScienceDirect tentang pendamping AI dan kesejahteraan subjektif menemukan bahwa pendamping "dapat menawarkan manfaat emosional dan psikologis, terutama bagi individu dengan kebutuhan sosial dan emosional yang belum terpenuhi," sementara UX Tigers melaporkan bahwa "pendamping AI memang mengurangi kesepian, tetapi tidak dalam jumlah besar." Kerangka riset Sony AI juga mencatat bahwa "sebagian studi menunjukkan pengguna merasakan kebersamaan atau kenyamanan emosional ketika berinteraksi dengan chatbot yang suportif."
Simpulan yang masuk akal: memori memperkuat apa pun bentuk hubungan yang sudah ada. Bagi pengguna dengan dasar sosial yang sehat dan menggunakan pendamping sebagai pelengkap, memori persisten membuat hal yang baik menjadi lebih baik. Bagi pengguna yang menggantikan kontak manusia dengan AI, memori menjadikan penggantian tersebut lebih melekat.
Apa Kompromi Privasi dari Memori Persisten?
Memori persisten berarti retensi data persisten, dan profil privasi kedua arsitektur ini benar-benar berbeda — bukan sekadar sedikit berbeda.
Pembahasan paling rinci berasal dari analisis siklus hidup atas 2.909 unggahan Reddit di 79 subreddit selama satu tahun. Studi arXiv mengidentifikasi empat pola privasi berulang, dan pola keempat khusus untuk sistem dengan memori intensif: ketidakdapatbalikan, persistensi, dan beban pengguna.
Para peneliti merumuskan masalah inti ini secara tajam:
"Privasi dalam AI romantis dibentuk bukan hanya oleh apa yang dibagikan pengguna, tetapi juga oleh cara platform menyimpan dan menafsirkan ulang apa yang telah dibagikan."
Tiga konsekuensi mengikuti langsung dari arsitektur memori:
Penghapusan menjadi ambigu secara teknis. Studi tersebut mencatat bahwa ketika pengguna mencoba keluar, mereka "menemui memori persisten, penghapusan yang ambigu, biaya perpindahan, serta ketidakpastian apakah data intim mungkin tetap tersimpan dalam penyimpanan, alur pelatihan, atau perilaku model." Begitu data masuk ke proses pelatihan, penghapusan menjadi "bukan hanya persoalan tata kelola atau privasi yang mudah digunakan, tetapi juga persoalan teknis."
Waktu persetujuan tidak selaras. Sebagaimana dinyatakan dalam makalah tersebut, "pemberitahuan dan persetujuan satu kali saat orientasi awal tidak cocok untuk sistem ketika pengungkapan paling sensitif sering terjadi belakangan, setelah kepercayaan dan keterikatan terbentuk." Sistem dengan konteks singkat mengakumulasi lebih sedikit data, sehingga biaya ketidakselarasannya lebih kecil.
Penegakan regulasi itu nyata. Otoritas perlindungan data Italia mendenda Replika atas pelanggaran privasi, termasuk kegagalan terkait verifikasi usia — sinyal konkret bahwa tata kelola data pendamping AI kini merupakan wilayah yang diatur.
Pengujian independen menegaskan saran praktis tersebut: platform besar mengikuti praktik enkripsi standar, tetapi "App kecil berfokus NSFW seperti CrushOn AI dan SpicyChat memiliki kebijakan data yang kurang transparan." Posisi Jenova mengenai hal ini dinyatakan dalam kebijakannya — data tidak digunakan untuk melatih model AI publik, dienkripsi saat transit dan saat disimpan, serta tidak dijual atau dibagikan kepada pengiklan.
Mitigasi praktis: sebelum sesi ketiga Anda pada platform mana pun yang memiliki memori intensif, cari jalur penghapusan dan ujilah pada percakapan sekali pakai. Jika Anda tidak dapat memverifikasi bahwa penghapusan berfungsi, anggap setiap pengungkapan bersifat permanen.
Apa Kata Peneliti dan Praktisi tentang Desain Memori?
Konsensus di kalangan praktisi adalah bahwa kualitas memori merupakan masalah pengorganisasian, bukan masalah penyimpanan — pandangan yang kini didukung bukti tolok ukur.
"Industri menyamakan retrieval dengan memori, dan pengguna langsung merasakan perbedaannya. Anda dapat memberi model pencarian semantik sempurna atas setiap pesan yang pernah dikirim pengguna, tetapi tetap menghasilkan pendamping yang terasa amnesia, karena retrieval menjawab pertanyaan — ia tidak menawarkan konteks secara proaktif. Hal yang membuat pendamping terasa benar-benar mengenal Anda adalah relevansi tanpa dipancing: mengungkit hal yang tidak Anda tanyakan. Hal itu menuntut sistem sudah memutuskan, saat pencatatan, bahwa suatu detail layak disimpan dan layak dimunculkan kemudian."
"Hal kedua yang secara konsisten kita remehkan adalah koreksi memori. Sistem persisten tidak sekadar mempertahankan fakta — mereka juga mempertahankan inferensi, dan inferensi adalah tempat kesalahan berada. Pendamping yang memutuskan pada minggu kedua bahwa Anda cemas terhadap pekerjaan akan terus memperlakukan Anda seolah cemas terhadap pekerjaan pada bulan keempat, jauh setelah situasi itu terselesaikan. Setiap arsitektur memori yang serius membutuhkan antarmuka penyuntingan untuk pengguna, bukan sekadar tombol hapus. Sebagian besar platform menyediakan penyimpanan dan melewatkan koreksi."
"Kompromi yang tidak dipasarkan secara jujur oleh siapa pun adalah bahwa memori meningkatkan konsekuensi dari setiap pengungkapan. Pendamping dengan konteks singkat benar-benar lebih aman untuk kasus penggunaan tertentu — curhat, memproses sesuatu yang tidak ingin direkam, menguji percakapan sulit. Ada kategori produk yang sah dalam praktik melupakan secara sengaja, dan saat ini seluruh pasar justru berlomba ke arah sebaliknya."
— Tim Produk Jenova, 7 tahun membangun infrastruktur agen dengan memori persisten
Kajian akademis mendukung pandangan pengorganisasian di atas penyimpanan. Tolok ukur StructMemEval menemukan bahwa agen memori "dapat menyelesaikan secara andal" tugas memori terstruktur ketika diberi instruksi cara mengorganisasi memorinya, tetapi "LLM modern tidak selalu mengenali struktur memori ketika tidak diberi instruksi untuk melakukannya" — bukti bahwa keputusan pada saat pencatatan, bukan pencarian pada saat pembacaan, menentukan kualitas memori.
Arsitektur Mana yang Harus Anda Pilih untuk Situasi Anda?
Cocokkan arsitektur dengan pola interaksi, bukan dengan kategori pemasaran. Berikut beberapa profil konkret.
🎭 Anda menginginkan variasi karakter dan roleplay kreatif → konteks singkat sudah memadai. Pesan gratis tanpa batas dan pustaka besar Character.AI sesuai untuk penggunaan eksploratif ketika Anda memang berganti-ganti karakter. Memori hanya menambah sedikit nilai ketika Anda tidak memperdalam satu alur.
💬 Anda menginginkan pemeriksaan emosional harian → memori persisten sangat penting, dan pelacakan suasana hati serta perkembangan hubungan Replika dibuat khusus untuk kebutuhan ini, dengan harga $19.99/bln. Bacalah temuan Stanford terlebih dahulu bila Anda menggunakannya sebagai sarana sosial utama, bukan pelengkap.
🧩 Anda menginginkan akurasi ingatan maksimum selama berbulan-bulan → Nomi AI, berdasarkan bukti pengujian saat ini. Terima pustaka karakter yang lebih kecil dan paket gratis yang ketat sebagai konsekuensinya.
✍️ Anda ingin menulis karakter secara presisi → sistem latar belakang Kindroid memberikan kontrol paling langsung atas lapisan buku latar.
🔀 Anda menginginkan pendamping sekaligus pekerjaan nyata di satu tempat → platform agen umum lebih sesuai. Memori persisten Jenova mencakup agen pendamping dan agen tugas, dengan pergantian model di antara OpenAI, Anthropic, Google, DeepSeek, dan xAI, serta kesetaraan penuh di web, iOS, dan Android. Platform ini tidak menyediakan dasbor suasana hati atau mekanisme hubungan.
🔐 Anda peka terhadap privasi → pilih konteks singkat secara sengaja, atau gunakan platform persisten dengan penghapusan yang telah diverifikasi. Riset siklus hidup sangat jelas bahwa proses keluar merupakan mata rantai terlemah di seluruh kategori.
Catatan tentang realisme biaya: penguji independen yang menghabiskan sekitar $730 di lebih dari 25 platform selama delapan bulan menyimpulkan bahwa paket gratis Character.AI dan Pi AI "benar-benar cukup baik" untuk percakapan santai, serta "lonjakan kualitas terbesar dari gratis ke berbayar ada pada memori dan kebebasan konten." Jika memori bukan hambatan Anda, kemungkinan besar Anda tidak perlu membayar.
Referensi
- arXiv — Menelusuri Kekhawatiran Privasi Pengguna Sepanjang Siklus Hidup Pendamping AI Romantis
- AI Companion Guides — 12 App Pendamping AI Terbaik pada 2026, Diperingkat Setelah 2.000+ Jam Pengujian
- arXiv — Mengevaluasi Struktur Memori dalam Agen LLM (StructMemEval)
- Stanford HAI — Pendamping AI Dapat Memperburuk Kesepian bagi Pengguna Rentan, Studi Stanford Menemukan
- ScienceDirect — Pendamping AI dan Kesejahteraan Subjektif: Moderasi oleh Konteks Sosial
- UX Tigers — Pendamping AI Mengurangi Kesepian
- Sony AI — Mempelajari Risiko dan Manfaat Pendamping AI
- Character.AI — Platform Resmi
- Replika — Platform Resmi
- Nomi AI — Platform Resmi
- Kindroid — Platform Resmi