Chat AI Memori Vektor: Ingatan Semantik Persisten untuk Agen
2026-09-15
Jenova menghadirkan chat AI memori vektor — percakapan yang mengingat makna, bukan sekadar beberapa pesan terakhir. Hingga September 2026, sebagian besar asisten masih melupakan preferensi, kehilangan konteks proyek, dan memaksa Anda menjelaskan ulang file yang sama. Platform ini menyimpan dialog, dokumen, dan preferensi agar agen khusus dapat mengambil konteks yang tepat saat Anda bertanya.
✅ Memori persisten lintas sesi, bukan jendela geser yang menghapus dirinya sendiri ✅ Pengambilan semantik, bukan kata kunci — temukan maksud Anda, bukan sekadar yang Anda ketik ✅ Basis pengetahuan yang cukup Anda lampirkan sekali dan gunakan kembali untuk riset, kode, serta penulisan ✅ Model memori yang sama di web, iOS, dan Android
Chat tanpa status murah dijalankan dan mahal digunakan. Untuk memahami mengapa memori vektor kini menjadi inti chat AI yang bermanfaat, penting untuk melihat bagaimana embedding, pengambilan, dan konteks jangka panjang benar-benar gagal dalam pekerjaan sehari-hari.
Jawaban Singkat: Apa Itu Chat AI Memori Vektor?
Chat AI memori vektor adalah sistem pengambilan yang menyimpan makna percakapan sebagai embedding sehingga AI dapat mengingat konteks, dokumen, dan preferensi yang relevan lintas sesi. Inilah perbedaan antara chatbot yang memulai ulang setiap utas dan agen yang melanjutkan pekerjaan.
Kemampuan utama:
- Merepresentasikan pesan, file, dan fakta sebagai vektor untuk pencarian kemiripan
- Memasukkan hanya memori yang paling relevan ke jendela konteks model
- Menyimpan riwayat chat tanpa batas dan preferensi lintas sesi pada satu platform
- Mendasarkan jawaban pada basis pengetahuan terlampir, alih-alih tebakan parametrik
- Membawa memori yang sama dari sesi di meja kerja ke ponsel tanpa memberi pengarahan ulang kepada agen
Mengapa Sebagian Besar Chat AI Masih Melupakan
Model bahasa besar kuat dalam penalaran dan lemah sebagai pengarsip. Bobotnya menyimpan pengetahuan umum; bobot tersebut tidak menyimpan backlog Anda, skema Anda, atau keputusan terakhir Anda. retrieval-augmented generation hadir secara khusus karena memori parametrik tidak konsisten dan sulit diperbarui untuk domain privat, sebagaimana dirangkum dalam survei arsitektur RAG tahun 2025.
Permintaan industri terhadap lapisan pengambilan tersebut tidak lagi bersifat eksperimental:
USD 2,652.1 million → USD 8,945.7 million — Proyeksi pasar database vektor global dari 2025 hingga 2030, dengan CAGR 27.5%
Belanja itu adalah gejala. Tim membeli infrastruktur vektor karena chat tanpa memori terus gagal dengan cara yang sama:
- Jendela konteks meluap sehingga keputusan lama menghilang di tengah proyek
- Pencarian kata kunci melewatkan parafrasa, sinonim, dan maksud tersirat
- Stack RAG buatan sendiri (chunking, indeks, evaluasi, autentikasi) terhenti sebelum produksi
- Personalisasi terjebak dalam riwayat chat satu vendor
- Jawaban menyimpang ketika model tidak dapat mendasarkan diri pada file Anda
Namun, menghadirkan memori yang tahan lama, privat, dan dapat dicari secara semantik ke dalam chat sehari-hari masih sangat sulit:
Jendela konteks bukan memori
Jendela konteks adalah buffer, bukan arsip. Riwayat percakapan, pertanyaan pengguna, dan sejumlah “fakta tersimpan” digabungkan ke dalam sebuah prompt; apa pun yang tidak muat akan dibuang. Inilah alasan agen coding melupakan error yang Anda tempel kemarin, dan tutor kembali menanyakan nilai target Anda. Memori vektor berada di luar jendela: memori ini mengambil potongan kecil yang relevan pada waktu inferensi, alih-alih berharap transkrip lengkap masih muat.
Pencarian kata kunci tidak dapat merepresentasikan makna
Pencarian klasik mengutamakan token yang persis sama. Pencarian vektor membandingkan embedding — representasi numerik berdimensi tinggi dari makna — menggunakan metrik seperti cosine similarity atau jarak Euclidean. Embedding ditambah indeks vektor adalah lapisan pengambilan yang memungkinkan aplikasi LLM modern. Tanpa lapisan tersebut, “rencana perekrutan Q3” tidak akan mengambil catatan yang Anda beri judul “jumlah karyawan untuk musim gugur.”
RAG buatan sendiri adalah proyek infrastruktur
Pipeline pengambilan untuk produksi memerlukan strategi chunking, pilihan embedding, indeks ANN, filter metadata, evaluasi, dan pekerjaan pembaruan. Benchmark ANN yang dipublikasikan menunjukkan alasan tim peduli: mesin dibandingkan berdasarkan latensi, throughput, dan presisi secara bersamaan, karena kecepatan tanpa recall adalah produk yang berbeda. Kebanyakan individu yang sekadar menginginkan chat yang mengingat tidak seharusnya harus mengoperasikan stack tersebut.
Personalisasi tanpa memori portabel itu rapuh
Digital Economy Lab Stanford berpendapat bahwa keunggulan tahan lama dalam AI akan datang dari konteks personal persisten yang dikendalikan pengguna — bukan dari chatbot terisolasi lainnya. Saat ini, memori biasanya merupakan fitur vendor: memori tidak ikut berpindah dengan Anda, dan dapat secara diam-diam membentuk informasi yang ditampilkan kepada Anda. Laporan Columbia Journalism Review tentang memori chatbot mencatat bahwa kemampuan mengingat pengguna dapat mengubah informasi yang diterima orang.
Inilah alasan Jenova dibangun.
Solusi Jenova
Jenova menjadikan chat AI memori vektor sebagai standar, bukan tambahan yang harus Anda rangkai sendiri nanti. Riwayat chat tanpa batas, memori persisten lintas sesi, dan basis pengetahuan yang dapat dilampirkan tersedia di balik setiap agen khusus. Anda berbicara dalam bahasa alami; platform mengambil embedding, alat, dan file yang tepat sebelum model menjawab.
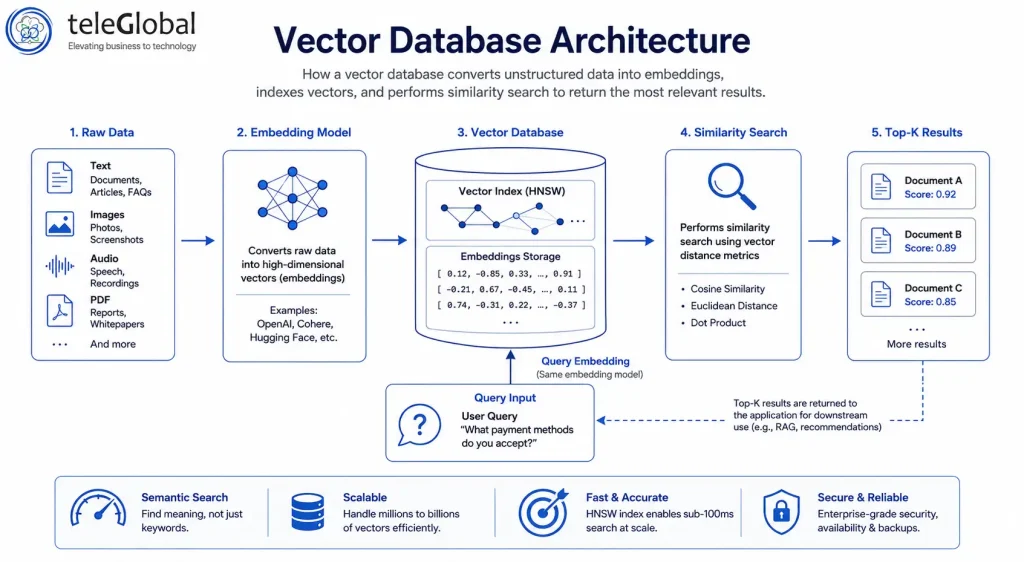
Diagram di atas menjelaskan mekanisme di balik pengalaman tersebut: teks, gambar, dan dokumen tidak terstruktur menjadi embedding, masuk ke indeks vektor, lalu dikembalikan sebagai kecocokan top-k untuk sebuah kueri. Anda tidak perlu mengonfigurasi parameter HNSW atau memilih metrik jarak. Anda cukup memulai utas.
| Pendekatan Tradisional | Jenova |
|---|---|
| Menempelkan ringkasan yang sama ke setiap chat baru | Memori persisten lintas sesi dan agen |
| Pencarian kata kunci pada catatan dan PDF | Pengambilan semantik melalui embedding |
| Mengelola sendiri database vektor, embedder, dan evaluasi RAG | Penyimpanan dan pengambilan yang dikelola sepenuhnya |
| Satu vendor model, satu silo memori | Akses multi-model dengan konteks bersama |
| Riwayat khusus desktop yang hilang di seluler | Kesetaraan penuh di web, iOS, dan Android |
Riset yang bertumbuh alih-alih dimulai ulang
Tinjauan literatur dan pemindaian pasar gagal ketika asisten tidak dapat mengingat makalah yang sudah Anda tolak. Real-Time Search mengambil hasil langsung dari Google, Reddit, YouTube, GitHub, dan lainnya, sementara memori vektor menjaga kriteria inklusi, sitasi sebelumnya, serta aturan “jangan gunakan sumber ini” tetap aktif. Anda tidak memulai kueri Boolean baru setiap pagi; Anda melanjutkan investigasi yang didukung pengambilan.
Basis kode yang benar-benar dipahami agen
Python Coding Assistant bermanfaat pada hari pertama untuk sebuah skrip. Agen ini menjadi andal pada hari kedua belas, saat masih mengetahui struktur packaging Anda, pengujian tidak stabil yang Anda putuskan untuk dilewati, dan kontrak API yang Anda bekukan minggu lalu. Lampirkan catatan repositori atau dokumen desain sekali saja. Prompt berikutnya akan mengambil konteks itu, alih-alih menciptakan arsitektur paralel.
Penulisan yang mempertahankan suara dan fakta Anda
Draf mati dalam chat tanpa status karena nada, frasa terlarang, dan URL sumber kebenaran keluar dari jendela. Agen berfokus pada penulisan di platform dapat menyimpan sampel gaya dan keputusan kerangka Anda sebagai memori, lalu mengambilnya ketika Anda berkata “gunakan suara yang sama seperti postingan peluncuran.” Dikombinasikan dengan lampiran dokumen, itulah memori vektor yang menjalankan kontinuitas editorial — bukan prompt yang lebih besar.
Kehidupan dan pembelajaran yang tidak seharusnya dimulai ulang
Pembinaan dan latihan bahasa hanya efektif jika agen mengingat batasan: cedera, tanggal ujian, kosakata yang sudah Anda kuasai. Memori persisten mengubah tutor generik menjadi tutor yang berhenti mengulang latihan minggu pertama. Penyimpanan yang sama yang mengambil traceback Python dapat mengambil fakta bahwa Anda belajar lebih baik melalui bermain peran daripada tabel tata bahasa.
Coba platform ini gratis — tanpa kartu kredit.
Agen AI Khusus untuk Chat AI Memori Vektor
Memori hanya berguna sejauh alur kerja yang dilayaninya. Agen-agen ini dibuat untuk tugas ketika melupakan itu mahal — rangkaian riset panjang, logistik berulang, latihan imersif, dan permainan dengan karakter yang konsisten.
Deep Research
Riset berjam-jam adalah contoh klasik chat AI memori vektor. Agen ini mencari ratusan sumber, menyintesis temuan dengan sitasi inline, dan menghasilkan laporan yang dapat Anda lanjutkan besok tanpa menyusun ulang cakupan pertanyaan.
- Menyimpan pertanyaan riset, sumber yang dikecualikan, dan tesis kerja
- Mengambil temuan sebelumnya agar bagian berikutnya tidak bertentangan dengan bagian awal
- Mendasarkan klaim pada materi bersitasi, bukan hanya ingatan model
Academic Research Assistant
Alur kerja PhD dan fakultas mencakup berbulan-bulan literatur, gaya sitasi, dan versi manuskrip. Asisten ini menemukan makalah di berbagai database utama serta membantu persiapan manuskrip, sementara memori menjaga target publikasi, metodologi, dan kumpulan bacaan yang telah Anda telaah tetap utuh.
- Penemuan literatur waktu nyata di berbagai repositori akademik
- Dukungan sitasi dan manuskrip yang terkait dengan draf Anda yang sedang berjalan
- Kontinuitas di antara makalah terkait, bukan jawaban chat sekali pakai
Personal Secretary
Logistik adalah masalah memori: vendor berulang, preferensi perjalanan, dan siapa yang menerima pembaruan hari Jumat. Agen ini mengoordinasikan kalender, email, dan operasi harian dengan konteks pribadi yang mendalam sehingga Anda tidak perlu mengajarkan ulang rutinitas setiap hari Senin.
- Mengingat preferensi tetap dan orang-orang yang bekerja dengan Anda
- Menghubungkan perencanaan dengan alat yang sudah Anda gunakan
- Membawa konteks dari pengarahan pagi ke tindak lanjut sore hari
Roleplay Game Master
Konsistensi naratif mustahil tanpa memori jangka panjang. Agen ini dibuat untuk bermain peran imersif dengan memori tanpa batas dan karakter yang stabil — janji plot, nama faksi, dan nada tidak diatur ulang ketika jendela konteks seharusnya telah meluap.
- Memori tanpa batas untuk status cerita dan suara karakter
- Pengambilan adegan sebelumnya saat bab berikutnya membutuhkannya
- Rentang kreatif tanpa kehilangan kontinuitas
Learn Russian Through Roleplay
Pemerolehan bahasa bergantung pada konteks personal yang berjarak: kata-kata yang Anda lewatkan, tingkat formalitas, dan cerita yang telah Anda jalani. Mentor ini menggunakan skenario tanpa batas dan memori tanpa batas agar latihan bertumbuh, bukan berputar pada skrip pemula.
- Mengingat kesenjangan kosakata dan jenis skenario yang Anda sukai
- Menjaga karakter dan latar tetap konsisten lintas sesi
- Mengubah setiap percakapan menjadi latihan yang didukung pengambilan
Cara Kerja Chat AI Memori Vektor
Anda tidak perlu menyiapkan database vektor. Mulailah percakapan; platform menangani embedding, pengambilan, dan jendela konteks.
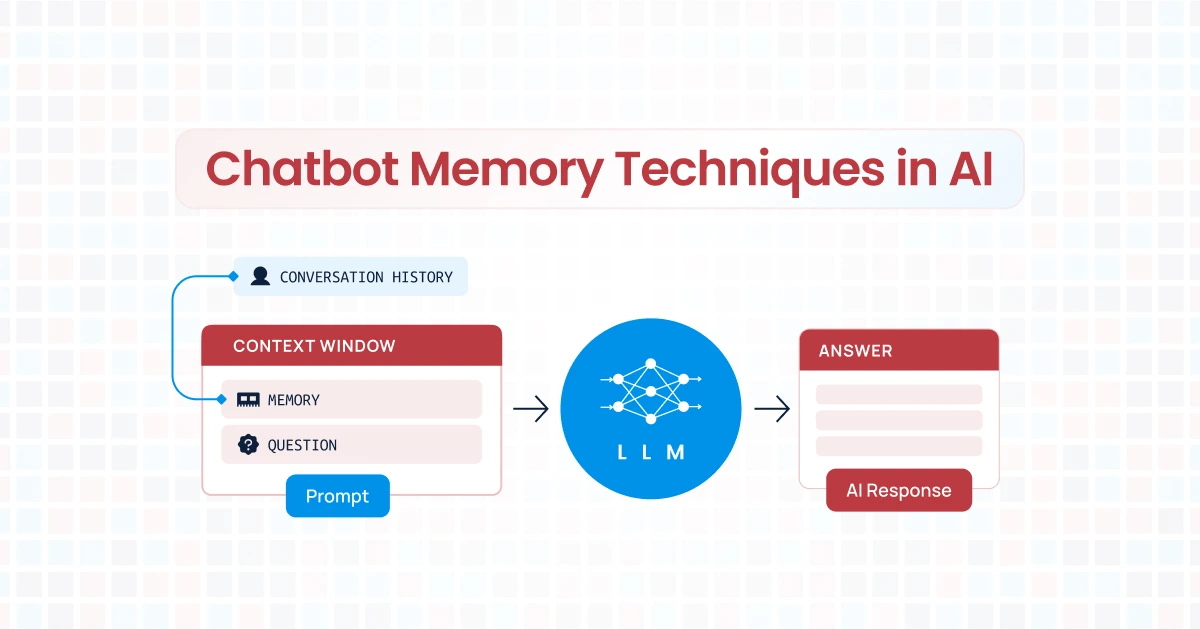
Diagram kedua itu adalah siklus yang terlihat oleh pengguna. Riwayat, memori tersimpan, dan pertanyaan baru dirangkai menjadi prompt; model kemudian menjawab. Pengambilan vektor menentukan memori mana yang termasuk dalam prompt agar jendela tetap fokus.
Langkah 1: Buka Agen dan Nyatakan Hasil yang Diinginkan Pilih spesialis untuk tugas tersebut — riset, kode, perjalanan, bimbingan belajar — lalu jelaskan seperti apa hasil “selesai.” Pesan pertama menjadi embedding seperti setiap pesan setelahnya.
"Saya sedang menulis tinjauan sistematis tentang retrieval-augmented generation. Utamakan survei dari 2024 dan seterusnya, kecualikan blog vendor, dan gunakan gaya sitasi IEEE."
Langkah 2: Lampirkan Pengetahuan yang Harus Dipercayai Model Unggah ringkasan, PDF, catatan, atau spesifikasi. Dokumen tersebut diindeks untuk pencarian semantik agar pertanyaan berikutnya mengambil bagian berdasarkan makna. Ini adalah pola yang kini didanai perusahaan sebagai infrastruktur RAG, tanpa Anda harus mengoperasikan indeksnya.
"Gunakan matriks literatur terlampir. Jika sebuah makalah ditandai tolak, jangan sitasi lagi."
Langkah 3: Terus Bekerja Lintas Sesi Tutup laptop. Keesokan hari, ajukan pertanyaan lanjutan. Memori persisten dan riwayat tanpa batas berarti agen mengambil cakupan tinjauan, daftar penolakan, dan judul kerangka terakhir, alih-alih menyapa Anda seperti orang asing.
"Lanjutkan dari bagian keterbatasan dan ambil tiga makalah yang kita tandai untuk pembahasan."
Langkah 4: Berpindah Perangkat Tanpa Pengarahan Ulang Buka utas yang sama di iOS atau Android. Pengaturan dan riwayat tersinkronkan. Prompt saat perjalanan dapat mengambil vektor yang sama seperti sesi di meja kerja, yang merupakan tujuan chat AI memori vektor: kontinuitas, bukan silo chat baru untuk tiap perangkat.
"Saya sedang menuju kampus — uji saya tentang tiga mode kegagalan RAG yang kita daftar kemarin."
Hasil dan Kasus Penggunaan
Memori vektor terlihat sebagai jam kerja yang tidak perlu diulang, bukan sebagai grafik benchmark. Skenario berikut umum terjadi saat chat mengambil makna.
📊 Sintesis literatur multi-minggu
Skenario: Seorang mahasiswa pascasarjana memerlukan pemetaan makalah tentang ketahanan RAG yang bersitasi dan diperbarui setiap beberapa hari saat preprint baru muncul.
Pendekatan Tradisional: Folder berisi PDF, spreadsheet catatan, dan chatbot yang melupakan daftar pengecualian. Menempelkan ulang ringkasan pada setiap sesi. Mudah untuk menyitasi sumber yang sama dua kali atau melewatkan kontradiksi.
Deep Research: Pertanyaan, pengecualian, dan kerangka kerja tetap bertahan. Proses baru mengambil sintesis sebelumnya sehingga laporan berkembang, bukan bercabang.
- Sitasi tetap selaras dengan bagian sebelumnya
- Sumber yang ditolak tetap ditolak
- Pertanyaan lanjutan lebih murah daripada pencarian awal
💼 Layanan Python yang melintasi beberapa sprint
Skenario: Anda membangun layanan FastAPI dengan spesifikasi OpenAPI yang dibekukan, satu pengujian tidak stabil yang diketahui, dan batasan deployment pada Python 3.11.
Pendekatan Tradisional: Setiap chat baru menciptakan struktur folder yang berbeda. Anda menghabiskan sepuluh menit pertama untuk menjelaskan ulang keputusan yang tidak dapat dilihat model.
Python Coding Assistant: Catatan arsitektur dan spesifikasi tersimpan dalam memori serta lampiran. Laporan bug pada hari Kamis mengambil daftar batasan hari Rabu.
- Lebih sedikit refaktor yang saling bertentangan
- Debugging dimulai dari stack yang sebenarnya
- Onboarding untuk diri Anda di masa depan (atau rekan tim yang membaca utas) menjadi lebih cepat
🎭 Kampanye yang tidak boleh saling bertentangan
Skenario: Sebuah permainan mingguan dengan NPC bernama, sebuah rahasia yang belum diketahui kelompok, dan nada yang telah Anda tetapkan pada sesi pertama.
Pendekatan Tradisional: Catatan sesi berada di aplikasi lain; chatbot memaksakan penjahat baru karena tidak dapat mengambil janji lama.
Roleplay Game Master: Status cerita adalah memori. Ketika pemain menyebut detail sepintas dari tiga sesi lalu, pengambilan dapat membawanya kembali ke dalam adegan.
- Suara karakter tetap stabil
- Janji plot tetap dapat dicari
- Alur panjang tetap koheren
📱 Perencanaan perjalanan dari antrean bandara
Skenario: Anda merencanakan perjalanan tiga kota di meja kerja — batas anggaran, hari yang mengutamakan berjalan kaki, tanpa penerbangan malam. Di gerbang keberangkatan, Anda memerlukan rencana ulang yang mempertimbangkan cuaca hanya untuk besok.
Pendekatan Tradisional: Mengambil screenshot catatan sendiri. Berharap chatbot seluler dapat menyimpulkan batasan yang belum pernah dilihatnya.
Travel Planning Advisor: Preferensi dan itinerary sudah berada dalam memori. Prompt dari ponsel mengambilnya dan mengubah satu hari tanpa membangun ulang seluruh perjalanan.
- Batasan tetap bertahan saat berpindah perangkat
- Pertanyaan lanjutan lokal tetap sesuai anggaran
- Anda tidak perlu mengetik ulang ringkasan di jembatan keberangkatan
Pengamatan terhadap penggunaan nyata memperlihatkan pola yang sama dengan hal yang dibayar pembeli database vektor perusahaan: pengambilan semantik berlatensi rendah saat pertanyaan berlangsung, bukan kotak chat yang lebih besar.
FAQ
Apa itu chat AI memori vektor?
Chat AI memori vektor menyimpan pesan, file, dan fakta sebagai embedding, lalu mengambil kecocokan terdekat saat Anda mengajukan pertanyaan. Kecocokan tersebut dimasukkan ke jendela konteks model sehingga respons dapat menggunakan riwayat dan dokumen Anda. Di Jenova, pengambilan ini terintegrasi ke dalam agen khusus, bukan ditawarkan sebagai database terpisah yang harus Anda kelola.
Apakah Jenova gratis digunakan untuk chat AI memori vektor?
Ya. Tingkat gratis mencakup fitur inti dengan penggunaan bulanan terbatas. Tingkat berbayar meningkatkan kapasitas penggunaan dan menambahkan opsi seperti pemilihan model kustom. Penggunaan diatur ulang pada tanggal penagihan, dengan seluruh kuota tersedia sejak hari pertama, bukan diberikan sedikit demi sedikit setiap hari.
Apa perbedaannya dengan chatbot yang “menyimpan memori”?
Banyak produk menyimpan daftar fakta singkat atau transkrip bergulir. Memori vektor mengambil informasi berdasarkan kemiripan semantik di seluruh riwayat tanpa batas dan pengetahuan terlampir, yang lebih dekat dengan RAG daripada catatan tempel. Riset independen mengenai memori jangka panjang untuk agen dalam produksi memperlakukan memori yang dapat diskalakan sebagai masalah sistem tersendiri — bukan sekadar sakelar di pengaturan. OpenAI juga telah memperluas kemampuan ChatGPT untuk merujuk konteks chat sebelumnya; pertanyaan arsitekturnya adalah apakah memori merupakan silo vendor atau infrastruktur di bawah setiap alur kerja yang Anda jalankan.
Dapatkah saya mendasarkan chat pada dokumen saya sendiri?
Ya. Lampirkan file yang harus diprioritaskan ketimbang pengetahuan awal model — spesifikasi, silabus, transkrip, panduan merek. Pengambilan memprioritaskan korpus tersebut saat Anda mengajukan pertanyaan terkait, yang membantu mengurangi halusinasi pada materi privat. Writing Assistant dapat terus menggunakan sampel tersebut untuk nada; agen riset dapat terus menggunakannya untuk klaim.
Apakah chat AI memori vektor berfungsi di seluler?
Ya. Web, iOS, dan Android berbagi riwayat, pengaturan, dan memori. Konversi suara-ke-teks tersedia ketika Anda tidak dapat mengetik. Skenario perjalanan di atas adalah rancangan yang dimaksudkan: mengambil vektor yang sama dari ponsel yang sebelumnya Anda bangun di meja kerja.
Apakah agen dengan memori cukup akurat untuk topik sensitif?
Memori meningkatkan konsistensi; memori tidak membuat model menjadi sempurna. Survei RAG masih menandai kualitas pengambilan, konteks yang berisik, dan kesetiaan pada sumber sebagai masalah terbuka (Sharma, 2025). Untuk keputusan kesehatan, hukum, atau keuangan, perlakukan agen sebagai pendukung dan verifikasi dengan sumber primer. Personal Therapist dapat mengingat tema yang Anda minta untuk dipertahankan, yang berguna untuk kontinuitas — bukan pengganti perawatan oleh profesional berlisensi.
Memori Vektor Adalah Antarmuka Chat yang Akhirnya Bertumbuh
Chat AI tanpa status menyia-nyiakan satu-satunya masukan langka yang Anda miliki: waktu yang dihabiskan untuk menjelaskan diri sendiri. Chat AI memori vektor menyimpan makna sebagai embedding, mengambilnya sesuai kebutuhan, dan memungkinkan agen khusus melanjutkan pekerjaan. Pasar untuk lapisan pengambilan tersebut berkembang karena masalahnya bersifat universal — mulai dari pencarian semantik dalam sistem produksi hingga konteks personal yang seharusnya menjadi milik pengguna.
Jenova menghadirkan memori tersebut untuk riset, kode, narasi, dan perencanaan tanpa meminta Anda mengoperasikan database vektor. Lanjutkan laporan Deep Research, layanan Python, atau kampanye roleplay seolah agen tersebut telah berada di ruangan bersama Anda sepanjang waktu.
Jelajahi pustaka agen lengkap di Jenova.
Untuk Pengembang: Setiap agen dalam artikel ini tersedia secara terprogram melalui Jenova API — integrasikan memori vektor, pengambilan, dan agen multi-model ke dalam aplikasi Anda dengan satu integrasi. Dokumentasi lengkap →