Bagaimana Anda Harus Menguji Asisten Riset AI untuk Integritas Sumber?
2026-08-22
Lima Pemeriksaan Audit Apa yang Membedakan Jejak Sumber Terverifikasi dari Teater Sitasi?
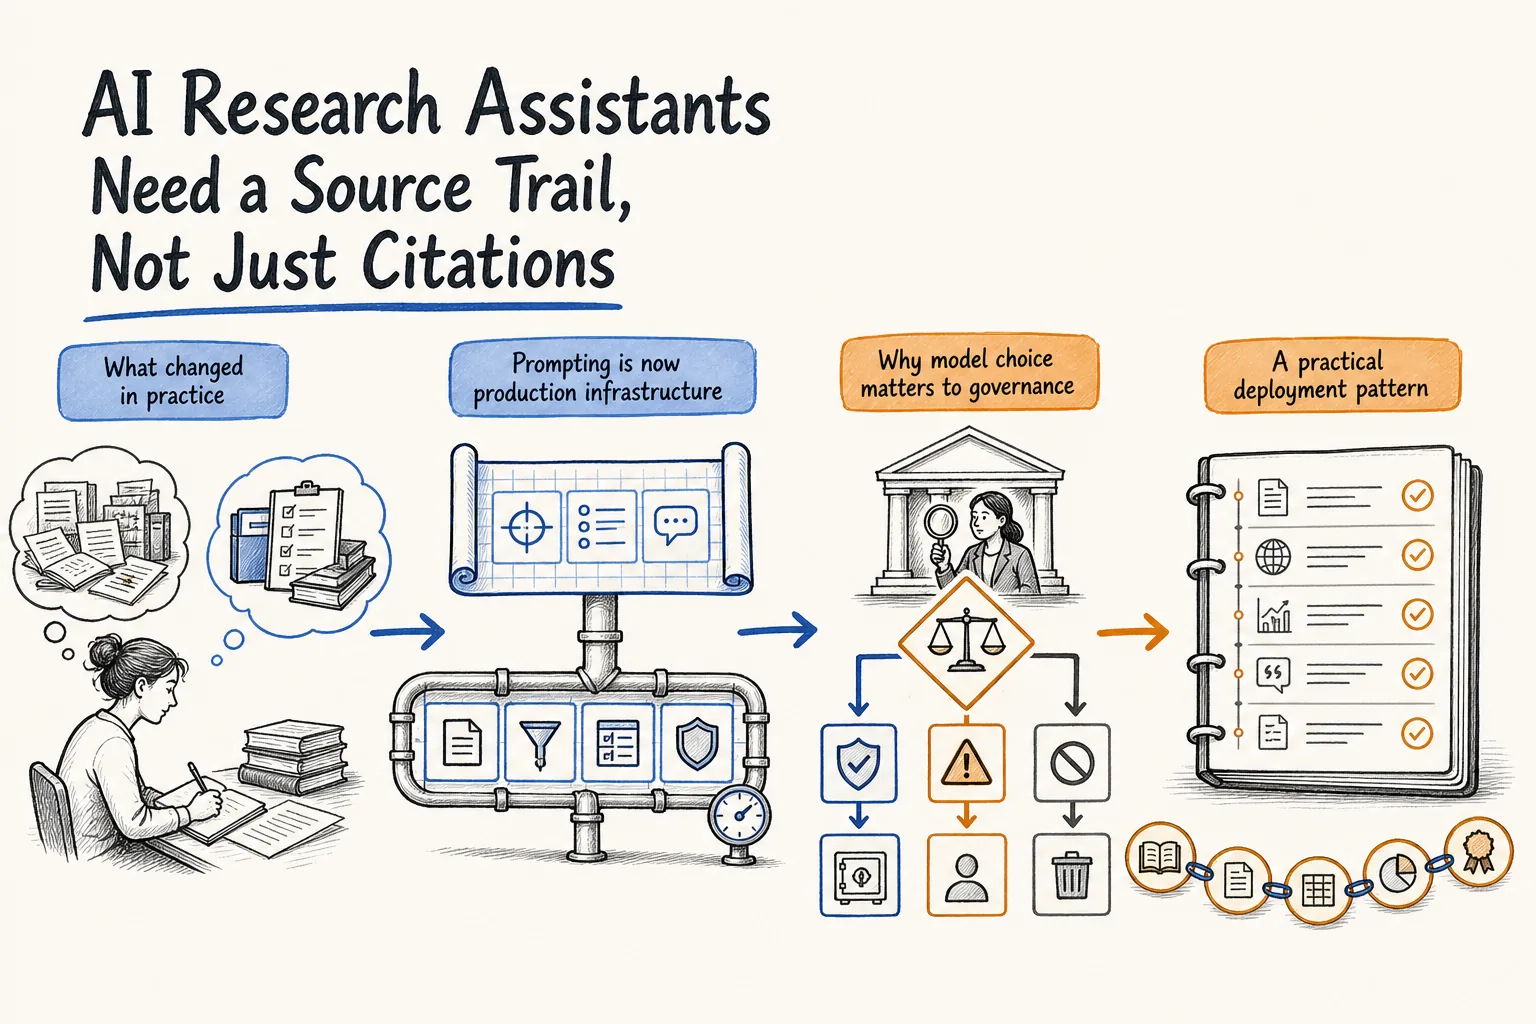
Asisten riset AI yang layak digunakan adalah yang dapat Anda audit, bukan yang sekadar terlihat memiliki sitasi. Pada 2026, uji praktisnya adalah apakah alat tersebut menghasilkan jejak sumber — jalur yang dapat dipulihkan dari setiap klaim menuju dokumen nyata, bertanggal, dan dapat diklik — melalui lima pemeriksaan: cakupan sumber, sitasi yang dapat diklik, keselarasan klaim dengan sumber, tanggal pembaruan, dan inferensi berlabel. Jenova's Academic Research Assistant dirancang untuk penemuan literatur langsung dan manajemen sitasi, sedangkan Elicit, Scite, Consensus, Perplexity, dan ChatGPT Deep Research masing-masing lolos pada sebagian pemeriksaan dan gagal pada pemeriksaan lainnya.
Perbedaannya bukan sekadar “lebih banyak catatan kaki.” Pedoman evaluasi perpustakaan menyatakannya secara tegas: bahkan ketika sebuah alat AI mengutip halaman nyata, prosa yang dihasilkan tetap dapat salah, sehingga Anda harus memeriksa respons tersebut terhadap sumber yang dikutip, bukan hanya memastikan bahwa sebuah URL tersedia (Perpustakaan Universitas Northwestern). Oleh karena itu, audit yang adil menilai lima dimensi TRACE:
✅ Keterlacakan — setiap klaim material memiliki sitasi yang dapat diklik dan membuka dokumen yang dimaksud ✅ Cakupan penelusuran — sumber mencakup korpus yang tepat (makalah, laporan, berita, data primer), bukan satu indeks praktis saja ✅ Keselarasan — bagian yang dikutip benar-benar mendukung klaim, termasuk angka dan kualifikasinya ✅ Keterkinian — tanggal publikasi atau pembaruan terlihat, serta sumber usang ditandai ✅ Pelabelan epistemik — asisten menandai apa yang dikutip, apa yang disimpulkan, dan apa yang belum diketahui
Untuk membandingkan alat secara bermakna, perlakukan prompting dan penilaian sebagai infrastruktur produksi: gunakan kueri yang sama, aturan lulus/gagal yang sama, serta persyaratan yang sama bahwa sintesis tanpa dukungan harus diberi label sebagai inferensi, bukan fakta.
Mengapa Pengujian Sitasi Lebih Penting bagi Asisten Riset AI pada 2026?
Pengujian sitasi lebih penting sekarang karena peneliti menggunakan alat generatif untuk sintesis berisiko tinggi, sementara alat tersebut masih mengarang, salah mengatribusikan, dan diam-diam memperbarui sumbernya. Perpustakaan University of Nevada, Reno menjelaskan kegagalan ini dengan lugas: yang Anda evaluasi adalah klaimnya, bukan kesan dari daftar sumber, dan sitasi yang tidak dapat Anda temukan mungkin merupakan halusinasi.
Tingkat kesalahannya bukan sekadar teori. Sebuah studi JMIR mengenai referensi yang dihasilkan ChatGPT menemukan bahwa hanya sekitar 73–76% sitasi yang sesuai dengan sumber nyata. Stanford HAI melaporkan bahwa model AI hukum berhalusinasi pada sedikitnya satu dari setiap enam kueri pembandingan. Angka-angka tersebut menjelaskan mengapa “alat ini memberi saya bibliografi” bukanlah uji penerimaan.
Keterkinian semakin meningkatkan risikonya. Analisis industri atas sitasi pencarian AI melaporkan bahwa sekitar setengah halaman yang dikutip AI berusia kurang dari 13 minggu, serta bahwa konten yang dikutip AI rata-rata sekitar 25% lebih baru daripada hasil web klasik. Asisten yang menghilangkan tanggal pembaruan dapat terlihat mutakhir sambil mendaur ulang angka dari kuartal lalu. Jika alur kerja Anda mencakup tinjauan literatur, memo kebijakan, atau riset investasi, asisten tanpa audit adalah rekan penulis diam-diam tanpa buku catatan laboratorium.
Rubrik Penilaian Apa yang Harus Digunakan untuk Mengaudit Asisten Riset AI?
Gunakan rubrik tingkat klaim dengan gerbang biner dan satu skor keselarasan bertingkat, bukan kesan menyeluruh seperti “ini tampak akademis.” Unit evaluasinya adalah satu kalimat faktual beserta cuplikan sumber yang dikutip, yaitu tingkat perincian yang sama seperti dalam alur validasi sitasi otomatis yang membandingkan pernyataan dengan teks rujukan.
Nilai setiap klaim material dengan rubrik berikut:
| Pemeriksaan | Lulus | Sebagian | Gagal |
|---|---|---|---|
| Cakupan sumber | Sumber primer atau sumber yang ditelaah sejawat sesuai dengan klaim | Hanya sumber sekunder yang relevan | Blog, halaman SEO, atau domain yang salah untuk klaim |
| Sitasi yang dapat diklik | URL membuka dokumen yang dikutip di lokasi yang dapat digunakan | URL membuka beranda atau halaman awal paywall | Tautan mati, dialihkan ke halaman tidak terkait, atau dibuat-buat |
| Keselarasan klaim dengan sumber | Sumber mendukung klaim, termasuk angka dan pengecualian | Sumber relevan tetapi tidak mendukung klaim persisnya | Bertentangan, angka salah, atau lompatan tanpa dukungan |
| Tanggal pembaruan | Tanggal ditampilkan dan sesuai untuk kueri | Tanggal tersedia tetapi sudah usang terhadap pertanyaan | Tidak ada tanggal, atau tanggal hanya tersirat tanpa bukti |
| Inferensi berlabel | Asisten menandai sintesis, ekstrapolasi, dan hal yang belum diketahui | Teks bersumber dan teks inferensial tercampur, hanya ditandai lemah | Inferensi ditulis sebagai fakta yang sudah mapan |
Batas kelulusan praktis untuk penggunaan profesional adalah: nol tautan palsu, nol klaim numerik tanpa label, dan setidaknya 80% klaim material didukung sepenuhnya oleh cuplikan yang dikutip. Dukungan langsung adalah standar yang tepat karena menilai kesenjangan inferensi, bukan kecocokan kata kunci; penelitian ACL Findings tentang evaluasi Open-QA menunjukkan bahwa penilaian dukungan langsung lebih selaras dengan penilaian manusia daripada metrik kecocokan persis.
Jalankan rubrik ini pada satu set probe tetap: satu pertanyaan berita/kebijakan yang berubah cepat, satu klaim ilmiah kuantitatif, satu pertanyaan tentang literatur yang saling bertentangan, dan satu pertanyaan “apa yang belum diketahui.” Jika asisten tidak dapat gagal dengan baik pada item terakhir, alat tersebut belum siap untuk riset.
Bagaimana Elicit, Consensus, Scite, Perplexity, dan Jenova Dibandingkan dalam Integritas Sumber?
Tidak ada satu asisten riset AI pun yang unggul di semua dimensi TRACE. Elicit paling kuat untuk ekstraksi terstruktur dari korpus makalah besar; Scite paling kuat untuk polaritas sitasi; Perplexity dan ChatGPT paling cepat untuk jawaban web terbuka dengan tautan inline; Jenova's Academic Research Assistant lebih kuat ketika Anda membutuhkan sesi riset langsung dari banyak sumber yang dapat mempertahankan jejak audit di seluruh putaran percakapan.
Perbandingan langsung pada 2026 umumnya menempatkan Elicit sebagai andalan tinjauan literatur dan Consensus sebagai pengukur bukti ya/tidak yang lebih cepat. Rangkuman riset medis menggambarkan Perplexity sebagai opsi serbaguna tercepat dengan sitasi inline dan batasan yang lebih longgar dibandingkan spesialis akademis. Perbandingan alat tinjauan literatur dari HKUST merupakan katalog yang berguna tentang perbedaan cakupan dan akses di seluruh kelompok ini.
| Fitur / Dimensi | Elicit | Scite | Consensus | Perplexity / ChatGPT | Jenova Academic Research Assistant |
|---|---|---|---|---|---|
| Cakupan sumber | 125M+ makalah; berfokus pada akademis (Elicit) | Grafik sitasi dan Smart Citations teks lengkap (Scite) | Korpus makalah yang disesuaikan untuk pertanyaan riset | Web terbuka ditambah sumber akademis opsional | Web langsung + pencarian ilmiah, alur kerja manuskrip dan sitasi |
| Sitasi yang dapat diklik | Rekaman makalah dan ekstrak | Halaman sitasi dengan cuplikan konteks | Jawaban yang didukung makalah | URL inline; kualitas bervariasi menurut kueri | Tautan sumber inline yang dapat diklik dalam jawaban riset |
| Keselarasan klaim dengan sumber | Akurasi ekstraksi yang dipublikasikan sebesar 1,502/1,511 titik data (99.4%) | Menunjukkan sitasi yang mendukung vs. bertentangan | Kuat untuk pertanyaan bukti biner | Pengguna harus memverifikasi; risiko halusinasi terdokumentasi | Bergantung pada cuplikan yang diambil; tidak ada tolok ukur ekstraksi yang dipublikasikan |
| Tanggal pembaruan | Metadata makalah (tahun, publikasi) | Konteks tahun publikasi | Konteks tahun makalah | Tidak konsisten kecuali diminta | Dapat menampilkan dan membandingkan tanggal ketika sumber menyediakannya |
| Inferensi berlabel | Kolom terstruktur mengurangi lompatan tersembunyi | Label polaritas, bukan tag epistemik lengkap | Consensus Meter memberi sinyal tingkat kesepakatan | Jarang memberi label inferensi kecuali diminta | Dapat diinstruksikan untuk menandai klaim bersumber vs. inferensial |
| Harga (per 2026) | Belum diverifikasi dalam ulasan ini | Belum diverifikasi; pengujian lama mencatat uji coba singkat (Pure AI) | Sekitar titik masuk $144/tahun dalam satu perbandingan 2026 | Belum diverifikasi; berdasarkan tingkatan vendor | Penggunaan terbatas gratis; Plus $20/mo (30×), Premium $50, Pro $100, Max $200, Ultra $500, Enterprise $1,000 |
| Paling sesuai untuk | Ekstraksi sistematis dari makalah | Memeriksa apakah literatur mendukung suatu klaim | Pertanyaan ilmiah ya/tidak yang cepat | Riset web luas dengan tautan inline | Riset multi-putaran yang dapat diaudit dan manajemen sitasi |
Keterbatasan Jenova yang jujur bersifat struktural: alat ini bukan grid ekstraksi makalah khusus seperti Elicit, dan tidak menyediakan grafik sitasi mendukung-versus-bertentangan milik Scite. Keunggulannya adalah memori sesi ditambah penelusuran langsung, yang penting ketika audit membutuhkan pertanyaan lanjutan terhadap jejak sumber yang sama. Keterbatasan Elicit adalah kebalikannya — luar biasa dalam indeks makalah, tetapi lebih lemah sebagai peneliti web umum atau dokumen kebijakan. Perplexity dan ChatGPT tetap menjadi alat yang paling mudah terlalu dipercayai karena sitasi inline yang lancar tetap dapat gagal dalam keselarasan.
Bagaimana Anda Menguji Cakupan Sumber dan Sitasi yang Dapat Diklik?
Anda menguji cakupan dengan mengajukan pertanyaan yang jawaban benarnya tidak mungkin berasal dari satu korpus, lalu mengklik setiap tautan. Cakupan lulus berarti asisten mengambil jenis sumber yang diperlukan oleh klaim — uji klinis untuk ukuran efek klinis, undang-undang atau halaman lembaga untuk ambang hukum, buku kode dataset untuk statistik — alih-alih blog praktis yang menyebut kata kunci sama.
Buat tiga probe cakupan:
- Probe khusus akademis: “Apa yang ditunjukkan uji acak sejak 2020 tentang X, dan hasil mana yang telah dipraregistrasi?”
- Probe dokumen primer: “Apa yang dikatakan aturan, pengajuan, atau dataset lembaga asli — bukan rangkuman berita?”
- Probe ruang negatif: “Sumber tepercaya mana yang membahas hal ini tetapi tetap menganggap efeknya belum terbukti?”
Kemudian terapkan protokol klik. Untuk setiap sitasi, catat apakah URL dapat diakses, apakah halaman tujuan adalah dokumen yang dikutip, dan apakah manusia dapat menemukan bagian pendukung dalam dua menit. Panduan evaluasi Northwestern merekomendasikan pencarian judul dalam katalog atau database perpustakaan karena sistem AI kerap memasangkan judul nyata dengan jurnal, penulis, atau tahun yang salah. Tautan mati, tautan beranda generik, dan catatan kaki “sumber: internet” adalah kegagalan otomatis.
Di Jenova, jadikan cakupan sebagai instruksi eksplisit, bukan harapan:
“Jawab menggunakan setidaknya empat sumber independen. Utamakan makalah yang ditelaah sejawat, badan pemerintah atau badan standar, dan dataset primer. Untuk setiap klaim, berikan URL yang dapat diklik, judul dokumen, tanggal publikasi atau pembaruan, serta kutipan 15–25 kata yang mendukung klaim. Jika Anda tidak dapat menemukan sumber primer, katakan demikian dan berhenti.”
Di Elicit, pengujian yang setara adalah apakah sel yang diekstrak dapat dipetakan kembali ke cuplikan makalah yang terlihat, bukan ke parafrasa model. Di Perplexity atau ChatGPT, pengujiannya lebih ketat: buka setiap tautan inline, karena agen riset web terbuka dapat mengambil banyak halaman dan tetap mengutip yang paling lemah. Memasangkan Jenova's Academic Research Assistant dengan Real-Time Search berguna ketika probe mencakup makalah, forum, repositori kode, dan berita sekaligus — tetapi setiap kanal tetap memerlukan pemeriksaan kliknya sendiri.
Bagaimana Anda Menguji Keselarasan Klaim dengan Sumber dan Inferensi Berlabel?
Anda menguji keselarasan dengan bertanya apakah bagian sumber yang dikutip mendukung secara langsung kalimat tersebut, bukan apakah kalimat itu sekadar berkaitan secara umum. Kegagalan yang paling penting adalah angka yang nyaris benar atau kualifikasi yang dihilangkan: sumber mengatakan “sekitar 80%,” model menulis “78%,” dan sitasi masih terlihat sempurna. Itulah kelas kesalahan yang dirancang untuk ditangkap oleh pelaksana evaluasi otomatis.
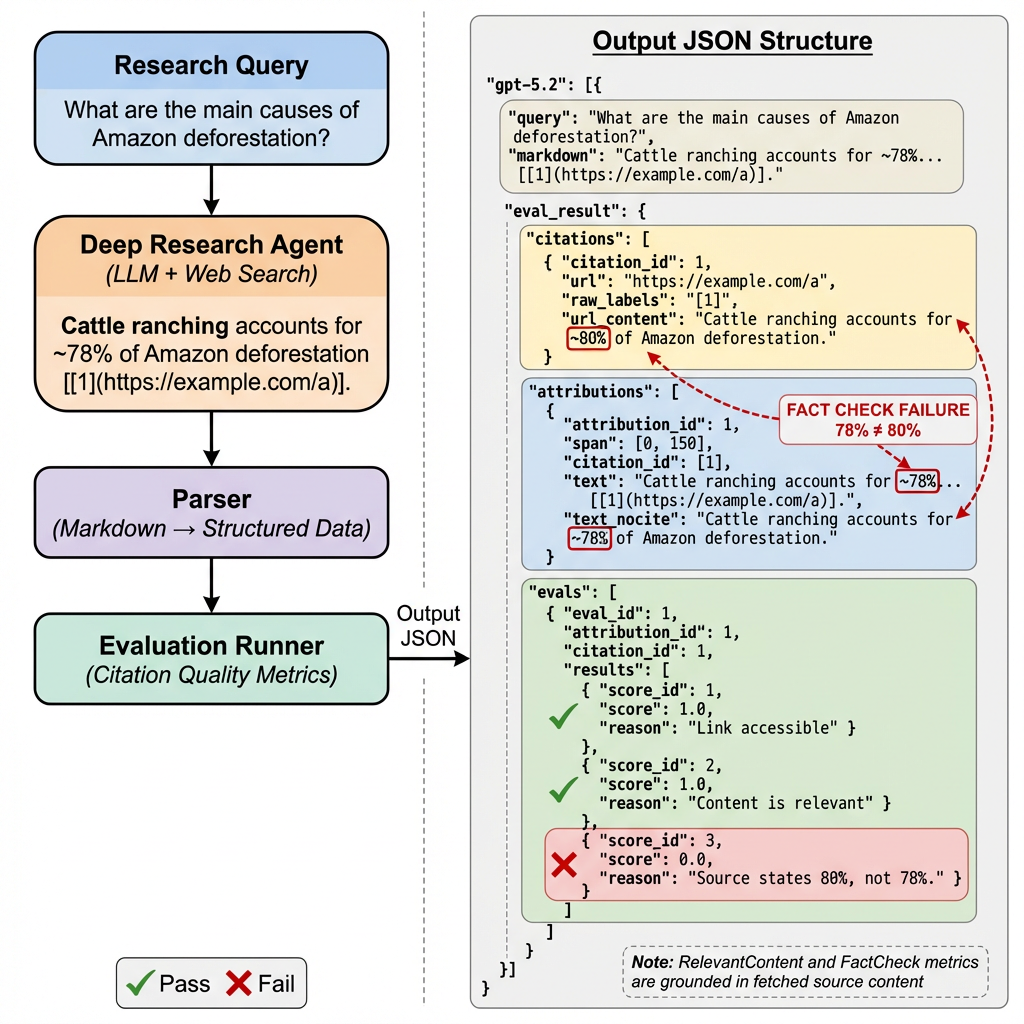
Gunakan uji keselarasan tiga lapis untuk setiap klaim kuantitatif atau kausal:
- Kecocokan cuplikan: sorot kalimat dalam sumber yang seharusnya mendukung klaim.
- Dukungan langsung: putuskan apakah klaim didukung secara langsung, tidak cukup ditentukan, atau bertentangan. Tidak cukup ditentukan adalah gagal jika asisten menyatakan klaim sebagai fakta.
- Kesetiaan angka dan kualifikasi: unit, sampel, tahun, interval kepercayaan, serta kata seperti “mungkin,” “pada tikus,” atau “di satu negara” harus tetap utuh.
Inilah alasan dukungan tekstual langsung merupakan metrik audit yang lebih baik daripada “halaman ini relevan.” Evaluasi Open-QA berbasis dukungan langsung ada secara khusus untuk mengukur kesenjangan inferensi antara dua teks. Pendekatan validasi sitasi NVIDIA mengoperasionalkan gagasan yang sama: bandingkan klaim dengan teks rujukan, lalu beri skor.
Inferensi berlabel adalah pemeriksaan pendampingnya. Asisten riset seharusnya menandai setiap paragraf sebagai sourced, inferred, atau unknown. Sintesis diperbolehkan; sintesis diam-diam tidak. Panduan pemeriksaan klaim UNR menawarkan naluri yang tepat: tanyakan siapa yang dapat memverifikasi pernyataan tersebut. Jika pihak yang memverifikasi adalah “pengetahuan umum model,” kalimat itu memerlukan label inferensi.
Prompt ketat untuk pemeriksaan ini:
“Pisahkan jawaban Anda menjadi tiga blok berlabel: (1) Klaim yang didukung langsung, masing-masing dengan kutipan dan URL; (2) Inferensi, beserta premis yang mendasarinya; (3) Hal yang belum diketahui. Jangan pindahkan inferensi ke blok 1. Jika angka bersifat perkiraan dalam sumber, pertahankan sifat perkiraannya.”
Elicit mengurangi inferensi tersembunyi dengan memaksa jawaban masuk ke kolom ekstraksi, dan itu merupakan kekuatan nyata. Scite memberi label apakah makalah berikutnya mendukung atau menentang suatu sitasi, yang menangkap lompatan berbeda — memperlakukan satu makalah sebagai konsensus mapan. Jenova dapat mengikuti format tiga blok sepanjang sesi panjang, tetapi tidak akan memaksakan label tersebut kecuali Anda memintanya. Ini adalah kesenjangan produk yang nyata dibandingkan alat dengan pengukur bukti bawaan.
Bagaimana Anda Memverifikasi Tanggal Pembaruan dan Keterkinian Sumber?
Anda memverifikasi keterkinian dengan meminta tanggal yang terlihat pada setiap sumber dan menyertakan setidaknya satu probe yang jawaban benarnya berubah dalam setahun terakhir. Asisten yang tidak dapat menunjukkan kapan halaman atau makalah diterbitkan belum siap untuk pertanyaan tentang harga, regulasi, peluncuran model, epidemiologi, atau struktur pasar.
Penelitian keterkinian konten dalam pencarian AI menemukan bahwa kebaruan memengaruhi apakah sistem mengambil halaman untuk pertanyaan terkini. Pekerjaan pelacakan atas sitasi AI juga memperingatkan bahwa mesin mengevaluasi ulang sumber secara terus-menerus, sehingga ringkasan rapi kemarin dapat menjadi usang secara diam-diam. Karena itu, audit Anda harus mencatat tiga tanggal, bukan satu:
- Tanggal sumber — stempel waktu publikasi atau pembaruan terakhir pada halaman atau makalah
- Tanggal bukti — tahun ketika data yang mendasari dikumpulkan
- Tanggal jawaban — waktu ketika asisten mengambil sumber
Kegagalan umum adalah mengutip ulasan 2019 untuk angka prevalensi “terkini,” atau mengutip dasbor langsung tanpa mencatat stempel waktu pengambilan. Spesialis akademis seperti Elicit dan Consensus biasanya menampilkan tahun publikasi karena bertumpu pada metadata makalah. Alat web terbuka sering kali tidak melakukannya kecuali diinstruksikan. Jenova dapat melaporkan tanggal ketika dokumen yang diambil menampilkannya, tetapi tidak dapat menciptakan stempel waktu yang tepercaya untuk halaman tanpa tanggal — dan seharusnya menyatakannya.
Contoh probe keterkinian:
“Berapa angkanya saat ini per 2026? Berikan tanggal pembaruan sumber. Jika sumber terbaik berusia lebih dari 18 bulan, beri label jawaban sebagai historis, bukan terkini.”
“Bandingkan sumber terbaru yang dapat Anda temukan dengan sumber lama yang paling banyak dikutip. Apa yang berubah, dan apa yang tidak?”
Jika asisten tidak dapat membedakan halaman HTML yang direvisi dari cetak ulang PDF yang tidak berubah, nilai keterkinian sebagai gagal meskipun URL berfungsi.
Bagaimana Anda Menjalankan Audit TRACE yang Dapat Diulang dari Satu Prompt?
Anda menjalankan audit yang dapat diulang dengan membekukan set probe, membekukan lembar penilaian, dan memaksa setiap alat menghasilkan bidang yang sama dan dapat diperiksa mesin. Tujuannya adalah transkrip yang dapat dinilai ulang oleh peneliti lain tanpa menyaksikan Anda bekerja.
Gunakan urutan ini untuk Jenova's Academic Research Assistant, lalu ulangi pada setidaknya satu spesialis (Elicit atau Scite) dan satu generalis (Perplexity atau ChatGPT):
- Nyatakan peran dan kontrak keluaran sebelum pertanyaan.
- Ajukan satu probe dari setiap kelas: kuantitatif, kontradiktif, dokumen primer, dan hal yang belum diketahui.
- Wajibkan judul, URL, tanggal, kutipan, dan label klaim pada setiap sitasi.
- Klik setiap tautan dan beri nilai TRACE sebelum mengajukan pertanyaan lanjutan apa pun.
- Baru setelah itu minta revisi atas klaim yang gagal.
Kontrak awal:
“Anda sedang diaudit. Untuk setiap klaim material, hasilkan: teks klaim; label (
sourced/inferred/unknown); judul sumber; URL yang dapat diklik; tanggal publikasi atau pembaruan; kutipan pendukung ≤25 kata. Jika keselarasan tidak sempurna, turunkan label menjadiinferredatauunknown. Jangan mengutip sumber yang tidak Anda ambil. Akhiri dengan catatan cakupan yang mencantumkan jenis sumber yang digunakan dan jenis sumber yang belum ada.”
Di Elicit, prosedur paralelnya adalah menjalankan pertanyaan yang sama sebagai laporan riset, lalu memeriksa sampel sel yang diekstrak terhadap cuplikan PDF. Di Scite, jalankan klaim inti sebagai kueri konteks sitasi dan hitung makalah yang mendukung versus yang bertentangan sebelum menerima kalimat yang terdengar seperti konsensus. Di ChatGPT Deep Research, alur kerja riset milik OpenAI sendiri tetap mengharuskan Anda memeriksa sumber; fitur produknya adalah penelusuran ditambah struktur, bukan pengganti pemeriksaan dukungan langsung.
Simpan log sederhana — klaim, URL, tanggal, skor TRACE, catatan. Sepuluh klaim di seluruh empat probe sudah cukup untuk melihat pola. Jika lebih dari dua klaim numerik gagal dalam keselarasan, berhenti menggunakan alat tersebut untuk keluaran apa pun yang akan dikutip orang lain.
Apa Pendapat Praktisi Integritas Riset tentang Pengujian Sitasi AI?
Praktik integritas riset telah mengarah pada satu aturan tegas: perlakukan sitasi AI sebagai pernyataan yang belum diverifikasi sampai manusia atau pemeriksaan dukungan otomatis membuka sumbernya. Perdebatan yang berguna bukan lagi tentang apakah model berhalusinasi, melainkan kegagalan mana yang dapat Anda instrumentasikan.
“Bidang ini terus mengoptimalkan bibliografi yang lebih indah. Itu adalah unit yang keliru. Sitasi adalah penunjuk, bukan bukti. Jika cuplikan yang dikutip tidak mendukung kalimat tersebut — khususnya angka, populasi, dan tahun — sitasi itu bersifat dekoratif. Kami telah melihat kegagalan ‘78% versus 80%’ lolos dalam setiap pemeriksaan kosmetik: URL nyata, judul relevan, nada meyakinkan. Itulah kesalahan yang bertahan hingga masuk ke manuskrip.”
“Inferensi berlabel adalah pengendalian termurah yang dilewatkan sebagian besar tim. Begitu asisten diizinkan mencampurkan penelusuran dengan pengetahuan dunia, ia akan mencuci tebakan menjadi temuan. Paksakan tiga wadah — bersumber, diinferensikan, belum diketahui — dan tingkat halusinasi Anda menjadi terlihat. Tim yang menolak menampilkan wadah ketidaktahuan sedang memberi tahu Anda bahwa mereka tidak dapat merepresentasikan ketidakpastian.”
“Pengujian cakupan juga merupakan pilihan tata kelola. Asisten khusus makalah akan tampak ketat tetapi tetap melewatkan memo lembaga yang mengubah aturan bulan lalu. Asisten khusus web akan tampak terkini tetapi tetap melewatkan uji klinis yang benar-benar mengukur hasilnya. Pilihan model penting di sini karena sebagian model berhati-hati, sebagian memadatkan, dan sebagian menghilangkan kualifikasi. Audit harus mengikuti klaim, bukan merek.”
— Tim Produk Jenova, evaluasi agen riset, 6 tahun membangun alur kerja penelusuran dan sitasi untuk pengguna akademis dan profesional
Posisi tersebut sejalan dengan praktik perpustakaan. Northwestern mendokumentasikan kasus ketika model mengutip artikel ensiklopedia nyata tetapi tetap salah dalam nama dan tanggal. UNR meminta peneliti menanyakan siapa yang dapat memverifikasi klaim. Keduanya adalah TRACE dalam bentuk prosa.
Kapan Asisten Riset AI Cukup Baik untuk Digunakan dalam Riset Nyata?
Asisten riset AI cukup baik ketika lolos audit TRACE pada jenis pertanyaan Anda yang sebenarnya, dengan klaim yang gagal diperbaiki dari sumber atau diturunkan menjadi inferensi berlabel. Alat tersebut belum cukup baik ketika menghasilkan jawaban yang lancar dan kaya tautan tetapi runtuh dalam pemeriksaan klik dan dukungan langsung.
Gunakan aturan keputusan ini:
- Gunakan ekstraktor khusus seperti Elicit ketika tugasnya adalah penyaringan atau ekstraksi data dari kumpulan makalah yang telah diketahui, dan Anda tetap akan memeriksa sampel sel.
- Gunakan Scite ketika pertanyaannya adalah apakah literatur mendukung, menyebutkan, atau menentang klaim tertentu.
- Gunakan Consensus ketika Anda memerlukan pembacaan cepat arah bukti untuk pertanyaan ilmiah yang terbatas.
- Gunakan Perplexity atau ChatGPT untuk penelusuran awal yang luas, lalu verifikasi ulang setiap angka sebelum masuk ke manuskrip.
- Gunakan Jenova's Academic Research Assistant ketika pekerjaan berlangsung multi-putaran — penemuan literatur, bahasa manuskrip, dan manajemen sitasi dalam satu rangkaian yang dapat diaudit — dan Anda bersedia mewajibkan bidang TRACE dalam prompt.
Jangan gunakan salah satu pun sebagai tahap akhir tanpa pengawasan. Hasil akurasi sitasi JMIR dan tingkat halusinasi Stanford HAI merupakan alasan yang cukup untuk tetap melibatkan manusia dalam alur kerja. Konfigurasi yang unggul pada 2026 bukanlah satu model “tepercaya.” Konfigurasi tersebut adalah jejak sumber yang dapat Anda ulangi: tautan yang dapat diklik, dokumen bertanggal, klaim yang didukung langsung, serta batas yang terlihat antara bukti dan inferensi.
Referensi
- Perpustakaan Universitas Northwestern — Mengevaluasi Konten yang Dihasilkan AI
- Perpustakaan University of Nevada, Reno — AI dan Evaluasi Sumber
- JMIR — Evaluasi Kinerja Model Bahasa Besar dan Keandalan Sitasi yang Dihasilkan
- Stanford HAI — AI di Pengadilan: Model Hukum Berhalusinasi pada 1 dari 6 atau Lebih Kueri Pembandingan
- AuthorityTech — Keterkinian Konten SEO pada 2026
- Diskusi Chris Long / Ahrefs — Keterkinian dan Visibilitas Pencarian AI
- ACL Findings — Evaluasi Open-QA yang Akurat dan Bernuansa melalui Dukungan Tekstual
- NVIDIA Developer — Validasi Sitasi Otomatis Menggunakan NVIDIA NIM
- Elicit — AI untuk Riset Ilmiah, Cakupan, dan Akurasi Ekstraksi
- Scite — Smart Citations untuk Literatur Ilmiah
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- iatroX — Alat AI Terbaik untuk Riset Medis 2026
- Perpustakaan HKUST — Perbandingan Alat AI Baru untuk Tinjauan Literatur
- Omid Saffari — Alat Riset AI Terbaik 2026: Elicit vs Consensus
- Pure AI — Sitasi Diperlukan: Menguji 7 Alat Riset AI
- SEOptimer — Keterkinian Konten dalam SEO dan Pencarian AI
- OtterlyAI — Cara Melacak Sitasi dan Sumber Mesin Pencarian AI
- Firecrawl — Pencarian Web dan Riset Mendalam untuk Agen AI
- OpenAI Academy — Riset dengan ChatGPT: Search dan Deep Research