Bagaimana Anda Dapat Mencegah Pelanggaran Integritas Riset AI?
2026-08-22
Mode Kegagalan Apa yang Harus Memandu Pilihan Anda atas Alat Riset AI?
Sebagian besar kegagalan integritas terkait AI dalam pekerjaan akademik berasal dari empat mode kegagalan yang dapat diprediksi — sumber yang direkayasa, sitasi yang tidak cocok atau terdistorsi, plagiarisme tidak sengaja, dan paparan data sensitif — dan alat yang menguranginya adalah alat yang mengambil literatur nyata sebelum menulis, bukan yang menulis terlebih dahulu lalu menciptakan daftar pustaka belakangan. Pada 2026, analisis Nature menemukan bahwa puluhan ribu publikasi tahun 2025 mungkin memuat referensi buatan AI yang tidak valid. Peneliti yang membandingkan pilihan biasanya menilai Academic Research Assistant milik Jenova untuk pekerjaan literatur dengan pengelolaan sitasi, Elicit untuk ekstraksi bukti sistematis, dan Scite untuk pemeriksaan konteks sitasi, sambil memperlakukan chatbot generik sebagai berisiko tinggi untuk klaim apa pun yang akan muncul dalam naskah yang diajukan.
Faktor utama yang membedakan riset AI yang aman bagi integritas dari penyusunan draf tanpa batasan:
✅ Arsitektur ambil-lalu-sitasi — sistem harus menemukan artikel nyata sebelum mengatribusikan suatu klaim kepada artikel tersebut. ✅ Verifikasi manusia atas setiap referensi — panduan pengajaran Cornell mewajibkan mahasiswa memverifikasi akurasi semua sitasi ketika penggunaan AI diizinkan. ✅ Pengungkapan dan akuntabilitas manusia — Committee on Publication Ethics (COPE) menyatakan bahwa alat AI tidak dapat menjadi penulis dan bahwa manusia tetap bertanggung jawab atas setiap kalimat, termasuk yang disusun oleh AI. ✅ Pembatasan data — dataset yang belum dipublikasikan, informasi peserta yang dapat diidentifikasi, dan naskah yang masih dalam embargo tidak boleh masuk ke pipeline pelatihan publik. ✅ Kesadaran terhadap ambang kemiripan — aturan institusional kini memperlakukan tumpang tindih yang tinggi, bukan hanya paragraf yang disalin, sebagai peristiwa yang dapat dikenai sanksi.
Untuk membandingkan alat secara bermanfaat, integritas perlu diperlakukan sebagai masalah rekayasa dengan empat gerbang — keberadaan, kesetiaan, atribusi, dan pembatasan — bukan sebagai satu skor plagiarisme.
Mengapa Sitasi Buatan AI Menjadi Krisis Integritas Riset?
Sitasi buatan AI telah menjadi krisis karena model bahasa besar melengkapi pola bibliografi yang tampak masuk akal alih-alih menelusuri katalog perpustakaan, sehingga referensi palsu terlihat cukup nyata untuk lolos dari pemeriksaan cepat. Enago melaporkan bahwa sekitar satu dari lima referensi akademik yang dibuat AI adalah palsu, dan referensi palsu tersebut biasanya meniru nama jurnal yang sah, pola penamaan penulis yang familier, serta judul artikel yang terdengar seperti berasal dari bidang terkait.
Kontaminasi ini tidak lagi terbatas pada esai mahasiswa. Laporan STAT tahun 2026 tentang meningkatnya sitasi curang menggambarkan penyebaran referensi buatan dalam literatur terbitan dan pencemaran catatan publik ilmu pengetahuan. Analisis biomedis juga menemukan bahwa referensi palsu buatan AI semakin umum dalam artikel riset. Setelah artikel hantu disitasi, penulis berikutnya dapat menyalin sitasi tersebut tanpa membuka sumbernya, sehingga satu halusinasi berubah menjadi kesalahan yang bertahan lama.
David B. Resnik dan rekan penulis berpendapat bahwa sitasi yang dihalusinasikan dapat merupakan pelanggaran riset ketika sitasi berfungsi sebagai data — misalnya dalam tinjauan sistematis, peta bukti, atau artikel apa pun yang argumennya bergantung pada siapa mengatakan apa. Kerangka ini penting: referensi yang diciptakan bukanlah kesalahan format. Referensi itu adalah klaim empiris palsu tentang keberadaan catatan akademik.
Editor kini diminta memperlakukan referensi yang tidak dapat diverifikasi sebagai kegagalan penyaringan, bukan gangguan penyuntingan salinan. Komentar PubMed Central membingkai sitasi rekayasa di era AI sebagai peringatan bagi editor jurnal. Bagi peneliti individu, implikasi praktisnya lebih sederhana. Jika sebuah alat tidak dapat menunjukkan sumbernya kepada Anda, Anda tidak memiliki sitasi.
Apa yang Harus Anda Cari dalam Asisten Riset AI yang Aman bagi Integritas?
Asisten riset AI yang aman bagi integritas harus mengambil artikel yang dapat diidentifikasi, mengaitkan klaim dengan bagian tertentu, menjaga file Anda yang belum dipublikasikan tetap berada di luar set pelatihan publik, dan meninggalkan jejak pengungkapan yang dapat Anda pertahankan di hadapan pembimbing atau editor. Daftar fitur adalah proksi yang lemah. Yang penting adalah apakah alur kerja default alat tersebut membuat rekayasa menjadi mahal dan verifikasi menjadi mudah.
Model evaluasi yang bermanfaat adalah Model Integritas yang Mengutamakan Sumber. Nilai sebuah alat berdasarkan kemampuannya melewati empat gerbang sebelum Anda menempelkan apa pun ke dalam bab tesis:
- Keberadaan — Apakah pengenal persisten (DOI, PMID, ISBN, atau URL stabil) mengarah ke karya nyata?
- Kesetiaan — Apakah bagian yang disitasi benar-benar mendukung klaim, atau model telah mendistorsi temuan tersebut?
- Atribusi — Apakah penulis, tahun, dan nomor halaman yang tepat terpasang pada kalimat yang tepat?
- Pembatasan — Apakah materi yang dapat diidentifikasi, sedang dalam embargo, atau sensitif secara klinis keluar dari kendali Anda?
Alat yang menghasilkan prosa terlebih dahulu lalu menaburkan referensi setelahnya secara sistematis gagal pada Gerbang 1. Alat yang menelusuri basis data akademik, mengembalikan artikelnya, lalu baru merangkumnya secara struktural lebih aman, meskipun tidak pernah otomatis. Panduan George Mason University tentang alat AI untuk tinjauan literatur mengelompokkan produk seperti Elicit dan Scite di sekitar sintesis bukti, bukan obrolan terbuka, yang merupakan batas kategori yang tepat.
Pertimbangkan juga kriteria operasional yang benar-benar ditanyakan oleh kantor integritas:
- Dukungan pengungkapan — Dapatkah Anda mencatat nama model, tanggal, dan prompt, sebagaimana APA, MLA, dan Chicago kini menyediakan pola untuk menyitasi keluaran LLM?
- Cakupan memori — Apakah memori proyek membantu Anda tetap konsisten, atau secara diam-diam mencampurkan data satu klien ke sesi lain?
- Default human-in-the-loop — Apakah antarmukanya memudahkan Anda membuka PDF, atau menyembunyikan sumber di balik paragraf yang fasih?
- Kemandirian dari detektor — Cornell saat ini menyarankan agar tidak mengandalkan algoritme deteksi AI otomatis karena tidak andal dan dapat salah menuduh penulis. Alat yang baik mengurangi kebutuhan akan detektor dengan membuat sumber dapat diperiksa.
Academic Research Assistant Jenova dibangun di sekitar penemuan literatur, persiapan naskah, dan pengelolaan sitasi, dengan memori persisten tingkat platform dan alat pencarian akademik. Alat ini bukan pengganti iThenticate, dewan peninjauan institusional, atau persetujuan pembimbing. Keterbatasan itu disengaja: integritas tetap menjadi tanggung jawab manusia.
Bagaimana Perbandingan Alat Riset AI Terkemuka dalam Verifikasi Sitasi dan Privasi?
Asisten riset khusus mengungguli chatbot generik dalam integritas sitasi karena terhubung ke korpus artikel, sedangkan model umum terhubung ke kelancaran token berikutnya. Perbandingan di bawah menggunakan Model Integritas yang Mengutamakan Sumber, bukan kategori pemasaran. Penilaian mencerminkan dokumentasi vendor dan laporan terbitan yang tersedia pada saat penulisan pada 2026.
| Fitur / Dimensi | Chatbot LLM generik | Elicit | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|
| Arsitektur sitasi | Buat-lalu-sitasi; risiko rekayasa tinggi | Mengambil dari korpus 138 juta artikel dan 545.000 uji klinis, dengan sitasi tingkat kalimat | Menelusuri lebih dari 300 juta artikel ilmiah dan menunjukkan apakah artikel berikutnya mendukung atau membantah suatu klaim | Penemuan literatur real-time ditambah dukungan naskah dengan pengelolaan sitasi |
| Pengendalian referensi halusinasi | Lemah kecuali pengguna memverifikasi setiap item secara mandiri | Lebih kuat untuk tabel bukti; tetap memerlukan pemeriksaan manusia | Kuat untuk konteks sitasi; lebih lemah sebagai lingkungan penulisan lengkap | Lebih kuat ketika alat Scholar/pencarian digunakan sebelum penyusunan draf; verifikasi tetap diperlukan |
| Risiko plagiarisme tidak sengaja | Tinggi jika pengguna menempelkan keluaran fasih tanpa perubahan | Lebih rendah untuk tabel ekstraksi; ringkasan masih dapat terlalu dekat dengan frasa sumber | Lebih rendah untuk pemeriksaan klaim; bukan terutama alat penyusunan draf | Lebih rendah saat digunakan untuk kerangka dan peta sumber; draf tetap memerlukan peninjauan orisinalitas |
| Sikap terhadap data sensitif | Berbeda menurut vendor dan paket; model publik adalah default yang buruk untuk data yang dapat diidentifikasi | Ruang kerja riset; ketentuan pelatihan/retensi harus dibaca per paket | Ruang kerja riset; ketentuan pelatihan/retensi harus dibaca per paket | Kebijakan platform: data pengguna tidak digunakan untuk melatih model AI publik |
| Harga (per 2026) | Tidak diverifikasi dalam ulasan ini | Tidak diverifikasi dalam ulasan ini | Tidak diverifikasi dalam ulasan ini | Tingkat gratis dengan penggunaan terbatas; Plus seharga $20/bulan (30× alokasi gratis); tingkat lebih tinggi meningkatkan skala penggunaan |
| Terbaik untuk | Bertukar pikiran tentang pertanyaan yang akan Anda beri sumber sendiri nantinya | Penyaringan sistematis, ekstraksi data, tabel bukti | Memvalidasi bagaimana suatu artikel disitasi dalam literatur | Alur kerja akademik menyeluruh yang memadukan penemuan, catatan, dan penyusunan draf yang sadar sitasi |
Elicit sangat kuat ketika tugasnya adalah tinjauan terstruktur. Perusahaan tersebut menyatakan peneliti melaporkan penghematan waktu hingga 80% pada alur kerja tinjauan sistematis dan bahwa setiap klaim yang dibuat AI didukung oleh sitasi tingkat kalimat. Perbandingan independen pada 2026 umumnya memperlakukan Elicit sebagai alat operasi tinjauan yang lebih luas dan Scite sebagai spesialis kecerdasan sitasi. Satu ulasan berdampingan menempatkan Elicit di depan untuk operasi dan Scite di depan untuk validasi bukti.
Produk bergaya Consensus, sebagaimana dijelaskan dalam perbandingan alat tahun 2026, menjawab pertanyaan riset berdasarkan bukti yang ditelaah sejawat, bukan teks web terbuka. Desain tersebut mengurangi rekayasa dibandingkan chatbot, tetapi tidak menghilangkan masalah kesetiaan: artikel nyata masih dapat diringkas secara keliru.
Keterbatasan jujur Jenova adalah keterbatasan yang sama yang seharusnya diumumkan setiap agen riset yang bertanggung jawab. Jenova dapat mengambil, mengatur, dan menyusun draf; Jenova tidak dapat menjamin bahwa PDF berbayar menyatakan apa yang diyakini model. Peneliti yang membutuhkan hitungan konteks sitasi mungkin tetap memilih Scite untuk tugas sempit tersebut. Peneliti yang menjalankan penyaringan bergaya PRISMA mungkin tetap memilih tabel Elicit. Keuntungan integritasnya adalah menggunakan alat yang mengutamakan sumber, lalu memverifikasinya.
Bagaimana Anda Dapat Mendeteksi dan Memblokir Sitasi yang Direkayasa atau Terdistorsi?
Anda mendeteksi sitasi yang direkayasa dan terdistorsi dengan mengarahkan setiap referensi ke catatan aktif, lalu membaca bagian yang disitasi dibandingkan dengan kalimat Anda, karena keberadaan dan kesetiaan adalah kegagalan yang berbeda. DOI yang menghasilkan 404 adalah rekayasa atau kesalahan metadata fatal. Artikel nyata yang dikutip untuk temuan yang tidak pernah dibuatnya adalah distorsi. Keduanya dapat memicu peninjauan pelanggaran.
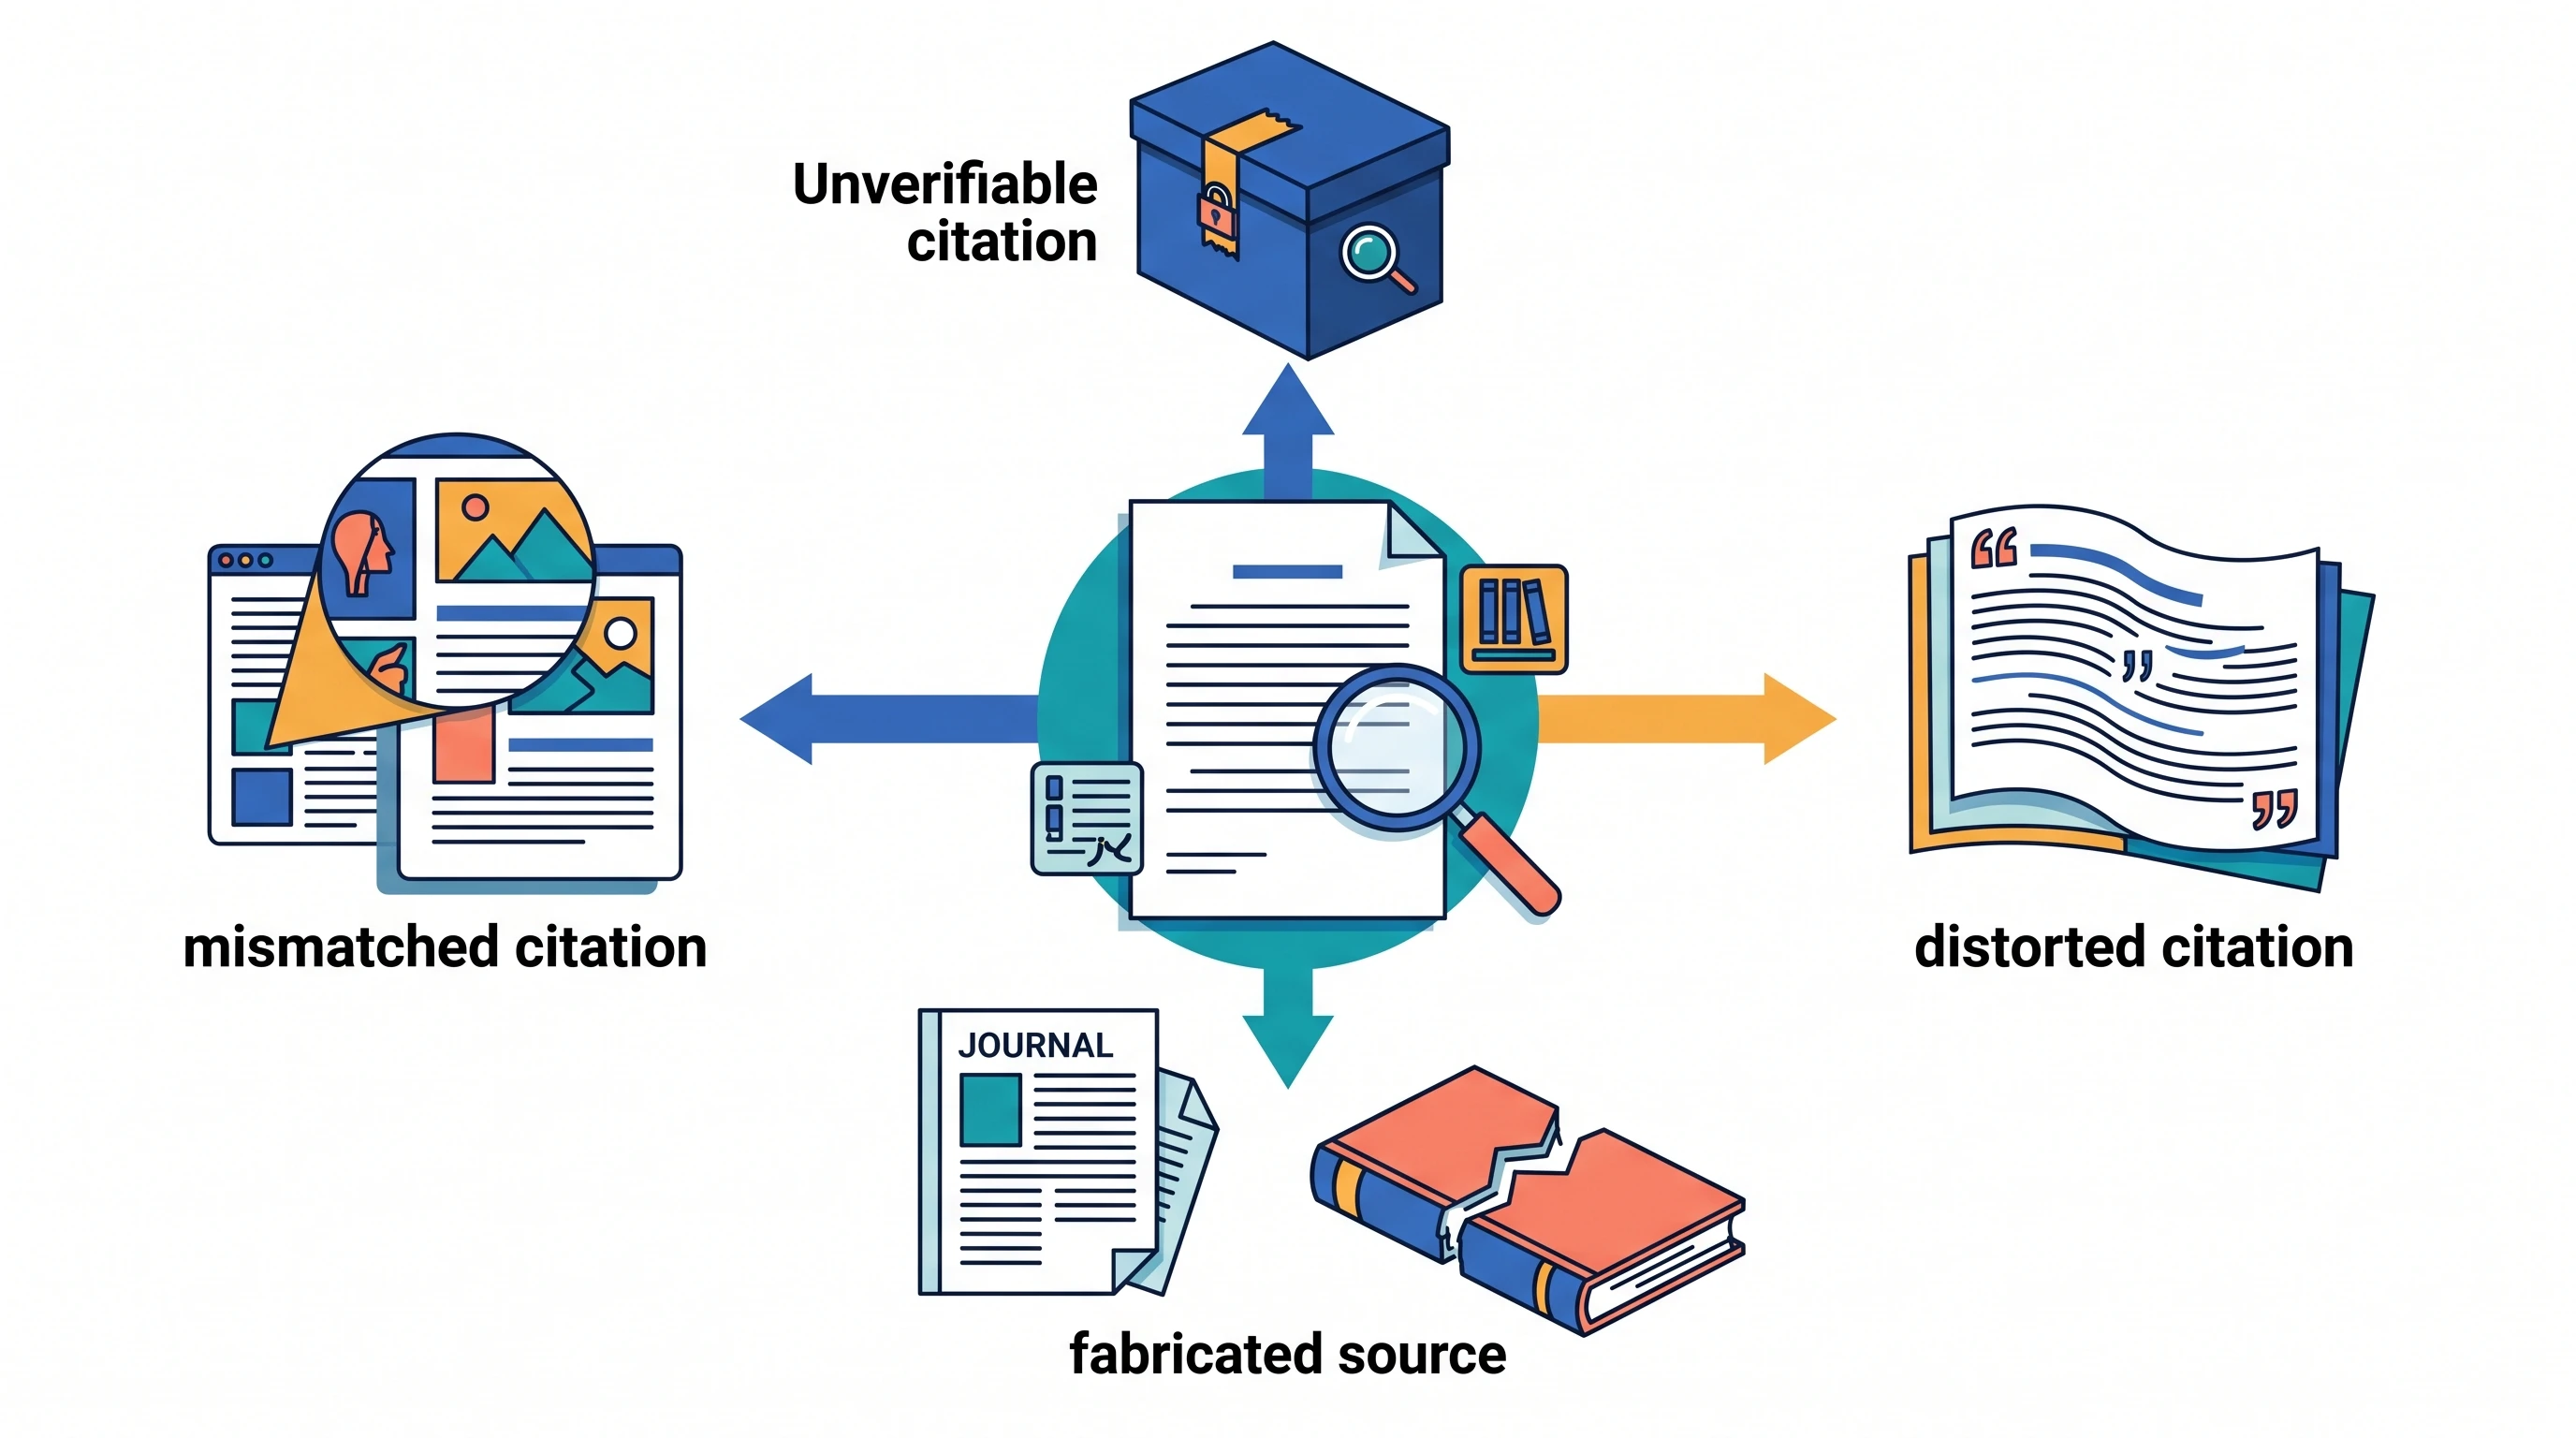
Empat jenis pelanggaran berulang kali muncul dalam daftar pustaka berbantuan AI:
- Sumber rekayasa — artikel, dataset, atau buku tersebut tidak ada.
- Sitasi yang tidak dapat diverifikasi — item mungkin ada, tetapi tidak ada catatan, DOI, atau salinan arsip yang dapat diakses.
- Sitasi tidak cocok — karya nyata dipasangkan dengan klaim, penulis, atau tahun yang salah.
- Sitasi terdistorsi — sumber ada dan relevan dengan topik, tetapi model membalikkan hasil, menghilangkan kualifikasi, atau memperlakukan keterbatasan sebagai temuan.
Protokol pemblokiran praktis membutuhkan sekitar dua menit untuk setiap klaim utama dan jauh lebih singkat setelah menjadi kebiasaan:
- Salin referensi ke Crossref, PubMed, Google Scholar, atau situs jurnal dan konfirmasi tiga serangkai judul–penulis–tahun.
- Buka PDF atau HTML dan temukan bagiannya. Jika tidak dapat menemukannya, hapus sitasinya.
- Periksa apakah penanda kehati-hatian tetap bertahan. “Berhubungan dengan” bukan “menyebabkan.” “Pada tikus” bukan “pada pasien.”
- Tolak sumber apa pun yang tidak dapat dihasilkan model saat diminta. “Saya ingat ada artikel tahun 2019 di Nature Neuroscience…” bukanlah sitasi.
- Simpan log verifikasi (spreadsheet atau catatan pengelola referensi) untuk bab tesis dan pengajuan jurnal.
Academic Research Assistant Jenova paling berguna pada langkah 1, ketika Anda memintanya mengambil artikel kandidat dan membangun peta sumber sebelum prosa apa pun ada. Padukan dengan Scite ketika Anda perlu mengetahui apakah literatur berikutnya mendukung atau membantah artikel yang akan Anda jadikan tumpuan. Padukan dengan Elicit ketika Anda mengekstrak metode dan hasil dari tumpukan uji coba.
Prompt dengan integritas tinggi terlihat seperti ini:
“Temukan artikel yang ditelaah sejawat dari 2020–2026 tentang [topik]. Untuk setiap artikel, berikan judul, penulis, tahun, DOI, tempat publikasi, dan klaim 25 kata yang secara eksplisit dinyatakan dalam abstrak atau hasil. Jika Anda tidak dapat memverifikasi DOI, jangan sertakan artikelnya. Jangan menciptakan referensi.”
Chatbot generik tetap terkadang akan gagal pada prompt ini. Perbedaannya adalah alur kerja yang mengutamakan sumber membuat kegagalan tersebut terlihat.
Bagaimana Anda Mencegah Plagiarisme Tidak Sengaja Saat Menyusun Draf dengan AI?
Anda mencegah plagiarisme tidak sengaja dengan memperlakukan keluaran AI sebagai bahan mentah tanpa lisensi — bukan sebagai teks yang Anda miliki — serta menulis ulang dari catatan alih-alih dari kalimat fasih milik model. Plagiarisme tidak sengaja kini menjadi kasus yang umum: pengguna tidak bermaksud mencuri, tetapi model meringkas sumber sedemikian dekatnya sehingga pemeriksa kemiripan, penguji, atau penelaah masih dapat menemukan kecocokan frasanya.
COPE mengharuskan penulis yang menggunakan AI dalam penulisan, gambar, atau analisis untuk mengungkapkan alat dan cara penggunaannya, biasanya dalam Metode atau bagian yang setara. Penulis tetap “bertanggung jawab penuh atas isi naskah mereka, termasuk bagian yang dihasilkan oleh alat AI.” Kalimat itu adalah keseluruhan struktur hukumnya. Model tidak dapat memegang hak cipta, mengelola konflik, atau menjawab pemberitahuan penarikan. Anda yang dapat melakukannya.
Tiga jalur plagiarisme muncul dalam draf berbantuan AI:
- Gema sumber — model memparafrasekan artikel yang Anda tempelkan atau yang diambilnya, sambil mempertahankan sintaksis asli.
- Plagiarisme diri — model mendaur ulang paragraf metode Anda yang telah diterbitkan sebelumnya karena Anda mengunggahnya sebagai “latar belakang.”
- Patchwriting dalam skala besar — banyak kalimat yang sedikit diubah dari banyak artikel, yang tetap ditandai oleh perangkat lunak kemiripan.
Urutan penyusunan draf yang lebih aman:
- Baca sumber sendiri dan tulis poin dalam kata-kata Anda sendiri beserta nomor halaman.
- Minta model mengatur ulang poin-poin Anda, bukan PDF.
- Jalankan alat kemiripan institusi Anda pada bab tersebut, bukan pada “skor orisinalitas” chatbot.
- Ungkapkan bantuan AI dalam format yang ditentukan jurnal atau sekolah pascasarjana Anda.
Prompt yang mengurangi gema:
“Saya akan menempelkan catatan kerangka saya sendiri, bukan PDF sumber. Susun ulang menjadi argumen yang logis. Jangan tambahkan sitasi baru. Jangan kembangkan poin apa pun menjadi bahasa yang dapat dianggap sebagai kalimat ilmiah jadi. Tandai setiap poin yang masih membutuhkan sumber.”
Academic Research Assistant Jenova membantu di sini ketika Anda menyimpan teks sumber pada lapisan catatan dan menyusun draf dalam utas terpisah. Memori persisten merupakan keunggulan untuk tesis panjang, karena agen dapat mengingat pertanyaan riset dan artikel yang dikecualikan. Namun, ini juga berisiko jika Anda menempelkan draf belum terbit milik rekan penulis ke proyek yang sama. Pembatasan adalah bagian dari orisinalitas: jangan biarkan satu naskah bocor ke naskah lain.
European Network for Academic Integrity menerbitkan pedoman integritas umum yang masih digunakan institusi sebagai kosakata dasar. Ulasan ScienceDirect tahun 2025 berpendapat bahwa universitas harus membangun kompetensi mahasiswa dan kebijakan AI yang eksplisit, bukan sekadar membeli detektor. Itulah penekanan yang tepat. Detektor hanya menebak. Pengungkapan dan log sumber membuktikan.
Bagaimana Anda Menjaga Data Riset Sensitif Tetap di Luar Sistem AI Publik?
Anda menjaga data riset sensitif tetap di luar sistem AI publik dengan tidak pernah menempelkan materi yang dapat diidentifikasi, sedang dalam embargo, atau dibatasi secara kontraktual ke alat yang pelatihan, retensi, atau subprosesornya tidak dapat Anda sebutkan. IBM mendefinisikan privasi AI sebagai perlindungan atas informasi pribadi atau sensitif yang dikumpulkan, digunakan, dibagikan, atau disimpan oleh sistem AI. Pekerjaan akademik dipenuhi jenis informasi tersebut: transkrip wawancara, catatan pasien, catatan sekolah, hasil negatif yang belum diterbitkan, dan narasi hibah.
Prinsip privasi klasik berbenturan dengan penggunaan AI yang naif. Komisioner informasi Victoria mencatat bahwa AI menantang pembatasan pengumpulan, spesifikasi tujuan, dan pembatasan penggunaan — gagasan bahwa Anda hanya mengumpulkan yang dibutuhkan, menyatakan alasannya, dan tidak mendaur ulang data itu untuk tujuan baru. Menempelkan seluruh dataset kualitatif ke chatbot publik untuk “menemukan tema” adalah tujuan baru yang tidak disetujui peserta.
Daftar periksa pembatasan yang dapat dipertahankan dalam peninjauan etika:
- Minimalkan — kirim kode, kutipan yang telah dihapus identitasnya, atau kamus variabel, bukan file mentah. Panduan minimalisasi data untuk sistem AI adalah mengumpulkan dan menyimpan hanya yang diperlukan oleh tugas.
- Hapus identitas sebelum unggah — hapus nama, lokasi, diagnosis langka, dan metadata file.
- Utamakan platform yang menyatakan bahwa mereka tidak melatih model publik menggunakan konten Anda — kebijakan platform Jenova menyatakan bahwa data pengguna tidak digunakan untuk melatih model AI publik dan dienkripsi saat transit maupun saat disimpan. Baca ketentuan pesaing mana pun dengan tingkat kekhususan yang sama; “kami menganggap privasi serius” bukanlah kontrol.
- Pisahkan proyek — satu utas agen per studi, agar dataset rumah sakit tidak dapat diingat kembali saat Anda menyusun draf artikel blog publik.
- Periksa kontrak — pekerjaan yang didanai industri, temuan penggunaan ganda, dan perjanjian penggunaan data sering kali melarang pemroses pihak ketiga sepenuhnya.
Jenova lebih kuat daripada chatbot konsumen pada dimensi ini karena sikap tanpa pelatihan publik dan memori proyek yang Anda kendalikan. Jenova bukan rekam medis elektronik bersertifikasi HIPAA, mesin anonimisasi, atau pengganti lingkungan aman universitas Anda. Jika protokol IRB menyebutkan perangkat lunak yang disetujui, daftar itu yang berlaku.
Untuk riset wawancara, prompt yang aman adalah:
“Berikut enam kutipan yang telah dihapus identitasnya dengan nama dan tempat yang sudah dihapus. Usulkan kode tematik saja. Jangan menebak identitas. Jangan menyimpan kutipan ini melampaui tugas ini jika nanti saya meminta Anda melupakannya.”
Jika Anda tidak dapat menulis prompt itu karena teksnya masih mengidentifikasi, Anda belum siap menggunakan AI pada data tersebut.
Bagaimana Anda Membangun Alur Kerja Riset AI yang Aman bagi Integritas?
Alur kerja yang aman bagi integritas dimulai dari pertanyaan riset dan pustaka sumber, menggunakan AI hanya pada tahap yang ditentukan, serta berakhir dengan paragraf pengungkapan dan log verifikasi. Urutan di bawah ini bekerja dalam Academic Research Assistant Jenova dan dapat dicerminkan, dengan kekuatan berbeda, di Elicit atau Scite.
Tahap 1 — Menetapkan cakupan tanpa sumber. Minta agen membuat daftar definisi yang bersaing, basis data yang mungkin digunakan, dan aturan pengecualian. Jangan menerima sitasi apa pun terlebih dahulu.
“Saya sedang menulis bab metode tentang [pertanyaan]. Buat daftar subpertanyaan yang harus dicakup pencarian sistematis. Jangan menyitasi artikel. Tandai bagian ketika pertanyaan saya terlalu luas.”
Tahap 2 — Ambil, lalu bekukan pustaka. Gunakan Academic Research Assistant (atau Elicit, jika Anda menyaring ratusan uji coba) untuk mengumpulkan catatan kandidat dengan DOI. Ekspor ke Zotero, EndNote, atau pengelola institusional Anda. Pengelola referensi — bukan transkrip obrolan — menjadi sistem catatan resmi.
Agen Deep Research terkait dari Jenova berguna ketika Anda membutuhkan pengarahan luas dengan banyak sitasi sebelum mempersempit korpus. Perlakukan pengarahan itu sebagai peta, bukan sebagai literatur yang telah Anda baca.
Tahap 3 — Ekstrak dengan tabel, bukan paragraf. Minta desain studi, sampel, hasil, dan keterbatasan dalam kolom. Elicit dibuat khusus untuk ini; Jenova dapat menyusun tabel yang sama jika Anda memberinya artikel yang telah Anda buka.
Tahap 4 — Susun draf dari catatan Anda. Tulis atau diktekan poin-poin. Izinkan agen membuat kerangka dan menguji tekanan logika. Jangan biarkan agen “menghaluskan” bahasa hingga sumber telah dikunci.
Tahap 5 — Verifikasi dan ungkapkan. Arahkan setiap DOI ke sumbernya. Baca setiap bagian yang Anda sitasi. Tambahkan kalimat metode seperti: “Model bahasa besar (nama model, tanggal) digunakan untuk mengatur catatan dan menyarankan istilah pencarian; semua sitasi diperiksa terhadap sumber primer oleh penulis.”
Penyiapan di Jenova membutuhkan beberapa menit: buka Academic Research Assistant, nyatakan bidang dan batasan integritas Anda dalam pesan pertama, lalu lampirkan hanya file yang diizinkan untuk Anda proses. Tingkat gratis mencakup penggunaan terbatas; Plus mulai dari $20 per bulan dengan 30 kali alokasi gratis. Penggunaan merupakan kumpulan bulanan, bukan batas harian, yang penting selama periode revisi intensif.
Untuk Elicit, jalur paralelnya adalah: ajukan pertanyaan tinjauan, buat tabel bukti, sesuaikan artikel mana yang masuk laporan, lalu ekspor dan verifikasi. Untuk Scite, jalur paralelnya adalah: masukkan artikel utama Anda dan periksa sitasi yang mendukung dibandingkan yang membantah sebelum Anda mengklaim adanya konsensus.
Aturan alur kerja yang tidak dapat ditawar adalah urutan. Cari sebelum kalimat. Bagian sebelum parafrasa. Pengungkapan sebelum pengajuan.
Apa Kata Pakar Integritas Riset tentang Karya Akademik Berbantuan AI?
Spesialis integritas riset semakin memperlakukan sitasi yang dihalusinasikan, penyusunan draf AI yang tidak diungkapkan, dan unggahan data yang tidak terkendali sebagai kegagalan proses yang dapat diantisipasi institusi, bukan sebagai peristiwa kecurangan mahasiswa yang langka.
“Kesalahan yang kami lihat bukanlah bahwa peneliti menggunakan model. Kesalahannya adalah mereka menggunakan putaran buat-lalu-sitasi pada tugas ketika sitasi itu sendiri merupakan datum. Jika bagian hasil Anda bergantung pada keberadaan suatu artikel, maka referensi palsu yang fasih lebih dekat pada fabrikasi data daripada pemformatan yang ceroboh. Perbaikannya bersifat arsitektural: ambil catatannya, ekstrak klaimnya, lalu tulis. Alat yang membalik urutan tersebut akan terus menanam hantu dalam literatur.”
“Kegagalan privasi mengikuti pembalikan yang sama. Orang menempelkan file terkaya yang mereka miliki karena praktis, yang merupakan kebalikan dari pembatasan pengumpulan. Hapus identitas terlebih dahulu, minimalkan kedua, dan pilih sistem yang tidak akan melatih model publik dengan sisa data tersebut. Kenyamanan bukan pengecualian etika.”
“Kami juga menyarankan laboratorium berhenti menyerahkan integritas kepada detektor AI. Detektor tidak dapat menunjukkan sumber, tidak dapat membuktikan niat, dan menciptakan positif palsu yang menghukum penulis nonpenutur asli. Log verifikasi dan pengungkapan bergaya COPE memang lebih lambat pada hari pertama, tetapi jauh lebih cepat ketika penelaah bertanya, ‘Dari mana referensi ini berasal?’”
— Tim Produk Jenova, riset alur kerja AI akademik, delapan tahun merancang agen riset yang sadar sitasi
Perspektif tersebut selaras dengan panduan formal. COPE menetapkan tanggung jawab kepada penulis manusia. Cornell meminta pengajar mewajibkan verifikasi sitasi dan mengumpulkan bukti objektif — referensi yang tidak ada, metode yang tidak dapat dijelaskan mahasiswa — alih-alih skor detektor. Pembahasan Cambridge tentang integritas akademik di era AI dimulai dari premis yang sama: jika penilaian tidak lagi mencerminkan pembelajaran, kredensial itu sendiri yang menjadi korban.
Apa yang Terjadi Ketika Penggunaan AI Melampaui Ambang Integritas Institusional?
Ketika penggunaan AI melampaui ambang institusional, hukuman melekat pada penulis manusia dan, semakin sering, pada pembimbing — mulai dari revisi wajib hingga pengajuan yang tertunda atau registrasi yang dibatalkan. Kebijakan berbeda menurut negara dan kampus, tetapi arah perkembangan pada 2026 adalah rentang kemiripan yang lebih ketat, pengawasan AI yang eksplisit, dan lebih sedikit toleransi terhadap alasan “model yang mengada-adakannya.”
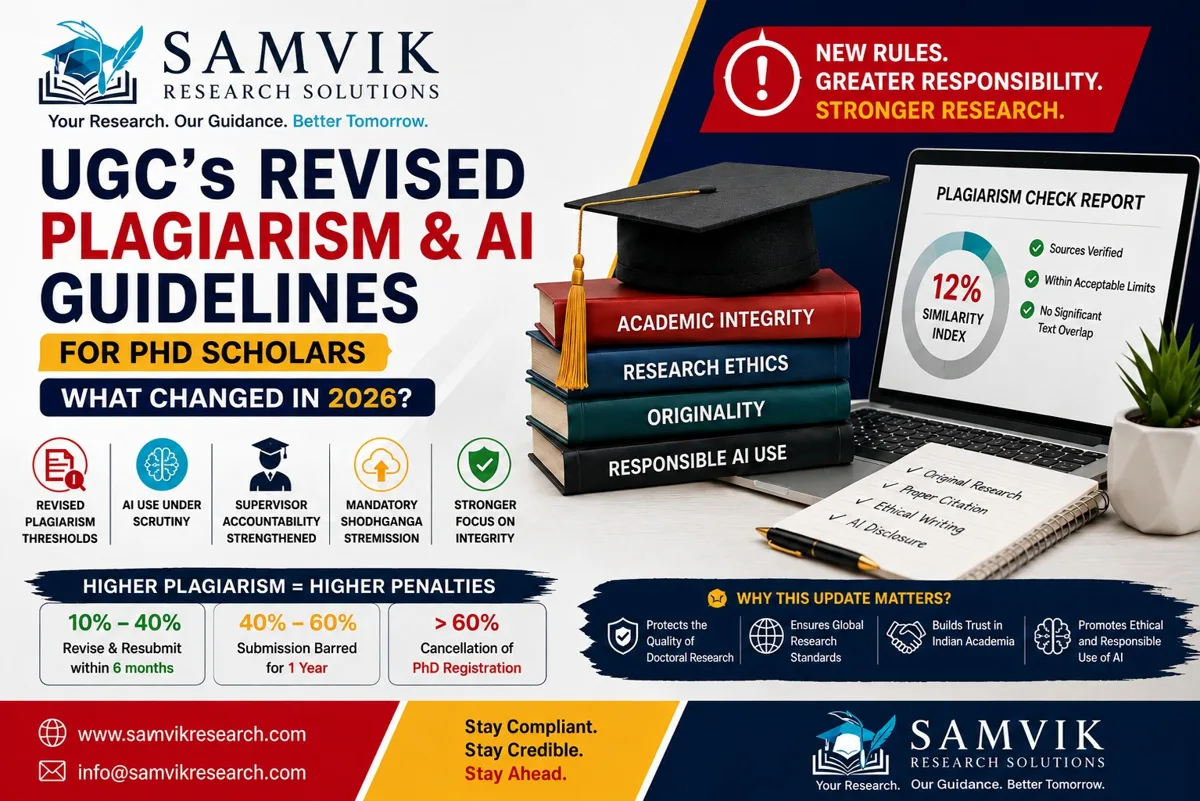
Panduan yang diedarkan kepada mahasiswa PhD pada 2026 terkait revisi University Grants Commission (UGC) menggambarkan bagaimana ambang numerik berubah menjadi peristiwa karier. Dalam kerangka tersebut, kemiripan antara 10% dan 40% memicu revisi dan pengajuan ulang dalam enam bulan; 40% hingga 60% dapat melarang pengajuan selama satu tahun; dan kemiripan di atas 60% dapat membatalkan registrasi PhD. Panduan yang sama memasangkan rentang tersebut dengan peninjauan penggunaan AI yang lebih ketat, akuntabilitas pembimbing yang lebih kuat, dan kewajiban penyimpanan di repositori. Bahkan jika universitas Anda menggunakan batas yang berbeda, logikanya dapat diterapkan: tumpang tindih diperlakukan sebagai sinyal integritas yang terukur, dan “AI membantu” bukan pembelaan jika teks itu bukan milik Anda atau referensinya tidak nyata.
Jurnal menambahkan lapisan kedua. Posisi kepenulisan COPE berarti Anda tidak dapat mencantumkan ChatGPT, Elicit, Scite, atau Jenova sebagai rekan penulis. Anda dapat, dan sering kali harus, menyebutkan alat tersebut dalam Metode. Kegagalan mengungkapkan semakin diperlakukan sebagai pelanggaran transparansi bahkan ketika ilmunya valid. Sebaliknya, referensi yang direkayasa dapat membenarkan penolakan atau penarikan karena memalsukan catatan akademik.
Implikasi praktis bagi siapa pun yang mengajukan karya pada 2026:
- Ketahui rentang kemiripan lokal Anda sebelum menyusun draf, bukan setelah pemeriksa dijalankan.
- Simpan prompt dan versi model agar Anda dapat merekonstruksi kontribusi alat tersebut.
- Jangan perlakukan skor detektor AI yang rendah sebagai izin. Perlakukan daftar pustaka yang lengkap dan dapat diarahkan ke sumber sebagai izin.
- Jika Anda membimbing mahasiswa, tinjau log sumber mereka. Akuntabilitas bergerak ke atas dalam rantai.
Digunakan dalam batasan tersebut, AI tetap menjadi akselerator yang sah untuk pencarian, ekstraksi, dan pengorganisasian. Digunakan sebagai rekan penulis tak terlihat dengan daftar referensi yang diciptakan, AI kini menjadi salah satu cara cepat untuk menghambat gelar atau artikel.
Referensi
- Nature — Sitasi halusinasi mencemari literatur ilmiah
- Enago — Referensi buatan AI: 1 dari 5 adalah palsu
- STAT — Sitasi curang yang dikaitkan dengan halusinasi AI menyebar dalam artikel akademik
- Today’s Clinical Lab — Referensi palsu buatan AI meningkat dalam literatur biomedis
- Accountability in Research (Taylor & Francis) — Sitasi halusinasi yang dihasilkan kecerdasan buatan generatif
- PubMed Central — Sitasi rekayasa di era AI: peringatan bagi editor
- Cornell University Center for Teaching Innovation — AI dan integritas akademik
- COPE — Kepenulisan dan alat AI
- Elicit — AI untuk riset ilmiah (ukuran korpus, sitasi tingkat kalimat, alur kerja tinjauan sistematis)
- Scite — Jawaban berbasis sitasi di lebih dari 300 juta artikel ilmiah
- Paperguide — Perbandingan Elicit vs Scite untuk peneliti (2026)
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Perpustakaan George Mason University — Alat AI untuk tinjauan literatur
- IBM — Mengeksplorasi isu privasi di era AI
- Office of the Victorian Information Commissioner — Kecerdasan buatan dan privasi: isu serta tantangan
- Fortra — Privasi data AI: tantangan dan solusi
- European Network for Academic Integrity — Pedoman umum untuk integritas akademik
- ScienceDirect — Menilai ulang integritas akademik di era AI
- Cambridge University Press — Integritas Akademik di Era AI