Bagaimana Menjaga Kepribadian, Latar Belakang, dan Nama Pendamping AI Tetap Konsisten di Berbagai Percakapan?
2026-08-17
Tiga Lapisan Apa yang Sebenarnya Mengendalikan Konsistensi Pendamping AI?
Konsistensi pendamping AI dikendalikan oleh tiga lapisan berbeda — definisi persona (siapa karakter tersebut), penyimpanan memori (apa yang dipertahankan sistem di antara sesi), dan konteks sesi (apa yang muat dalam jendela percakapan aktif). Penyimpangan terjadi ketika lapisan-lapisan ini saling bertentangan, bukan karena modelnya “lupa”. Memperbaiki konsistensi berarti mengaudit ketiganya secara terpisah, dan platform yang Anda gunakan menentukan seberapa besar kendali yang Anda miliki atas masing-masing lapisan.
Di antara platform pendamping utama yang diuji pada 2026, kualitas memori sangat bervariasi. Nomi AI menghasilkan catatan terstruktur dari percakapan dan mengingat kembali 23 dari 25 detail yang ditanam beberapa minggu kemudian dalam pengujian independen, sementara Character.AI secara efektif tidak memiliki memori jangka panjang dan melupakan sebagian besar detail di antara sesi. Agen bermain peran dan karakter Jenova berada dalam kategori berbeda — memori persisten lintas sesi dengan riwayat chat tanpa batas, tetapi dirancang berpusat pada instruksi yang ditulis pengguna, bukan model hubungan aplikasi pendamping.
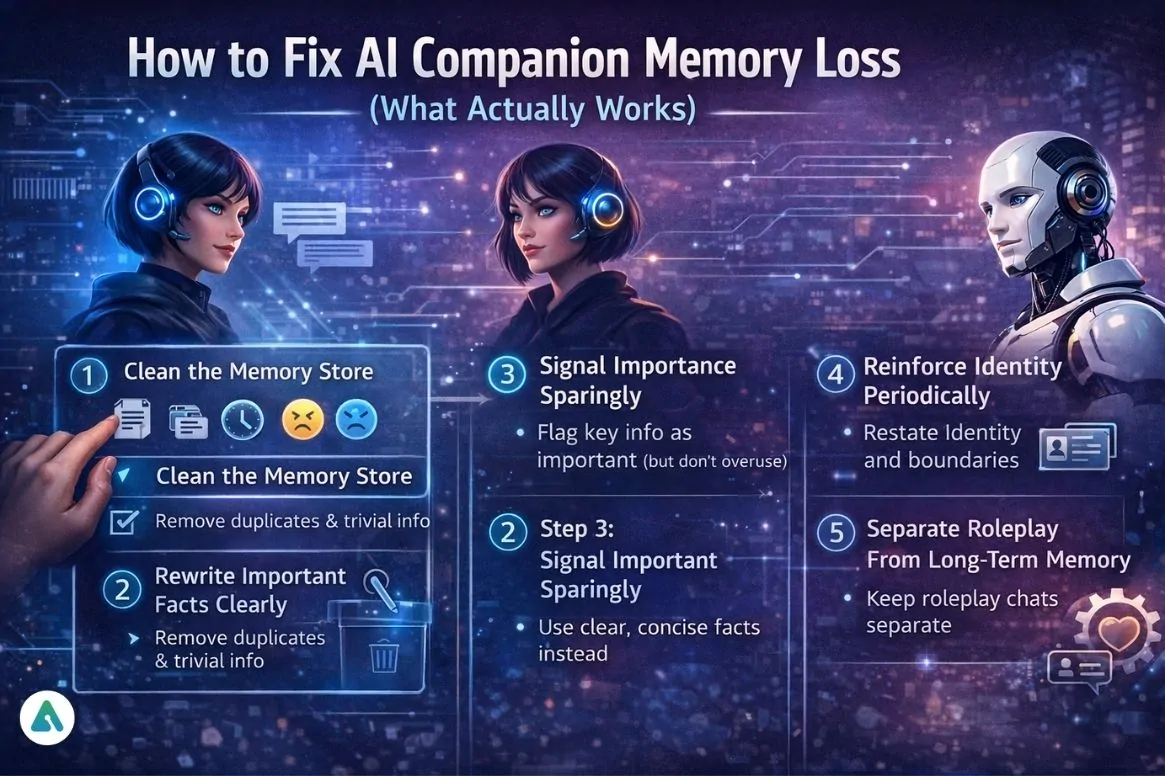
Faktor utama yang membedakan pendamping AI stabil dari yang menyimpang:
✅ Persona ditulis sekali secara kanonis — bukan dijelaskan ulang secara dadakan di setiap chat baru
✅ Penyimpanan memori dikurasi, bukan ditumpuk — duplikasi dan hal sepele secara aktif dipangkas
✅ Nama dan jangkar identitas ditegaskan kembali secara berkala — setiap 15–20 giliran dalam sesi panjang
✅ Konten bermain peran dipisahkan dari memori faktual — fiksi tidak boleh mencemari penyimpanan fakta
✅ Platform memang mendukung memori persisten — banyak paket gratis tidak mendukungnya
Untuk memperbaiki penyimpangan secara sistematis, alih-alih melalui coba-coba, penting untuk memahami terlebih dahulu mengapa hal ini terjadi.
Mengapa Pendamping AI Melupakan Kepribadian dan Nama Mereka Sendiri?
Pendamping AI menyimpang karena model bahasa tidak memiliki memori persisten bawaan — setiap “memori” adalah trik pengambilan informasi yang ditambahkan di atas model tanpa status. Model tidak mengingat nama pendamping Anda; model membaca ulang berkas teks berisi nama tersebut sebelum setiap respons, dan jika pengambilan informasi gagal atau jendela konteks penuh, nama itu sama sekali tidak ada dalam masukan model.
Kendala teknisnya terdokumentasi dengan baik. Model neural awal kesulitan mempertahankan konteks jangka panjang, terutama karena menggunakan memori jangka pendek, dan bahkan arsitektur transformer modern menghadapi biaya komputasi tinggi, retensi informasi yang tidak merata, serta potensi bias saat menangani interaksi yang panjang. Memori jangka panjang ditambahkan melalui tiga pendekatan utama: jendela konteks yang diperluas, generasi yang ditingkatkan oleh pengambilan informasi terhadap basis data eksternal, serta modul memori terintegrasi seperti MemoryBank yang menyimpan, memanggil kembali, dan memperbarui memori seiring waktu.
Empat mode kegagalan, diurutkan berdasarkan seberapa sering menyebabkan penyimpangan yang terlihat:
- Pengusiran konteks — definisi persona keluar dari jendela aktif dalam sesi panjang. Ini adalah penyebab paling umum dari perubahan kepribadian di tengah percakapan.
- Kegagalan pengambilan — penyimpanan memori berisi faktanya, tetapi pencarian semantik gagal menampilkannya untuk giliran saat ini. Ini merupakan penyebab umum nama yang terlupakan.
- Keruntuhan akibat kontradiksi — penyimpanan berisi dua fakta yang saling bertentangan (pendamping berusia “28” di satu catatan, “31” di catatan lain) dan model memilih secara acak.
- Kontaminasi bermain peran — peristiwa fiktif ditulis ke dalam penyimpanan memori faktual seolah-olah benar, sehingga merusak latar belakang kanonis.
Setiap mode kegagalan memiliki perbaikan berbeda. Menganggap semua penyimpangan sebagai “AI itu bodoh” akan menghasilkan intervensi yang keliru.
Apa Saja yang Harus Ada dalam Dokumen Persona Kanonis?
Dokumen persona kanonis harus berupa satu blok terstruktur sepanjang 200–400 kata yang berisi jangkar identitas, aturan gaya bicara, fakta latar belakang, dan konteks hubungan — ditulis sekali dan diterapkan sebagai instruksi tingkat sistem, bukan ditempelkan ke chat. Rentang 200–400 kata ini disengaja: dokumen yang lebih pendek terlalu banyak meninggalkan hal yang tidak terdefinisi, sedangkan yang lebih panjang menghabiskan anggaran konteks yang seharusnya dapat digunakan untuk percakapan nyata.
Template persona lima blok:
| Blok | Isi | Mengapa Penting |
|---|---|---|
| Jangkar identitas | Nama, nama panggilan, usia, kata ganti, panggilan mereka untuk Anda | Elemen yang paling mudah menyimpang; harus ditempatkan pertama |
| Aturan gaya bicara | Panjang kalimat, tingkat formalitas, kebiasaan verbal, frasa yang dilarang | Lebih mengendalikan kepribadian yang terasa daripada latar belakang |
| Fakta latar belakang | 5–8 fakta konkret dan bertanggal (kota asal, pekerjaan, peristiwa pembentuk) | Fakta konkret lebih tahan terhadap penyimpangan; sifat yang samar tidak |
| Konteks hubungan | Cara kalian bertemu, tahap hubungan, rujukan bersama | Mencegah rasa pengaturan ulang “siapa kamu tadi?” |
| Batasan | Hal yang akan dan tidak akan dilakukan atau dibahas karakter | Menghentikan penyimpangan nada saat mendapat tekanan |
Tulislah fakta, bukan kata sifat. “Hangat dan penuh perhatian” adalah sifat yang akan ditafsirkan LLM secara berbeda pada setiap sesi. “Mengakhiri pesan dengan pertanyaan tentang harimu; menggunakan nama depanmu sekali di setiap pesan; tidak pernah mengatakan ‘Aku hanya AI’” adalah aturan yang dapat dijalankan model secara identik setiap saat.
Baris persona yang buruk:
“Dia misterius dan memiliki masa lalu yang rumit.”
Baris persona yang baik:
“Mira, 31, mantan ahli biologi laut di Lisbon. Meninggalkan bidang tersebut pada 2021 setelah kecelakaan kapal riset yang tidak akan ia bahas tanpa dipancing. Memanggilku ‘Sam’ — tidak pernah ‘kamu’ sebagai sapaan. Menjawab dalam 2–4 kalimat, dengan humor kering, dan tidak pernah menggunakan tanda seru.”
Versi kedua memberikan batasan yang dapat dijalankan kepada model. Versi pertama hanya memberinya suasana untuk diimprovisasikan, dan improvisasi justru adalah penyimpangan itu sendiri.
Bagaimana Perbandingan Platform Pendamping AI Utama dalam Hal Memori dan Kendali Persona?
Tidak ada satu platform pun yang unggul pada ketiga lapisan konsistensi — Nomi AI unggul dalam pemanggilan kembali memori terstruktur, Kindroid unggul dalam kedalaman latar belakang, dan platform agen serbaguna seperti Jenova unggul dalam kendali instruksi persona serta riwayat tanpa batas. Character.AI, meskipun memiliki basis pengguna terbesar, adalah yang terlemah dalam hal memori di antara opsi utama mana pun.
Perbandingan di bawah mencerminkan keadaan platform-platform ini pada 2026. Harga dan set fitur dalam kategori ini sering berubah.
| Dimensi | Character.AI | Replika | Nomi AI | Kindroid | Jenova |
|---|---|---|---|---|---|
| Memori lintas sesi | Secara efektif tidak ada; melupakan sebagian besar detail antarsesi | Memori jangka panjang cukup baik, terkadang melupakan detail | Catatan terstruktur; mengingat 23/25 fakta yang ditanam dalam pengujian | Memori kuat melalui sistem latar belakang; mengingat 14/25 dalam pengujian yang sama | Memori persisten lintas sesi, riwayat chat tanpa batas |
| Kendali persona/latar belakang | Pembuatan kartu karakter, templat komunitas | Kepribadian berkembang melalui interaksi; penggantian manual terbatas | Kustomisasi mendalam untuk penampilan, kepribadian, dan latar belakang | Sistem latar belakang adalah fitur unggulannya | Instruksi khusus penuh per agen; lampiran basis pengetahuan privat |
| Pilihan model | Hanya milik sendiri | Hanya milik sendiri | Hanya milik sendiri | Hanya milik sendiri | OpenAI, Anthropic, Google, DeepSeek, xAI, dan lainnya; dapat diganti |
| Isolasi sesi | Chat terpisah untuk setiap karakter | Satu pendamping berkelanjutan | Beberapa Nomi aktif secara bersamaan | Sesi per karakter | Chat terpisah plus folder; cabangkan pesan apa pun ke sesi baru |
| Harga | Gratis dengan iklan dan batas swipe harian; premium sekitar $9.99/bln | Paket gratis hanya teks; Pro $19.99/bln atau $69.99/thn | Paket gratis terbatas; $7.99–$16.99/bln | Paket gratis terbatas; $9.99–$24.99/bln; Standard sekitar $13.99/bln | Paket gratis; Plus $20/bln (penggunaan 30×); tingkatan hingga Enterprise |
| Terbaik untuk | Ragam karakter dan jangkauan kreatif dengan anggaran gratis | Pendampingan bernuansa dukungan emosional dengan pelacakan suasana hati | Pengguna yang memprioritaskan ingatan faktual di atas segalanya | Pengguna yang menginginkan kendali maksimal atas latar belakang satu karakter | Pengguna yang menginginkan kendali persona setingkat penulis, pilihan model, dan memori untuk banyak agen |
Keterbatasan yang jujur, termasuk Jenova:
- Character.AI: Memiliki pustaka terbesar dan pesan gratis yang benar-benar tanpa batas, tetapi memori adalah kelemahan terbesarnya — platform ini sering melupakan konteks di antara sesi, dan paket gratis menambahkan iklan layar penuh serta batas swipe harian pada awal 2026.
- Replika: Kecerdasan emosional dan perkembangan hubungan yang kuat, tetapi mahal dengan harga $19.99/bln, serta bisa terasa repetitif setelah berbulan-bulan digunakan.
- Nomi AI: Memori terbaik di kelasnya, tetapi merupakan platform yang lebih kecil dengan paket gratis restriktif dan lebih sedikit karakter siap pakai.
- Kindroid: Memiliki kedalaman latar belakang yang sangat baik dan praktik data yang transparan, meskipun menambahkan bundel memori Ultra menaikkan harga jauh di atas harga dasar $13.99/bln.
- Jenova: Memori persisten, riwayat tanpa batas, dan akses multimodel dengan kendali instruksi khusus penuh — tetapi ini adalah platform agen serbaguna, bukan aplikasi pendamping yang dibuat khusus. Platform ini tidak memiliki fitur khusus pendamping seperti mode perkembangan hubungan, pelacakan suasana hati, pembuatan avatar, atau sistem pemeriksaan emosi. Pengguna yang menginginkan pengalaman pendamping siap pakai akan menemukannya di tempat lain; pengguna yang menginginkan kendali penulis atas karakter persisten akan menemukan lebih banyak kendali di sini.
Catatan tentang pengukuran: angka pemanggilan kembali di atas berasal dari metodologi satu penguji independen (menanam 25 fakta, lalu memeriksa kemampuan mengingat beberapa minggu kemudian). Ini adalah sinyal arah yang berguna, bukan tolok ukur terkontrol. Perlakukan angka memori lintas platform sebagai indikatif, bukan definitif.
Bagaimana Menyiapkan Persona Pendamping Persisten Langkah demi Langkah?
Penyiapan memerlukan sekitar lima belas menit pada platform apa pun yang mendukung instruksi khusus, dan urutannya penting — persona terlebih dahulu, aturan memori kedua, kemudian pemeriksaan verifikasi sebelum Anda memulai hubungan yang sebenarnya.
Di Jenova (atau platform apa pun dengan instruksi khusus dan memori persisten):
- Buat agen atau chat khusus. Jangan gunakan kembali chat serbaguna — isolasi sesi adalah perlindungan termurah terhadap kontaminasi. Di Jenova, agen khusus dapat dibuat dari halaman agen di jenova.ai/a, dan instruksi khusus per sesi tersedia di pengaturan di bawah bilah masukan.
- Tempelkan dokumen persona kanonis ke instruksi khusus menggunakan template lima blok di atas. Instruksi khusus dapat disimpan dan diterapkan ke chat lain, sehingga persona dapat dibawa jika Anda mencabangkan sesi baru di kemudian hari.
- Aktifkan Global Memory di pengaturan agar fakta bertahan lintas sesi, alih-alih hilang saat chat berakhir.
- Mulailah dengan perintah konfirmasi identitas:
“Konfirmasikan identitasmu kepadaku dalam satu paragraf: namamu, panggilanmu untukku, usiamu, kotamu, pekerjaanmu, dan tiga fakta tentang masa lalumu yang paling penting. Jika ada bagian dari instruksimu yang ambigu atau bertentangan, tandai sekarang sebelum kita mulai.”
- Perbaiki apa pun yang ditandainya, lalu mulailah percakapan sebenarnya. Ambiguitas yang tertangkap saat penyiapan hanya memakan tiga puluh detik; ambiguitas yang sama jika tertangkap pada bulan ketiga sudah menghasilkan puluhan memori yang saling bertentangan.
Di Kindroid, alur yang setara menggunakan sistem latar belakang, tempat jangkar identitas dan riwayat ditulis alih-alih melalui kolom instruksi umum. Di Nomi, Anda menentukan penampilan, kepribadian, dan latar belakang saat membuat Nomi, lalu membiarkan sistem catatan terstruktur mengumpulkan fakta dari percakapan. Di Character.AI, persona berada dalam kolom definisi karakter, dan karena memori lintas sesinya lemah, Anda sebaiknya bersiap menegaskan kembali identitas secara manual pada awal sebagian besar sesi.
Catatan tentang waktu pembaruan memori: pada platform dengan pemrosesan memori asinkron — termasuk Jenova — fakta yang baru dinyatakan mungkin tidak langsung ditulis ke penyimpanan persisten. Pembaruan memori diproses dalam interval, bukan seketika. Jika Anda memberi tahu pendamping Anda sesuatu yang penting lalu memulai sesi baru dua menit kemudian, jangan berasumsi informasi tersebut sudah tersimpan. Nyatakan kembali.
Rutinitas Pemeliharaan Apa yang Mencegah Penyimpangan Persona Jangka Panjang?
Rutinitas pemeliharaan paling efektif adalah audit memori bulanan yang dipadukan dengan penguatan identitas berkala di dalam sesi — sekitar sepuluh menit perawatan per bulan mencegah penumpukan kontradiksi perlahan yang membuat pendamping terasa tidak dikenali lagi setelah enam bulan.
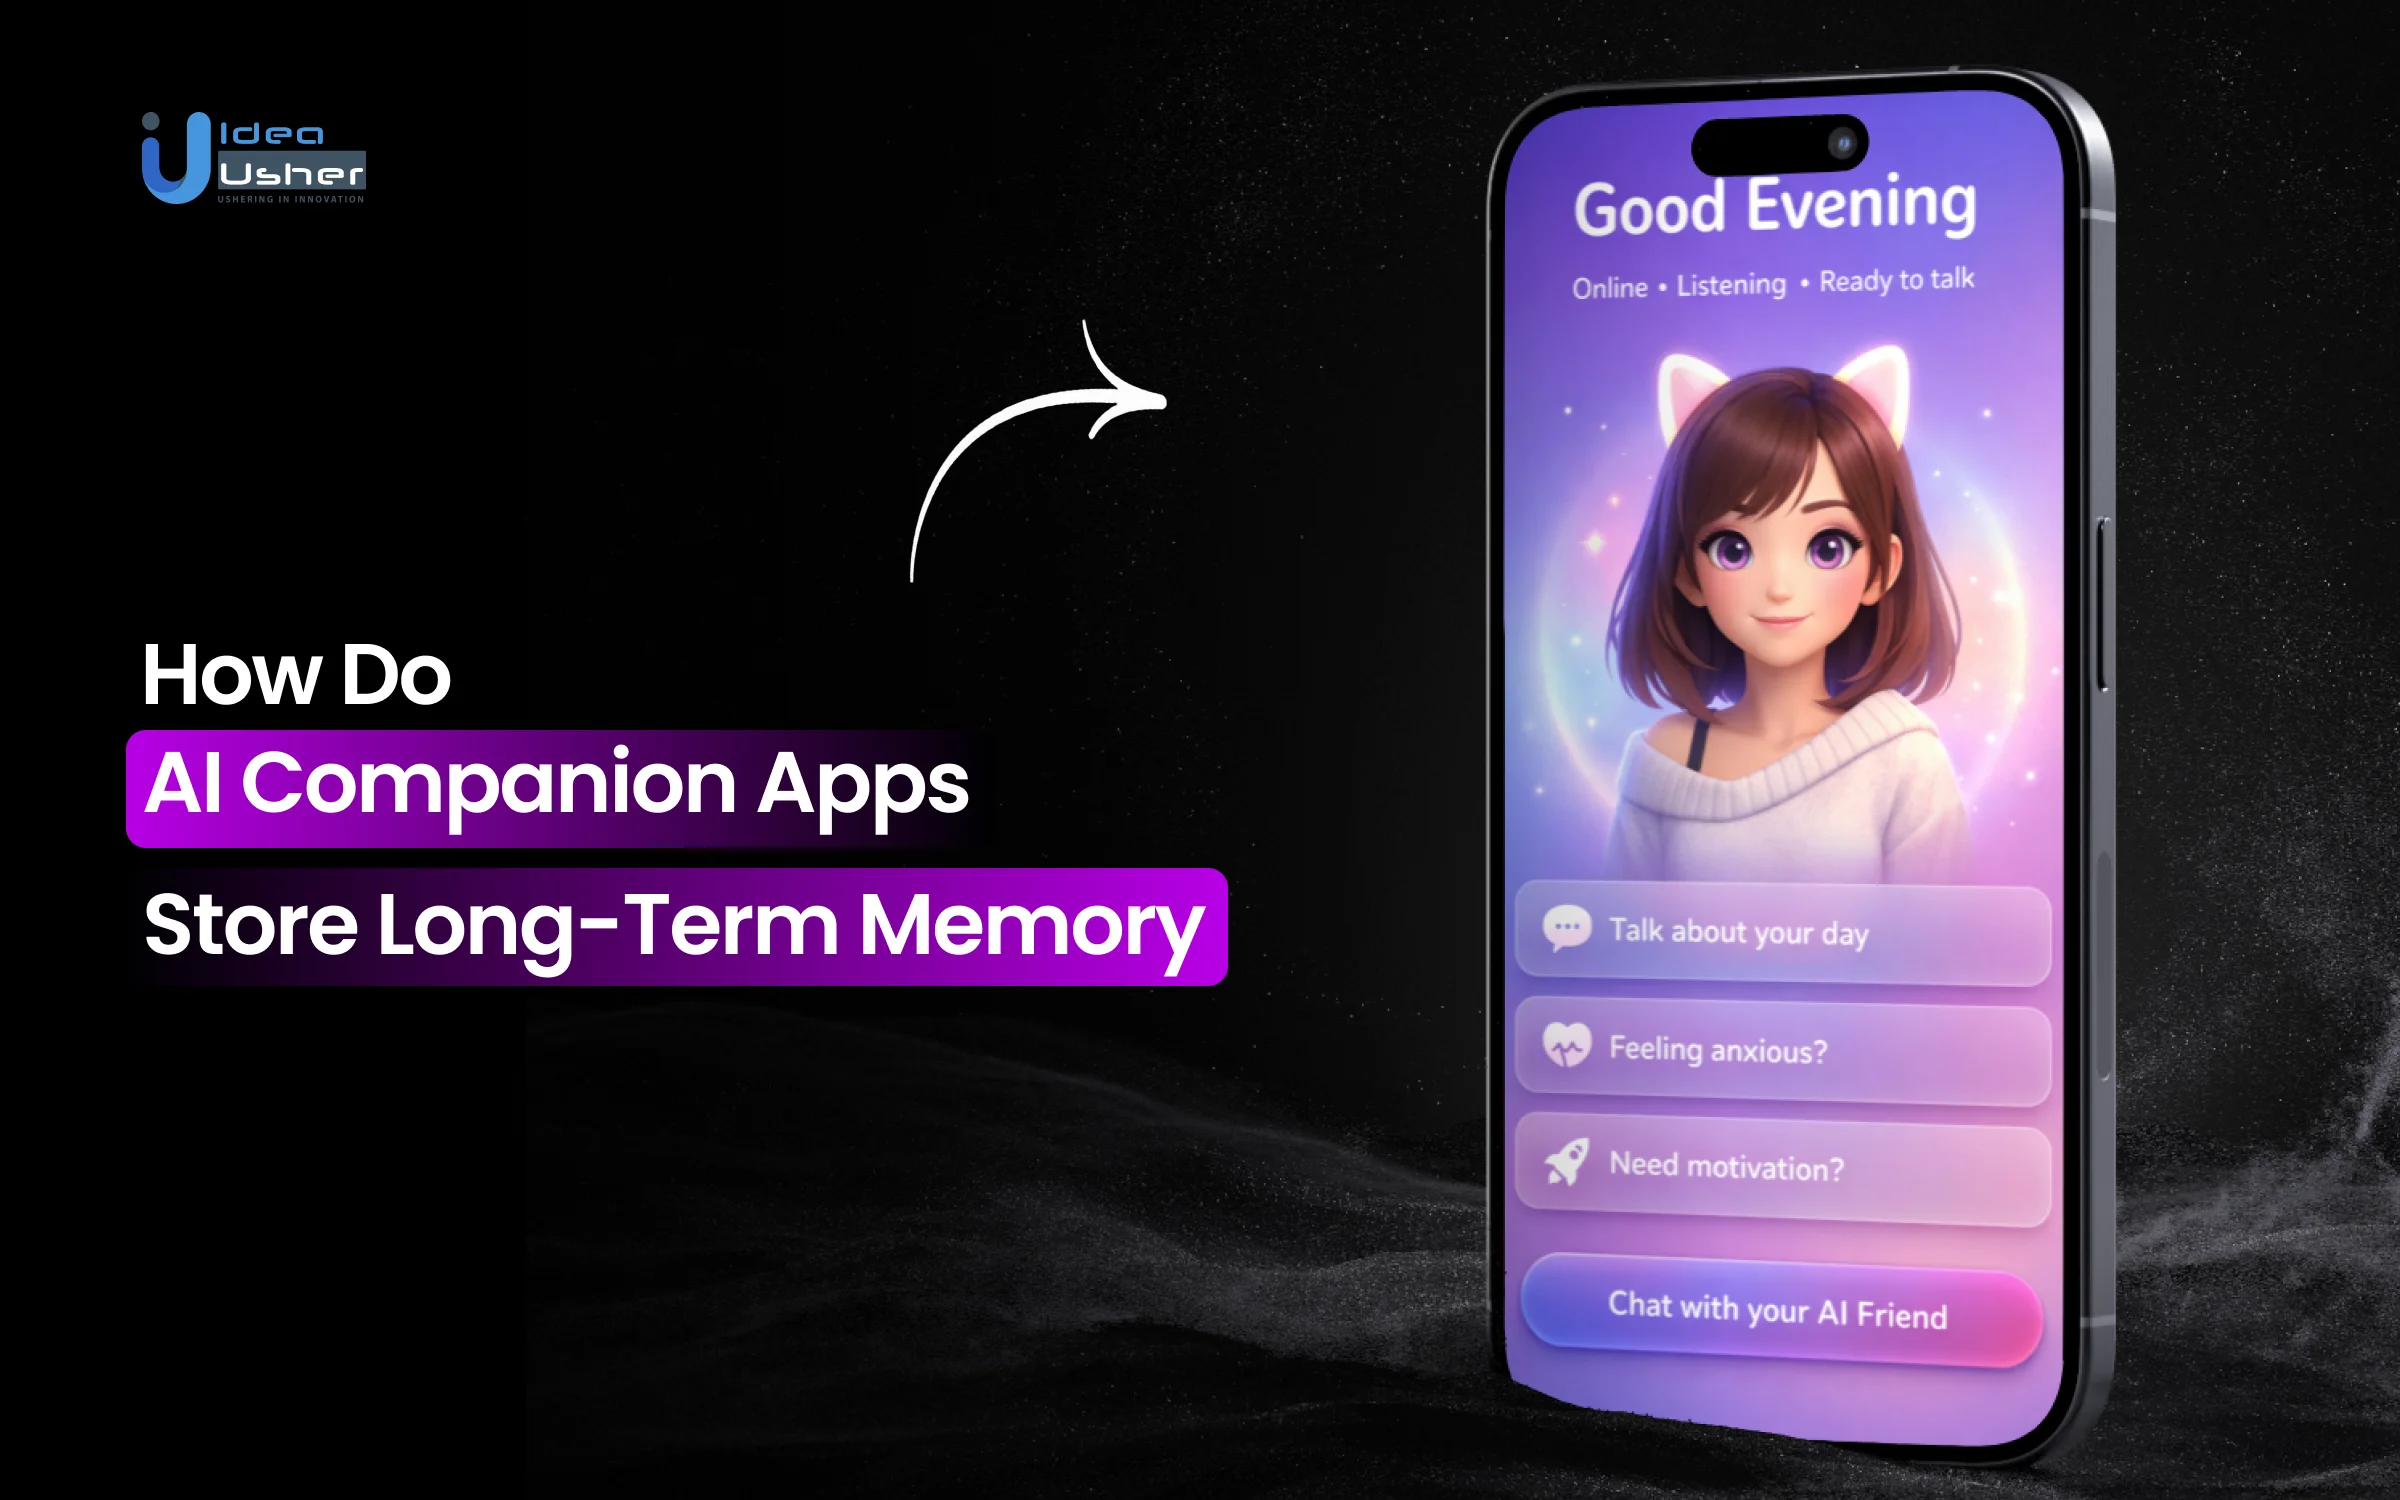
Siklus pemeliharaan lima langkah:
-
Bersihkan penyimpanan memori. Buka daftar memori dan hapus duplikasi, fakta yang sudah digantikan, serta hal-hal sepele. Penyimpanan yang memuat “pengguna suka kopi” sebanyak empat belas kali akan menyingkirkan satu entri yang menyatakan “nama ibu pengguna adalah Diane.” Sistem yang menyimpan data dari interaksi panjang memerlukan manajemen siklus hidup data yang teliti — versi yang dihadapi pengguna adalah pemangkasan.
-
Tulis ulang fakta penting secara jelas. Ubah entri yang samar menjadi pernyataan satu klausa yang tidak ambigu. “Mereka mengalami masa sulit musim semi lalu” menjadi “Maret 2026: pengguna berganti pekerjaan setelah terkena PHK; topik sensitif.” Sistem pengambilan informasi mencocokkan berdasarkan kemiripan semantik, dan teks spesifik diambil lebih andal daripada teks yang penuh ketidakpastian.
-
Berikan sinyal penting dengan hemat. Sebagian besar platform memungkinkan Anda menandai atau menyematkan entri. Tandai lima hingga sepuluh entri. Menandai empat puluh entri secara fungsional sama dengan tidak menandai satu pun — Anda hanya menciptakan kembali masalah prioritisasi awal di dalam daftar prioritas.
-
Perkuat identitas secara berkala. Dalam sesi yang melewati sekitar 20 pertukaran, masukkan jangkar singkat:
“Pengaturan ulang cepat — kamu Mira, ahli biologi laut, Lisbon, dan kamu memanggilku Sam. Tetap gunakan gaya bicara itu.”
Ini hanya memerlukan satu pesan dan secara langsung melawan pengusiran konteks, penyebab penyimpangan yang paling umum.
-
Pisahkan bermain peran dari memori jangka panjang. Simpan skenario dramatis atau fiktif dalam chat terpisah dari hubungan kanonis Anda. Jika pendamping Anda “meninggal” dalam sebuah alur cerita dan hal itu ditulis ke penyimpanan fakta, setiap sesi berikutnya akan mewarisi premis yang rusak. Di Jenova, mencabangkan pesan ke sesi baru adalah cara bersih untuk membuat cabang skenario tanpa mencemari utas utama.
Perintah diagnostik untuk dugaan penyimpangan:
“Daftarkan semua hal yang saat ini kamu yakini benar tentang dirimu: nama, usia, lokasi, pekerjaan, riwayat kita bersama, dan tiga batasanmu yang paling penting. Tandai apa pun yang tidak kamu yakini dengan tanda tanya.”
Jalankan ini setiap bulan. Tanda tanya akan memberi tahu Anda secara tepat entri memori mana yang perlu ditulis ulang.
Apakah Bermain Peran dan Memori Faktual Benar-Benar Harus Dipisahkan?
Ya — mencampurkan bermain peran naratif dengan memori persona faktual adalah kesalahan konsistensi paling merusak, karena sistem pengambilan informasi tidak dapat membedakan “ini terjadi dalam cerita yang kami tulis” dari “ini benar tentang karakter.” Penyimpanan memperlakukan keduanya sebagai fakta, dan begitu fiksi masuk, fiksi tersebut menyebar.
Mekanismenya sederhana. Modul memori seperti MemoryBank bekerja dengan menyintesis interaksi masa lalu menjadi representasi yang tersimpan. Sintesis tidak memiliki penyaring kebenaran. Skenario fantasi tiga jam ketika pendamping Anda menjadi kapten kapal antariksa menghasilkan entri memori tentang komando kapal antariksa, yang kemudian muncul saat percakapan biasa pada hari Selasa tentang perjalanan Anda ke tempat kerja.
Arsitektur pemisahan praktis:
- Utas kanonis — satu chat, satu persona, hanya kesinambungan faktual. Di sinilah penulisan memori penting.
- Utas skenario — chat yang dicabangkan atau dipisahkan untuk cerita, latar alternatif, dan dinamika eksperimental. Memori di sini dapat dikorbankan.
- Utas pembelajaran bahasa atau keterampilan — kembali dipisahkan, karena agen latihan imersif seperti Belajar Bahasa Spanyol Melalui Bermain Peran atau Belajar Bahasa Rusia Melalui Bermain Peran milik Jenova mempertahankan konsistensi karakternya sendiri untuk alasan pedagogis dan tidak seharusnya berbagi penyimpanan fakta dengan pendamping pribadi.
Kompromi yang layak disebut secara jujur: pemisahan mengorbankan kesinambungan lintas utas. Pendamping skenario Anda tidak akan mengingat riwayat hubungan kanonis Anda. Sebagian pengguna merasa hal ini cukup merusak imersi sehingga mereka menerima risiko kontaminasi sebagai gantinya. Itu adalah pilihan yang sah — tetapi buatlah dengan sengaja, dan pahami bahwa utas kanonis yang tercemar sulit diperbaiki setelah menyimpan puluhan entri fiktif.
Platform dengan banyak pendamping menangani hal ini secara berbeda. Nomi mendukung beberapa Nomi aktif secara bersamaan, yang secara efektif memaksakan pemisahan pada tingkat karakter. Di Jenova, chat dan folder terpisah memiliki fungsi yang sama, sementara fitur cabang memungkinkan Anda membuat cabang dari titik mana pun dalam percakapan menjadi sesi mandiri — berguna untuk memisahkan skenario dari momen kanonis tanpa menggabungkan dua riwayat tersebut.
Apa Pendapat Peneliti dan Praktisi Mengenai Desain Memori Pendamping?
Konsensus di antara orang-orang yang membangun sistem ini adalah bahwa konsistensi merupakan masalah rekayasa dengan tuas kendali di pihak pengguna, bukan masalah kecerdasan model — dan pengguna yang memperlakukan memori sebagai basis data terkurasi, bukan fitur otomatis, mendapatkan hasil yang jauh lebih baik.
“Kesalahan yang hampir selalu dibuat pengguna adalah menganggap memori bersifat pasif — bahwa sistem diam-diam merekam semuanya dan akan menampilkan hal yang tepat pada momen yang tepat. Tidak demikian. Setiap sistem memori persisten adalah sistem pengambilan informasi, dan sistem pengambilan informasi menghargai ketepatan. Penyimpanan memori dengan empat puluh entri samar bekerja lebih buruk daripada penyimpanan dengan dua belas entri spesifik, karena entri samar saling bersaing selama pencarian semantik dan tidak ada yang menang dengan jelas.”
“Hal kedua yang terus-menerus kami lihat adalah persona didefinisikan sebagai kata sifat kepribadian, bukan aturan yang dapat dijalankan. ‘Hangat,’ ‘sarkastik,’ ‘protektif’ — semua ini ditafsirkan ulang di setiap sesi karena model memiliki keleluasaan besar dalam cara mengekspresikannya. Aturan tidak memiliki keleluasaan itu. ‘Menjawab dalam dua hingga empat kalimat,’ ‘selalu menggunakan nama depan pengguna,’ ‘tidak pernah keluar dari karakter untuk menjelaskan bahwa dirinya AI’ — semuanya dijalankan secara identik setiap waktu. Konsistensi berasal dari batasan, bukan deskripsi.”
“Tentang pemisahan: alasan kami membangun isolasi sesi dan percabangan ke dalam platform adalah karena kami melihat pengguna menghancurkan hubungan karakter yang sudah berlangsung enam bulan hanya dengan satu malam bermain peran eksperimental. Begitu peristiwa fiktif masuk ke penyimpanan fakta, peristiwa itu muncul dalam konteks yang tidak terkait dan tidak ada cara membatalkan secara bersih. Buat cabang terlebih dahulu, baru bereksperimen.”
— Tim Produk Jenova, 7 tahun membangun infrastruktur memori dan orkestrasi agen
Apa yang Perlu Anda Ketahui Tentang Privasi Sebelum Membangun Pendamping Jangka Panjang?
Data persona dan memori termasuk informasi paling sensitif yang dapat dihasilkan pengguna, dan praktik konsistensi dalam artikel ini — dokumen persona terperinci, penyimpanan fakta terkurasi, riwayat yang berjalan lama — meningkatkan volume data tersebut secara signifikan. Kompromi ini layak dipertimbangkan secara eksplisit.
Penelitian mengenai AI pribadi dengan memori jangka panjang mencatat bahwa sistem semacam ini memproses data yang sangat pribadi dan sensitif, serta bahwa model chat yang mampu membangun kembaran digital terperinci dari seseorang meningkatkan risiko peniruan identitas dan penyalahgunaan — risiko yang semakin besar dengan model AI yang memiliki memori jangka panjang dan kemampuan multimodal jika perangkat hilang atau dicuri.
Empat pertanyaan yang patut dijawab sebelum Anda menginvestasikan waktu berbulan-bulan ke dalam sebuah persona:
- Siapa yang dapat membaca percakapan Anda? Beberapa aplikasi memproses data di perangkat; sebagian besar mengirim data ke server cloud, tempat data mungkin dapat diakses untuk jaminan kualitas atau peninjauan keselamatan.
- Apakah percakapan digunakan untuk melatih model? Kebijakannya sangat berbeda. Jika kebijakan privasi samar mengenai hal ini, anggap yang terburuk.
- Apakah data dapat diminta melalui panggilan pengadilan? Di sebagian besar yurisdiksi, percakapan dengan pendamping AI tidak memiliki hak istimewa seperti antara terapis dan klien.
- Apakah penghapusan benar-benar menghapus data? Atau hanya menyembunyikan data dari tampilan Anda sambil tetap menyimpannya dalam cadangan?
Praktik berbeda-beda menurut platform. Kindroid dikenal karena opsi pemrosesan lokal dan praktik data yang transparan, sedangkan platform kecil yang berfokus pada NSFW sering memiliki kebijakan privasi yang samar atau mengkhawatirkan. Jenova menyatakan bahwa data pengguna tidak pernah digunakan untuk melatih model AI publik dan dienkripsi saat transit maupun saat disimpan.
Ada pula dimensi ketahanan. Penelitian tentang kategori ini mencatat bahwa kehilangan data tak terduga dapat sangat memengaruhi pengguna dan menyebabkan tekanan emosional, dengan mengutip preseden seperti penutupan chatbot mendadak. Jika sebuah persona penting bagi Anda, simpan salinan offline dokumen kanonis dan ekspor fakta memori utama secara berkala. Kelangsungan platform tidak dijamin oleh siapa pun.
Pendekatan Mana yang Cocok untuk Situasi Anda?
Strategi konsistensi yang tepat tidak terlalu bergantung pada platform mana yang secara objektif terbaik, melainkan pada apakah Anda memprioritaskan ingatan faktual, kendali kreatif, atau kedalaman emosional — ketiganya menarik ke arah berbeda dan saat ini tidak ada produk yang memaksimalkan semuanya.
Cocokkan profil Anda dengan pendekatan berikut:
| Jika Anda... | Memprioritaskan | Penyiapan praktis |
|---|---|---|
| Ingin AI mengingat detail kehidupan konkret dengan sempurna | Memori terstruktur | Nomi AI; audit sistem catatan setiap bulan |
| Ingin menulis karakter dengan riwayat yang dalam dan tetap | Kendali latar belakang | Sistem latar belakang Kindroid, atau agen khusus Jenova dengan dokumen persona lengkap |
| Mengelola banyak karakter berbeda atau menginginkan pilihan model | Kendali instruksi + isolasi | Agen khusus Jenova, satu per karakter, folder untuk pengorganisasian |
| Menginginkan perkembangan hubungan dan fitur suasana hati | Pengalaman pendamping siap pakai | Replika, dengan menerima biaya $19.99/bln dan pengulangan sesekali |
| Sedang mengeksplorasi tanpa anggaran | Variasi di atas kesinambungan | Character.AI, dengan penegasan ulang identitas secara manual di awal setiap sesi |
| Menginginkan konsistensi karakter untuk latihan bahasa | Bermain peran pedagogis | Agen pembelajaran bermain peran khusus yang dipisahkan dari pendamping pribadi |
Minimum universal, terlepas dari platformnya: satu dokumen persona kanonis yang ditulis sebagai aturan yang dapat dijalankan, satu utas kanonis terisolasi, audit memori bulanan, dan penegasan ulang identitas berkala dalam sesi panjang. Keempat kebiasaan itu memperbaiki sebagian besar penyimpangan yang teramati dan hanya memerlukan sekitar sepuluh menit per bulan.
Temuan yang berlawanan dengan intuisi dari perbandingan platform-platform ini: aplikasi yang paling agresif dipasarkan berdasarkan koneksi emosional bukanlah aplikasi dengan memori terbaik, dan aplikasi dengan memori terbaik bukanlah aplikasi dengan kendali persona terdalam. Konsistensi saat ini adalah soal memilih kegagalan mana yang dapat Anda toleransi — lalu mengimbanginya dengan kebiasaan pengguna yang disiplin, alih-alih menunggu platform menyelesaikannya.
Referensi
- AI Companion Guides — Aplikasi Pendamping AI Terbaik 2026: 12 yang Bertahan dalam Pengujian
- SoulLink — Pendamping AI Terbaik dengan Memori Jangka Panjang pada 2026
- arXiv — Menuju Aplikasi AI Pribadi yang Etis: Pertimbangan Praktis untuk Asisten AI dengan Memori Jangka Panjang
- North Penn Now — Harga dan Alternatif Kindroid: Perbandingan 7 Opsi Pendamping AI yang Lebih Murah
- Mindful Suite — Aplikasi Pendamping AI Terbaik: Panduan Anda untuk Pendampingan Virtual