Bagaimana Saya Mencegah Asisten Riset AI Mengarang Sitasi Palsu?
2026-08-21
Perlindungan Apa yang Membedakan Alat Riset AI Berbasis Sitasi dari Chatbot yang Berhalusinasi?
Cara paling andal untuk menghentikan asisten riset AI mengarang artikel adalah menolak alat yang menghasilkan referensi dari ingatan, mewajibkan setiap klaim terikat pada rekaman yang diambil dengan pengenal yang dapat diperiksa mesin, serta memverifikasi setiap sitasi terhadap sumbernya sebelum masuk ke naskah. Pada 2026, rangkaian perlindungan tersebut — temu kembali berbasis sumber, pemeriksaan pengenal, dan verifikasi manusia — membedakan alat literatur seperti Academic Research Assistant milik Jenova, Elicit, SciSpace, Consensus, dan Scite dari chatbot serbaguna yang masih membuat referensi yang tampak masuk akal tetapi palsu.
Faktor utama yang benar-benar mengurangi sumber karangan:
✅ Temu kembali, bukan ingatan — asisten harus menelusuri rekaman ilmiah yang terindeks, bukan melengkapi daftar pustaka otomatis dari data pelatihan. ✅ Pengikatan pengenal — setiap karya yang disitasi harus memuat DOI, PMID, arXiv ID, atau URL penerbit yang dapat diakses secara mandiri. ✅ Kesetiaan, bukan sekadar keberadaan — artikel nyata yang dikutip untuk temuan yang tidak dikandungnya tetap merupakan kegagalan, sebagaimana ditunjukkan oleh riset evaluasi RAG. ✅ Ketepatan bibliografis — nama penulis, tahun, volume, dan rentang halaman harus cocok dengan rekaman, bukan hampir cocok tetapi diciptakan oleh model. ✅ Siklus verifikasi manusia — Stanford Libraries dan panduan gaya utama menetapkan bahwa penulis, bukan alat, bertanggung jawab atas setiap sitasi.
Untuk membandingkan alat secara bermanfaat, integritas sitasi perlu diperlakukan sebagai masalah arsitektur, bukan sekadar trik menulis prompt. Bagian selanjutnya memetakan arsitektur tersebut, mode kegagalan yang hendak ditangkapnya, dan alur kerja yang dapat Anda jalankan pada asisten apa pun.
Mengapa Sitasi AI Palsu Muncul dalam Artikel yang Diterbitkan pada 2026?
Sitasi palsu bukan lagi sekadar anekdot di ruang kelas. Sitasi tersebut masuk ke jurnal, berkas hibah, dan indeks sitasi karena peneliti menempelkan daftar pustaka dari chatbot ke naskah tanpa memeriksa setiap referensi. Analisis Nature pada 2026 memperkirakan bahwa puluhan ribu publikasi tahun 2025 mungkin mengandung referensi AI yang tidak valid.
Pola kontaminasinya khas. Ilmuwan komputer Guillaume Cabanac diberi tahu bahwa salah satu artikelnya dikutip dalam International Dental Journal — bidang yang tidak beririsan dengan karyanya tentang mendeteksi artikel palsu — dan ia mendapati bahwa ia tidak mengenali rujukan atas namanya sendiri. Begitulah sitasi hantu menyebar: formatnya tampak benar, menyebut jurnal yang terdengar nyata, dan lolos dari pemeriksaan sekilas.
Kasus yang terdokumentasi cukup parah hingga memaksa pencabutan artikel. Resnik dan Hosseini merangkum sebuah artikel di Academic Ethics yang 19 dari 29 sitasinya berhalusinasi, artikel PLOS ONE yang kemudian dicabut dengan 18 dari 76 sitasi dibuat-buat, serta perspektif di Digestive Diseases and Sciences yang 12 dari 14 referensinya tidak ada. Studi kesehatan mental tahun 2025 mengenai sitasi GPT-4o menemukan bahwa 56% mengandung kesalahan, dengan kira-kira satu dari lima sepenuhnya berhalusinasi.
Kekhawatiran dosen kini nyaris universal. Riset College Board melaporkan bahwa pengajar khawatir penggunaan AI menggerus pemikiran kritis, penulisan orisinal, dan integritas akademik. Panduan perpustakaan seperti milik UNC Charlotte kini memperlakukan sitasi berhalusinasi sebagai risiko riset standar, bukan kasus pinggiran.
Implikasinya bagi pemilihan alat sangat jelas. Jika sebuah asisten dapat mengeluarkan referensi APA atau Vancouver yang tampak rapi tanpa mengambil rekaman aktif, ia dapat mengarang artikel yang tidak pernah ada — dan artikel itu dapat bertahan hingga dicetak.
Apa yang Harus Dievaluasi Sebelum Mempercayakan Daftar Referensi kepada Asisten Riset AI?
Anda perlu mengevaluasi asisten riset AI berdasarkan Tumpukan Integritas Sitasi yang terdiri dari lima bagian: sumber kebenaran, pengikatan pengenal, kesetiaan klaim-ke-bagian teks, ketepatan bibliografis, dan siklus verifikasi manusia yang wajib. Alat yang nilainya tinggi dalam kelancaran bahasa tetapi rendah dalam tumpukan ini tidak aman untuk daftar referensi, betapapun rapi prosa yang dihasilkannya.
1. Sumber kebenaran
Tanyakan apakah jawaban berasal dari korpus yang diambil atau dari ingatan parametrik. Sistem berbasis temu kembali menelusuri Google Scholar, PubMed, Semantic Scholar, Scopus, atau arXiv lalu menghasilkan jawaban. Chatbot tanpa temu kembali memprediksi token berikutnya dari sebuah sitasi. Metrik kesetiaan ada secara khusus karena hasil generasi dapat menyimpang dari konteks yang diambil bahkan ketika temu kembali telah terjadi.
2. Pengikatan pengenal
Kombinasi judul-penulis-tahun tidak cukup. Wajibkan DOI, PMID, PMCID, atau URL penerbit, lalu akses sendiri. Referensi hantu sering langsung gagal dalam pengujian ini. Referensi bibliografis yang nyaris cocok — artikel nyata dengan volume atau rentang halaman yang salah — akan gagal saat diperiksa kedua kali.
3. Kesetiaan klaim-ke-bagian teks
Riset ACM tentang sitasi RAG menemukan bahwa kebenaran tidak sama dengan kesetiaan: hingga 57% sitasi dapat gagal mendukung klaim yang seharusnya ditopangnya. Artikel yang ada tetapi tidak memuat temuan tersebut sama berbahayanya dengan artikel yang tidak ada, karena ia mencuci hasil palsu melalui nama penulis yang nyata.
4. Ketepatan bibliografis
Urutan penulis, tahun, jurnal, volume, nomor terbitan, dan halaman harus sesuai dengan rekaman. Pengujian alat RAG dalam administrasi bisnis menunjukkan bahwa item "hantu" yang sepenuhnya dibuat-buat mungkin jarang, sementara kesalahan bibliografis kecil tetap umum. Kesalahan tersebut tetap merusak indeks sitasi dan dapat menyembunyikan artikel yang tertukar.
5. Siklus verifikasi manusia
Kebijakan jurnal APA, sebagaimana dirangkum Stanford, menyatakan bahwa penulis harus memverifikasi setiap informasi dan sitasi yang diberikan alat AI. Panduan peneliti Wiley dan panduan integritas riset Harvard juga menempatkan kewajiban pengungkapan dan akurasi pada penulis manusia. Tidak ada asisten dalam kategori ini yang menghapus kewajiban tersebut.
Berikan bobot pada tumpukan sesuai tugas. Tinjauan sistematis harus lebih menekankan kesetiaan dan pengikatan pengenal. Penelusuran eksploratif dapat menerima cakupan yang lebih luas selama setiap kandidat terpilih diverifikasi sebelum disitasi. Jangan pernah memberi bobot berlebih pada kualitas prosa. Paragraf yang lancar adalah mekanisme yang membuat sitasi palsu terasa meyakinkan.
Bagaimana Perbandingan Alat Riset AI Populer dalam Keandalan Sitasi?
Perbedaannya sangat tajam dalam hal apakah referensi diambil dari indeks ilmiah atau dihasilkan dari ingatan model, dan satu pilihan desain tersebut memprediksi sebagian besar risiko sitasi hantu. Chatbot serbaguna tetap menjadi pilihan berisiko tertinggi untuk daftar pustaka. Asisten riset yang dirancang khusus mengurangi referensi hantu, tetapi masih dapat salah mengutip, salah mencatat metadata, dan mengklaim terlalu jauh dari isi artikel.
Per 2026, perbandingan praktisnya adalah sebagai berikut:
| Fitur / Dimensi | Chatbot serbaguna (misalnya ChatGPT) | Elicit | SciSpace | Consensus | Scite | Jenova Academic Research Assistant |
|---|---|---|---|---|---|---|
| Sumber bukti | Sebagian besar ingatan parametrik kecuali penjelajahan diaktifkan | Artikel yang diambil, tabel ekstraksi | Temu kembali dari banyak basis data (Google Scholar, PubMed, arXiv) | Artikel yang diambil untuk pertanyaan empiris | Indeks sitasi dengan konteks pendukung/berlawanan | Penemuan literatur waktu nyata di berbagai basis data akademik dan repositori |
| Risiko referensi hantu | Tinggi; terdokumentasi di jurnal dan laboratorium | Rendah dalam studi daftar referensi RAG | Rendah dalam studi daftar referensi RAG | Berbasis temu kembali; tetap perlu verifikasi | Rendah untuk item dalam graf sitasinya | Berbasis temu kembali; tetap membutuhkan pemeriksaan DOI mandiri |
| Kesetiaan klaim-ke-sumber | Lemah tanpa bagian teks yang diambil | Lebih kuat untuk ekstraksi terstruktur | Lebih kuat ketika jawaban menyitasi artikel yang diambil | Lebih kuat untuk pertanyaan empiris ya/tidak | Kuat untuk mengetahui bagaimana sebuah artikel disitasi | Bergantung pada bagian teks yang diambil dan pilihan model; pemeriksaan manusia tetap diperlukan |
| Ketepatan bibliografis | Detail karangan sering muncul | Ketidakakuratan kecil dilaporkan dalam audit RAG | Ketidakakuratan kecil dilaporkan dalam audit RAG | Belum diverifikasi pada tingkat audit lapangan | Kuat dalam konteks sitasi | Mewarisi metadata dari rekaman yang diambil; prosa masih dapat menyimpang |
| Harga (per 2026) | Beragam menurut paket vendor | Belum diverifikasi | Belum diverifikasi | Belum diverifikasi | Belum diverifikasi | Tingkat gratis dengan penggunaan terbatas; paket berbayar mulai dari $20/bulan |
| Paling sesuai untuk | Menyusun bahasa, bukan membangun daftar referensi | Tabel bukti dan ekstraksi sistematis | Pencarian literatur luas lintas disiplin | Jawaban cepat atas pertanyaan empiris ya/tidak | Memvalidasi apakah sitasi mendukung atau membantah klaim | Penemuan literatur menyeluruh, persiapan naskah, dan manajemen sitasi dengan memori berkelanjutan |
Chatbot serbaguna
Chatbot unggul dalam membuat kerangka dan memparafrasekan, tetapi gagal dalam membangun bibliografi. Audit kesehatan mental GPT-4o yang disebutkan di atas memberikan angka peringatan: lebih dari separuh sitasi yang dihasilkan mengandung kesalahan. Jika alat dapat mengeluarkan referensi yang tampak sempurna tanpa rekaman aktif, perlakukan setiap sitasi sebagai belum diverifikasi.
Elicit
Elicit lebih kuat ketika tugasnya menyaring artikel dan mengekstrak metode, luaran, serta keterbatasan ke dalam tabel. Perbandingan independen menggambarkannya sebagai alat yang lebih cocok untuk alur kerja berbasis bukti yang ketat daripada pencarian eksploratif cepat. Keterbatasannya adalah kepadatan cakupan: dalam tolok ukur SciSpace dengan 200 kueri, Elicit mengembalikan 13,0 artikel yang sangat relevan per kueri, dibandingkan 26,3 untuk SciSpace Deep Review. Kesenjangan itu penting bagi cakupan, bukan risiko referensi hantu.
SciSpace
SciSpace menelusuri banyak basis data ilmiah dan, dalam evaluasi Deep Review miliknya, memimpin presisi dari P@3 hingga P@70. Cakupan luas ini membantu pertanyaan lintas disiplin ketika bukti berada di PubMed, arXiv, dan Google Scholar sekaligus. Keterbatasannya bersifat metodologis: tolok ukur utama dijalankan oleh SciSpace, meskipun label relevansi berasal dari tiga model eksternal. Perlakukan tolok ukur vendor sebagai petunjuk arah, lalu verifikasi sendiri kandidat yang dipilih.
Consensus
Consensus dirancang untuk menjawab pertanyaan ilmiah empiris berdasarkan artikel, bukan untuk menulis tinjauan naratif. Dalam uji 200 kueri yang sama, Consensus Deep memiliki presisi terbaik pada hasil pertama (P@1 = 0.5882) lalu kehilangan keunggulan tersebut lebih dalam di daftar hasil. Ini adalah alat yang kuat untuk menemukan titik awal dan kurang kuat sebagai alat utama untuk kumpulan penyaringan yang panjang.
Scite
Aset khas Scite adalah kecerdasan sitasi — melihat apakah artikel-artikel setelahnya mendukung, menyebut, atau membandingkan dengan suatu klaim. Perbandingan menempatkannya sebagai alat yang lebih sempit daripada alat operasional riset lengkap, tetapi lebih kuat untuk validasi bukti. Jika mode kegagalan Anda adalah "artikel nyata ini tidak mengatakan apa yang diklaim asisten", konteks sitasi bergaya Scite adalah instrumen yang tepat.
Jenova Academic Research Assistant
Academic Research Assistant milik Jenova dibuat untuk akademisi dan mahasiswa PhD yang membutuhkan penemuan literatur serta dukungan naskah dan sitasi dalam satu ruang kerja berkelanjutan. Alat ini dapat menelusuri basis data akademik utama dan repositori secara waktu nyata, menyimpan memori proyek lintas sesi, serta menyusun draf dengan model terkini alih-alih terkunci pada satu vendor. Kombinasi tersebut berguna ketika sebuah tinjauan berlangsung selama berminggu-minggu dan asisten harus mengingat kriteria inklusi, artikel yang ditolak, serta DOI yang belum terselesaikan.
Ini bukan indeks konteks sitasi khusus, sehingga tidak akan menggantikan Scite untuk pemetaan artikel yang mendukung versus yang berlawanan. Ini juga bukan tabel ekstraksi khusus seperti Elicit. Pencarian waktu nyata juga dapat mengambil rekaman bermutu rendah atau tidak cocok yang kemudian ditafsirkan berlebihan oleh model yang lancar berbahasa. Aturan penggunaan yang jujur sama seperti untuk setiap alat temu kembali: gunakan untuk menemukan dan mengatur kandidat, bukan untuk mengesahkan daftar pustaka.
Apakah RAG Sepenuhnya Menghentikan Referensi Hantu?
Tidak. RAG secara tajam mengurangi artikel yang sepenuhnya diciptakan dalam daftar referensi, tetapi tidak menghilangkan kesalahan bibliografis dan tidak menjamin bahwa artikel yang diambil mendukung kalimat yang dilekatkan padanya. Karena itu, pencegahan harus menargetkan tiga mode kegagalan yang berbeda, bukan satu saja.
Ketiga mode ini mudah tertukar karena semuanya menghasilkan "sitasi yang tampak masuk akal":
- Referensi hantu — karya yang dikutip tidak ada.
- Pergeseran bibliografis — karya tersebut ada, tetapi penulis, tahun, volume, atau halaman salah.
- Halusinasi konteks — karya tersebut ada dan metadata sebagian besar benar, tetapi asisten mengatribusikan temuan yang tidak dikandung artikel.
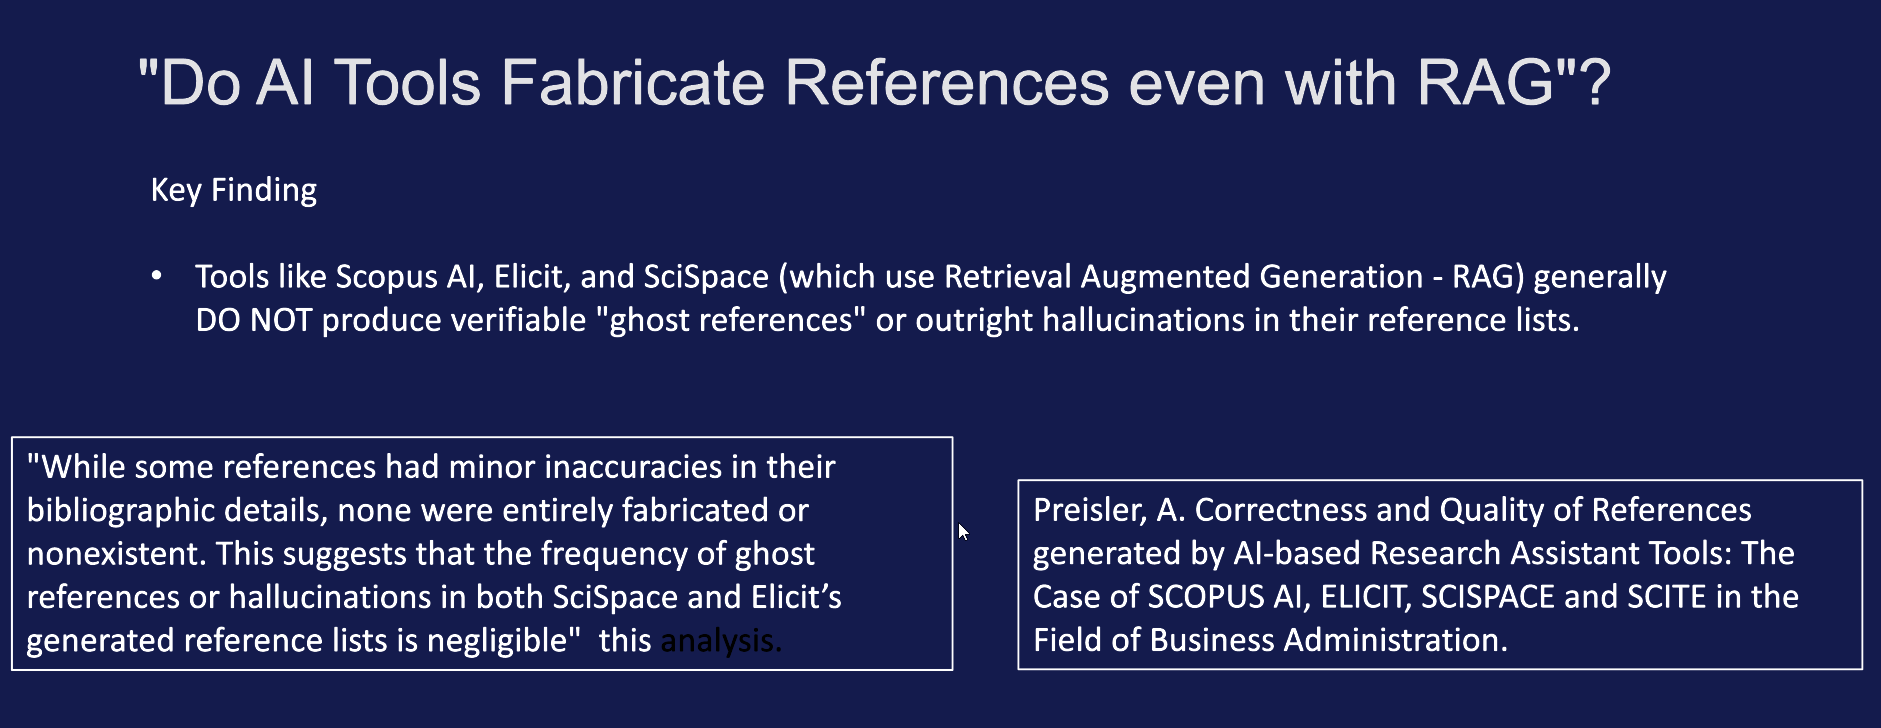
Analisis lapangan terhadap Scopus AI, Elicit, SciSpace, dan Scite dalam administrasi bisnis menemukan bahwa alat berbasis RAG umumnya tidak mengeluarkan referensi hantu yang dapat diverifikasi. Ketidakakuratan bibliografis kecil masih muncul; sumber yang sepenuhnya tidak ada dapat diabaikan jumlahnya dalam daftar yang dihasilkan tersebut. Itulah cara yang tepat untuk memahami RAG: RAG merupakan kendali kuat terhadap referensi hantu, bukan sistem kualitas sitasi yang lengkap.
Riset kesetiaan menjelaskan risiko yang tersisa. Kerangka evaluasi RAG membedakan relevansi jawaban dari kesetiaan: sebuah respons dapat sesuai topik tetapi tetap tidak berlandaskan bagian teks yang diambil. Temuan ACM bahwa sebagian besar sitasi RAG dapat kurang setia merupakan peringatan operasional. Jika Anda hanya memeriksa apakah DOI dapat diakses, Anda akan menangkap referensi hantu tetapi melewatkan klaim yang salah diatribusikan.
Chatbot serbaguna gagal pada mode pertama. Asisten RAG sebagian besar gagal pada mode kedua dan ketiga. Karena itu, alur kerja pencegahan yang hanya menanyakan "apakah artikel ini ada?" tidak lengkap bagi alat yang seharusnya digunakan peneliti.
Bagaimana Memverifikasi Sitasi yang Dihasilkan Asisten Riset AI?
Verifikasikan dengan protokol dua tahap: akses pengenal terlebih dahulu, lalu pastikan bahwa bagian teks tertentu mendukung klaimnya. Melewatkan salah satu tahap adalah cara sumber yang dibuat-buat atau disalahgunakan sampai ke publikasi.
Tahap 1 — Apakah rekamannya ada?
- Salin judul, penulis pertama, tahun, dan DOI persis seperti yang dikembalikan.
- Akses DOI di halaman lembaga pendaftar atau penerbit. Jika tidak ada DOI, telusuri judul persisnya di Google Scholar, PubMed, atau situs jurnal, mengikuti pendekatan pencarian langsung yang direkomendasikan panduan riset.
- Tolak item apa pun yang tidak dapat diakses, mengarah ke artikel berbeda, atau hanya ada sebagai sitasi berformat AI.
- Periksa urutan penulis, tahun, volume, nomor terbitan, dan halaman terhadap rekaman penerbit, bukan terhadap blok bibliografi milik asisten.
Tahap 2 — Apakah artikel ini mendukung kalimat ini?
- Buka teks lengkap PDF atau HTML. Abstrak tidak cukup untuk klaim kausal, ukuran efek, atau pernyataan "bukti pertama".
- Temukan bagian teks yang diduga mendukung klaim. Kutip bagian tersebut dalam catatan Anda.
- Tandai sitasi sebagai mendukung, menyebut, atau berlawanan — perbedaan yang diproduktisasi oleh Scite dan dapat Anda terapkan secara manual.
- Jika asisten memparafrasekan keterbatasan sebagai temuan, atau hipotesis sebagai hasil, buang sitasi itu untuk kalimat tersebut.
Untuk Academic Research Assistant milik Jenova, batasi temu kembali sebelum Anda menghasilkan daftar referensi:
"Telusuri artikel yang telah ditelaah sejawat dan pracetak tentang [topik], 2019–2026. Kembalikan hanya item dengan DOI atau PMID. Untuk setiap item: judul, penulis, tahun, sumber publikasi, pengenal, temuan satu kalimat, dan kutipan bagian teks. Jika Anda tidak dapat mengambil rekaman yang dapat diverifikasi, hilangkan item tersebut sepenuhnya. Jangan melengkapi atau menebak metadata."
Lalu jalankan kandidat terpilih yang sama melalui Elicit atau SciSpace sebagai pemeriksaan korpus kedua. Ketidaksepakatan antaralat merupakan fitur, bukan kelemahan: hal itu menandai artikel yang diberi peringkat oleh satu sistem tetapi tidak dapat diambil oleh sistem lain.
Pelaporan Science tentang artikel ilmiah berhalusinasi menunjukkan mengapa membaca judul secara sepintas tidak memadai. Seorang asisten dapat mengutip satu artikel nyata dengan benar lalu menciptakan artikel tetangga dalam paragraf yang sama. Verifikasi harus dilakukan per item, bukan per paragraf.
Apakah Sitasi Berhalusinasi Dapat Dianggap sebagai Pelanggaran Riset?
Ya, dalam serangkaian kasus tertentu — dan bahkan ketika tidak memenuhi definisi hukum tentang pelanggaran riset, hal itu tetap dapat memicu pencabutan artikel, masalah hibah, serta kerusakan karier. Motif pencegahannya bukan sekadar etiket. Ini adalah tanggung jawab.
Resnik dan Hosseini berpendapat bahwa sitasi berhalusinasi dapat memenuhi syarat sebagai pelanggaran riset yang dapat dibuktikan berdasarkan peraturan federal AS ketika tiga kondisi terpenuhi: peneliti menggunakan alat generatif untuk menghasilkan sitasi yang tidak ada; sitasi tersebut berfungsi sebagai data karena mendukung temuan, seperti dalam tinjauan atau studi bibliometrik; dan peneliti menunjukkan sikap abai terhadap risiko fabrikasi dengan tidak memeriksa hasilnya. Referensi hantu dalam pendahuluan naratif adalah praktik ilmiah yang buruk. Referensi hantu yang dihitung sebagai bukti dalam tinjauan sistematis lebih dekat pada data palsu.
Pemberi dana sudah memperlakukan masalah ini sebagai isu operasional. Pada musim panas 2025, staf peninjau hibah NIH dibanjiri proposal berbantuan AI, dan lembaga tersebut menyatakan bahwa penggunaan AI yang tidak semestinya yang ditemukan setelah pendanaan diberikan dapat dirujuk untuk peninjauan integritas. Pusat integritas riset Harvard menegaskan batasan terkait: alat AI tidak dapat dicantumkan sebagai penulis, penelaah sejawat ilmiah NIH dilarang menggunakan AI generatif untuk merumuskan kritik, dan penulis wajib mengungkapkan bagaimana alat digunakan.
Jurnal-jurnal menuju pembagian tanggung jawab yang sama. Kompilasi Stanford atas aturan APA, MLA, Chicago, dan IEEE mewajibkan pengungkapan konten yang dihasilkan AI dan, dalam kasus APA, verifikasi eksplisit oleh manusia terhadap sitasi. Panduan pengajaran Cornell juga memperingatkan bahwa algoritme otomatis untuk mendeteksi AI terlalu tidak andal untuk menjadi strategi integritas. Deteksi setelah kejadian adalah pengganti yang lemah bagi verifikasi sebelum pengajuan.
Standar praktisnya sederhana. Jika Anda tidak dapat menunjukkan rekaman yang dapat diakses dan bagian teks yang mendukung, sitasi tersebut tidak boleh berada dalam naskah, presentasi, atau proposal hibah.
Apa Kata Spesialis Integritas Riset tentang Sitasi yang Dihasilkan AI?
Para spesialis kini memperlakukan referensi karangan sebagai kegagalan proses — menggunakan model generatif seperti perpustakaan — bukan sebagai cacat model misterius yang tidak dapat diperkirakan pengguna. Konsensus di kantor integritas dan studi sitasi adalah bahwa RAG mengurangi referensi hantu, verifikasi manusia tetap wajib, dan daftar pustaka chatbot tanpa pengawasan adalah tindakan ceroboh mengingat tingkat kegagalan yang sudah diketahui.
"Kesalahan yang terus sampai ke jurnal bukanlah bahwa model terkadang menebak. Kesalahannya adalah peneliti membiarkan model bahasa menjalankan tugas katalogisasi yang tidak dirancang untuknya. Jika asisten tidak mengambil suatu rekaman, ia sedang melengkapi pola bibliografis, dan pola yang dilengkapi seperti itulah yang menghasilkan artikel yang tampak nyata di jurnal yang tampak nyata dengan DOI yang tidak dapat diakses. Beralih ke alat temu kembali secara drastis menekan mode kegagalan itu. Namun, langkah tersebut tidak menekan kegagalan berikutnya: mengutip artikel nyata untuk hasil yang hanya hidup dalam ringkasan model, bukan di bagian hasil."
"Kami meminta pengguna riset menjalankan alur kerja tiga kelompok. Kelompok A sudah diambil dan diperiksa bagian teksnya — sitasi tersebut boleh digunakan. Kelompok B sudah diambil tetapi hanya diperiksa metadatanya — sitasi itu tetap berada dalam daftar bacaan. Kelompok C adalah apa pun yang dikeluarkan model tanpa pengenal yang dapat diakses — item itu dihapus, bukan 'dicari nanti'. Tim yang melewati Kelompok C karena sayang membuang format yang sudah rapi adalah tim yang kemudian mendapati bahwa 12 dari 14 referensi tidak pernah ada. Biaya pemeriksaan tambahan sangat kecil dibandingkan pencabutan artikel atau rujukan integritas hibah."
— Tim Produk Jenova, desain agen riset AI untuk alur kerja akademik
Nasihat tersebut sejalan dengan kebijakan penerbit dan universitas: sebutkan alatnya, sebutkan tugas yang dijalankannya, dan pertahankan tanggung jawab penulis manusia atas setiap referensi. Panduan integritas tidak lagi berbunyi "hindari AI." Panduan tersebut berbunyi "jangan alihdayakan keberadaan sumber Anda."
Bagaimana Menjalankan Tinjauan Literatur yang Aman bagi Sitasi dengan AI?
Jalankan sebagai saluran kerja dengan temu kembali terlebih dahulu, ekstraksi kedua, prosa terakhir, serta gerbang verifikasi yang tidak boleh dilewati kalimat mana pun. Membalik urutan itu — menyusun argumen, lalu meminta asisten untuk "menambahkan sitasi" — adalah pola prompt yang paling terkait dengan referensi hantu.
Alur kerja yang dapat bertahan dalam pemeriksaan jurnal dan hibah:
- Tuliskan aturan inklusi sebelum mencari. Populasi, intervensi, tahun, bahasa, dan jenis studi. Tempelkan aturan tersebut ke asisten agar memori, jika alat memilikinya, berlanjut lintas sesi.
- Cari dengan dua alat temu kembali, bukan satu. Contoh pasangan: Academic Research Assistant milik Jenova ditambah Elicit atau SciSpace. Simpan gabungan semua hasil; jangan percaya pada satu daftar berperingkat.
- Bekukan kumpulan kandidat dengan pengenal. Ekspor judul, penulis, tahun, sumber publikasi, DOI/PMID. Apa pun tanpa pengenal menunggu di luar kumpulan.
- Ekstrak, jangan ringkas, dari teks lengkap. Metode, sampel, luaran, keterbatasan, dan satu kalimat kutipan. Tabel bergaya Elicit berguna di sini; ringkasan naratif adalah tempat halusinasi konteks mulai muncul.
- Susun draf dari tabel ekstraksi. Jika sebuah kalimat tidak memiliki baris di tabel, kalimat itu tidak mendapatkan sitasi — dan mungkin tidak layak masuk ke artikel.
- Ungkapkan alat yang digunakan. Ikuti kompilasi aturan panduan gaya Stanford: nama alat, versi, tanggal, serta fungsi yang dijalankan, seperti pencarian, ekstraksi, atau penyuntingan bahasa.
- Lakukan penyisiran DOI terakhir pada bibliografi yang dikirimkan. Tahap akhir ini menangkap pergeseran akibat salin-tempel dan setiap referensi yang dimasukkan model selama revisi.
Prompt yang menjaga Jenova berada dalam saluran kerja, bukan dalam mode chatbot:
"Dengan hanya menggunakan kumpulan kandidat yang saya unggah, susun bagian latar belakang. Setiap kalimat empiris harus menyitasi DOI dari kumpulan tersebut dan tidak boleh memperkenalkan sumber baru. Jika suatu klaim tidak didukung catatan ekstraksi, tandai sebagai UNSUPPORTED alih-alih menyitasi."
Untuk SciSpace atau Elicit, gunakan tampilan temu kembali atau ekstraksi masing-masing alat untuk membangun ulang tabel yang sama dan membandingkan barisnya. Ketika tabel tidak sepakat tentang suatu temuan, baca PDF-nya. Ketidaksepakatan itu lebih murah daripada koreksi setelah publikasi.
Batasan yang membuat saluran kerja ini berhasil bersifat psikologis sekaligus teknis: jangan pernah meminta asisten apa pun, termasuk yang kuat, untuk "menyediakan referensi" bagi prosa yang ditulis tanpa sumber. Prompt tersebut mengubah alat riset kembali menjadi generator sitasi, yaitu mode kegagalan yang dirancang untuk dicegah oleh seluruh tumpukan ini.
Referensi
- Nature — Sitasi berhalusinasi mencemari literatur ilmiah
- Accountability in Research (Resnik & Hosseini) — Sitasi berhalusinasi yang dihasilkan kecerdasan buatan generatif
- Stanford Libraries — AI dalam Riset Akademik: Panduan Sitasi
- ACM Digital Library — Kebenaran bukan Kesetiaan dalam Retrieval Augmented Generation
- DeepEval — Metrik kesetiaan untuk sistem RAG
- Confident AI — Metrik evaluasi RAG: relevansi jawaban, kesetiaan, dan relevansi kontekstual
- UNC Charlotte Library — Panduan riset sitasi AI berhalusinasi
- Wiley — Panduan AI untuk peneliti
- College Board — Kekhawatiran dosen bahwa penggunaan AI mahasiswa merusak integritas akademik
- Harvard Medical School Academic and Research Integrity — AI dalam Riset
- Cornell Center for Teaching Innovation — AI dan Integritas Akademik
- SciSpace — Tolok ukur pencarian literatur SciSpace vs Elicit vs Consensus pada 200 kueri
- Paperguide — Perbandingan Elicit vs SciSpace
- Paperguide — Perbandingan Elicit vs Scite
- Science — Mengutip yang tak terlihat: ketika AI menghalusinasikan artikel ilmiah
- SciSpace — Perbandingan produk SciSpace vs Elicit