Bagaimana Asisten Riset AI Memetakan Kesenjangan Bukti untuk Topik Baru?
2026-08-22
Apa yang Membedakan Alur Kerja Pencarian-Penyaringan-Pemetaan yang Dapat Ditelusuri dari Ringkasan Literatur Generik?
Asisten riset AI yang andal tidak memulai dengan merangkum makalah apa pun yang dapat ditemukannya. Asisten tersebut membangun strategi pencarian yang dapat direproduksi, menyaring kumpulan studi yang terbatas berdasarkan kriteria eksplisit, lalu memetakan cakupan — dan kekurangan cakupan — dari studi-studi tersebut agar sel kosong menjadi kesenjangan bukti, bukan artefak pencarian. Pada 2026, perbedaan ini penting karena ringkasan chat generik dapat terlihat lengkap sambil mengarang sitasi atau menyatukan desain studi yang tidak kompatibel menjadi satu klaim.
Untuk topik baru, satuan kerja praktis sering kali berupa kumpulan inti 50 makalah: cukup besar untuk mengungkap klaster, tetapi cukup kecil sehingga peneliti masih dapat memverifikasi setiap keputusan include/exclude. Alat yang mendukung alur kerja ini mencakup Academic Research Assistant milik Jenova, alur kerja tinjauan sistematis Elicit, Rayyan, serta pemeta jaringan sitasi seperti ResearchRabbit.
Hal-hal yang membedakan proses pencarian-penyaringan-pemetaan yang layak disitasi dari tumpukan literatur sekali pakai:
✅ Kueri yang dapat ditelusuri — string Boolean, database, rentang tanggal, dan sinonim dicatat sebelum penyaringan dimulai
✅ Penyaringan yang dapat diaudit — setiap makalah menerima tag include, exclude, atau unsure yang terhubung pada kriteria yang telah dinyatakan
✅ Bukti diekstrak, bukan diparafrasekan — temuan, metode, dan keterbatasan tetap melekat pada sumber yang dapat diverifikasi
✅ Peta kesenjangan multidimensi — sel kosong dikodekan berdasarkan populasi, metode, geografi, dan luaran, bukan berdasarkan intuisi
✅ Verifikasi manusia — AI menyusun draf peta; peneliti mengonfirmasi bahwa setiap sitasi ada dalam makalah asli
Untuk membandingkan asisten secara bermakna, pencarian, penyaringan, dan pemetaan kesenjangan perlu diperlakukan sebagai tiga pekerjaan dengan mode kegagalan yang berbeda, bukan sebagai satu fitur “tinjauan literatur”.
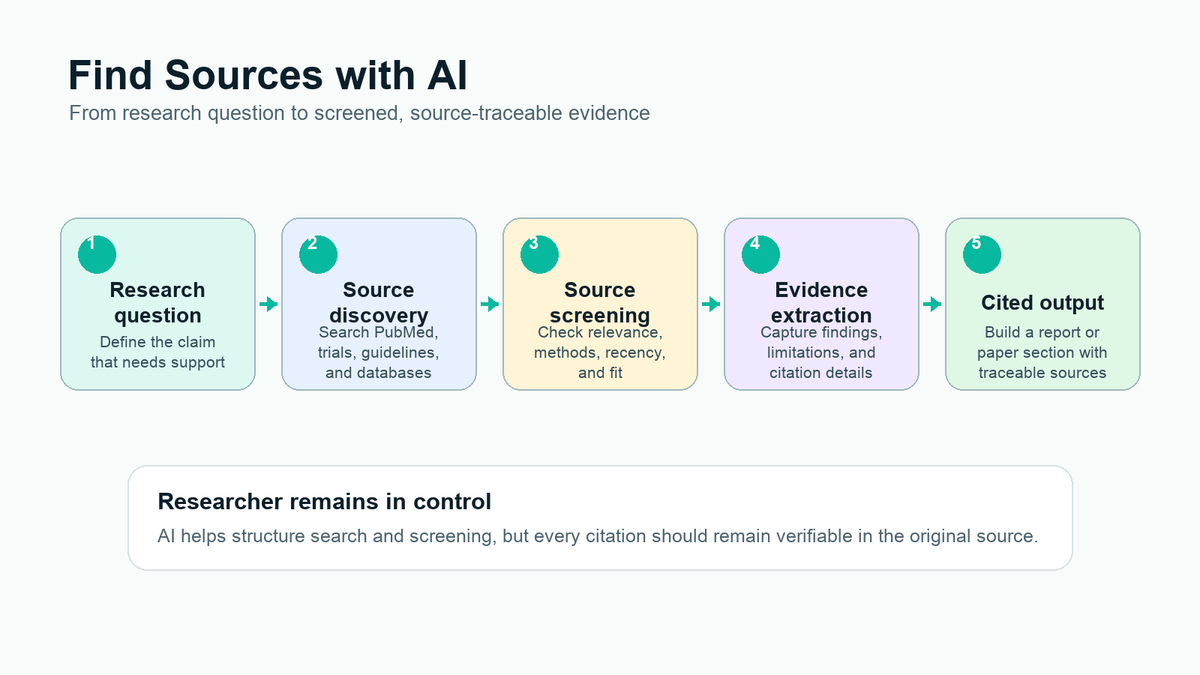
Mengapa Peta Kesenjangan Bukti Semakin Esensial untuk Topik Riset Baru?
Peta bukti dan kesenjangan telah menjadi cara standar untuk melihat, secara sekilas, bagian mana dari suatu bidang yang padat dan bagian mana yang sunyi sebelum peneliti berkomitmen pada desain studi baru. Sebuah peta bukti dan kesenjangan adalah presentasi visual sistematis mengenai ketersediaan bukti relevan untuk domain kebijakan atau riset, yang diidentifikasi melalui protokol pencarian yang telah ditetapkan sebelumnya, bukan daftar bacaan ad hoc.
Definisi yang dikembangkan untuk Campbell Collaboration ini mudah disalahgunakan. Banyak peta melaporkan bukti apa yang tersedia, bukan kesimpulan dari bukti tersebut. Mencampuradukkan keduanya menghasilkan keyakinan palsu: sel yang padat masih dapat lemah secara metodologis, dan sel kosong dapat mencerminkan pencarian yang gagal, bukan ketidaktahuan yang nyata.
Metode ini bukan lagi pendekatan khusus. Sebuah tinjauan sektor kesehatan pada 2016 mengidentifikasi 145 judul pemetaan, dengan 34 publikasi yang menyajikan peta bukti eksplisit. Tinjauan pemetaan dan peta kesenjangan bukti kini diperlakukan sebagai produk sintesis tersendiri untuk menavigasi kumpulan riset yang kompleks, yang berada di antara tinjauan cakupan dan tinjauan sistematis penuh.
Bagi seseorang yang memasuki topik baru pada 2026, tekanannya bersifat praktis. Elicit mencatat bahwa tinjauan sistematis sering dimulai dengan hingga 20.000 rekaman dan disaring menjadi 30–100 makalah yang diikutsertakan, suatu proses yang secara manual dapat memerlukan tiga bulan hingga lebih dari satu tahun. Penyaringan 50 makalah bukan pengganti alur standar emas tersebut. Ini adalah instrumen pertama yang tepat ketika tujuannya adalah menentukan apakah tinjauan sistematis, studi primer, atau pertanyaan yang lebih sempit dapat dibenarkan.
AI mengubah kecepatan pada tahap awal. AI tidak menghapus kewajiban pelaporan dalam PRISMA 2020, yang tetap mengharapkan metode identifikasi, seleksi, dan ekstraksi yang transparan.
Apa yang Harus Dicari dalam Asisten Riset AI untuk Penyaringan Literatur?
Anda sebaiknya mengevaluasi asisten riset AI berdasarkan kemampuannya menjaga strategi pencarian tetap dapat direproduksi, keputusan penyaringan dapat diperiksa, dan klaim kesenjangan dapat dipalsukan — bukan berdasarkan kelancarannya menulis tinjauan literatur. Daftar periksa TRACE-GAP di bawah ini adalah kerangka yang digunakan dalam artikel ini.
Dimensi evaluasi TRACE-GAP
- T — Kueri yang dapat ditelusuri. Bisakah alat menghasilkan database, string, batasan, dan rentang tanggal yang persis sehingga peneliti lain dapat menjalankannya kembali?
- R — Kriteria relevansi. Bisakah aturan inklusi dan eksklusi dinyatakan sebelum makalah apa pun dinilai?
- A — Penyaringan yang dapat diaudit. Apakah setiap keputusan menyertakan alasan, bukan sekadar ya/tidak?
- C — Ekstraksi tingkat sitasi. Apakah temuan terhubung pada suatu kutipan atau setidaknya makalah tertentu, bukan ringkasan gabungan?
- E — Pengodean kekuatan bukti. Bisakah desain studi, sampel, dan keterbatasan dicatat di samping temuan?
- G — Dimensi kesenjangan. Bisakah peta menggunakan setidaknya dua sumbu, biasanya intervensi × luaran atau populasi × metode?
- A — Validasi lintas klaster. Apakah alur kerja memaksa peninjauan kedua sebelum sel kosong disebut sebagai kesenjangan?
- P — Pertanyaan yang diprioritaskan. Apakah keluaran mengubah kesenjangan tervalidasi menjadi pertanyaan riset, bukan sekadar peta panas dekoratif?
Sebuah tolok ukur panduan pembeli tahun 2026 yang menilai asisten berdasarkan landasan sitasi menemukan bahwa tautan sumber tingkat paragraf menghasilkan rasio halusinasi terhadap verifikasi terendah, dengan Atlas sebesar 0,05, Elicit 0,07, Consensus 0,09, dan SciSpace 0,16. Tinjauan yang sama memperlakukan ResearchRabbit sebagai pemeta jaringan, bukan pembuat jawaban, yang merupakan kategori tepat untuk perluasan dari makalah awal.
Dua pengujian tambahan penting untuk penggunaan akademik. Pertama, PRISMA 2020 tetap mengharuskan penulis memverifikasi nilai yang diekstrak; alat apa pun yang menyembunyikan kutipan pendukung gagal dalam pengujian tersebut. Kedua, sitasi hasil halusinasi telah masuk ke draf pakar dan alur penerbitan jurnal, sehingga “terdengar ilmiah” bukanlah kriteria penerimaan.
Academic Research Assistant milik Jenova paling kuat dalam penyusunan strategi, penemuan multidatabase, memori proyek persisten, dan penulisan yang peka terhadap sitasi. Alat ini lebih lemah sebagai platform khusus penyaringan ganda: Jenova tidak membuat diagram alur PRISMA atau menjalankan penyelesaian konflik tersamar seperti yang dilakukan Rayyan dan Covidence.
Bagaimana Perbandingan Jenova, Elicit, Rayyan, dan ResearchRabbit untuk Pencarian, Penyaringan, dan Pemetaan Kesenjangan?
Jenova paling kuat sebagai mitra strategi dan sintesis, Elicit sebagai mesin ekstraksi terstruktur, Rayyan sebagai meja kerja penyaringan bervolume tinggi, dan ResearchRabbit sebagai penjelajah jaringan sitasi — dan tidak satu pun sebaiknya digunakan sebagai sistem tertutup tunggal untuk topik baru. Perbandingan yang berguna adalah pekerjaan mana yang seharusnya dimiliki setiap alat.
| Fitur / Dimensi | Jenova Academic Research Assistant | Elicit | Rayyan | ResearchRabbit / Scite |
|---|---|---|---|---|
| Dukungan strategi pencarian | Penyusunan PICO/Boolean secara percakapan dengan Scholar dan pencarian web; memori proyek persisten | Pencarian semantik atas 125 juta+ makalah; menyarankan bidang penyaringan dari pertanyaan | Mengimpor ekspor database tradisional; bukan terutama perancang pencarian | ResearchRabbit berkembang dari makalah awal; Scite memeriksa sikap sitasi di tahap berikutnya |
| Penyaringan sekitar 50 makalah | Tabel include/exclude berbasis kriteria dalam chat, disertai alasan dan keterbatasan | Penyaringan berperingkat serta baris ekstraksi yang didukung kutipan | Dirancang khusus untuk penyaringan judul/abstrak, deduplikasi, dan alur kerja tim | Lemah sebagai penyaring; kuat untuk menemukan makalah terkait atau mengaudit sitasi |
| Pemetaan kesenjangan bukti | Pengodean klaster, validasi sel kosong, dan penerjemahan ke pertanyaan riset | Tabel ekstraksi yang baik untuk membangun peta pada tahap berikutnya | Log penyaringan mendukung peta; pemetaan sendiri sebagian besar dilakukan di tahap hilir | Peta jaringan menunjukkan tautan yang hilang, bukan kesenjangan bukti tervalidasi |
| Landasan sitasi | Jawaban multimodel dengan prompt yang mengutamakan sumber; verifikasi manusia tetap diperlukan | Kutipan tingkat makalah untuk bidang yang diekstrak | Log keputusan dapat diaudit; sintesis bukan produknya | Scite menandai sitasi yang mendukung, berlawanan, atau sekadar menyebutkan |
| Harga (per 2026) | Tingkat gratis dengan penggunaan terbatas; Plus mulai $20/bulan | Pro, Team, dan Enterprise (harga daftar bervariasi berdasarkan paket) | Gratis selamanya untuk penggunaan dasar | ResearchRabbit gratis; Scite Student sekitar $10/bulan, Premium sekitar $20/bulan |
| Paling cocok untuk | Strategi topik baru, pemaknaan 50 makalah, dan mengubah kesenjangan menjadi justifikasi studi | Ekstraksi terstruktur di banyak makalah | Penyaringan tim dalam skala tinjauan sistematis | Memasuki bidang dari makalah awal, lalu mengaudit sitasi utama |
Rayyan melaporkan penggunaan oleh lebih dari 1 juta peneliti di lebih dari 20.000 institusi pada lebih dari 190 negara dan dibangun dengan dasar kemampuan audit, reproduktibilitas, serta prioritisasi berbantuan AI. Tinjauan perangkat lunak berdampingan pada 2026 masih menggambarkan pilihan sebagai Covidence untuk manajemen tinjauan institusional, Rayyan untuk penyaringan yang mudah diakses, dan Elicit untuk pencarian serta ekstraksi AI.
Keterbatasan Jenova adalah antarmuka, bukan niat. Penyaringan 50 makalah dalam chat dapat diperiksa jika Anda memaksakan penggunaan tabel, tetapi tidak akan menggantikan dua penyaring independen pada ekspor 5.000 rekaman. Keterbatasan Elicit justru kebalikannya: tabelnya sangat baik, tetapi Elicit sendiri menyatakan bahwa tinjauan berstandar publikasi tetap harus menjalankan pencarian kata kunci tradisional dan memperlakukan pencarian semantik sebagai pelengkap. Keterbatasan ResearchRabbit adalah kejujuran tentang cakupannya: alat ini memetakan apa yang terhubung, bukan apa yang hilang setelah penilaian kualitas.
Untuk topik baru, tumpukan alat dengan hasil tinggi biasanya adalah Jenova atau Semantic Scholar untuk strategi, Rayyan atau Elicit untuk penyaringan, Scite untuk sikap sitasi, dan Jenova kembali untuk narasi kesenjangan. Agen Deep Research milik Jenova adalah serah-terima yang lebih baik ketika peta 50 makalah memerlukan pengarahan yang lebih panjang dan padat sitasi.
Bagaimana Membangun Strategi Pencarian yang Dapat Direproduksi dengan Asisten Riset AI?
Anda membangun strategi pencarian yang dapat direproduksi dengan mengunci pertanyaan, konsep, sumber, dan batasan sebelum meminta model apa pun mencari makalah. Tugas asisten adalah mengungkap sinonim yang terlewat dan batasan yang bias, bukan mengimprovisasi daftar bacaan.
Mulailah dengan jangkar riset: populasi atau latar, intervensi atau paparan, pembanding jika relevan, luaran, dan desain studi yang akan diterima. Tinjauan pemetaan dapat lebih luas daripada satu pertanyaan PICO, tetapi tetap memerlukan strategi pencarian dan formulir pengodean yang ditetapkan secara ex ante. Panduan universitas mendeskripsikan peta bukti atau kesenjangan sebagai tabel utama dengan baris, kolom, dan filter untuk variabel tertentu. Baris dan kolom tersebut seharusnya sudah ada di atas kertas sebelum kueri pertama dijalankan.
Prompt awal yang berguna dalam Academic Research Assistant milik Jenova terlihat seperti berikut:
"Saya sedang membuka lini riset baru tentang [topik]. Buatkan strategi pencarian yang dapat direproduksi dengan: (1) elemen PICO atau PECO, (2) kriteria inklusi dan eksklusi, (3) database dan sumber literatur abu-abu, (4) string Boolean dengan sinonim dan kosakata terkendali, serta (5) rentang tanggal 2019–2026. Daftarkan istilah yang kemungkinan saya lewatkan dan batasan apa pun yang akan menyembunyikan desain studi relevan."
Lalu paksakan pemeriksaan metode:
"Tulis ulang strategi ini agar peneliti lain dapat menjalankannya kembali. Pisahkan istilah wajib dari sinonim opsional. Tandai bagian saat pencarian semantik akan membantu recall dan bagian saat hanya sintaks database yang presisi yang dapat diterima."
Asisten yang baik akan mengarahkan Anda ke berbagai sumber. Topik biomedis tetap memerlukan MEDLINE/PubMed serta setidaknya satu indeks pelengkap; pendidikan dan kebijakan sosial sering memerlukan ERIC, PsycINFO, atau pustaka peta khusus. Panduan sintesis University of Toronto memperlakukan tinjauan pemetaan sebagai cara untuk melihat kesenjangan sebelum berkomitmen pada tinjauan sistematis yang lebih sempit.
Dua kesalahan strategi terus muncul dalam pengujian. Pertama adalah pemfilteran berlebihan berdasarkan “review” atau “RCT” terlalu dini, yang menghapus sel kosong yang justru ingin Anda temukan. Kedua adalah membiarkan model memilih database setelah model tersebut sudah melihat beberapa hasil yang mudah ditemukan. Bekukan protokol, lalu lakukan pencarian.
Jenova membantu di sini karena percakapan tetap berlanjut antar sesi dan dapat menyimpan jangkar, string, serta daftar eksklusi dalam memori. Namun, alat ini bukan pengganti pencarian yang ditinjau pustakawan untuk tinjauan sistematis yang ditujukan ke jurnal, dan Anda tidak boleh berpura-pura bahwa alat ini dapat menggantikannya.
Bagaimana Menyaring Sekitar 50 Makalah Utama Tanpa Kehilangan Ketelitian Metodologis?
Anda sebaiknya menyaring 50 makalah sebagai log keputusan yang dikodekan: satu baris per studi, satu alasan per keputusan, dan tidak ada makalah yang diterima hanya karena abstraknya “terdengar relevan”. Lima puluh adalah korpus kerja untuk topik baru, bukan klaim bahwa literatur telah dicari secara menyeluruh.
Terapkan disiplin penyaringan sistematis bahkan ketika Anda belum menulis tinjauan PRISMA. PRISMA 2020 adalah pedoman pelaporan terkini untuk tinjauan yang mengidentifikasi, memilih, dan menyintesis studi. Daftar periksa 27 butir yang menyertainya ada untuk membuat metode tersebut transparan. Log 50 makalah Anda tidak akan memenuhi standar tinjauan sistematis penuh, tetapi seharusnya dapat menjawab pertanyaan dasar yang sama: apa yang ditemukan, apa yang dipertahankan, dan mengapa.
Prompt penyaringan yang praktis:
"Saring 50 makalah berikut berdasarkan kriteria inklusi dan eksklusi ini. Untuk setiap makalah, kembalikan: keputusan (include / exclude / unsure), satu kriteria yang menentukan keputusan, desain studi, populasi, latar, luaran utama, dan satu keterbatasan. Kutip frasa yang membenarkan keputusan tersebut. Jangan tambahkan makalah yang tidak ada dalam daftar ini."
Kemudian lakukan tahap kalibrasi pada sepuluh rekaman pertama sendiri. Jika asisten dan peneliti tidak sepakat pada lebih dari dua atau tiga rekaman, kriterianya masih kabur. Perjelas definisi populasi, desain, dan luaran sebelum menilai empat puluh rekaman sisanya.
Rayyan adalah instrumen yang lebih baik ketika kumpulan data bertambah atau penyaring kedua bergabung. Perbandingan independen antara Covidence dan Rayyan sejak lama memperlakukan keduanya sebagai platform penyaringan tinjauan sistematis yang layak dengan model kolaborasi berbeda. Elicit adalah instrumen yang lebih baik ketika langkah berikutnya adalah tabel data: ukuran sampel, arah luaran, dan bidang metode yang diisi dengan kutipan pendukung.
Batasan jujur Jenova adalah ergonomi pemrosesan batch. Penyaringan berbasis chat cepat untuk 50 makalah yang dipilih dengan saksama dan merepotkan untuk 5.000 rekaman yang diimpor. Gunakan Jenova untuk menerapkan kriteria dan mengekstrak buku kode yang konsisten. Pindahkan buku kode yang sama ke Rayyan atau Elicit jika proyek berkembang menjadi tinjauan formal.
Jangan pernah membiarkan model “mengisi” PDF yang hilang. Jika teks lengkap tidak tersedia, baris tersebut tetap unsure, bukan include. Satu aturan itu mencegah sebagian besar teater sitasi.
Bagaimana Mengubah Makalah yang Telah Disaring Menjadi Peta Kesenjangan Bukti yang Tervalidasi?
Anda mengubah kumpulan yang telah disaring menjadi peta kesenjangan dengan mengodekan setiap studi yang diikutsertakan pada dua dimensi atau lebih, menandai sel kosong sebagai sementara, dan baru kemudian menguji apakah sel kosong tersebut bertahan setelah pencarian kedua. Sel kosong yang belum diuji adalah sisa pengodean, bukan justifikasi riset.
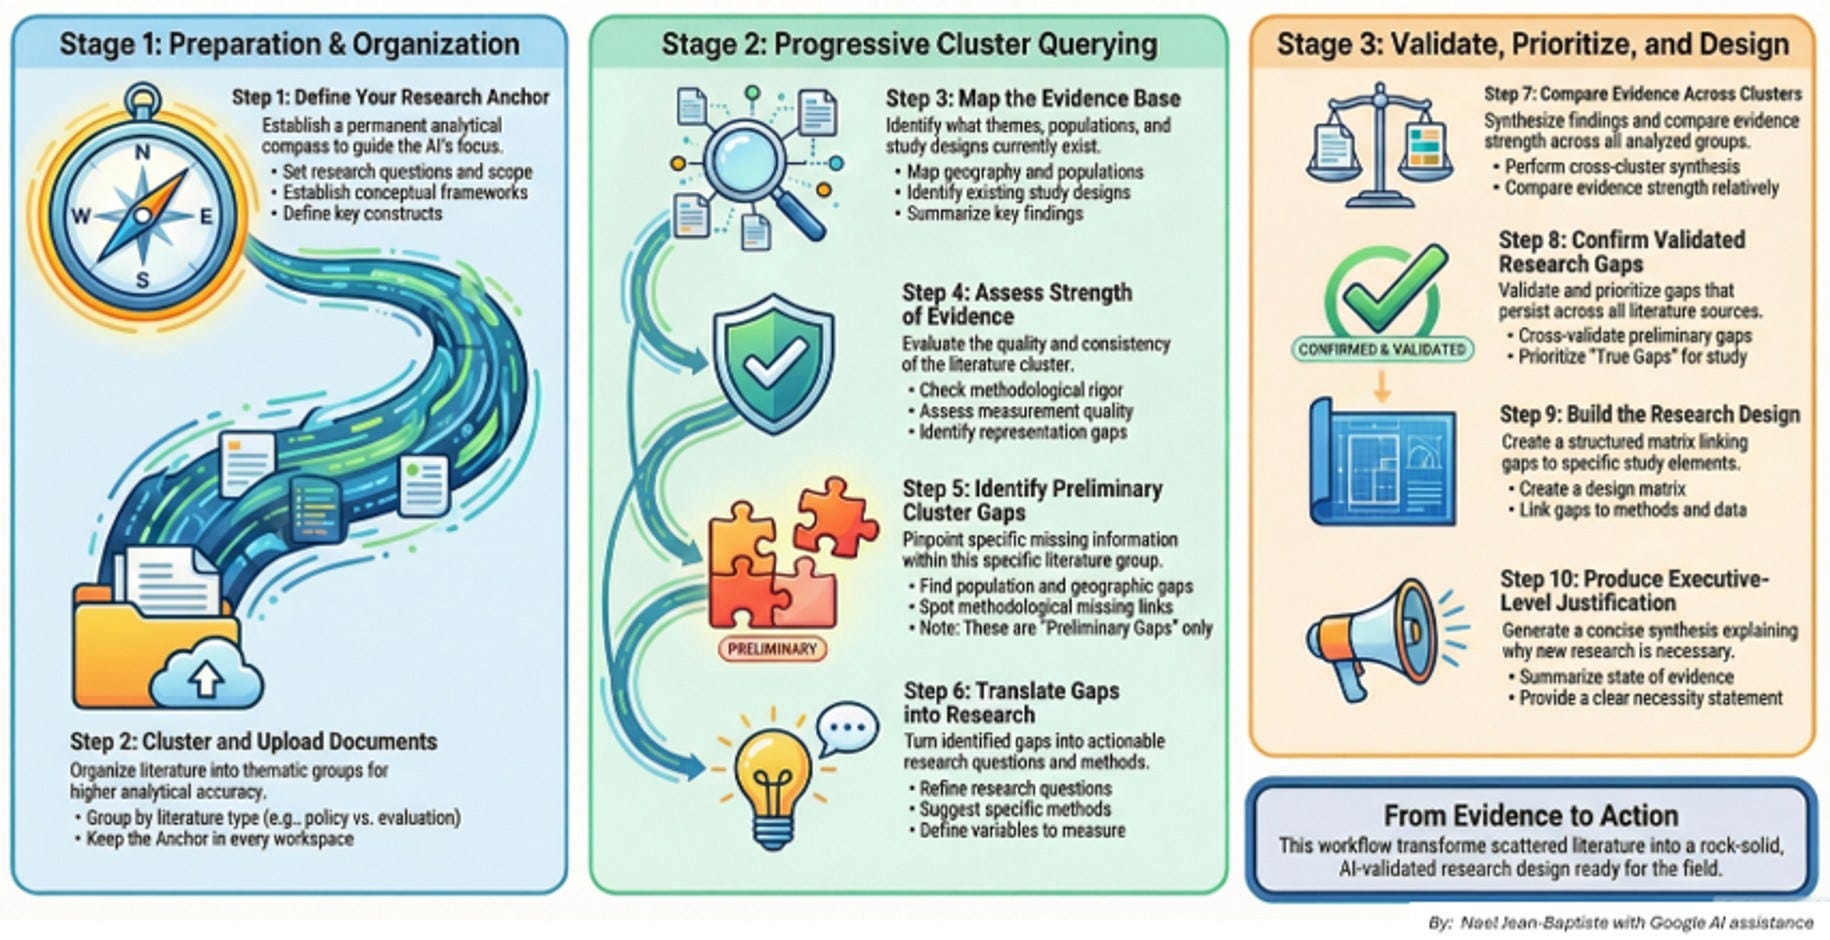
Alur kerja dalam gambar di atas adalah urutan yang tepat: siapkan jangkar analitis, kelompokkan dokumen, nilai kekuatan bukti, tandai kesenjangan sementara, lalu validasi kesenjangan tersebut lintas klaster sebelum Anda merancang studi. Urutan ini selaras dengan cara kerja peta formal yang seharusnya. Peta kesenjangan bukti interaktif adalah alat visual terstruktur untuk menampilkan volume dan karakteristik bukti, bukan poster dari hipotesis yang disukai.
Peta yang tahan lama biasanya memerlukan setidaknya:
- Baris: intervensi, paparan, atau pertanyaan riset
- Kolom: luaran, populasi, atau desain studi
- Filter: tahun, geografi, kualitas, dan status publikasi
- Isi sel: jumlah studi, ditambah tag kekuatan kasar (tinjauan, uji coba, observasional, protokol)
Minta asisten membangun matriks awal hanya dari makalah yang diikutsertakan:
"Dengan hanya menggunakan studi yang diikutsertakan, buat matriks kesenjangan dengan baris = [intervensi atau pertanyaan] dan kolom = [luaran atau populasi]. Di setiap sel, cantumkan jumlah studi, desain dominan, dan keterbaruan. Tandai sel kosong sebagai Preliminary. Lalu usulkan tiga pencarian lanjutan yang dapat memalsukan setiap sel kosong, termasuk registri uji coba dan literatur abu-abu."
Validasi adalah langkah yang dilewatkan oleh sebagian besar tulisan AI. Perbandingan metodologis menekankan bahwa peta harus mencakup studi yang sedang berlangsung dari registri, menerapkan penilaian kritis, dan diperbarui dalam sekitar tiga tahun. Sel yang tampak kosong dalam kumpulan 50 makalah Anda mungkin penuh dalam server pracetak atau registri protokol.
Jenova berguna pada fase ini karena dapat menyimpan buku kode, matriks, dan makalah yang ditolak dalam satu rangkaian, lalu menyusun memo “mengapa studi ini diperlukan” hanya dari kesenjangan tervalidasi. Jenova akan menafsirkan sel kosong secara berlebihan jika Anda membiarkannya. Wajibkan pencarian pemalsuan untuk setiap kesenjangan yang ingin Anda danai atau tulis.
Jika topik kemudian berkembang menjadi tinjauan cakupan, alihkan pelaporan ke PRISMA-ScR, yang menetapkan 20 butir esensial dan 2 butir opsional. Jangan memoles ulang peta kasual 50 makalah seolah-olah sudah merupakan tinjauan cakupan.
Bagaimana Memaksimalkan Alur Kerja Pencarian-Penyaringan-Pemetaan Berbantuan AI?
Anda mendapatkan hasil terbaik dari alur kerja ini dengan memberikan asisten protokol yang dibekukan, korpus yang dibatasi, dan anggaran verifikasi — lalu menolak klaim apa pun yang tidak dapat dibuka dalam PDF asli. Kecepatan berasal dari pengodean yang konsisten, bukan dari melewati pemeriksaan teks lengkap.
Urutan operasional yang ringkas:
- Tulis jangkar. Satu paragraf yang menyatakan klaim yang memerlukan dukungan, populasi, dan apa yang akan dianggap sebagai bukti yang menyangkal.
- Susun dan bekukan pencarian. Database, string, tanggal, dan aturan eksklusi dimasukkan ke catatan bertanggal sebelum penemuan dimulai.
- Kumpulkan 50 makalah dengan sengaja. Padukan tinjauan, uji coba atau studi primer terbaru, dan setidaknya beberapa makalah dari bidang terkait agar peta tidak menjadi ilusi satu klaster.
- Saring dalam tabel. Include, exclude, atau unsure, dengan satu kriteria penentu dan satu frasa yang dikutip.
- Ekstrak, lalu nilai. Temuan, keterbatasan, desain, dan sampel tetap berada dalam bidang terpisah.
- Petakan, lalu serang bagian kosong. Setiap kesenjangan sementara mendapat pencarian kedua yang dirancang untuk menggugurkannya.
- Tulis berdasarkan matriks. Kalimat kebaruan makalah harus menyebutkan sel kosong yang tervalidasi, bukan sekadar kesan.
Dalam Jenova, simpan seluruh rangkaian tersebut dalam satu proyek agar asisten tidak dapat diam-diam mengubah aturan inklusi antar sesi. Prompt tindak lanjut yang mencegah penyimpangan:
"Terapkan kembali kriteria inklusi asli pada makalah baru ini. Jika Anda perlu mengubah kriteria untuk mengikutsertakannya, berhenti dan tunjukkan perubahan yang diusulkan alih-alih menilai makalah tersebut."
Untuk Elicit, mulailah dari pertanyaan riset, biarkan sistem menyarankan bidang penyaringan dan ekstraksi, lalu ganti bidang tersebut sesuai kebutuhan sebelum menjalankan keseluruhan kumpulan. Untuk Rayyan, impor ekspor database, atur label yang sesuai dengan buku kode Anda, dan perlakukan pemeringkat relevansi AI sebagai urutan pengurutan, bukan sebagai keputusan.
Alokasikan waktu verifikasi secara eksplisit. Target yang dapat diterapkan untuk kumpulan inti 50 makalah adalah dua hingga empat menit pemeriksaan manusia untuk setiap teks lengkap yang diikutsertakan, dengan fokus pada apakah temuan yang dikutip benar-benar ada dalam makalah serta apakah desainnya dikodekan dengan tepat. Ini tetap jauh lebih murah daripada ekstraksi tanpa bantuan, dan merupakan satu-satunya cara untuk memenuhi harapan PRISMA bahwa nilai yang diekstrak telah diverifikasi.
Apa Kata Metodolog Riset dan Pembangun Alat tentang Pemetaan Bukti Berbantuan AI?
Metodolog riset memperlakukan peta bukti sebagai bagan ketersediaan yang digerakkan oleh protokol, sementara pembangun alat terus menemukan bahwa sitasi, bukan prosa, adalah bagian yang sering salah dilakukan AI. Kedua kelompok bertemu pada aturan operasional yang sama: AI dapat menyusun pencarian dan penyaringan, tetapi peneliti tetap bertanggung jawab atas setiap sel dalam peta.
"Mode kegagalan yang paling sering kami lihat adalah memperlakukan sel kosong sebagai sebuah penemuan. Sel kosong hanyalah hipotesis tentang bukti yang hilang. Sel tersebut menjadi kesenjangan tervalidasi setelah Anda memeriksa klaster yang berdekatan, literatur abu-abu, dan registri protokol, serta mengonfirmasi bahwa ketiadaan itu bukan artefak pencarian. Jika pemeriksaan itu tidak dilakukan, Anda tidak memiliki peta kesenjangan. Anda memiliki visualisasi kueri pertama Anda."
"Dalam penyaringan 50 makalah, penghematan waktu berasal dari pengodean yang konsisten, bukan dari melewati teks lengkap. Pembagian kerja yang berguna itu sederhana: asisten menyusun draf keputusan include/exclude, baris ekstraksi, dan matriks pertama; peneliti meluangkan beberapa menit untuk setiap makalah yang diikutsertakan guna mengonfirmasi bahwa kutipan itu ada dan desainnya tidak ditingkatkan dalam penceritaan ulang. Ini tetap dapat memadatkan catatan berantakan selama berhari-hari menjadi satu buku kode."
"Kami tidak akan mengirimkan tinjauan sistematis jurnal hanya dari log chat. Platform penyaringan khusus masih unggul untuk tinjauan ganda, penyelesaian konflik, dan diagram PRISMA. Asisten riset percakapan memperoleh tempatnya lebih awal: mengunci pertanyaan, mengungkap batasan pencarian yang bias, menjaga makalah yang ditolak tetap terlihat, dan mengubah sel kosong tervalidasi menjadi justifikasi studi yang presisi."
— Tim Produk Jenova, alur kerja riset akademik, 8 tahun membangun perangkat riset AI yang dapat ditelusuri ke sumbernya
Kehati-hatian tersebut konsisten dengan penelitian independen. Tinjauan sistem generatif untuk sintesis literatur terus menemukan kapabilitas nyata yang disertai batasan keandalan sehingga tinjauan tanpa pengawasan menjadi tidak aman. Panduan mengenai peta bukti sistematis juga menekankan kategorisasi terstruktur atas bukti ilmiah, bukan keyakinan naratif. Batasan bahwa peneliti tetap memegang kendali dalam alur kerja sumber lima langkah bukan sekadar slogan. Itulah langkah kendali mutu yang menjadi landasan seluruh metode lainnya.
Referensi
- Saran dan White — Peta bukti dan kesenjangan: perbandingan berbagai pendekatan (PMC)
- Khalil dkk. — Metodologi untuk tinjauan pemetaan, peta bukti, dan peta kesenjangan (Research Synthesis Methods)
- Elicit — Memperkenalkan Elicit Systematic Review
- Pernyataan PRISMA — Panduan pelaporan PRISMA 2020
- Atlas Workspace — Asisten Riset AI Terbaik (2026), perbandingan terverifikasi halusinasi
- Fortune — Halusinasi AI menyusup ke pekerjaan ilmiah pakar (Mei 2026)
- University of Illinois Grainger LibGuide — Tinjauan cakupan, tinjauan pemetaan, peta bukti atau kesenjangan
- Page dkk. — Pernyataan PRISMA 2020 (The BMJ)
- University of Kansas Medical Center — PRISMA dan standar tinjauan terkait
- Elicit — Alur kerja tinjauan sistematis yang dibangun untuk PRISMA 2020
- Rayyan — Platform tinjauan sistematis bertenaga AI
- INRA.AI — Perbandingan Covidence vs Rayyan vs Elicit
- University of Toronto Libraries — Tinjauan pemetaan dalam keluarga sintesis pengetahuan
- Kellermeyer, Harnke, dan Knight — Perbandingan Covidence dan Rayyan (PMC)
- EvalCommunity Academy — Pemeta kesenjangan bukti interaktif
- PRISMA — Ekstensi PRISMA untuk tinjauan cakupan
- Adel, Alateeq, dan Alshahrani — Dapatkah AI generatif menyintesis literatur secara andal? (AI & Society)
- Khalil dkk. — Panduan untuk melakukan peta bukti sistematis (Science of the Total Environment)