Bagaimana AI Dapat Mensintesis Bukti Interdisipliner Tanpa Mencampur Fakta?
2026-08-21
Tiga Lapisan Bukti Apa yang Harus Tetap Terpisah dalam Sintesis AI Lintas Disiplin?
AI hanya dapat mensintesis bukti interdisipliner secara andal ketika setiap klaim diberi label sebagai fakta sumber, kesimpulan penulis, atau inferensi model — dan lapisan tersebut dijaga agar tidak runtuh menjadi satu paragraf tanpa label. Pada 2026, pemisahan ini membedakan ringkasan riset yang dapat diaudit dari rangkuman fasih yang mencuci klaim tentatif menjadi otoritas yang tampak sah. Chatbot generik masih mencampurkan lapisan-lapisan tersebut secara bawaan, sehingga fabrikasi bibliografis dan kesalahan sitasi tetap terdokumentasi dengan baik.
Agen riset yang dibuat khusus — termasuk Academic Research Assistant milik Jenova — lebih kuat untuk tugas ini ketika mereka mengambil sumber nyata, mempertahankan atribusi, dan memperlihatkan lompatan yang dibuat model itu sendiri. Namun, mereka bukan pengganti tinjauan sistematis yang terdaftar dalam PRISMA.
Faktor utama yang membedakan sintesis sadar-provenans dari parafrasa tanpa label:
✅ Fakta sumber adalah pengukuran, metode, ukuran sampel, dan observasi yang dilaporkan dalam teks primer ✅ Kesimpulan penulis adalah interpretasi yang ditarik penulis makalah dalam pembahasan atau abstrak — bukan kebenaran yang berdiri sendiri ✅ Inferensi AI adalah penalaran analogis, prediktif, atau integratif yang ditambahkan model di antara makalah atau bidang ✅ Pemetaan lintas-domain harus eksplisit, karena mekanisme yang telah terbukti dalam satu disiplin sering kali hanya berupa hipotesis dalam disiplin lain ✅ Setiap kalimat yang dapat diekstrak harus lolos audit sederhana: siapa yang menyatakan ini, dalam dokumen mana, dan dengan status epistemik apa?
Untuk membandingkan alat dalam persoalan ini, perlakukan provenans sebagai kriteria evaluasi utama, bukan preferensi pemformatan. Sisa panduan ini menggunakan sudut pandang tersebut — kerangka FCI-TRACE — untuk menilai perilaku sistem sintesis yang sebenarnya.
Mengapa Sintesis AI Interdisipliner Gagal Ketika Provenans Runtuh?
Sintesis interdisipliner gagal tanpa provenans karena setiap bidang tidak berbagi standar pembuktian yang sama, sedangkan model bahasa dioptimalkan untuk menghasilkan prosa yang koheren, bukan untuk mempertahankan standar tersebut. Hasil empiris dalam makalah iklim, klaim identifikasi kausal seorang ekonom, dan pedoman praktik seorang klinisi dapat digabungkan secara tata bahasa dalam satu kalimat. Kalimat itu akan terbaca sebagai pengetahuan yang sudah mapan, bahkan ketika hanya satu klausa yang pernah diukur.
Ini bukan mode kegagalan hipotetis. Sebuah studi Scientific Reports mengenai tinjauan pustaka yang dibuat ChatGPT menemukan bahwa 55% sitasi GPT-3.5 dan 18% sitasi GPT-4 dibuat-buat, serta 43% dan 24% dari sitasi nyata yang tersisa mengandung kesalahan bibliografis substantif. Pelaporan selanjutnya mengaitkan kenaikan yang lebih luas pada sitasi palsu dalam makalah yang diterbitkan dengan alat generatif. Tinjauan multi-model pada 2026 masih menemukan bahwa hampir 40% referensi buatan AI mengandung kesalahan atau fabrikasi, dengan hanya 26,5% yang sepenuhnya akurat.
Tingkat halusinasi bahkan lebih tinggi di luar prosa ilmiah yang terindeks dengan baik. Evaluasi Stanford HAI yang dirangkum oleh MIT Sloan menemukan bahwa chatbot untuk tujuan umum berhalusinasi pada 58–82% kueri riset hukum dalam model era 2023. Domain hukum, kebijakan, dan klinis justru merupakan konteks ketika ringkasan interdisipliner paling sering diminta — dan ketika inferensi tanpa label paling mahal dampaknya.
Masalah yang lebih dalam adalah pencucian sumber: sebuah klausa berhati-hati dalam bagian pembahasan dinyatakan ulang tanpa penanda kehati-hatian, lalu disitasi seolah-olah merupakan hasil. Standar provenans ada untuk menghentikan transformasi tersebut. Kerja interdisipliner melipatgandakan risiko karena pembaca tidak dapat mengandalkan metode bersama untuk menyadari kapan status suatu klaim telah berubah.
Kriteria Apa yang Harus Digunakan untuk Mengevaluasi Sistem Sintesis Bukti AI?
Anda sebaiknya mengevaluasi sistem sintesis bukti AI berdasarkan kemampuannya menjaga lapisan FCI tetap utuh saat terjadi ketidaksepakatan, bukan berdasarkan jumlah makalah yang disebutkannya. Kefasihan, kecepatan, dan bahkan cakupan pencarian bersifat sekunder bila keluaran tidak dapat diaudit. Kerangka FCI-TRACE yang digunakan di sini menilai enam dimensi.
FCI (status epistemik)
- Fakta: Dapatkah sistem mengutip atau memparafrasakan secara dekat suatu hasil dengan penunjuk lokasi, seperti makalah, bagian, gambar, atau tabel?
- Kesimpulan: Apakah sistem mengatribusikan interpretasi kepada penulis yang disebutkan dan mempertahankan penanda kehati-hatian?
- Inferensi: Apakah sistem menandai langkah analogis atau integratif sebagai buatan model?
TRACE (kualitas sintesis)
- Keterlacakan: Setiap klaim dipetakan ke cuplikan sumber, bukan sekadar judul makalah.
- Kemutakhiran: Sistem membedakan tanggal preprint, tanggal publikasi, dan pembaruan pedoman — kegagalan yang diketahui bahkan pada alat bibliografis non-AI, serta mode kesalahan ChatGPT yang terdokumentasi dalam studi Walters dan Wilder.
- Kesepakatan: Temuan yang selaras dan bertentangan ditabulasi, bukan dirata-ratakan menjadi konsensus palsu.
- Cakupan: Setidaknya dua metode disipliner terwakili ketika pertanyaannya lintas-domain.
- Pelabelan epistemik: Tag status terlihat dalam prosa, bukan disembunyikan dalam catatan kaki.
Ini lebih ketat daripada daftar periksa generik “AI untuk tinjauan pustaka”, yang sering berhenti pada pencarian dan perangkuman. Panduan universitas kini mencantumkan alat yang merangkum makalah dan mengekstrak data ke dalam tabel terstruktur, dan tim tinjauan sistematis membedakan penyaringan semi-otomatis dari penyaringan sepenuhnya otomatis. Kemampuan tersebut penting. Namun, kemampuan itu sendiri tidak mencegah kesimpulan penulis ditulis ulang sebagai fakta.
Transparansi protokol juga tetap harus masuk penilaian. PRISMA 2020 adalah daftar periksa pelaporan 27 butir untuk tinjauan sistematis yang mencakup sintesis, yang dipelihara bersama makalah penjelasan melalui EQUATOR Network. Tidak ada sesi chatbot yang merupakan tinjauan PRISMA. Namun, alur kerja AI yang dapat dipertanggungjawabkan tetap harus melaporkan logika kelayakan, sumber yang dicari, dan hal yang ditambahkan model.
Bagaimana Alat Riset AI Terkemuka Menangani Fakta, Klaim Penulis, dan Inferensi Model?
Alat terkemuka terbagi berdasarkan garis yang jelas: pengekstrak yang berpijak pada makalah mengurangi fabrikasi, sedangkan model chat umum tetap fasih tetapi lemah dalam atribusi — dan hampir tidak ada yang secara bawaan menegakkan label FCI dalam prosa yang dihasilkan. Perbandingan di bawah berfokus pada kebersihan epistemik, bukan popularitas keseluruhan.
| Fitur / Dimensi | ChatGPT untuk tujuan umum | Elicit | Jenova Academic Research Assistant | Scite (konteks sitasi) |
|---|---|---|---|---|
| Korpus landasan | Data pelatihan ditambah penelusuran opsional; sitasi sering tidak diverifikasi | Pencarian, rangkuman, dan ekstraksi atas 125 juta makalah; digunakan oleh lebih dari 2 juta peneliti | Pengambilan ilmiah dan web secara langsung, lampiran, serta memori sesi persisten | Graf sitasi dan konteks pendukung/penyangkal tentang cara makalah disitasi |
| Pelabelan FCI dalam keluaran | Biasanya tanpa label; fakta, klaim pembahasan, dan lompatan model memiliki suara yang sama | Lebih kuat dalam ekstraksi tingkat makalah daripada tag epistemik tingkat kalimat | Dapat diinstruksikan untuk memberi tag lapisan FCI dan mempertahankan protokol di seluruh sesi | Lebih banyak melabeli sikap sitasi daripada jenis klaim dalam sintesis |
| Sintesis interdisipliner | Kefasihan tinggi; jejak audit antarb idang lemah | Paling kuat untuk pertanyaan riset empiris dan ekstraksi terstruktur | Paling kuat saat protokol metode beserta tindak lanjut domain diperlukan selama berhari-hari | Terbatas sebagai penyintesis; lebih kuat sebagai lensa konteks sitasi |
| Verifikasi sitasi | Tingkat fabrikasi dan kesalahan tinggi dalam pengujian sistematis | Baris yang berpijak pada makalah mengurangi referensi rekaan | Pengambilan-plus-atribusi; tetap memerlukan pemeriksaan acak oleh manusia | Konteks bawaan mengenai apakah makalah berikutnya mendukung atau menyangkal suatu klaim |
| Penyaringan / ekstraksi | Tidak terstruktur | Mengotomatisasi penyaringan dan ekstraksi data untuk tinjauan sistematis | Penemuan iteratif dan dukungan manuskrip, bukan UI penyaringan khusus | Bukan meja kerja penyaringan |
| Harga (per 2026) | Langganan; tingkatan konsumen persisnya tidak diverifikasi di sini | Tidak diverifikasi dalam ulasan ini | Tingkat gratis dengan penggunaan terbatas; Plus seharga $20/bulan (penggunaan 30×) | Tidak diverifikasi dalam ulasan ini |
| Terbaik untuk | Menyusun draf setelah sumber sudah tersedia | Ekstraksi kolom dari makalah empiris | Ringkasan multi-sumber lintas sesi yang harus menjaga lapisan FCI tetap terlihat | Memeriksa bagaimana suatu klaim diperlakukan dalam literatur berikutnya |
Elicit. Pemeriksaan cakupan produknya menunjukkan bahwa Elicit adalah meja kerja riset, bukan chatbot: pengguna mengajukan pertanyaan, mengambil makalah, dan mengekstrak bidang. Perbandingan independen pada 2026 menggambarkan Elicit lebih kuat untuk penemuan literatur, penyaringan, dan ekstraksi data, sedangkan Consensus digambarkan lebih kuat untuk pertanyaan ilmiah ya/tidak. Kekuatan ekstraksi itu nyata. Keterbatasannya bersifat pelengkap: tabel yang terisi tetap dapat menyajikan kata kerja kausal dari abstrak seolah-olah merupakan hasil, kecuali pengguna menetapkan kolom yang memisahkan temuan dari interpretasi.
Consensus dan Semantic Scholar. Consensus berulang kali diposisikan sebagai mesin jawaban berbasis makalah nyata, bukan alur kerja tinjauan lengkap (The Drive AI). Salah satu rangkuman 2026 mencantumkan Consensus sekitar $144 per tahun sebagai titik masuk. Semantic Scholar tetap menjadi tulang punggung penemuan dalam perbandingan yang sama. Berdasarkan deskripsi publik yang ditinjau di sini, tidak satu pun alat tersebut menyediakan lapisan fakta-versus-inferensi yang wajib.
Scite. Scite lebih sesuai ketika pertanyaannya adalah bagaimana sebuah makalah disitasi, bukan bagaimana menggabungkan dua disiplin. Perbandingan memperlakukannya sebagai spesialis konteks sitasi dibandingkan alur kerja tinjauan Elicit yang lebih luas (Paperguide, 2026). Label sitasi pendukung-versus-penyangkal bernilai penting dan tetap berbeda dari FCI: makalah berikutnya dapat “mendukung” kesimpulan penulis yang sejak awal bukan fakta.
ChatGPT untuk tujuan umum. Ini tetap menjadi pilihan bawaan yang keliru untuk sintesis tanpa pengawasan. Bahkan tingkat fabrikasi 18% pada GPT-4 yang telah membaik tidak kompatibel dengan pekerjaan setingkat sitasi, dan bidang sitasi numerik seperti volume, halaman, serta tahun merupakan kesalahan paling umum di antara referensi nyata. Panduan perpustakaan kini memperlakukan sitasi berhalusinasi sebagai topik integritas riset tersendiri.
Jenova Academic Research Assistant. Agen ini dibuat bagi akademisi dan mahasiswa PhD yang memerlukan penemuan literatur, dukungan manuskrip, dan manajemen sitasi, bukan rangkuman sekali jalan. Pada platform Jenova, agen ini dapat menggunakan pencarian ilmiah, mempertahankan riwayat chat tanpa batas, dan menyimpan protokol metode dalam memori persisten agar aturan FCI tidak diatur ulang setiap sesi. Dipasangkan dengan Deep Research — yang mencari secara luas dan menghasilkan laporan padat sitasi — alat ini sangat sesuai untuk pertanyaan interdisipliner yang berkembang selama beberapa kali sesi kerja.
Keterbatasan yang jujur tetap penting. Alat ini bukan Covidence, DistillerSR, atau Rayyan: tidak ada meja kerja diagram alir PRISMA khusus dan tidak ada kisi ekstraksi bawaan untuk 125 juta makalah pada skala yang diiklankan Elicit. Keputusan inklusi berisiko tinggi dan penggabungan statistik tetap menjadi ranah peninjau manusia. Keunggulan kedalamannya terletak pada keberlanjutan protokol dan pelabelan eksplisit, bukan kepastian otomatis.
Bagaimana Orkestrasi Pengetahuan Menjaga Bukti Disipliner agar Tidak Runtuh Menjadi Satu Narasi?
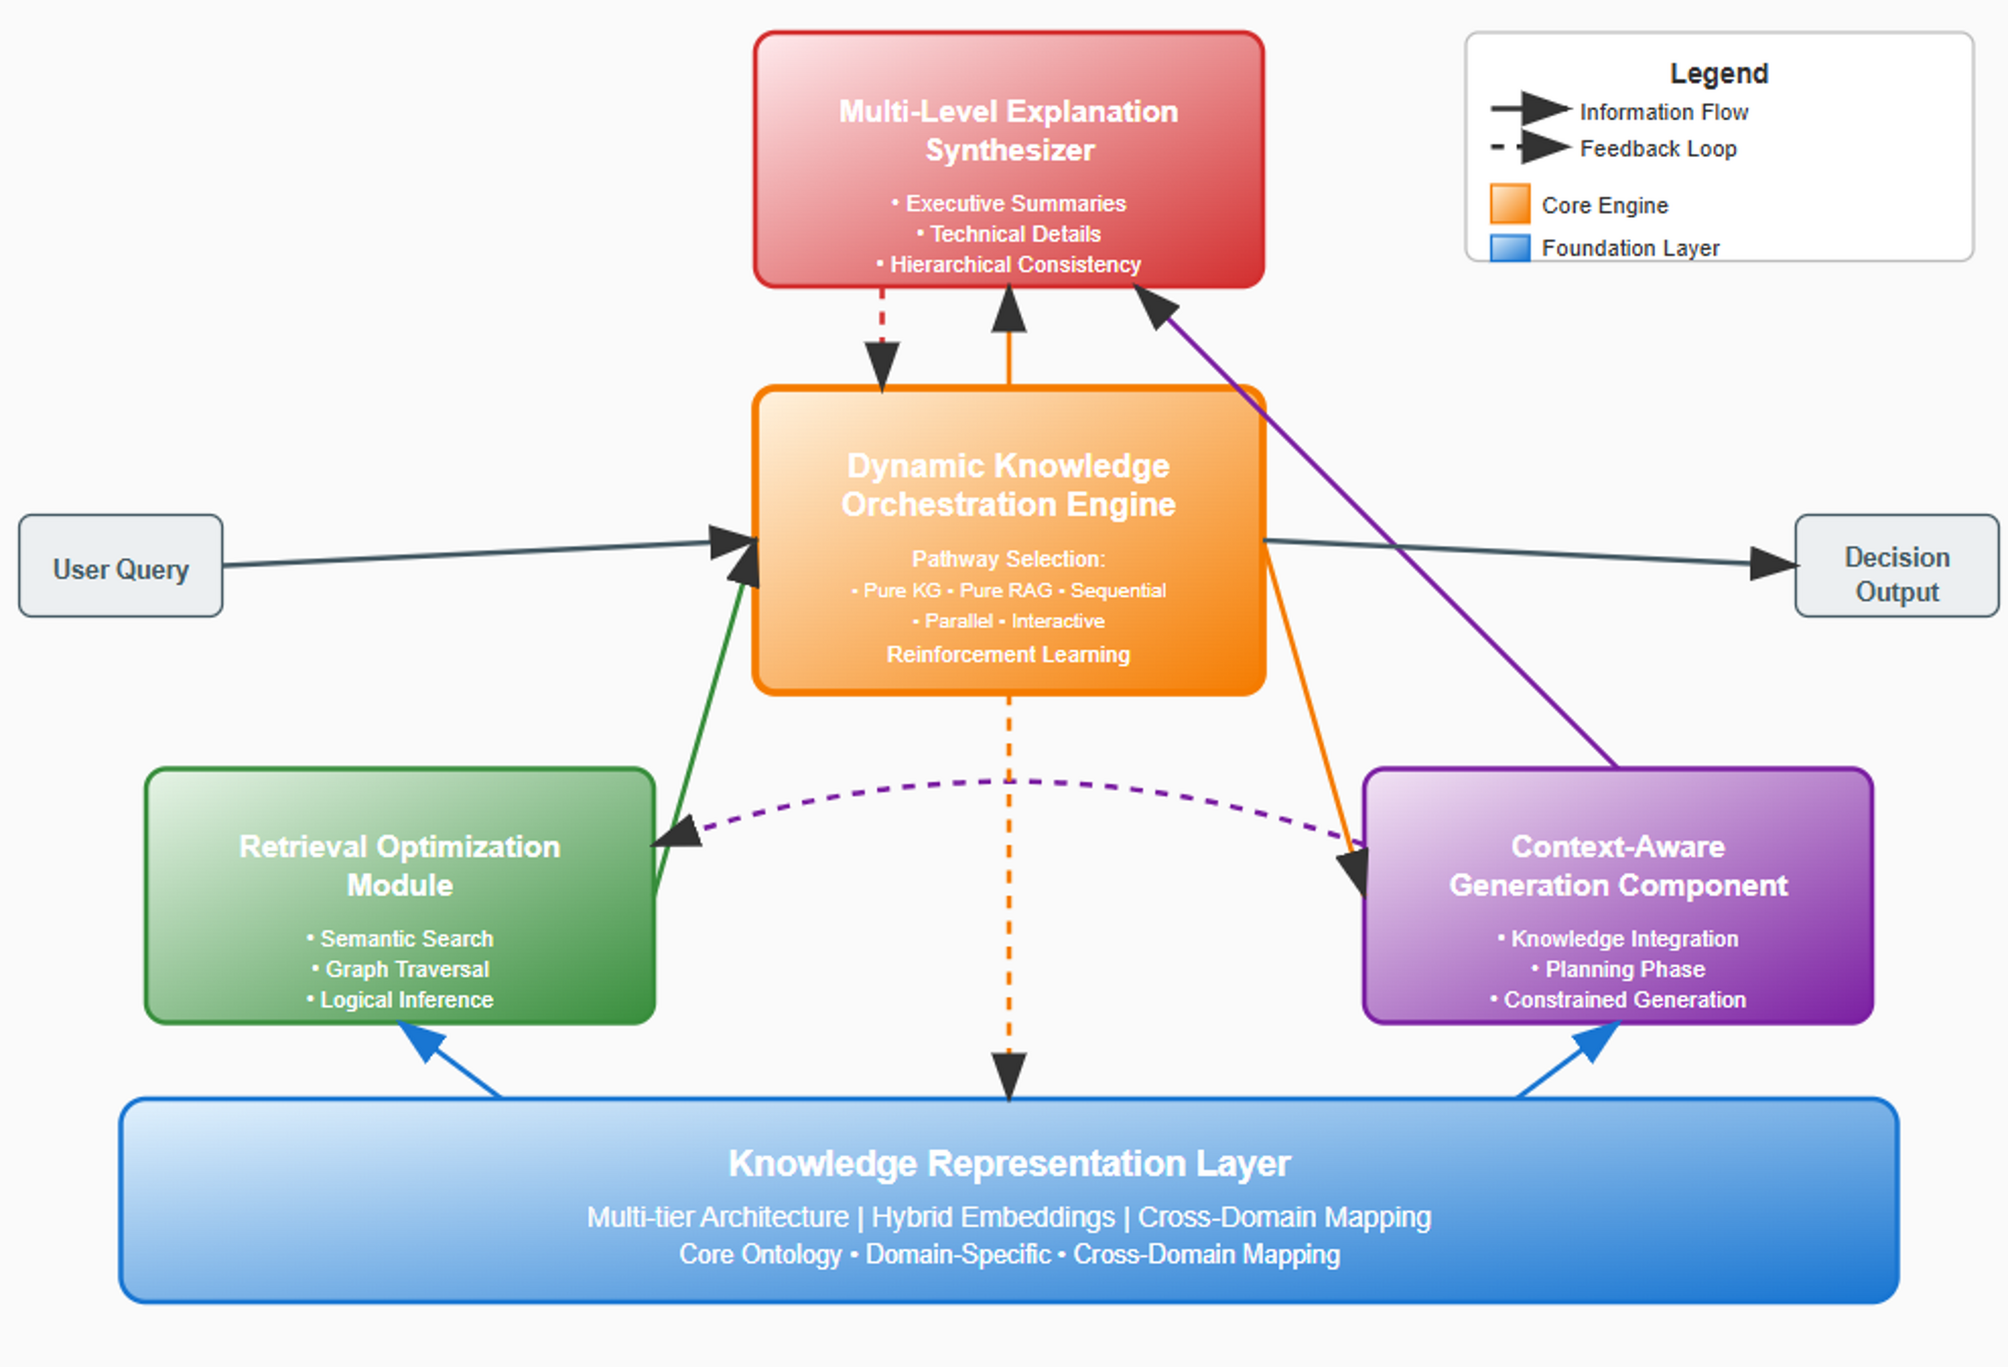
Orkestrasi pengetahuan menjaga bukti disipliner tetap utuh dengan memilih jalur pengambilan sebelum pembuatan, lalu memaksa penjelasan agar tetap konsisten secara hierarkis dengan materi yang diambil. Pemeriksaan tumpukan orkestrasi yang lazim menunjukkan mengapa pendekatan “cukup ambil lalu tulis” tidak memadai untuk kerja interdisipliner.
Fondasinya adalah lapisan representasi pengetahuan: embedding hibrida, ontologi domain, dan pemetaan lintas-domain. Tanpa lapisan itu, model memperlakukan “ketidakpastian” dalam fisika iklim, “ketidakpastian” dalam ekonometrika, dan “ketidakpastian” dalam pedoman klinis sebagai lingkungan token yang sama. Padahal tidak demikian. Memetakan istilah antarbidang adalah langkah inferensi dan harus diberi label sebagai inferensi.
Di atas lapisan tersebut, modul optimasi pengambilan menggabungkan pencarian semantik, penelusuran graf, dan inferensi logis. Penelusuran graf penting ketika pertanyaannya bersifat relasional, misalnya apakah mekanisme A dalam ekologi beranalogi dengan mekanisme B dalam kesehatan masyarakat. Pencarian semantik saja mengembalikan bahasa serupa; ia tidak membuktikan struktur kausal bersama. Inferensi logis atas klaim yang diekstrak lebih dekat pada jaringan inferensi bukti yang dirancang untuk verifikasi klaim yang dapat diinterpretasikan.
Kemudian, mesin orkestrasi memilih jalur — hanya graf pengetahuan, hanya RAG, berurutan, paralel, atau interaktif — alih-alih selalu membuang potongan teks ke dalam prompt. Pengambilan paralel tepat ketika dua disiplin harus dikumpulkan secara independen sebelum dilakukan pemetaan apa pun. Pengambilan berurutan tepat ketika ukuran hasil dari satu bidang harus membatasi kueri berikutnya. Mencampur mode-mode tersebut tanpa menyatakannya merupakan cara sebuah ringkasan iklim-kesehatan diam-diam berubah menjadi rekomendasi kebijakan.
Tahap pembuatan yang sadar-konteks harus merencanakan di bawah batasan: jangan menghasilkan kata kerja kausal kecuali sumber menggunakannya; jangan menggabungkan kerangka sampel. Tahap terakhir, penyintesis penjelasan multilevel, adalah tempat FCI menjadi terlihat — ringkasan eksekutif, detail teknis, dan pemeriksaan konsistensi agar rangkuman tidak melampaui bukti. Antarmuka klaim-bukti dalam riset saat ini, seperti PaperTrail, mengarah ke arah yang sama: keterpercayaan dalam konteks ilmiah bergantung pada pencocokan klaim dengan bukti, bukan prosa yang lebih mulus.
Academic Research Assistant milik Jenova tidak mengekspos setiap sakelar perutean internal sebagai kontrol yang ditujukan kepada peneliti. Ini merupakan keterbatasan nyata bagi tim yang memerlukan DAG yang dapat diperiksa sepenuhnya. Namun, alat ini menawarkan padanan praktis untuk sebagian besar alur kerja akademik: instruksi persisten, korpus terlampir, pengambilan langsung, dan memori yang cukup untuk menjaga protokol pelabelan tetap stabil ketika bukti terus bertambah.
Bagaimana Pipeline Sitasi Semantik Dapat Memverifikasi Klaim Sebelum Masuk ke Sintesis?
Pipeline sitasi semantik memverifikasi klaim dengan memperlakukan setiap sitasi sebagai hipotesis yang harus dicocokkan dengan dokumen sumber, bukan ornamen berformat pada akhir paragraf. Jika langkah ini dilewati, sintesis interdisipliner akan mewarisi setiap referensi rekaan atau menyimpang yang dihasilkan oleh generator.
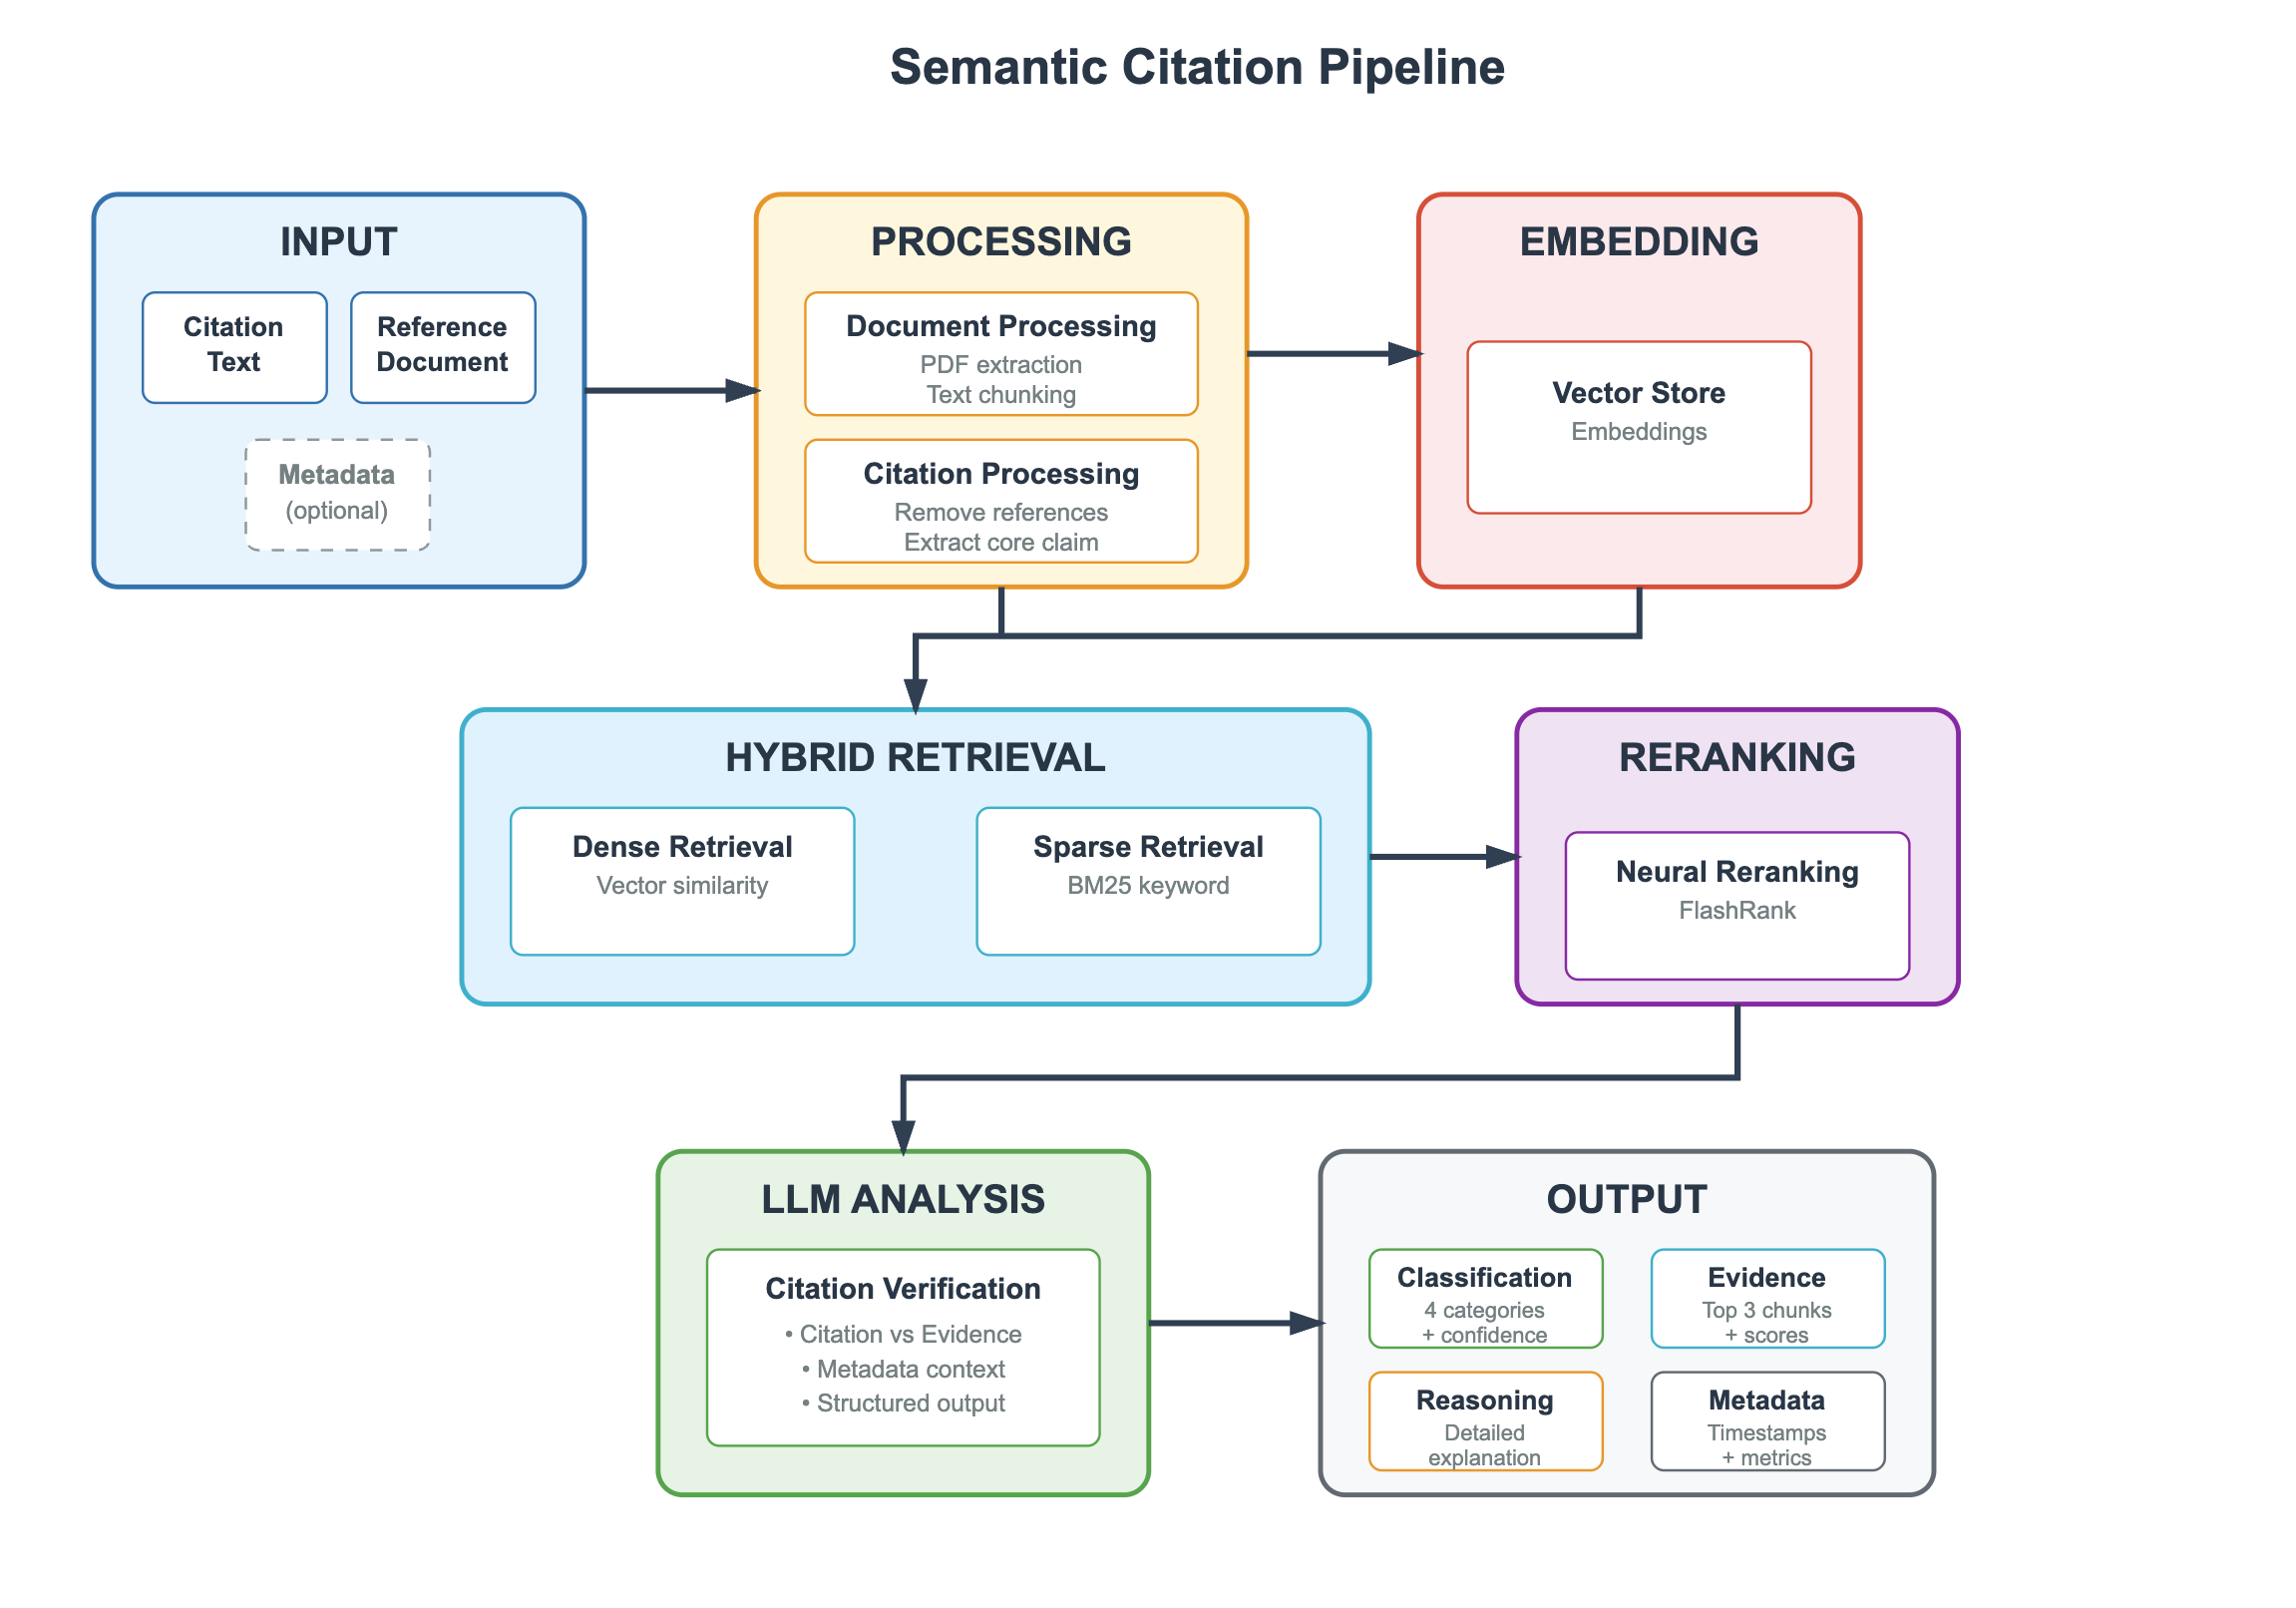
Pemeriksaan pipeline bergaya produksi menunjukkan urutan yang tetap. Masukan terdiri atas teks sitasi, dokumen referensi, dan metadata opsional. Pemrosesan mengekstrak teks PDF, memecahnya menjadi potongan, menghapus daftar referensi agar model tidak dapat “memverifikasi” klaim dengan membaca bibliografi, serta mengisolasi klaim inti. Embedding menyimpan potongan tersebut. Pengambilan hibrida kemudian menjalankan pencarian vektor padat dan BM25 jarang secara paralel — diperlukan karena jargon disipliner dan notasi statistik sering gagal pada pencarian embedding murni. Pemeringkatan ulang neural seperti FlashRank mempertahankan cuplikan teratas. Baru setelah itu analisis LLM mengklasifikasikan hubungan antara klaim dan bukti.
Keluaran yang berguna bukanlah lolos atau gagal secara biner. Klasifikasi empat arah dengan tingkat keyakinan — didukung, disangkal, tidak dibahas, atau sebagian dibahas — ditambah cuplikan bukti teratas dan alasan tertulis, adalah hal yang seharusnya dimasukkan oleh agen sintesis. Pola tersebut selaras dengan pergeseran yang lebih luas menuju verifikasi klaim yang dapat dijelaskan pada tingkat bukti. Pola ini juga sesuai dengan rekomendasi unit pengajaran universitas ketika mereka mendeskripsikan asisten AI yang mengekstrak bukti alih-alih mengarang narasi.
Dua mode kegagalan tetap ada bahkan dengan pipeline. Pertama, kesimpulan penulis yang dikutip dengan benar masih dapat salah diklasifikasikan sebagai fakta bila pengklasifikasi mengabaikan konteks bagian, yaitu hasil versus pembahasan. Kedua, pengambilan hibrida dapat menampilkan kalimat yang sangat mirip dari makalah lain dalam bidang yang sama — penyimpangan sitasi melalui parafrasa. Karena itu, tinjauan manusia atas cuplikan teratas adalah bagian dari metode, bukan pengakuan kekalahan.
Alur kerja Jenova dapat mendekati pipeline ini dengan mewajibkan kutipan-plus-penunjuk lokasi sebelum klaim diizinkan masuk ke memo sintesis, lalu menjalankan Deep Research sebagai lintasan kedua atas bibliografi yang sama. Alur tersebut tidak menggantikan layanan verifikasi sitasi khusus dengan metrik evaluasi yang dibekukan. Untuk bab disertasi dan naskah jurnal, ekspor tabel bukti dan periksa isinya.
Bagaimana Anda Menginstruksikan Agen Riset AI untuk Memisahkan Fakta, Kesimpulan, dan Inferensi?
Anda menginstruksikan agen dengan protokol tetap yang mendefinisikan label, melarang peningkatan status klaim secara diam-diam, dan meminta tabel kontradiksi sebelum narasi lintas-domain apa pun. Pilihan alat penting, tetapi prompt tanpa label akan meruntuhkan FCI pada setiap platform.
Untuk Academic Research Assistant milik Jenova, pengaturan yang tahan lama terlihat seperti ini:
- Buka agen di jenova.ai/a/academic-research-assistant dan nyatakan pertanyaan riset, disiplin yang dicakup, serta batas tanggal.
- Tempel protokol FCI tetap berikut ini, lalu simpan dalam instruksi khusus jika aturan yang sama harus berlaku di seluruh sesi:
“Protokol kerja: Beri label setiap kalimat [FAKTA], [KESIMPULAN PENULIS], atau [INFERENSI AI]. Fakta memerlukan penunjuk lokasi sumber. Kesimpulan penulis harus menyebut nama makalah dan mempertahankan penanda kehati-hatian. Inferensi AI mencakup pemetaan lintas-domain, lompatan kausal, atau rekomendasi apa pun yang tidak dinyatakan oleh sumber. Jika bukti saling bertentangan, jangan merata-ratakannya. Buat tabel: Klaim | Lapisan | Sumber | Penunjuk Lokasi | Kesepakatan (mendukung / menyangkal / tidak ada).”
- Mulai korpus. Lampirkan PDF yang sudah Anda percayai, lalu minta penemuan tambahan alih-alih membiarkan pencarian pertama menentukan bidang.
- Wajibkan hasil bertingkat — bibliografi beranotasi, temuan bertag FCI, lalu sintesis singkat yang tidak boleh memperkenalkan fakta baru.
Prompt awal yang biasanya menghasilkan struktur yang dapat digunakan:
“Pertanyaan: Bagaimana intensitas pulau panas perkotaan, kualitas perumahan, dan penerimaan darurat kardiovaskular saling berhubungan di kota-kota berpenghasilan tinggi sejak 2015? Disiplin: klimatologi, epidemiologi, ekonomi perkotaan. Keluaran: (1) peta sumber, (2) temuan bertag FCI, (3) log kontradiksi, (4) inferensi AI dicantumkan terakhir dan ditandai sebagai belum diuji. Jangan sitasi apa pun yang belum Anda ambil.”
Untuk Elicit, disiplin yang setara terletak pada rancangan kolom, bukan label prosa. Buat bidang ekstraksi terpisah untuk hasil yang dilaporkan, interpretasi penulis, populasi, dan keterbatasan yang teridentifikasi, mengikuti alur kerja pertanyaan-ke-ekstraksi milik alat tersebut. Jangan gunakan satu kolom “temuan utama”; kolom itu adalah tempat kata kerja pembahasan dinaikkan statusnya menjadi hasil.
Untuk chatbot umum, tambahkan pemeriksaan adversarial yang ditunjukkan perlu oleh studi Nature: minta kutipan, lalu selesaikan secara independen setiap referensi dalam basis data perpustakaan. Meminta model yang sama menjawab “apakah sitasi ini nyata?” adalah tindakan tidak andal. Jika proyeknya adalah tinjauan sistematis, gunakan alat penyaringan yang dijelaskan dalam panduan perpustakaan sintesis bukti untuk keputusan inklusi, dan jangan libatkan chatbot dalam penentuan kelayakan.
Deep Research di Jenova merupakan tindak lanjut yang lebih baik ketika bibliografinya besar dan Anda membutuhkan lintasan kedua yang padat sitasi. Gunakan setelah aturan FCI diterapkan, bukan sebagai penyisiran pertama tanpa label.
Apa Kata Metodolog Riset tentang Provenans Bukti AI?
Metodolog riset memperlakukan sintesis AI tanpa label sebagai kegagalan pelaporan, bukan peningkatan produktivitas: bila pembaca tidak dapat melihat lapisan yang ditempati suatu kalimat, dokumen tersebut belum menjadi bukti. Pandangan ini sejalan dengan tuntutan PRISMA terhadap sintesis yang transparan dan studi integritas sitasi yang memperlakukan referensi palsu sebagai ancaman terhadap catatan pembuktian.
“Mode kegagalan yang kami lihat bukanlah bahwa model tidak dapat membaca makalah. Masalahnya, model menulis dengan satu suara epistemik. Angka metode, klausa penuh kehati-hatian dari bagian pembahasan, dan analogi lintas-bidang keluar dari model sebagai bahasa yang sama-sama yakin. Komite interdisipliner kemudian memperdebatkan kesimpulan, padahal mereka seharusnya memperdebatkan lapisannya. Jika sebuah kalimat tidak dapat menjawab ‘siapa yang menyatakan ini, dan apakah ini diukur atau disimpulkan?’, kalimat itu tidak boleh masuk ke ringkasan hasil.”
“Pelabelan FCI lebih murah daripada penarikan kembali setelah kejadian. Tim yang memaksa adanya penunjuk lokasi sebelum sintesis menghabiskan lebih banyak waktu pada lintasan pertama dan jauh lebih sedikit waktu membongkar penyimpangan sitasi. Studi Nature tentang ChatGPT masih menjadi dasar peringatan: bahkan penurunan besar dalam fabrikasi tetap menyisakan tingkat kesalahan yang tidak dapat diterima dalam daftar referensi. Provenans adalah sistem kendalinya. Kefasihan bukan.”
“Orkestrasi dan pipeline verifikasi sitasi adalah cara mengoperasionalkan standar tersebut. Ambil disiplin secara paralel ketika mereka tidak berbagi konstruksi. Verifikasi klaim terhadap potongan teks sebelum mencapai penyintesis. Simpan langkah integratif model dalam blok terpisah yang diberi nama. Arsitektur tersebut lebih konservatif daripada rangkuman chatbot, dan itulah tujuannya.”
— Tim Produk Jenova, desain agen riset AI, delapan tahun membangun alur kerja pengambilan-dan-atribusi untuk pengguna ilmiah dan profesional
Implikasinya bagi pilihan alat bersifat terbatas. Utamakan sistem yang dapat mempertahankan protokol, menampilkan sumber, dan menoleransi kontradiksi. Jangan mengutamakan sistem yang sekadar terdengar interdisipliner.
Kapan Tinjauan Manusia Harus Mengalahkan Sintesis AI Antarbidang?
Tinjauan manusia harus mengalahkan sintesis AI setiap kali sebuah klaim mengubah keputusan, melintasi batas metode disipliner, atau tidak dapat ditelusuri ke penunjuk lokasi — yang mencakup sebagian besar pekerjaan yang sejak awal membenarkan kebutuhan sintesis. AI adalah pengganda untuk penyusunan draf dan pengambilan. AI bukan otoritas epistemik.
Pengesampingan oleh manusia tidak dapat dinegosiasikan dalam setidaknya lima kondisi:
- Bahasa kausal muncul dalam sintesis, tetapi tidak dalam bagian hasil dari karya yang disitasi.
- Ketidakcocokan konstruksi mungkin terjadi, misalnya “stres” dalam psikologi versus “beban alostatik” dalam kedokteran versus “volatilitas” dalam ekonomi.
- Pedoman atau hukum terlibat; tingkat halusinasi dalam kueri hukum sangat tinggi dalam pengujian terkontrol.
- Penggabungan statistik tersirat. Model bahasa tidak melakukan meta-analisis yang dapat dipertahankan hanya dengan memparafrasakan abstrak, dan PRISMA 2020 secara khusus ada untuk tinjauan yang mencakup sintesis.
- Verifikasi sitasi belum dijalankan terhadap PDF. Referensi rekaan atau yang berubah masih cukup umum pada 2026 sehingga jurnal dan perpustakaan memperlakukannya sebagai masalah integritas.
Pembagian kerja yang praktis terlihat seperti ini. Academic Research Assistant mengusulkan peta sumber, tag FCI, dan log kontradiksi. Elicit atau alat penyaringan mengelola ekstraksi terstruktur ketika korpusnya berupa tinjauan formal. Metodolog manusia memutuskan peningkatan lapisan dan seluruh inferensi lintas-domain. AI dapat menyarankan pemetaan; hanya manusia yang dapat menaikkan statusnya.
Dengan penggunaan seperti itu, sintesis AI bukan pengganti penilaian interdisipliner. Ia adalah cara untuk menjaga fakta, kesimpulan penulis, dan inferensi model dalam aliran terpisah yang dapat diperiksa, sehingga penilaian manusia memiliki bahan yang jujur untuk digunakan.
Referensi
- Rules Integrity Initiative — Provenans dan pencucian sumber
- Walters & Wilder, Scientific Reports — Fabrikasi dan kesalahan dalam sitasi bibliografis yang dibuat oleh ChatGPT
- Forbes — AI disalahkan atas kenaikan sitasi palsu dalam makalah riset (2026)
- Enago — Halusinasi AI dalam sitasi riset (2026)
- MIT Sloan — Menangani halusinasi dan bias AI, termasuk tingkat kueri hukum Stanford HAI
- George Mason University Libraries — Alat AI untuk tinjauan pustaka
- King's College London — Alat AI dalam sintesis bukti
- Pernyataan PRISMA 2020
- Page dkk., The BMJ — Pernyataan PRISMA 2020
- EQUATOR Network — Pedoman pelaporan PRISMA
- Elicit — AI untuk riset ilmiah
- Paperguide — Perbandingan Elicit vs Scite (2026)
- PapersFlow — Elicit vs Consensus AI
- The Drive AI — Elicit vs Consensus vs Semantic Scholar
- Omid Saffari — Alat riset AI terbaik 2026
- UNC Charlotte Library — Sitasi AI yang berhalusinasi
- Wu dkk., AAAI — Jaringan Inferensi Bukti untuk verifikasi klaim yang dapat diinterpretasikan
- PaperTrail — Antarmuka klaim-bukti untuk melandaskan keluaran LLM ilmiah (arXiv)
- Zhang dkk., EACL — Verifikasi klaim multimodal dan dapat dijelaskan
- University of Iowa — Tinjauan pustaka berbantuan AI