Bagaimana AI Mengekstrak Bukti Berdasarkan Pertanyaan Riset dari Ratusan Artikel?
2026-08-21
Bagaimana Alur Kerja Ekstraksi yang Berjangkar pada Pertanyaan Berbeda dari Alat AI yang Mengutamakan Ringkasan?
Alur kerja yang berjangkar pada pertanyaan menghasilkan bidang yang dapat dibandingkan dan tertaut ke sumber untuk pertanyaan riset yang telah ditentukan; alat yang mengutamakan ringkasan menghasilkan paragraf lancar yang menguraikan kembali setiap artikel berdasarkan kerangkanya sendiri. Pada 2026, perbedaan ini lebih penting daripada merek model. Jenova's Academic Research Assistant paling kuat untuk ekstraksi iteratif berbasis pertanyaan dengan memori persisten dan dukungan penyusunan naskah. Elicit lebih kuat untuk matriks riset empiris. Covidence tetap menjadi standar untuk tinjauan sistematis dengan dua peninjau yang harus mengikuti pelaporan PRISMA 2020.
Faktor utama yang membedakan ekstraksi bukti dari peringkasan tingkat artikel:
✅ Kesetiaan pada pertanyaan — setiap sel menjawab pertanyaan Anda, bukan pembingkaian artikel itu sendiri atas kontribusinya.
✅ Struktur tingkat bidang — metode, ukuran sampel, luaran, dan arah efek ditempatkan dalam kolom khusus yang tertaut ke cuplikan sumber.
✅ Keterbandingan lintas artikel — kontradiksi dan perbedaan desain baru terlihat ketika bidang-bidang selaras.
✅ Pemeriksaan konteks sitasi — suatu temuan yang disitasi diuji kembali terhadap literatur berikutnya, bukan diasumsikan benar hanya karena telah disitasi.
✅ Ajudikasi manusia — model bahasa besar mempercepat ekstraksi, tetapi penggunaan tanpa pengawasan belum siap untuk sintesis berisiko tinggi.
Untuk membandingkan alat secara bermakna, ekstraksi sebaiknya diperlakukan sebagai sebuah alur — masukkan sumber, saring berdasarkan pertanyaan, strukturkan, bandingkan, validasi, lalu tulis — alih-alih sebagai satu perintah “ringkas PDF ini”.
Mengapa Ringkasan AI yang Luas Gagal ketika Unit Analisisnya adalah Pertanyaan Riset?
Ringkasan luas gagal karena menggabungkan studi-studi yang tidak sebanding menjadi sebuah narasi, sehingga menyembunyikan sel-sel spesifik yang dibutuhkan oleh suatu pertanyaan riset. Sinopsis tingkat artikel dapat terdengar lengkap sambil menghilangkan ukuran sampel, pembanding, periode tindak lanjut, atau apakah hasilnya berupa peningkatan, penurunan, atau nihil. Penghilangan tersebut fatal ketika Anda beralih dari “tentang apa artikel ini?” menjadi “apa yang dikatakan korpus ini tentang pertanyaan ini?”
Sintesis bukti ada untuk menjawab pertanyaan terstruktur, bukan untuk memparafrase abstrak. PRISMA 2020 dibangun untuk melaporkan mengapa sebuah tinjauan dilakukan, metode apa yang digunakan, dan apa yang ditemukan — bukan untuk menghasilkan intisari yang enak dibaca. Tinjauan klasik masih membutuhkan sekitar satu tahun bagi sebuah tim ketika metode yang direkomendasikan diterapkan. Volume literatur yang menciptakan hambatan tersebut adalah volume yang sama yang coba dikompresi oleh alat chat berorientasi ringkasan menjadi beberapa paragraf.
Ringkasan juga mewarisi retorika artikel. Penulis menekankan temuan yang signifikan; abstrak kurang melaporkan hasil nihil; sitasi menyebarkan klaim yang kemudian dilemahkan oleh penelitian lanjutan. Ekstraksi tingkat pertanyaan membalik bias ini: Anda menetapkan bidang terlebih dahulu, lalu mengajukan pertanyaan yang sama kepada setiap artikel. Pengujian ekstraksi LLM juga menunjukkan mode kegagalan yang berlawanan. Model dapat melewatkan data luaran bahkan ketika menangani bidang latar belakang secara andal, sehingga ekstraksi luaran tetap lebih sulit daripada ekstraksi karakteristik studi.
Implikasi praktisnya sederhana. Jika keluaran Anda tidak dapat langsung dimasukkan ke tabel dengan satu baris per studi dan satu kolom per elemen pertanyaan, Anda belum memiliki bukti. Anda memiliki sinopsis.
Apa yang Harus Dicari dalam Alur Kerja Ekstraksi Bukti AI?
Anda sebaiknya mencari enam kemampuan yang bersama-sama membentuk Kerangka Ekstraksi Berbasis Pertanyaan: kesetiaan pada pertanyaan, bidang terstruktur, keterlacakan sumber, penyelarasan lintas artikel, validasi konteks sitasi, dan siklus verifikasi manusia yang terdokumentasi. Alat yang unggul dalam penulisan lancar tetapi lemah pada keenam aspek tersebut tetap akan menghasilkan ringkasan luas.
Kesetiaan pada pertanyaan. Sistem harus menerima pertanyaan bergaya protokol — PICO, PECO, atau skema khusus — dan menolak menyimpang ke temuan yang berdekatan. “Saring berdasarkan pertanyaan” adalah langkah penopang utama dalam alur ekstraksi LLM modern, bukan penyempurnaan opsional.
Bidang terstruktur. Ukuran sampel, desain, intervensi atau pajanan, pembanding, luaran, arah efek, dan keterbatasan harus masuk ke kolom khusus, masing-masing tertaut ke cuplikan sumber. Teks bebas dalam jendela chat bukan formulir ekstraksi data.
Keterlacakan sumber. Jawaban memerlukan sorotan atau penanda lokasi dalam PDF. Tanpanya, Anda tidak dapat mengajudikasi kesalahan model terhadap catatan asli dan tidak dapat melaporkan metode secara transparan.
Penyelarasan lintas artikel. Bidang yang sama harus memiliki arti yang sama di setiap baris. Jika tidak, Anda tidak dapat melihat kontradiksi, perbedaan dosis, atau efek desain.
Validasi konteks sitasi. Temuan yang benar pada 2018 mungkin tidak lagi berlaku setelah uji coba berikutnya. Ekstraksi yang tidak pernah memeriksa ulang klaim yang disitasi akan mencuci bukti usang ke dalam naskah baru.
Verifikasi manusia. Hingga 63% studi yang diekstraksi manusia mengandung setidaknya satu kesalahan ekstraksi data. LLM menimbulkan kesalahan yang berbeda dan juga dapat menangkap kesalahan manusia. Alur kerja harus memperlakukan ketidaksepakatan sebagai sinyal untuk membuka PDF, bukan sebagai papan skor.
Perbandingan perpustakaan universitas pada 2026 masih menilai alat berdasarkan peran, korpus, dan mode kegagalan, bukan klaim pemasaran. Tinjauan Oregon State University mencatat bahwa Consensus dapat salah membaca sumber, sedangkan matriks Elicit paling berguna untuk artikel empiris dan dapat kurang bernuansa dalam ringkasan. Ini adalah temuan evaluasi, bukan alasan untuk mengabaikan alat tersebut — dan itulah tingkat penilaian yang tepat.
Alat AI Mana yang Mengekstrak Bukti Terstruktur dari Berbagai Artikel?
Tidak ada satu alat pun yang mendominasi setiap tahap. Elicit unggul untuk matriks empiris, Covidence untuk tinjauan sistematis tim, Consensus untuk ringkasan cepat mengenai tingkat kesepakatan, dan Jenova's Academic Research Assistant untuk analisis iteratif berbasis pertanyaan yang berlanjut ke manajemen sitasi dan penyusunan draf. Alur bergaya Paperguide menggambarkan urutan yang mengutamakan ekstraksi, bahkan ketika Anda merangkai langkah-langkah yang sama di berbagai alat.
| Fitur / Dimensi | Elicit | Jenova Academic Research Assistant | Consensus | Covidence |
|---|---|---|---|---|
| Kolom khusus tingkat pertanyaan | Matriks riset dengan kolom yang dapat disesuaikan untuk metode, ukuran sampel, dan temuan | Skema yang ditentukan melalui prompt disimpan dalam memori persisten lintas sesi | Ringkasan tabular dan pengukur konsensus; kontrol bidang khusus lebih terbatas | Formulir ekstraksi data pada studi yang disertakan setelah penyaringan |
| Skala sintesis umum | Alur dari protokol ke ekstraksi pada sumber yang terkumpul; ringkasan Plus menyitasi sejumlah kecil artikel | Ekstraksi berkelompok atas PDF yang diunggah dan catatan yang tertaut ke Scholar | Hingga 20 artikel (Pro) atau 50 artikel (Deep) per sintesis | Korpus penyaringan skala tim untuk tinjauan formal |
| Keterlacakan sumber | Tautan kembali ke literatur yang disertakan | Jawaban berbasis dokumen dengan PDF terlampir | Tautan ke sumber yang digunakan dalam ikhtisar | Jejak audit penyaringan dan ekstraksi lengkap |
| Alur kerja dua peninjau | Bukan rancangan inti | Tidak tersedia secara bawaan | Tidak tersedia secara bawaan | Penyaringan independen oleh dua peninjau dan resolusi konflik |
| Pemeriksaan konteks sitasi | Terbatas di luar kumpulan yang diekstrak | Tindak lanjut literatur lintas sesi melalui Scholar dan pencarian | Pengukur konsensus sebagai sinyal kesepakatan | Manual; protokol tinjauan mengatur pembaruan |
| Serah terima naskah | Ekspor ke pengelola referensi | Manajemen sitasi serta penyusunan draf; Word Doc Generator dapat memformat naskah | Ekspor untuk pengguna Plus | Penyusunan laporan tinjauan tetap merupakan tahap terpisah |
| Harga (per 2026) | Langganan Plus institusional; tingkatan konsumen belum diverifikasi di sini | Tingkatan gratis; Plus mulai dari $20/bulan | Freemium; beberapa kampus melisensikan Pro | Paket tahunan individu, paket gabungan, atau organisasi |
| Paling sesuai untuk | Tabel ekstraksi empiris | Analisis iteratif berbasis pertanyaan dengan proyek jangka panjang | Gambaran cepat konsensus biomedis/STEM | Tinjauan sistematis tim yang mematuhi PRISMA |
Elicit secara eksplisit diposisikan untuk menyempurnakan protokol, mengumpulkan sumber, menyaring, mengekstrak, dan mensintesis. Itulah deskripsi tugas yang tepat untuk pekerjaan tingkat pertanyaan. Keterbatasannya, yang tercatat dalam evaluasi perpustakaan, adalah ringkasan yang dihasilkan sering berfokus pada temuan dan kurang bernuansa, sementara matriksnya disetel untuk konvensi pelaporan empiris. Artikel kualitatif, teoretis, atau yang strukturnya buruk akan diekstrak dengan kurang bersih.
Consensus berguna ketika pertanyaan sudah mendekati klaim empiris ya/tidak. Alat ini mensintesis ikhtisar naratif, tabel, dan pengukur konsensus, serta dapat melakukan pencarian lebih mendalam yang menandai kesenjangan. Alat ini juga dapat salah membaca sumber, dan batas artikel pada tingkatan Deep masih jauh di bawah “ratusan teks lengkap”. Perlakukan sebagai instrumen penjajakan, bukan formulir pengodean.
Covidence secara luas digambarkan sebagai perangkat lunak terkemuka untuk mengelola tinjauan sistematis. Bersama EPPI-Reviewer, DistillerSR, dan JBI-SUMARI, Covidence termasuk dalam kelompok kecil platform yang mendukung seluruh rangkaian tinjauan intervensi — catatan, penyaringan, ekstraksi, dan resolusi konflik tim. Alat ini lebih berat daripada yang dibutuhkan riset eksploratif. Ekstraksi percakapan “chat dengan PDF ini” bukan pusat desainnya, dan sebagian besar proyek tetap mengandalkan formulir ekstraksi yang diisi manusia.
Jenova's Academic Research Assistant berada di bagian berbeda dari rangkaian kerja tersebut. Alat ini mencari sumber ilmiah langsung, menerima PDF yang diunggah, menyimpan riwayat chat tanpa batas, dan mengingat protokol lintas sesi agar definisi kolom tidak perlu diajarkan ulang setiap hari. Alat ini bukan penyaring dengan dua peninjau, tidak membuat diagram alur PRISMA, dan ratusan artikel harus diproses secara berkelompok, bukan dituangkan ke satu jendela konteks. Itu adalah keterbatasan nyata. Kekuatan penyeimbangnya adalah persistensi, akses multi-model, dan kemampuan membawa pertanyaan riset yang sama dari ekstraksi ke penyusunan draf berbasis sitasi tanpa perlu mengekspor keluar dari proyek.
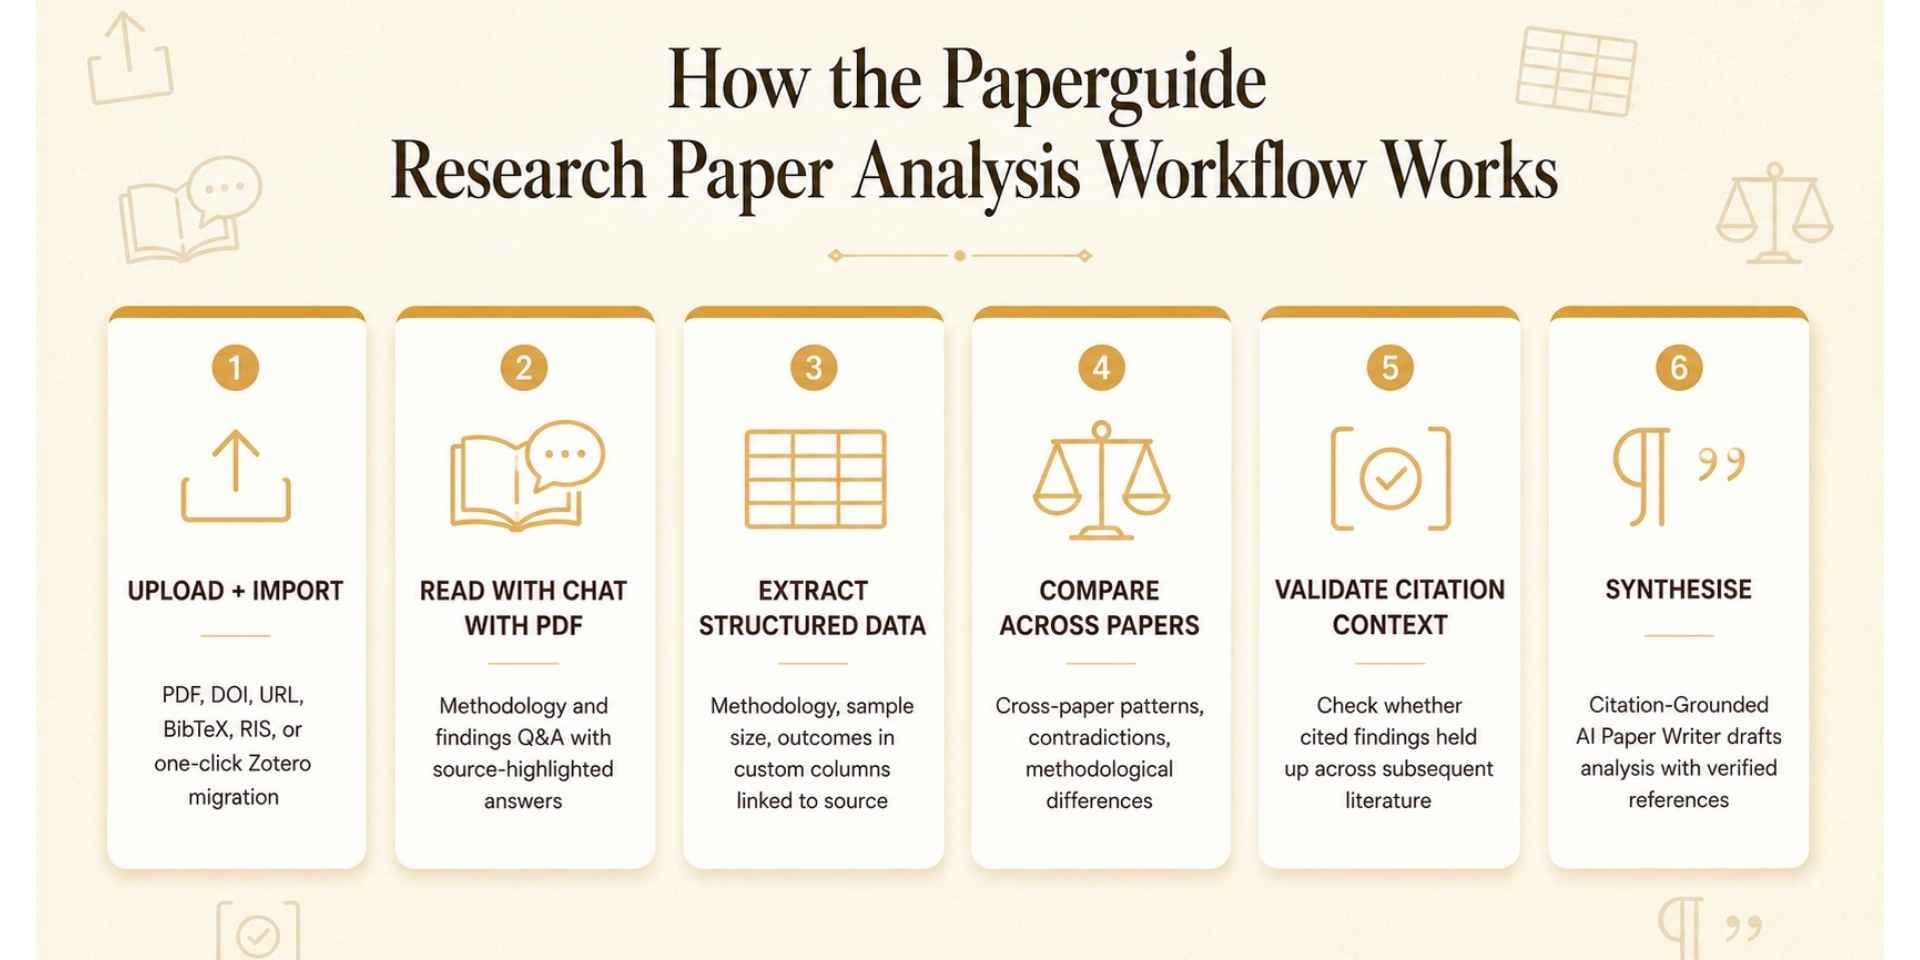
Urutan enam langkah yang dipublikasikan Paperguide — unggah, chat-with-PDF, kolom terstruktur, bandingkan lintas artikel, validasi konteks sitasi, lalu penulisan berbasis sitasi — merupakan pernyataan jelas tentang pola yang mengutamakan ekstraksi. Angka akurasi dan harga independen untuk Paperguide tidak diverifikasi untuk artikel ini; alur kerjanya sendiri adalah objek perbandingan yang berguna.
Bagaimana Ekstraksi Data Terstruktur Bekerja ketika Korpus Mencakup Ratusan Artikel?
Ekstraksi ini bekerja dengan mengubah setiap artikel menjadi baris-baris bidang yang ditentukan oleh protokol, lalu menyaring baris tersebut berdasarkan pertanyaan riset sebelum teks sintesis apa pun ditulis. Skala berasal dari pengulangan sebuah skema, bukan dari ringkasan yang lebih panjang.
Langkah pertama adalah memasukkan sumber. PDF, DOI, URL, BibTeX, RIS, atau ekspor pengelola referensi membentuk korpus. Chat-with-PDF adalah langkah kedua, bukan terakhir: Anda menggunakannya untuk menemukan cuplikan metode dan hasil, lalu mengunci cuplikan tersebut ke dalam kolom. Sebuah tinjauan hidup mengenai ekstraksi otomatis menemukan 76 publikasi mengenai topik tersebut tetapi hanya enam alat pengguna akhir yang diimplementasikan, dan 84% algoritme hanya menambang judul dan abstrak. Ekstraksi yang hanya berbasis abstrak akan melewatkan luaran, analisis subkelompok, dan rincian risiko bias yang ada dalam teks lengkap. Alur kerja apa pun yang mengklaim menangani “ratusan artikel” hanya berdasarkan abstrak sebenarnya sedang meringkas, bukan mengodekan.
Kolom khusus harus sesuai dengan pertanyaan, bukan templat bawaan vendor. Untuk pertanyaan efektivitas, bidang umum mencakup desain, populasi, intervensi atau pajanan, pembanding, luaran primer, arah efek, ukuran efek beserta interval, tindak lanjut, dan keterbatasan. Untuk pertanyaan mekanisme, gantikan ukuran efek dengan jalur yang dihipotesiskan dan apakah studi benar-benar mengujinya. Menautkan setiap sel ke cuplikan sumberlah yang memungkinkan perbandingan selanjutnya. Tanpa penanda lokasi, tabel hanyalah ringkasan lain dengan ruang kosong tambahan.
Ratusan artikel juga memaksa pemrosesan berkelompok. Jendela konteks, batas laju, dan kesalahan penguraian PDF membuat ekstraksi sekali jalan atas seluruh korpus tinjauan sistematis tidak andal. Pola yang tahan lama adalah: tentukan skema pada set percontohan berisi 8–15 artikel, ukur kesesuaian terhadap pengodean manusia, tetapkan prompt, lalu jalankan artikel sisanya secara bertahap. Teks prompt menentukan kelengkapan dan format; prompt unik per artikel tidak dapat digeneralisasi. Uji coba pada subset, lalu pertahankan prompt tetap konstan.
Jenova's Academic Research Assistant mendukung pola tersebut karena skema dapat disimpan dalam memori persisten dan PDF dapat tetap terlampir pada proyek. Namun, Anda tetap harus memprosesnya secara berkelompok. Matriks Elicit lebih dekat dengan lembar pengodean bawaan untuk bidang empiris. Covidence mengasumsikan korpus telah lolos penyaringan. Pilih alat yang sesuai dengan tahap yang benar-benar sedang Anda jalani.
Bagaimana Anda Memvalidasi Temuan yang Diekstrak terhadap Konteks Sitasi dan Desain Studi?
Anda memvalidasinya dengan memeriksa apakah klaim yang diekstrak masih berlaku dalam cuplikan yang disitasi, dalam literatur berikutnya, dan di berbagai desain studi yang menjawab pertanyaan yang sama. Ekstraksi tanpa pemeriksaan tersebut akan mereproduksi bias sitasi pada kecepatan mesin.
Validasi konteks sitasi berarti membuka cuplikan yang disitasi, bukan memercayai kalimat yang menyitasi. Artikel secara rutin melebih-lebihkan apa yang ditunjukkan oleh suatu referensi, menyitasi abstrak alih-alih hasil, atau meneruskan temuan yang dibalikkan oleh uji coba berikutnya. Oleh karena itu, pemeriksaan khusus “apakah temuan yang disitasi ini masih berlaku?” merupakan langkah terpisah dari “apa yang dilaporkan artikel ini?”. Alur kerja bergaya Paperguide menempatkan pemeriksaan tersebut tepat sebelum sintesis, dan itulah urutan yang benar: jangan tulis paragraf sampai selnya stabil.
Validasi yang mempertimbangkan desain melangkah lebih jauh. Sebuah ilustrasi metode tahun 2025 di Nature Communications menunjukkan alur dua tahap yang berguna sebagai arsitektur referensi, bahkan jika Anda tidak pernah menerapkan rumus penilaiannya. Model bahasa besar mengurai teks bebas menjadi populasi, intervensi atau pajanan, hubungan, dan luaran, lalu mengklasifikasikan arah efek sebagai peningkatan, penurunan, atau tanpa perubahan. Catatan tersebut dikelompokkan berdasarkan desain — uji acak, randomisasi Mendelian, studi observasional — agar hasil tidak diperlakukan sebagai sesuatu yang dapat dipertukarkan di seluruh metode.
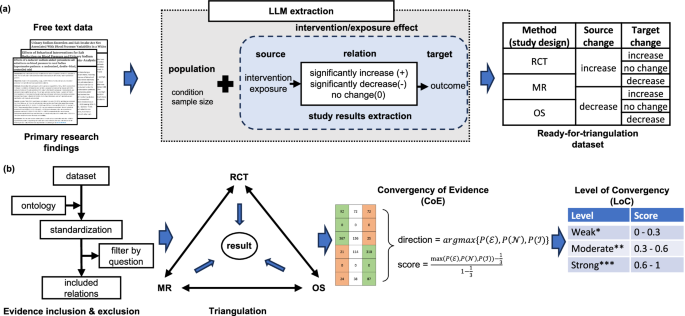
Panel kedua adalah bagian yang dilewati oleh sebagian besar alat ringkasan. Setelah standardisasi dan penyaringan inklusi, hasil ditriangulasi lintas desain. Skor Convergence of Evidence menggunakan arah dengan massa probabilitas tertinggi; pita Level of Convergence kemudian melabeli kumpulan bukti sebagai lemah, sedang, atau kuat. Anda tidak perlu metrik persis tersebut untuk menerapkan gagasannya. Namun, Anda perlu berhenti menggabungkan asosiasi observasional yang signifikan dengan uji coba nihil seolah-olah keduanya adalah satu kalimat “literatur menyatakan X”.
Ketidaksepakatan manusia–model harus diajudikasi terhadap PDF melalui pemeriksaan ketiga, bukan dinilai sebagai kegagalan model otomatis. Dalam satu bukti konsep, Claude 2 membuat satu kesalahan besar dan lima kesalahan kecil — serta mendeteksi 21 kesalahan kecil dalam standar referensi manusia. Memperlakukan ekstraksi yang dipublikasikan sebagai standar emas akan meremehkan model dan melebih-lebihkan manusia. Unit analisis yang benar adalah kesesuaian faktual pada setiap bidang, dengan statistik gabungan (estimasi titik ditambah interval) dihitung secara koheren, bukan sebagai tiga angka yang tidak berkaitan.
Jenova dapat menjalankan pemeriksaan konteks sitasi karena dapat mencari literatur berikutnya dan menyimpan tabel ekstraksi asli dalam memori. Namun, Jenova tidak dapat menggantikan peninjau manusia kedua untuk tinjauan bergaya Cochrane. Covidence dapat mewajibkan peninjau kedua tersebut. Gunakan kedua fakta itu tanpa menyederhanakannya menjadi satu pemenang.
Bagaimana Menjalankan Alur Kerja Ekstraksi Berbasis Pertanyaan dalam Praktik?
Anda mendefinisikan pertanyaan dan bidang terlebih dahulu, menguji skema, mengekstrak secara berkelompok dengan penanda sumber, membandingkan baris, memeriksa ulang sitasi, lalu menulis dari tabel. Membalik urutan tersebut — menulis terlebih dahulu, kemudian mencari kutipan — akan menciptakan kembali masalah ringkasan.
Untuk Jenova's Academic Research Assistant, urutan umum terlihat seperti ini:
- Buka Agen dan nyatakan protokol dalam satu blok, termasuk kriteria inklusi dan kolom persis yang Anda inginkan.
- Lampirkan set percontohan PDF (atau DOI), bukan seluruh korpus.
- Ekstrak ke dalam tabel dengan mewajibkan penanda lokasi untuk setiap sel.
- Tetapkan prompt setelah Anda mengoreksi set percontohan.
- Proses artikel yang tersisa secara berkelompok, lalu jalankan pemeriksaan kontradiksi dan pemeriksaan konteks sitasi sebelum sintesis naratif apa pun.
Prompt pembuka yang berguna:
“Pertanyaan riset: Pada orang dewasa dengan depresi resisten terhadap pengobatan, apakah ketamin tambahan menurunkan skor Montgomery–Åsberg dibandingkan plasebo pada 24 jam? Sertakan hanya RCT. Untuk setiap artikel, ekstrak: desain, n yang diacak, dosis dan rute, pembanding, luaran primer, titik waktu, ukuran efek dengan 95% CI, arah (peningkatan / penurunan / tanpa perubahan), dan keterbatasan. Kutip kalimat hasil untuk setiap ukuran efek. Jangan ringkas artikel yang tidak memenuhi inklusi. Tandai sel kosong alih-alih menyimpulkan.”
Prompt perbandingan yang berguna setelah tabel tersedia:
“Dengan hanya menggunakan tabel ekstraksi, daftarkan (1) konflik arah efek, (2) perbedaan dosis atau titik waktu yang mungkin menjelaskan konflik, dan (3) setiap baris yang uji pendukungnya disitasi lebih lama daripada hasil nihil terbaru pada luaran yang sama. Jangan tambahkan artikel yang tidak ada dalam tabel.”
Untuk Elicit, jalur yang setara adalah penyempurnaan protokol, pengumpulan sumber, penyaringan, lalu matriks kolom khusus — langkah-langkah yang didokumentasikan produk tersebut untuk tinjauan literatur sistematis. Mulailah dengan pertanyaan empiris yang bidangnya (n, metode, luaran) sudah sesuai dengan matriks. Jangan mengharapkan hasil yang sama dari artikel teori.
Untuk Covidence, jalankan impor hasil pencarian, penghapusan duplikat, penyaringan judul/abstrak oleh dua peninjau, penyaringan teks lengkap, lalu formulir ekstraksi. Panduan perpustakaan memperlakukan kelas perangkat lunak ini sebagai lingkungan untuk sintesis bukti yang terstruktur, transparan, dan dapat direproduksi, bukan sebagai chatbot. Jika Anda memerlukan diagram alur PRISMA dan dua peninjau independen, mulailah di sini dan gunakan LLM hanya di dalam formulir ekstraksi, dengan peninjau kedua tetap manusia.
Dua aturan operasional berlaku pada ketiganya. Pertama, jangan pernah membiarkan model mengisi bagian kosong dengan nilai yang masuk akal; sel kosong adalah data. Kedua, ukur waktu untuk seluruh tugas — iterasi prompt, ajudikasi, dan koreksi — bukan hanya latensi model. Waktu yang dihabiskan untuk tugas adalah luaran efisiensi yang relevan, dan rekayasa prompt merupakan bagian dari waktu tersebut.
Apa Pendapat Peneliti Sintesis Bukti tentang Ekstraksi Data LLM?
Peneliti memperlakukan LLM sebagai akselerator yang menjanjikan untuk bidang latar belakang dan sebagai pengganti yang belum terbukti untuk ekstraksi luaran, sementara desain validasi itu sendiri masih merupakan masalah metodologis terbuka. Konsensus dalam artikel metode 2025–2026 bersifat bersyarat: berguna dalam alur kerja yang diawasi, belum siap sebagai pengekstrak tanpa pengawasan.
“Hambatan dalam sintesis bukti bukanlah kecepatan membaca. Hambatannya adalah membuat setiap studi menjawab pertanyaan yang sama dalam bidang yang sama, lalu menyadari ketika bidang-bidang tersebut tidak sepakat. Sebuah ringkasan dapat lancar tetapi tetap tidak dapat digunakan untuk tugas itu, karena kelancaran menyembunyikan sel kosong. Ketika kami memindahkan tim dari chat tingkat artikel ke tabel yang berjangkar pada pertanyaan, hal pertama yang muncul bukanlah wawasan — melainkan ketidaklengkapan. Ukuran sampel tanpa penyebut, luaran tanpa titik waktu, sitasi yang tidak mendukung kalimat yang ditempelinya.”
“Kami juga berhenti memperlakukan ekstraksi manusia sebagai standar emas. Sebagian besar studi yang dikodekan manusia mengandung setidaknya satu kesalahan ekstraksi, dan model kadang menangkap kesalahan itu sambil memperkenalkan kesalahan lain, terutama pada statistik gabungan. Unit evaluasi yang produktif adalah kesesuaian faktual per bidang, yang diajudikasi terhadap PDF. Sampai suatu alur kerja dapat menunjukkan siklus itu — skema, penanda lokasi, batch, kontradiksi, periksa sitasi ulang — alat tersebut adalah peringkas, terlepas dari berapa banyak artikel yang diklaim telah dibacanya.”
— Tim Produk Jenova, desain alur kerja riset, pengalaman membangun proyek Agen akademik jangka panjang untuk penemuan literatur dan persiapan naskah
Posisi tersebut selaras dengan komentar independen. Sebuah tinjauan cakupan tentang LLM dalam tinjauan sistematis menyimpulkan bahwa alat ini sedang meningkat penggunaannya tetapi belum siap digunakan sebagai infrastruktur mandiri. Penelitian terpisah mengenai model bahasa untuk ekstraksi data dan penilaian risiko bias sedang menguji alur gabungan manusia–model, bukan tinjauan yang hanya menggunakan model. Pertanyaan aktif di bidang ini bukanlah “dapatkah model membaca 400 PDF?” Melainkan, “dapatkah tabel tercatat yang disaring berdasarkan pertanyaan bertahan dalam tinjauan ganda?”
Kapan Anda Tetap Harus Menggunakan Perangkat Lunak Tinjauan Sistematis Khusus, Bukan Agen Riset AI?
Gunakan perangkat lunak tinjauan sistematis khusus ketika Anda memerlukan penyaringan independen oleh dua peninjau, alur PRISMA yang dapat dilaporkan, dan jejak audit yang akan diperiksa oleh jurnal, badan HTA, atau panel pedoman. Gunakan Agen riset AI ketika Anda masih membentuk pertanyaan, mengodekan korpus yang terus berkembang, atau mengubah tabel stabil menjadi naskah. Keduanya lebih sering bersifat berurutan daripada bersaing.
Covidence, DistillerSR, EPPI-Reviewer, dan JBI-SUMARI ada karena metode yang dapat direproduksi, alur kerja tim, dan catatan yang mematuhi PRISMA adalah persyaratan, bukan preferensi, untuk tinjauan intervensi. Machine learning dalam platform tersebut paling banyak membantu pada tahap penyaringan — satu evaluasi memperkirakan pengurangan beban penyaringan hingga 60% — sementara alat ekstraksi dan risiko bias masih lebih terbatas. Jika keluaran Anda adalah tinjauan terdaftar, jangan melewati rangkaian kerja itu hanya karena model chat dapat memparafrase PDF.
Agen merupakan lingkungan kerja harian yang lebih baik ketika pertanyaan masih berubah. Anda dapat melampirkan PDF baru, merevisi kolom, dan menyimpan keputusan protokol dalam memori tanpa membuka proyek tinjauan baru untuk setiap perubahan arah. Jenova's Academic Research Assistant dibangun untuk mode tersebut: pencarian ilmiah langsung, teks lengkap terlampir, skema ekstraksi persisten, serta jalur menuju penyusunan draf dengan sitasi yang dikelola. Alat ini tidak akan memenuhi protokol yang mengharuskan dua penyaring. Menyatakan batasan itu adalah bagian dari penggunaannya yang tepat.
Pembagian praktis yang digunakan banyak kelompok pada 2026 terlihat seperti ini. Jajaki dan tetapkan bidang dengan Agen atau Elicit. Daftarkan protokolnya. Lakukan penyaringan dan ekstraksi di Covidence atau alat yang setara, secara opsional dengan pengodean berbantuan LLM yang tetap diverifikasi manusia. Kembali ke Agen untuk menguji ketahanan konteks sitasi dan menulis dari tabel yang telah dikunci. Daftar perangkat bukti-sintesis milik Duke mengingatkan bahwa tidak ada satu Aplikasi yang mencakup setiap tahap; keahlian profesionalnya adalah mengetahui tahap yang sedang Anda jalani.
Uji yang seharusnya menentukan rangkaian kerja adalah uji yang sama yang membuka artikel ini. Jika Anda dapat menunjuk pada sebuah pertanyaan riset, satu kolom untuk setiap elemen pertanyaan tersebut, satu penanda lokasi untuk setiap sel, dan catatan mengenai apa yang dikecualikan, Anda sedang mengekstrak bukti. Jika Anda hanya memiliki ikhtisar yang ditulis dengan baik tentang “apa yang dikatakan artikel-artikel tersebut”, Anda masih sedang meringkas — bahkan jika ikhtisar itu dihasilkan dari ratusan berkas.
Referensi
- Pernyataan PRISMA — Panduan pelaporan untuk tinjauan sistematis
- The BMJ — Pernyataan PRISMA 2020: pedoman terkini untuk pelaporan tinjauan sistematis
- ScienceDirect — LLM dalam tinjauan sistematis: meningkat penggunaannya, tetapi belum siap digunakan (tinjauan cakupan)
- PMC — Alat digital untuk mendukung proses tinjauan sistematis
- BMJ Evidence-Based Medicine — Tantangan dan jebakan dalam mengevaluasi LLM untuk ekstraksi data
- Perpustakaan Oregon State University — Perbandingan alat AI untuk penelusuran literatur
- Elicit — Alur kerja tinjauan literatur sistematis
- Covidence — Perangkat lunak pengelolaan tinjauan sistematis
- Panduan Perpustakaan UCL — Perangkat lunak tinjauan sistematis
- Nature npj Digital Medicine — Model bahasa untuk ekstraksi data dan penilaian risiko bias
- Perpustakaan Duke University — Perangkat lunak dan alat untuk sintesis bukti