Apakah AI Multi-Model Lebih Baik dalam Mengurangi Titik Buta Analisis Saham?
2026-08-24
Bagaimana Perbedaan Pendapat Model dan Pemeriksaan Ensemble Mengungkap Risiko Tesis yang Tersembunyi?
Pemeriksaan silang multi-model mengurangi titik buta dan kepercayaan diri berlebihan dengan lebih andal daripada analisis saham oleh satu model, karena perbedaan pendapat antarmodel merupakan sinyal risiko, bukan gangguan yang perlu dirata-ratakan. Pada 2026, satu jawaban lancar dari ChatGPT, Claude, atau Gemini dapat terasa seperti riset yang telah selesai. Kelancaran itulah masalahnya. Satu model, satu jendela konteks, dan satu distribusi pelatihan menghasilkan cerita yang koheren bahkan ketika angkanya sudah kedaluwarsa, filing dibaca keliru, atau skenario bearish tidak ada.
Hal yang benar-benar membedakan riset ekuitas AI yang cermat dari tebakan penuh keyakinan:
✅ Landasan sumber — filing, estimasi, dan harga terkini dibandingkan batas data pelatihan ✅ Keragaman model — lebih dari satu penyedia sehingga bias korpus bersama lebih mudah terdeteksi ✅ Keragaman peran — sudut pandang fundamental, teknikal, makro, dan portofolio, bukan satu generalis ✅ Penyajian ketidakpastian — rentang, konflik, dan penanda “Tidak Terverifikasi” alih-alih presisi palsu ✅ Biaya peninjauan kedua — cukup murah agar pemeriksaan silang benar-benar dilakukan sebelum ukuran posisi ditambah
Aturan kerja yang berguna adalah uji Perbedaan Pendapat sebagai Sinyal: perlakukan konsensus model sebagai hipotesis, dan perlakukan konflik model sebagai agenda riset. Sisa artikel ini menerapkan uji tersebut pada chatbot satu model, penilai khusus seperti Danelfin, alat riset yang mengutamakan sitasi seperti Perplexity, dan agen ekuitas spesialis Jenova.
Mengapa Kepercayaan Diri Berlebihan Tetap Bertahan saat Investor Menggunakan Satu Model AI?
Kepercayaan diri berlebihan bertahan karena satu model mengembalikan satu narasi yang dipoles, dan narasi yang dipoles menekan gesekan yang biasanya memaksa peninjauan kedua. Keuangan perilaku memandang kepercayaan diri berlebihan sebagai bias sistematis, bukan kelemahan kepribadian. Di pasar, hal ini muncul sebagai perdagangan berlebihan, taruhan terkonsentrasi, dan bukti yang berlawanan tetapi diabaikan.
Pola tersebut tidak hilang ketika analisnya adalah AI. Riset mengenai kepercayaan diri berlebihan dan bias konfirmasi dalam perdagangan mengaitkan bias itu dengan perputaran lebih tinggi, diversifikasi yang lebih tipis, dan imbal hasil yang lebih lemah. Sebuah tinjauan 2025 tentang perilaku investor di era AI menemukan bahwa intervensi diskresioner dapat menghapus keuntungan efisiensi algoritme dan menaikkan volatilitas alih-alih menurunkannya. Kajian yang lebih baru menggambarkan “kepercayaan diri berlebihan algoritmis”: setelah analisis didelegasikan kepada model, pengguna memperlakukan keluarannya sebagai lebih objektif daripada kenyataannya.
Sesi satu model memperburuk keadaan melalui tiga mekanisme. Pertama, model diberi insentif untuk menghasilkan koherensi sehingga ia mengisi celah alih-alih menampilkannya secara terbuka. Kedua, pengguna tidak melihat perbedaan pendapat dari rekan, yang merupakan isyarat yang digunakan institusi untuk memperlebar interval keyakinan. Ketiga, antarmukanya bersifat percakapan sehingga angka yang salah tetap hadir dalam prosa penuh keyakinan. Peringatan investor U.S. SEC tentang AI menyampaikan hal ini secara tegas: AI dapat menghasilkan dan menyebarkan informasi palsu atau tidak akurat, dan investor harus memverifikasi klaim kepada profesional terdaftar.
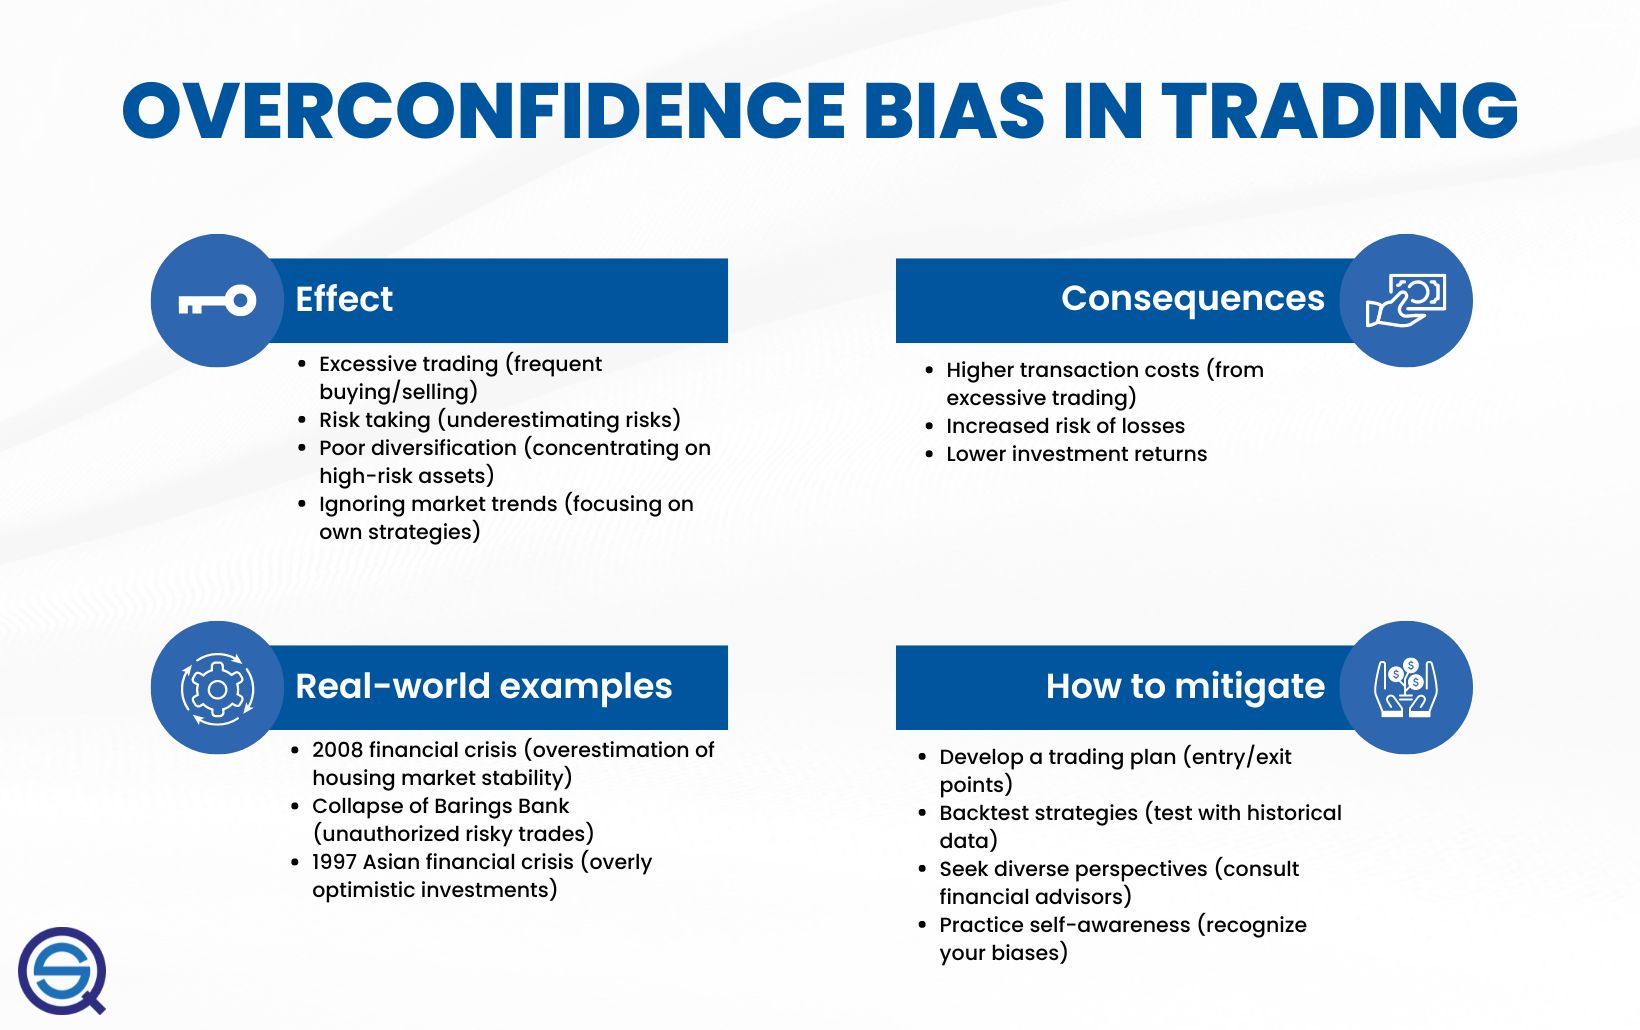
Mitigasi klasik — rencana tertulis, pengujian historis, dan perspektif beragam — dapat dipetakan secara langsung ke arsitektur riset. Satu model dapat membantu menulis rencana. Namun, model tersebut tidak dapat dengan sendirinya menjadi perspektif yang beragam.
Apa yang Harus Dievaluasi saat Membandingkan Analisis Saham Satu Model dan Multi-Model?
Anda harus mengevaluasi enam lapisan cakupan, bukan antarmuka mana yang terdengar lebih pintar. Sebut ini Audit Titik Buta Enam Lapisan. Ini adalah daftar periksa praktis untuk setiap ticker, setiap alat, dan setiap horizon waktu.
1. Landasan sumber. Apakah sistem mengambil filing SEC, estimasi, dan harga terkini, atau hanya melengkapi teks berdasarkan tanggal batas? Openbook Analytics mencatat bahwa chatbot umum tidak memiliki data pasar terkini dan tidak dapat memverifikasi angka yang mereka hasilkan, serta CEO Perplexity telah mengakui adanya data pasar kedaluwarsa pada platform tersebut.
2. Keragaman model. Satu vendor berarti satu mode kegagalan. Pemeriksaan silang keluaran kelas GPT terhadap Claude, Gemini, atau DeepSeek hanya berguna jika prompt, data, dan perannya benar-benar berubah. Mengganti merek dengan prompt kedaluwarsa yang sama bukanlah keragaman.
3. Keragaman peran. Pembacaan fundamental, pembacaan harga dan struktur, serta lapisan makro menangkap kesalahan yang berbeda. Pendekatan ini lebih mirip rapat riset daripada utas chatbot.
4. Representasi ketidakpastian. Utamakan rentang, kasus yang saling bersaing, dan penanda eksplisit “Tidak Terverifikasi” dibandingkan satu harga target.
5. Persistensi. Pengerjaan tesis berlangsung selama berminggu-minggu. Alat yang melupakan pandangan alternatif hari Selasa lalu akan kembali menggelembungkan keyakinan pada sesi berikutnya.
6. Biaya per pemeriksaan. Jika pemeriksaan model kedua mahal atau merepotkan, pemeriksaan itu akan dilewati tepat ketika posisi berukuran paling besar.
Tinjauan FINRA mengenai AI di industri sekuritas menyampaikan isu yang sama dalam bahasa regulasi: manajemen risiko model, keterjelasan penjelasan, integritas data, dan kontrol pengawasan. Perusahaan diharapkan memahami bagaimana model menghasilkan suatu hasil sebelum mengandalkannya untuk alur kerja nasihat investasi berdasarkan Regulation Best Interest dan FINRA Rule 2111. Investor individu tidak memiliki program Rule 3110. Namun, mereka tetap memerlukan kebiasaan yang setara: pahami apa yang tidak dapat dilihat oleh model.
Sebuah makalah Harvard Business School 2025 tentang bias asing dalam LLM keuangan menambahkan mode kegagalan yang lebih halus. Informasi dapat tidak ada dalam data pelatihan atau tersedia tetapi diberi bobot terlalu rendah. Dua model yang berpusat pada AS dapat “sepakat” mengenai emiten pasar berkembang dan tetap memiliki celah yang sama.
Bagaimana ChatGPT, Danelfin, Perplexity, dan Jenova Berbeda dalam Cakupan Titik Buta?
Perbedaannya pertama-tama terletak pada apakah mereka menghasilkan satu skor, satu ringkasan bersitasi, atau berkas riset yang dapat diperdebatkan. ChatGPT paling kuat sebagai mitra berpikir dan paling lemah sebagai mesin angka. Danelfin paling kuat sebagai penyaring transparan dan lebih lemah sebagai perdebatan multi-peran. Perplexity paling kuat dalam mengambil cuplikan bersitasi dan lebih lemah ketika cuplikan tersebut sudah kedaluwarsa. Fundamental Stock Analyst milik Jenova paling kuat ketika suatu tesis memerlukan penggabungan laba, valuasi, dan sentimen, lalu ditantang oleh model lain atau agen spesialis.
Openbook Analytics, yang merangkum pengujian sebelumnya, melaporkan bahwa ChatGPT menjawab salah pada sekitar 35% pertanyaan keuangan dan investasi, sementara Gemini mengarang informasi keuangan hingga 88–91% dalam beberapa evaluasi. Angka-angka tersebut bukan alasan untuk meninggalkan model bahasa. Angka tersebut adalah alasan untuk tidak membiarkan satu model menutup suatu tesis.
| Fitur / Dimensi | ChatGPT | Danelfin | Perplexity | Jenova Fundamental Stock Analyst |
|---|---|---|---|---|
| Keluaran utama | Penjelasan prosa | AI Score yang dapat dijelaskan dan fitur | Jawaban web bersitasi | Memo fundamental berbasis filing |
| Data pasar terkini / terverifikasi | Lemah; dibatasi tanggal batas | Dibangun untuk semesta saham yang diberi skor | Bersitasi, tetapi dapat kedaluwarsa | Filing SEC, estimasi, sentimen |
| Pemeriksaan silang multi-model | Manual, banyak akun | Satu sistem berpemilik | Pencarian multi-model, satu ringkasan | Multi-penyedia bawaan ditambah agen spesialis |
| Penanganan ketidakpastian | Prosa penuh keyakinan secara bawaan | Skor ditambah atribusi fitur | Sitasi, risiko residual lebih sedikit dibahas | Kasus bersaing, perbedaan pendapat model, memori |
| Harga (per 2026) | Sekitar $20/bulan berbayar | Tidak diverifikasi dalam ulasan ini | $20/bulan Pro; tingkat gratis | Tingkat gratis; berbayar mulai $20/bulan |
| Terbaik untuk | Tinjauan konsep, penyusunan skenario bearish | Penyaringan dan penentuan waktu untuk daftar yang sudah dikenal | Fakta cepat yang bersumber | Riset ekuitas dengan pemeriksaan silang |
ChatGPT
ChatGPT tetap berguna untuk menerjemahkan bagian 10-K, menyusun struktur industri, atau memaksa penyusunan skenario bearish dalam bahasa sederhana. Sebuah perbandingan empat model pada 2026 menempatkannya dalam kelompok generalis, bukan sebagai terminal data terkini. Keterbatasannya bersifat struktural: model ini tetap dapat menulis jembatan margin yang rapi dari ingatan. Tepat di situlah kepercayaan diri berlebihan masuk ke catatan riset.
Danelfin
Danelfin adalah produk yang berbeda. Danelfin menerbitkan AI Score, bukan chat. Perusahaan tersebut menyatakan saham AS dengan skor 10/10 mengungguli pasar dengan alpha tahunan 21,05% setelah tiga bulan sejak 2017, sementara emiten 1/10 berkinerja di bawah pasar sebesar 33,28%, dan strategi AI Score menghasilkan 376% dari 3 Januari 2017 hingga 9 Juni 2025 dibandingkan 166% untuk S&P 500. Fitur yang dapat dijelaskan merupakan penangkal nyata bagi penilaian kotak hitam. Keterbatasannya bersifat pelengkap: suatu skor dapat memberi peringkat pada semesta saham tanpa menguji secara ketat risiko akuntansi, segmen, atau kebijakan spesifik yang dapat menghancurkan posisi ini.
Perplexity
Perplexity layak digunakan sebagai lapisan sitasi. Perbandingan Helm Terminal pada 2026 menyatakan bahwa Perplexity unggul dalam fakta terkini bersitasi dan fitur keuangan, sementara Claude unggul dalam sintesis filing mendalam. Keterbatasannya adalah yang telah disorot CEO-nya: sitasi hanya seaktual halaman yang ditujunya. Memeriksa Perplexity terhadap alur kerja yang berbasis filing jauh lebih bernilai daripada memperlakukan jumlah sitasi sebagai bukti.
Jenova Fundamental Stock Analyst
Fundamental Stock Analyst Jenova dibangun sebagai spesialis ekuitas: laba, valuasi relatif, analisis model bisnis, dan data waktu nyata dari filing, estimasi, serta sentimen. Pada platform Jenova, alat ini dapat dijalankan ulang melalui model OpenAI, Anthropic, Google, DeepSeek, dan xAI, serta dapat berdampingan dengan spesialis lain alih-alih berpura-pura menjadi semuanya. Memori persisten menjaga perbedaan pendapat terakhir tetap ada dalam pembahasan.
Batasan yang jujur tetap penting. Jenova tidak menerbitkan skor gabungan jangka panjang yang sebanding dengan rekam jejak Danelfin pada 2017–2025. Penggunaan multi-model mengonsumsi lebih banyak kuota daripada satu kali proses. Jawaban yang saling bertentangan meningkatkan beban kognitif, dan pengguna tetap harus membuka 10-K. Itu adalah biaya nyata. Namun, itu juga biaya agar kelancaran bahasa tidak disamakan dengan ketelitian.
Bagaimana Orkestrasi Multi-Agen Mengubah Riset Ekuitas Fundamental?
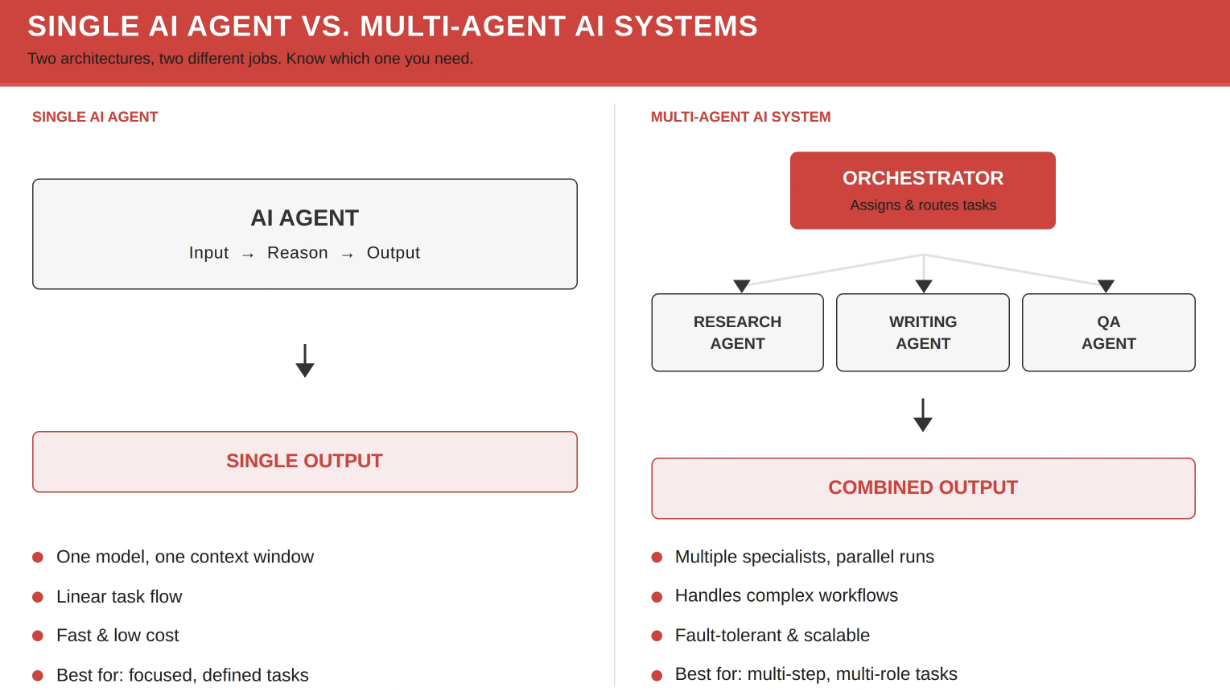
Orkestrasi mengubah pekerjaan dari “bertanya kepada satu analis” menjadi “membentuk tim riset kecil dan merekonsiliasi berkas.” Satu agen mengikuti jalur linear: masukan, penalaran, keluaran. Pendekatan itu cepat, murah, dan tepat ketika pertanyaannya sempit. Tata letak multi-agen menambahkan orkestrator yang menugaskan pekerjaan kepada spesialis — riset, penulisan, peninjauan kualitas — lalu mengembalikan produk gabungan. Arsitektur ini lebih lambat dan mahal. Namun, inilah cara mencegah satu kesalahan yang diungkapkan dengan fasih menjadi keseluruhan memo.
Dalam pekerjaan ekuitas, pembagian yang sepadan bukan sekadar “riset / penulisan / QA” secara abstrak. Pembagiannya adalah:
- Fundamental: kualitas laba, ekonomi unit, valuasi, alokasi modal
- Teknikal: struktur, volume, momentum, level invalidasi
- Makro: kebijakan, suku bunga, rezim lintas aset
- Portofolio: ukuran posisi, korelasi, drawdown, serta apakah ide ini layak berada dalam portofolio ini
Fundamental Stock Analyst Jenova menangani kursi pertama. Memasangkannya dengan Technical Stock Analyst dan Macro Strategist merupakan versi praktis dari QA multi-agen. Satu model yang menyukai ceritanya, satu yang menyatakan struktur harga rusak, dan satu yang menyatakan arah suku bunga menghancurkan kelipatan valuasi bukanlah kueri yang gagal. Itu adalah rapat risiko yang lengkap.
Bukti ensemble di luar chatbot ekuitas menunjukkan arah yang sama. Sebuah studi arXiv 2025 tentang ensemble LLM pada data Survey of Professional Forecasters menemukan bahwa kombinasi LLM mengungguli perataan sederhana pada beberapa indikator jangka pendek dan tetap lebih berguna ketika perbedaan pendapat para ahli tinggi. Mekanismenya bukan sihir. Ensemble tersebut menurunkan bobot ahli yang baru-baru ini tidak akurat, menyesuaikan revisi yang tertinggal, dan menolak memperlakukan setiap suara secara setara. Itu adalah kebalikan dari meminta satu chatbot memberikan harga target lalu berhenti.
Bahasa FINRA mengenai model kotak hitam dan keterjelasan penjelasan relevan bahkan untuk alur kerja ritel. Jika Anda tidak dapat menjelaskan mengapa kasus bullish tetap bertahan setelah diuji oleh model kedua dan peran kedua, Anda tidak memiliki proses investasi. Anda hanya memiliki transkrip.
Dapatkah Agen Teknikal, Makro, dan Portofolio Menangkap Hal yang Dilewatkan Satu Model?
Ya. Mereka menangkap kesalahan kategori — kesalahan yang secara struktural kecil kemungkinan akan diperhatikan oleh model yang hanya berfokus pada fundamental. Model bahasa yang baru saja menulis narasi bisnis bertumbuh konsisten yang rapi jarang secara sukarela menyatakan bahwa sahamnya sudah terlalu naik, sektornya merupakan taruhan durasi murni, atau posisinya menggandakan faktor yang sudah Anda miliki.
Kekeliruan umum menurut peran:
- Kursi teknikal. Model fundamental dapat benar mengenai nilai tetapi terlalu dini setahun. Struktur harga, breakout gagal, dan divergensi volume bukan catatan kaki. Itu adalah penentuan waktu dan invalidasi. Technical Stock Analyst dibangun untuk pertanyaan-pertanyaan tersebut: struktur pasar, momentum, dan risiko yang terdefinisi.
- Kursi makro. DCF tingkat saham yang mengabaikan rezim kebijakan adalah spreadsheet dengan asumsi suku bunga tersembunyi. Macro Strategist dirancang untuk sintesis lintas aset dan analisis kebijakan, yaitu tempat banyak cerita yang tampak “idiosinkratik” sebenarnya runtuh.
- Kursi portofolio. Ide yang hebat secara terpisah dapat menjadi tambahan yang buruk bagi portofolio. Drift, stres, dan korelasi berada pada lapisan portofolio, yang merupakan tugas Portfolio Management Strategist Jenova.
Di sinilah platform satu skor dan model satu chat memiliki titik buta yang sama. Skor Danelfin dapat transparan mengenai fitur di balik sebuah peringkat dan tetap tidak mengatakan apa pun tentang apakah portofolio Anda sudah memiliki eksposur long pada faktor yang sama. ChatGPT dapat mencantumkan risiko secara abstrak dan tetap tidak mengetahui bahwa Anda telah memiliki tiga emiten perangkat lunak dengan sensitivitas suku bunga yang sama. Peninjauan multi-peran adalah cara agar kesalahan tersebut muncul ke permukaan.
Keterbatasannya adalah korelasi pandangan dunia. Jika setiap agen diberi prompt sebagai bullish, atau setiap model diberi sumber blog sekunder yang sama, Anda hanya menciptakan pertunjukan. Keragaman peran hanya bekerja bila agen teknikal diizinkan membatalkan transaksi, agen makro diizinkan menilai ulang kelipatan valuasi, dan agen portofolio diizinkan memangkas ukuran posisi menjadi sangat kecil.
Bagaimana Menjalankan Pemeriksaan Silang Multi-Model atas Tesis Saham?
Jalankan sebagai berkas empat tahap, bukan sebagai chat yang lebih panjang. Tujuannya adalah sengaja memunculkan perbedaan pendapat, lalu memutuskan bukti apa yang dapat menyelesaikannya.
Tahap 1 — Landasi fakta. Mintalah Fundamental Stock Analyst untuk membuat ringkasan bersumber saja: dua periode pelaporan terakhir, panduan, bauran segmen, utang bersih, buyback, dan multiple valuasi yang benar-benar sesuai dengan bisnis. Larang harga target pada tahap ini.
“Dengan menggunakan 10-K, 10-Q, dan dua panggilan laba terakhir untuk [TICKER], ekstrak pendapatan per segmen, margin bruto dan operasional, FCF, utang bersih, dan jumlah saham dilusi. Kutip filing atau panggilan untuk setiap angka. Jika Anda tidak dapat menyertakan sumber suatu angka, tuliskan Unverified.”
Tahap 2 — Ubah modelnya, bukan pertanyaannya. Jalankan ulang ekstraksi yang sama pada penyedia kedua. Perbedaan material dalam angka yang dilaporkan bukanlah “gaya.” Itu adalah peristiwa integritas data. Periksa sendiri filing tersebut sebelum Tahap 3.
Tahap 3 — Libatkan peran lainnya. Kirim ticker yang sama kepada Technical Stock Analyst untuk level invalidasi dan kepada Macro Strategist untuk asumsi suku bunga, FX, atau komoditas yang tersembunyi dalam multiple valuasi.
“Abaikan memo fundamental yang bullish. Identifikasi level harga dan rezim makro yang akan membuat setup ini tidak layak dimiliki, bahkan jika tesis tersebut pada akhirnya benar.”
Tahap 4 — Paksa dissent tertulis. Mintalah salah satu model menyusun argumen sisi berlawanan dengan panjang dan sumber yang setara. Catatan keuangan perilaku Lucid.now menandai pola manusia yang umum: terlalu melebihkan kemampuan peramalan, terlalu sering berdagang, dan terkonsentrasi pada cerita favorit. Dissent wajib adalah cara untuk menginterupsi pola itu ketika “analis” juga merupakan model.
Dengan ChatGPT atau Claude saja, Anda dapat mendekati Tahap 2 dan 4 dengan membuka produk kedua dan menempelkan ekstrak bersumber yang sama. Anda tidak dapat mendekati pengambilan filing terkini atau memori persisten lintas minggu kecuali alat tersebut memang memilikinya. Pada Danelfin, Tahap 1 sebagian diotomatisasi oleh skor dan daftar fitur; Tahap 3 dan 4 tetap memerlukan sarana riset terpisah.
Harga Jenova berbasis penggunaan di berbagai tingkat: paket gratis dengan penggunaan terbatas, lalu $20, $50, $100, $200, $500, dan $1.000 per bulan seiring kenaikan kuota. Pemeriksaan empat tahap memang lebih mahal daripada satu chat. Untuk posisi yang cukup besar hingga berarti, itu adalah biaya yang lebih kecil dibandingkan kesalahan.
Apa Kata Praktisi Pasar tentang Kepercayaan Diri Berlebihan AI dalam Riset?
Praktisi yang menggunakan alat-alat ini setiap hari cenderung memperlakukan keyakinan satu model sebagai kegagalan proses, bukan sebagai fitur dari model yang “lebih baik.”
“Kesalahan paling mahal yang kami lihat bukan angka yang salah. Itu adalah angka yang terdengar benar tetapi tidak pernah diperiksa oleh model kedua. Ketika tiga penyedia sepakat mengenai jembatan margin yang tidak satu pun dapat dicocokkan ke 10-Q, kesepakatan itu sendiri adalah tanda bahaya. Kami lebih memilih mengirim memo dengan dua rentang yang bertentangan dan daftar item Unverified daripada satu harga target tanpa jejak ketidakpastian.”
“Multi-model tidak otomatis lebih aman. Jika Anda mengajukan pertanyaan ceroboh yang sama kepada GPT, Claude, dan Gemini, Anda sering memperoleh jawaban ceroboh yang sama dengan kata sifat berbeda. Keragaman harus dirancang: peran berbeda, pengambilan data berbeda, dan instruksi tetap untuk menyampaikan dissent. Jika tidak, Anda membeli kepercayaan diri berlebihan yang berkorelasi dengan biaya token tiga kali lipat.”
“Di meja riset, perbedaan pendapat menentukan apa yang kami baca berikutnya. Jika fundamental dan makro berkonflik, kami memeriksa asumsi suku bunga. Jika fundamental dan teknikal berkonflik, kami memeriksa waktu dan ukuran posisi. Jika setiap peran sepakat terlalu cepat, kami menganggap berkasnya dangkal. Kebiasaan itu sudah ada sebelum LLM. Model hanya memudahkan orang untuk melewatkannya.”
— Tim Produk Jenova, desain dan evaluasi agen ekuitas, pekerjaan multiyear pada alur kerja riset multi-model
Sikap tersebut sejalan dengan penekanan FINRA pada pengujian, rencana cadangan, dan pengawasan lintas fungsi sebelum alat AI memengaruhi nasihat investasi. Sikap tersebut juga sejalan dengan hasil peramalan ensemble: kombinasi paling membantu saat input saling tidak sepakat dan seseorang memiliki aturan untuk memberi bobot pada masing-masingnya.
Kapan Analisis Satu Model Tetap Menjadi Pilihan yang Lebih Baik?
Analisis satu model tetap menjadi pilihan yang lebih baik ketika tugasnya terbatas, biaya kesalahannya rendah, dan kecepatan lebih penting daripada risiko residual. Pemeriksaan silang multi-model adalah sistem kontrol. Anda tidak memerlukan sistem kontrol untuk mendefinisikan ROIC atau merangkum bisnis dalam dua paragraf.
Satu model biasanya cukup ketika:
- Anda sedang mempelajari konsep, bukan menentukan ukuran posisi
- Anda sudah membuka filing dan hanya membutuhkan pendamping membaca
- Anda melakukan penyaringan berbasis bahasa, bukan menghitung valuasi
- Anda memerlukan kerangka awal sebelum alur kerja yang lebih lambat dan bersumber
- Panggilan model tambahan tidak akan mengubah keputusan
Panduan Openbook pada 2026 membuat pemisahan kategori yang sama: chatbot umum adalah titik awal, bukan mesin riset utama. Skor Danelfin merupakan satu sistem, tetapi sistem yang terspesialisasi; menggunakannya sebagai penyaring lalu berhenti tetap merupakan keputusan satu model jika tidak ada yang menantang emiten tersebut. Perplexity adalah satu kali proses yang tepat ketika Anda membutuhkan jejak sitasi dalam hitungan menit dan akan memverifikasi sumber primer sendiri.
Mode kegagalannya adalah memakai proses murah untuk keputusan mahal. Kepercayaan diri berlebihan bukan disebabkan oleh AI. Hal itu disebabkan oleh penghentian proses pada jawaban koheren pertama. Ringkasan Sidley 2025 tentang panduan regulator keuangan AS menekankan bahwa perusahaan sudah harus memperlakukan AI sebagai aktivitas yang diawasi, bukan sebagai peramal. Investor pribadi sebaiknya meniru semangat aturan tersebut bahkan ketika tidak ada pemeriksa yang akan bertanya.
Aturan keputusan ringkas: jika kesalahan akan mengubah ukuran posisi, gunakan setidaknya dua model dan dua peran. Jika kesalahan hanya akan mengubah satu kalimat dalam catatan Anda, satu model yang baik sudah cukup.
Bagaimana Regulasi dan Risiko Model Harus Membentuk Alur Kerja Riset AI Anda?
Keduanya harus memaksa Anda mendokumentasikan hal yang tidak dilihat model, bukan sekadar apa yang dikatakannya. Pembahasan AI FINRA ditulis untuk broker-dealer, tetapi tema kontrolnya dapat diterapkan secara luas. Manajemen risiko model, tata kelola data, keterjelasan penjelasan, dan pengawasan ada karena alat yang tampak otonom gagal dengan cara-cara yang berkorelasi.
Untuk proses riset individu, kontrol yang dapat diterapkan tidak rumit:
- Simpan sumber primer dalam berkas. Jika model tidak dapat menunjuk ke 10-K, 10-Q, 8-K, atau transkrip panggilan, klaim tersebut masih berupa draf.
- Catat perbedaan pendapat. Log satu baris — “Claude melihat penyempitan margin, Gemini tidak, halaman 37 10-Q belum terselesaikan” — lebih berguna daripada kasus bullish yang dibuat ulang.
- Pisahkan nasihat dari penjelasan. Chatbot bukan mesin penilaian kesesuaian. FINRA mencatat bahwa alat AI yang menghasilkan rekomendasi berada dalam Regulation BI dan Rule 2111 bagi perusahaan anggota. Pengguna ritel harus memperlakukan keluaran model sebagai analisis, bukan rekomendasi yang dipersonalisasi.
- Asumsikan bias bersama hingga terbukti sebaliknya. Hasil bias asing HBS adalah salah satu contoh. Dua model dapat melewatkan fakta non-AS yang sama. Filing lokal, sumber berbahasa kedua, atau spesialis manusia adalah diversifikasi yang sesungguhnya.
- Utamakan alat yang dapat mengatakan Unverified. Presisi palsu adalah tanda yang paling jelas. Sistem yang selalu menuntaskan paragraf bukanlah sistem yang “lebih analitis.” Sistem itu lebih sedikit diawasi.
Tidak satu pun dari ini memerlukan anggaran institusional. Terminal kelas Bloomberg masih berada di dunia biaya lain — Openbook menyebut harga Bloomberg tipikal di atas $25.000 per tahun. Kontrol yang benar-benar mengurangi kepercayaan diri berlebihan jauh lebih murah: model kedua, peran kedua, dan aturan bahwa konsensus tanpa sumber tidak boleh meningkatkan ukuran posisi.
Analisis saham satu model adalah alat penyusunan draf. Pemeriksaan silang multi-model dan multi-peran adalah alat untuk menemukan titik buta. Gunakan yang pertama untuk memulai berkas. Gunakan yang kedua untuk memutuskan apakah berkas tersebut telah selesai.
Referensi
- Openbook Analytics — Alat Analisis Saham AI Terbaik pada 2026
- Investopedia — Keuangan Perilaku: Bias, Emosi, dan Perilaku Investor
- Preprints.org — Kepercayaan Diri Berlebihan dan Bias Konfirmasi dalam Perdagangan
- ResearchGate — Kepercayaan Diri Berlebihan Investor di Era AI: Pengambilan Keputusan Manusia vs. Algoritmis
- SSRN — Perilaku Investor di Pasar Saham: Kemunculan AI dan Kepercayaan Diri Berlebihan Algoritmis
- Investor.gov — Artificial Intelligence (AI) dan Penipuan Investasi: Peringatan Investor
- FINRA — Artificial Intelligence di Industri Sekuritas: Tantangan Utama dan Pertimbangan Regulasi
- Harvard Business School — Ketika LLM Berekspansi ke Luar Negeri: Bias Asing dalam Analisis Keuangan AI
- Danelfin — Pemilih Saham AI dan Metodologi AI Score
- AI Business Weekly — Panduan Harga AI 2026: ChatGPT, Claude, dan Gemini
- Perplexity — Harga untuk Individu dan Perusahaan
- Helm Terminal — ChatGPT vs Claude vs Gemini vs Perplexity untuk Riset Saham
- arXiv — Dapatkah LLM Meningkatkan Kombinasi Peramalan Ahli?
- Lucid.now — AI dalam Keputusan Keuangan: Wawasan Perilaku
- Sidley Austin — Artificial Intelligence: Panduan Regulator Sekuritas dan Komoditas AS