Generator Suara Karakter: Suara AI untuk Game, Cerita & Film
2026-09-06
Jenova membantu Anda merancang karakter yang khas, menulis dialog yang enak diucapkan, dan menyiapkan prompt siap produksi untuk generator suara karakter apa pun. Pada September 2026, sistem suara AI dapat menyalin timbre dalam hitungan detik, tetapi sebagian besar hasilnya tetap terdengar generik karena tulisan di baliknya tidak memiliki kepribadian. Pengisi suara studio masih lambat dan mahal bagi tim indie, sementara penerapan text-to-speech yang dangkal membuat setiap peran memiliki ritme yang sama.
- ✅ Kepribadian yang konsisten untuk karakter sepanjang cerita panjang dan alur game
- ✅ Dialog yang ditulis untuk diucapkan, bukan sekadar dibaca di halaman
- ✅ Prompt yang terstruktur untuk model suara modern dan pelokalan
- ✅ Dukungan skrip, komik, musik, dan roleplay dalam satu alur kerja kreatif
Untuk memahami mengapa ini penting, lihat kebutuhan nyata kreator dari generator suara karakter: bukan penggeser lain berlabel “gembira”, melainkan suara yang benar-benar milik seseorang. Hambatannya jarang terletak pada perender. Hambatannya adalah pengembangan karakter, pembacaan dialog, dan batas etis antara penampilan orisinal dengan peniruan tanpa izin.
Jawaban Singkat: Apa Itu Generator Suara Karakter?
Generator suara karakter adalah sistem AI yang menghasilkan ucapan khas dan spesifik terhadap kepribadian sehingga setiap peran terdengar seperti orang yang berbeda. Kreator menggunakannya untuk game, cerita, video, dan aksesibilitas — tetapi suara hanya akan berhasil jika karakternya sudah jelas.
Kemampuan utama:
- Timbre, tempo, dan rentang emosi yang berbeda untuk setiap karakter
- Skrip dan prompt yang tetap alami saat melalui text-to-speech, bukan terdengar seperti GPS
- Roleplay dengan konsistensi karakter yang terkunci sebelum Anda menekan tombol generate
- Alur kerja karakter orisinal yang menghindari penyalinan orang nyata tanpa persetujuan
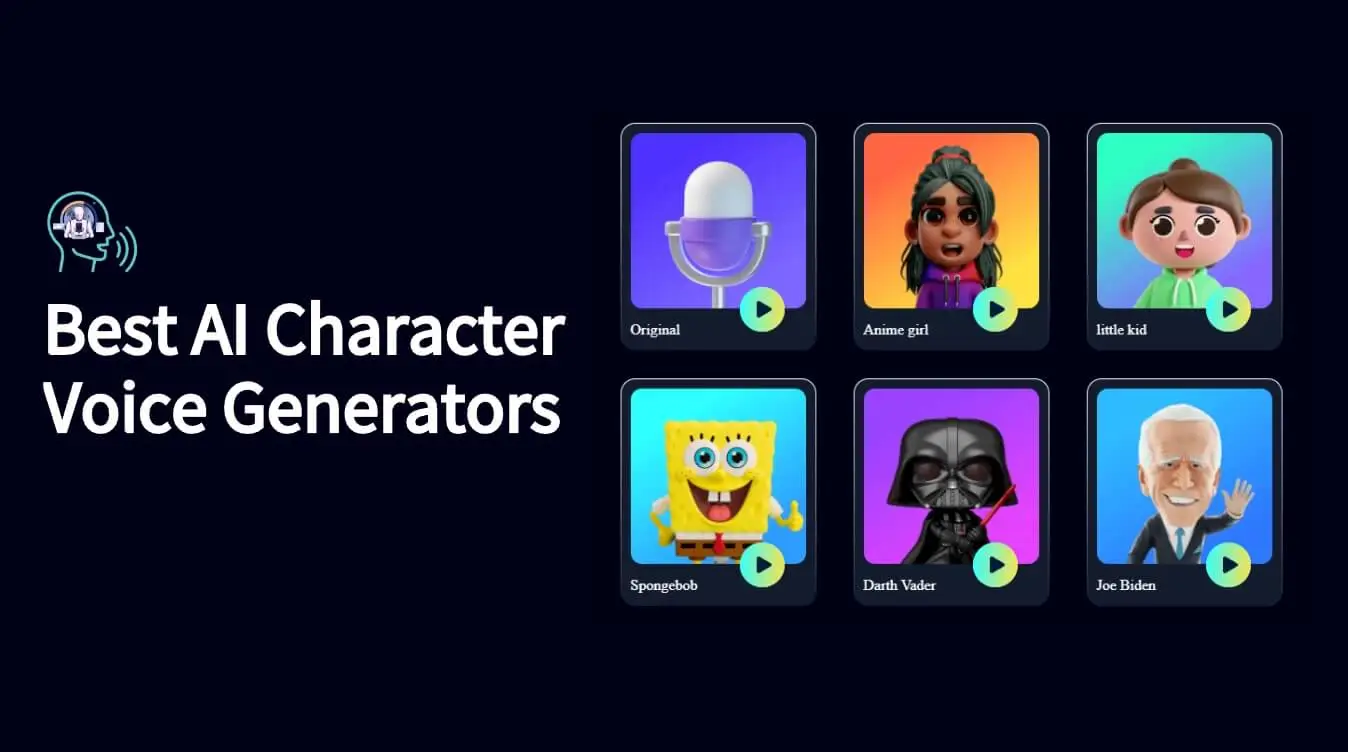
Mengapa Sebagian Besar Generator Suara Karakter Masih Terdengar Generik
Permintaan akan suara sintetis bukan lagi eksperimen. Perusahaan riset kini melacak pembuatan suara AI sebagai pasar tersendiri, bukan sekadar fitur sampingan chatbot.
USD 6.4 billion — Ukuran pasar global generator suara AI pada 2025, dengan pertumbuhan yang diproyeksikan dari USD 8.36 billion pada 2026
USD 19.09 billion — Pasar pengenalan ucapan dan suara pada 2025, yang diproyeksikan mencapai USD 23.70 billion pada 2026
Pengeluaran tersebut mengalir ke game, pelokalan, video sosial, dan audio pelanggan. Penggunaan Voice AI tumbuh 9x pada 2025, dan 84 persen organisasi yang disurvei berencana meningkatkan anggaran teknologi suara. Namun, membeli perender tidak berarti membeli sebuah penampilan. Mengakses suara yang diingat audiens masih sangat sulit:
- Setiap karakter mewarisi ritme, pola napas, dan nada “asisten yang membantu” yang sama
- Sesi studio terlalu lambat dan mahal untuk kebutuhan NPC dalam jumlah besar, jajaran YouTube, dan sulih suara webtoon mingguan
- Dialog yang ditulis untuk halaman runtuh saat diucapkan — anak kalimat menumpuk, lelucon mati, dan nama salah dilafalkan
- Kloning selebritas dan politikus menimbulkan risiko hukum dan kepercayaan, bahkan saat UI membuatnya tinggal satu klik
- Tim harus mengelola penulis, insinyur prompt, komposer, dan alat suara tanpa panduan karakter bersama
Suara Sama, Label Nama Berbeda
Generator suara karakter dapat mengubah tinggi nada tetapi tetap gagal membangun identitas. Pendengar menangkap sikap, bukan hanya frekuensi: bagaimana seorang penjahat menunda konsonan, bagaimana seorang anak terburu-buru menyampaikan lelucon, bagaimana kapten yang lelah menurunkan volume pada akhir laporan. Riset tentang ucapan sadar emosi dan spesifik karakter dari komik serta pembuatan suara multikarakter berbasis teks terus mengarah pada temuan yang sama — model memerlukan konteks karakter, bukan hanya target waveform. Tanpa kepribadian yang tertulis, Anda hanya mendapatkan kostum, bukan penampilan.
Tembok Biaya untuk Tim Indie dan Menengah
Pemeran utama manusia tetap membawa adegan yang kompleks secara emosional. Masalah produksi terletak pada skala besar: ribuan sapaan NPC, varian terlokalkan, dan pelafalan nama pemain. Analisis industri tentang suara AI yang etis dalam game menggambarkan pembagian “manusia plus” — aktor untuk adegan pahlawan, sintesis untuk volume — serta mencatat bahwa tim indie kini dapat melokalkan ke puluhan bahasa dalam hitungan minggu, bukan bulan. Itu hanya membantu jika dialog sumber mudah diucapkan dan lembar karakternya stabil. Jika tidak, Anda hanya membayar untuk memperbanyak audio biasa-biasa saja.
Skrip yang Tidak Pernah Dimaksudkan untuk Didengar
Prosa novel dan teks UI bertentangan dengan mulut. Anak kalimat bertumpuk, akronim tanpa penjelasan, dan nama fantasi yang sulit diucapkan memaksa model ke pola penekanan robotis. Generator suara karakter akan dengan setia merender dialog yang buruk. Perbaikannya ada di hulu: bagian yang lebih pendek, ejaan fonetis, arahan emosional, dan dialog yang benar-benar dapat diucapkan seorang pemeran dalam satu tarikan napas.
Persetujuan, Kloning, dan Platform yang Mengundang Masalah
Sistem zero-shot dapat mereplikasi timbre dalam sekitar tiga detik. Kecepatan ini bermanfaat untuk replika berizin dan karakter orisinal. Namun, ini berbahaya ketika pustaka menampilkan figur publik atau maskot berhak cipta sebagai preset. FTC telah menegaskan bahwa tidak ada pengecualian AI dari hukum perlindungan konsumen yang berlaku, dan telah menggunakan Voice Cloning Challenge serta Impersonation Rule untuk menargetkan audio yang menipu. Dalam game, Interactive Media Agreement Juli 2025 disetujui dengan 95.04% suara dan menjadikan persetujuan tertulis sebagai syarat mutlak untuk replikasi suara. Jika alur kerja Anda tidak dapat membuktikan persetujuan, jangan hasilkan suaranya.
Inilah tepatnya tujuan Jenova dibuat: kecerdasan karakter di sekitar generator, bukan jalan pintas untuk menghindari hukum.
Solusi Jenova
Generator suara karakter mengubah teks menjadi audio. Jenova membuat teks itu layak untuk disuarakan. Anda mendefinisikan siapa yang berbicara, cara mereka berpikir, hal yang tidak akan pernah mereka katakan, serta bagaimana sebuah dialog harus disampaikan — lalu Anda menyerahkan prompt dan skrip yang bersih kepada model ucapan apa pun yang Anda gunakan. Platform audio khusus merender gelombang suara; platform ini membangun sosok di balik gelombang tersebut.
| Pendekatan Tradisional | Jenova |
|---|---|
| Memesan studio, menunggu sesi, merekam ulang setiap tambahan | Lembar karakter dan draf yang mudah diucapkan dalam satu sesi kerja |
| Satu suara TTS dengan nama tampilan baru | Kepribadian, diksi, dan ketukan emosional ditulis untuk setiap peran |
| Mengkloning suara terkenal dan berharap tidak ada yang menyadarinya | Karakter orisinal, replika berizin, dan penggunaan yang terdokumentasi |
| Penulis di satu tab, catatan prompt di tab lain, komposer di tab ketiga | Agen terhubung untuk cerita, prompt, komik, musik, dan pengiriman |
| Pelokalan datar yang mengabaikan humor dan pengaturan waktu | Dialog yang disusun agar sesuai dengan suku kata dan penulisan ulang budaya |
Panduan Karakter Sebelum Anda Menyentuh Audio
Mulailah dari identitas, bukan preset. Name Generator menghasilkan nama yang koheren secara budaya dan mudah diucapkan — filter praktis yang sering dilewati banyak alur kerja suara hingga model tersandung pada deretan konsonan. Padukan dengan Writing Assistant untuk mengunci diksi: batas kosakata, kata tabu, lelucon berulang, dan satu metafora yang selalu dicari oleh karakter. Saat batasan tersebut ada, generator suara karakter apa pun memiliki sesuatu yang spesifik untuk ditampilkan.
Dialog yang Dibangun untuk Mulut
Film Screenwriter memperlakukan dialog sebagai perilaku berwaktu: interupsi, keheningan, dan subteks. Keahlian ini langsung dapat diterapkan pada dialog pendek game, drama vertikal, dan komik bersulih suara. Anda mendapatkan petunjuk dalam tanda kurung yang dapat diikuti model suara (“pelan, lalu lebih cerah”), bukan label samar seperti “sedih”. Untuk penceritaan seluler berseri, Microdrama Screenwriter menjaga cliffhanger tetap cukup singkat untuk disuarakan tanpa terengah-engah.
Contoh arahan yang dapat Anda tempel ke generator:
"Bacakan sebagai Kapten Ilya Voss, usia 50-an, suara serak berat dari dada. Ia tidak pernah menaikkan volume saat marah — ia memperlambat tempo. Dialog: 'Kau membawa peta. Kau tidak membawa cuacanya.' Jeda setelah peta. Tanpa senyum."
Prompt yang Tetap Bertahan Saat Bertemu Model
Sebagian besar “suara AI yang buruk” berasal dari instruksi yang buruk. Prompt Generator mengubah panduan karakter menjadi teks siap model: catatan aksen, usia, ruang rekaman, alur emosi, dan prompt negatif (“tanpa ritme penyiar, tanpa senyum pada vokal”). Itulah perbedaan antara kartu pustaka bernama “Gadis Anime” dan sosok yang kebetulan dianimasikan.
Gambar, Musik, dan Sisa Adegan
Suara hanyalah satu lapisan. Graphic Designer membangun wajah yang diharapkan oleh telinga. Manga Creator, Comic Creator, dan Webtoon Creator menghasilkan seni berurutan dengan gerak bibir dan ritme panel yang dapat Anda beri skor. Music Composition Assistant dan Lyric Writer memberi karakter motif serta dialog yang mudah dinyanyikan sehingga suara lisan dan lagu berasal dari dunia yang sama.
Sementara API ucapan khusus berfokus pada perenderan audio, Jenova berfokus pada penulisan, prompting, dan kesinambungan yang menentukan apakah seseorang ingin mendengar audio itu untuk kedua kalinya.
Agen AI Khusus untuk Pekerjaan Suara Karakter
Coba Jenova secara gratis — tanpa kartu kredit. Agen-agen ini mencakup pekerjaan yang berada tepat sebelum dan sesudah generator suara karakter.
Roleplay Game Master
Jika Anda perlu mendengar karakter melalui bahasa sebelum menyintesiskannya, inilah ruang latihannya. Memori tanpa batas menjaga diksi, rahasia, dan hubungan tetap stabil lintas sesi, yang merupakan padanan teks dari model suara yang terkunci.
- Menguji ungkapan khas sampai terdengar tak terelakkan
- Memisahkan suara kelompok dan NPC dalam kampanye panjang
- Menghasilkan dialog sesuai karakter yang dapat langsung dimasukkan ke generator
Film Screenwriter
Gunakan saat suara harus membawa alur cerita, bukan hanya memberi warna. Struktur, tujuan adegan, dan keahlian dialog mencegah penampilan berubah menjadi eksposisi dengan aksen lucu.
- Ketukan dan konflik yang membenarkan pergeseran emosi dalam audio
- Dialog pendek yang mudah direkam ulang untuk game dan iklan
- Pengembangan karakter yang bertahan dalam sulih suara dua belas episode
Prompt Generator
Model suara hanya sebaik arahannya. Agen ini menulis prompt untuk sistem teks, gambar, musik, dan video — termasuk model ucapan yang sudah Anda bayar.
- Blok prompt konsisten per karakter agar episode tetap selaras
- Deskriptor emosi dan ruang yang benar-benar diikuti model
- Penyempurnaan iteratif saat hasil rekaman terdengar terlalu cerah atau terlalu lambat
Writing Assistant
Agen andalan untuk panduan karakter, narasi, dan penulisan ulang “ini seharusnya terdengar seperti mereka”. Agen ini menyesuaikan diri dengan format dan audiens agar curahan lore dan hinaan di kedai tidak berbagi ritme kalimat yang sama.
- Penyuntingan untuk kemudahan diucapkan dan tingkat keterbacaan
- Pencocokan nada untuk teks misi, trailer, dan catatan pembaruan
- Kolaborasi saat Anda sudah memiliki draf yang hampir berhasil
Music Composition Assistant
Generator suara karakter menangani ucapan. Agen ini menangani latar di bawahnya — motif, harmoni, dan catatan aransemen yang dapat Anda serahkan ke DAW atau model lain.
- Leitmotif yang terkait dengan peran tertentu
- Peta tempo yang menyisakan ruang untuk dialog
- Panduan berbasis teori agar tema penjahat tidak berbenturan dengan rentang vokal
Public Speaking Coach
Saat Anda adalah pemerannya — atau perlu mengarahkan seorang pemeran — agen ini membantu penyampaian, kecemasan, dan audiens. Inilah pasangan sisi manusia dari ucapan sintetis: napas, jeda, dan penekanan yang kemudian dapat Anda enkode dalam prompt.
- Penanda tempo dan tekanan yang dapat diterapkan pada tag TTS
- Latihan tanya jawab dan pembacaan langsung untuk siaran hibrida
- Catatan tentang dampak dialog pada pendengar, bukan sekadar bunyinya
Cara Alur Kerja Generator Suara Karakter Sebenarnya Berjalan
Anda tidak memerlukan studio terlebih dahulu. Anda memerlukan seseorang di halaman, dialog yang dapat diucapkan, dan prompt yang tidak saling bertentangan.
Langkah 1: Kunci Orangnya, Bukan Presetnya
Tulis usia, status, fisik, dan satu aturan yang tidak pernah mereka langgar. Buat nama yang mudah diucapkan, lalu panduan karakter 150 kata. Jika dua karakter dapat saling menukar dialog tanpa ada yang menyadarinya, Anda belum memiliki dua suara.
"Buat panduan karakter untuk Ryn Calder, 17 tahun, kurir sungai, selalu sopan kepada kargo dan kasar kepada kapten. Kalimat pendek. Tanpa slang sejak desanya terbakar. Beri saya tiga dialog yang tidak akan pernah ia ucapkan."
Langkah 2: Tulis Dialog untuk Napas, Bukan untuk Halaman
Pindahkan adegan ke Writing Assistant atau Film Screenwriter. Potong anak kalimat bertumpuk. Eja nama sulit secara fonetis dalam tanda kurung. Tambahkan catatan penampilan yang dapat dijalankan model.
"Tulis ulang paragraf lore ini menjadi enam dialog lisan untuk Ryn, maksimal dua belas kata masing-masing, dengan jeda yang ditandai sebelum dialog terakhir."
Langkah 3: Ubah Panduan Menjadi Prompt Generator
Serahkan batasan yang sama kepada Prompt Generator. Tentukan ruang rekaman, jarak mikrofon, emosi pada skala 1–5, dan hal yang harus dihindari. Simpan satu blok untuk tiap karakter agar episode keempat tidak melenceng.
"Ubah panduan Ryn menjadi prompt model suara: alto remaja, kering, reverb gudang dalam ruangan, tempo 1.05x, tanpa senyum, tanpa akhiran gaya penyiar. Sertakan prompt negatif."
Langkah 4: Selaraskan Wajah, Panel, dan Musik
Masukkan panduan yang sama ke agen visual dan musik agar gambar serta latar selaras dengan suara. Wajah kartun cerah di atas pembacaan yang muram adalah cara audiens memutuskan bahwa audio itu palsu — bahkan saat modelnya akurat.
Langkah 5: Berlatih di Ponsel, Lalu Render
Jenova berjalan dengan kesetaraan fitur penuh di web, iOS, dan Android. Bacakan dialog keras-keras saat bepergian, tandai bagian yang tersendat, tulis ulang, lalu tempelkan ke generator suara karakter Anda. Rekaman tambahan termurah adalah yang tidak pernah perlu Anda rekam.
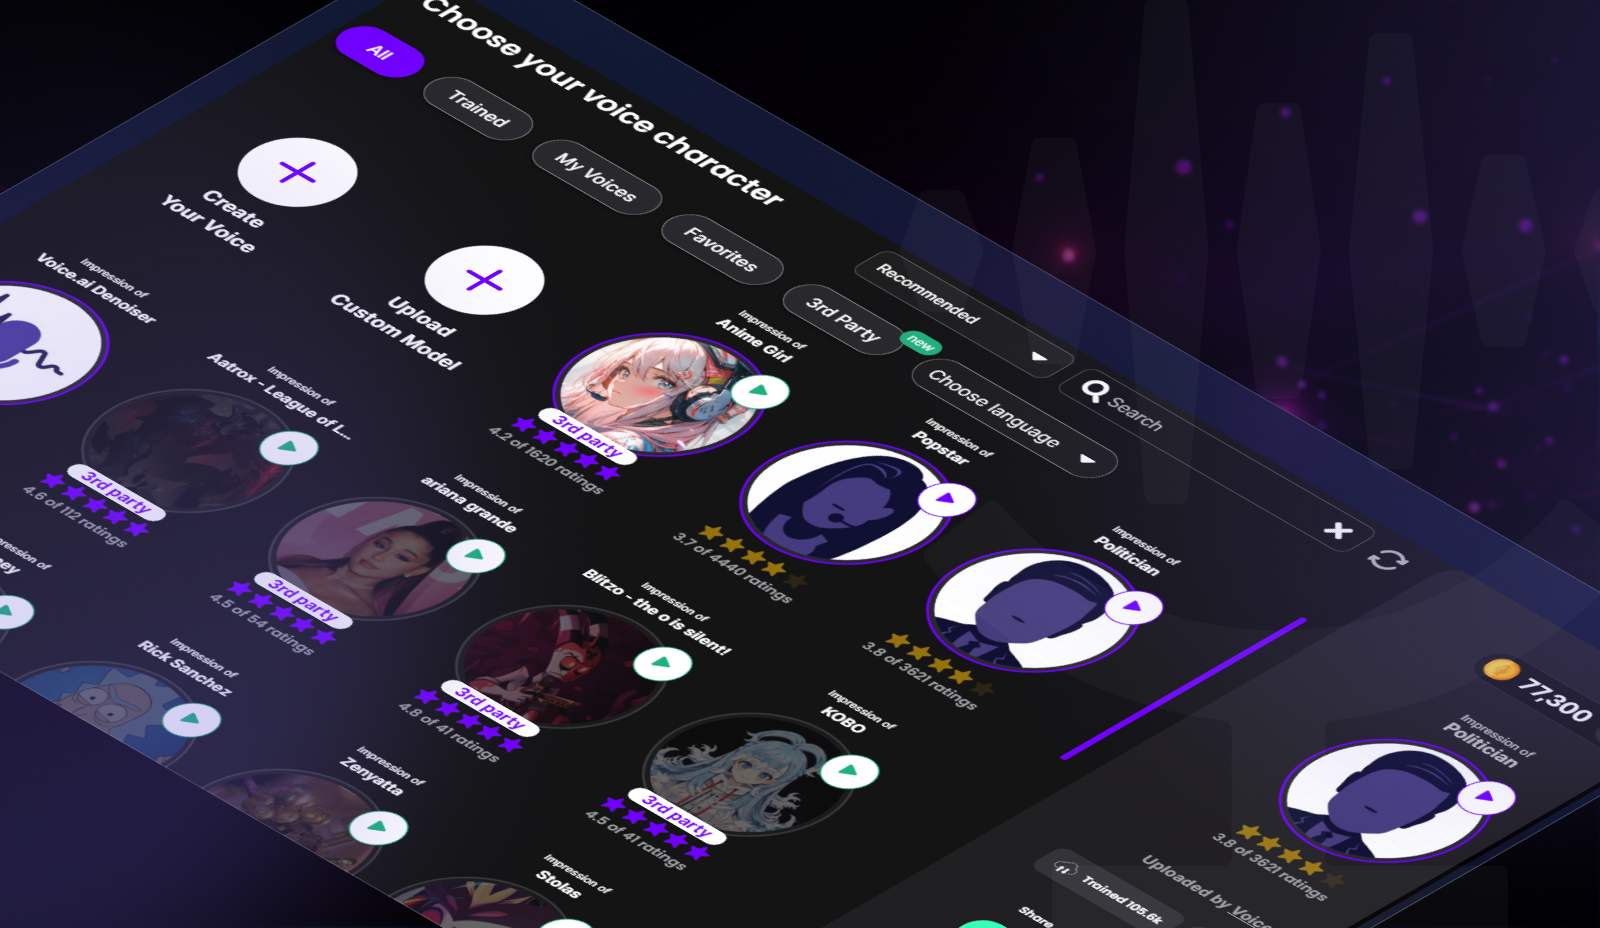
Hasil dan Kasus Penggunaan
🎮 NPC Game Indie Tanpa Anggaran Studio Rekaman
Skenario: RPG berdurasi 12 jam membutuhkan 4.000 dialog non-utama, ditambah pelafalan nama pemain.
Pendekatan Tradisional: Sesi serikat untuk peran utama, keheningan atau dialog pendek daur ulang untuk semua yang lain, dengan pelokalan mengantre untuk “suatu hari nanti”.
Jenova: Adegan pahlawan tetap ditangani manusia. Kebutuhan berskala besar mendapatkan panduan karakter, dialog yang mudah diucapkan, dan prompt stabil agar generator suara karakter Anda dapat mengisi penyambut, penjaga toko, dan NPC penyebar rumor tanpa mengkloning selebritas.
- Lembar karakter yang membuat pandai besi tidak terdengar seperti penyihir
- Dialog pendek siap pelokalan
- Blok prompt yang dapat Anda versikan seperti kode
🎬 Sulih Suara Webtoon dan Komik
Skenario: Serial vertikal mingguan menginginkan episode audio tanpa menunggu jajaran pemeran lengkap.
Pendekatan Tradisional: Sulih suara penggemar dengan mikrofon yang tidak seragam, atau satu narator yang memainkan setiap peran.
Jenova: Webtoon Creator dan Comic Creator menjaga kesinambungan visual sementara penulis skenario membagi suara berdasarkan panel. Setiap peran mendapatkan prompt sendiri agar generator tidak perlu menebak.
- Dialog yang diatur waktunya per panel, bukan curahan prosa
- Pemeran berbeda untuk peran utama dan kerumunan
- Isyarat musik yang menyisakan ruang bagi ucapan
📱 Latihan Bahasa yang Terdengar Seperti Seseorang
Skenario: Anda sedang bepergian dan menginginkan percakapan, bukan suara buku teks.
Pendekatan Tradisional: Latihan Aplikasi dengan satu tutor sintetis dan tanpa ingatan atas kesalahan Anda.
Jenova: Learn English Through Roleplay menempatkan Anda dalam sebuah adegan bersama karakter yang konsisten. Anda dapat menyuarakan dialog yang sama nanti melalui generator untuk latihan mendengarkan — tetap sebagai karakter orisinal, bukan peniruan.
- Memori yang membuat barista tidak kembali ke awal di setiap sesi
- Idiom dalam situasi yang benar-benar akan Anda gunakan lagi
- Sesi seluler yang pas untuk perjalanan kereta
🎙️ Podcast Bermerek dan Jajaran Konten Sosial
Skenario: Kanal produk membutuhkan pembawa acara, rekan skeptis, dan penafian yang dibaca langsung setiap minggu.
Pendekatan Tradisional: Suara pendiri yang sama untuk setiap segmen, atau pekerja lepas yang tidak dapat hadir pada hari Kamis.
Jenova: Social Media Content Generator menyusun skrip khusus platform; agen penulisan dan prompt menjaga pembawa acara serta rekan skeptis agar tidak menyatu. Anda merendernya dengan alat suara berlisensi, bukan dengan kloning figur publik tanpa izin.
- Segmen berulang dengan diksi yang stabil
- Penafian yang ditulis untuk diucapkan, bukan dibaca sekilas
- Pembuka yang berukuran tepat untuk Shorts, Reels, dan episode penuh
Pertanyaan Umum
Apa itu generator suara karakter?
Generator suara karakter adalah perangkat lunak yang mengubah teks menjadi ucapan dengan identitas pilihan — usia, tinggi nada, aksen, dan emosi — sehingga peran yang berbeda tidak memakai ritme yang sama. Model audio menyediakan timbre. Penulisan karakter, arahan panggung, dan prompt menyediakan sosoknya. Alat di Jenova berada pada sisi penulisan tersebut: panduan karakter, dialog, dan instruksi siap model yang dapat Anda tempelkan ke sistem ucapan berlisensi apa pun.
Apakah generator suara karakter gratis digunakan?
Banyak aplikasi ucapan menawarkan paket gratis terbatas dan mengenakan biaya untuk klip lebih panjang, hak komersial, atau suara hasil kloning. Jenova memiliki paket gratis dengan fitur inti serta tingkatan berbayar jika Anda memerlukan penggunaan lebih banyak. Anggarkan dua biaya: pekerjaan kreatif (skrip, prompt, kesinambungan) dan perender (menit audio, lisensi suara). Persetujuan dan ketentuan komersial untuk suara hasil kloning terpisah dari harga langganan — baca keduanya sebelum Anda menerbitkan.
Bagaimana cara membuat suara karakter AI terdengar unik?
Berikan setiap peran satu aturan, batas kosakata, dan kebiasaan fisik, lalu tulis dialog yang tidak dapat mereka tukar. Cantumkan batasan itu di prompt setiap kali: ruang, tempo, emosi, dan prompt negatif terhadap ritme penyiar. Prompt Generator dibuat untuk arahan tersebut. Jika dua karakter masih terdengar identik setelah prompt yang baik, masalahnya ada pada panduan karakternya, bukan penggesernya.
Apakah legal mengkloning suara orang nyata?
Tidak secara otomatis, dan bukan sebagai preset lelucon. Anda memerlukan persetujuan yang jelas dan tercatat untuk penggunaan yang benar-benar Anda maksud, ditambah aturan hak publisitas dan hak cipta yang berlaku di yurisdiksi Anda. FTC memperlakukan kloning suara AI yang menipu sebagai masalah perlindungan konsumen, bukan sekadar hal baru. Perjanjian game dan hiburan semakin mewajibkan persetujuan tertulis serta pelaporan penggunaan. Bangun karakter orisinal atau replika berlisensi. Jangan mengambil suara politikus, aktor, atau penyanyi hanya karena dasbor membuatnya mudah.
Dapatkah saya menjalankan alur kerja ini di ponsel?
Ya. Jenova dibuat untuk web, iOS, dan Android dengan kemampuan inti yang sama, termasuk fitur ucapan-ke-teks saat Anda lebih suka berbicara ke catatan daripada mengetik di perjalanan. Buat draf dialog di kereta, rapikan, hasilkan prompt, lalu render di alat suara desktop jika di sanalah model berlisensi Anda berada.
Apa perbedaannya dengan text-to-speech biasa?
TTS biasa membaca kata-kata. Generator suara karakter mencoba memainkan sebuah peran. Penampilan tetap bergantung pada tulisan: identitas, konflik, dan arahan. Jenova tidak menggantikan perender audio berlisensi Anda. Jenova menghasilkan pengembangan karakter yang dibutuhkan perender tersebut melalui agen seperti Roleplay Game Master dan Film Screenwriter, sehingga Anda tidak membayar untuk mendengar asisten magang yang sama dalam enam kostum.
Kesimpulan
Generator suara karakter hanya sebaik sosok yang Anda minta untuk diperankannya. Pasar ucapan AI berkembang pesat, model dapat mengunci timbre dalam hitungan detik, dan regulator telah menolak gagasan bahwa “AI yang melakukannya” merupakan pembelaan. Jalur praktisnya lebih sempit dan lebih baik: karakter orisinal, replika berizin, tulisan yang mudah diucapkan, dan prompt yang dapat Anda ulangi.
Rancang perannya, tulis napasnya, lalu hasilkan rekamannya. Mulailah dengan Jenova — kemudian bawa dialog tersebut ke alat ucapan yang sudah Anda percayai.
Jelajahi lebih banyak alur kerja serupa melalui Roleplay Game Master, Writing Assistant, dan Prompt Generator. Saat karakternya jelas, suaranya memiliki arah untuk dituju.
Untuk Developer: Setiap agen dalam artikel ini tersedia secara terprogram melalui Jenova API — integrasikan panduan karakter, pembuatan dialog, dan prompting model suara ke dalam aplikasi Anda dengan satu integrasi. Dokumentasi lengkap →