Apakah Asisten Riset AI Khusus Lebih Andal daripada Chatbot?
2026-08-22
Bagaimana Keterlacakan dan Landasan Sumber Membedakan AI Riset dari Chatbot?
Asisten riset akademik khusus lebih andal daripada chatbot AI umum untuk keterlacakan sitasi dan ekstraksi bukti karena mereka mengambil informasi dari indeks ilmiah, mengaitkan klaim dengan bagian yang dapat diidentifikasi, serta menampilkan konteks yang mendukung atau bertentangan. Chatbot umum menghasilkan bahasa bibliografis yang fasih berdasarkan pola pelatihan, sehingga masih dapat mengarang penulis, judul, DOI, dan temuan yang tidak dapat ditelusuri kembali ke sumbernya.
Kesenjangan keandalan bukan soal kualitas tulisan. Ini soal apakah suatu klaim dapat diaudit.
Faktor utama yang membedakan bantuan riset yang layak disitasi dari prosa chatbot:
✅ Penelusuran sebelum pembuatan — jawaban disusun dari makalah yang terindeks, bukan hanya dari probabilitas token berikutnya ✅ Atribusi tingkat bagian — setiap temuan yang diekstrak merujuk ke kalimat, tabel, atau bagian tertentu, bukan sekadar judul makalah ✅ Visibilitas kontradiksi — karya lanjutan yang mendukung, membantah, atau hanya menyebut suatu klaim ditampilkan, bukan diratakan menjadi satu ringkasan ✅ Ekstraksi terstruktur — metode, sampel, hasil, dan keterbatasan dimasukkan ke dalam bidang yang dapat dibandingkan, bukan menjadi paragraf parafrasa ✅ Asal-usul yang dapat diperiksa manusia — setiap ringkasan, sitasi, dan temuan yang diekstrak dapat dibuka dan dibandingkan dengan sumber asli
Untuk membandingkan alat-alat ini secara berguna pada 2026, anggap keandalan sitasi sebagai sifat rekayasa, bukan janji merek. Sisa artikel ini mengevaluasi chatbot dan asisten riset berdasarkan sifat tersebut.
Mengapa Keandalan Sitasi Menjadi Masalah Integritas Riset?
Keandalan sitasi telah menjadi masalah integritas riset karena AI generatif kini digunakan dalam skala publikasi, sementara model umum masih mengarang referensi yang tampak cukup nyata untuk lolos dari peninjauan sekilas. Adopsi oleh mahasiswa dan peneliti meningkat tajam pada 2025, dan sitasi palsu bukan lagi kesalahan yang langka. Sitasi tersebut mulai masuk ke prosiding konferensi, manuskrip, dan graf sitasi.
Survei mahasiswa 2025 dari Higher Education Policy Institute menemukan bahwa penggunaan alat AI generatif untuk penilaian melonjak dari 53% menjadi 88% dalam satu tahun. Laporan terkait dari survei yang sama menyatakan bahwa 92% mahasiswa kini menggunakan AI dalam bentuk tertentu, naik dari 66% pada 2024. Volume tersebut penting karena referensi palsu yang meyakinkan lebih sulit dideteksi daripada referensi kosong.
Analisis 2026 dalam Energy Research & Social Science melaporkan bahwa ChatGPT menghasilkan 178 referensi untuk proposal riset, dengan 69 di antaranya tidak memiliki DOI yang valid. Makalah yang sama mengutip tinjauan GPTZero atas 4.841 makalah NeurIPS 2025 yang mengonfirmasi setidaknya 100 sitasi hasil halusinasi di 53 makalah yang diterima. Penelaahan sejawat oleh banyak ahli pun tidak menangkapnya.
Mekanismenya kini telah dijelaskan dengan baik. Halusinasi AI adalah keluaran yang fasih tetapi salah atau tidak berlandaskan sumber. Panduan perpustakaan universitas mencatat bahwa chatbot dapat mengarang satu sitasi lengkap — penulis, judul, dan jurnal. Science berpendapat bahwa model dilatih untuk menghasilkan jawaban bahkan ketika mereka tidak mengetahuinya. Saat perintahnya adalah “sitasi sumber”, model mencocokkan pola gaya bibliografis. Untuk karya yang khusus atau baru, pencocokan gaya tersebut berubah menjadi rekaan.
Apa yang Harus Dievaluasi Saat Memilih Asisten Riset AI?
Anda perlu mengevaluasi asisten riset AI berdasarkan apakah setiap klaim dapat ditelusuri, berlandaskan sumber, diatribusikan, dibandingkan dengan kontradiksi, dan diekstrak — bukan berdasarkan seberapa rapi prosanya. Ringkasan yang berguna adalah kerangka TRACE: Keterlacakan, landasan penelusuran, granularitas atribusi, kesadaran akan kontradiksi, dan keterestrakan.
Keterlacakan menanyakan apakah pembaca dapat berpindah dari satu kalimat dalam draf ke bagian pendukung yang tepat. Jika alat hanya menghasilkan referensi berformat, alat tersebut memberikan penunjuk, bukan bukti.
Landasan penelusuran menanyakan apakah sistem mencari korpus ilmiah atau mengambil sampel dari bobot model. Ekstraksi yang berlandaskan sitasi dirancang untuk mencegah rekaan tanpa sumber dan parafrasa tanpa atribusi dengan mewajibkan atribusi sumber yang eksplisit bagi setiap klaim yang diekstrak.
Granularitas atribusi membedakan sitasi tingkat makalah dari sitasi tingkat kalimat atau tingkat bidang. Makalahnya mungkin nyata, tetapi temuan yang dikutip bisa salah, kedaluwarsa, atau diambil dari abstrak alih-alih hasil penelitian.
Kesadaran akan kontradiksi menanyakan apakah alat menampilkan studi lanjutan yang mendukung, menantang, atau hanya menyebut klaim tersebut. Satu abstrak yang mengonfirmasi bukanlah literatur.
Keterestrakan menanyakan apakah metode, sampel, hasil, dan keterbatasan dapat dibandingkan dalam bidang terstruktur. Ringkasan prosa menyembunyikan data yang hilang. Tabel membuat kesenjangan terlihat.
Panduan sintesis bukti King's College London menyampaikan implikasi praktis secara tegas: alat AI dapat mendukung beberapa tahap tinjauan, tetapi tidak dapat menggantikan metode pencarian yang tervalidasi, dan sistem generatif masih menghasilkan referensi palsu. Tinjauan 2025 yang dikutip dalam panduan tersebut menyimpulkan bahwa bukti saat ini tidak mendukung penggunaan AI generatif dalam sintesis bukti tanpa keterlibatan manusia. Karena itu, pertanyaan evaluasinya bukan “Apakah alat ini dapat menulis?” Melainkan “Apakah alat ini dapat diaudit?”
Bagaimana Perbandingan Asisten Riset Khusus dengan Chatbot Umum?
Asisten riset khusus mengungguli chatbot umum dalam keterlacakan sitasi karena mereka mengikat jawaban pada makalah yang ditemukan, sedangkan chatbot tetap paling kuat untuk penyusunan draf, penjelasan, dan curah pendapat. Perbandingan yang jujur harus berbasis peran. Chatbot adalah mesin penulisan yang fleksibel. Asisten riset adalah sistem penelusuran yang lebih sempit dan lebih mudah diperiksa.
Elicit mencari jutaan makalah akademik dan mengembalikan laporan terstruktur dengan sitasi. Alat ini sangat kuat saat peneliti perlu menyusun metode, sampel, dan temuan dari sejumlah studi secara berdampingan. Perbandingan terkait Cochrane pada 2026 yang dikutip King's College London menemukan bahwa Elicit tidak memiliki sensitivitas pencarian yang cukup tinggi untuk menggantikan pencarian literatur tradisional, meskipun presisinya membuatnya berguna sebagai pelengkap. Itu adalah keterbatasan nyata, bukan catatan kaki.
Scite dibangun untuk verifikasi, bukan penyusunan draf. Scite melaporkan cakupan lebih dari 300 juta artikel ilmiah dan akses berlisensi melalui perjanjian dengan lebih dari 40 penerbit. Smart Citations miliknya mengklasifikasikan apakah makalah lanjutan mendukung, membandingkan secara kontras, atau hanya menyebut sebuah klaim. Setiap klaim yang dibuat asistennya ditautkan ke kalimat spesifik dalam makalah spesifik. Komprominya adalah cakupan: Scite lebih kuat dalam kecerdasan sitasi daripada alur kerja manuskrip menyeluruh.
ResearchRabbit paling kuat dalam pemetaan. Alat ini membantu peneliti menemukan makalah terkait, membuat peta sitasi, dan memantau perkembangan bidang dari satu artikel awal. Alat ini kurang berguna sebagai mesin ekstraksi bukti atau validasi sitasi. Itu bukan kekurangan jika tugasnya adalah penemuan.
Chatbot umum seperti ChatGPT tetap banyak digunakan karena dapat menyusun draf dengan cepat dan menangani pertanyaan lintas disiplin yang tidak rapi. Kelemahan terdokumentasinya adalah rekaan bibliografis. Pelaporan terbaru yang dirangkum dalam analisis integritas ilmiah 2026 menempatkan halusinasi sitasi faktual untuk model canggih seperti GPT-4o dan Claude 3.7 pada kisaran 15–20%, yang meningkat menjadi 35–55% untuk topik khusus atau baru. Tolok ukur yang mengaudit referensi ilmiah yang dihasilkan oleh model bahasa besar telah melaporkan tingkat kesalahan melebihi 30% dalam beberapa kondisi.
Academic Research Assistant milik Jenova berada pada posisi yang berbeda. Ini adalah Agen domain untuk penemuan literatur, persiapan manuskrip, dan manajemen sitasi, dengan memori persisten serta pencarian langsung di seluruh basis data akademik. Alat ini lebih kuat daripada chatbot dalam menjaga konsistensi proyek riset lintas sesi. Alat ini lebih lemah daripada Scite dalam klasifikasi sitasi teks lengkap berlisensi, dan lebih lemah daripada Elicit sebagai produk tabel ekstraksi khusus. Kesenjangan tersebut menjelaskan mengapa tumpukan alat gabungan masih mengungguli satu asisten mana pun.
| Fitur / Dimensi | Chatbot umum (misalnya ChatGPT) | Jenova Academic Research Assistant | Elicit | Scite | ResearchRabbit |
|---|---|---|---|---|---|
| Landasan penelusuran | Terutama memori model; penjelajahan berbeda menurut produk | Penelusuran ilmiah dan web langsung dalam Agen riset persisten | Pencarian korpus makalah dengan laporan terstruktur | Teks lengkap ilmiah berlisensi serta korpus terbuka | Penemuan graf sitasi dari makalah awal |
| Keterlacakan sitasi | Sering tidak dapat diverifikasi atau dibuat-buat | Sumber sebaris dengan verifikasi lanjutan terhadap sumber asli | Sitasi terhubung ke bidang yang diekstrak | Tautan tingkat kalimat serta label dukungan/kontras | Tautan jaringan antar makalah, bukan bukti tingkat klaim |
| Ekstraksi bukti | Ringkasan bentuk bebas | Catatan, perbandingan, dan sintesis siap manuskrip | Tabel terstruktur yang kuat | Lebih kuat pada konteks sitasi daripada ekstraksi bidang | Terbatas; pemetaan lebih diutamakan daripada ekstraksi |
| Kesadaran akan kontradiksi | Biasanya diratakan menjadi satu jawaban | Dapat membandingkan temuan yang saling bertentangan saat diminta | Bergantung pada kumpulan hasil yang ditemukan | Fitur produk inti melalui Smart Citations | Tidak langsung, melalui klaster karya terkait |
| Harga (per 2026) | Belum diverifikasi di berbagai paket | Paket gratis; paket berbayar mulai $20/bulan | Belum diverifikasi | Belum diverifikasi | Belum diverifikasi |
| Paling cocok untuk | Penyusunan draf, penjelasan, perumusan awal | Proyek akademik berkelanjutan yang memerlukan penemuan serta memori penulisan | Menyaring makalah ke dalam tabel bukti yang dapat dibandingkan | Memeriksa apakah suatu klaim didukung atau dibantah | Pemetaan literatur visual dan penemuan penulis/klaster |
Rangkuman alat AI untuk riset akademik pada 2026 mencapai pembagian kerja serupa: Elicit unggul dalam ekstraksi terstruktur, Consensus paling cepat untuk pemeriksaan bukti singkat, dan Semantic Scholar tetap menjadi indeks penemuan gratis terkuat. Tidak ada satu kolom pun dalam lanskap tersebut yang dapat menggantikan kolom lainnya.
Bagaimana Ekstraksi Bukti Berbeda di Berbagai Alat AI Akademik?
Ekstraksi bukti berbeda berdasarkan apakah alat mengembalikan bidang yang dapat dibandingkan atau hanya parafrasa naratif. Ekstraksi tingkat bidang lebih andal untuk metode, ukuran sampel, hasil, dan keterbatasan karena nilai yang hilang tetap terlihat. Ekstraksi naratif lebih cepat dan lebih mudah dibaca, tetapi menyembunyikan perbedaan antara hasil, interpretasi, dan detail hasil halusinasi.
Elicit adalah contoh paling jelas dari pendekatan terstruktur. Alat ini dirancang untuk mengubah pertanyaan riset menjadi laporan dengan baris berupa makalah dan kolom berupa karakteristik studi. Format ini menjadi alasan para peninjau sering memilihnya untuk penyaringan awal. Alat ini tetap membutuhkan manusia untuk memeriksa logika inklusi, karena presisi tinggi tidak sama dengan cakupan tinggi.
Scite mengekstrak objek yang berbeda: konteks sitasi. Alih-alih menanyakan “Apa temuan makalah ini?”, Scite menanyakan “Apa yang dilakukan makalah-makalah berikutnya terhadap temuan ini?” Pendekatan itu lebih dekat pada penilaian bukti daripada ekstraksi data. Ini sangat berguna setelah makalah kandidat telah diidentifikasi.
Chatbot umum mengekstrak dalam bentuk prosa. Mintalah perbandingan empat uji acak terkontrol dan mereka akan menghasilkan paragraf yang meyakinkan. Paragraf tersebut mungkin berguna sebagai sketsa awal. Namun, itu adalah artefak audit yang buruk karena tidak ada bidang yang dapat ditandai sebagai “tidak dilaporkan”.
Academic Research Assistant milik Jenova dan Agen pendampingnya, Deep Research, berada di antara dua kutub tersebut. Deep Research menelusuri secara luas dan menghasilkan laporan tersintesis dengan sitasi sebaris. Academic Research Assistant menjaga proyek tetap berstatus: keputusan inklusi sebelumnya, makalah yang ditolak, persyaratan gaya, dan bagian manuskrip yang belum selesai tetap tersedia pada sesi berikutnya. Pengujian alur kerja ini menunjukkan keunggulan praktis dalam tinjauan literatur yang berlangsung berminggu-minggu. Keterbatasannya juga sama praktisnya. Kedua Agen tersebut bukan penyaring tinjauan sistematis khusus seperti alat yang dibuat khusus, misalnya Rayyan atau DistillerSR, yang masih dipandang pustakawan sintesis bukti sebagai pilihan yang lebih dievaluasi untuk penyaringan judul dan abstrak.
Perintah ekstraksi yang andal membuat bidang yang diinginkan menjadi eksplisit:
“Ekstrak dari makalah-makalah ini: desain studi, ukuran sampel, populasi, hasil utama, arah efek, keterbatasan yang dinyatakan, dan kalimat persis yang mendukung setiap bidang. Jika suatu bidang tidak ada, tulis ‘tidak dilaporkan’ alih-alih menyimpulkannya.”
Perintah yang sama dalam chatbot tetap hanya sebaik teks yang berhasil diambil. Jika model tidak pernah membuka makalahnya, model akan mengisi tabel berdasarkan ingatan gaya.
Apa Saja yang Sebenarnya Diperlukan oleh Alur Verifikasi Sitasi?
Alur verifikasi sitasi memerlukan dokumen sumber, bukan sekadar string referensi. Proses minimum yang layak adalah: memasukkan teks yang disitasi, memecahnya menjadi bagian-bagian, mengambil bagian yang paling relevan dengan klaim, memberi peringkat ulang, lalu mengklasifikasikan hubungan antara klaim dan bukti. Apa pun yang kurang dari itu hanyalah pemformatan bibliografi.
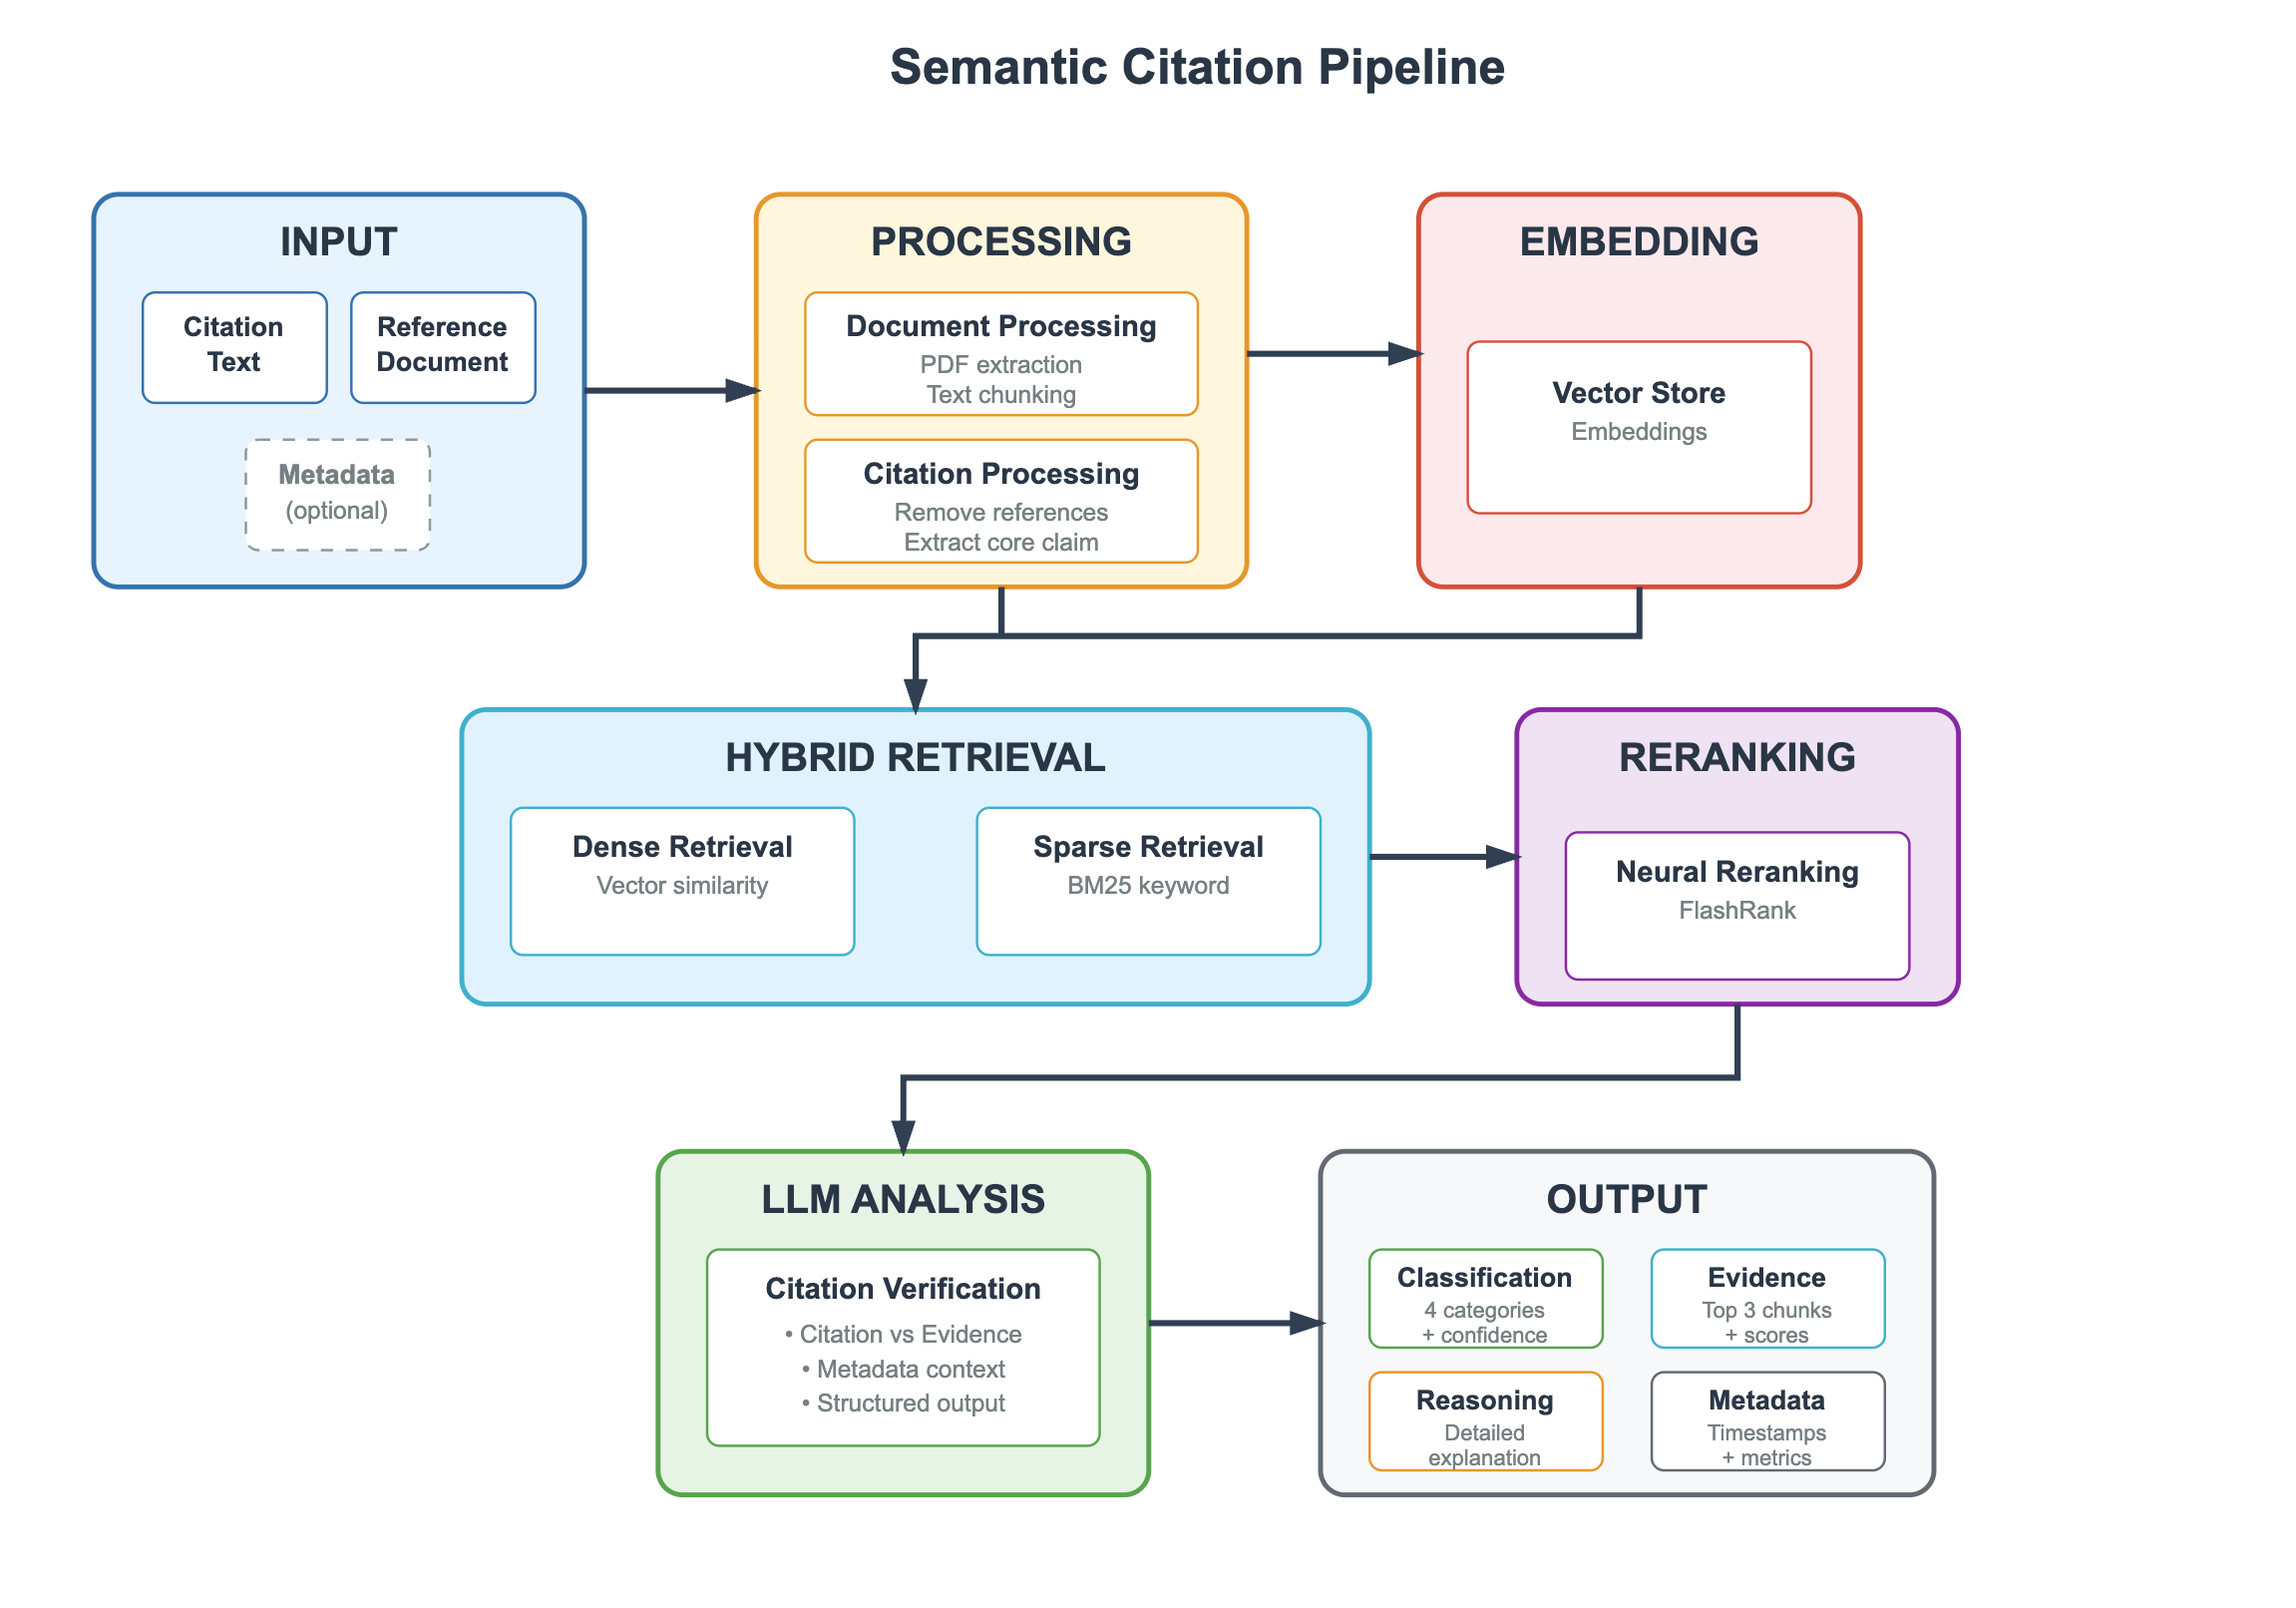
Arsitektur di atas adalah perbedaan antara “sitasi ini tampak nyata” dan “sitasi ini didukung.” Masukannya adalah klaim ditambah dokumen referensi. Pemrosesan menghapus bibliografi, mengekstrak klaim inti, dan memecah PDF menjadi bagian-bagian. Penelusuran hibrida kemudian mencari kemiripan vektor dan tumpang tindih kata kunci, yang penting karena nama metode dan ukuran hasil sering gagal ditemukan oleh pencarian semantik murni. Pemberian peringkat ulang neural mempertahankan bagian teratas. Baru setelah itu LLM mengklasifikasikan hubungan dan mengembalikan bukti, tingkat keyakinan, serta penalaran.
Sistem seperti SemanticCite sedang dibangun secara khusus untuk memverifikasi akurasi sitasi melalui analisis sumber teks lengkap. Pilihan desain tersebut ada karena pencocokan metadata tidak cukup. DOI dapat valid sementara kalimat yang disitasi berasal dari makalah berbeda, abstrak preprint, atau temuan yang kemudian diberi kualifikasi oleh para penulisnya.
Infrastruktur penerbit tidak menyelesaikan masalah ini secara otomatis. Jurnal besar telah menautkan referensi, tetapi perkiraan yang dibahas dalam analisis integritas 2026 menempatkan kegagalan DOI, atau tautan mati, hingga 37% dalam sampel konten ilmiah. Tautan hijau bukanlah klaim yang telah diverifikasi.
Di sinilah chatbot umum gagal dengan cara yang paling dapat diprediksi. Mereka mengoptimalkan jawaban yang lengkap. Alur verifikasi mengoptimalkan hubungan yang terklasifikasi: didukung, tidak didukung, dibantah, atau bukti tidak memadai. Keempat label tersebut lebih berguna secara ilmiah daripada paragraf yang rapi, karena memberi tahu peneliti jenis pemeriksaan yang masih diperlukan.
Agen Jenova dapat menjalankan versi ringan dari putaran ini dengan mengambil makalah kandidat, mengutip bagian pendukung, dan menandai klaim yang tidak dapat ditemukan. Saat ini, Agen tersebut belum menggantikan pengklasifikasi sitasi teks lengkap berlisensi dengan cakupan setingkat penerbit. Peneliti yang membutuhkan label Smart Citation tetap memasangkan Agen penulisan dengan Scite daripada meminta satu sistem melakukan kedua pekerjaan.
Bagaimana Membangun Alur Kerja Literatur Berbantuan AI yang Lebih Aman?
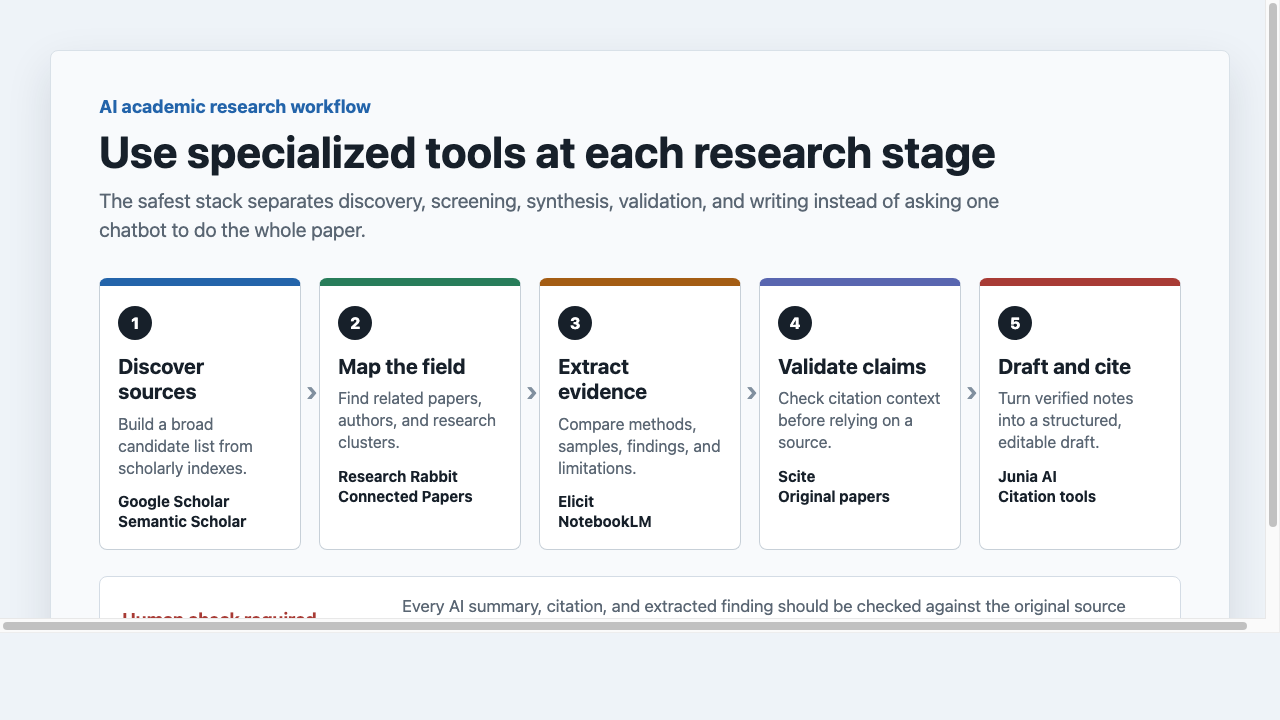
Anda membangun alur kerja literatur berbantuan AI yang lebih aman dengan menetapkan setiap tahap pada alat yang dapat diperiksa, lalu memverifikasi setiap temuan yang diekstrak terhadap makalah asli. Pola yang tidak aman adalah meminta satu chatbot untuk menemukan, menyaring, mengekstrak, memvalidasi, dan menulis.
Alur kerja bertahap terlihat seperti ini:
- Temukan sumber di indeks ilmiah seperti Google Scholar atau Semantic Scholar, bukan di jendela chat.
- Petakan bidang dengan ResearchRabbit atau Connected Papers agar penulis dan klaster terkait terlihat.
- Ekstrak bukti dengan Elicit, NotebookLM, atau Agen riset ke dalam catatan terstruktur.
- Validasi klaim di Scite dan PDF asli sebelum kalimat apa pun dianggap layak disitasi.
- Susun draf dan sitasi hanya dari kumpulan catatan yang telah diverifikasi.
Untuk Academic Research Assistant milik Jenova, pengaturannya berupa ringkasan riset, bukan tur fitur:
- Buka Agen di jenova.ai/a/academic-research-assistant.
- Nyatakan pertanyaan, disiplin, dan seperti apa hasil akhir yang dianggap selesai:
“Saya sedang menulis bagian metode tentang tingkat kesalahan sitasi LLM. Prioritaskan studi yang telah ditelaah sejawat dan analisis penerbit dari 2023–2026. Untuk setiap sumber, ekstrak sampel, definisi kesalahan, tingkat halusinasi, dan apakah manusia memverifikasi referensinya.”
- Minta daftar kandidat terlebih dahulu, lalu tabel ekstraksi, kemudian prosa. Jangan langsung melompat ke draf.
- Simpan makalah yang ditolak dalam utas yang sama agar Agen tidak memperkenalkannya kembali nanti.
Untuk Elicit, langkah awal yang setara adalah pertanyaan sempit dan daftar kolom: populasi, intervensi, hasil, jenis studi. Untuk Scite, mulailah dari makalah atau klaim yang telah dikenal dan periksa sitasi yang mendukung dibandingkan dengan yang berkontras sebelum menulis. Untuk chatbot umum, penggunaan paling aman adalah membuat kerangka dan mengedit bahasa setelah sumbernya sudah tersedia.
Dua aturan operasional mencegah sebagian besar kegagalan. Pertama, jangan pernah menerima sitasi yang tidak dapat dibuka. Kedua, jangan pernah membiarkan model penyusun draf menjadi satu-satunya catatan mengenai isi suatu makalah. Catatan yang telah diverifikasi adalah sumber kebenaran. Draf hanyalah penyusunan ulang catatan tersebut.
Kapan Chatbot Serbaguna Tetap Menjadi Alat Akademik yang Lebih Baik?
Chatbot serbaguna tetap menjadi alat akademik yang lebih baik ketika tugasnya berkaitan dengan bahasa, struktur, atau penjelasan, bukan bukti. Keandalan bergantung pada pekerjaannya. Keterlacakan sitasi adalah pengujian yang salah untuk model penulisan, seperti kefasihan prosa adalah pengujian yang salah untuk indeks penelusuran.
Chatbot tetap berguna untuk:
- Mengubah kerangka yang telah diverifikasi menjadi prosa akademik yang lebih rapi
- Menjelaskan metode yang telah dibaca peneliti
- Menghasilkan string pencarian, kontraargumen, atau daftar periksa revisi
- Menerjemahkan bagian padat menjadi bahasa yang lebih sederhana untuk catatan, bukan untuk sitasi
Chatbot adalah mesin literatur utama yang buruk. Karya klasifikasi yang terkait dengan Nature memperlakukan pernyataan chatbot tanpa dasar sebagai jenis halusinasi tersendiri, dan panduan perpustakaan terus mengulang peringatan yang sama: sitasi palsu dapat memuat paket lengkap penulis-judul-jurnal. Mode kegagalan ini mahal dalam tesis, proposal hibah, dan pengajuan jurnal, ketika satu referensi rekaan dapat merusak kredibilitas argumen yang sebenarnya cermat.
Ada pula alasan alur kerja untuk mempertahankan chatbot dalam tumpukan alat. Alat khusus lebih sempit. Elicit tidak akan memperbaiki ritme sebuah paragraf. Scite tidak akan menjalankan percakapan bimbingan sepanjang semester tentang satu bab disertasi. ResearchRabbit tidak akan memformat gaya referensi suatu jurnal. Chatbot, atau Agen penulisan umum, mengisi kesenjangan tersebut setelah bukti dikunci.
Aturan praktisnya adalah urutan. Gunakan penelusuran dan verifikasi khusus terlebih dahulu. Gunakan model umum setelahnya, dan hanya pada teks yang sumbernya sudah ada dalam pustaka yang dapat Anda buka. Jika chatbot memperkenalkan sitasi baru selama revisi, perlakukan sitasi tersebut sebagai tidak tepercaya sampai lolos pemeriksaan TRACE yang sama dengan bagian manuskrip lainnya.
Apa Kata Spesialis Integritas Riset tentang Sitasi AI?
Spesialis integritas riset memperlakukan chatbot umum sebagai alat bantu penyusunan draf dan sistem khusus yang terikat pada sumber sebagai satu-satunya lapisan yang dapat diterima untuk klaim yang akan disitasi. Konsensusnya bukan “hindari AI.” Melainkan “jangan biarkan generator tanpa landasan sumber menjadi catatan mengenai apa yang dikatakan literatur.”
“Kegagalan yang terus kami lihat bukan karena model menulis dengan buruk. Masalahnya adalah model menulis bibliografi lengkap untuk makalah yang tidak ada, atau untuk makalah nyata yang tidak memuat hasil yang diklaim. Begitu string tersebut masuk ke draf, ia berperilaku seperti bukti. Penelaah, rekan penulis, dan alat sitasi berikutnya dapat menyebarkannya sebelum siapa pun membuka sumbernya.”
“Asisten riset khusus mengubah unit kerja. Alih-alih meminta paragraf dengan sitasi, Anda meminta klaim, bagian teks, dan klasifikasi: didukung, tidak didukung, dibantah, atau tidak memadai. Keluaran ini lebih lambat dan kurang elegan. Namun, ini juga satu-satunya keluaran yang dapat dipertahankan oleh bagian metode.”
“Memori proyek persisten lebih penting daripada yang diperkirakan orang. Halusinasi sering masuk kembali ke sebuah makalah saat revisi, ketika chatbot umum diminta untuk ‘menambahkan sumber’ ke bagian yang sebelumnya sudah bersih. Asisten yang mengingat makalah mana yang dikecualikan, dan alasannya, sedang melakukan pekerjaan integritas, bukan hanya pekerjaan kenyamanan. Bahkan begitu, PDF asli tetap menjadi otoritas.”
— Tim Produk Jenova, alur kerja riset akademik, pekerjaan multi-tahun dalam desain Agen yang berlandaskan sitasi
Posisi tersebut sejalan dengan panduan pustakawan dan sintesis bukti. King's College London menyarankan penggunaan AI sebagai pelengkap, pemeriksaan hak cipta sebelum mengunggah teks lengkap, serta asumsi bahwa alat generatif masih dapat mengarang referensi dan tajuk subjek. Analisis tingkat penerbit kini memperlakukan referensi hasil halusinasi sebagai masalah korpus, bukan sekadar masalah anekdotal. Satu komentar pada 2026, yang merujuk pada pemeriksaan Nature terhadap sekitar 4.000 publikasi, mencatat bahwa 65 dari 100 makalah yang paling mencurigakan memuat setidaknya satu referensi tidak valid, pola yang dapat mengindikasikan lebih dari 110.000 makalah terdampak di antara sekitar 7 juta publikasi pada 2025.
Implikasi dari para ahli bersifat operasional. Pilih alat yang membuat pemeriksaan menjadi mudah. Tolak alat yang membuat pemeriksaan terasa tidak perlu.
Referensi
- Higher Education Policy Institute — Survei AI Generatif Mahasiswa 2025
- ERIC / U.S. Department of Education — Survei AI Generatif Mahasiswa 2025, HEPI Policy Note 61
- Boretti, Energy Research & Social Science — Halusinasi dalam AI generatif dan integritas ilmiah
- Wikipedia — Halusinasi (kecerdasan buatan)
- University of Nebraska Medical Center McGoogan Library — Halusinasi AI dengan Sitasi
- Science / AAAS — Mengapa model AI berhalusinasi alih-alih mengakui ketidakpastian
- LlamaIndex — Ekstraksi Berlandaskan Sitasi
- Panduan Perpustakaan King's College London — Alat AI dalam sintesis bukti
- Elicit — AI untuk riset ilmiah
- Scite — Riset berbasis sitasi dan Smart Citations
- ResearchRabbit — Pemetaan literatur dan jaringan sitasi
- newline — Tolok ukur untuk memeriksa referensi ilmiah yang dihasilkan oleh LLM
- Paperguide — Perbandingan alat AI riset akademik, 2026
- arXiv — SemanticCite: verifikasi sitasi dengan analisis teks lengkap
- Nature Humanities and Social Sciences Communications — Klasifikasi halusinasi AI