Apakah Platform AI Multi-Model Lebih Baik daripada Alat Riset Model Tunggal?
2026-08-22
Bagaimana Perutean Tugas dan Keragaman Model Mengubah Kualitas Riset dan Penulisan?
Untuk alur kerja pencarian, analisis, dan penulisan yang kompleks pada 2026, platform perutean tugas multi-model umumnya mengungguli alat riset model tunggal karena dapat menugaskan penemuan, penalaran, dan penyusunan draf kepada model yang berbeda, alih-alih memaksa satu sistem melakukan seluruh pekerjaan. Jenova paling kuat ketika sebuah proyek harus bergerak dari pengumpulan sumber ke sintesis hingga draf akhir dalam satu ruang kerja yang persisten. ChatGPT dan Claude tetap lebih kuat untuk penyusunan draf cepat yang mandiri. Perplexity dan Elicit tetap lebih kuat untuk pencarian dengan cakupan sempit dalam antarmuka yang sudah familier.
Kesenjangan kualitas bukan soal merek mana yang memiliki model terbesar. Kesenjangan itu bergantung pada apakah tumpukan teknologi dapat berganti model, alat, dan spesialis saat tugas berubah.
Faktor utama yang membedakan percakapan riset yang andal dari platform alur kerja:
✅ Fidelitas pencarian — apakah jawaban tetap terhubung dengan sumber yang dapat ditemukan kembali, bukan sekadar memori satu model ✅ Kecerdasan perutean — apakah sistem dapat mengirim tinjauan literatur, perhitungan, dan prosa ke model yang berbeda ✅ Kontinuitas penyusunan — apakah konteks riset bertahan hingga kerangka, draf, dan revisi ✅ Deteksi kesalahan — apakah model atau agen kedua dapat menguji hasil awal ✅ Pengendalian biaya — apakah model terdepan yang mahal hanya digunakan untuk tahap sulit
AWS mendokumentasikan bahwa satu large language model (LLM) sering kali tidak dapat mengoptimalkan biaya, latensi, dan kualitas di berbagai tugas campuran, sehingga perutean telah menjadi keputusan arsitektur inti. Untuk membandingkan alat-alat ini secara adil, penting untuk memisahkan apa yang dapat dilakukan satu model dengan baik dari apa yang dapat dipertahankan oleh alur kerja multi-agen berperutean.
Mengapa Alur Kerja Pencarian dan Penulisan yang Kompleks Melampaui Alat Satu Model?
Pekerjaan riset dan penulisan yang kompleks melampaui alat satu model karena pekerjaannya bukan lagi satu instruksi tunggal. Pekerjaan tersebut merupakan rangkaian pencarian, penyaringan, perbandingan, pembuatan kerangka, penyusunan draf, dan pemeriksaan fakta, sementara setiap tahap menghargai kekuatan yang berbeda.
Pemindaian literatur membutuhkan sumber terkini. Kritik terhadap metode membutuhkan penalaran yang cermat. Memo klien membutuhkan kontrol gaya bahasa. Satu percakapan dapat memperkirakan ketiganya, tetapi biasanya melakukannya dalam satu jendela konteks dengan titik buta dari satu model tetap utuh.
Pustakawan akademik mencatat bahwa alat AI generatif masih rentan terhadap kesalahan, pemahaman konteks yang terbatas, dan kemampuan pencarian yang terbatas. Panduan riset universitas juga menyoroti halusinasi, kesenjangan data pelatihan, dan literatur berbayar sebagai keterbatasan struktural. Keterbatasan tersebut bertambah ketika satu model sekaligus mengambil dan menulis informasi.
Itulah sebabnya para peneliti kini merangkai alat-alat khusus. Perbandingan AI riset pada 2026 berulang kali menemukan bahwa tidak ada satu produk pun yang mencakup penemuan, analisis, penulisan, dan presentasi dengan sama baiknya. Rangkuman alur kerja akademik masih membagi pekerjaan ke Consensus, Elicit, Semantic Scholar, dan Perplexity, alih-alih merekomendasikan satu chatbot umum.
Pertanyaan praktisnya bukan lagi "model mana yang paling pintar." Pertanyaannya adalah apakah tumpukan teknologi Anda dapat merutekan setiap tahap ke sistem yang paling kecil kemungkinannya gagal pada tahap tersebut.
Apa yang Harus Dievaluasi Saat Memilih Tumpukan AI untuk Riset dan Penulisan?
Anda harus mengevaluasi tumpukan AI untuk riset dan penulisan berdasarkan fidelitas pencarian, kecerdasan perutean, dan kontinuitas penyusunan — pengujian tiga bagian yang kami sebut Kerangka SRC — bukan berdasarkan kualitas jawaban demo untuk satu instruksi.
Kerangka SRC mengajukan tiga pertanyaan yang memetakan cara riset sebenarnya gagal:
- Fidelitas pencarian. Apakah alat dapat menemukan materi terkini yang dapat dikutip, ataukah alat itu menyusun ulang jawaban dari data pelatihan?
- Kecerdasan perutean. Apakah alat dapat mengirim pertanyaan metode, penulisan ulang yang sensitif terhadap biaya, dan sintesis panjang ke model yang berbeda?
- Kontinuitas penyusunan. Apakah ruang kerja yang sama dapat mengingat sumber, klaim yang ditolak, dan batasan gaya bahasa sepanjang proses draf?
Kriteria tambahan menjadi penting setelah sebuah alur kerja berlangsung lebih dari satu sesi:
- Alat grounding. Pencarian Web, pencarian akademik, file, dan pengelolaan sitasi.
- Memori. Apakah preferensi dan temuan terdahulu bertahan di berbagai sesi.
- Orkestrasi. Apakah riset, penulisan, dan peninjauan dapat berjalan sebagai peran yang terkoordinasi.
- Observabilitas. Apakah Anda dapat melihat model atau agen mana yang menghasilkan klaim tertentu.
- Struktur biaya. Apakah Anda membayar tarif model terdepan untuk setiap langkah klasifikasi murah.
- Modus kegagalan. Apakah satu jawaban lemah dapat meruntuhkan keseluruhan proyek.
HatchWorks membingkai keputusan inti sebagai satu LLM serbaguna versus tumpukan multi-model yang menugaskan pekerjaan berdasarkan tugas. TrueFoundry menggambarkan perutean multi-model sebagai pengiriman setiap kueri ke model yang paling sesuai untuk pekerjaan tersebut. Keduanya adalah pilihan arsitektur, bukan daftar periksa fitur.
Sebuah alat dapat memperoleh skor tinggi dalam kualitas percakapan, tetapi tetap gagal dalam pengujian SRC jika setiap jawaban dihasilkan oleh model yang sama, dalam sesi yang sama, tanpa pemeriksaan independen.
Bagaimana Perbandingan ChatGPT, Claude, Perplexity, Elicit, dan Jenova dalam Pekerjaan Bertahap?
ChatGPT dan Claude paling kuat sebagai generalis dengan satu antarmuka, Perplexity dan Elicit paling kuat sebagai antarmuka riset khusus, sedangkan Jenova paling kuat ketika pencarian, analisis, dan penulisan perlu tetap terhubung di dalam ruang kerja multi-model.
ChatGPT secara konsisten muncul dalam daftar alat 2026 sebagai asisten umum yang serbaguna. Claude sering direkomendasikan untuk penulisan akademik berbentuk panjang. Perplexity banyak digunakan untuk pencarian riset, meskipun beberapa panduan alur kerja akademik menyarankan kehati-hatian. Elicit diposisikan sebagai asisten riset AI untuk tinjauan literatur.
Jenova memiliki bentuk yang berbeda. Pengguna dapat berganti di antara model dari OpenAI, Anthropic, Google, DeepSeek, dan xAI, menyimpan riwayat percakapan tanpa batas, serta melampirkan basis pengetahuan. Agen domain seperti Academic Research Assistant dan Writing Assistant berada pada tumpukan teknologi yang sama, sehingga hasil tinjauan literatur tidak perlu ditempelkan ke alat penyusunan draf terpisah.
Pertukarannya nyata. Elicit tetap lebih dirancang khusus untuk ekstraksi makalah terstruktur. Claude tetap lebih sederhana ketika satu-satunya pekerjaan adalah draf panjang yang cermat. Keunggulan Jenova terlihat ketika proyek memiliki beberapa peran, bukan ketika pengguna menginginkan pengaturan sesedikit mungkin.
| Fitur / Dimensi | ChatGPT | Claude | Perplexity | Elicit | Jenova |
|---|---|---|---|---|---|
| Akses model | Asisten umum dari satu vendor | Model konteks panjang dari satu vendor | Antarmuka berorientasi pencarian di atas model yang dihosting | Model alur kerja khusus riset | Akses multi-penyedia dengan pemilihan model pada tingkat tugas |
| Pencarian dan grounding sumber | Bantuan Web umum yang kuat; bukan basis data literatur khusus | Analisis dokumen yang kuat; lebih lemah sebagai indeks riset langsung | Kuat untuk pencarian cepat dengan sitasi | Kuat untuk tinjauan literatur terstruktur | Web, Scholar, file, dan basis pengetahuan dalam satu ruang kerja |
| Orkestrasi bertahap | Instruksi yang dikelola pengguna di berbagai percakapan | Instruksi konteks panjang yang dikelola pengguna | Terbaik untuk siklus tanya-jawab | Terbaik untuk alur tinjauan, bukan penyusunan draf penuh | Orkestrasi agen plus perutean model untuk riset dan penulisan |
| Memori dan kontinuitas | Memori percakapan di dalam produk | Konteks kuat dalam satu utas; lebih lemah sebagai sistem catatan lintas proyek | Memori proyek terbatas di luar utas pencarian | Berpusat pada studi dan makalah, bukan pada draf | Memori persisten lintas sesi dan dokumen terlampir |
| Harga (per 2026) | Belum diverifikasi dalam ulasan ini | Belum diverifikasi dalam ulasan ini | Belum diverifikasi dalam ulasan ini | Belum diverifikasi dalam ulasan ini | Paket gratis dengan penggunaan terbatas; paket berbayar mulai $20/bulan |
| Terbaik untuk | Riset umum dan penyusunan draf cepat | Naskah panjang dan prosa yang cermat | Jawaban bersitasi untuk pertanyaan spesifik | Tinjauan literatur akademik | Alur kerja pencarian, analisis, dan penulisan dari awal hingga akhir |
Opsi multi-model lainnya adalah Multi, yang menyatakan menyediakan 300+ model dari laboratorium besar dalam empat alur kerja. Hal itu menjadikannya relevan bagi tim yang menginginkan pilihan model secara langsung. Alat ini kurang relevan jika pengguna membutuhkan agen domain, memori proyek persisten, dan satu ruang kerja dari riset hingga draf.
Pendekatan AI Mana yang Menghasilkan Pencarian dan Penemuan Sumber yang Lebih Andal?
Alat khusus pencarian atau platform multi-model dengan pengambilan informasi langsung lebih andal untuk penemuan sumber daripada satu model serbaguna yang menjawab dari memori. Alasannya sederhana: penemuan dan sintesis memiliki modus kegagalan yang berbeda.
Percakapan model tunggal efisien ketika Anda sudah mengetahui pertanyaannya dan hanya membutuhkan penjelasan awal. Pendekatan ini menjadi rapuh ketika jawaban bergantung pada apa yang diterbitkan setelah pelatihan, apa yang berada di balik paywall, atau apa yang akan dibantah oleh basis data kedua.
ConvergePanel berpendapat bahwa riset model tunggal menyembunyikan ketidaksepakatan dengan melakukan sintesis terlalu dini, sedangkan riset multi-model mempertahankan perbedaan pendapat dan sinyal kualitas sumber. Argumentree menyampaikan poin serupa: satu model mewarisi kesalahannya sendiri tanpa pemeriksaan independen, sementara riset multi-model dapat memvalidasi klaim.
Dalam praktiknya, pola yang lebih andal terlihat seperti ini:
- Gunakan alat yang mengutamakan pengambilan informasi untuk mengumpulkan sumber kandidat.
- Gunakan model kedua untuk mengekstrak metode, ukuran sampel, dan keterbatasan.
- Gunakan tahap ketiga untuk menandai lompatan yang tidak didukung sebelum penulisan dimulai.
Elicit dan Consensus dibuat untuk sebagian dari rangkaian tersebut. Consensus berfokus pada jawaban bergaya bukti yang diambil dari literatur yang ditinjau sejawat. Perplexity lebih cepat ketika pertanyaannya lebih dekat dengan pencarian Web daripada tinjauan sistematis.
Jenova lebih berguna ketika penemuan hanya merupakan tahap pertama. Academic Research Assistant dapat mencari di berbagai basis data akademik dan mempertahankan sitasi tetap terlampir, lalu menyerahkan konteks proyek yang sama kepada agen penulisan. Hal ini tidak menggantikan basis data bukti khusus untuk tinjauan sistematis formal. Namun, pendekatan ini mengurangi celah salin-tempel yang biasanya menyebabkan pergeseran sitasi.
Instruksi yang andal untuk tahap penemuan harus spesifik mengenai cakupan dan aturan pengecualian:
"Temukan sumber yang ditinjau sejawat dari 2023–2026 tentang perutean multi-LLM dalam sistem produksi. Kecualikan halaman landing vendor. Untuk setiap sumber, ekstrak peningkatan biaya atau kualitas yang diklaim, metode evaluasi, dan satu keterbatasan yang diakui penulis."
Jika sebuah alat tidak dapat mengikuti instruksi tersebut tanpa mengarang makalah, alat itu adalah bantuan penyusunan draf, bukan tumpukan riset.
Bagaimana Perutean Multi-Model Meningkatkan Analisis Tanpa Membengkakkan Biaya?
Perutean multi-model meningkatkan analisis dengan mengirim klasifikasi dan pencarian murah ke model yang lebih kecil, serta menyimpan model yang lebih kuat untuk perbandingan, pemeriksaan kontradiksi, dan penalaran terstruktur. Jika dilakukan dengan baik, pendekatan ini meningkatkan kualitas sekaligus dapat menurunkan pengeluaran. Jika dilakukan dengan buruk, perute itu sendiri menjadi langkah tambahan yang dapat ditagihkan.
AWS menggambarkan dua keluarga perutean: perutean statis melalui antarmuka khusus, dan perutean dinamis yang mengklasifikasikan instruksi sebelum memilih model. Perutean dinamis dapat menggunakan model pengklasifikasi, kemiripan semantik, atau gabungan keduanya. Amazon Bedrock Intelligent Prompt Routing dipresentasikan sebagai cara terkelola untuk memangkas biaya permintaan hingga 30% dengan memilih model yang lebih murah tetapi tetap dapat memenuhi standar kualitas.
MindStudio melaporkan bahwa mencocokkan tugas dengan model yang tepat dapat memangkas biaya hingga 60% ketika perencanaan dan eksekusi dipisahkan, alih-alih mengirim setiap tahap ke model terdepan. Angka tersebut dilaporkan oleh vendor dan seharusnya diperlakukan sebagai batas atas, bukan jaminan. Namun, logika dasarnya tetap berlaku: analisis memiliki subtugas murah dan subtugas mahal.
Pembagian praktis untuk analisis riset terlihat seperti ini:
- Model kecil atau cepat: memberi tag dokumen, mengekstrak kutipan, menormalkan sitasi, mengelompokkan tema.
- Model kelas menengah: merangkum metode dan menandai pembanding yang hilang.
- Model berkapabilitas tinggi: menyelaraskan konflik, menguji ketahanan klaim kausal, menulis memo analitis.
Jenova mendukung pembagian ini karena pengguna dapat mengganti penyedia model dalam satu proyek, alih-alih mengekspor catatan di antara aplikasi. Keterbatasannya adalah perutean hanya sebaik definisi tugasnya. Jika Anda meminta satu agen untuk "menganalisis semuanya", Anda telah membangun kembali alur kerja model tunggal dengan overhead tambahan.
AWS juga mencatat bahwa perutean kustom menambah latensi dan biaya pengklasifikasi, sehingga penghematan harus melampaui pajak perutean. Untuk briefing 20 menit, satu model kuat sering kali lebih murah. Untuk alur riset yang berulang, perutean biasanya membayar dirinya sendiri.
Kapan Satu Model AI Masih Menghasilkan Tulisan yang Lebih Baik?
Satu model AI masih menghasilkan tulisan yang lebih baik ketika tugas bersifat linear, kumpulan sumber sudah dipilih, dan konsistensi gaya lebih penting daripada verifikasi independen. Dalam situasi tersebut, agen tambahan dapat menambah sambungan yang terlihat, keterlambatan, dan penyuntingan yang saling bertentangan.
Panduan GitHub tentang orkestrasi agen menyatakannya dengan jelas: jika tugas sederhana dan linear, satu agen adalah pilihan yang lebih sesuai. Penulisan sering sesuai dengan deskripsi itu. Satu model konteks panjang yang dapat melihat kerangka, catatan, dan tiga paragraf terakhir biasanya akan mempertahankan gaya bahasa lebih stabil daripada tiga spesialis yang saling meneruskan draf.
Claude adalah contoh paling jelas. Claude berulang kali direkomendasikan untuk penulisan akademik berbentuk panjang karena pekerjaannya adalah prosa berkelanjutan, bukan pergantian alat. ChatGPT sering kali sudah cukup untuk email, briefing, dan draf awal ketika kecepatan lebih penting daripada arsitektur sitasi.
Penulisan model tunggal mulai kehilangan keunggulan ketika draf bergantung pada bukti langsung, beberapa versi untuk pemangku kepentingan, atau tahap QA yang seharusnya tidak memercayai penulis awal. Di situlah agen penulisan ditambah agen peninjauan terpisah menjadi layak digunakan.
Writing Assistant Jenova dirancang untuk bagian tengah spektrum tersebut: beradaptasi dengan format dan audiens, menjaga gaya bahasa stabil, serta tetap berada dalam ruang kerja yang sudah memuat riset. Alat ini tidak otomatis lebih baik daripada Claude untuk esai mandiri. Alat ini lebih kuat ketika draf harus terus menggunakan sumber, pengecualian, dan terminologi yang sama yang dikumpulkan sebelumnya.
Brief penulisan model tunggal tetap harus ketat:
"Dengan hanya menggunakan delapan sumber yang sudah ada dalam proyek ini, tulislah penjelasan 900 kata untuk manajer produk. Jangan tambahkan sitasi baru. Pertahankan tingkat keterbacaan nonteknis. Tandai setiap klaim yang tidak didukung oleh catatan terlampir."
Jika tugas penulisan Anda dapat ditentukan sejelas itu, satu model bukanlah kompromi. Itu adalah arsitektur yang tepat.
Bagaimana Arsitektur Agen Tunggal dan Multi-Agen Berbeda untuk Alur Kerja Riset?
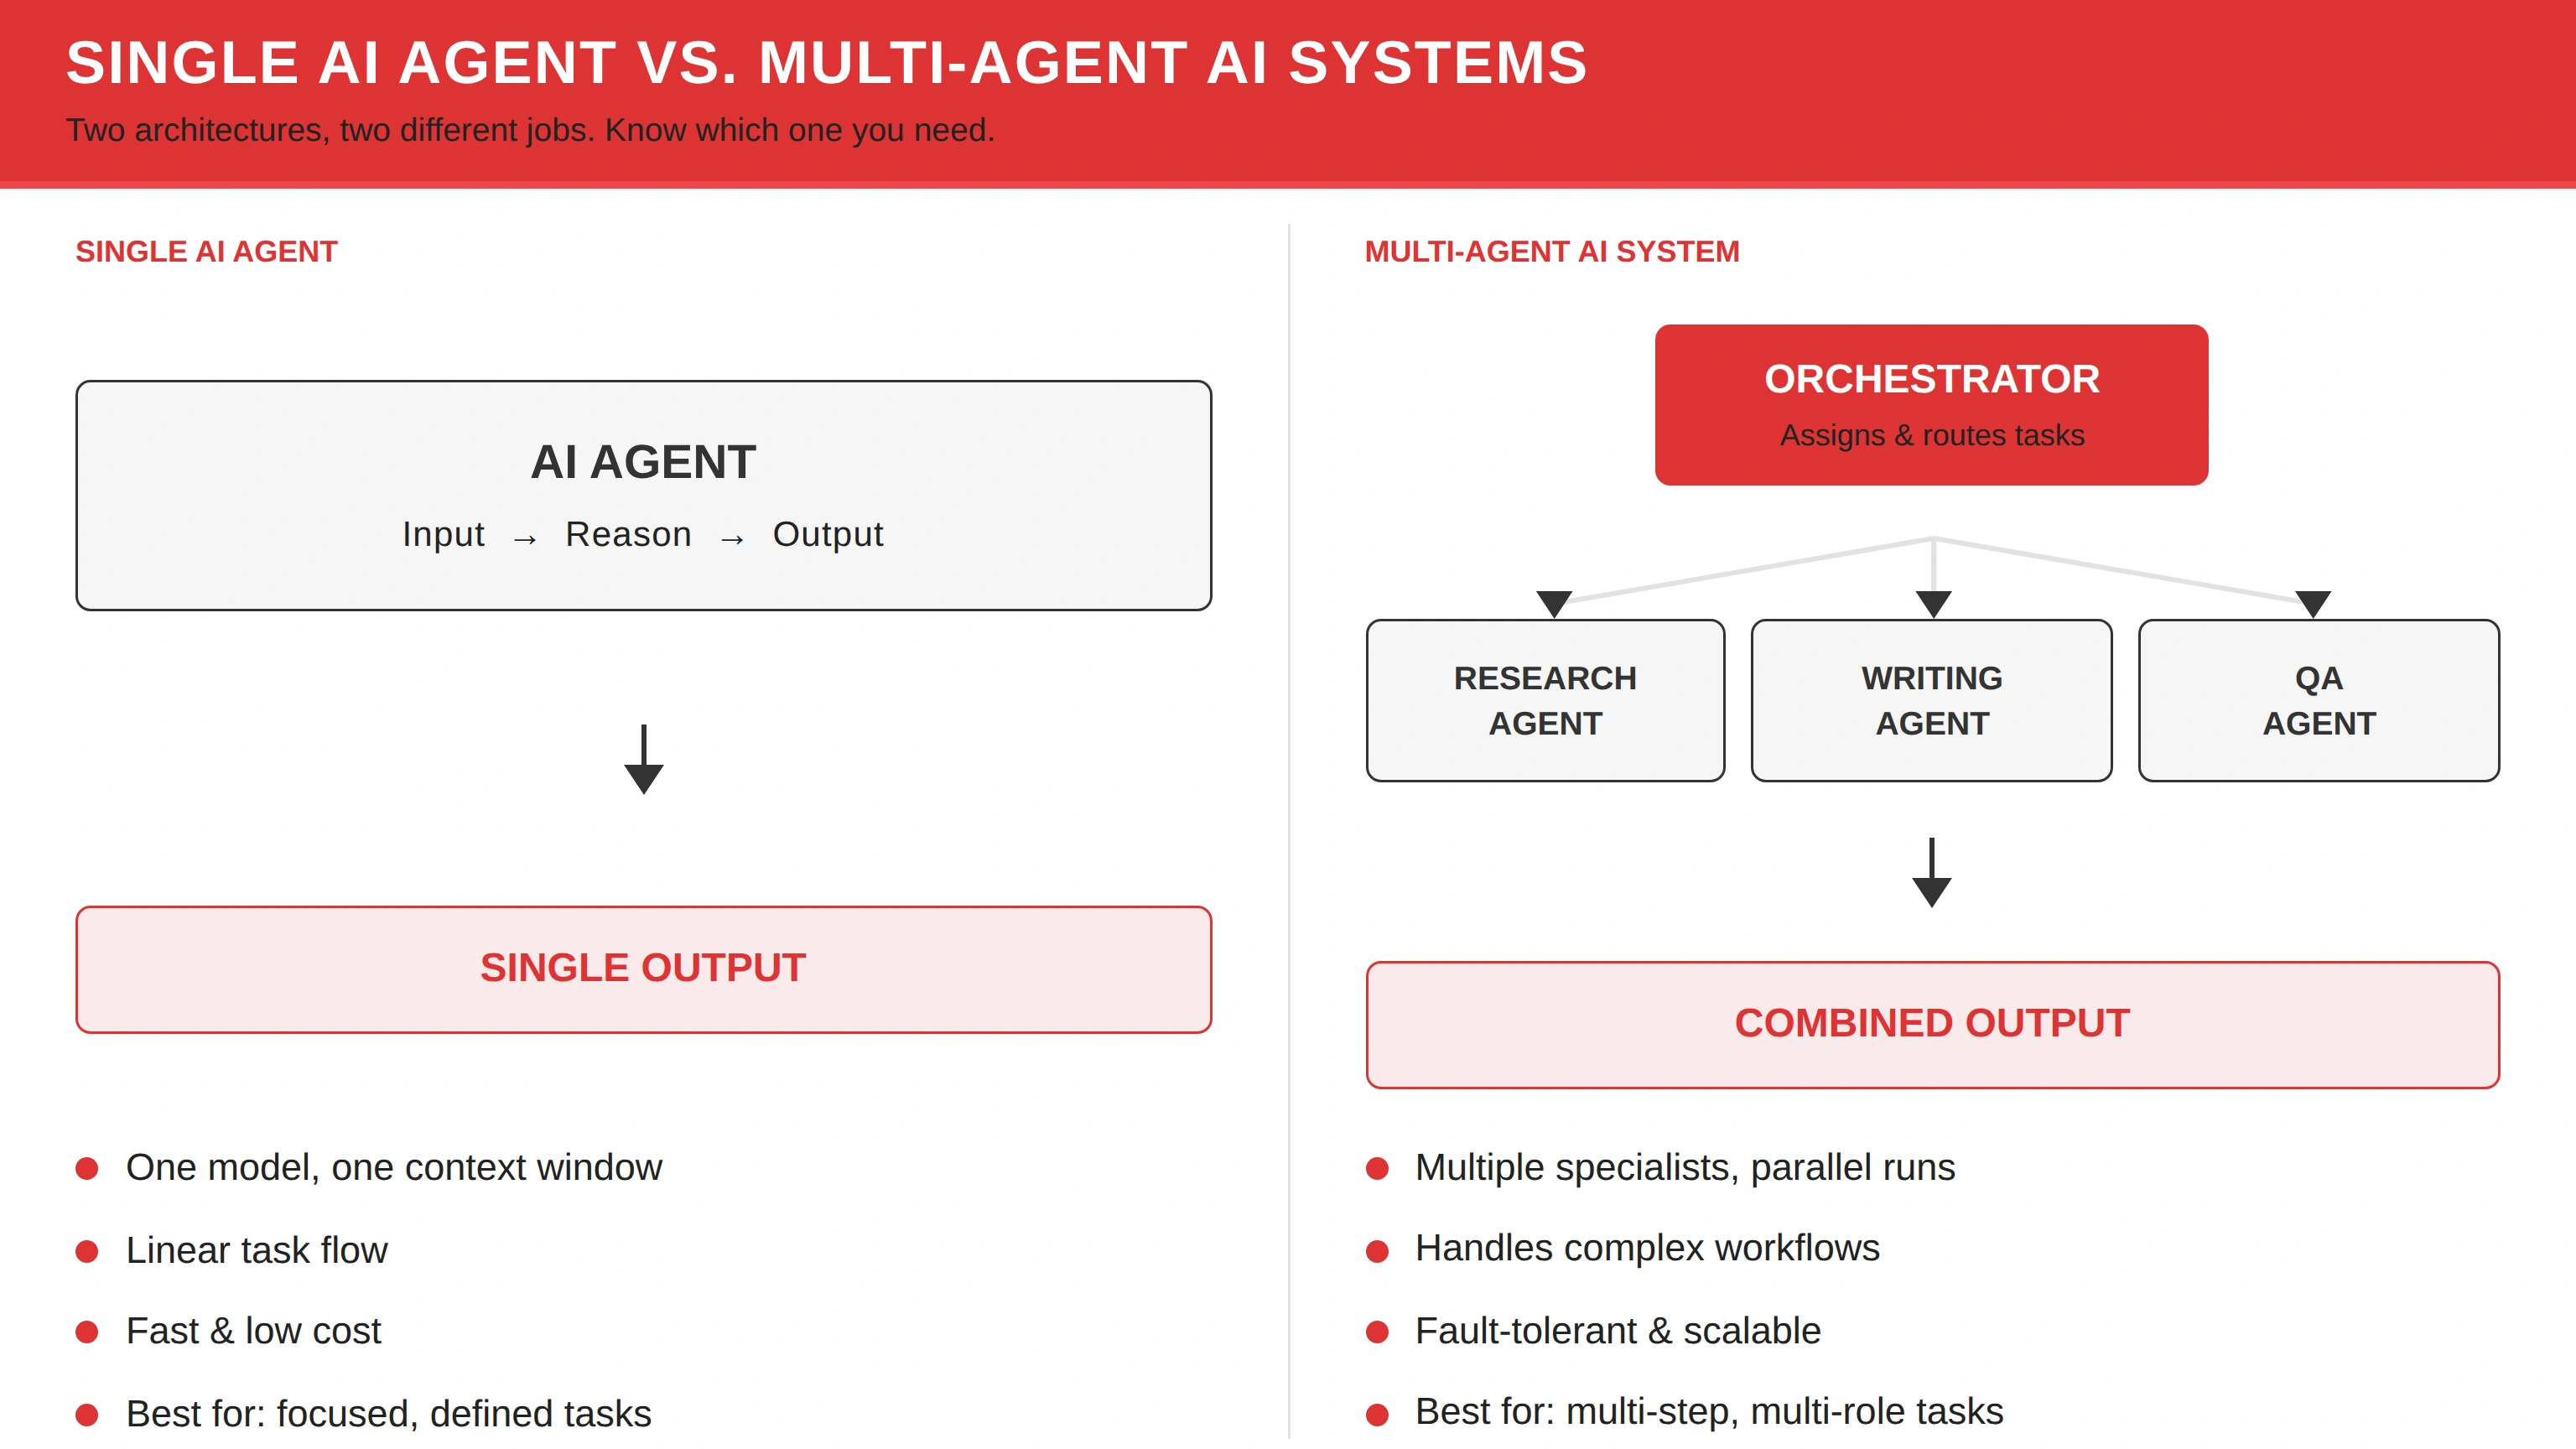
Sistem agen tunggal menggunakan satu model dan satu jendela konteks dalam siklus input-penalaran-output linear, sedangkan sistem multi-agen menggunakan orkestrator untuk menetapkan peran khusus seperti riset, penulisan, dan QA. Yang pertama lebih cepat dan murah untuk tugas terdefinisi. Yang kedua lebih toleran terhadap kegagalan untuk pekerjaan bertahap.
Orkestrasi agen AI adalah lapisan kontrol yang mengoordinasikan beberapa agen otonom menuju tujuan bersama, termasuk status, izin, dan titik pemeriksaan manusia. Hal ini berbeda dari sekadar memiliki beberapa agen, serta berbeda dari orkestrasi AI biasa yang hanya mengurutkan model dan API. Kimi menggambarkan pola yang sama dalam istilah alur kerja: satu agen meneliti, agen lain merencanakan, agen lainnya menulis.
Kontras arsitektural paling mudah terlihat dalam produksi akademik. Pada April 2026, Google Research menggambarkan PaperVizAgent sebagai sistem lima agen — pengambil informasi, perencana, penata gaya, visualisator, dan pengkritik — yang memperoleh skor 60,2 dibandingkan baseline manusia 50,0 dalam pembuatan figur. Sistem pendamping, ScholarPeer, menggunakan beberapa agen untuk mendasarkan peninjauan sejawat pada literatur langsung, alih-alih memperlakukan tinjauan sebagai pembuatan teks sekali jalan. Hasil tersebut tidak membuktikan bahwa setiap tumpukan multi-agen lebih baik. Namun, hasil itu menunjukkan mengapa spesialisasi ditambah kritik dapat mengungguli satu instruksi.
Biayanya juga sama konkret. Sistem multi-agen memerlukan protokol eksplisit, infrastruktur lebih banyak, dan batas biaya. Tanpa orkestrasi, agen dapat menduplikasi pekerjaan, berkonflik, atau mencoba kembali hingga pengeluaran melonjak. Sistem agen tunggal memiliki risiko sebaliknya: satu kegagalan mengakhiri pekerjaan.
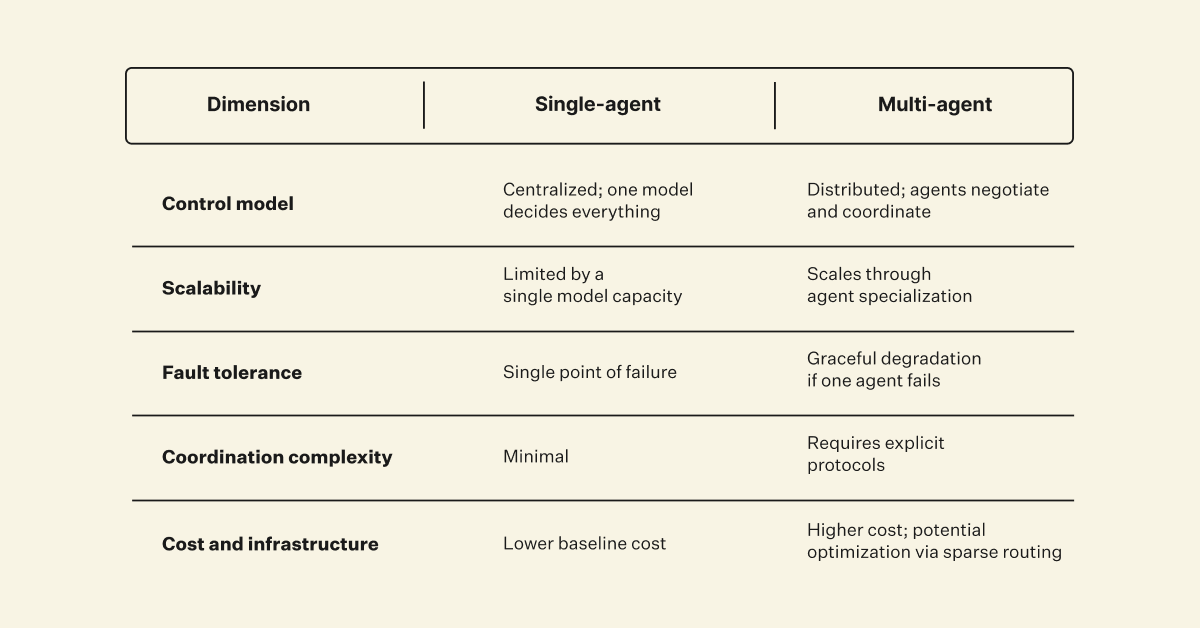
Untuk riset dan penulisan, aturan yang berguna adalah jumlah peran. Jika pekerjaan memiliki satu peran, gunakan satu agen. Jika pekerjaan memiliki peneliti, penulis, dan peninjau, gunakan sistem yang diorkestrasi — atau terima bahwa Andalah orkestratornya.
Bagaimana Anda Membangun Alur Kerja Riset dan Penulisan Berbantuan AI yang Lengkap?
Anda membangun alur kerja riset dan penulisan berbantuan AI yang lengkap dengan memisahkan penemuan, analisis, dan penyusunan, lalu memilih alat model tunggal atau platform berperutean untuk setiap lapisan, bukan menggunakan satu percakapan untuk keseluruhan proyek.
Rangkaian yang tahan lama terlihat seperti ini:
- Tentukan keputusan. Tulis pertanyaan yang harus dijawab dokumen akhir, beserta apa yang akan membantahnya.
- Kumpulkan sumber dengan alat yang mengutamakan pengambilan informasi. Gunakan Elicit atau Consensus untuk tinjauan tingkat makalah, Perplexity untuk briefing skala Web, atau Academic Research Assistant Jenova ketika ruang kerja yang sama harus mempertahankan sitasi.
- Analisis dengan model kedua. Ekstrak metode, ketidaksepakatan, dan tingkat keyakinan, bukan hanya rangkuman.
- Susun draf dengan spesialis penulisan. Gunakan Claude untuk naskah mandiri atau Writing Assistant Jenova ketika draf harus tetap terhubung dengan memori proyek.
- Jalankan tahap QA yang kritis. Minta model berbeda untuk menyerang sitasi, kronologi, dan klaim berlebihan.
- Kunci artefak. Ekspor hanya setelah klaim yang tidak didukung dihapus atau diturunkan tingkat kepastiannya.
Di Jenova, rangkaian tersebut dapat tetap berada dalam satu akun. Pengguna dapat memulai dengan Academic Research Assistant, mengganti model untuk tahap analitis, lalu melanjutkan dengan Writing Assistant atau SEO Blog Generator jika hasilnya adalah artikel publik. Memori persisten dan file terlampir mengurangi hilangnya batasan yang lazim terjadi di antara berbagai alat.
Instruksi transfer yang baik antara riset dan penulisan menjelaskan secara eksplisit apa yang tidak boleh berubah:
"Berikut paket sumber dan klaim yang sudah kami tolak. Susun bagian analisis untuk audiens kebijakan. Setiap paragraf memerlukan satu sumber yang tetap digunakan. Jika suatu klaim merupakan inferensi, beri label sebagai inferensi. Jangan hidupkan kembali klaim yang ditolak."
Pada alat model tunggal, alur kerja yang sama tetap dimungkinkan. Anda hanya menjadi peruternya: percakapan baru, catatan yang ditempelkan, dan model QA manual. Hal tersebut dapat menjadi rancangan yang tepat untuk pekerjaan sesekali. Namun, pendekatan ini menjadi rapuh ketika proyek berlangsung berminggu-minggu atau melibatkan banyak jenis dokumen.
Jenova bukanlah cara paling sederhana untuk membuat rangkuman satu kali. Keunggulannya adalah alur kerja di atas tidak memerlukan tiga langganan dan sistem pencatatan pribadi untuk menjaga semua bagiannya tetap selaras.
Apa Pendapat Tim Infrastruktur AI tentang Tumpukan Model Tunggal versus Multi-Model?
Tim infrastruktur AI umumnya menganggap alat model tunggal sebagai pilihan awal yang tepat untuk pekerjaan linear, serta platform multi-model sebagai pilihan awal yang tepat ketika alur kerja memiliki peran khusus, batasan biaya, atau tahap peninjauan independen.
"Kesalahan riset paling mahal yang kami lihat bukanlah memilih model terdepan yang salah. Kesalahannya adalah menggunakan satu model sebagai peneliti, analis, dan editor, lalu memercayai kelancaran paragraf akhirnya. Ketika sistem yang sama mengarang sumber lalu menulis kalimat yang bergantung pada sumber tersebut, tidak ada alarm internal. Model kedua tidak menjamin kebenaran, tetapi menciptakan peluang untuk tidak setuju."
"Perutean hanya layak menambah kompleksitas setelah Anda dapat menamai pekerjaannya. 'Teliti ini lalu tuliskan' masih satu pekerjaan. 'Kumpulkan makalah kandidat, ekstrak metode, selaraskan konflik, susun draf, lalu serang sitasinya' adalah lima pekerjaan. Tim yang melewatkan penguraian tersebut membeli diagram multi-agen, tetapi tetap menjalankan satu instruksi."
"Argumen biaya itu nyata, tetapi berlaku dua arah. Pekerjaan perutean Amazon yang dipublikasikan menunjukkan bahwa mengirim setiap permintaan ke model terkuat membuang uang, dan laporan vendor mengenai penghematan 30% hingga 60% masuk akal ketika klasifikasi dan penyusunan draf dipisahkan. Kegagalan sebaliknya juga umum: orkestrator, pengklasifikasi, dan tiga spesialis menghabiskan lebih banyak daripada yang akan dihabiskan satu model cermat untuk memo singkat."
— Tim Produk Jenova, arsitektur alur kerja AI, 8 tahun membangun sistem agen multi-model
Pandangan tersebut selaras dengan literatur rekayasa publik. AWS memperlakukan perutean multi-LLM sebagai tanggapan terhadap jenis tugas campuran, bukan sebagai peningkatan universal. GitHub memperlakukan orkestrasi sebagai kebutuhan setelah agen berkembang banyak, bukan sebelumnya. Konsensus para ahli bersifat kondisional: tambahkan model ketika pekerjaan memiliki sambungan. Jangan tambahkan model hanya untuk menghias tugas sederhana.
Kapan Anda Harus Tetap Menggunakan Alat Riset Model Tunggal?
Anda harus tetap menggunakan alat riset model tunggal ketika pertanyaannya terbatas, sumber sudah tersedia, tenggat waktunya singkat, dan Anda tidak memerlukan sistem kedua untuk mengaudit sistem pertama. Dalam kondisi tersebut, perutean multi-model menambah biaya koordinasi tanpa menambah banyak kebenaran.
Tetap gunakan ChatGPT atau Claude ketika Anda:
- Menjelaskan konsep yang sudah familier, bukan memetakan literatur.
- Menulis ulang dokumen yang sudah Anda percayai.
- Mengeksplorasi gaya, struktur, atau urutan argumen.
- Bekerja dalam satu sesi tanpa transfer ke rekan tim lain.
Tetap gunakan Perplexity atau Elicit ketika Anda:
- Mengajukan pertanyaan spesifik yang membutuhkan sitasi.
- Menyaring abstrak sebelum pembacaan yang lebih mendalam.
- Melakukan tinjauan literatur yang akan ditulis di tempat lain.
Beralihlah ke platform perutean tugas multi-model ketika dua atau lebih kondisi berikut benar:
- Proyek menggabungkan pencarian, analisis, dan penulisan akhir.
- Hasil harus mempertahankan jejak sumber di berbagai draf.
- Anda membutuhkan model berbeda untuk ekstraksi, penalaran, dan prosa.
- Pekerjaan cukup sering berulang sehingga alur kerja yang dapat digunakan kembali menjadi penting.
- Sitasi yang salah akan menimbulkan biaya besar.
Jenova sesuai dengan daftar kedua. Jenova lebih lemah sebagai pengganti alur kerja ekstraksi makalah Elicit dan lebih lemah daripada Claude sebagai sarana penulis konteks panjang yang sederhana. Jenova lebih kuat ketika pekerjaan-pekerjaan tersebut harus terjadi bersama, dengan memori, pilihan model, dan agen khusus di satu tempat.
Karena itu, keputusan tersebut bukan "model tunggal versus multi-model" sebagai ujian loyalitas. Keputusannya adalah apakah alur kerja Anda masih terlihat seperti percakapan atau sudah terlihat seperti lini produksi. Percakapan cocok untuk satu model. Lini produksi cocok untuk peruter.
Referensi
- AWS Machine Learning Blog — Strategi perutean multi-LLM untuk aplikasi AI generatif di AWS
- The Chicago School Library — Alat dan Sumber Daya Artificial Intelligence: Manfaat dan Keterbatasan
- University of the District of Columbia Library — Penggunaan dan Keterbatasan AI Generatif
- PapersFlow — AI Terbaik untuk Peneliti pada 2026: 10 Alat Dibandingkan Berdasarkan Kategori
- Thesify — Alat AI Terbaik untuk Riset Akademik pada 2026
- HatchWorks AI — Kasus Penggunaan Large Language Model: Satu LLM vs Beberapa Model
- TrueFoundry — Perutean Multi-Model: Optimalkan Tugas AI secara Efisien
- Synthesia — 12 Alat AI Terbaik untuk 2026
- AnswerThis — 10 Alat AI Teratas untuk Peneliti pada 2026
- Zerve — Alat AI untuk Riset pada 2026: Tinjauan Literatur, Analisis
- Multi — Satu tugas, alur kerja AI yang tepat
- ConvergePanel — Alat AI Multi-Model Terbaik untuk Riset
- Argumentree.AI — Riset AI Multi-Model vs Model Tunggal
- MindStudio — Cara Memangkas Biaya 60% dengan Mencocokkan Tugas ke Model yang Tepat
- GitHub Resources — Apa Itu Orkestrasi Agen AI?
- Kimi AI — Orkestrasi Agen AI: Jenis, Tahap, dan Manfaat
- Google Research — Memperkenalkan dua agen AI untuk figur dan peninjauan sejawat yang lebih baik”